首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10008篇文章
优秀的个人博客,低调大师

2.python爬虫基础——Urllib库

#python中Urllib库实战 #系统学习urllib模块,从urllib基础开始。学习urlretrieve(),urlcleanup(),info(),getcode(),geturl() import urllib.request #urlretrieve() 直接将一个网页爬到本地 urllib.request.urlretrieve("http://www.hellobi.com",filename="/Users/xubin/myapp/pythonfile/urlretrieve.html") #urlcleanup() 将urlretrieve产生的缓存,清空 urllib.request.urlcleanup() #info() 将一些基础的环境信息展示粗来 file=urllib.request.urlopen("http://www.hellobi.com") print(file.info()) #getcode() 获取访问url的状态码,返货200, print(file.getcode()) #geturl() 获取爬取得网址 print(file.geturl()) #超时设置 #爬取一个网页,需要时间。访问网页,网页长时间未响应,系统判断网页超时了,无法打开网页。 #服务器反应快设置2秒没反应未超时,如果服务器反应慢设置100秒没反应未超时,timeout超时时间为2 100 file=urllib.request.urlopen("http://www.hellobi.com",timeout=1) for i in range(0,10): try: file=urllib.request.urlopen("http://yum.iqianyue.com",timeout=0.1) data=file.read() print(len(data)) except Exception as e: print("出现异常:"+str(e)) #自动模拟http请求 #客户端如果要与服务器端进行通信,需要通过http请求进行,http请求有很多种 #主要涉及post,get两种方式,比如登录,搜索某些信息的时候会用到 #一般登录某个网站的时候,需要post请求 #一般搜索某些信息的时候,需要get请求 #在百度上搜索关键词,用python实现,需要用到请求,get get请求URL中有? #https://www.baidu.com/s?wd=python import urllib.request import re keywd="徐彬" keywd=urllib.request.quote(keywd) url="http://www.baidu.com/s?wd="+keywd #注意不能用https req=urllib.request.Request(url) data=urllib.request.urlopen(req).read() fh=open("/Users/xubin/myapp/pythonfile/百度python.html","wb") fh.write(data) fh.close() #post请求 比如需要登录用户 需要提交post请求 #http://passport.csdn.net/account/login 用户名:username 密码:password import urllib.request import urllib.parse url="https://passport.csdn.net/account/login" mydata=urllib.parse.urlencode({"username":"bingoxubin","password":"19900127LLBingo"}).encode("utf-8") req=urllib.request.Request(url,mydata) data=urllib.request.urlopen(req).read() fh=open("/Users/xubin/myapp/pythonfile/csdn登录界面.html","wb") fh.write(data) fh.close() ''' #爬取oa上的所有照片,存到OA照片.docx中 #遇到问题,目前所学,只能爬取单页的内容 import re import urllib.request data=urllib.request.urlopen("oa.epoint.com.cn").read() data=data.decode("utf-8") pat="" mydata=re.compile(pat).findall(data) fh=open("/Users/xubin/myapp/pythonfile/OA照片.docx","w") for i in range(0,len(mydata)): fh.write(mydata[i]+"\n") fh.close() '''

优秀的个人博客,低调大师

python-利用豆瓣爬虫发个动态

目前总的来说是失败了。原因可能是因为豆瓣验证码的问题,因为我看不到登录时候的界面,所以没法分析验证码的链接。(我用自己的浏览器登录都是默认不要验证码的,这就尴尬了),所以登录不上,后面的post也就没有意义了。把代码贴出来。 # -*- coding: utf-8 -*- """ Created on Sat Jan 6 14:45:40 2018 @author: xglc """ import requests import time session = requests.session() #创建request对象 def _login(iddata): url = 'https://www.douban.com/accounts/login' login_header = { 'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36', 'Origin':'https://www.douban.com/accounts/login', } session.headers.update(login_header) session.post(url,data=iddata,headers=session.headers) #_login() #print(session.headers.items) def _saysth(say_data): url = 'https://www.douban.com/' add_headers = {'Cache-Control':'max-age=0', 'Content-Length':'20', 'Content-Type':'application/x-www-form-urlencoded' } session.headers.update(add_headers) session.post(url,data=say_data,headers=session.headers) if __name__ == '__main__': iddata = {'form_mail':'账号', 'form_password':'密码', 'redir':'https://www.douban.com', 'login':'登录', } _login(iddata) print ('_login') # print (session.headers.items) for i in range(5): print(5-i) time.sleep(1) say_data = {'ck':'OJop', 'comment':'vict', } _saysth(say_data) print('完成!') View Code 也不打算继续扣了,因为用的是自己平时用的账号,post 太多豆瓣别把我给封了?如果继续扣的话,大概方向有两点: 找出豆瓣验证码的链接(我手动登录完全看不到验证码,这是我的常用电脑,所以无法分析) 完善update一下headers的内容,那里还有一些需要修改的项。 这几天淮南雪都开始化了,零下5度,made,空调还给我偶尔出冷风,需要赶紧上班去办公室温暖一下。 手动分析豆瓣js查看: Python-关于豆瓣发布“说句话”,添加网页等的js行为分析

优秀的个人博客,低调大师

Python爬虫入门教程 42-100 爬取儿歌多多APP数据-手机APP爬虫部分

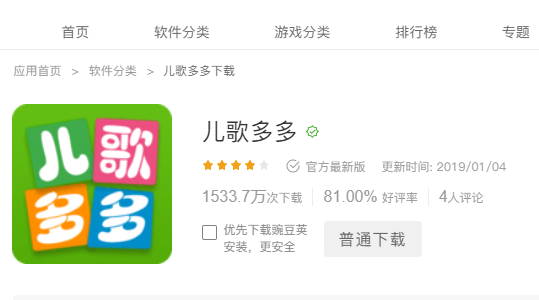
1. 儿歌多多APP简单分析 今天是手机APP数据爬取的第一篇案例博客,我找到了一个儿歌多多APP,没有加固,没有加壳,没有加密参数,对新手来说,比较友好,咱就拿它练练手,熟悉一下Fiddler和夜神模拟器是如何配合着使用的。 儿歌多多APP在豌豆荚的下载量还是可以的,一家做内容的APP。 2. APP安装和使用 APP直接去下载APK包就可以了,拖拽到夜神模拟器就安装成功了。在模拟器打开出现如下界面,表示已经可以开始操作了,非常儿童的APP。 3. 抓包测试 打开APP同时,打开Fiddler,首先测试一下网络是否正常,用模拟器自带的浏览器去访问百度,如果可以访问表示无问题,否则重新设置代理 运行软件过程中,注意观察Fiddler,如果出现JSON类型的API[接口],就要注意了,你想要的数据就在这里 我们点击链接,看Fiddler右侧显示内容

优秀的个人博客,低调大师

Python爬虫入门教程 38-100 教育部高校名单数据爬虫 scrapy

爬前叨叨 今天要爬取一下正规大学名单,这些名单是教育部公布具有招生资格的高校名单,除了这些学校以外,其他招生的单位,其所招学生的学籍、发放的毕业证书国家均不予承认,也就是俗称的野鸡大学! 网址是 https://daxue.eol.cn/mingdan.shtml 爬取完毕之后,我们进行一些基本的数据分析,套路如此类似,哈哈 这个小项目采用的是scrapy,关键代码 import scrapy from scrapy import Request,Selector class SchoolSpider(scrapy.Spider): name = 'School' allowed_domains = ['daxue.eol.cn'] start_urls = ['https://daxue.eol.cn/ming

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册