首页 文章 精选 留言 我的

精选列表

搜索[技术选型],共10004篇文章
优秀的个人博客,低调大师

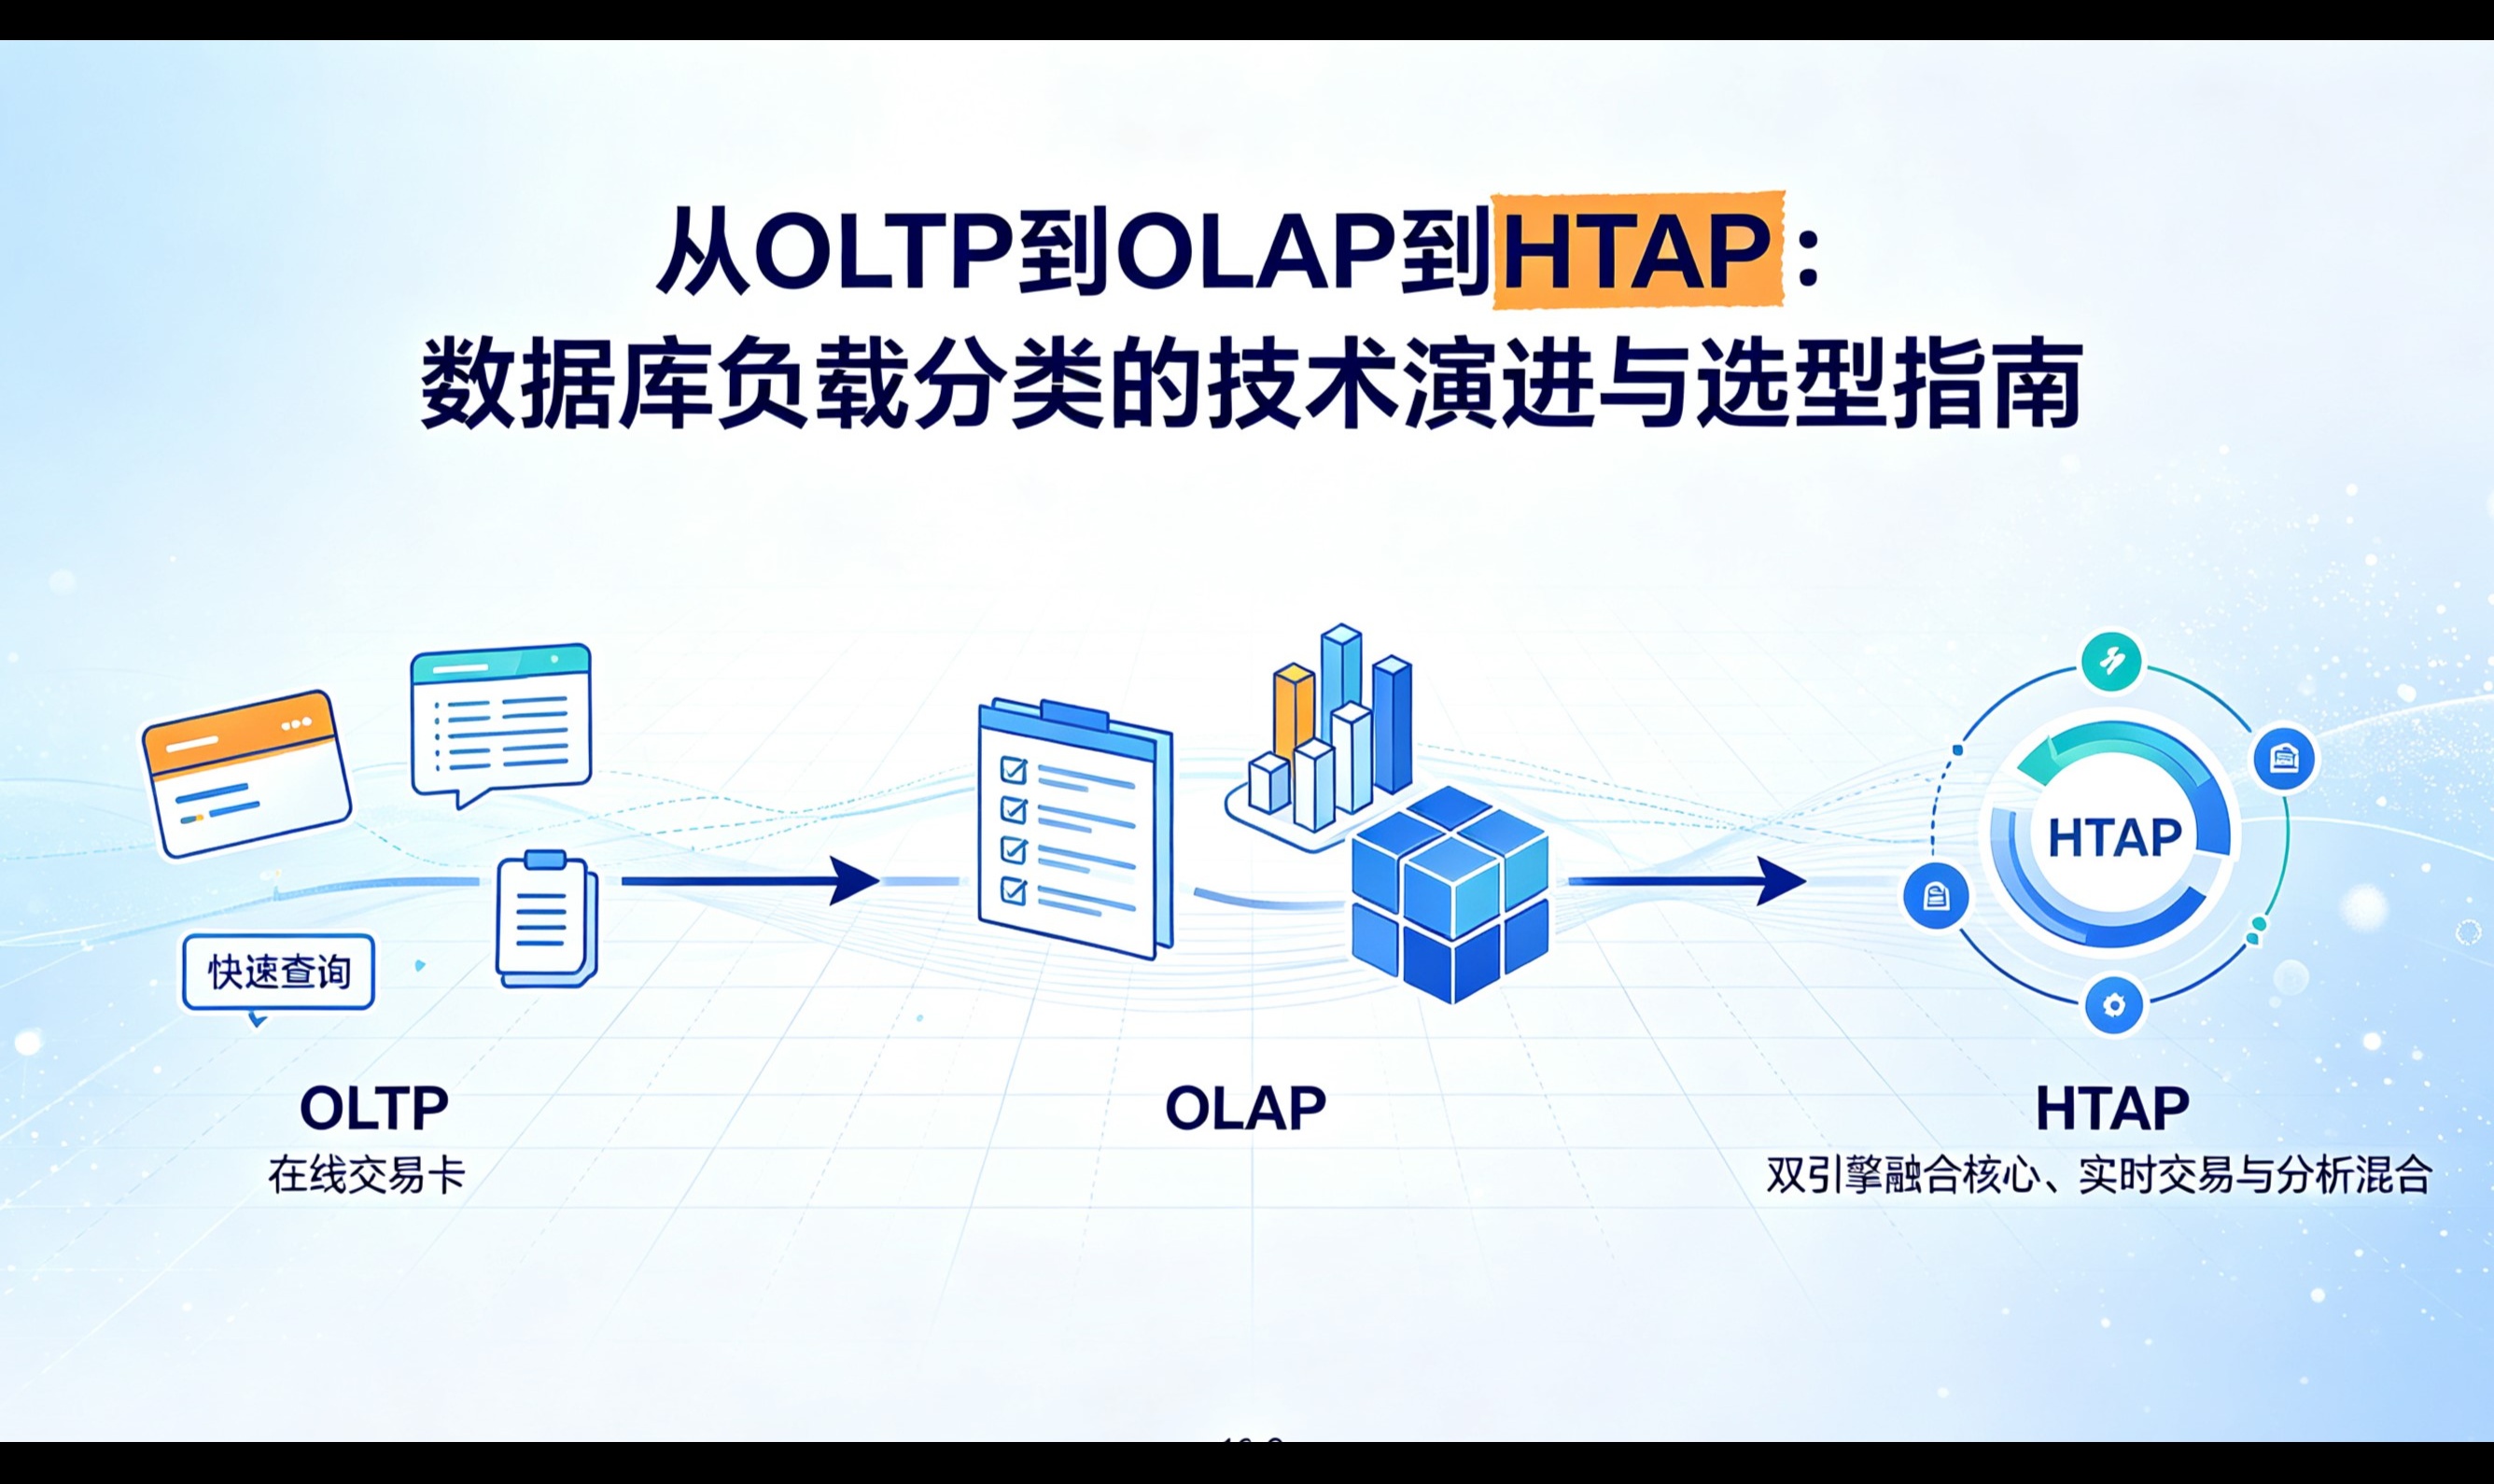
从OLTP到OLAP到HTAP:数据库负载分类的技术演进与选型指南

大家好,我是小耶,写功课只是为了我踩过的坑,你们别再踩了! 订单查询毫秒级,报表查询几十秒——这是很多人用MySQL时遇到的典型困惑。同一个数据库,同样的数据量,为什么换个查询方式就慢得离谱? 原因在于:**OLTP和OLAP是两种完全不同的负载类型,对数据库的要求也完全不同。** MySQL跑不动报表,问题不在SQL写得不好,在于它的存储结构和索引设计天生不适合做大范围聚合扫描。今天把OLTP和OLAP这件事彻底讲清楚。 ### 一、什么是OLTP? OLTP(Online Transaction Processing),在线事务处理。 **核心特征**: - **短事务**:每条事务只涉及少量行,比如“下单扣库存”、“转账扣款” - **高并发**:每秒数千到数万笔事务 - **强一致**:ACID是硬要求,扣款不能扣错、库存不能超卖 - **按行访问**:查询通常带主键或索引,一次只取几行 **典型场景**:订单系统、支付系统、用户注册、库存扣减。 **存储特征**:行式存储。一行的所有字段连续存放在一起。读取一行数据时,一次I/O就能拿到完整记录。 **索引特征**:B+树索引。支持快速的点查和范围查询。 **一句话总结**:OLTP数据库像便利店的收银台——每笔交易涉及的金额小、速度快、不能算错账。 ### 二、什么是OLAP? OLAP(Online Analytical Processing),在线分析处理。 **核心特征**: - **长事务**:一条查询可能扫描几千万行数据 - **低并发**:同时跑的报表查询通常只有几条 - **弱一致**:对实时性要求不高,可以接受分钟级延迟 - **按列访问**:通常只关心少数几列(比如销售额、品类),不需要整行数据 **典型场景**:报表统计、数据仓库、BI分析、大屏展示。 **存储特征**:列式存储。同一列的数据连续存放。扫描“销售额”这一列时,只需要读取这一列的数据,不需要把整行都读出来。 **索引特征**:通常用分区、排序键、位图索引等,而不是B+树。 **一句话总结**:OLAP数据库像超市月底盘点——不着急,但要把所有货架数一遍。 ### 三、为什么MySQL跑不动报表? **原因一:行式存储的I/O放大** 订单表用行式存储。一条订单记录可能包含几十个字段(订单号、用户ID、商品ID、金额、状态、创建时间、收货地址……)。 报表查询只需要“品类”和“销售额”两列,但行式存储会把整行数据都读出来——几十个字段里,只有两个有用,其余全是无效I/O。 **原因二:没有为聚合设计的索引** 订单表的索引是为OLTP设计的——按订单号查、按用户ID查、按创建时间查。但报表查询需要的是“按品类分组聚合”,这个索引不存在。 于是MySQL只能全表扫描5000万行,逐行过滤、分组、累加。 **原因三:临时表和排序开销** `GROUP BY`需要分组,`ORDER BY`需要排序。没有合适的索引,MySQL只能创建临时表做分组,再对结果排序。临时表可能落盘,性能断崖式下降。 **一句话**:OLTP的存储结构和索引设计,天生不适合OLAP的大范围聚合扫描。 ### 四、OLTP和OLAP的全面对比 |对比维度|OLTP|OLAP| | --- | --- | --- | |事务类型|短事务、高并发|长查询、低并发| |数据访问|按行读写|按列扫描| |存储方式|行式存储|列式存储| |索引结构|B+树|分区/排序键/位图| |一致性要求|强一致(ACID)|弱一致(可接受延迟)| |典型场景|订单、支付、库存|报表、BI、大屏| |代表产品|MySQL、Oracle、金仓KES|ClickHouse、Doris、StarRocks| **核心差异**:OLTP按行存、按行查,适合“精确找到某几行并修改”;OLAP按列存、按列算,适合“扫描大量行做聚合”。 ### 五、实际使用中的典型场景 **场景一:电商大促的实时库存扣减** 大促期间,每秒数万笔订单同时涌入。每笔订单需要扣减库存、生成订单记录、更新用户积分。 这是典型的OLTP场景。数据库需要承受极高的并发写入,同时保证库存不会超卖、积分不会算错。任何一条事务的延迟都会直接影响用户体验——用户点击“提交订单”后,等待超过2秒就会开始焦虑。 在这种场景下,数据库的优化重点是:**减少单条事务的响应时间、提高并发处理能力、保证ACID**。索引设计围绕主键和唯一键展开,事务隔离级别通常选择READ COMMITTED,锁的粒度尽可能小。 **场景二:运营人员的实时数据大屏** 运营团队需要一块大屏,实时展示“今日各品类销售额”、“Top10热销商品”、“各渠道转化率”。数据每分钟刷新一次。 这是典型的OLAP场景。查询需要扫描当天的所有订单数据,按品类、渠道分组聚合,计算销售额和转化率。 在这种场景下,数据库的优化重点是:**大范围扫描的吞吐量、聚合计算的效率、列式存储的压缩比**。查询可能扫描几百万行,但只需要读取“品类”、“金额”、“渠道”等少数几列。列式存储让这些查询只需要读取相关列的数据,避免无效I/O。 **场景三:月底财务对账** 财务部门需要在每月1号完成上个月的对账工作。需要统计每个商户的交易总额、退款总额、手续费、结算金额。 这个查询涉及的数据量可能是几亿行,涉及多张表的关联和复杂的聚合计算。查询可能跑几十分钟甚至几个小时。 这是典型的OLAP批处理场景。对响应时间的要求不高,但对计算结果的准确性要求极高。数据库的优化重点是:**大表关联的执行效率、聚合函数的计算速度、磁盘I/O的吞吐量**。 ### 六、HTAP:把两者合在一起 OLTP和OLAP的割裂带来了一个现实问题:**数据要从OLTP系统同步到OLAP系统,才能做分析。** 这个同步过程通常通过ETL(抽取、转换、加载)完成。数据延迟从几分钟到几小时不等,业务方要看的实时大屏根本做不到。 HTAP(Hybrid Transactional/Analytical Processing)就是为了解决这个问题——**同一套数据库,同时支撑OLTP和OLAP**。 **HTAP的三种实现方式**: **方式一:行列混存**——同一份数据,在内存中按行存一份用于交易,在磁盘上按列存一份用于分析。 **方式二:多副本分工**——主副本处理OLTP,从副本用列存处理OLAP。 **方式三:统一引擎**——存储层同时支持行式和列式格式,查询时自动选择。 **2026年的趋势**:HTAP正在从“概念验证”走向“规模化落地”。越来越多的业务系统不再维护两套数据库(OLTP一套、OLAP一套),而是用一套HTAP数据库同时支撑交易和分析。 ### 七、小结 OLTP和OLAP的核心差异,是数据组织和访问方式的不同。OLTP按行存、按行查,追求高并发下的强一致;OLAP按列存、按列算,追求大范围扫描的高吞吐。MySQL跑不动报表,是因为它的存储结构和索引设计是为OLTP优化的。2026年的趋势是HTAP——用一套数据库同时支撑交易和分析,让数据不再需要在两套系统之间来回同步。 **小耶在手,SQL 不愁** 还有什么想了解的,欢迎留言!小耶一定知无不言言无不尽……我们下次见~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册