首页 文章 精选 留言 我的

精选列表

搜索[小程序·云开发],共10036篇文章
优秀的个人博客,低调大师

对比来看java的Runnable&Callable&FutureTask

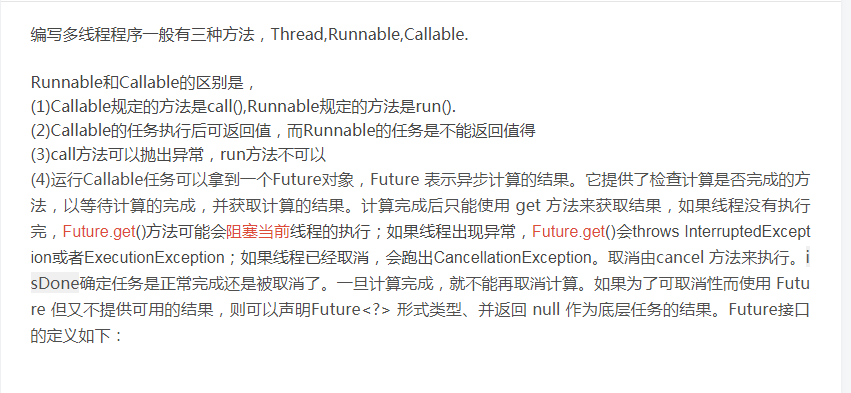
这篇文章其实主要是想要讲清楚一个概念,就是Runable和Callable的区别,以及当它们和FutureTask、ExecutorService一起执行的原理。 基本概念 java多线程实现方案 说明: 1、上图中java多线程的实现方案就没什么好说的了,基本上搞java的人都是理解的。 2、其实我始终觉得Thread是一个容器,所以和Runnable和Callable应该不在一个层次的概念,Thread应该是cpu真正调度的实体,这个实体会做什么呢,会执行Runnable和Callable的方法,所以特别不喜欢把这三者放在一起。 基本流程 FutureTask基本流程 说明: 1、左边是任务创建过程,右边是任务执行过程。 基本用法 常用方法 说明: 1、这个截图基本上就是Runnable和Callable和ExecutorService结合一起使用的用法。 2、关键是我比较感兴趣submit内部做了什么事情。 FutureTask创建之Callble对象 Callable的futureTask创建过程 说明: 1、在submit一个对象的时候,其实内部是给我们创建了一个FutureTask对象,整个创建过程是层层递进的。 2、FutureTask对象有两个重要属性,一个是callable对象也就是执行对象,一个state,标记这个任务是否完成。 FutureTask创建之Runable Runnable的FutureTask的创建过程 说明: 1、当我们针对Runnable对象创建futureTask的时候内部其实用Callable的适配器包装了一下,然后对外以Callable的对象运行。 2、可以看到call实际上调用的是task的run函数,这个run就不说了吧,线程里面的入口函数。 FutureTask内部属性 futureTask的核心内容 说明: 1、几个核心属性,callable就是刚刚所谓的执行对象,outcome最后执行返回的结果,其他整个线程的执行状态流转。 FutureTask任务提交 futureTask提交过程 说明: 1、这个futureTask的提交过程跟我们跟文章《我发现我不懂你了_JUC》其实是一样的,可以自行参考。 2、ExecutorService里面的worker其实真正调用的是run函数,所以我们还需要进一步搞清楚FutureTask是否包含run函数,当然毫无疑问肯定是有的,可以参考下面这个图。 FutureTask任务执行 futureTask内部实现run接口 说明: 1、接上面描述的文字,所以ExecutorService的worker其实真正执行的是Callable对象的call函数并设置回调结果。

优秀的个人博客,低调大师

Error:Execution failed for task ':app:mergeDebugResources'. > ...

Android Studio 编译中断.... Error:Execution failed for task ':app:mergeDebugResources'. > Some file crunching failed, see logs for details 错误信息如上: 解决方案: drawable里面的图片格式保存不对,Android studio 当编译资源文件的时候(using AAPT(Android Asset Packaging Tool))会抛出异常, 只需要用图片编辑工具,打开重新保存为.png图片,重新用新的图片,编译,即可。

优秀的个人博客,低调大师

深入了解高可用注册中心->Spring Cloud Eureka

在微服务架构这样的分布式环境中,我们需要充分考虑发生故障的情况, 所以在生产 环境中必须对各个组件进行高可用部署, 对于微服务如此, 对于服务注册中心也一样。 但 是到本节为止,我们一直都在使用单节点的服务注册中心,这在生产环境中显然并不合适, 我们需要构建高可用的服务注册中心以增强系统的可用性。 Eureka Server的设计一开始就考虑了高可用问题, 在Eureka的服务治理设计中, 所有 节点即是服务提供方, 也是服务消费方, 服务注册中心也不例外。 是否还记得在单节点的 配置中,我们设置过下面这两个参数, 让服务注册中心不注册自己: eureka.client.register-with-eureka=false eureka.client.fetch-registry=false Eureka Server的高可用实际上就是将自己作为服务向其他服务注册中心注册自己,这 样就可以形成一组互相注册的服务注册中心, 以实现服务清单的互相同步, 达到高可用的 效果。 下面我们就来尝试搭建高可用服务注册中心的集群。 目录结构 在etc/hosts文件中添加对peerl和peer2的转换, 让上面配置的host形式的 serviceUrl能在本地正确访间到; Windows系统路径为C:WindowsSystem32 driversetchosts。 1 2 127.0.0.1 peer1 127.0.0.1 peer2 启动: java -jar Eureka-0.0.1-SNAPSHOT.jar --spring.profiles.active=peer1 java -jar Eureka-0.0.1-SNAPSHOT.jar --spring.profiles.active=peer2 peer1图 peer2图 此时访问peer1的注册中心http://localhost:1111/, 如下图所示, 我们可以到看, registered-replicas中已经有peer2节点的eureka-server了。 同样的, 我们访 问peer2的注册中心http://localhost: 2222/ , 也能到看registered-replicas 中已经有peer1节点,并且这些节点在可用分片(available-replicase)之中。 在设置了多节点的服务注册中心之后, 服务提供方还需要做一些简单的配置才能将 服务注册到Eureka Server 集群中。 我们以下面的项目为例, 修改 application.properties 配置文件, 如下所示: 修改pom.xml 上面的配置主要对eureka.client.serviceUrl.defaultZone属性做了改动, 将注册中心指向了之前我们搭建的peerl与peer2(类似于dubbo服务)。 访问地址: http://localhost:1111/ http://localhost:2222/ 可以观察到hello-service 服务同时被注册到了peerl和peer2上。若此时断开peer!, 由于compute-service同时也向peer2注册, 因此在peer2上的 其他服务依然能访问到hello-service, 从而实现了服务注册中心的高可用。 想深入了解Spring Cloud,想提升职业技能么,这里有在大型企业工作十余年的架构师分享经验,Java工程化管理、高性能、分布式、高可用架构、zookeeper、Spring cloud,MyBatis,Netty源码分析和大数据等多个知识点高级进阶干货的直播讲解以及在线答疑,如果你想拿高薪的,想学习的,想就业前景好的,想跟别人竞争能取得优势的,想进阿里面试但担心面试不过的,你都可以来,QQ群号为:468947140

优秀的个人博客,低调大师

Template parsing error: template: :1:2: executing at <Volumes>: ...

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80400454 报错: [root@ops-ip-statistic ~]# docker inspect -f {{.Volumes}} volume-test1 Template parsing error: template: :1:2: executing "" at <.Volumes>: map has no entry for key "Volumes" 1 2 3 解决: 1,使用 “.Config.Volumes” 替换 “.Volumes” [root@ops-ip-statistic ~]# docker inspect -f {{.Config.Volumes}} volume-test1 map[/data:{}] 1 2 显示为空,此法 在此不可行 2,直接看容器的所有信息 再grep [root@ops-ip-statistic _data]# docker inspect volume-test1 | grep Mounts -A 10 "Mounts": [ { "Name": "0a3d70900bd0fa46c797f7aa7ff5176b7f6a5a798b6a282cd6c532facfd24925", "Source": "/var/lib/docker/volumes/0a3d70900bd0fa46c797f7aa7ff5176b7f6a5a798b6a282cd6c532facfd24925/_data", "Destination": "/data", "Driver": "local", "Mode": "", "RW": true, "Propagation": "" } ], 1 2 3 4 5 6 7 8 9 10 11 12 找到对应的目录是: /var/lib/docker/volumes/0a3d70900bd0fa46c797f7aa7ff5176b7f6a5a798b6a282cd6c532facfd24925/_data 1 进入容器中创建一个文件: [root@nginx data]# echo 123 >a [root@nginx data]# cat a 123 1 2 3 在宿主机的对应的目录中查看: [root@ops-ip-statistic _data]# cd /var/lib/docker/volumes/0a3d70900bd0fa46c797f7aa7ff5176b7f6a5a798b6a282cd6c532facfd24925/_data [root@ops-ip-statistic _data]# cat a 123 1 2 3 可行!

优秀的个人博客,低调大师

Android Studio中解决Gradle DSL method not found: &amp;#39;android()&amp;#39;

近期导入as的项目出了这种问题 这个问题困扰了我非常长时间,好吧,搜了半天全都是runProguard的。最后在stackoverflow上搜到解决的方法了:http://stackoverflow.com/questions/27735646/android-studio-gradle-dsl-method-not-found-android-error17-0 解决方法: 删掉最外层的build.gradle中的 android { compileSdkVersion 19 buildToolsVersion '21.1.1' } 然后又一次刷新就ok了 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5275790.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

构建高并发&amp;高可用&amp;安全的IT系统-高并发部分

什么是高并发? 狭义来讲就是你的网站/软件同一时间能承受的用户数量有多少 相关指标有 并发数:对网站/软件同时发起的请求数,一般也可代表实际的用户 每秒响应时间:常指一次请求到系统正确响的时间(以秒为单位) TPS(每秒事务数):每秒钟可以处理的事务(请求响应),大概的计算公式为:并发数/每秒响应时间=TPS QPS(每秒查询数):TPS事务有读有写,而QPS指的是读取,一般情况QPS应是高于TPS的 IP(独立IP):一个IP可以发生多次UV和PV PV(访问量):即Page View,页面浏览或点周量,用户每次新刷新即被计算一次 UV(独立访客):一般通过cookies记录等判断为一个独立用户,同一IP可能有多个UV(共享IP),发生多次PV 流量(网络流量):请求所产生的网络流量,因为受限于带宽也是并发中的一个重要指 一般公司演化阶段 1、优化运算代码、SQL查询、数据库索引等 2、进行应用负载均衡、数据库做主从/主主复制进行读写分离、增加缓存(Redis\Mem) 3、对系统和数据进行垂直拆分,按业务模块拆分成不同的应用及数据库表 4、分布式服务化、异步消息机制、数据库表水平拆分 优化运算代码、SQL查询、数据库索引等 一般初创公司系统大多数都是单体单库的系统,按照成本优先级第一要做的就是对系统进行代码级的优化。比如应用代码逻辑梳理、合理使用多线程、SQL避免全表扫描、少使用LIKE、 根据业务创建索引等。 案例 单次LIKE大数据量统计查询Sending data状态过多导致数据库连接被耗尽,系统停止响应。通过在统计表建立触发器更新单值表解决 负载均衡、读写分离、缓存 到了第二阶段,单体应用通过优化与增加硬件配置已无法解决高并发的问题,这时可以考虑进行以下架构的演化,这种演化对系统基本没有侵入性,成本低廉 负载均衡: 可以通过Nginx反向代理、F5等进行应用的多流量分发,需要解决的问题就是会话问题,可采用Nginx的路由或是SESSION同步/独立。 读写分离: 采用数据库的主从复制机制,将写入库与读取库分离,可采用中间件进行代理路由,基本可以不改代码。 缓存: 可跟据业务规则将部分数据进行缓存 应用、数据垂直拆分 第二阶段支撑过一定量后,随着并发量再次的提升,由于单库表数据量变大以及访问限制已经不能满足,这时可以考虑进行数据库表的按系统模块垂直拆分。将内联的业务划分为独立的库表,相应的应用也 应随之拆分(应用这时加机器还能挺,不过做不到可审缩资源利用最大化)。同一应用系统访问同一库表,应用系统之间进行少量通信。 分布式服务化、异步消息机制、数据库表水平拆分 在经历过前三阶段后,能走到第四阶段说明平台的发展非常好了,对系统的高并发又有了进一步的要求,这也是成本最高最复杂的,系统架构需要进行很大的改造 分布式: 对系统应用进行服务化(如微服务),服务化的目的不只是为了高并发,也从系统的可维护性(团队大了)、资源利用最大化(对服务进行差异化支撑)方面考虑。 面临的挑战主要是分布式事务方面的控制,可采用二阶段提交方式或是分布式事务容器实现分布式事务。 异步消息机制: 主要解决大并发写入瓶颈,利用消息对列对写入消息进行排队,待数据库进 行处理。 数据库表水平拆分:按一定规则将同一业务表的数据拆分到不同的库/表中(如HASH),面临的挑战主要是跟业务关联性强、跨表的数据合并等。解决方案就是写 好代码吧。。。 http://www.cnblogs.com/assion/p/7239106.html 分类: 软件设计, 网站性能, 重构 本文转自左正博客园博客,原文链接: http://www.cnblogs.com/soundcode/p/7244160.html,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册