首页 文章 精选 留言 我的

精选列表

搜索[小程序·云开发],共10036篇文章
优秀的个人博客,低调大师

Elasticsearch: 权威指南 » 深入搜索 » 多字段搜索 » 多数字段 good

跨字段实体搜索 » 多数字段编辑 全文搜索被称作是召回率(Recall)与精确率(Precision)的战场:召回率——返回所有的相关文档;精确率——不返回无关文档。目的是在结果的第一页中为用户呈现最为相关的文档。 为了提高召回率的效果,我们扩大搜索范围——不仅返回与用户搜索词精确匹配的文档,还会返回我们认为与查询相关的所有文档。如果一个用户搜索 “quick brown box” ,一个包含词语fast foxes的文档被认为是非常合理的返回结果。 如果包含词语fast foxes的文档是能找到的唯一相关文档,那么它会出现在结果列表的最上面,但是,如果有 100 个文档都出现了词语quick brown fox,那么这个包含词语fast foxes的文档当然会被认为是次相关的,它可能处于返回结果列表更下面的某个地方。当包含了很多潜在匹配之后,我们需要将最匹配的几个置于结果列表的顶部。 提高全文相关性精度的常用方式是为同一文本建立多种方式的索引,每种方式都提供了一个不同的相关度信号signal。主字段会以尽可能多的形式的去匹配尽可能多的文档。举个例子,我们可以进行以下操作: 使用词干提取来索引jumps、jumping和jumped样的词,将jump作为它们的词根形式。这样即使用户搜索jumped,也还是能找到包含jumping的匹配的文档。 将同义词包括其中,如jump、leap和hop。 移除变音或口音词:如ésta、está和esta都会以无变音形式esta来索引。 尽管如此,如果我们有两个文档,其中一个包含词jumped,另一个包含词jumping,用户很可能期望前者能排的更高,因为它正好与输入的搜索条件一致。 为了达到目的,我们可以将相同的文本索引到其他字段从而提供更为精确的匹配。一个字段可能是为词干未提取过的版本,另一个字段可能是变音过的原始词,第三个可能使用shingles提供词语相似性信息。这些附加的字段可以看成提高每个文档的相关度评分的信号signals,能匹配字段的越多越好。 一个文档如果与广度匹配的主字段相匹配,那么它会出现在结果列表中。如果文档同时又与signal信号字段匹配,那么它会获得额外加分,系统会提升它在结果列表中的位置。 我们会在本书稍后对同义词、词相似性、部分匹配以及其他潜在的信号进行讨论,但这里只使用词干已提取(stemmed)和未提取(unstemmed)的字段作为简单例子来说明这种技术。 多字段映射编辑 首先要做的事情就是对我们的字段索引两次:一次使用词干模式以及一次非词干模式。为了做到这点,采用multifields来实现,已经在multifields有所介绍: DELETE /my_index PUT /my_index { "settings": { "number_of_shards": 1 }, "mappings": { "my_type": { "properties": { "title": { "type": "string", "analyzer": "english", "fields": { "std": { "type": "string", "analyzer": "standard" } } } } } } } 拷贝为 CURL 在 SENSE 中查看 参考被破坏的相关度. title字段使用english英语分析器来提取词干。 title.std字段使用standard标准分析器,所以没有词干提取。 接着索引一些文档: PUT /my_index/my_type/1 { "title": "My rabbit jumps" } PUT /my_index/my_type/2 { "title": "Jumping jack rabbits" } 拷贝为 CURL 在 SENSE 中查看 这里用一个简单match查询title标题字段是否包含jumping rabbits(跳跃的兔子): GET /my_index/_search { "query": { "match": { "title": "jumping rabbits" } } } 拷贝为 CURL 在 SENSE 中查看 因为有了english分析器,这个查询是在查找以jump和rabbit这两个被提取词的文档。两个文档的title字段都同时包括这两个词,所以两个文档得到的评分也相同: { "hits": [ { "_id": "1", "_score": 0.42039964, "_source": { "title": "My rabbit jumps" } }, { "_id": "2", "_score": 0.42039964, "_source": { "title": "Jumping jack rabbits" } } ] } 如果只是查询title.std字段,那么只有文档 2 是匹配的。尽管如此,如果同时查询两个字段,然后使用bool查询将评分结果合并,那么两个文档都是匹配的(title字段的作用),而且文档 2 的相关度评分更高(title.std字段的作用): GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 我们希望将所有匹配字段的评分合并起来,所以使用most_fields类型。这让multi_match查询用bool查询将两个字段语句包在里面,而不是使用dis_max查询。 { "hits": [ { "_id": "2", "_score": 0.8226396, "_source": { "title": "Jumping jack rabbits" } }, { "_id": "1", "_score": 0.10741998, "_source": { "title": "My rabbit jumps" } } ] } 文档 2 现在的评分要比文档 1 高。 用广度匹配字段title包括尽可能多的文档——以提升召回率——同时又使用字段title.std作为信号将相关度更高的文档置于结果顶部。 每个字段对于最终评分的贡献可以通过自定义值boost来控制。比如,使title字段更为重要,这样同时也降低了其他信号字段的作用: GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title^10", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 title字段的boost的值为10使它比title.std更重要。 https://www.elastic.co/guide/cn/elasticsearch/guide/current/most-fields.html

优秀的个人博客,低调大师

Android中<meta-data>的使用

在AndroidManifest.xml中。<meta-data>元素能够作为子元素,被包括在<activity>、<application> 、<service>和<receiver>元素中,但 不同的父元素。在应用时读取的方法也不同。 1 :在Activity的应用。 xml代码段: <activity...> <meta-data android:name="myMsg" android:value="hello my activity"></meta-data> </activity> java代码段: ActivityInfo info=this.getPackageManager() .getActivityInfo(getComponentName(), PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 2:在application的应用。 xml代码段: <application...> <meta-data android:value="hello my application" android:name="myMsg"></meta-data> </application> java代码段: ApplicationInfo appInfo = this.getPackageManager() .getApplicationInfo(getPackageName(), PackageManager.GET_META_DATA); String msg=appInfo.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 3:在service的应用。 xml代码段: <service android:name="MetaDataService"> <meta-data android:value="hello my service" android:name="myMsg"></meta-data> </service> java代码段: ComponentName cn=new ComponentName(this, MetaDataService.class); ServiceInfo info=this.getPackageManager() .getServiceInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 4: 在receiver的应用。 xml代码段: <receiver android:name="MetaDataReceiver"> <meta-data android:value="hello my receiver" android:name="myMsg"></meta-data> <intent-filter> <action android:name="android.intent.action.PHONE_STATE"></action> </intent-filter> </receiver> java代码段: ComponentName cn=new ComponentName(context, MetaDataReceiver.class); ActivityInfo info=context.getPackageManager() .getReceiverInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5113540.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(二)--Capped集合 &amp;&amp; GridFS存储文件

Capped集合 Capped集合的大小是固定的,如果空间都被用完了,新添加的对象会取代最旧的那个数据。 创建 使用了db.createCollection()方法创建了一个名字为mycapped,空间大小为100000的Capped Colletcion。 限制 如果需要限定Collection中对象的数量,就要设置max参数,如果到了限制的数量,就要移除一个最近的插入。 使用validate()查询mycapped2集合的使用的存储空间。 默认情况下,非Capped集合会在_id上创建索引,而Capped集合不会在_id上创建索引,如果需要在_id上创建索引就需要用到autoIndexID参数。 GridFS存储文件 GridFS存储文件时会分两个集合来存储: files 包含元数据对象。 chunks 包含其他一些相关信息的二进制块。 使用mongofiles put F:\MongoDB\mongodb\bin\bad.txt命令将bad.txt文件保存到了数据库中。 查看数据库中有哪些GridFS文件: 重命名本地的bad.txt文件为bad1.txt,将数据库中文件导出: GridFS的块由单独的集合来存储,默认情况下,使用fs.chunks集合来存储块。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3557578.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker安装初试&amp;&amp;制作centos6.5基础镜像

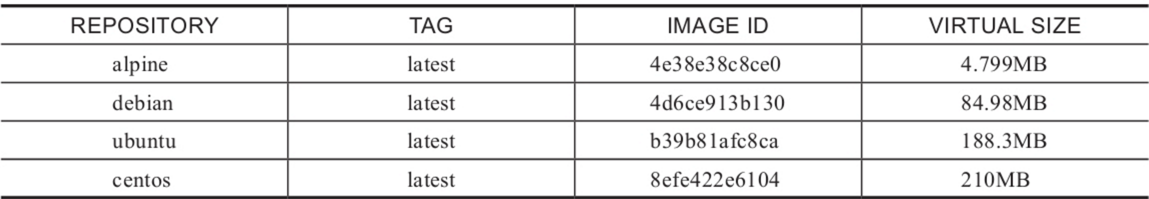
https://blog.tankywoo.com/docker/2014/05/08/docker-4-summary.html https://yeasy.gitbooks.io/docker_practice/content/basic_concept/container.html centos7.x系列的yum源中自带了docker的rpm包,安装比较简单 # yum install docker -y 安装过程中可能会遇到lvm2包依赖冲突,如不使用,卸载即可 # yum remove lvm2 启动服务 # service docker start 查看版本 # docker -v Docker version 1.10.3, build d381c64-unsupported 获取BusyBox镜像 # docker pull busybox 创建容器并echo一句话 # docker run busybox /bin/echo Starting docker trip? Starting docker trip? centos6.x系列需要安装epel源,并且升级内核到3.10版本否则docker不能正常运行 基于git克隆安装https://github.com/llitfkitfk/docker-tutorial-cn # git clone git://github.com/llitfkitfk/docker-tutorial-cn.git # cd docker-tutorial-cn/ # ./docker_install.sh ##执行此步骤如果报下文错误需要修改/etc/yum.repos.d/epel.repo文件,取消baseurl的注释,注释掉mirrorlist Error: Cannot retrieve metalink for repository: epel. Please verify its path and try again # ./docker_config.sh ##可根据实际情况修改docker image的储存路径,此处配置到/mnt/docker,默认路径是/var/lib/docker # mkdir /mnt/docker # ./start_docker.sh ##开启docker服务 docker: relocation error: docker: symbol dm_task_get_info_with_deferred_remove, version Base not defined in file libdevmapper.so.1.02 with link time reference # yum upgrade device-mapper-libs ##启动报错,需要安装依赖 # docker info ##检查Docker是否正确安装 Containers: 0 Images: 0 Storage Driver: devicemapper Pool Name: docker-253:0-1182180-pool Pool Blocksize: 65.54 kB Backing Filesystem: extfs Data file: /dev/loop0 Metadata file: /dev/loop1 Data Space Used: 305.7 MB Data Space Total: 107.4 GB Data Space Available: 28.35 GB Metadata Space Used: 733.2 kB Metadata Space Total: 2.147 GB Metadata Space Available: 2.147 GB Udev Sync Supported: true Deferred Removal Enabled: false Data loop file: /var/lib/docker/devicemapper/devicemapper/data Metadata loop file: /var/lib/docker/devicemapper/devicemapper/metadata Library Version: 1.02.117-RHEL6 (2016-04-01) Execution Driver: native-0.2 Logging Driver: json-file Kernel Version: 2.6.32-358.6.2.el6.x86_64 Operating System: <unknown> CPUs: 12 Total Memory: 3.662 GiB Name: localhost ID: SAJR:3GXN:LA3H:XV3F:4WUS:PJNS:N7YI:IXS2:LCO2:J6WL:AMCV:AEBW 在docker index中搜索centos相关的image # docker search centos 从docker registry server拉取centos镜像 # docker pull centos 创建一个运行bash应用的容器,一直报错,使用-d命令查看进行运行信息,发现内核版本过低 # docker run -i -t centos /bin/bash Error response from daemon: Cannot start container 317bcef4837ad90112a9021012f243bdf92e594h file or directory # docker -d WARN[0000] You are running linux kernel version 2.6.32-358.6.2.el6.x86_64, which might be pgrade your kernel to 3.10.0. 于是升级内核到3.10 http://my.oschina.net/denglz/blog/487332 安装kernel-lt(long-term) # yum install http://www.elrepo.org/elrepo-release-6-5.el6.elrepo.noarch.rpm # yum --enablerepo=elrepo-kernel install kernel-lt -y 新安装的内核已经自动写入了grub.conf文件,只需修改Grub引导顺序,重启即可 # sed -i 's/default=1/default=0/' /etc/grub.conf 内核已经更新 # uname -a Linux localhost.localdomain 3.10.102-1.el6.elrepo.x86_64 #1 SMP Tue Jun 14 11:40:50 EDT 20 列出images # docker images REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE centos latest d83a55af4e75 2 weeks ago 196.7 MB 使用centos这个镜像创建container进入交互模式,login shell是/bin/bash Docker制作centos6.5基础镜像 http://blog.chinaunix.net/uid-20788636-id-4909654.html # yum install febootstrap # mkdir /dockerimg/centos6.5 创建镜像文件保存目录 # febootstrap -i bash -i wget -i yum -i iputils -i iproute -i man -i vim -i openssh-server -i openssh-clients -i tar -i p7zip -i net-tools centos6.5 /dockerimg/centos6.5 http://vault.centos.org/6.5/os/x86_64/ -i指定安装的包 centos6.5标识OS版本 # cp /etc/skel/.bash* /dockerimg/centos6.5/root/ # cd /dockerimg/centos6.5 # tar -c .|docker import - centos6.5 导入镜像文件 63a8a89d802130fa35f0661402bf776069dcfd2cf83da553d4874c6a6c7ad056 # docker images 已经成功导入,使用docker run命令就可以基于centos6.5创建容器使用了 REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE centos6.5 latest 63a8a89d8021 About a minute ago 372 MB

优秀的个人博客,低调大师

对比来看java的Runnable&amp;Callable&amp;FutureTask

这篇文章其实主要是想要讲清楚一个概念,就是Runable和Callable的区别,以及当它们和FutureTask、ExecutorService一起执行的原理。 基本概念 java多线程实现方案 说明: 1、上图中java多线程的实现方案就没什么好说的了,基本上搞java的人都是理解的。 2、其实我始终觉得Thread是一个容器,所以和Runnable和Callable应该不在一个层次的概念,Thread应该是cpu真正调度的实体,这个实体会做什么呢,会执行Runnable和Callable的方法,所以特别不喜欢把这三者放在一起。 基本流程 FutureTask基本流程 说明: 1、左边是任务创建过程,右边是任务执行过程。 基本用法 常用方法 说明: 1、这个截图基本上就是Runnable和Callable和ExecutorService结合一起使用的用法。 2、关键是我比较感兴趣submit内部做了什么事情。 FutureTask创建之Callble对象 Callable的futureTask创建过程 说明: 1、在submit一个对象的时候,其实内部是给我们创建了一个FutureTask对象,整个创建过程是层层递进的。 2、FutureTask对象有两个重要属性,一个是callable对象也就是执行对象,一个state,标记这个任务是否完成。 FutureTask创建之Runable Runnable的FutureTask的创建过程 说明: 1、当我们针对Runnable对象创建futureTask的时候内部其实用Callable的适配器包装了一下,然后对外以Callable的对象运行。 2、可以看到call实际上调用的是task的run函数,这个run就不说了吧,线程里面的入口函数。 FutureTask内部属性 futureTask的核心内容 说明: 1、几个核心属性,callable就是刚刚所谓的执行对象,outcome最后执行返回的结果,其他整个线程的执行状态流转。 FutureTask任务提交 futureTask提交过程 说明: 1、这个futureTask的提交过程跟我们跟文章《我发现我不懂你了_JUC》其实是一样的,可以自行参考。 2、ExecutorService里面的worker其实真正调用的是run函数,所以我们还需要进一步搞清楚FutureTask是否包含run函数,当然毫无疑问肯定是有的,可以参考下面这个图。 FutureTask任务执行 futureTask内部实现run接口 说明: 1、接上面描述的文字,所以ExecutorService的worker其实真正执行的是Callable对象的call函数并设置回调结果。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册