首页 文章 精选 留言 我的

精选列表

搜索[加密解密],共10003篇文章
优秀的个人博客,低调大师

解密游戏推荐系统的建设之路

作者:vivo 互联网服务器团队- Ke Jiachen、Wei Ling 本文从零开始介绍了游戏推荐项目的发展历程,阐述了大型项目建设中遇到的业务与架构问题以及开发工程师们的解决方案,描绘了游戏推荐项目的特点以及业务发展方向,有着较好的参考与借鉴意义。 一、游戏推荐的背景与意义 从信息获取的角度来看,搜索和推荐是用户获取信息的两种主要手段,也是有效帮助产品变现的两种方式,搜索是一个非常主动的行为,并且用户的需求十分明确,在搜索引擎提供的结果里,用户也能通过浏览和点击来明确的判断是否满足了用户需求。 然而,推荐系统接受信息是被动的,需求也都是模糊而不明确的。 推荐系统的作用就是建立更加有效率的连接,更有效率地连接用户与内容和服务,节约大量的时间和成本。以此背景,游戏推荐系统由此诞生。 游戏推荐系统从设计之初就作为游戏分发的平台,向公司内所有主要流量入口(游戏中心、应用商店、浏览器、jovi等)分发游戏,系统通过各种推荐算法及推荐策略,为用户推荐下载付费意愿较高且兼顾商业价值的游戏,从而为公司带来收入。发展至今天,该系统还具备类游戏内容与素材的推荐功能。 二、游戏推荐的初期模型 游戏推荐的目的是推出用户想要且兼顾商业价值的游戏,以此来提高业务的收入指标。此处的商业价值是由运营侧通过策略规则去把控的,而用户意向游戏则是通过算法排序得到的,算法排序所需要的特征数据,以及推荐效果的反馈数据则由埋点信息上报以供计算分析。 因此我们的模型可以分成四大块: 运营推荐规则配置 算法模型训练 推荐策略生效 数据埋点上报 模块间的交互如下:在策略生效前,运营会先在配置中心生成对应的配置规则,这些规则会以缓存的形式存储以供推荐高并接口调用。当用户访问app应用某些特定页面时,其后台会带着对应的场景信息来请求游戏推荐后台,推荐后台根据场景信息映射相关配置(召回,标签,过期,算法等..........)调用算法服务并进行资源排序,最终将推荐的结果反馈给app应用。 app应用在展示推荐页面的同时,也将用户相应的行为数据以及推荐数据的相关埋点进行上报。 三、业务增长与架构演进 随着接入系统带来的正向收益的提升,越来越多的业务选择接入游戏推荐系统,这使得我们支持的功能日益丰富。 目前游戏推荐覆盖的场景有分类、专题、榜单、首页、搜索等;包含的策略类型有干预、打散、资源配比、保量;支持的推荐类型更是丰富:联运游戏、小游戏、内容素材、推荐理由。 这些丰富的使用场景使得业务的复杂度成本增长,令我们在性能,扩展性,可用性上面临着新的挑战,也推动着我们架构变革。 3.1 熵增环境下的通用组合策略 在0 到 1 的过程中,游戏推荐聚焦于提高分发量,这时候考虑得更多的是怎么把游戏推出去,在代码实现上使用分层架构来划分执行的业务。 但是在1 到 2 的过程中, 我们游戏推荐不仅仅推荐游戏,也推荐内容和素材;同时在策略调用上也更加灵活,不同场景其调用的策略是不同的,执行顺序也是不同的;更重要的是加入了很多用户个性化业务与动态规则,这些都使得现有业务代码急剧膨胀,扩展起来捉襟见肘,无从下手。因此我们急需一个高复用,易扩展,低代码的策略框架去解决这些问题。 如图所示,通用组合策略负责流转的角色有两个acceptor和executor,通讯媒介是推荐上下文context。负责执行逻辑的角色有三个matcher,listener和process,它们都有多个不同逻辑的实现类。当请求游戏推荐系统时,acceptor会先从配置中动态查询策略模板进行匹配,接着listener组件会执行相应的预处理逻辑。处理后acceptor通过上下文context将任务流转给executor处理器。executor再根据配置,将process根据前置条件进行筛选并排列组合,最后埋点返回。 经过这套通用的策略,我们在实现一般业务的时候,只要扩展具体matcher和process,并在配置中心将场景和处理优先级绑定起来,就能完成大部分的场景开发,这样研发者可以更聚焦于某个逻辑流程的开发,而不用疲于梳理代码,并进行扩展设计。 3.2 多级缓存与近实时策略 游戏推荐系统服务于手机游戏用户,处于整个系统链路的下游,峰值流量在3W TPS左右 ,是个读远多于写的系统。“读”流量来自于用户在各种推荐场景,列表、搜索、下载钱下载后、榜单等,写数据主要来源于运营相关策略的变更,所以我们面临的一个重大挑战就是如何在保证可用性的前提下应对高频的读请求。 为了保证系统的读性能,我们采用了redis + 本地缓存的设计。配置更新后先写mysql,写成功后再写redis。本地缓存定时失效,使用懒加载的方式从redis中读取相关数据。这种设计能保证最终一致性,软状态时服务集群数据存在短暂不一致的情况,早期对业务影响不大,可以认为是一个逐步放量的过程。 早期原先部署节点较少,整个系统达到最终一致性的时间较短,但随着节点增加到数百台,这个时间就变得不是那么和谐了。 同时随着业务复杂度的增加,常常是多个配置策略决定这一个推荐结果,此时本地缓存的状态极大影响了测试和点检的便利,如果配置更改不能做到立马更新本地缓存,那就要等待漫长的一段时间才能开始验证逻辑。因此,我们对缓存结构做出了如下的调整: 与先前不同的是,我们加入消息队列并通过配置版本号的比对来实现策略的实时更新同步,取得了很好的效果。 3.3 高并服务的垃圾回收处理 任何一个java服务都逃离不了FGC的魔咒,高并服务更是如此。很多服务每天两位数的FGC更是家常便饭,显然这对业务的稳定性和服务性能影响是巨大的。游戏推荐这边通过不断实践总结了一套较为通用的方法很好地解决了这个问题: 可以看到起初jvm配置较为常规:1G的年轻代,2G的老年代以及一些其他常见的多线程回收的配置,其结果就是每天10次的FGC,YGC单次耗时在100ms,FGC耗时在350 - 400ms。我们知道线上接口容忍的范围一般是200ms以内,不超过300ms,这样显然是不达标的。 通过分析,我们发现高并服务的高频FGC来源于这几个方面: 大量的本地缓存(堆内)占据了老年代的空间,大大增加了老年代叠满的频率。 高并请求导致了对象的急速生成,年轻代空间不足以容纳这剧增的对象,导致其未达到存活阈值(15次)就晋升至老年代。 引入的监控组件为了性能,常常延迟 1 - 2 min再将数据上报服务端,导致这部分数据也无法在年轻代被回收。 当然这还不是问题的全部,FGC还有个致命问题就是stop the world,这会导致业务长时间无法响应,造成经济损失。反过来,就算FGC频繁,stop the world 只有1ms,也是不会对业务造成影响的,因此不能单单以FGC的频率来判断jvm服务的gc性能的好坏。经过上面的探讨,我们在实践中得到了如下的解决方案: 不常变化的缓存(小时级别)移到堆外,以此减少老年代叠满的基础阈值。 变化不那么频繁的缓存(分钟级别)更新的时候进行值对比,如果值一样则不更新,以此减少老年代的堆积。 使用G1回收器:-XX:+UseG1GC-XX:MaxGCPauseMillis=200-XX:InitiatingHeapOccupancyPercent=25-XX:MaxNewSize=3072M -Xms4608M -Xmx4608M -XX:MetaspaceSize=512M-XX:MaxMetaspaceSize=512M 其效果如上所示,调整后各项指标都有很大的进步:由于年轻代中的复制算法使其垃圾清理速度较快,所以调大其容量使对象尽量在其中回收,同时设置每次清理的时间,使得mix gc控制在200ms以内。 3.4 限流降级与兜底策略 为了保证业务的可用性,大部分业务都会引入hystrix, sentinel, resilience4j 这类熔断限流组件, 但这些组件也不能解决全部的问题。 对于游戏推荐来说,一台节点往往承载着不同的业务推荐,有些业务十分核心,有些不是那么重要,限流降级的时候不是简单的哪个服务限流多少问题,而是在权衡利弊的情况下,将有限的资源向哪些业务倾斜的问题,对此我们在分层限流上下足了功夫。 同时对于个性化业务来说,仅仅返回通用的兜底会使推荐同质化,因此我们的策略是将用户的历史数据存储下来,并在下次兜底的时候作为推荐列表进行返回。 四、精细化运营模式的探索 在经历过了0 到1 的开疆拓土 与 1 到 2 的高速增长后,游戏的推荐架构已经趋于稳定。这时候我们更加关注效能的提高与成本的下降,因此我们开始着手于系统运营的精细化设计,这对推荐系统的良性发展是意义重大的。 精细化运营不仅能提高尾量游戏的收入,提高运营人员的工作效率,还能实时快速反馈算法在线效果并立马做出调整,做到一个业务上的闭环。首先就不得不提到游戏推荐系统的分层正交实验平台,这是我们做精细化运营的基础。 4.1 多层 hash 正交实验平台 游戏推荐的关键就一个"准"字,这就需要通过精细化策略迭代来提升效率和准确度,从而不断扩大规模优势,实现正向循环。然而策略的改变并不是通过“头脑风暴”空想的,而是一种建立在数据反馈上的机制,以带来预期内的正向变化。这就需要我们分隔对照组来做A/Btest。 一般线上业务常见的A/B test是通过物理方式对流量进行隔离,这种方法常见于H5页面的分流实验,但面对复杂业务时却存在着部署较慢,埋点解析困难等问题,其典型的架构方式如下: 对于游戏推荐来说,其完成一次推荐请求的流程比较复杂,涉及到多组策略,为了保证线上流量的效率与互斥,就不能采用简单的物理分配流量的方式。 因此在业务层我们建立了一套多层hash正交实验规则来满足我们A/B test的要求。 其流量走势如下图所示, 与物理隔离流量,部署多套环境的方式不同,分层模型在分流算法中引入层级编号因子(A)来解决流量饥饿和流量正交问题。每一实验层可以划分为多个实验田,当流量经过每一层实验时,会先经过Function(Hash(A)) 来计算其分配的实验田,这样就能保证层与层之间的流量随机且相互独立。 以上就是推荐业务和一般业务实验流量隔离的不同之处,在实验设计上我们又将一个完整的实验周期分为以下几个阶段。在预备阶段需要跟根据业务指标的需求,提出实验假设,划分好基线和实验田的流量比例,并上线配置(放量)。 在实验阶段,线上流量进入后,服务会根据流量号段的匹配响应的策略进行执行,并将实验数据上报。放量一段时候后,我们会根据上报的埋点数据进行数据分析,以确定此次策略的好坏。 和实验阶段划分相对应地,我们将实验平台划分为实验配置,埋点上报和实验结果分析三个模块,在实验配置模块,我们根据实验需求来完成分流配置和业务场景的映射关系。 并在hash实验管理中将业务层级划分,以便流量的流通。 在埋点上报模块中,我们通过sdk的方式植入业务代码中,当流量进入该实验田时就会进行分析和埋点上报,我们将上报的埋点分为游戏和请求维度,节省上报流量的同时以满足不同的分析需求: 游戏维度: { "code": 0, "data": [ { "score": 0.016114970572330977, "data": { "gameId": 53154, "appId": 1364982, "recommendReason": null, }, "gameps": "埋点信息", } ], "reqId": "20200810174423TBSIowaU52fjwjjz" } 请求维度: { "reqId":"20200810142134No5UkCibMdAvopoh", "scene": "appstore.idx", "imei": "869868031396914", "experimentInfo": [ { "experimentId": "RECOMMENDATION_SCENE", "salt":"RECOMMENDATION_SCENE", "imei": "3995823625", "sinfo": "策略信息" }, { "experimentId": "AUTO_RECOMMENDATION_REASON", "salt":"RECOMMENDATION_SCENE", "imei": "1140225751", "sid": "3,4,5" } ] } 在实验结果分析模块中,我们将采集的埋点的数据上报只大数据侧,并由其进行分析计算,其结果指导这我们对实验策略进行进一步的分析迭代。对于游戏请求的上报格式,我们可以直接通过appId和gameps的信息直接分析得出该类游戏的推荐结果和用户行为的关系。同时加入请求维度的分析(包含策略信息),可以直接分析出决策对各项指标的影响。 4.2 召回优化之多路召回 召回在游戏推荐业务中就是利用一定的规则去圈选一批游戏,这是为了将海量的候选集快速缩小为几百到几千的规模。而召回之后的排序则是对缩小后的候选集进行精准排序,最终达到精准推荐的目的。 然而这种单路的召回在业务上却有着很大的缺陷: 通常为了保证计算效率,圈选的数量在几百个左右,由于数量限制其无法完全覆盖完整的目标用户候选集。 随着业务的复杂度变高,召回策略的种类也开始膨胀,其召回规则是剥离的无法统一,这也意味着在某些业务场景下,在种类上无法覆盖完全。 因此,权衡了计算效率和业务覆盖度(召回率)的问题,我们逐步上线了多路召回功能。 在业务实现上,多路召回兼容了原有的个性化召回、算法召回、游戏池召回、分类/标签/专题/同开发者)召回等召回路径,通过圈选多个游戏池做为召回策略,经过合并、过滤、补量、截断等策略最终筛选出一批进行算法预估打分的游戏。 本质上,多路召回利用各简单策略保证候选集的快速召回,从不同角度设计的策略保证召回率接近理想状态。 4.3 曝光干预之动态调参 一个推荐系统的效能如何,除了运营策略之外很大程度上取决于推荐算法的结果,而推荐算法的结果又是以曝光量,下载量,ctr等作为评价指标的。所以在游戏推荐业务的生命周期中,推荐算法一直致力于优化这些指标。 但是在开发中有个实际问题就是,从算法结果的数据反馈,到代码改进上线这个时间周期较长,对一些需要快速响应的业务场景来说是不符合要求的。因此我们需要一套规则来对线上的算法结果做动态调整,以满足业务的要求,这就是动态调参。 目前游戏业务的营收中,曝光量是个极其重要的指标,而大盘在一段时间内的曝光量是确定的,太多或太少都会严重影响业务,由此推荐算法就会根据线上实时反馈的一些数据对游戏的曝光进行调整。 经过设计, 我们先将调参游戏划分为多个等级,并将游戏的生命周期划分为几个时间段,同时在每个时间段内以游戏曝光量,评级,数量等因素作为计算因子来计算曝光的分配权重。 接着系统根据实时采集的游戏曝光信息及所计算的游戏目标曝光对实际曝光进行调整,最终实现游戏曝光的动态调控。 对于正向调控来说,动态调参就是最有效的扶持机制,增加了游戏曝光的同时提升了导流能力。对于负向调控,动态调参能对品质和要求不达标的游戏,通过减少曝光的方式进行打压,提升用户体验。 五、展望之智能化建设 经过多年的探索实践,游戏推荐系统成就了一套完整的推荐体系。 在架构上的演进使得我们能更好地应对复杂多变的业务需求,在精细化运营上的探索与建设令我们能更加敏锐地把握住市场的变化以做出响应,这些建设也很好地反馈的反馈到了业务结果中,提升了众多效能和收益指标,得到了业务方的一致好评。 但当分发效率和收入效益问题解决了之后,我们在思考自己还能做什么,原先游戏推荐做的比较多的是接入服务,在单链路上去做闭环提高效益,但这是远远不够的。 在未来我们会考虑如何打造覆盖搜广推+ 智能运营的全栈业务支撑系统(智能礼券,智能push,用户反馈智能处理系统),以提升平台和渠道的价值。

优秀的个人博客,低调大师

解密 云HBase 冷热分离技术原理

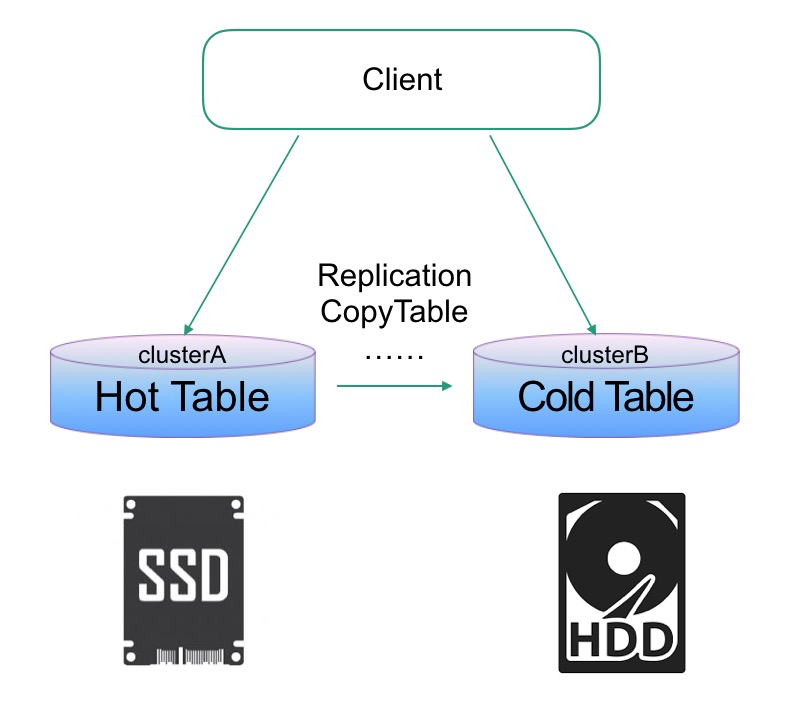
前言 HBase是当下流行的一款海量数据存储的分布式数据库。往往海量数据存储会涉及到一个成本问题,如何降低成本。常见的方案就是通过冷热分离来治理数据。冷数据可以用更高的压缩比算法(ZSTD),更低副本数算法(Erasure Coding),更便宜存储设备(HDD,高密集型存储机型)。 HBase冷热分离常见解决方案 1.主备集群 备(冷)集群用更廉价的硬件,主集群设置TTL,这样当数据热度退去,冷数据自然只在冷集群有。 优点:方案简单,现成内核版本都能搞缺点:维护开销大,冷集群CPU存在浪费 1.x版本的HBase在不改内核情况下,基本只能有这种方案。 2.HDFS Archival Storage + HBase CF-level Storage Policy 需要在2.x之后的版本才能使用。结合HDFS分层存储能力 + 在Table层面指定数据存储策略,实现同集群下,不同表数据的冷热分离。 优点:同一集群冷热分离,维护开销少,更灵活的配置不同业务表的策略缺点:磁盘配比是个很大的问题,不同业务冷热配比是不一样的,比较难整合在一起,一旦业务变动,集群硬件配置是没法跟着变的。 云HBase冷热分离解决方案 上述2套方案都不是最好的方案,对于云上来说。第一套方案就不说了,客户搞2个集群,对于数据量不大的客户其实根本降不了成本。第二套方案,云上客户千千万,业务各有各样,磁盘配置是很难定制到合适的状态。 云上要做 cloud native 的方案,必须满足同集群下,极致的弹性伸缩,才能真正意义上做到产品化。云上低成本,弹性存储,只有OSS了。所以很自然的想到如下架构: 实现这样的架构,最直接的想法是直接改HBase内核:1)增加冷表数据标记 2)根据标记增加写OSS的IO路径。 这样做的缺陷非常明显,你的外部系统(如:备份恢复,数据导入导出)很难兼容这些改动,他们需要感知哪些是冷文件得去OSS哪个位置读,哪些是热文件得去部署在云盘上的HDFS上读。这些本质上都是一些重复的工作,所以从架构设计角度来看必须抽象出一层。这一层能读写HDFS文件,读写OSS文件,感知冷热文件。这一层也就是我最后设计出的ApsaraDB FileSystem,实现了Hadoop FileSystem API。对于HBase,备份恢复,数据导入导出等系统只要替换原先FileSystem的实现即可获得冷热分离的功能。 下面将详细阐述,这套FileSystem设计的细节与难点。 ApsaraDB FileSystem 设计 核心难点A 1.OSS并非文件系统 OSS并不是一个真正意义上的文件系统,它仅仅是两级映射 bucket/object,所以它是对象存储。你在OSS上看到类似这样一个文件:/root/user/gzh/file。你会以为有3层目录+1个文件。实际上只有一个对象,这个对象的key包含了/字符罢了。 这么带来的一个问题是,你要想在其上模拟出文件系统,你必须先能创建目录。很自然想到的是用/结尾的特殊对象代表目录对象。Hadoop社区开源的OssFileSystem就是这么搞的。有了这个方法,就能判断到底存不存在某个目录,能不能创建文件,不然会凭空创建出一个文件,而这个文件没有父目录。 当然你这么做依然会有问题。除了开销比较大(创建深层目录多次HTTP请求OSS),最严重的是正确性的问题。试想一下下面这个场景:把目录/root/user/source rename 成 /root/user/target。这个过程除了该目录,它底下的子目录,子目录里的子文件都会跟着变。类似这样:/root/user/source/file => /root/user/target/file。这很好理解,文件系统就是一颗树,你rename目录,实际是把某颗子树移动到另一个节点下。这个在NameNode里的实现也很简单,改变下树结构即可。 但是如果是在OSS上,你要做rename,那你不得不递归遍历/root/user/source把其下所有目录对象,文件对象都rename。因为你没法通过移动子树这样一个简单操作一步到位。这里带来的问题就是,假设你递归遍历到一半,挂了。那么就可能会出现一半目录或文件到了目标位置,一半没过去。这样rename这个操作就不是原子的了,本来你要么rename成功,整个目录下的内容到新的地方,要么没成功就在原地。所以正确性会存在问题,像HBase这样依赖rename操作将临时数据目录移动到正式目录来做数据commit,就会面临风险。 2.OSS rename实则是数据拷贝 前面我们提到了rename,在正常文件系统中应该是一个轻量级的,数据结构修改操作。但是OSS并没有rename这个操作实际上,rename得通过 CopyObject + DeleteObject 两个操作完成。首先是copy成目标名字,然后delete掉原先的Object。这里有2个明显的问题,一个是copy是深度拷贝开销很大,直接会影响HBase的性能。另一个是rename拆分成2个操作,这2个操作是没法在一个事物里的,也就是说:可能存在copy成功,没delete掉的情况,此时你需要回滚,你需要delete掉copy出来的对象,但是delete依然可能不成功。所以rename操作本身实现上,正确性就难以保证了。 解决核心难点A 解决上面2个问题,需要自己做元数据管理,即相当于自己维护一个文件系统树,OSS上只放数据文件。而因为我们环境中仍然有HDFS存储在(为了放热数据),所以直接复用NameNode代码,让NodeNode帮助管理元数据。所以整体架构就出来了: ApsaraDB FileSystem(以下简称ADB FS)将云端存储分为:主存(PrimaryStorageFileSystem)和 冷存(ColdStorageFileSystem)。由ApsaraDistributedFileSystem类(以下简称ADFS)负责管理这两类存储文件系统,并且由ADFS负责感知冷热文件。 ApsaraDistributedFileSystem: 总入口,负责管理冷存和主存,数据该从哪里读,该写入哪里(ADFS)。主存:PrimaryStorageFileSystem 默认实现是 DistributedFileSystem(HDFS)冷存:ColdStorageFileSystem 默认实现是 HBaseOssFileSystem(HOFS) ,基于OSS实现的Hadoop API文件系统,可以模拟目录对象单独使用,也可以只作为冷存读写数据,相比社区版本有针对性优化,后面会讲。 具体,NameNode如何帮助管理冷存上的元数据,很简单。ADFS在主存上创建同名索引文件,文件内容是索引指向冷存中对应的文件。实际数据在冷存中,所以冷存中的文件有没有目录结构无所谓,只有一级文件就行。我们再看下一rename操作过程,就明白了: rename目录的场景也同理,直接在NameNode中rename就行。对于热文件,相当于全部代理HDFS操作即可,冷文件要在HDFS上创建索引文件,然后写数据文件到OSS,然后关联起来。 核心难点B 引入元数据管理解决方案,又会遇到新的问题:是索引文件和冷存中数据文件一致性问题。我们可能会遇到如下场景: 主存索引文件存在,冷存数据文件不存在 冷存数据文件存在,主存索引文件不存住 主存索引文件信息不完整,无法定位冷存数据文件 先排除BUG或者人为删除数据文件因素,上诉3种情况都会由于程序crash产生。也就是说我们要想把法,把生成索引文件,写入并生成冷数据文件,关联,这3个操作放在一个事物里。这样才能具备原子性,才能保证要么创建冷文件成功,那么索引信息是完整的,也指向一个存在的数据文件。要么创建冷文件失败(包括中途程序crash),永远也见不到这个冷文件。 解决核心难点B 核心思想是利用主存的rename操作,因为主存的rename是具备原子性的。我们先在主存的临时目录中生产索引文件,此时索引文件内容已经指向冷存中的一个路径(但是实际上这个路径的数据文件还没开始写入)。在冷存完成写入,正确close后,那么此时我们已经有完整且正确的索引文件&数据文件。然后通过rename一把将索引文件改到用户实际需要写入到目标路径,即可。 如果中途进程crash,索引文件要么已经rename成功,要么索引文件还在临时目录。在临时目录我们认为写入没有完成,是失败的。然后我们通过清理线程,定期清理掉N天以前临时目录的文件即可。所以一旦rename成功,那目标路径上的索引文件一定是完整的,一定会指向一个写好的数据文件。 为什么我们需要先写好路径信息在索引文件里?因为如果先写数据文件,在这个过程中crash了,那我们是没有索引信息指向这个数据文件的,从而造成类似“内存泄漏”的问题。 冷热文件标记 对于主存,需要实现给文件冷热标记的功能,通过标记判断要打开怎样的数据读写流。这点NameNode可以通过给文件设置StoragePolicy实现。这个过程就很简单了,不详细赘述,下面说HBaseOssFileSystem写入优化设计。 HBaseOssFileSystem 写入优化 在说HOFS写设计之前,我们先要理解Hadoop社区版本的OssFileSystem设计(这也是社区用户能直接使用的版本)。 社区版本写入设计 Write -> OutputStream -> disk buffer(128M) -> FileInputStream -> OSS 这个过程就是先写入磁盘,磁盘满128M后,将这128M的block包装成FileInputStream再提交给OSS。这个设计主要是考虑了OSS请求成本,OSS每次请求都是要收费的,但是内网流量不计费。如果你1KB写一次,费用就很高了,所以必须大块写。而且OSS大文件写入,设计最多让你提交10000个block(OSS中叫MultipartUpload),如果block太小,那么你能支持的最大文件大小也是受限。 所以要攒大buffer,另外一个因素是Hadoop FS API提供的是OutputStream让你不断write。OSS提供的是InputStream,让你提供你要写入内容,它自己不断读取。这样你必然要通过一个buffer去转换。 这里会有比较大的一个问题,就是性能慢。写入磁盘,再读取磁盘,多了这么两轮会比较慢,虽然有PageCache存在,读取过程不一定有IO。那你肯定想,用内存当buffer不就好了。内存当buffer的问题就是前面说的,有费用,所以buffer不能太小。所以你每个文件要开128M内存,是不可能的。更何况当你提交给OSS的时候,你要保证能继续写入新数据,你得有2块128M内存滚动,这个开销几乎不能接受。 HBaseOssFileSystem 写入设计 我们既要解决费用问题,也要解决性能问题,同时要保证开销很低,看似不可能,那么怎么做呢? 这里要利用的就是这个InputStream,OSS让你提供InputStream,并从中读取你要写入的内容。那么我们可以设计一个流式写入,当我传入这个InputStream给OSS的时候,流中并不一定得有数据。此时OSS调read读取数据会block在read调用上。等用户真的写入数据,InputStream中才会有数据,这时候OSS就能顺利读到数据。当OSS读了超过128M数据时候,InputStream会自动截断,返回EOF,这样OSS会以为流已经结束了,那么这块数据就算提交完成。 所以我们本质只要开发这么一个特殊的InputStream即可。用户向Hadoop API提供的OutputStream中写入数据,数据每填满一个page(2M)就发给InputStream让其可读取。OuputStream相当于生产者,InputStream相当于消费者。这里的内存开销会非常低,因为生产者速度和消费者速度相近时,也就2个page的开销。最后将这整套实现封装成OSSOutputStream类,当用户要写入冷文件时,实际提供的是OSSOutputStream,这里面就包含了这个特殊InputStream的控制过程。 当然实际生产中,我们会对page进行控制,每个文件设置最多4个page。并且这4个page循环利用,减少对GC对影响。所以最后我们得到下面一个环形缓冲的写入模式: 性能对比1:社区版本 vs 云HBase版 因为不用写磁盘,所以写入吞吐可以比社区的高很多,下图为HBase1.0上测试结果。在一些大KV,写入压力更大的场景,实测可以接近1倍。这个比较是通过替换ADFS冷存的实现(用社区版本和云HBase版本),都避免了rename深拷贝问题。如果直接裸用社区版本而不用ADFS那性能会差数倍。 性能对比2:热表 vs 冷表 热表数据在云盘,冷表数据在OSS。 得益于上述优化,加上冷表WAL也是放HDFS的,并且OSS相对HBase来说是大集群(吞吐上限高),冷表的HDFS只用抗WAL写入压力。所以冷表吞吐反而会比热表略高一点点。 不管怎么说,冷表的写入性能和热表相当了,这样的表现已经相当不错了。基本是不会影响用户灌数据,否则使用冷存后,吞吐掉很多,那意味着要更多机器,那这功能就没什么意义了。 总结 这大约是1年多前落地的项目,已经稳定运行很久。之前也有出去分享过,但是没有今天这么细致。现在写出来主要是自我总结下。当设计一个服务去解决某个问题的时候,上下游的关系,可能存在的问题得考虑清楚。在做这个项目最初的时候,想把HBase直接架设在社区版本OssFileSytem上,发现性能不行外,正确性也存在很大风险。不断思考,考虑各种情况后才有了今天这套方案。

优秀的个人博客,低调大师

深度解密Python工厂类相关模式

认识工厂类相关模式认识工厂类相关模式 1 工厂类相关模式含义工厂方法模式(英语:Factory method pattern)是一种实现了“工厂”概念的面向对象设计模式。就像其他创建型模式一样,它也是处理在不指定对象具体类型的情况下创建对象的问题。工厂方法模式的实质是“定义一个创建对象的接口,但让实现这个接口的类来决定实例化哪个类。工厂方法让类的实例化推迟到子类中进行。”[1]创建一个对象常常需要复杂的过程,所以不适合包含在一个复合对象中。创建对象可能会导致大量的重复代码,可能会需要复合对象访问不到的信息,也可能提供不了足够级别的抽象,还可能并不是复合对象概念的一部分。工厂方法模式通过定义一个单独的创建对象的方法来解决这些问题。由子类实现这个方法来创建具体类型的对象。对象创建中的有些过程包括决定创建哪个对象、管理对象的生命周期,以及管理特定对象的创建和销毁的概念。2 工厂类相关模式优点工厂模式、抽象工厂模式的优点:1、工厂模式巨有非常好的封装性,代码结构清晰;在抽象工厂模式中,其结构还可以随着需要进行更深或者更浅的抽象层级调整,非常灵活;2、屏蔽产品类,使产品的被使用业务场景和产品的功能细节可以分而开发进行,是比较典型的解耦框架。3 工厂类相关模式缺点工厂模式、抽象工厂模式的缺点:1、工厂模式相对于直接生成实例过程要复杂一些,所以,在小项目中,可以不使用工厂模式;2、抽象工厂模式中,产品类的扩展比较麻烦。毕竟,每一个工厂对应每一类产品,产品扩展,就意味着相应的抽象工厂也要扩展。4 工厂类相关模式应用工厂模式、抽象工厂模式的使用场景:1、当系统实例要求比较灵活和可扩展时,可以考虑工厂模式或者抽象工厂模式实现。比如,在通信系统中,高层通信协议会很多样化,同时,上层协议依赖于下层协议,那么就可以对应建立对应层级的抽象工厂,根据不同的“产品需求”去生产定制的实例。 Python实现工厂类相关模式Python实现工厂类相关模式 1 实例分析Python实现工厂类相关模式2.1 实例分析工厂类相关的模式在Python里面没有特别的实现方法,我们就直接用案例来分析。 2.1.1 背景要求假设我们现在需要开发一个快餐点餐系统,想必大家一定见过类似于麦当劳自助点餐台一类的点餐系统吧。在一个大的触摸显示屏上,有三类可以选择的上餐品:汉堡等主餐、小食、饮料。当我们选择好自己需要的食物,支付完成后,订单就生成了。下面,我们用今天的主角--工厂模式--来生成这些食物的逻辑主体。 2.1.2 主餐的生成(仅以两种汉堡为例)@dataclassclass Burger: name: str = "" price: float = 0.0 def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass cheeseBurger(Burger): name = "cheese burger" price = 10.0 @dataclassclass spicyChickenBurger(Burger): name = "spicy chicken burger" price = 15.0 2.1.3 小食生成@dataclassclass Snack: name: str = "" price: float = 0.0 type: str = "SNACK" def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass chips(Snack): name = "chips" price = 6.0 @dataclassclass chickenWings(Snack): name = "chicken wings" price = 12.0 2.1.4 饮料生成@dataclassclass Beverage: name: str = "" price: float = 0.0 type: str = "BEVERAGE" def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass coke(Beverage): name = "coke" price = 4.0 @dataclassclass milk(Beverage): name = "milk" price = 5.0 2.1.5 实现工厂类以上的Burger,Snack,Beverage,都可以认为是该快餐店的产品,由于只提供了抽象方法,我们把它们叫抽象产品类,而cheese burger等6个由抽象产品类衍生出的子类,叫作具体产品类。接下来,“工厂”就要出现了。 @dataclassclass foodFactory: type: str = "" def createFood(self, foodClass) -> ClassVar: print(self.type, " factory produce a instance.") foodIns = foodClass() return foodIns @dataclassclass burgerFactory(foodFactory): type = "BURGER" @dataclassclass snackFactory(foodFactory): type = "SNACK" @dataclassclass beverageFactory(foodFactory): type = "BEVERAGE" 2.1.6 开始生产同样,foodFactory为抽象的工厂类,而burgerFactory,snackFactory,beverageFactory为具体的工厂类。在业务场景中,工厂模式是如何“生产”产品的呢? if __name__=="__main__": burger_factory=burgerFactory() snack_factorry=snackFactory() beverage_factory=beverageFactory() cheese_burger=burger_factory.createFood(cheeseBurger) print cheese_burger.getName(),cheese_burger.getPrice() chicken_wings=snack_factorry.createFood(chickenWings) print chicken_wings.getName(),chicken_wings.getPrice() coke_drink=beverage_factory.createFood(coke) print coke_drink.getName(),coke_drink.getPrice() output BURGER factory produce a instance.cheese burger 10.0SNACK factory produce a instance.chicken wings 12.0BEVERAGE factory produce a instance.coke 4.0 总结总结 总结工厂模式也分为简单工厂模式和抽象工厂模式,像下面这样 class simpleFoodFactory: @classmethod def createFood(cls,foodClass): print "Simple factory produce a instance." foodIns = foodClass() return foodIns 在场景中写成如下形式:spicy_chicken_burger=simpleFoodFactory.createFood(spicyChickenBurger)这样,省去了将工厂实例化的过程。这种模式就叫做简单工厂模式。还是在上述例子中,createFood方法中必须传入foodClass才可以指定生成的food实例种类,如果,将每一个细致的产品都建立对应的工厂(如cheeseBurger建立对应一个cheeseBurgerFactory),这样,生成食物时,foodClass也不必指定。事实上,此时,burgerFactory就是具体食物工厂的一层抽象。这种模式,就是抽象工厂模式。

优秀的个人博客,低调大师

解密分布式事务框架-Fescar

1.分布式事务 在去年的时候我写过一篇关于分布式事务的文章再有人问你分布式事务,把这篇扔给他。再这篇文章中我叫大家能不用分布式事务就别用分布式事务,因为会引入很多的复杂度。当时说这个的时候其实还有一个原因,没有大厂的成熟开源解决方案,虽然再网上有很多开源的分布式事务框架,但是都不是太成熟,没有大量的业务验证。它不像其他的分布式中间件有大量的成熟的解决方案,比如分布式消息队列中间件:Apache Kafka,Apache RocketMQ,Apache Pulsar这三个均是Apache顶级项目;又比如分布式任务调度,也有很多的开源比如XXL-JOB,Elastic-Job都是有很多的公司在使用。 而我们的分布式事务框架,却一直没有一个经过大量业务验证的框架。通过我的一些了解,其实各大公司都是有自己的分布式事务的解决方案,但很多时候都和业务上强耦合了,不适于做一些通用的框架。但是阿里在今年年初的时候给了大家一个惊喜,Fescar开源!从而让大家再以后选择分布式事务的时候多了一个选择方案,而且是经过成熟业务验证的方案。 这篇文章我会带大家认识Fescar,以及他的一些设计。后续的文章还会陆续推出Fescar的核心源码解析篇。 2.初识Fescar 说Fescar之前这里先简单的介绍一下著名的2PC:XA Transactions。 在XA协议中分为两阶段: 第一阶段:事务管理器要求每个涉及到事务的数据库预提交(precommit)此操作,并反映是否可以提交. 第二阶段:事务协调器要求每个数据库提交数据,或者回滚数据。 优点: 尽量保证了数据的强一致,实现成本较低,在各大主流数据库都有自己实现,对于MySQL是从5.5开始支持。 缺点: 单点问题:事务管理器在整个流程中扮演的角色很关键,如果其宕机,比如在第一阶段已经完成,在第二阶段正准备提交的时候事务管理器宕机,资源管理器就会一直阻塞,导致数据库无法使用。 同步阻塞:在准备就绪之后,资源管理器中的资源一直处于阻塞,直到提交完成,释放资源。 数据不一致:两阶段提交协议虽然为分布式数据强一致性所设计,但仍然存在数据不一致性的可能,比如在第二阶段中,假设协调者发出了事务commit的通知,但是因为网络问题该通知仅被一部分参与者所收到并执行了commit操作,其余的参与者则因为没有收到通知一直处于阻塞状态,这时候就产生了数据的不一致性。 只能用于单一类型数据库,跨数据库种类,其他缓存或者文件等资源不支持。 总的来说,XA协议比较简单,成本较低,但是其单点问题,以及不能支持高并发(由于同步阻塞)依然是其最大的弱点。 可以看见XA协议问题较多所以其作为分布式事务方案讨论的时候基本都会被无情的干掉,但是XA有个很好优点是对业务没有侵入(数据库层面),再业务上不需要编写额外的代码,更加关注业务。 在我的那篇文章中我又介绍了几种在应用层面上的分布式事务,但是或多或少的对业务都有一定的入侵。比如我们的TCC,常用的一些TCC框架都需要编写try,confirm,cancel等接口对于现成的业务需要进行转换。如果采用本地消息表模式那么又需要增加额外的表。如果采用事务性消息比如RocketMQ,会让一些没有使用该消息队列的业务需要更换消息队列。如果采用Saga模式,同样我们需要编写正向和反向接口。可以看见不论采用哪种分布式事务方案,都会有一定的业务改造,业务入侵成本。 而Fescar结合了XA的无侵入的优点和其他应用层事务协议高性能的优点,在应用层实现了二阶段协议的事务,同时对业务代码基本无侵入。 2.1 Fescar和XA Fescar虽然是二阶段提交协议的分布式事务,但是其解决了上面XA的一些缺点: 单点问题:虽然目前Fescar(0.4.1)还是单server的,但是Fescar官方预计将会在0.5.x中推出HA-Cluster,到时候就可以解决单点问题。 同步阻塞:Fescar的二阶段,其再第一阶段的时候本地事务就已经提交释放资源了,不会像XA会再两个prepare和commit阶段资源都锁住,并且Fescar,commit是异步操作,也是提升性能的一大关键。 数据不一致:如果出现部分commit失败,那么fescar-server会根据当前的事务模式和分支事务的返回状态的结果来进行不同的重试策略。并且fescar的本地事务会在一阶段的时候进行提交,其实单看数据库来说在commit的时候数据库已经是一致的了。 只能用于单一数据库: Fescar提供了两种模式,AT和MT。在AT模式下事务资源可以是任何支持ACID的数据库,在MT模式下事务资源没有限制,可以是缓存,可以是文件,可以是其他的等等。当然这两个模式也可以混用。 同时Fescar也保留了接近0业务入侵的优点,只需要简单的配置Fescar的数据代理和加个注解,加一个Undolog表,就可以达到我们想要的目的。 3.Fescar总体设计 Fescar的设计核心就是他的角色分类。不论是数据库上的XA还是Fescar都有两个角色TM(事务管理器)和RM(资源管理器),同时Fescar还有一个TC(事务协调器)。我们先来看看如果没有TC,只有TM和RM会发生什么呢?这里我举个简单的例子,小明去网站上面购买了一个商品,如下图所示: 这里小明其实就是TM(事务管理器),而商品和账户其实就是我们的RM(资源管理器),正常情况下可能没问什么问题,账户和库存都能扣减成功。如果小明再扣减库存的时候成功但是在扣减账户的时候失败,这个时候就需要对我们的库存资源进行回滚。小明这个时候就会通知库存把上个阶段扣减的货物补回来。但是回滚库存的时候库存服务不稳定,这次回滚就失败了。一般来说小明会不断的去重试,直到成功。这样就有个问题小明就一直被阻塞,不能做任何事。这个也可以看做二阶段commit/rollback的时候一直会阻塞TM,网易DDB的XA协议针对这种情况会做一个异步线程的操作。但是在Fescar中一切都是由TC去做的,当然TC其实不仅仅会做二阶段失败的重试,他会做二阶段的所有RM的commit和rollback,让我们的TM做更少的事。 再Fescar中TM,RM,TC的关系如下面官方提供的图: TM:事务的发起者。用来告诉TC,全局事务的开始,提交,回滚。 RM:具体的事务资源,每一个RM都会作为一个分支事务注册在TC。 TC:事务的协调者。也可以看做是Fescar-servr,用于接收我们的事务的注册,提交和回滚。 这三个角色的分工明确,正是我们Fescar真正的核心所在,下面我会通过如何使用Fescar带大家更加深刻的理解这三个角色。 4.快速开始Fescar 在Fescar的github上已经提供了一个简单的例子https://github.com/fescar-group/fescar-samples,这里我们需要将这个例子下载下来。 4.1搭建TC Fescar-server 首先我们搭建事务协调器,也可以叫做搭建Fescar-Server.官网的例子是使用Nacos加上fescar-server已经打好的Jar包运行的。这里为了方便我们直接下载fescar的代码https://github.com/alibaba/fescar。 找到我们的Server: 直接运行main方法,该方法会帮助我们在本地启动一个端口号为8091的fescar-server服务。如果我们想要进行服务注册,我们可以修改registry.conf下面的type 可以看见在0.4.1版本的时候支持四种服务注册,nacos,eureka,redis,zk。目前使用redis进行服务注册是有问题的,我也提了一个PR给官方进行修正。当然为了方便其实选择file,后续我们直连是最为便捷的。 再运行main方法之后,如果出现Server started日志,就代表我们的TC(事务协调器)成功启动。 4.2 认识TM 上面事务协调器已经搭建完成,我们接下来需要做的就是将TM和RM运行起来,将对应的操作交给我们的事务协调器去做。这个时候我们需要打开fescar-samples这个项目:由于这个项目使用的RPC是Dubbo,他默认配的服务注册中心是Nacos,需要我们再本地安装一个Nacos,具体安装可以自行搜索,这里不展开讲了。 这里官方例子中,业务关系如下图: 可以看见Business也就是我们的TM,找到对应的代码: 从代码中我们知道启动一个分布式事务是需要添加@GlobalTransactional注解的,当然Fescar也提供了API的方式让我们达到同样的效果。我们同时也需要修改registry.conf中的Type为file。 如果不是在例子中,而是在我们真正的业务上完全不需要修改业务代码,直接在我们分布式事务发起方添加上这个注解即可。 这个GloablTranscational注解到底做了什么呢?其实加了这个注解的都会走一个叫GlobalTransactionalInterceptor的切面,再这个切面中又会进入TrascationTemplate这个类中的excute方法,这个也是TM的核心方法: 上面的代码有部分删减,只选取了核心的流程。TrascationTemplate其实也是Fescar提供给我们的API,如果不使用注解那么我们也可以模仿他的方式去做。可以看见主要分为五步: 获取当前上下文中是否已经有事务,这一步是通过ThreadLocal去实现的,如果有则获取当前的,如果没有则获取默认的。 开启事务,这一步是向TC(事务协调器)发出一个请求,注册一个GloabTranscation,这里的timeout是指超过这段时间没有rollback或者commit,TC会帮助我们做rollback。 做业务。 如果该方法抛出了异常,则回滚。这里要注意的时候抛出异常,很多时候我们会把异常给捕获,导致我们这里根本没有异常抛出,所以就不会出现回滚。这里的回滚也是向TC发起一个回滚请求,由他帮助我们对RM进行回滚。 如果没有异常则向TC发起commit,TC会帮助我们向RM异步发起提交请求。 TM的核心过程主要是这5步,其他详细的讲解会在后续的代码中体现。 4.3 认识RM 当我们上面的Business发起业务请求之后,就来到了我们RM的流程,我们的Storage和Order服务是怎么知道现在已经是处于分布式事务当中了呢?这个就需要借助RPC框架来完成了,这里我们使用的是Dubbo,fescar为dubbo提供了一个filter,如下图所示: 这里会从rpcContext中获取我们的xid,也就是我们的分布式事务ID,如果有的话就证明本次请求处于分布式事务中,那么就会把XID种入我们的RootContext(fescar的本地上下文)。如果你不是Dubbo,那么也可以根据此方法适配你的RPC。 在RM中我们应该做什么呢?只需要做下面两步: 将数据源换成Fescar代理 在当前数据库中添加一个Undolog的表,用于记录日志回滚。 再Fescar中不仅仅是对dataSource进行代理,也会对connection和statement进行代理,如下图: 大家都知道我们的SQL的具体执行需要依赖Statement,在Fescar的StatementProxy中有如下代码: 可以看见运行的方法是ExecuteTemplate.execute,在execute方法中会根据我们执行语句的类型记录我们的Undolog,具体的执行流程参考下面官方的一张图片: 总的来说我们的RM核心流程主要有两个:一个是如何识别分布式事务,另外一个是通过我们数据源代理让我们原本简单的执行SQL流程做了更多的事。 5.总结 写这篇文章的目的,不仅仅是让大家知道Fescar,也是让更多的人知道一个优秀分布式事务框架到底应该怎样去做。目前Fescar的版本号是0.4.1,还有很多功能比如HA-Cluster,SpringCloud集成还没有发布。所以目前再线上使用的话可能会遇到Fescar单点的问题,所以目前还不是太推荐线上使用。Fescar的目前规划会在0.5.x版本推出HA-Cluster,到时候其单点问题就会被解决。 这篇文章的原理目前介绍的比较粗浅,后面会陆续推出三篇文章详细介绍分析:TC,TM,RM,敬请期待。 最后这篇文章被我收录于JGrowing-Java分布式事务篇,一个全面,优秀,由社区一起共建的Java学习路线,如果您想参与开源项目的维护,可以一起共建,github地址为:https://github.com/javagrowing/JGrowing 麻烦给个小星星哟。 如果大家觉得这篇文章对你有帮助,你的关注和转发是对我最大的支持,O(∩_∩)O: 参考文章 阿里开源分布式事务解决方案Fescar: https://mp.weixin.qq.com/s/TFGRcHV6EgeLB45OEJPRXw


优秀的个人博客,低调大师

VMworld 2012动手实验室解密

VMworld 2012已经于2012年8月30日在旧金山的Moscone中心降下帷幕,今年的亮点之一动手实验室(HOL- Hands On Lab)仍然让我们回味无穷,并且HOL会继续为参会者通过在线模式开放到今年的第四季度,为大家深入了解VMware在VMworld上发布的产品和技术提供了一个很好的云实验室。 很多人对HOL充满了好奇,本文为大家打开一扇窗,帮助您更深入了解VMworld HOL。为此,首先对比一下过去四届VMworld上HOL的演化,从私有云开始,到混合云模式,到去年和今年纯公有云模式来实现,实际上类似很多企业数据中心要走的运之旅。 图1:VMworld过去四年HOL的演化 接下去,咱们首先看一下今年VMworld HOL的整体架构,见图2。通过图2,我们可以看到今年HOL的两国四地的公有云实现的架构,确保了整体VMworld HOL的扩展性、可靠性和弹性等需求。 图2:VMworld 2012 HOL的整体架构 看完整体架构,我们可以进一步拆解到软硬件的配置情况。请看下面具体的软硬件配置情况,为我们进一步了解细节情况一个概况。 从数字看硬件配置 •服务器数量: 416台 3,840个CPU核心 39.936 TB内存 •网络: 10 Gig聚合网络 •存储: 1 PB的可用存储 软件上的扩展能力 •vCloud Director: 4个实例 (每个数据中心一个 + 管理) 每个实例3个单元 •vCenter Servers (VCVA): 24个实例 14个实例在LAS,管理着 248台ESX服务器 MIA和AMS各有5个实例,各管理56台ESX服务器 基于上面的软硬件配置,VMworld 2012 HOL还是完全基于VMware的产品堆栈来实现所有需求的,图3详细的记录了这些内容。 图3:VMworld 2012 HOL上VMware产品堆栈 到这里,我们从架构到软硬件配置,再到VMware产品堆栈,我们已经大体了解了VMworld 2012 HOL的概况。如此庞大的在线实验室,是如何管理的呢?实际上图3已经列出了主要的管理组件vCoud Director和vCenter Operations。图4和图5展示了通过vCD和vCOps管理的两张界面图,可以让我们更好了解HOL。 图4:VMworld 2012 HOL通过vCD实现管理 图5:VMworld 2012 HOL通过vCenter Operations实现监控 当然,构建庞大的在线实验室,没有一个强大的队伍是根本难以实现的,VMworld 2012 HOL也不例外。这只团队包括了各方面的人才,包括:设计、部署、运维、现场支持、协调等,确保了本次实验室的顺利进行。 图6:VMworld 2012 HOL背后的坚强团队 另外,虽然VMworld 2012美国站已经落幕,但是今年的在线实验室还会继续为与会者开放到第四季度,图7 为大家提供了界面一撇。当然,即使您没能参加今年的VMworld也不必后悔, www.vmworld.com上提供了很多公开信息为您服务。当然,今年VMware中国也会在11月15日到16日在北京召开中国的用户大会vForum,千万别再次错过幺。 2012年11月15日-16日,北京欢迎您,VMware欢迎您,云计算欢迎您! 本文转自张振伦 51CTO博客,原文链接:http://blog.51cto.com/virtualman/988806,如需转载请自行联系原作者

优秀的个人博客,低调大师

深度解密:人机大战——网红脸识别

雷锋网按:本文作者为Slyvia,ARC增强现实(微信ID:arinchina)文章详细的分析了1)机器和人类在人脸识别方面的不同点;2)人机大战结果的原因分析。 继「围棋」人机大战——以李世石为代表的人类,输给了阿尔法狗代表的计算机后,人类又发起了「人脸识别」之人机大战。这一次是诞生于杭州的人脸识别机器人蚂可,对战「鬼才之眼」王昱珩。 王昱珩是谁? 15 年「最强大脑」中,在同质同量同源的 520 杯水中,他成功指出评审选中的那杯,并精准说出水杯旋转了 15 度,中间经人手,从此,「水哥」一战成名。 这次,对上「万变不离其宗」的网红脸,人类可以一雪前耻么? 结果揭露前,先了解计算机「看人」的套路。 人眼和计算机,都喜欢瞄「点」。只不过,人眼在辨别物体时,往往通过不同点来判断。而计算机则相反,它找的是相同点。 通过摄像头「观察」目标,计算机将拍

优秀的个人博客,低调大师

解密Java中的类型转换问题

众所周知Java中的数据类型是强数据类型,基本数据类型之间的转换尤其固定的规则,当数据宽度比较窄的数据类型(如int)转换成数据类型比较宽的数据类型时(如double),则窄的数据类型会加宽,可以完成自动类型转换,这称为隐式转换。 如:以下代码没有任何问题,结果也是正确的,成绩不会发生变化,所不同的是成绩的精度提高了。 intintScore=96; doubledoubleScore=intScore; 那么如果试图把宽的数据类型(如double)转换成窄的数据类型(如float)时,编译器会提示编译错误,想要编译通过,需要进行强制类型转换。那么,此时的数据会发生截断。产生的结果是: 1. 数据正确,只是精度降低了; 2.数据不正确,发生了溢出; 对于上述第1种情况,比较好理解,我们来看个例子: floatfloatWeight=63.5;//编译错误 doubledoubleWeight=63.5; 上述第一条语句会提示编译错误,那是因为编译器看到63.5时,会把它当做一个double类型,把一个double类型赋给float类型,当然编译不通过了。推荐的解决方案是: floatfloatWeight=63.5f; 当然,你也可以强制转换成float类型: floatfloatWeight=(float)63.5; 其实,上述语句本质是把double类型的数据强制转换成float类型,发生了截断。虽然数据的大小没有变化,但是数据的精度却降低了。 同理: doubleWeight=floatWeight;//隐式转换 floatWeight=(float)doubleWeight;//强制转换 现在,问题来了,既然是截断,怎么会产生溢出呢?我们先来看个例子: shorti=150; shortj=75; byteb=(byte)i; byted=(byte)j; System.out.println("b="+b); System.out.println("d="+d); 以上代码的输出结果是: b = -106 d = 75 看到结果,不免会问为什么b=-106呢?这是因为强制转换时发生溢出。由于150超出了byte能够表示的最大范围(-128 ~ 127)。 那么-106又是如何得来的呢? i = 150,用二进制表示i = 0000 0000 1001 0110,short类型占2个字节,16位,最高位的0表示正数。当把i强制转换成byte类型时,高位发生截断,i = 1001 0110。在计算机中,用补码表示,最高位的1表示负数,那么用原码表示的话:i = 1110 1010,正好表示十进制数-106。 至此,也就解释了为什么截断也可能会发生溢出。

优秀的个人博客,低调大师

技术架构解密

## **背景** 最近OpenClaw持续火爆,在各类渠道几乎都会看到它的身影。同时,无论懂或不懂的人也都在讨论、尝试和分享。 不少朋友也在咨询OpenClaw怎么样,能不能做到XX?在公司,同事之间也在讨论这一火爆现象背后的原因以及OpenClaw能够应用在哪些场景。 这篇文章,就从实现架构、工程以及产品角度来聊聊OpenClaw的。OpenClaw没有网络上吹嘘的那么强大,同时它所带来的里程碑性的意义也不容忽视。 ## **关于OpenClaw的基础认知** 在聊OpenClaw的架构之前,先说几条关于OpenClaw的一些基础认知。 在OpenClaw火爆之前,大多数公司所使用大模型,基本上都用在了具有特定SOP(Standard Operating Procedure,标准作业程序)的业务场景下,无论是聊天场景,还是业务的某一个环节,基本上都是如此。 在特定的SOP场景下,基于Agent的实现,为了保证高效、准确性以及鲁棒性等要求,通常采用的技术方案又是基于Workflow来实现。 在这一阶段,老板要求的是100%的确定性,但Agent的执行底层逻辑又是基于概率。所以,在现实中,无论在技术上对外吹嘘多么牛的Agent编排和方案,一旦涉及到具体的产品设计以及满足老板们的需求时,基本都歇菜了。最终的技术实现,往往都采用了Workflow的方案。 虽然这两年模型的能力以及Agent的效果都在不断进化,但模型应用的编程范式并没有太大的改进,基本上就是Workflow、Skills、Agent、RAG、ReACT、MCP、Tools等。 而OpenClaw只是基于这些已有的编程范式整合出来一个普通人可以上手使用的应用框架或解决方案。同时,从工程架构上实现了从“AI给提建议”到“AI动手帮你做”的最后一公里。 换句话来说就是,Workflow能做的事,OpenClaw可以,Workflow不能做的事,OpenClaw也无法实现。对于大多数线上产品,最终的落地,需要的不是一个大而全但表现普通的OpenClaw,而是借鉴OpenClaw特定的技术方案和思想,通过Workflow来实现一个特定的SOP。 ## **OpenClaw的架构实现** OpenClaw的架构实现往简单来说,就是通过聊天工具作为入口,通过Agent编排来实现意图分析、任务拆解,然后通过脚本在本地的沙箱环境中执行具体的任务,最终把执行的结果汇总返回聊天入口。在这个过程中,针对特定的业务功能和场景,提供了可扩展的技能包。 ![OpenClaw核心流程](https://developer.qcloudimg.com/http-save/yehe-1161110/bbaeb9a9505b9403263ce35dab89f6f9.png) OpenClaw核心流程 用一句话来概述OpenClaw的就是:**OpenClaw 是一套聊天入口 + Agent 编排 + 本地执行沙箱 + 可扩展技能包的开源数字员工框架**。 如果再进一步展开,把前面提到的模型应用编程范式以及工程化的技术实现引入进来,OpenClaw的架构可进一步展示为下图。 ![OpenClaw架构图](https://developer.qcloudimg.com/http-save/yehe-1161110/c9ed8a2634ae6493eb816b3f88a78781.png) OpenClaw架构图 在上图中,入口与交互层提供了用户可以在各终端或消息通信工具中来给OpenClaw下达指令以及获得执行结果的窗口。特别是消息通信工具的加入,也是OpenClaw的创新之处,它的存在让非开发人员有了一个通过聊天来执行任务的入口,并且使用者摆脱了电脑设备的束缚,可以远程操作等。 另外两大核心模块就网关(Gateway)和智能体(Agent)。 网关用来接收来自各类聊天平台和控制界面,把收到的消息做统一格式化与路由分发给Agent运行时。 智能体是真正干活的核心引擎,组装上下文、调用AI模型、执行工具操作(比如浏览网页、操作文件、定时任务等)、保存状态等。这里面最具魅力的点是它通过调用大模型实现了意图理解、步骤规划、工具调用和结果反思等工作,在多轮循环中把任务执行完毕。 当智能体调用模型,模型返回执行某个工具的参数之后,便可在沙箱环境真正的去操作系统文件、命令行、浏览器、三方接口等。 在这些功能中,有些朋友会惊叹,OpenClaw真的可以“主动提醒我干某事”,这在技术实现上其实也就是一个周期性的定时任务而已。定时任务调用Agent Runner,再把执行结果通过消息通信工具推送给用户。 关于OpenClaw的架构就不再过多展开,回顾上面的架构图,会发现OpenClaw集成的所有功能都是已经存在的模型应用编程范式,Workflow同样在使用。 另外一个核心两点是它真正的去执行操作系统了,让原本通过ChatBot聊天的结果在操作系统或软件层面有了行动力。 最后,我们再通过一个时序图,看一下完整的调用链路。 ![OpenClaw核心流程图](https://developer.qcloudimg.com/http-save/yehe-1161110/c1050c325ee331f5b1ed17d03c946ab2.png) OpenClaw核心流程图 ## **OpenClaw的表现将归于平庸** 大多数人出于新鲜感或焦虑感(FOMO)会去部署和尝试OpenClaw,但真正体验之后,能够持续使用的人将是极少数的。 这里有几个关键点: 第一,巨大的Token消耗。如果关注一下OpenClaw原始的Prompt,会发现它本身就占用了大量的Token数,随着聊天的进行,每一轮操作的Token消耗会直线上升。特别是遇到多次重试的情况,问题还没解决,Token已经在疯狂的烧了。 第二,单纯消耗Token还好,当执行复杂的任务,你需要反复沟通,反复尝试,如果不是标准的SOP,结果可能会非常拉胯。大量的执行错误(Agent的循环越多,错误被放大的概率越高),会消耗掉用户的耐心。极大的降低用户体验。那些视频中行云流水的效果,背后都是博主调试了几十次才能呈现出那么一次符合预期的效果。 第三,除了预置的那些Skills(能力),如果想执行更专业的,包含行业KnowHow的内容,单纯依赖模型能力,它只能输出普通而泛化的内容。一个好的AI产品,最终还是要回归于行业SOP以及行业数据处理。 第四,其实大多数情况下,特别是AI产品,并不需要OpenClaw去执行本地操作系统的。对于普通人来说,也没有那么多需要自动化的重复任务需要操作。而对于线上投产的产品也不会在OpenClaw构建。 关于安全问题就不再说了,如果你用日常使用的电脑,很可能面临着信息被盗、电脑成为肉鸡等风险。 ## **OpenClaw的意义所在** 上面讲了那么多,但OpenClaw的意义是不可忽视的。 第一,普及意义。OpenClaw让模型应用得到了一次广泛的普及,这有点类似DeepSeek刚出来的时候。特别是对于普通人,有了一次尝试AI执行的能力体验。对于老板们,也开始相信OpenClaw或者说AI的能力,这将推动各个行业的SOP/Workflow的进程,如何去形成规范的SOP,如何用AI来替代掉业务中的一些标准流程。 第二,OpenClaw开创了一个走向未来的案例或者说是技术架构和框架,让人们看到通过Agent真的可以自主完成一些任务。这一条的核心点前面也提到,它把文字描述的“方案”变成了“动作”,把“建议”变成了“执行”,解决了最后一公里的问题。 第三,OpenClaw已经可以做到的一些功能价值,比如一些简单、重复操作事情,真的是可以交给OpenClaw来做的,比如网络上大量的文件整理、跑脚本、查数据、跳表、发邮件等案例。 另外一个就是对于产品经理来说,它还可以执行一些实验性功能,比如想实现某个功能,可以尝试让OpenClaw先做一个简单Demo或验证。 第四,数据的本地化/私有化可以控制在边界之内。 第五,对于产品经理、研发人员,具有非常大的借鉴意义。拓展了产品经理对基于AI产品的思考和思路,给研发人员提供了一个可参考的技术架构和解决方案。 ## **小结** 最后总结一下,真正想说的是OpenClaw的意义重大,但也不要无限的夸大,体验一下就好。本质上,它与Workflow、Claude Code实现的模型应用范式是一样的。 最终,想要将这一套理念和架构应用到生产中,要解决的核心问题不在于这些范式的组合,而在于如何梳理和规范化业务的SOP,如何基于行业KnowHow来让模式输出符合预期的结果。要想利用AI构建一个好的产品,最难的应该是还是SOP(行业标准流程)及数据治理(行业KnowHow数据)。 全文完,感谢阅读,如果喜欢请三连。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册