首页 文章 精选 留言 我的

精选列表

搜索[加密解密],共10003篇文章
优秀的个人博客,低调大师

CART算法解密:从原理到Python实现

本文深入探讨了CART(分类与回归树)算法的核心原理、实现方法以及应用场景。文章首先介绍了决策树的基础知识,然后详细解析了CART算法的工作机制,包括特征选择和树的构建。接着,通过Python和PyTorch的实例代码展示了CART算法在实际问题中的应用。最后,文章评价了该算法的优缺点,并讨论了其在不同领域如医疗、金融和市场分析中的应用潜力。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人。 一、简介 CART(Classification and Regression Trees)算法是一种用于分类和回归任务的决策树模型。这一模型由Breiman等人于1986年提出,现如今已广泛应用于各种数据挖掘任务和机器学习问题。 CART算法的背景 CART算法是基于决策树的一种扩展。决策树模型作为一种可解释性极强的模型,很早就得到了广泛的应用。CART算法不仅具有决策树所有的优点,还引入了更多高级的优化技巧,如基尼不纯度、树剪枝等。 例子:医疗诊断 在医疗诊断领域,决策树可用于根据一系列病症(特征)来预测疾病(标签)。CART算法则可以进一步优化这一过程,通过剪枝避免过拟合,提高模型的泛化能力。 应用场景 CART算法在多个领域有着广泛的应用,包括但不限于: 数据挖掘 自然语言处理 图像识别 金融风控 例子:金融风控 在金融风控领域,CART算法可以用于评估用户的信用等级。通过对用户的年龄、收入、消费习惯等特征进行分析,模型可以预测该用户是否有违约的风险。 定义与组成 CART算法基本上由三个主要组成部分: 决策树构建:使用训练数据创建一个决策树。 树剪枝:通过删除决策树的某些部分以防止过拟合。 决策与预测:使用构建和剪枝后的决策树进行数据分类或回归预测。 例子:电子邮件分类 假设你想构建一个电子邮件分类器来区分垃圾邮件和正常邮件。CART算法首先会通过观察电子邮件的特征(如发件人、主题、邮件内容中的关键词等)来构建一个决策树。然后,它可能会删除决策树中一些不必要或过于复杂的节点(剪枝)以防止过拟合。最后,使用这个剪枝后的决策树对新收到的电子邮件进行分类。 二、决策树基础 在深入了解CART算法之前,有必要先了解其基础——决策树模型。决策树是一种树形结构,用于进行决策或预测。它由节点和边组成,并具有一个根节点和多个叶节点。 什么是决策树 决策树是一种流行的机器学习算法,主要用于分类和回归任务。它通过一系列“是或否”的问题来进行决策或预测。每一个内部节点代表一个特征,每一个分支代表一个决策规则,每一个叶节点代表一个预测输出。 例子:天气预测 假设你想预测明天是否适合郊游。你可能会观察多个特征,比如天气(晴、阴、雨)、温度(高、中、低)等。决策树会从根节点开始,根据这些特征进行一系列决策,最终在叶节点给出一个预测(适合或不适合郊游)。 如何构建简单的决策树 构建决策树的基本步骤如下: 选择最佳特征:从数据集中选择一个特征作为当前节点。 分割数据集:基于选定特征的不同取值,将数据集分成多个子集。 决策或递归:如果某个子集已经包含同类数据,将其标记为叶节点;否则,对该子集递归地构建决策树。 例子:动物分类 假设你有一个数据集,其中包含了多种动物及其特性(如“有羽毛”、“会飞”、“是哺乳动物”等)。你的任务是构建一个决策树来分类这些动物。 你可能首先根据“有羽毛”这一特征来分割数据集。 对于“有羽毛”的子集,你可能进一步根据“会飞”这一特征进行分割。 最终,每一个叶节点都会包含同类的动物(如“鸟”或“哺乳动物”)。 决策树算法的类型 决策树算法主要有三种类型: ID3(Iterative Dichotomiser 3):使用信息增益作为特征选择的准则。 C4.5:是ID3的改进版,使用信息增益比作为特征选择的准则。 CART(Classification and Regression Trees):使用基尼不纯度或平方误差作为特征选择的准则,并且可以用于分类和回归任务。 例子:垃圾邮件分类 假设你正在构建一个垃圾邮件分类器: 使用ID3,你可能会选择那些带有最多信息增益(能最好地区分垃圾邮件和非垃圾邮件)的单词作为节点。 使用C4.5,你会考虑到每个单词出现的频率,选择信息增益比最高的单词。 使用CART,你可能会使用基尼不纯度来度量每个单词的分类能力。 通过这些定义和例子,我们可以更好地理解决策树的基础概念,为深入了解CART算法做好准备。 三、CART算法详解 在了解了决策树的基础知识后,接下来我们将详细介绍CART(Classification and Regression Trees)算法。CART算法是一种用于分类和回归的树模型,具有很高的灵活性和准确性。 特点和优势 CART算法有以下几个显著特点: 可用于分类和回归:与仅用于分类的决策树算法(如ID3、C4.5)不同,CART可以同时应用于分类和回归任务。 二叉树结构:CART总是生成二叉树,即每个节点都有两个子节点。 剪枝技术:CART使用成本复杂度剪枝(Cost-Complexity Pruning)来避免过拟合。 例子:房价预测 在房价预测(一个回归问题)中,CART算法可以根据多个特征(如面积、地段、年代等)建立一个模型来预测房价。与此同时,该算法也可以用于分类问题,比如预测房屋是否会在短期内售出。 构建CART决策树 构建CART决策树的主要步骤包括: 特征选择:在CART中,基尼不纯度或平方误差是用于特征选择的常见准则。 数据分割:根据选定的特征,数据集被分成两个子集。 递归与终止:对子集进行递归地树构建,直至满足某个终止条件(如节点中的样本数小于预定阈值)。 例子:学生分级 假设一个学校需要根据学生的多个特征(如成绩、出勤率、行为表现等)进行分级。CART算法首先会选择最重要的特征(可能是成绩),然后根据这一特征分割数据集。接着,算法会继续在每个子集上递归进行这一过程。 树剪枝 树剪枝是CART算法中一个非常重要的步骤,主要包括: 成本复杂度参数:通过调整成本复杂度参数(通常表示为( \alpha )),我们可以控制树的复杂度。 最小化成本函数:目标是找到一棵通过最小化成本函数得到的最优子树。 例子:电子商务产品推荐 在电子商务产品推荐中,可能原始的决策树非常复杂,并考虑了许多不必要的用户特征。通过剪枝,我们可以去除一些不重要的节点,从而得到一个更简单、更易于解释的模型,同时还能保持良好的推荐效果。 四、Python实战 在理论部分,我们详细地了解了CART算法的核心概念和特点。现在,让我们通过一个具体的Python实战例子来探讨如何实现CART算法。 场景描述:银行贷款审批 假设我们是一家银行的数据科学团队,负责开发一个机器学习模型来自动审批贷款申请。我们有一组包含四个特征的数据:年收入、信用分数、工作年限和贷款金额。目标是预测贷款是否会被偿还。 输入和输出 输入:一个数据集,包含每个申请人的年收入、信用分数、工作年限和贷款金额。 输出:一个预测结果,表明贷款是否应该被批准。 数据预处理 在构建模型之前,先要进行数据预处理。这通常包括空值填充、数据标准化等。 import pandas as pd from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler # 加载数据 data = pd.read_csv('loan_data.csv') # 数据预处理 scaler = StandardScaler() data[['Annual_Income', 'Credit_Score', 'Years_in_Job', 'Loan_Amount']] = scaler.fit_transform(data[['Annual_Income', 'Credit_Score', 'Years_in_Job', 'Loan_Amount']]) # 分割数据 X = data[['Annual_Income', 'Credit_Score', 'Years_in_Job', 'Loan_Amount']] y = data['Loan_Status'] X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) CART模型构建 使用DecisionTreeClassifier从sklearn.tree库中进行CART模型的构建和训练。 from sklearn.tree import DecisionTreeClassifier # 创建CART分类模型 cart_model = DecisionTreeClassifier(criterion='gini') # 模型训练 cart_model.fit(X_train, y_train) 模型评估 使用准确性(accuracy)作为模型评估的标准。 from sklearn.metrics import accuracy_score # 预测 y_pred = cart_model.predict(X_test) # 模型评估 accuracy = accuracy_score(y_test, y_pred) print(f'Model Accuracy: {accuracy}') 输出: Model Accuracy: 0.88 五、优缺点 在深入了解了CART算法和其Python实现之后,现在让我们总结一下这一算法的优缺点。 优点 1. 灵活性高 CART算法可以应用于分类和回归问题,这使得它在解决各种类型的问题上具有很高的灵活性。 例子:健康诊断与股价预测 比如在医疗健康的分类问题中,可以使用CART算法预测患者是否患有特定疾病。同时,在金融领域的股价预测(回归问题)也可以使用CART算法。 2. 易于理解和解释 由于CART生成的是树结构模型,因此模型的结果通常容易解释和理解,这对于需要解释模型决策的场合非常有用。 例子:信贷审批 在信贷审批的场景中,不仅需要模型有高的准确性,还需要能够解释贷款批准或拒绝的原因。CART算法生成的决策树可以直观地展示这些逻辑。 3. 可以处理缺失值和异常值 CART具有很强的鲁棒性,能够有效地处理缺失值和异常值,而不需要进行复杂的数据预处理。 例子:传感器数据 在工业生产中,由于传感器可能出现故障或噪声,收集到的数据可能包含缺失值或异常值。CART算法能够在这种情况下依然表现良好。 缺点 1. 容易过拟合 尽管CART算法提供了剪枝技术,但如果不正确地设置剪枝参数或训练数据本身具有噪声,模型仍然容易过拟合。 例子:股市预测 在股市预测中,由于市场变化多端,使用CART算法容易捕捉到数据中的噪声而导致过拟合。 2. 对于非线性关系不如其他算法强大 虽然CART算法可以捕捉到一定的非线性关系,但对于高度复杂的非线性系统,其表现可能不如基于核方法或神经网络的算法。 例子:图像识别 在图像识别问题中,由于像素之间的复杂关系,CART算法通常不如卷积神经网络(CNN)等更复杂的模型表现出色。 六、应用场景 CART算法因其灵活性和易解释性而广受欢迎,具有多样的应用场景。在本节中,我们将详细探讨这些应用场景。 1. 医疗诊断 CART算法可以用于分析患者的医疗记录,并基于多种参数预测疾病风险。 例子:心脏病风险预测 通过分析患者的年龄、血压、胆固醇水平等因素,CART算法可以预测患者未来心脏病的风险。这对于提早进行预防性治疗非常有用。 2. 金融风控 在金融行业,CART算法用于评估贷款或信用卡申请人的信用风险。 例子:信用评分模型 银行使用CART算法分析申请人的年收入、工作年限、过往信用记录等,以预测其违约的可能性。据此,银行可以决定是否批准贷款或信用卡申请。 3. 市场分析 CART算法在市场分析中也有广泛的应用,尤其在客户细分和推荐系统中。 例子:个性化推荐 电商网站使用CART算法分析用户的购买历史、页面浏览行为等,为他们推荐最可能购买的产品。 4. 自然资源保护 CART算法在环境科学和自然资源管理方面也有潜在应用。 例子:野生动物栖息地评估 通过分析土壤类型、气候条件、植被覆盖等因素,CART算法可以评估某个区域作为特定野生动物栖息地的适宜性。 5. 工业生产 在工业生产中,CART算法可以用于优化生产流程、故障检测等。 例子:生产质量控制 通过实时分析生产线上的各种传感器数据,CART算法可以预测产品是否会有质量问题,从而及时进行调整。 七、总结 经过前面几个章节的详细探讨,我们不难发现CART算法是一个非常强大和灵活的机器学习算法。它可以应用于分类和回归问题,具有良好的解释性,并在各个行业中都有着广泛的应用。 然而,值得注意的是,任何算法都不是银弹。CART算法虽然在某些方面表现出色,但也有其局限性,比如容易过拟合,以及在处理复杂非线性问题时的局限。因此,在选择算法时,我们需要根据具体的应用场景和需求来进行综合评估。 解释性与复杂性的权衡:在现实世界的应用中,尤其是在高风险或高价值的领域(如医疗、金融等),模型的解释性可能与预测性能同等重要。CART算法提供了一种有效地平衡这两者的方法。 数据驱动的特性工程:传统的特性工程往往依赖于领域知识和经验,而CART算法通过自动选择重要的特征和分裂点,为数据驱动的决策提供了强有力的支持。 集成方法的基础:CART算法往往作为集成方法(如随机森林和梯度提升树)的基础,这进一步证明了它在处理各种复杂问题时的有效性和可扩展性。 对不平衡数据的敏感性:虽然CART算法有其优点,但它对不平衡数据特别敏感,这在某些应用场景下可能是一个问题。因此,在使用CART算法之前,对数据进行适当的预处理或采用适当的评价指标是非常必要的。 关注TechLead,分享AI全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人。 如有帮助,请多关注 TeahLead KrisChang,10+年的互联网和人工智能从业经验,10年+技术和业务团队管理经验,同济软件工程本科,复旦工程管理硕士,阿里云认证云服务资深架构师,上亿营收AI产品业务负责人。

优秀的个人博客,低调大师

议程大曝光,GOTC 2023 解密 AI 编程

全球开源技术峰会(Global Open-source Technology Conference,简称 GOTC)是由开放原子开源基金会、 上海浦东软件园、Linux 基金会亚太区和开源中国联合发起的,面向全球开发者的一场盛大开源技术盛宴。 GOTC 2023 将于 5 月 27 日至 28 日在上海张江科学会堂召开。大会将以行业展览、主题发言、特别论坛、分论坛的形式展现,与会者将一起探讨 元宇宙、3D 与游戏、eBPF、Web3.0、区块链等热门技术主题,以及 开源社区、AIGC、汽车软件、AI 编程、开源教育培训、云原生等热门话题,探讨开源未来,助力开源发展。 其中,AI 编程分论坛由 华为云智能化软件研发首席专家王千祥担任出品人,将于 5 月 28 日举行。 GOTC 2023 报名通道现已开启: https://www.bagevent.com/event/8387611,来吧,一起了解 AI 编程最新研究成果和应用实例,一起探索 AI 编程的无限可能性。 大会亮点: 代码与 AI 的前世今生 软件工程应如何拥抱大模型? 代码大模型的关键问题与技术挑战 顶级专家畅聊:AI 编程如何提升生产力 专题论坛出品人:王千祥 华为云智能化软件研发首席专家,PaaS 技术创新 LAB 主任,中国计算机学会软件工程专委副主任。主导华为公司的智能化软件研发,结合 AI 技术与软件分析技术,赋能公司的系列软件研发工具。 议题:智能化时代的软件工程:拥抱大模型的正确姿势 嘉宾: 彭鑫 | 复旦大学计算机科学技术学院副院长、教授、博导 演讲时间:9:00-9:30 议题简介:以 ChatGPT 为代表的大模型技术对于包括软件工程在内的很多领域都带来了巨大的冲击,也引发了广泛的焦虑。为了在迷雾中看清一点方向,近期我们基于各种技术文献和实践分享以及我们自身的一些初步探索不断地在讨论和思考“大模型时代的软件工程”这一命题。拥抱大模型对于软件工程学术界和产业界应当都是一个正确甚至必要的方向,但如何实现系统和全面的软件智能化开发还需要冷静思考,同时还有很多基础性的工作需要去做。本次报告将分享我们的一些初步理解以及对于未来发展方向的展望。 议题:从针对代码的人工智能到集成代码的通用人工智能 嘉宾: 段楠 | 微软亚洲研究院首席研究员 演讲时间:9:30-10:00 议题简介:ChatGPT 和 GPT-4 开启了通往通用人工智能(AGI)的大门。代码在这些基础模型中起到了至关重要的作用。本报告将从针对代码任务设计的人工智能模型讲起(AI models for code tasks),一路讲到集成了代码数据的基础模型(foundation models with code),最后介绍我们为构建 AGI 提出的 TaskMatrix 架构。整个报告涉及的工作我们都做了很好的开源,希望能够推动 AI for Code 领域的发展,促进 AGI with Code关键技术的探索。 议题:软件工程 3.0 之下 软件开发新范式 嘉宾: 朱少民 | 同济大学特聘教授,“软件工程3.0” 定义者 演讲时间:10:00-10:30 议题简介:(1)从软件工程1.0到软件工程3.0(SE3.0);(2) SE3.0的新形态;(3) SE3.0的新开发范式;(4) 新范式下编程将如何展开;(5)企业如何更好利用新范式;(6)未来展望与挑战。 议题:华为代码大模型的方案与应用 嘉宾: 马宇驰 | 博士、华为云 Dev AI Lab Leader、智能化研发算法技术专家 演讲时间:10:30-11:00 议题简介:(1)AIGC for SE 的业界洞察;(2)华为代码大模型方案与应用;(3)代码大模型的关键问题与技术挑战;(4)AIGC for SE 的机遇与展望。 议题:代码智能:从任务特定模型到通用大模型的探索之路 嘉宾: 王焱林 | 中山大学软件工程学院助理教授、硕士生导师 演讲时间:11:00-11:30 议题简介:在这次分享中,我们将探讨软件工程领域中代码智能相关任务上的探索过程及其未来趋势,包含三个主要部分:(1) 任务特定模型上的探索之路:在这一部分,将回顾我们在任务特定模型上的几项工作,包括它们的核心思想以及在解决特定编程任务上取得的成果;(2)软工领域通用模型的探索之路:本部分将讨论从专用模型过渡到通用模型的需求及初步探索;(3)未来求索之路:在最后一部分,我们将探讨将二者结合的可能性并展望代码智能研究的未来发展趋势。 圆桌:AI 编程如何提升生产力 时间:11:30-12:00 嘉宾: 王千祥,华为云智能化软件研发首席专家 彭鑫,复旦大学计算机科学技术学院副院长、教授、博导 段楠,微软亚洲研究院首席研究员 马宇驰,博士、华为云 Dev AI Lab Leader、智能化研发算法技术专家 王焱林,中山大学软件工程学院助理教授、硕士生导师 GOTC 2023报名通道现已开启,诚邀全球各技术领域开源爱好者共襄盛举! 参会报名,请访问:https://www.bagevent.com/event/8387611 进入官网了解更多信息,请访问:https://gotc.oschina.net

优秀的个人博客,低调大师

解密负载均衡技术和负载均衡算法

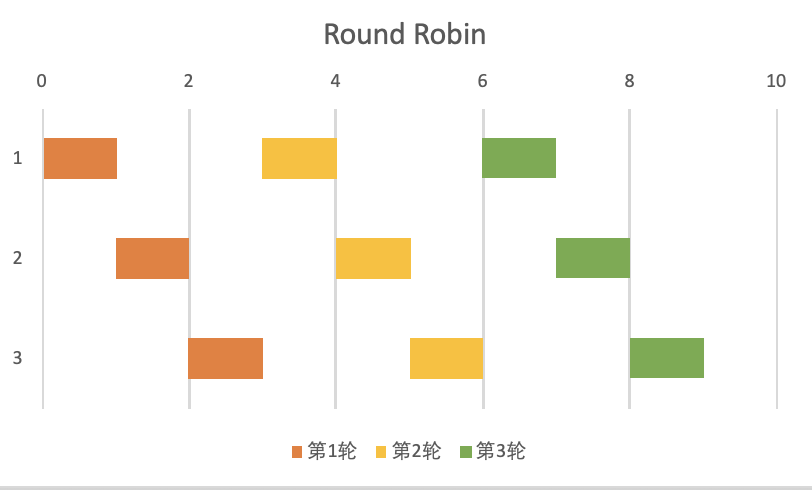
什么是负载均衡技术 负载均衡器是一种软件或硬件设备,它起到了将网络流量分散到一组服务器的作用,可以防止任何一台服务器过载。负载均衡算法就是负载均衡器用来在服务器之间分配网络流量的逻辑(算法是一组预定义的规则),有时候也叫做负载均衡的类型。负载均衡算法的种类非常多,包括从简单的轮询负载均衡算法到基于响应状态信息的自适应负载均衡算法。 负载均衡算法的选择会影响负载分配机制的有效性,从而影响性能和业务连续性(也就是对外承诺的SLA),选择正确的负载均衡算法会对应用程序性能产生重大影响。 本文将会介绍常见的负载均衡算法,并结合主流负载均衡软件或硬件设备介绍各种负载均衡算法的实现方式 常见负载均衡算法介绍 Round Robin(轮询负载均衡算法) 在所有负载均衡算法中,轮询负载均衡算法是最简单的、最常用的负载均衡算法。客户端请求以简单的轮换方式分发到应用程序服务器上。例如,假设有三台应用程序服务器:第一个客户端请求发送到第一台应用程序服务器,第二个客户端请求发送到第二台应用程序服务器,第三个客户端请求发送到第三台应用程序服务器,第四个客户端请求重新从第一台应用程序服务器开始,依次往复。 轮询负载均衡适合所有客户端请求都需要相同的服务器负载,并且所有的服务器实例都具有相同的服务器容量和资源(比如网络带宽和存储) Weighted Round Robin(加权轮询负载均衡算法) 加权负载均衡算法与轮询算法相似,增加了根据每个服务器的相对容量来将请求分散到不同服务器的能力。它适合将传入的客户端请求分散到一组具有不同功能或具有不同负载容量的服务器上。服务器集群管理员根据一个标准为每个应用程序服务器分配一个权重,这个标准表示每个服务器对请求的相对处理能力。 例如,如果在其他资源都是无穷多的情况下,假如服务器#1的CPU核心数是服务器#2和服务器#3的CPU核心数的二倍,那么服务器#1的权重更高,而服务器#2和#3的权重相同(都比#1低)。如果我们有4个连续的客户端请求,那么有2次请求发送到#1,另外2次请求分别发送到#2和#3。 加权轮询负载均衡算法描述的是在一段时间内负载的分布情况,不同的加权轮询负载均衡算法可能会产生不同的选择序列,不应该对处理下一次负载的服务器进行假设。 Least Connections(最少连接负载均衡算法) 最少连接负载均衡算法又叫做最少等待请求算法(Least Outstanding Request, LOR)。最少连接负载均衡是一种动态负载均衡算法,客户端请求被分发到在接收到请求时活动连接数最少的应用服务器。在应用服务器具有类似规格的情况下,一台服务器可能会因为连接数过多而过载(无法接收请求也属于过载),这个算法考虑了活动连接负载。这种技术适合具有不同连接时间的传入请求(多机房)以及一组在处理能力和可用资源方面相对相似的服务器。 Weighted Least Connections(加权最少连接负载均衡算法) 加权最少连接建立在最少连接负载均衡算法上,考虑不同的应用程序服务器特性。与加权轮询负载均衡算法相同,服务器集群管理员根据一个标准为每个应用程序服务器分配一个权重,这个标准表示每个服务器对请求的相对处理能力。负载均衡器根据活动链接和分配的服务器权重做出负载平衡决策(例如,使用连接数乘以权重的倒数,选择值最高的服务器)。 Resource Based(基于资源的负载均衡算法) 基于资源的负载均衡算法又叫做自适应负载均衡算法。基于资源的负载均衡算法根据后端服务器提供的状态指标来做出决策。这个状态指标可以由一个运行在服务器上的自定义应用程序(比如agent),或从基础设施提供方的开放接口获取。负载均衡器定期查询每台服务器的状态指标,然后适当地调整服务器的动态权重。 在这种方式下,负载均衡算法实际上是在每台真实服务器上执行健康检查。这个算法适用于任何需要来自每台服务器的详细健康检查信息来做出负载均衡决策的情况。 例如:此算法适用于工作负载多变且需要详细的应用程序性能和状态来评估服务器运行状态的任何应用程序(例如CPU密集型的最短路径计算,或其他高性能计算场景)。 Fixed Weighting(固定权重负载均衡算法) 固定权重负载均衡算法允许服务器集群管理员根据他们的标准为每个应用程序服务器分配一个权重,以表示每个服务器的相对流量处理能力。权重最高的应用服务器将接收所有流量。如果权重最高的应用服务器出现故障,所有流量将会被引导到下一个权重最高的应用服务器。此方法适用于单个服务器能够处理所有预期传入请求的工作负载,如果当前活动的服务器发生故障,一个或多个“热备用”服务器可以直接用于承担负载。 Weighted Response Time(加权响应时间负载均衡算法) 加权响应时间负载均衡算法使用应用程序的响应时间来计算服务器权重。响应速度最快的应用程序服务器接收下一个请求。此方法适用于应用程序响应时间是最重要的问题的场景。 当应用程序提供的是对外开放服务时尤为重要,因为对外开放服务都会为合作伙伴提供服务级别协议(Service Level Argument,SLA),而SLA中承诺的主要就是服务的可用性与服务的响应时间(TP99、TP999等)。 Source IP Hash(源地址哈希负载均衡算法) 源地址哈希负载均衡算法使用客户端请求的源IP与目标IP地址生成唯一的哈希密钥,用于将客户端请求分配给特定的服务器。如果传输层会话中断,可以重新密钥,因此客户端请求将会被定向到它之前使用的统一服务器。当客户端对于每个连续连接始终返回到同一服务器至关重要时,此方法最适用。 服务端研发经常接触的数据库事务就适用于此场景 Consistent Hash(一致性哈希负载均衡算法) 一致性哈希负载均衡算法类似于源地址哈希,不同在于一致性哈希负载均衡算法可以使用任意应用参数组成唯一的哈希密钥,并且当服务器集群发生变化时可以尽可能少地进行数据迁移。 常见负载均衡算法实现 本节将会介绍各种常见负载均衡算法的实现方式,某些负载均衡算法具有多种不同的实现方式,并且每种实现方式都有各自适用的场景,这些不同的实现方式也会在本节进行介绍。同时本节中会假设所有的请求都是线性的,不会处理并发安全相关的细节。 Round Robin(轮询负载均衡算法) 在所有负载均衡算法中,轮询负载均衡算法实现起来最简单,只需要一个变量表示当前位置并不断增加即可。 public class RoundRobinLoadBalancer { private final List instances; private int position; public RoundRobinLoadBalancer(List instances) { this.instances = instances; this.position = ThreadLocalRandom.current().nextInt(instances.size()); } public ServiceInstance peek(HttpServletRequest request) { int peeked = (position++) & Integer.MAX_VALUE; return instances.get(peeked % instances.size()); } } 这里有两个需要注意的点 当我们初始化位置时,需要将其设置为一个随机值,避免多个负载均衡器同时请求同一个服务器,造成服务器的瞬时压力 在位置自增时,需要忽略符号位,因为Java没有无符号整数,所以当位置的值超出整型最大值时会变成负值导致抛出异常。至于为什么不能使用绝对值,是因为整型的最小值没有对应的绝对值,得到的依旧是负值(Spring Cloud #1074) Weighted Round Robin(加权轮询负载均衡算法) 加权轮询负载均衡算法有很多主流的实现,并且各自都有各自的优点。虽然加权负载均衡产生任意符合全总分配比例分布的选择序列都是合适的,但在短时间窗口内是否能够选择尽可能多的节点提供服务仍是评价加权负载均衡实现的质量的关键指标。 数组展开方式 数组展开实现方式是一种适用空间换时间的策略,适用于较小的服务器集群或专用型负载均衡设备。它的优点是速度非常快,与Round Robin实现完全一致。它的缺点也很明显,当权重的总和很大时会带来很大的内存开销 public class WeightedLoadBalancer { private final List instances; private int position; public WeightedLoadBalancer(List instances) { this.instances = expandByWeight(instances); } public ServiceInstance peek(HttpServletRequest request) { int peeked = (position++) & Integer.MAX_VALUE; return instances.get(peeked % instances.size()); } private List expandByWeight(List instances) { List newInstances = new ArrayList<>(); for (ServiceInstance instance : instances) { int bound = instance.getWeight(); for (int w = 0; weight < bound; weight++) { newInstances.add(instance); } } Collections.shuffle(newInstances); return newInstances; } } 这里有三个需要注意的点: 当实例按权重展开成数组的时候,可能会出现实例权重都很大,但是它们的最大公约数不为1,这个时候可以使用最大公约数来减少展开后的数组大小。因为最大公约数的诸多限制,例如任意自然数N与N+1互质,任意自然数N与1互质,所以很容易出现优化失败的情况,因此本示例并未给出,感兴趣的可以去看Spring Cloud相关PR(Spring Cloud #1140) 在实例按权重展开成数组后,需要对得到的数组进行洗牌,以保证流量尽可能均匀,避免连续请求相同实例(Java中实现的洗牌算法是Fisher-Yates算法,其他语言可以自行实现) 因为是在构建负载均衡器的时候按权重展开成数组的,所以在负载均衡器构建完成后无法再改变实例的权值,对于频繁动态变更权重的场景不适用 上界收敛选择方式 上界收敛选择方式提前计算出所有权重的最大值,并将初始上界设置为所有权重的最大值,接下来我们一轮一轮地去遍历所有实例,并找到权重大于等于上界的实例。当前轮遍历结束后,所有大于等于上界的元素都被选取到了,接下来开始尝试权重更低的节点,直到最后上界为0时,将其重新置为最大值。目前openresty (有人在issue #44上分析了这种算法) public class WeightedLoadBalancer { private final List instances; private final int max; private final int gcd; private int bound; private int position; public WeightedLoadBalancer(List instances) { this.instances = instances; this.max = calculateMaxByWeight(instances); this.gcd = calculateGcdByWeight(instances); this.position = ThreadLocalRandom.current().nextInt(instances.size()); } public ServiceInstance peek(HttpServletRequest request) { if (bound == 0) { bound = max; } while (instances.size() > 0) { for (int peeked = position; peeked < instances.size(); peeked++) { ServiceInstance instance = instances.get(peeked); if (instance.getWeight() >= bound) { position = peeked + 1; return instance; } } position = 0; bound = bound - gcd; } return null; } private static int calculateMaxByWeight(List instances) { int max = 0; for (ServiceInstance instance : instances) { if (instance.getWeight() > max) { max = instance.getWeight(); } } return max; } private static int calculateGcdByWeight(List instances) { int gcd = 0; for (ServiceInstance instance : instances) { gcd = gcd(gcd, instance.getWeight()); } return gcd; } private static int gcd(int a, int b) { if (b == 0) { return a; } return gcd(b, a % b); } } 这里面有四个需要注意的点: 如果是短频率请求,将会一直访问高权重实例,导致在短时间窗口内负载看起来并不均匀。这个可以通过改变方向,从下界向上界逼近来解决。 每一轮后降低上界的值可以取所有权重的最大公约数,因为如果每次下降1的话,中间这些轮会反复请求权重最高的那些实例,导致负载不均衡。 虽然最大公约数可以减少下降次数,但是如果权重相差非常多,并且所有元素都是互质的(n与n+1互质,任意自然数n与1互质,在实践中非常容易出现),那么在上界下降的过程中将会带来很多空转。这个可以参考广度优先遍历的思想,使用先入先出的队列来减少空转。 与数组展开方式遇到的问题相同,因为是在构建负载均衡器的时候计算最大公约数的值,所以对于频繁动态变更权重的场景依旧会有很大的性能开销,但是相较于数组展开方式可以避免频繁动态分配数组导致的性能与内存碎片问题 权重轮转实现 权重轮转算法中将会存储两个权重的值,一个是不会变化的原始权重,一个是会随着每次选择变化的当前权重。权重轮转实现中维护了一个循环不变量——所有节点的当前权重的和为0。每轮遍历过程中所有实例的有效权重都会增加它的原始权重,并选择出当前权重最高的节点。选择出权重最高的节点后将它的当前权重减去所有实例权重的总和,以避免它再次被选择。NGINX中加权轮询负载均衡算法使用此实现(NGINX)。这种算法的优势是它很平滑,低权重节点的等待时间较短,并且每轮权重轮转的最小正周期很小,是所有服务器实例权重的和。。 在NGINX中又叫做平滑加权负载均衡(Smooth Weighted Load Balancing,SWRR)。 public class WeightedLoadBalancer { private final List instances; public WeightedLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; int total = 0; for (ServiceInstance instance : instances) { total += instance.getWeight(); instance.setCurrentWeight(instance.getCurrentWeight() + instance.getWeight()); if (best == null || instance.getCurrentWeight() > best.getCurrentWeight()) { best = instance; } } if (best != null) { best.setCurrentWeight(best.getCurrentWeight() - total); } return best; } } 这里面有三个需要注意的点: 权重轮转非常适合实例变化频率非常高的集合,因为它不需要提前构建数据结构 权重轮转实现的效率与实例数量相关,时间复杂度是O(n),当集群服务器数量非常大时需要限制每次参与选择的服务器数量(Spring Cloud #1111) 权重轮转实现需要修改服务器实例的数据结构,当服务实例是由其他机构提供时无法使用此实现 EDF(Earliest Deadline First)实现 EDF算法最早被用在CPU调度上,EDF是抢占式单处理器调度的最佳调度算法。EDF实现与权重轮转实现相似,引入了名为deadline的额外变量,可以认为权重越高的服务器实例完成任务的时间越快,那么在假设所有请求的成本相同时,所需要花费的时间是权重的倒数,所以可以很自然地选择可以最早空闲出来提供服务的服务器实例,并将任务分配给它。 实现EDF算法只需要将每个下游服务器实例与deadline绑定,然后以deadline为优先级维护到优先队列中,并不断取出队首元素,调整它的deadline,并将它重新提交到优先队列中。知名Service Mesh代理envoy使用了此方法实现加权负载均衡(envoy),以及蚂蚁开源网络代理mosn中也实现了此方法(mosn #1920) public class WeightedLoadBalancer { private final PriorityQueue entries; public WeightedLoadBalancer(List instances) { this.entries = instances.stream().map(EdfEntry::new).collect(Collectors.toCollection(PriorityQueue::new)); } public ServiceInstance peek(HttpServletRequest request) { EdfEntry entry = entries.poll(); if (entry == null) { return null; } ServiceInstance instance = entry.instance; entry.deadline = entry.deadline + 1.0 / instance.getWeight(); entries.add(entry); return instance; } private static class EdfEntry implements Comparable { final ServiceInstance instance; double deadline; EdfEntry(ServiceInstance instance) { this.instance = instance; this.deadline = 1.0 / instance.getWeight(); } @Override public int compareTo(EdfEntry o) { return Double.compare(deadline, o.deadline); } } } EDF每次选择的算法复杂度为O(log(n)),相较于数组展开要慢,但相较于上界收敛选择在最坏情况下以及权重轮转都需要O(n)的时间复杂度来说,其性能表现的非常好,并且对于超大集群,其性能下降不明显。其空间复杂度为O(n),不会造成很大的内存开销。 Least Connections(最少连接负载均衡算法) 遍历比较方式 最简单的实现方式,遍历所有实例,并找出当前连接数最少的实例 public class LeastConnectionLoadBalancer { private final List instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; for (ServiceInstance instance : instances) { if (best == null || instance.getConnections() < best.getConnections()) { best = instance; } } if (best != null) { best.setConnections(best.getConnections() + 1); } return best; } } 堆维护方式 所有动态有序集合都可以通过优先队列来实现,与EDF算法相同,取出队首的元素,修改它的优先级,并放回队列中 public class LeastConnectionLoadBalancer { private final PriorityQueue instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances.stream().collect(toCollection( () -> new PriorityQueue<>(comparingInt(ServiceInstance::getConnections)))); } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = instances.poll(); if (best == null) { return null; } best.setConnections(best.getConnections() + 1); return best; } } Weighted Least Connections(加权最少连接负载均衡算法) 加权最少连接负载均衡算法的实现方式与最少连接负载均衡算法相同,只是在计算时增加了权重相关的参数 遍历比较方式 public class LeastConnectionLoadBalancer { private final List instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = null; for (ServiceInstance instance : instances) { if (best == null || instance.getConnections() * best.getWeight() < best.getConnections() * instance.getWeight()) { best = instance; } } if (best != null) { best.setConnections(best.getConnections() + 1); } return best; } } Tips,在不等式中 a/b < c/d 与 ad < bc等价,并且可以避免除法带来的性能与精度问题 堆维护方式 public class LeastConnectionLoadBalancer { private final PriorityQueue instances; public LeastConnectionLoadBalancer(List instances) { this.instances = instances.stream().collect(toCollection( () -> new PriorityQueue<>(comparingDouble(ServiceInstance::getWeightedConnections)))); } public ServiceInstance peek(HttpServletRequest request) { ServiceInstance best = instances.poll(); if (best == null) { return null; } best.setConnections(best.getConnections() + 1); best.setWeightedConnections(1.0 * best.getConnections() / best.getWeight()); return best; } } Weighted Response Time(加权响应时间负载均衡算法) 加权响应时间负载均衡算法使用统计学的方法,通过历史的响应时间来得到预测值,使用这个预测值来选择相对更优的服务器实例。得到预测值的方法有很多,包括时间窗口内的平均值、时间窗口内的TP99、历史所有响应时间的指数移动加权平均数(EWMA)等等。其中Linkerd与APISIX使用了EWMA算法(Linkerd和APISIX)。 通过历史的响应时间来得到预测值这个操作通常是CPU开销很大的,实际使用时可以不用遍历所有元素,而是使用K-临近元素或直接随机选择两个元素进行比较即可,这种启发式方法办法无法保证全局最优但是可以保证不至于全局最差。 Source IP Hash(源地址哈希负载均衡算法) 源地址哈希负载均衡以任意算法将请求地址映射成整型数,并将这个整型数映射到实例列表的下标 public class IpHashLoadBalancer { private final List instances; public IpHashLoadBalancer(List instances) { this.instances = instances; } public ServiceInstance peek(HttpServletRequest request) { int h = hashCode(request); return instances.get(h % instances.size()); } private int hashCode(HttpServletRequest request) { String xForwardedFor = request.getHeader("X-Forwarded-For"); if (xForwardedFor != null) { return xForwardedFor.hashCode(); } else { return request.getRemoteAddr().hashCode(); } } } 这里有一个需要注意的点: 面向公网提供服务的负载均衡器前面可能会经过任意多层反向代理服务器,为了获取到真实的源地址,需要先获取X-Forwarded-For头部,如果该头部不存在再去获取TCP连接的源地址 负载均衡技术扩展 服务注册表与发现(Service Registry and Service Discovery) 在维护大型服务器集群时,服务器实例随时都有可能被创建或移除,当服务器被创建或移除时,集群管理员需要到各个负载均衡设备上去更新服务器实例列表。 服务注册表会在内部维护服务对应的服务器实例列表。在服务器实例被创建并成功运行服务后,服务器实例会去服务注册表中注册自身,包括网络地址(IPv4/IPv6)、服务端口号、服务协议(TCP/TLS/HTTP/HTTPS)以及自身提供的服务名称等等,有的服务注册表本身也会提供主动健康检查的能力(如Eureka与Consul)。在服务器实例正常退出时会在服务注册表执行反注册逻辑,这个时候服务注册表就会将这个服务器实例从服务器实例列表中移除。即使服务器实例异常退出导致无法执行反注册逻辑,服务注册表也会通过主动健康检查机制将这个异常的服务器实例从服务器实例列表中移除。 在拥有服务注册表后,负载均衡设备不需要再手动维护服务器实例列表,而是当请求到来时从服务注册表中拉取对应的服务器实例列表,并在这个服务器实例列表中进行负载均衡。为了提高服务的可用性,负载均衡设备会在本地(内存或本地文件注册表)缓存这些服务器实例列表,以避免由于负载均衡设备与服务注册表无法连接而导致服务不可用。 缓存及重新获取服务器列表的策略根据不同业务场景有不同的实现,在Spring Cloud Loadbalancer中是通过缓存过期而触发重新获取的逻辑(Spring Cloud),当服务注册表不可用时,因为负载均衡设备中无可用的服务器备份而导致服务完全不可用;在大部分的负载均衡设备中将缓存获取与更新逻辑改为定时器主动刷新的机制,这样当服务注册表不可用时可以主动决定是否将旧数据标记为过期。尽管本地缓存可以提高服务的可用性,但是要注意负载均衡设备在使用的仍旧是旧的服务提供方列表,当长时间无法获取到新的服务提供方列表时,负载均衡设备应当舍弃旧的服务提供方列表,并将服务不可用的问题暴露出来,通过基础设施提供的监控与告警能力通知集群管理员来进行处理。 健康检查(Health Check) 健康检查本质是一个预定规则,它向负载均衡器背后的服务器集群中的所有成员发送相同的请求,以确定每个成员服务器是否可以接受客户端请求。 对于某些类型的健康检查,通过评估来自服务器的响应以及收到服务器响应所需的时间以确定每个成员服务器的运行状态。通常情况下,当成员服务器的状态变为不健康时,负载均衡器应该快速地将其从服务器实例列表中移除,并在成员服务器状态恢复正常时将其重新添加回服务器实例列表中。 对于网络层负载均衡器(也叫做NLB或L4LB),通过建立TCP连接,根据是否能够成功建立连接以及建立连接所需要的时间来确定成员服务器的状态。 对于应用层负载均衡器(也叫做ALB或L7LB),通过发送应用层协议(不只是HTTP协议)定义的用于健康检查的请求报文,并根据响应报文内容以及整个请求从建立连接到完整收到所有响应所花费的时间来确定成员服务器的状态。 应用负载均衡器没有固定的模式。例如,对于提供HTTP协议服务的应用,可以提供用于健康检查的URL,设置通过健康检查的HTTP状态码(或状态码集),并验证响应报文中用于表示服务器状态的字段(通过JSONPath或XMLPath等提取)是否是预期值等方式来确认成员服务器状态;对于RPC协议,可以提供专门的ping-pong服务,负载均衡器根据RPC协议组装请求报文,并发送ping请求到成员服务器上,并根据成员服务器返回的内容是否为pong响应来确认成员服务器的状态,具体设计可以参考websocket的ping-pong机制(RFC 6455)。 慢启动(Slow Start) 负载均衡器中的慢启动思想来自于TCP的拥塞控制理论,其核心也是为了避免大量请求涌入刚刚启动完成的应用程序,导致大量请求阻塞、超时或异常的情况。 众所周知,Java是半编译半解释型语言,包括Java语言在内,现代解释型语言的解释器都带有即时编译器(Just In Time,JIT),JIT编译器会跟踪每个方法的执行点,对那些热点路径(Hotspot)进行更高效的优化,这也是Hotspot JVM名字的由来。而JIT对热点路径的优化全都来自于自应用程序启动以来的所有方法调用,也就是说应用程序的系统承载能力是随着程序的运行而不断得到强化的,经过JIT优化的Java代码甚至可以得到近似GCC中O3(最高级别)优化的性能。跟多关于JIT编译器的细节可以看Oracle的Java开发者指南(Java Developer Guide)。 同时,现代应用程序都不可避免的会使用本地缓存,当应用程序刚刚启动时内存中的缓存是空的,随着应用程序的运行,不断地访问外部系统获取数据并将数据写入到内存缓存中,应用程序与外部系统的交互会不断减少,应用程序的系统承载能力也会逐渐达到峰值。 上面是应用程序在启动后性能不断提升的因素中最常见的,初次之外还有很多的因素。所以为了避免大量请求涌入刚刚启动完成的应用程序的现象发生,负载均衡器会通过慢启动的方式,随着服务器运行不断增加这些服务器实例的权重,最终达到服务器的实际权重,从而达到动态调整分配给这些服务器实例的流量的效果。 服务器权重变化算法有很多,包括随时间线性增长、随时间对数增长、随时间指数增长、随时间变幂增长、与随时间按Logistic增长等。目前京东服务框架(JSF)实现的是随时间线性增长;envoy实现了随时间变幂增长,并引入了渐进因子来调整变化速率(envoy slow start)。 总结 负载均衡技术是网络代理与网关组件最核心的组成部分,本文简单介绍了什么是负载均衡技术、常见的负载均衡算法以及常见负载均衡算法的实现,并给出了负载均衡技术的扩展,为将来更深入学习网络代理相关技术打下基础。 因本人才学疏浅经验能力有限,文中难免会有疏忽和遗漏,以及不连贯的地方,欢迎大家与我沟通交流给出建议。 作者:纪卓志

优秀的个人博客,低调大师

解密指纹和面容认证的实现方法

科幻电影一直是人们津津乐道的话题,其中不乏一些经典场面,让观众为之震惊赞叹,例如《钢铁侠》中的悬浮虚拟触摸屏、《碟中谍》中的指纹虹膜识别等。如今,这些看似高大上的科技也走进了我们的日常生活,像指纹与面容识别,其应用已经极为普遍与广泛。 当今社会对个人隐私的保护越来越重视,对App的安全性也提出了更高的要求,具备私密性与独特性的指纹与面容识别,就成为了强有力的保障。当用户在解锁设备、支付、文件访问时,利用指纹或者面容认证,这在很大程度上减少了帐号盗取、信息泄露的风险。 华为线上快速身份验证服务(FIDO)提供了相关功能:开放基于WebAuthn标准的FIDO2客户端能力,提供本地指纹、面容认证开放能力,为应用提供安全可信的本地生物特征认证和安全便捷的线上快速身份验证能力。其优势在于通过系统完整性检测和密钥校验机制保证结果安全可信,通用的无密码用户身份验证方案,易与现有帐号基础设施集成。接下来,为大家说明如何集成指纹和面容认证能力。 主要的接入步骤如下: 1. 配置AppGallery Connect 2. 集成HMS Core SDK 3. 集成本地生物认证能力 步骤1、2可以参考超链接中的指导进行完成,这里不做赘述。 需要注意的是步骤2中提供了两种本地生物认证的SDK: Bioauthn-AndroidX implementation 'com.huawei.hms:fido-bioauthn-androidx:5.2.0.301' Bioauthn implementation 'com.huawei.hms:fido-bioauthn:5.2.0.301' 这两个SDK对外表现的能力略有不同。主要表现在BioAuthn-AndroidX SDK的指纹认证能力提供统一界面,不需要应用自己绘制指纹认证提示界面;BioAuthn SDK的指纹认证能力不提供统一界面,需要应用自己绘制指纹认证提示界面。 可以参考官网FAQ中的说明: 这次我们主要介绍Bioauthn-AndroidX的集成,Demo可以在这里下载 集成本地生物认证能力 注意:1. 请保证手机没有root过,不然无法使用指纹和面容能力2. 测试前请先保证手机中已经有相应的指纹和面容信息,否则会报相关的错误码。可以在设置-生物识别和密码-指纹/人脸识别中添加相关指纹和面容 指纹认证 使用指纹认证分为两步: 1. 初始化BioAuthnPrompt对象,代码如下: BioAuthnPrompt bioAuthnPrompt = new BioAuthnPrompt(this, ContextCompat.getMainExecutor(this), new BioAuthnCallback() { @Override public void onAuthError(int errMsgId, CharSequence errString) { showResult("指纹认证报错. errorCode=" + errMsgId + ",errorMessage=" + errString); } @Override public void onAuthSucceeded(BioAuthnResult result) { showResult("指纹认证成功. CryptoObject=" + result.getCryptoObject()); } @Override public void onAuthFailed() { showResult("指纹认证失败."); } }); 2. 创建提示信息,并进行认证。 // 自定义设置信息 BioAuthnPrompt.PromptInfo.Builder builder = new BioAuthnPrompt.PromptInfo.Builder().setTitle("主标题") .setSubtitle("副标题") .setDescription("内容描述"); //允许使用其他认证方式 builder.setDeviceCredentialAllowed(true); BioAuthnPrompt.PromptInfo info = builder.build(); //进行认证 bioAuthnPrompt.auth(info); 配置完成后就可以进行指纹认证了,认证页面如下: 面容认证 面容认证的限制条件比较多,具体请参考FAQ: 1. 检查是否有相机权限(EMUI10.1及以后版本不需要相机权限) int permissionCheck = ContextCompat.checkSelfPermission(MainActivity.this, Manifest.permission.CAMERA); if (permissionCheck != PackageManager.PERMISSION_GRANTED) { showResult("请先申请相机权限"); ActivityCompat.requestPermissions(MainActivity.this, new String[] {Manifest.permission.CAMERA}, 1); return; } 2.检查当前设备是否支持人脸识别 FaceManager faceManager = new FaceManager(this); int errorCode = faceManager.canAuth(); if (errorCode != 0) { resultTextView.setText(""); showResult("不支持人脸识别. errorCode=" + errorCode); return; } 3.进行人脸认证 int flags = 0; Handler handler = null; CryptoObject crypto = null; faceManager.auth(crypto, cancellationSignal, flags, new BioAuthnCallback() { @Override public void onAuthError(int errMsgId, CharSequence errString) { showResult("认证报错. errorCode=" + errMsgId + ",errorMessage=" + errString + (errMsgId == 1012 ? " 没有相机权限." : "")); } @Override public void onAuthHelp(int helpMsgId, CharSequence helpString) { showResult("返回识别过程中提示信息. helpMsgId=" + helpMsgId + ",helpString=" + helpString + "\n"); } @Override public void onAuthSucceeded(BioAuthnResult result) { showResult("认证成功. CryptoObject=" + result.getCryptoObject()); } @Override public void onAuthFailed() { showResult("认证失败."); } }, handler); 这样人脸识别的代码就完成了,调用后就会进行人脸认证。需要注意的是人脸认证没有默认的UI页面,需要我们自己去设计配置。 使用场景 指纹认证 一般来说指纹认证是用在支付场景的,用户付款前可以使用指纹认证来进行安全检测。指纹认证也可以用在文件保护App里,只有指纹认证通过才可以查看相关文件。 面容识别 面容识别也可以在支付场景和文件保护APP中使用,这个不再赘述在文件保护APP方面,面容识别的效果会比指纹表现的更出色。因为文件保护App有一个通病,那就是“此地无银三百两”,摆明了告诉别人你这个文件很重要或很敏感。所以其他人只要搞定了你的指纹(虽然也比较困难),那就畅通无阻了。 那么文件保护App除了可以在明面上展示指纹识别外,还可以“悄悄地”再做一层面容识别(面容识别不需要设计UI界面),只有指纹识别和面容识别都过了,才展示正确的文件,否则可以展示假文件。这样做的话就可以更好的保护用户的隐私。 具体的人脸识别的代码实现可以是下面这样的: faceManager.auth(crypto, cancellationSignal, flags, new BioAuthnCallback() { @Override public void onAuthError(int errMsgId, CharSequence errString) { if(isFingerprintSuccess){//指纹认证成功但面容识别失败 //展示假文件 showFakeFile(); } } @Override public void onAuthHelp(int helpMsgId, CharSequence helpString) { } @Override public void onAuthSucceeded(BioAuthnResult result) { if(isFingerprintSuccess){//指纹认证成功 //展示真文件 showRealFile(); }else {//指纹认证失败 //展示假文件 showFakeFile(); } } @Override public void onAuthFailed() { if(isFingerprintSuccess){//指纹认证成功但面容识别失败 //展示假文件 showFakeFile(); } } }, handler); >>访问华为线上快速身份验证服务官网,了解更多相关内容 >>获取华为线上快速身份验证服务开发指导文档 >>华为HMS Core官方论坛 >>华为线上快速身份验证服务开源仓库地址:GitHub、Gitee 点击右上角头像右方的关注,第一时间了解华为移动服务最新技术~

优秀的个人博客,低调大师

解密 云HBase时序引擎OpenTSDB 优化技术

逝者如斯夫,不舍昼夜。 —— 孔子 时间如流水,一去不复返。自古不乏对时间流逝的感慨,而现代已经有很多技术记录流逝的过去。我们可以拍照,可以录像,当然还可以用时序数据库! 时序数据库是专门存放随着时间推移而不断变化的数据。近些年,随着IoT等概念的流行,时序数据库成为数据库一个相对独立的领域逐渐受到重视,广泛应用于物联网、监控系统、金融、医疗和零售等多种场景。 过去12个月时序数据库(Time Series DBMS)热度不断增长 那么云上的用户如何构建一个存储海量数据的时序数据库呢?笔者这里推荐使用 云HBase + OpenTSDB 方案。云HBase是使用阿里多年优化过的HBase内核版本,本文不作过多介绍,详情请看 产品主页。 OpenTSDB简介 OpenTSDB是一款基于HBase构建的时序数据库,它的数据存储完全交给HBase,本身没有任何数据存储。所有节点是对等的,所以部署起来其实是非常方便的。因为基于HBase,所以本身就具备了横向扩展,存储海量数据的能力。常见的部署模式有2种,一种分离部署,一种混合部署。 独立部署,即与多个业务共享一个HBase。适合时序业务较小,或者用不满HBase资源。 混合部署,即TSDB进程和RS在一个VM内。适合时序业务较重,需要独享HBase。 上述2种模式,云HBase产品都能提供支持,云HBase购买页面现已增加时序引擎购买入口。 OpenTSDB数据定义 一条时间线由 Metirc + 多个tag 唯一确定,时间线上会有源源不断的数据点(Data Point)写入,数据点由时间戳和值组成。OpenTSDB支持秒级(10位整数),毫秒级别(13位整数)两种时间精度。 举个例子,比如我们监控一个手环收集的心跳信息,那么我们可以这样定义: Metric: "band.heartbeat" Tags: "id" # 只定义一个tag,就是手环的ID 那么我们通过 band.heartbeat + id=1 就能查询到编为1的手环收集到的心跳信息。 OpenTSDB数据存储格式 数据表整体设计 这个设计有几个特点: 1.metric和tag映射成UID,不存储实际字符串,以节约空间。 2.每条时间线每小时的数据点归在一行,每列是一个数据点,这样每列只需要记录与这行起始时间偏移,以节省空间。 3.每列就是一个KeyValue,如果是毫秒精度,一行最多可以有3600000个KV,这里其实会有些问题,后面会讲到。 RowKey格式 salt:打散同一metric不同时间线的热点metric, tagK, tagV:实际存储的是字符串对应的UID(在tsdb-uid表中)timestamp:每小时数据存在一行,记录的是每小时整点秒级时间戳 metric和tag 它们长度默认是3个字节,即最多只能分配2^24=16777216个UID。可以通过这些参数调整: tsd.storage.uid.width.metric # metric UID长度,默认3 tsd.storage.uid.width.tagk # tagK UID长度,默认3 tsd.storage.uid.width.tagv # tagV UID长度 默认3 # 这3者的UID分配分别是独立的空间 注意:集群已经写过数据后就无法修改,所以最好是一开始就确定好,建议4个字节。因为使用压缩技术后,RowKey多占的几个字节可以忽略,下文会提到。 salt salt这个东西最好根据自己HBase集群规模去配置,它有2个配置: tsd.storage.salt.width # 默认1,1基本够了,不用调整 tsd.storage.salt.buckets # 打散到几个bucket去,默认20 查询的时候会并发 tsd.storage.salt.buckets 个Scanner到HBase上,所以如果这个配置太大,对查询影响比较大,容易打爆HBase。这里其实是一个权衡,写入热点和查询压力。默认20其实我个人觉得有点多,配置3~8就差不多了,当然实际效果还和metric设计有关,如果在一个metric里设计了很多时间线,那就得配置很多bucket。在一个metric中设计过多时间线,会影响OpenTSDB的查询效率,所以不建议这么做。这个参数也是设置了就不能改的,所以也是要一开始规划好。 Column格式 这是列名(HBase中称为qualifier)的格式,可以看到毫米级需要多出2个字节。所以如果你的采集间隔不需要精确到毫秒级别,那请一定使用秒级(10位整数)。Value只能存储整数和浮点,所以有一个bit存储Float flag。 这里大家一定会有疑问,直接通过qualifier长度是4还是2不就能判断是秒级精度的数据点,还是毫秒了么?为何还需要MS flag这样一个标记信息?阅读下面的“压缩”部分,就能知道为什么。 OpenTSDB压缩问题 OpenTSDB有个很常见并且很麻烦的问题,就是整点时候对HBase对流量冲击。下面2张图是我们一个测试集群只做写入对效果: OpenTSDB HBase 可以看到会有一个数倍流量的爆发,要持续很久才能消化。 这意味着我们需要更高规格去抗这个峰值。首先我们要明白OpenTSDB为啥要做压缩?在压缩些什么东西? 前面提到过OpenTSDB一行一小时的特点,那么一行里会有很多KV。表面上看起来好像没什么问题,但是实际上对比逻辑视图和物理视图你会发现一些问题。 很明显,每个KV都记录了rowX,那rowX就是一个空间浪费。这个空间不仅影响成本,还影响查询效率(毕竟数据多了)。压缩做的事情就是把多个小KV合成1个大KV,减少这部分浪费。所以压缩的时候会涉及到对HBase的“读-写-删”,这就是整点HBase IO流量的来源。那么我们有没有办法,既做压缩,同时又消除这部分HBase IO呢?当然有!我们可以把压缩的逻辑放到HBase内部去。因为HBase本身就需要对HFile做合并工作,这时候HBase本身就会读写数据文件,这部分对HDFS的IO不会少,而我们通过hook在HBase读出数据后,替换掉要写入的数据(即压缩好的数据)。 实现上面这个功能,当然需要一定内核开发量。好消息是通过云HBase购买页面购买的时序引擎,已经自带了上述功能。不管是分离部署模式,还是混合部署模式。这个功能的好处显而易见,消除峰值节省成本,提升集群稳定性。这样我们对一个现有的HBase集群空闲资源需求就不是那么高了,完全可以复用了。下面是使用此功能后,同样只做写入的测试集群的流量情况:

优秀的个人博客,低调大师

使用python解密SecureCRT上保存的密码

一、系统环境 系统:CentOS Linux release 7.5.1804 (Core) 系统本身自带:python-2.7.5-69.el7_5.x86_64 另外安装:python2-crypto-2.6.1-15.el7.x86_64 yum install pycrypto 二、用法: python Decrypt.py [filename...] 1、使用vi编辑器创建Decrypt.py文件,写入源代码。 2、其中[filename...]指的是ini文件,位于%APPDATA%\VanDyke\Config\Sessions\sessionname.ini 3、执行命令,即可查看到主机IP、账户、密码信息。 源代码: from Crypto.Cipher import Blowfish import argparse import re def decrypt(password) : c1 = Blowfish.new('5F B0 45 A2 94 17 D9 16 C6 C6 A2 FF 06 41 82 B7'.replace(' ','').decode('hex'), Blowfish.MODE_CBC, '\x00'*8) c2 = Blowfish.new('24 A6 3D DE 5B D3 B3 82 9C 7E 06 F4 08 16 AA 07'.replace(' ','').decode('hex'), Blowfish.MODE_CBC, '\x00'*8) padded = c1.decrypt(c2.decrypt(password.decode('hex'))[4:-4]) p = '' while padded[:2] != '\x00\x00' : p += padded[:2] padded = padded[2:] return p.decode('UTF-16') REGEX_HOSTNAME = re.compile(ur'S:"Hostname"=([^\r\n]*)') REGEX_PASWORD = re.compile(ur'S:"Password"=u([0-9a-f]+)') REGEX_PORT = re.compile(ur'D:"\[SSH2\] Port"=([0-9a-f]{8})') REGEX_USERNAME = re.compile(ur'S:"Username"=([^\r\n]*)') def hostname(x) : m = REGEX_HOSTNAME.search(x) if m : return m.group(1) return '???' def password(x) : m = REGEX_PASWORD.search(x) if m : return decrypt(m.group(1)) return '???' def port(x) : m = REGEX_PORT.search(x) if m : return '-p %d '%(int(m.group(1), 16)) return '' def username(x) : m = REGEX_USERNAME.search(x) if m : return m.group(1) + '@' return '' parser = argparse.ArgumentParser(description='Tool to decrypt SSHv2 passwords in VanDyke Secure CRT session files') parser.add_argument('files', type=argparse.FileType('r'), nargs='+', help='session file(s)') args = parser.parse_args() for f in args.files : c = f.read().replace('\x00', '') print f.name print "ssh %s%s%s # %s"%(port(c), username(c), hostname(c), password(c)) 代码来源: GitHub上gitPoc32的项目

优秀的个人博客,低调大师

GTS解密--GTS的原理、架构与特点

作者 赵成 日期 2018-01-01 标签 分布式事务 , GTS , Global Transaction Service, 柔性事务, TCC , XA两阶段提交协议 全局事务服务(Global Transaction Service,简称 GTS)是阿里新推出的分布式事务处理方案,对其深入分析的资料相对匮乏。本文的目标是剖析GTS的技术路线,厘清其优势与约束。文章参考了GTS公开的专利、产品文档、相关网页,文章中肯定有不准确的地方,欢迎各位同学拍砖与指正。 一、GTS的目标 GTS是一个面向互联网交易场景的分布式事务解决方案。 制约分布式事务的三个因素 分布式事务是互联网交易场景面临的关键问题之一。不同于搜索、社交、联机分析应用,电子商务、支付是典型的交易场景,数据的错误会带来严重的后果,对数据的一致性与可用性有很高的要求。互联网环境带来了海量的数据容量、连接数与访问量,单一数据库节点无法应对,成为整个系统的瓶颈。为解决单一数据库成为瓶颈的问题,通过数据拆分实现数据库能力的线性扩展。数据拆分是使用分库分表的方式,将数据存储在多个数据库节点,利用分布式数据库平台解决数据库瓶颈的问题。分布式数据库环境中,一个事务会跨越多个数据库,面临分布式事务处理的问题。 分布式事务解决方案面临应用灵活性、数据一致性、性能三者的挑战。目前已有多种成熟方案,每种方案都是对这三个方面做出的取舍。 相互制约的三个因素为: 应用灵活性:应用访问数据的方式是否需要修改,以及修改的程度。 一致性:数据是强一致,还是最终一致的(允许中间不一致的状态)。 系统性能:分布式事务对整体性能的影响。 现有分布式处理方案 现有成熟的分布式解决方案包括XA两阶段提交、可靠消息与TCC模式等类型。XA两阶段提交属于强一致事务,可靠消息与TCC模式属于柔性事务。 XA两阶段提交 XA 是指由 X/Open 组织提出的分布式事务处理的规范。XA规范主要定义了Transaction Manager(TM)和Resource Manager(RM)之间的接口,结构如下图所示。 XA协议的流程可大致分为三个步骤: 步骤1:APP向TM创建全局事务,TM向APP返回全局事务号。 步骤2:APP使用全局事务号,访问RM的资源(当RM为数据库时,资源访问就是SQL操作)。当RM第一次收到访问时,使用该全局事务号向TM注册,TM返回事务分支事务号。 步骤3:APP向TM发出全局事务提交请求,TM与参与事务的RM通信,进行提交处理,全部完成后,向APP返回结果。 TM与RM之间的提交处理,采用两阶段提交协议。TM在第一阶段对所有的参与事务的RM请求“预备”操作,达成关于分布式事务一致性的共识。事务参与者必须完成所有的约束检查,并且确保后续提交或放弃时所需要的数据已持久化。在第二阶段,根据之前达到的提交或放弃的共识,请求所有参事务的RM完成相应的操作。 提交事务的过程中需要在多个资源节点之间进行协调,而各节点对锁资源的释放必须等到事务最终提交时,所以两阶段提交在执行同样的事务时会比一阶段提交消耗更多的时间。当事务并发量达到一定数量时,就会出现大量事务积压甚至出现死锁,系统性能和处理吞吐量就会严重下滑。 可靠消息 可靠消息的一种可能实现的结构如下图。 说明: 业务处理服务在业务事务提交前,向实时消息服务请求发送消息,实时消息服务只记录消息数据,而不真正发送。 业务处理服务在业务事务提交后,向实时消息服务确认发送。只有在得到确认发送指令后,实时消息服务才真正发送消息。 业务处理服务在业务事务回滚后,向实时消息服务取消发送。 消息状态确认系统定期找到未确认发送或回滚发送的消息,向业务处理服务询问消息状态,业务处理服务根据消息ID或消息内容确定该消息是否有效。 通过消息进行事务异步的方式,可以保证业务数据操作和消息的发送同时执行成功或失败,保持了事务的最终一致性。 采用可靠消息的方式,在两个事务间实现分布式事务时,可以很好地满足事务最终一致性以及事务的回滚,但如果一个事务上下文中超过两个事务操作后,需要开发人员实现整个事务流程的操作日志的记录、每个事务分支的回滚以及整个流程的准确调度。 TCC模式 TCC模式为全局事务执行提供了一个框架,开发人员只需要实现每个事务分支的回滚,不需要记录整个事务流程的操作日志。TCC模式结构如下图。 说明: 一个完整的业务活动由一个主业务服务与若干从业务服务组成。 主业务服务负责发起并完成整个业务活动。 从业务服务提供TCC型业务操作。 业务活动管理器控制业务活动的一致性,它登记业务活动中的操作,并在业务活动提交时确认所有的TCC型操作的confirm操作,在业务活动取消时调用所有TCC型操作的cancel操作。 TCC业务包括两个阶段完成: 第一阶段:主业务服务分别调用所有从业务的 try 操作,并在活动管理器中登记所有从业务服务。当所有从业务服务的 try 操作都调用成功或者某个从业务服务的 try 操作失败,进入第二阶段。 第二阶段:活动管理器根据第一阶段的执行结果来执行 confirm 或 cancel 操作。如果第一阶段所有 try 操作都成功,则活动管理器调用所有从业务活动的 confirm操作。否则调用所有从业务服务的 cancel 操作。 小结 可靠消息与TCC模式通过避免XA两阶段提交对数据资源的长期锁定提升了性能,通过在数据库外部实现事务机制达到了最终一致性,但牺牲了应用灵活性,需要开发人员实现事务检查与回滚的细节,面临着花费大量精力保证应用正确性的问题。 GTS目标是在性能开销可接受的情况下,由GTS统一处理全局事务的故障恢复与并发控制,对应用开发屏蔽事务处理的细节,从而提升应用的灵活性与数据的一致性。 二、GTS的技术路线 GTS采用基于XA架构优化的技术路线,在保留XA架构灵活性的优点下,通过将XA提交中的第一阶段与第二阶段解耦,将提交过程转换为第一阶段本地事务提交+第二阶段异步清理的方式,从而提供提升系统性能,同时通过在GTS内部维护应用级别的日志与锁信息,实现了全局事务的回滚与并发控制。 GTS方案认为XA性能低效的根本原因是采用了阻塞协议。在分布式事务提交的第一阶段等待最慢的一个事务分支完成,即使在不存在锁冲突的情况下,各事务分支的数据库连接依然会被挂起所占用的资源都不能够释放,以防止全局事务提交前释放资源所造成的数据不一致。对于业务流量极高的大规模互联网企业,难以接受 XA 两阶段提交协议所带来的巨大性能开销。 GTS架构包含的组件与XA完全相同,示意架构如下图。 GTS全局事务处理流程与XA一致,也包括全局事务注册、数据访问与全局事务提交三个步骤,但在第二步与第三步的内部处理上与XA不同: 第二步数据访问中,各事务分支完成数据操作的同时,会将全局事务信息(锁与日志信息)存储在当前数据库的表中。 第三步全局事务提交中,采用一阶段本地事务提交+二阶段异步清理的方式。首先对各数据库做本地事务的提交,并释放数据库连接等系统资源,然后,向TM发出全局事务提交请求,TM收到请求后,立即返回成功,TM后续实际工作是对各个数据库使用全局事务标识符进行全局事务信息的清理。 GTS与XA在全局事务的故障恢复处理与并发控制采用了不同的实现机制: XA两阶段协议是基于数据库内核的日志与锁信息实现全局事务的回滚与并发控制。由于GTS一阶段本地事务提交中,会直接提交本地事务并释放连接,此时数据库内核的日志与锁表对全局事务不再有效。在第二步中,GTS会将日志和锁信息存储在表中,当事务本地提交后,日志和锁信息被持久化保存,用于实现全局事务的并发控制与故障恢复。 GTS的故障恢复只有UNDO操作没有REDO操作,日志表中存储了UNDO需要的信息,包括行记录标识、全局事务号、镜像查询语句、操作的前像与操作的后像。当发生故障时,对于已经本地提交的数据库,从UNDO表中找到修改的记录,记录的操作前像和操作后像,使用镜像查询语句从数据库中读取该记录的当前值。如果当前值与记录操作后像相同,则直接使用操作前像进行恢复,否则报警,进行人工处理。 GTS的全局锁表中存储了记录的加锁信息。封锁的粒度是行(记录),锁的类型包括共享锁和互斥锁,对于同一个记录,加锁的规则是共享锁与共享锁不冲突,共享锁与互斥锁冲突、互斥锁与互斥锁冲突。对插入(INSERT)、修改(UPDATE)、删除(DELETE)、更新模式的锁定查询(SELECT… FOR UPDATE) 操作加互斥锁。对于共享模式的锁定查询 (SELECT…LOCK IN SHARE MODE) 操作加共享锁。若没有锁冲突,在GTS锁表中,增加一行记录,表示加锁成功。 GTS的默认隔离级别为读未提交(脏数据),使用SELECT… FOR UPDATE和SELECT…LOCK IN SHARE MODE,可使查询隔离级别提升至读已提交。 三、GTS的架构与处理流程 架构 下图描述了GTS一种可能的实现架构。 与XA架构相同,GTS架构由应用、事务管理器、资源管理器三个部分组成。资源管理器由事务分支处理模块、镜像查询构造模块、并发控制模块、恢复控制模块,以及存储在数据库中的GTS事务信息(GTS锁表与GTS日志表)等组成。 事务分支处理模块:是资源管理器的外部接口,并完成内部各模块的调用。 镜像查询构造模块:从Insert、Update、Delete语句,生成该操作对应记录集的镜像查询语句。例如table_name表包含两个字段column1和column2,column1为主键,则镜像查询语句为select column1, column2 from table_name where column1=v1。 并发控制模块:基于GTS事务锁表,维护读写并发控制。锁表定义如下: 字段名 字段类型 字段描述 ID 整数 自增主键 TABLE_NAME 字符串 表名 KEY_VALUE 整数 数据行ID XID 字符串 全局事务标识 XLOCK 整数 互斥锁标记 SLOCK 整数 共享锁标记 BRANCH_ID 整数 事务分支标识 恢复控制模块:基于GTS日志表,进行故障恢复。 日志表定义如下: 字段名 字段类型 字段描述 ID 整数 自增主键 GMT_CREATE 时间 创建时间 GMT_MODIFIED datetime 修改时间 XID 整数 全局事务ID BRANCH_ID 整数 分支事务ID ROLLBACK_INFO longblob 查询语句、前像与后像 STATUS 整数 状态 SERVER 字符串 分支所在DB IP 主要流程序列图 分别描述了insert/delete/update操作、读已提交操作、提交操作和回滚操作等四个操作的序列图(一种可能的实现方式)。 insert/delete/update操作流程序列图 读已提交操作流程序列图 提交操作流程序列图 回滚操作流程序列图 阿里官方案例 GTS产品网站给出了一个交易类事务中最典型的转账案例 A和B两个用户的数据分别位于一个DRDS实例的两个不同分库中,用50个进程并发进行 A转账给3,每个进程转账10次,每次转账金额在1到10之间随机生成,转账过程中模拟了3%的网络异常,使用GTS事务保证了A和B钱的总数不变。 从代码上可看出,只需增加一条开启GTS的sql语句,就将单机事务应用提升至分布式事务,体现出很好的应用灵活性。测试中转账事务执行500次,成功490次,失败10次。转账结束10秒后,查询账户金额总数正确。 2017云栖大会 GTS产品介绍中,给出了使用GTS与不使用事务(1PC)测试对比。下图,GTS比1PC的性能损耗在10%,远远小于2PC方式,表现出优异的性能。 四、GTS的优势与约束 与基于消息队列与TCC补偿模式的分布式事务相比,在性能满足的情况下,GTS更好的应用灵活性与数据一致性: 灵活性:数据库应用基本实现零修改,同时,基于XA模型,可方便的支持消息队列数据库等多种RM。 数据一致性:GTS 的缺省事务隔离级别为读未提交,该模式下可以达到分布式事务的最大性能,但可能会读到脏数据。对于一致性要求高的应用,在性能允许的情况下,可以采用已提交读语句(for update、lock in share mode)将隔离级别提升至读已提交。 根据GTS实现机制的特点,其应用场景上有以下约束:加锁操作记录数量不能太大,操作冲突不能太多,加锁时间不能太长。违法以上约束时,GTS内部会占用过多资源、锁冲突和回滚增加,导致性能的下降。电商、物流、金融、零售行业中的核心交易场景有着高并发,高性能,单次操作数据集小,事务响应时间敏感的特点,GTS类方案在此类场景中有着广泛和良好的应用前景。 五、参考 书 《企业IT架构转型之道》第六章 专利 CN201510111872-一种分布式事务处理方法及系统 CN201510111986-一种分布式事务处理方法及系统 网页 破解世界性技术难题! GTS让分布式事务简单高效 分布式事务云市场分析 分布式事务中间件GTS(TXC) GTS for DRDS分布式事务的实现理解 GTS全局事务测试-单DRDS跨库事务 版权声明:自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)

优秀的个人博客,低调大师

英特尔:大数据解密互联汽车

数字世界催生了无处不在的连接需求。如今,消费者希望即使身在旅途也能享受各类数字化体验,就像在办公室、在家里或其他地方一样。在这种需求的驱动下,汽车正在经历从交通工具到巨型移动设备的转型。据IHS发布的互联汽车报告估计,到2020年,将有1.52亿辆互联汽车上路,每年产生11PB数据。从移动设备的激增到物联网的蓬勃发展,各种技术力量亦在加速这种转变,使汽车成为当今信息网络中不可或缺的组成部分。 现在,汽车既能接收数据,也能将数据发至云端、交通基础设施以及其他车辆。我们能否充分挖掘互联汽车的价值,与这些数据直接相关。 图:英特尔公司物联网解决方案事业部副总裁兼汽车解决方案部总经理Elliot Garbus IT世界的机遇 目前,汽车已产生大量数据,而随着各项功能的扩充,数据量只会进一步增加,汽车也将成为数据制造大户。IT经理们现在应该考虑:如何从中挖掘有意义的信息,用于商业模式的改进。同时,驾驶员亦可根据自己的偏好调整隐私设置,决定共享多少数据。通过对数据加以分析,汽车制造商能够更加了解用户以及车内的各项状况。此外,这些数据还能帮助市场、工程及IT机构携手改进车内体验。通过利用CRM数据和增进对驾驶员行为及偏好的了解,汽车制造商可以更好地满足用户需求,在恰当的时间提供恰当的体验,如向驾驶员发出疲劳警告、汽车故障预警,然后主动帮助解决问题,通过观察发展趋势,积极做好准备以防患于未然。更重要的是,在此基础之上,汽车制造商可以有效降低成本,开发出更好的汽车。 呼唤多层数据分析 通过多层数据分析,我们可以实现诸如交通事故警告、天气预报等新型服务。数据将从车辆传感器传至云端,实时获取驾驶员当下所需的信息,这意味着汽车必须拥有自主分析数据以及征询云端反馈的能力。汽车制造商需要考虑整个数据处理周期,包括汽车与云、汽车与交通基础设施以及车与车之间的数据传送。从传感控制器到网关、从云端到客户端、从汽车到基础设施,每个环节都涉及有效信息的抽取和数据价值的挖掘。之后,数据分析的结果将与其他车辆以及交通基础设施分享,并向驾驶员提交建议结果以便防患于未然。 通过了解其生产的所有车辆情况,汽车制造商得以为车主提供更好的服务。例如,当汽车出现某些问题,用户可以第一时间向汽车制造商咨询这类情况是否需要高昂的修理费用或存在任何安全隐患,甚至根据数据分析结果预约上门维修服务或提前预订零部件,以尽可能减少这些问题带来的不便。为了支持自主驾驶以及高级驾驶员辅助系统(ADAS)等先进技术,强大的计算能力不可或缺,需要车辆与安全可靠的数据中心主干建立高速连接,以在云端进行群数据分析。 确保安全与隐私 随着越来越多的车辆及交通基础设施实现互联,对于汽车制造商和用户来说,安全可靠地保存和收发数据至关重要。信息安全和车辆安全密不可分,因为来自虚拟世界的恶意攻击很有可能导致实实在在的技术故障。先进技术的推陈出新与汽车制造商对上述要求的响应速度紧密相关。车辆亦需根据这些数据及其来源快速、准确地做出决策。只有采用多层分析模式,车辆才能充分利用各项数据,自主进行分析。此外,在保护用户隐私之余,所有互联汽车的被盗风险亦可被降低。 未来的驾驶体验 曾有调查显示,几乎一半的美国人希望拥有无人驾驶汽车,其中超过1/3的人相信,近10年就可以实现这一愿望。随着自主驾驶这一理念越来越受追捧,汽车制造商必须重新思考如何设计新型汽车,将其打造成为一个多系统运行平台,这些系统可以彼此通信、相互协作并主动提供有效建议。英特尔正在积极运用自己的创新技术和专长,与汽车行业紧密合作,打造全新的车内体验。 原文发布时间为: 本文作者: 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

浪潮InCloudRack解密整机柜服务器

近年来随着云计算、物料网、大数据及移动互联网的蓬勃发展,传统数据中心也在向大型、超大型数据中心转型。据IDC报告显示:“未来五年超过60%的数据中心投资增长来自超大规模数据中心,5000台以上的数据中心将占到总体的68%以上,而到2020年将会出现50万台容量的单一数据中心。” 数据中心规模的扩大对于后台的压力成倍增加,使得机房空间成本高昂、交付时间大大增加、海量服务器的运维也变得复杂。整机柜服务器因为能够帮助用户降低TCO、提升空间利用率,实现快速部署而被广泛认可。Intel推出的RSD(Rack Scale Design)架构同样认为未来数据中心将会以整机柜为最小单位,喊出了“重塑数据中心”的口号,推动数据中心真正走向池化、弹性与软件定义。 当前整机柜服务器已经大规模应用于互联网行业,但是对传统企业级用户来说,虽然他们对整机柜服务器集中管理、集中供电、集中散热等优势感到心动,但还是有许多顾虑让他们望而却步,下面让我们一一来看。 整机柜hold不住关键应用? 众所周知,整机柜服务器已经广泛应用于横向扩展互联网型应用,如为公有云、大数据等搭建支撑平台,但当一些应用,如数据库、交易系统、计费系统等,需要较高单台计算能力、极高的业务耦合度时,整机柜服务器一般都会显得心有余而力不足。 但这个问题并不会难倒InCloudRack。浪潮InCloudRack不仅满足于支持横向扩展,还支持2/4/8路堆叠设计。在提供四路、八路超强计算能力节点的同时,还可以进行节点的灵活搭配、重组,提供高性能又不失灵活性。 整机柜服务器不能满足新兴应用的I/O扩展需求? 当前许多新兴应用对I/O扩展性要求非常高,如VDI大规模并发应用、工业设计及大量非结构化数据的出现,需要充足的并行异构处理单元进行加速并兼容专业软件,另外还有深度学习、视频解析、虚拟化整合、NFV等新兴应用。这些应用无疑均需要服务器提供强大的I/O 扩展能力。 浪潮InCloudRack通过模块化设计,可以灵活配置多种节点和扩展模块,拥有144个PCIe插槽的I/O扩展能力,最多支持96个热插拔PCIe插槽,可扩展48块GPU卡或96块MIC卡、FPGA卡等,让I/O扩展性能不再是新兴应用的困扰。 此外,InCloudRack可支持多种计算、存储以及GPU扩展方案,实现传统/新兴应用“All in One”的全面整合,是业界扩展方案最为丰富的整机柜服务器之一。 整机柜服务器冗余能力如何? 企业级客户对支撑应用的IT平台一直以来均有较为严格的要求,如金融、医疗、电力、高铁等行业特性决定了其应用的运行一旦出现意外中断就会造成极大的、甚至是无法弥补的不良影响和损失。 浪潮InCloudRack采用全模块化设计,实现全部模块免工具拆装,支持多种热插拔维护,并且拥有高冗余特性。18个N+N冗余电源模块、24个N+1冗余风扇、1+1冗余TSW模块、1+1冗余TMC(Tray-Management Controller)管理模块、1+1冗余RMC管理模块及双路冗余电源接入,保障系统持续稳定运行,使得硬件维护不下电、整机供电不间断、散热效果无影响,随时管理可信赖,进一步确保客户数据安全。 建立新应用,真的就要花双份钱? 当客户面临建设新应用,买了一套整机柜服务器,但又想用集中存储时,是否还要再买一个机柜?答案是:否! 浪潮InCloudRack融合架构整机柜服务器在机柜上部专门预留了9U标准区间,为用户构建一体化解决方案提供了更广阔的设计空间。用户可根据应用灵活放置交换机、存储或机架式服务器等设备,轻松实现“一柜一落地,一柜一方案”。 据说整机柜服务器的统一管理不够友好? 由于整机柜服务器诞生于互联网行业的应用需求,而互联网行业用户的IT运维水平比较高,因此整机柜服务器的管理界面往往是采用命令行形式,这对传统行业用户来说,无疑增加了学习成本,加大了运维管理难度。 浪潮InCloudRack为了解决企业用户这一困扰,整机柜统一管理采用了友好的图形交互界面,使得运维管理人员可以轻松观察机器运行状态,对设备进行管理运维。 虽然整机柜服务器在硬件上实现了一体化,易交付、易管理,但还要准备软件及集成等工作,有什么省事的办法? 浪潮InCloudRack目前正在紧锣密鼓筹备一体化解决方案中,已率先推出基于浪潮InCloudRack加浪潮云海OS的云一体机和基于浪潮InCloudRack加浪潮大数据方案的大数据一体机,同时也在积极构建其它一体化解决方案。最终可实现整机柜服务器融合解决方案一体化交付,真正实现2小时从0到数据中心。 原文发布时间为:2017年3月21日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

加密库 libsodium 1.0.22 发布

libsodium 1.0.22 现已发布。此版本更新包含了 1.0.21-stable 版本的所有更改,此外还包括: 后量子密钥封装现已可用。ML-KEM768(the NIST-standardized lattice-based KEM)可通过crypto_kem_mlkem768_*()相关函数调用。 X-Wing 是一种混合型 KEM,它结合了 ML-KEM768 和 X25519,可同时抵御经典和量子攻击,可通过crypto_kem_*()函数调用。X-Wing 是大多数应用场景的推荐 KEM。 SHA-3 哈希函数现在以crypto_hash_sha3256_*()和crypto_hash_sha3512_*()的形式提供,同时提供one-shot 和 streaming API。 Version 1.0.21-stable 性能:针对 ARM 平台上的 Argon2 进行了 NEON 优化。 性能:SHA3 (Keccak1600) 现在在 ARM 平台上可用时会利用 ARM SHA3 指令。 性能:已添加 Argon2 的 WebAssembly SIMD 实现。 Emscripten:LTO 现已禁用。在 Emscripten 4 中,LTO 生成的 WebAssembly 模块中的函数运行速度明显低于未启用 LTO 的情况。 Emscripten:新增选项,允许使用 SIMD 支持进行编译。 Emscripten:现已支持原生 ESM 模块生成。 JavaScript sumo 构建现在允许使用高达 80 MiB 的内存,因此带有交互式设置的crypto_pwhash不仅可以在 WebAssembly 中使用,还可以在纯 JavaScript 中使用。 XOF 状态对齐要求已放宽。 crypto_core_keccak1600_state已添加。 导出缺失的crypto_ipcrypt_nd_keygen()辅助函数。 crypto_auth_hmacsha256_init和crypto_auth_hmacsha512_init现支持接受 NULL key 指针(即密钥长度为零),以与其他_init函数保持一致。 apple-xcframework:头文件现在位于 Clibsodium 子目录中,以防止 module.modulemap 与其他 xcframework 发生冲突。 修复了在 aarch64 和 gcc 4.x 上使用 GCC 进行编译的问题。 在 aarch64 架构上,即使不使用 clang,包括 MSVC,现在也启用了 aes256-gcm。 当工具集未定义 PlatformToolsetVersion 时,增加了与 Visual Studio 2026 的兼容性。 Libsodium 可以直接作为 Zig 项目的依赖项使用。 MSVC 构建的性能得到了提升。 更新说明:https://github.com/jedisct1/libsodium/releases/tag/1.0.22-RELEASE

优秀的个人博客,低调大师

加密库 libsodium 1.0.20 发布

libsodium 1.0.20 现已发布。此版本包含自 1.0.19-stable 以来的所有更改,主要解决编译问题和对 .NET 包的改进。 Building withzig build现在需要 Zig 0.12。 使用传统的 build system 时,使用 -O3 而不是 -Ofast。 改进了 aarch64 上所需的编译器标志的检测。 提高了与 aarch64 上自定义构建系统的兼容性。 apple-xcframework:如果 Xcode 不包含该 SDK,则不会构建 VisionOS 包。 添加了crypto_kdf_hkdf_sha512_statebytes()。 使用 Visual Studio 时,现在在 Windows/aarch64 上启用运行时 CPU 功能检测。 在 Windows 上使用 Swift 时,C++ guards 存在影响 libsodium 使用的问题。此问题现已修复。 Emscripten:crypto_aead_aegis*()函数现在可以在 JavaScript 构建中导出 Emscripten:不支持的--memory-init-file选项已被删除。 apple-xcframework:最小部署目标可以设置为 iOS 11+。 .NET 软件包现在包括适用于 Windows/arm64、iOS、TvOS 和 Catalyst 的预编译库。 .NET 预编译库现在可以在任何 CPU 上运行,仅使用 runtime feature 检测。 SYSV 程序集不应在针对 Windows 时使用。 已解决与 LLVM 18 和 AVX512 的兼容性问题。 GitHub attestation build provenance 现已添加到 NuGet 包中。 JavaScript 测试现在可以使用 Bun 作为 Node 的替代品。 更新说明:https://github.com/jedisct1/libsodium/releases/tag/1.0.20-RELEASE

优秀的个人博客,低调大师

加密库 libsodium 1.0.19 发布

libsodium 1.0.19 现已发布。此版本包含 1.0.18-stable 的所有更改,以及两项新增内容: New AEADs:crypto_aead_aegis128l_*()和crypto_aead_aegis256_*()命名空间中新增了 AEGIS-128L 和 AEGIS-256。AEGIS 是面向高性能应用的认证密码系列,利用 x86_64 和 aarch64 上的硬件 AES 加速。除性能外,AEGIS 密码还具有独特的特性,使其比 AES-GCM 更易于使用,也更安全。它们还可用作高性能 MAC。 crypto_kdf_hkdf_*()命名空间现在提供了许多标准协议所需的 HKDF 密钥生成机制。它是针对 SHA-256 和 SHA-512 哈希函数实现的。 osx.sh构建脚本已重命名为macos.sh 删除了对 android-mips 的支持。 From 1.0.18-stable: Visual Studio:添加了对 Windows/ARM64 builds的支持。 Visual Studio:在支持的 CPU 上启用了 AVX512 实现。 Visual Studio:添加了 MSVC 2022 解决方案。 Apple XCFramework:添加了对 VisionOS 的支持。 Apple XCFranework:添加了对 Catalyst 的支持。 Apple XCFramework:构建模拟器现在是可选的。 iOS:不再生成 bitcode,因为它已被 Apple 弃用。 watchOS:添加了对 arm64 的支持。 Zig 工具链现在可以用作现代构建系统来替换 autoconf/automake/libtool/make/ccache 和编译器。这可以实现更快的编译时间、更轻松的交叉编译以及针对任何 CPU 进行优化的静态库。 Zig 工具链现在是将libsodium编译为 WebAssembly/WASI(X) 的推荐方法。 libsodium 现在可以作为 Zig 项目的依赖项添加。 AES-GCM 实现被完全重写。现在它速度更快,并且也可在 aarch64 上使用,包括 Windows/ARM64。 新增了与 CET instrumentation / IBT / Shadow Stack 的兼容性。 Emscripten:已从 Sumo builds 中删除crypto_pwhash_*()函数,因为它们即使在未使用时也会占用大量 JavaScript 内存。 基准测试现在尽可能使用CLOCK_MONOTONIC。 WebAssembly:现在可以使用 Bun、WasmEdge、Wazero、wasm3 和 wasmer-js 运行测试。对 WAVM 和 Lucet 的支持已被删除,因为这些项目已达到 EOL。 .NET:支持的最低 macOS 版本现在为 1.0.15。 .NET:所有包现在都是在所有平台上使用 Zig 构建的。 .NET:ARM64 的软件包现在可用。 C23memset_explicit()现在可用。 编译时默认使用-Ofast或-O3而非-O2。 可移植性改进有助于将 libsodium 编译到现代游戏机。 JavaScript:不再设置默认的unhandledRejection处理程序。 略微加快 25519 操作速度。 OpenBSD:leverageMAP_CONCEAL。 详情可查看更新说明。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册