首页 文章 精选 留言 我的

精选列表

搜索[博客搭建],共10000篇文章
优秀的个人博客,低调大师

Windows上搭建Standalone模式的Spark环境

Java 安装Java8,设置JAVA_HOME,并添加 %JAVA_HOME%\bin 到环境变量PATH中 E:\java -version java version "1.8.0_60" Java(TM) SE Runtime Environment (build 1.8.0_60-b27) Java HotSpot(TM) 64-Bit Server VM (build 25.60-b23, mixed mode) Scala 下载解压Scala 2.11,设置SCALA_HOME,并添加 %SCALA_HOME%\bin 到PATH中 E:\ scala -verion Scala code runner version 2.11.7 -- Copyright 2002-2013, LAMP/EPFL Spark 下载解压Spark 2.1, 设置SPARK_HOME,并添加 %SPARK_HOME%\bin 到PATH中,此时尝试在控制台运行spark-shell,出现如下错误提示无法定位winutils.exe。 E:\>spark-shell Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties Setting default log level to "WARN". To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel). 17/06/05 21:34:43 ERROR Shell: Failed to locate the winutils binary in the hadoop binary path java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries. at org.apache.hadoop.util.Shell.getQualifiedBinPath(Shell.java:379) at org.apache.hadoop.util.Shell.getWinUtilsPath(Shell.java:394) at org.apache.hadoop.util.Shell.<clinit>(Shell.java:387) at org.apache.hadoop.hive.conf.HiveConf$ConfVars.findHadoopBinary(HiveConf.java:2327) at org.apache.hadoop.hive.conf.HiveConf$ConfVars.<clinit>(HiveConf.java:365) at org.apache.hadoop.hive.conf.HiveConf.<clinit>(HiveConf.java:105) at java.lang.Class.forName0(Native Method) at java.lang.Class.forName(Class.java:348) at org.apache.spark.util.Utils$.classForName(Utils.scala:229) at org.apache.spark.sql.SparkSession$.hiveClassesArePresent(SparkSession.scala:991) at org.apache.spark.repl.Main$.createSparkSession(Main.scala:92) at $line3.$read $$ iw $$ iw.<init>(<console>:15) at $line3.$read $$ iw.<init>(<console>:42) at $line3.$read.<init>(<console>:44) at $line3.$read$.<init>(<console>:48) at $line3.$read$.<clinit>(<console>) at $line3.$eval$.$print$lzycompute(<console>:7) at $line3.$eval$.$print(<console>:6) at $line3.$eval.$print(<console>) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43) at java.lang.reflect.Method.invoke(Method.java:497) at scala.tools.nsc.interpreter.IMain$ReadEvalPrint.call(IMain.scala:786) at scala.tools.nsc.interpreter.IMain$Request.loadAndRun(IMain.scala:1047) at scala.tools.nsc.interpreter.IMain$WrappedRequest $$ anonfun$loadAndRunReq$1.apply(IMain.scala:638) at scala.tools.nsc.interpreter.IMain$WrappedRequest $$ anonfun$loadAndRunReq$1.apply(IMain.scala:637) at scala.reflect.internal.util.ScalaClassLoader$class.asContext(ScalaClassLoader.scala:31) at scala.reflect.internal.util.AbstractFileClassLoader.asContext(AbstractFileClassLoader.scala:19) at scala.tools.nsc.interpreter.IMain$WrappedRequest.loadAndRunReq(IMain.scala:637) at scala.tools.nsc.interpreter.IMain.interpret(IMain.scala:569) at scala.tools.nsc.interpreter.IMain.interpret(IMain.scala:565) at scala.tools.nsc.interpreter.ILoop.interpretStartingWith(ILoop.scala:807) at scala.tools.nsc.interpreter.ILoop.command(ILoop.scala:681) at scala.tools.nsc.interpreter.ILoop.processLine(ILoop.scala:395) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply$mcV$sp(SparkILoop.scala:38) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply(SparkILoop.scala:37) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply(SparkILoop.scala:37) at scala.tools.nsc.interpreter.IMain.beQuietDuring(IMain.scala:214) at org.apache.spark.repl.SparkILoop.initializeSpark(SparkILoop.scala:37) at org.apache.spark.repl.SparkILoop.loadFiles(SparkILoop.scala:105) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply$mcZ$sp(ILoop.scala:920) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply(ILoop.scala:909) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply(ILoop.scala:909) at scala.reflect.internal.util.ScalaClassLoader$.savingContextLoader(ScalaClassLoader.scala:97) at scala.tools.nsc.interpreter.ILoop.process(ILoop.scala:909) at org.apache.spark.repl.Main$.doMain(Main.scala:69) at org.apache.spark.repl.Main$.main(Main.scala:52) at org.apache.spark.repl.Main.main(Main.scala) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43) at java.lang.reflect.Method.invoke(Method.java:497) at org.apache.spark.deploy.SparkSubmit$.org$apache$spark$deploy$SparkSubmit $$ runMain(SparkSubmit.scala:743) at org.apache.spark.deploy.SparkSubmit$.doRunMain$1(SparkSubmit.scala:187) at org.apache.spark.deploy.SparkSubmit$.submit(SparkSubmit.scala:212) at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:126) at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala) 从错误消息中可以看出Spark需要用到Hadoop中的一些类库(通过HADOOP_HOME环境变量,因为我们之前并未设置过,所以文件路径null\bin\winutils.exe里面出现了null),但这并不意味这我们一定要安装Hadoop,我们可以直接下载所需要的winutils.exe到磁盘上的任何位置,比如C:\winutils\bin\winutils.exe,同时设置 HADOOP_HOME=C:winutils 。 现在我们再次运行spark-shell,又有一个新的错误: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveSessionState': at org.apache.spark.sql.SparkSession$.org$apache$spark$sql$SparkSession $$ reflect(SparkSession.scala:981) at org.apache.spark.sql.SparkSession.sessionState$lzycompute(SparkSession.scala:110) at org.apache.spark.sql.SparkSession.sessionState(SparkSession.scala:109) at org.apache.spark.sql.SparkSession$Builder $$ anonfun$getOrCreate$5.apply(SparkSession.scala:878) at org.apache.spark.sql.SparkSession$Builder $$ anonfun$getOrCreate$5.apply(SparkSession.scala:878) at scala.collection.mutable.HashMap $$ anonfun$foreach$1.apply(HashMap.scala:99) at scala.collection.mutable.HashMap $$ anonfun$foreach$1.apply(HashMap.scala:99) at scala.collection.mutable.HashTable$class.foreachEntry(HashTable.scala:230) at scala.collection.mutable.HashMap.foreachEntry(HashMap.scala:40) at scala.collection.mutable.HashMap.foreach(HashMap.scala:99) at org.apache.spark.sql.SparkSession$Builder.getOrCreate(SparkSession.scala:878) at org.apache.spark.repl.Main$.createSparkSession(Main.scala:96) ... 47 elided Caused by: java.lang.reflect.InvocationTargetException: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveExternalCatalog': at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.SparkSession$.org$apache$spark$sql$SparkSession $$ reflect(SparkSession.scala:978) ... 58 more Caused by: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveExternalCatalog': at org.apache.spark.sql.internal.SharedState$.org$apache$spark$sql$internal$SharedState $$ reflect(SharedState.scala:169) at org.apache.spark.sql.internal.SharedState.<init>(SharedState.scala:86) at org.apache.spark.sql.SparkSession $$ anonfun$sharedState$1.apply(SparkSession.scala:101) at org.apache.spark.sql.SparkSession $$ anonfun$sharedState$1.apply(SparkSession.scala:101) at scala.Option.getOrElse(Option.scala:121) at org.apache.spark.sql.SparkSession.sharedState$lzycompute(SparkSession.scala:101) at org.apache.spark.sql.SparkSession.sharedState(SparkSession.scala:100) at org.apache.spark.sql.internal.SessionState.<init>(SessionState.scala:157) at org.apache.spark.sql.hive.HiveSessionState.<init>(HiveSessionState.scala:32) ... 63 more Caused by: java.lang.reflect.InvocationTargetException: java.lang.reflect.InvocationTargetException: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.internal.SharedState$.org$apache$spark$sql$internal$SharedState $$ reflect(SharedState.scala:166) ... 71 more Caused by: java.lang.reflect.InvocationTargetException: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.hive.client.IsolatedClientLoader.createClient(IsolatedClientLoader.scala:264) at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:358) at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:262) at org.apache.spark.sql.hive.HiveExternalCatalog.<init>(HiveExternalCatalog.scala:66) ... 76 more Caused by: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at org.apache.hadoop.hive.ql.session.SessionState.start(SessionState.java:522) at org.apache.spark.sql.hive.client.HiveClientImpl.<init>(HiveClientImpl.scala:188) ... 84 more Caused by: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at org.apache.hadoop.hive.ql.session.SessionState.createRootHDFSDir(SessionState.java:612) at org.apache.hadoop.hive.ql.session.SessionState.createSessionDirs(SessionState.java:554) at org.apache.hadoop.hive.ql.session.SessionState.start(SessionState.java:508) ... 85 more <console>:14: error: not found: value spark import spark.implicits._ ^ <console>:14: error: not found: value spark import spark.sql ^ Welcome to ____ __ / __/__ ___ _____/ /__ _\ \/ _ \/ _ `/ __/ '_/ /___/ .__/\_,_/_/ /_/\_\ version 2.1.1 /_/ Using Scala version 2.11.8 (Java HotSpot(TM) 64-Bit Server VM, Java 1.8.0_60) Type in expressions to have them evaluated. Type :help for more information. scala> 错误消息中提示零时目录 /tmp/hive 没有写的权限: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- 所以我们需要更新E:/tmp/hive的权限(我在E盘下运行的spark-shell命令,如果在其他盘运行,就改成对应的盘符+/tmp/hive)。运行如下命令: E:\>C:\winutils\bin\winutils.exe chmod 777 E:\tmp\hive 再次运行spark-shell,spark启动成功。此时可以通过 http://localhost:4040 来访问Spark UI

优秀的个人博客,低调大师

用本机电脑搭建网站

最近又准备瞎捣鼓一下个人网站。本来呢,如果是自己玩玩的话,用花生壳或者NAT123这样的动态DNS解析就可以了。但是最近花生壳这个吊玩意不知道怎么又没办法解析了。而且这货给的域名用的是我的手机号,如此一来个人隐私也暴露了。所以今天我就来研究一下自己购买域名并设置解析。 本机网站 这一部分其实非常自由,用你最喜欢、最熟悉的技术,想怎么来就怎么来。不管是Java、Python、PHP、ASP.NET还是什么的,只要你电脑能运行起来就行。 这里我为了测试就直接用IIS新建了一个空网站,里面只放了一个index.html。然后在浏览器中测试一下,看看是否能够访问。如果显示缺少什么权限的话,可能需要在网站文件夹的属性中添加IIS_IUSRS用户的读取权限。 IIS网站 购买域名 如果你想正式运营一个网站的话,最好购买一个cn域名,这样审核、备案什么的都很方便。如果只是瞎玩玩,那么可以随便买个顺眼的域名。需要注意好像只有cn和com的域名才能备案,所以如果你购买了其他域名的话,只能自己瞎搞了。 现在国内主流的云厂商都可以方便的购买域名。我为了省事就直接在阿里云上买了一个me域名,直接用支付宝付款就行了。反正也不备案了,自己瞎玩玩。 设置DNS解析 域名也有了,下面就可以设置DNS解析了。由于国内政策比较严格,所以好像大部分DNS解析都需要备案才行。如果你使用云主机来做网站,那么必须进行备案。如果是自己的电脑的话,好像暂时不用备案。这里我用阿里云的解析,发现可以成功解析,但是不知道可以使用多长时间。 如果过几天网站不能访问了,那么只能使用外国的DNS解析服务了。我查了一下,下面两篇文章列出了一些免费的外国DNS解析服务,如果有需要的话可以参考一下。 8个国外免费DNS域名解析网站 免费域名解析服务 由于我国IPv4地址资源非常紧张,所以基本上没办法向美国那样奢侈的使用IP地址。如果电脑没有公网IP地址的话,是没办法直接进行DNS解析的。所以第一步就是在路由器中设置端口转发或者是DMZ功能。 所谓端口转发,就是将经过路由器某个端口的请求全部转发到内部局域网中某台电脑上。如果只需要开启这么一个端口,使用端口转发是很方便的。DMZ则相反,它是将内部的主机暴露到了公网中,对公网IP地址的访问会全部代理到内部的主机上。为了省事,我就直接把自己的电脑用DMZ暴露了出来。 需要注意,路由器设置DMZ的话,自己的电脑就暴露到了互联网上了。所以最好保持防火墙始终开启的状态。 设置完成之后,我们就有了可以添加到DNS解析中的公网IP地址。我们进入阿里云解析,根据需求,设置www解析或者@解析。等待几分钟之后,打开浏览器,输入申请好的域名,即可看到相应的网站。 申请免费SSL证书 有了个人网站,最好在申请一个免费的SSL证书,增加安全性。我查了一下对于个人用户来说,腾讯云提供的服务就非常不错,免费的,而且时长为一年。申请方法很简单,进入腾讯云SSL,然后点击这里的申请证书。 腾讯云SSL 然后选择左边的免费版DVSSL证书,按照提示在阿里云DNS设置中添加一个TXT解析。服务器会自动读取DNS解析并验证。验证完成之后,就可以下载生成的SSL证书了。 免费SSL 下载好的证书有Apache、IIS和Nginx三种版本的。按照所用的服务器设置相应的SSL即可。需要注意,浏览器会对域名进行验证。所以如果域名不匹配的话,是不会出现绿色的HTTPS标志的。 未经过浏览器验证的SSL证书 只有使用申请证书时使用的域名进行访问,浏览器才能确认这个SSL证书是可信的。 验证通过 设置完成之后,我们就拥有了一个安全的个人网站。如果懂得一点Web技术的话,现在就可以做一个个人网站,然后发布出来,让别人看到。是一件很有成就感的事情哦!

优秀的个人博客,低调大师

在Windows平台上搭建Docker开发环境

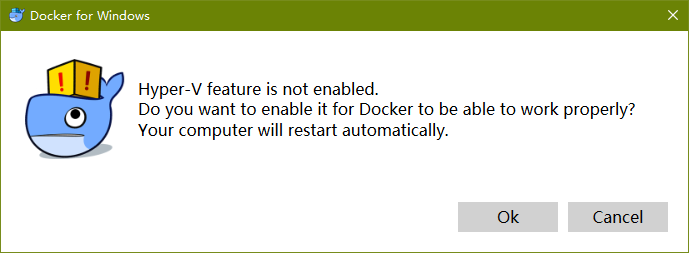
本文介绍的是如何在Windows系统上安装Docker运行环境。Docker官方提供了Windows平台上的安装包,这个安装包会打开Windows平台上的HyperV虚拟机。所以如果不喜欢使用HyperV虚拟机或者有需要使用其他虚拟机软件的话,可以自己在Linux虚拟机中安装Docker。 安装Docker 安装Docker For Windows 首先打开Docker下载页面,然后下载Docker For Windows安装包。注意这个安装包是针对最新的Windows 10系统的,如果使用Windows 8之类的,请下载旧版本的Docker。 安装之后可能会弹出这么一个对话框,提示我们说HyperV未开启,询问我们是否要开启HyperV,我们选择是,然后电脑会重启。之后一切就准备就绪了。 未开启HyperV 电脑重启之后,我们应该可以在任务栏上找到一个Docker图标,右键点击选择version会弹出这样的对话框。如此一来,Docker就安装完毕了。 Docker版本 安装Kitematic 右键点击Docker图标,会看到有一项名字叫 Kitematic,这是一个Docker可视化工具,推荐大家安装。我们点击这个菜单项,就会弹出一个对话框提示我们下载Kitematic,然后放到C:\Program Files\Dockder\Kitematic中。 然后打开Kitematic,我们可以看到如下的样子。在这里可以非常方便的下载、开启、关闭Docker镜像。如果你注册了Docker账号的话,还可以上传自己的Docker镜像,让大家一起使用。 Kitematic 使用Docker 设置阿里云加速器 在下载Docker之前,我们需要先配置一下加速器。由于Docker的服务器在国外,所以下载镜像的速度不太理想。国内因此有了很多加速服务,其中最好用的还是阿里云的。我们打开Docker 镜像服务,登录账号之后,获取自己创加速器地址。然后使用docker-machine创建一个新的虚拟机并使用加速器来加速。 docker-machine create --engine-registry-mirror=https://XXX.mirror.aliyuncs.com -d hyperv default 当然如果你有自己的代理的话,也可以直接在Docker设置中设置代理。 安装镜像 我们在Kitematic中搜索hello-world,然后安装。当然如果使用命令行的话也可以,输入docker pull hello-world即可。 docker hello-world 安装完成之后运行docker run hello-world即可看到如下的输出。 hello-world 进入镜像执行环境 在Kitematic中点击一个正在运行的镜像,然后点击右边的EXEC,就可以打开对应的执行环境了。 redis 默认情况下的shell是sh,不太好用。我们可以点击Kitematic下面的docker-cli右边的齿轮图标,然后将shell设置为bash。 docker-cli设置 配置镜像 在镜像右边还有一个车Settings标签,点进来之后可以对镜像进行各种配置,如设置端口号、设置数据分区等等。 配置镜像 利用Docker,我们可以做很多事情。由于很多软件例如Redis之类的,主要设计为在Linux下工作,虽然有Windows下的版本,但是仍然有很多不足之处。利用Docker,我们可以在Linux环境下运行这些程序,又可以在Windows下开发,简直两全其美!

优秀的个人博客,低调大师

[Docker系列·12] 搭建Kafka服务器

1 Docker-Ubuntu-Kafka 工作目录:/home/erichan/docker-room/ubuntu-kafka 1.1 制作镜像 erichan@ubuntu14_04_1-pd:~/docker-room/ubuntu-zookeeper$ nano Dockerfile # Version: 0.0.1 FROM feuyeux/ubuntu-java7 MAINTAINER Eric Han "feuyeux@gmail.com" RUN apt-get update && apt-get install -y wget unzip git RUN wget -q http://apache.fayea.com/apache-mirror/kafka/0.8.1.1/kafka_2.10-0.8.1.1.tgz RUN tar -xzf kafka_2.10-0.8.1.1.tgz -C /opt ENV KAFKA_HOME /opt/kafka_2.10-0.8.1.1 ADD start-kafka.sh /usr/bin/start-kafka.sh RUN chmod 777 /usr/bin/start-kafka.sh CMD start-kafka.sh start-kafka.sh sed -r -i "s/(zookeeper.connect)=(.*)/\1=$ZK_PORT_2181_TCP_ADDR/g" $KAFKA_HOME/config/server.properties sed -r -i "s/(broker.id)=(.*)/\1=$BROKER_ID/g" $KAFKA_HOME/config/server.properties sed -r -i "s/#(advertised.host.name)=(.*)/\1=$HOST_IP/g" $KAFKA_HOME/config/server.properties sed -r -i "s/^(port)=(.*)/\1=$PORT/g" $KAFKA_HOME/config/server.properties if [ "$KAFKA_HEAP_OPTS" != "" ]; then sed -r -i "s/^(export KAFKA_HEAP_OPTS)=\"(.*)\"/\1=\"$KAFKA_HEAP_OPTS\"/g" $KAFKA_HOME/bin/kafka-server-start.sh fi $KAFKA_HOME/bin/kafka-server-start.sh $KAFKA_HOME/config/server.properties start-broker.sh #!/bin/bash ZOOKEEPER=`sudo docker ps -a | awk '{print $NF}' | grep "zk346$"` ZOOKEEPER_RUNNING=$? if [ $ZOOKEEPER_RUNNING -eq 0 ] ; then echo "ZooKeeper is already running" else echo "Starting Zookeeper" sudo docker run -p 49181:2181 -h zookeeper --name zk346 -d feuyeux/zookeeper:3.4.6 fi ID=$1 PORT=$2 HOST_IP=$3 echo "BROCKER-ID=$ID KAFKA=$HOST_IP:$PORT" sudo docker run -p $PORT:$PORT --name kafka081_$4 --link zk346:zk -e BROKER_ID=$ID -e HOST_IP=$HOST_IP -e PORT=$PORT -d feuyeux/kafka:0.8.1 erichan@ubuntu14_04_1-pd:~/docker-room/ubuntu-kafka$ chmod +x start-broker.sh 1.2 创建镜像 erichan@ubuntu14_04_1-pd:~/docker-room/ubuntu-kafka$ d build -t feuyeux/kafka:0.8.1 . 1.3 测试镜像 d kill $(d ps -q) && d rm $(d ps -a -q) cd ~/docker-room/ubuntu-kafka ./start-broker.sh 101 9093 10.16.41.135 1 ./start-broker.sh 102 9094 10.16.41.135 2 脚本自动执行:d run -p 49181:2181 -h zookeeper --name zk346 -d feuyeux/zookeeper:3.4.6 d ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 78a84862a311 feuyeux/kafka:0.8.1 "/bin/sh -c start-ka 3 seconds ago Up 3 seconds 22/tcp, 0.0.0.0:9094->9094/tcp kafka081_2 951ff2d3296a feuyeux/kafka:0.8.1 "/bin/sh -c start-ka 12 seconds ago Up 11 seconds 22/tcp, 0.0.0.0:9093->9093/tcp kafka081_1 efbd8d713866 feuyeux/zookeeper:3.4.6 "/opt/zookeeper-3.4. 12 seconds ago Up 12 seconds 2888/tcp, 3888/tcp, 22/tcp, 0.0.0.0:49181->2181/tcp kafka081_1/zk,kafka081_2/zk,zk346 erichan@ubuntu14_04_1-pd:~/docker-room/ubuntu-kafka$ 参考 https://github.com/wurstmeister/kafka-docker https://github.com/apache/kafka/tree/0.8.1/examples/src/main/java/kafka/examples

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册