首页 文章 精选 留言 我的

精选列表

搜索[语言切换],共10000篇文章
优秀的个人博客,低调大师

GoLand 2019.2.1 发布,JetBrains 打造的 Go 语言 IDE

GoLand 2019.2.1 已发布,这是对GoLand 2019.2 的 bug-fix 更新版本。更新内容包括对 UI 的修复、对自动补全代码功能的改进、对导入功能的优化、改进 SQL 注入功能以及改进代码格式化工具等。 下载地址和详细更新内容说明请查看发布公告。 而 GoLand 今年第二个重大版本 2019.2 的主要更新内容是对调试器功能的增强:调试器中支持函数调用,并在变量面板中显示String(),Error()和DebugString()方法的返回结果。其他一些改进包括引入精心设计的 Default&Darcula 颜色方案、支持自定义的 Postfix Completion 模板、更智能的 Go Modules 和dep 集成。 最重要的是,GoLand 2019.2 增加了对 Go 1.13 中引入的新功能的支持,基于 Change Signature 重构的各种快速修复,以及许多新的代码编辑功能。例如可以使用对 Shell 脚本和对 Kustomize for Kubernetes 的支持,最后同样重要的是,Extract Method 重构现在可以处理包含 return 语句的代码,详情点此查看。 调试器中支持函数调用 对 Go 1.13 的支持 GoLand 2019.2 支持将数字字面量和符号型整数作为位移次数。 更智能的Go Modules 和dep 集成 当 GoLand 2019.2 检测到项目使用 Go Modules 或 dep 时,它将自动启用 Go Modules/dep 集成功能。 代码检查 名为冗余类型转换(Redundant type conversions)的代码检查功能可帮助保持项目的可读性和整洁性。它会对可以省略的冗余类型转换发出警告。 UI 改进 详细的更新内容介绍请点此查看。

优秀的个人博客,低调大师

ABAP Netweaver体内的那些寄生式编程语言

今天这篇文章的主题是:寄生。 Jerry最近看到朋友圈里一位朋友分享的一张寄居蟹的照片,对于Jerry这种在内地长大的又很宅的人来说,没有机会看到寄居蟹,所以觉得很新鲜: 寄居蟹主要以螺壳为寄体,寄居的最大螺体直径可达15厘米以上。其外形介于虾和蟹之间,多数寄居于螺壳内。 另一种比较出名的寄生生物,就是Jerry小时候在电视上看到的《异形》,这种生物通过卵生的方式降生,成为下图这种俗名叫抱脸虫的二阶形态后,通过口器管将异形幼虫注入宿主体内,这样抱脸虫就完成了自己的使命,不多时便会死去。 异形幼虫在宿主体内发育约一天后,会从宿主体内破腔而出,经历如蚕宝宝的几次蜕皮后,成长为完全体。 Jerry距离寄生式生物最近的一次,就是前年全家去西岭雪山泡温泉,当时看到有一个室外游泳池,马上跳下去游起来。 正游得高兴,透过泳镜一看,一只像头发丝一样,长约十余

优秀的个人博客,低调大师

聊聊新的Go语言错误处理方案

今天早些时候,golang/x/exp中默默的更新了一个名曰xerrors的包,这个包和同样处于golang/x/exp下的另一个名叫errors的包名字十分相似,就连介绍也都一致: Package errors implements functions to manipulate errors. This package implements the Go 2 draft designs for error inspection and printing 从目前的情况来看,基本上错误的处理形式基本已经定型,处理方式则是类似于之前的另一个github.com/pkg/errors包,但是具体细节不尽相同。 如何处理error? 在之前介绍文章中提到过github.com/pkg/errors包的设计思路,那么在Go团队的实现中,这种思

优秀的个人博客,低调大师

关于python语言优化的一些思考

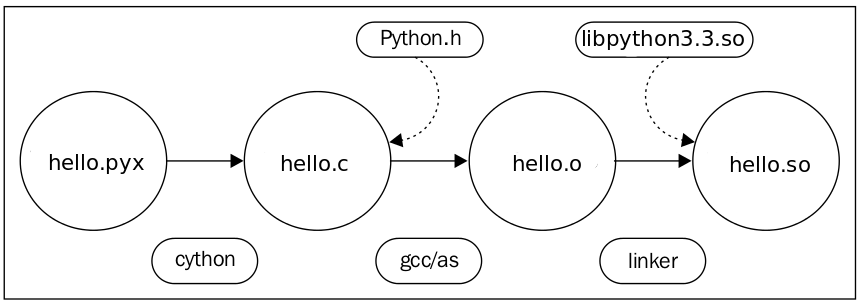
最近一直在做python工程化相关的工作,颇有心得,遂总结一下。一是为了整理思绪,二是为了解放自己健忘的大脑。 python是一个C的语法糖盒子 原生的python通常都是由cpython实现,而cpython的运行效率,确实让人不敢恭维,比较好的解决方案有cython、numba、pypy等等 cython 是目前我认为发展最好,最靠谱的一项Python加速解决方案。 使用cython编译过后的代码,通常会对原python代码有2倍以上的速度提升。cython的编译也很简单,只需要构建一个setup.py,然后执行: python setup.py build_ext numba numba也是我比较看好的,它的亮点在于使用装饰器的方式应用jit技术,例如下面的代码: @jit def run_xxx(): ... 可直接将run_xxx方法进行高效的c编译。但在大多数应用场景下(尤其是采取了服务拆分或微服务的架构策略),这种功能反而让人有种鸡肋的感觉 只能说numba更适用于模型开发的场景,在模型应用和部署的环节,numba的作用很尴尬 pypy pypy相对比较小众,这是由于它本身的限制条件较多,尤其是对python第三方包的支持上面更是非常局限。由于我在做python开发的过程中,经常需要限制版本,以及引入较多的第三方包,所以pypy就不在考虑的范围内了 不要轻易相信声称自己很快的模块和方法 曾经在网上看到有人发文,声称numpy是目前python下非常高效的一个模块,而numpy的“娘亲们”,甚至把自己夸上了天,说自己如何如何高效。而国内的一些伪专家们,也是盲目的“助纣为虐”,说什么如果你不太懂,请不要轻易去优化numpy云云,难道你自认为优化的算法能胜过numpy里内置的久经考验的算法?真的是误人子弟!很多人在这里就被唬住了,代码分析到numpy的环节,就不敢往下走了。我想说的是,对一切永远保持怀疑的精神才是真正的科学素养,是不是真的高性能,一切要用数据说话。刚开始,我也被短暂的唬住了,毕竟numpy的底层也没接触过,但profiler分析的结果告诉我,问题就出在numpy里,结果发现在我的项目场景里,使用dict能完全替代numpy的所有操作,性能一下提高了很多,而numpy的高效在于ndarray 所以,采取什么数据结构要看应用场景,没有万能的高效数据结构 不要以为排除法是万能的 优化代码的过程中,因为我的以往成功“经验”,也导致走了不少弯路,最主要的,就是盲目使用排除法。使用排除法只能使用二分查找或快排的策略去组织代码,如果目标代码比较少还可以,事实上,在真实场景中往往有成百上千行目标代码。人工执行和实现O(logN)量级的操作,似乎是一种蛮干。 这里有几个度量工具顺便记录下: py_spy https://github.com/benfred/py-spy方便的生成CPU执行方法的火焰图 line_profiler https://github.com/rkern/line_profiler逐行代码分析,不要小看它的能力,它还可以指定要分析的方法和模块 量变真的会引起质变 在很多人的习惯性逻辑思维里,一个程序的性能,随着代码的优化,会是一条平滑的增长曲线。但实践表明,这个逻辑确实有问题。通过不断对代码的优化,我发现,程序的性能到达一定阶段会发生“突变”,或者“阶跃”。上一次优化的执行时间几百毫秒,下一次优化后的执行时间竟然只有几十毫秒,说发生了“阶跃”一点都不夸张。为什么会这样?至少在我的朋友圈里,还没有人能给我令人信服的答案,我自认为比较可靠的理解是,现代操作系统在cpu指令的处理上,对cpu的任务分配还不是那么“流畅”。哪位朋友有好的见解,欢迎批评指正!

优秀的个人博客,低调大师

Pyhanlp自然语言处理中的新词识别

新词发现 本“新词发现”模块基于信息熵和互信息两种算法,可以在无语料的情况下提取一段长文本中的词语,并支持过滤掉系统中已存在的“旧词”,得到新词列表。 调用方法 静态方法 一句话静态调用接口已经封装到HanLP中: /** * 提取词语 * * @param text 大文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size) /** * 提取词语 * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size) throws IOException /** * 提取词语(新词发现) * * @param text 大文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size, boolean newWordsOnly) /** * 提取词语(新词发现) * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size, boolean newWordsOnly) throws IOException 调用示例请参考com.hankcs.demo.DemoNewWordDiscover。 值得注意的是,在计算资源允许的情况下,文本越长,结果质量越高。对于一些零散的文章,应当合并为整个大文件传入该算法。 高级参数 根据语料的长度或用词的不同,默认的参数有可能不能得到最佳的结果。我们可以通过构造不同的NewWordDiscover调整提取算法。该构造函数如下: /** * 构造一个新词识别工具 * @param max_word_len 词语最长长度 * @param min_freq 词语最低频率 * @param min_entropy 词语最低熵 * @param min_aggregation 词语最低互信息 * @param filter 是否过滤掉HanLP中的词库中已存在的词语 */ public NewWordDiscover(int max_word_len, float min_freq, float min_entropy, float min_aggregation, boolean filter) 其中: · max_word_len控制识别结果中最长的词语长度,默认值是4;该值越大,运算量越大,结果中出现短语的数量也会越多。 · min_freq控制结果中词语的最低频率,低于该频率的将会被过滤掉,减少一些运算量。由于结果是按照频率排序的,所以该参数其实意义不大。 · min_entropy控制结果中词语的最低信息熵的值,一般取0.5左右。该值越大,越短的词语就越容易被提取出来。 · min_aggregation控制结果中词语的最低互信息值,一般取50到200.该值越大,越长的词语就越容易被提取出来,有时候会出现一些短语。 · filter设为true的时候将使用内部词库过滤掉“旧词”。

优秀的个人博客,低调大师

学习Python语言 基础语法:变量的基本使用

Python变量 程序是用来处理数据的,变量就是用来保存数据的,通过给数据定义一个名称来保证方便记忆和识别、使用这个数据。变量可以保存所有类型的数据。 Python变量的定义 在Python中,变量的定义可以不定义变量的类型,这与PHP一样。 同时,在使用变量前必须给变量赋值。(这与上述的观点一致,都没有数据,用啥呢?) 赋值的格式如下: 左边是变量名称,中间使用“=”号,右边为数据,基本可以记忆为“将右边的数据用左边的名称”替代。也可以多变量赋值,如:变量1=变量2=变量3=“数据”,如图: 在学习中有迷茫不知如何学习的朋友小编推荐一个学Python的学习q u n 227 -435- 450可以来了解一起进步一起学习!免费分享视频资料 变量赋值示例 一些Python已经定义的类型 Python有五个标准的数据类型: Numbers(数字) String(字符串) List(列表) Tuple(元组) Dictionary(字典) 其中Numbers支持int、float、long、complex类型 String为字符串,可以使用[头下标:尾下标]来获取子字符串,其中头下标可以从左到右,默认0开始,尾下标可以从右到左,默认-1开始,用来截取子字符串。如: 字符串示例 List为列表,用“[]”来标识,它可以包含多种类型,也可以像String的用法一样,使用[头下标:尾下标]来获取子列表,如: 列表示例 Tuple元组,用“()”来标识,更像是List的缩减版,一旦定义以后就不能编辑,只能读取,如: 元组示例 Dictionary字典,用“{}”来标识,类似于java的map,由索引“key”和值“value”组成,取值时也是由“key”定位取得“value”,如: 字典示例 关于数据类型的转换,可以通过转换函数进行转换,如:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册