首页 文章 精选 留言 我的

精选列表

搜索[mvc框架],共10000篇文章
优秀的个人博客,低调大师

Gearman——分布式任务分发框架

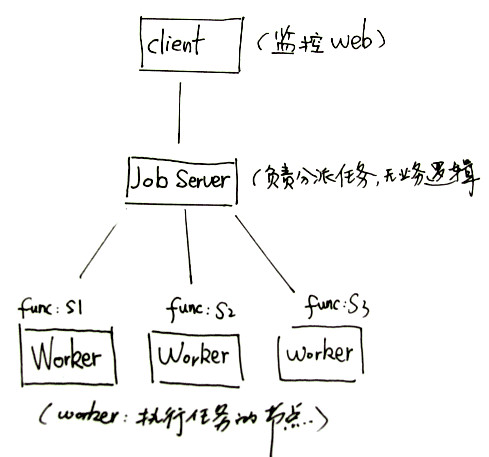
工作中我们有时候会遇到比如需要同时发布数据到多个个服务器上,或者同时处理多个任务。可以使用PHP的curl_multi的方式并发处理请求,但是由于网络和数据以及各个服务器等等的一些情况导致这种并发处理的响应时间很慢,因为在并发请求的过程中还包括记录日志,处理数据等逻辑,等待处理结果并返回,所以也不能友好的满足后台操作的体验。 现在有另外一种方案,利Gearman来实现并发的需求。通过Client将请求发送到Gearman的Jobs,在每个Work中来再来进行curl_multi和数据处理和日志等一些操作,同时用supervisor 来监控Gearman以及Works的进程,这样可以实现一个并行的多进程和负载均衡的方案。 Gearman可以做什么: 异步处理:图片处理,订单处理,批量邮件/通知之类的 要求高CPU或内存的处理:大容量的数据处理,MapReduce运算,日志聚集,视频编码 分布式和并行的处理 定时处理:增量更新,数据复制 限制速率的FIFO处理 分布式的系统监控任务 Gearman工作原理: 使用Gearman的应用通常有三部分组成:一个Client、一个Worker、一个 任务服务器。 Client的作用是提出一个 Job 任务 交给 Job Server 任务服务器。Job Server 会去寻找一个 合适的 Worker 来完成这项任务。Worker 执行由 Client 发送过来的 Job,并且将结果通过 Job Server 返回给 Client。Gearman 提供了 Client 和 Worker 的 API,利用这些API 应用可以同 Gearman Job Server来进行通信。Gearman 内部 Client 和 Worker 之间的通信都是通过 TCP 连接来进行的。 通常,多语言多系统之间的集成是个大问题,一般来说,人们多半会采用WebService的方式来处理此类集成问题,但不管采用何种风格的WebService,如RPC风格,或者REST风格,其本身都有一定的复杂性。相比之下,Gearman也能实现类似的作用,而且更简单易用。 一个Gearman请求的处理过程涉及三个角色:Client -> Job -> Worker。 Client:请求的发起者,可以是C,PHP,Perl,MySQL UDF等等。 Job:请求的调度者,用来负责协调把Client发出的请求转发给合适的Work。 Worker:请求的处理者,可以是C,PHP,Perl等等。 因为Client,Worker并不限制用一样的语言,所以有利于多语言多系统之间的集成。 甚至我们通过增加更多的Worker,可以很方便的实现应用程序的分布式负载均衡架构。 3 Gearman下载 1)官网 http://gearman.org/ 2)官网下载 https://launchpad.net/gearmand 3)官网使用向导 http://gearman.org/getting-started/ 3)本次安装用到的所有软件下载地址(安装环境为CentOS-6.5) http://download.csdn.net/detail/clevercode/8698699 4 Gearman安装 4.1 安装linux必备常用库 Linux中必备常用支持库的安装:http://blog.csdn.net/clevercode/article/details/45438401 4.2 安装gearmand依赖的库 # yum install -y boost-devel gperf libevent-devel libuuid-devel 4.3 安装gearmand服务 1)解压 # cd /usr/local/src/gearman # tar xzf gearmand-1.1.12.tar.gz 2)配置 # cd gearmand-1.1.12 # ./configure 3)编译 # make 4)安装 # make install 5)安装成功图,输入 # gearman 5 安装php扩展 1)安装phpize # yum install -y php-devel 2)解压 # cd /usr/local/src/gearman # tar xzf gearman-1.1.2.tgz 3)配置 # cd gearman-1.1.2 # phpize # ./configure 4)编译 # make 5)安装 # make install 6)安装成功 出现“Installing shared extensions: /usr/lib64/PHP/modules/”表示安装成功,/usr/lib64/php/modules/是gearman.so扩展的目录。如图 7)配置(加入扩展) # vi /usr/local/php5/etc/php.ini extension="gearman.so" 8)查配置是否成功 # vi test.php print gearman_version() . "\n"; ?> 执行php test.php后,出现1.1.12表示安装成功 # php test.php 1.1.12 6 Gearman启动停止 1) 创建日志/data0/logs/gearmand.log # touch /data0/logs/gearmand.log 2)启动 # /usr/local/sbin/gearmand -d -u root -L 192.168.142.130 --log-file=/data0/logs/gearmand.log 3)参数详解 -b,--backlog= 储备的监听连接数量 -d, --daemon 后台运行 -f, --file-descriptors= 文件描述符的数量 -h, --help 帮助 -j, --job-retries= 在ob server移除不可用job之前运行的次数,防止不断运行导致其他可用worker崩溃。默认没有限制 -l, -log-file= 日志文件存放位置(默认记录最简单日志) -L, --listen= 监听的IP,默认全部接受 -p, --port= 指定监听端口 -P, --pid-file= 指定进程ID写入位置 -r, --protocol= 加载协议模块 -q, --queue-type= 指定持久化队列 -t, --threads= 使用的I/9线程数量。默认为0 -u, --user= 启动后,切换到指定用户 -v, --verbose 增加一级详细程度 -V, --version 显示版本信息 4)查是否运行 # ps axu | grep gearmand 5)查看监听端口 # netstat -anp | grep 4730 6)停止,直接kill掉进程。 7 Gearman使用 7.1 创建Worker 创建worker.php,创建一个发送邮件的Worker端。代码如下 [php]view plaincopy $worker=newGearmanWorker(); $worker->addServer('192.168.142.130','4730'); $worker->addFunction("sendMail","my_sendmail_function"); while($worker->work()); functionmy_sendmail_function($job){ //接收数据 $tmp=$job->workload(); $receiveArr=unserialize($tmp); $from=$receiveArr['from']; $to=$receiveArr['to']; $subject=$receiveArr['subject']; $content=$receiveArr['content']; //发送邮件 //.... return$subject.'sendmailOK'; } ?> 7.2 启动Worker端 如果处理的数据量大,可以执行以下脚本多次,即启动多个Worker端。 # nohup php worker.php > tmp.txt & 7.3 创建Client(阻塞模式,需要等待返回结果才结束) 创建一个client.php。do()方法是阻塞模式,必须等待worker端返回结果,程序才能停止。(如图返回:hello Gearman sendmail OK) [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //等到worker端返回结果,才会结束。 $ret=$client->do("sendMail",$job); echo$ret."\r\n"; ?> 7.4 创建Client(非阻塞,不用等结果) 创建一个client2.php。doBackground()不用等待worker端返回结果,程序就结束了。 [php]view plaincopy $client=newGearmanClient(); $client->addServer('192.168.142.130','4730'); $job=array(); $job['from']='Code'; $job['to']='Gearman'; $job['subject']='helloGearman'; $job['content']='helloGearman:thisisfromGearmanClient'; $job=serialize($job); //不等待返回结果,就会结束 $ret=$client->doBackground("sendMail",$job); echo$ret."\r\n"; ?> 8 Gearman管理 输入以下命令,查看4730端口情况。 # (echo "status" ; sleep 2 ) | telnet 192.168.142.130 4730 1)字段说明:"已知注册的任务" "正在运行的任务" "队列中的任务" "可用的 Worker". 2)sendMail 0 0 1,注册的任务名为 sendMail,0 个正常在运行,队列为空,有一个可用的 Worker.

优秀的个人博客,低调大师

6种Java序列化框架

下面介绍几种常用的Java序列化技术,耗时比较,单位纳秒 0.002511:com.my.tools.serialize.KryoRegisterSerialize 0.007207:com.my.tools.serialize.FSTSerialize 0.00811:com.my.tools.serialize.KryoSerialize 0.010137:com.my.tools.serialize.GsonSerialize 0.012367:com.my.tools.serialize.FastjsonSerialize 0.021474:com.my.tools.serialize.JDKSerialize 1.JDKSerialize 方法一:若Student类仅仅实现了Serializable接口; 方法二:若Student类仅仅实现了Serializable接口,并且还定义了readObject(ObjectInputStream in)和writeObject(ObjectOutputSteam out); 方法三:若Student类实现了Externalnalizable接口,且Student类必须实现readExternal(ObjectInput in)和writeExternal(ObjectOutput out)方法, [java] view plain copy publicstaticbyte[]serialize(Objectobj){try{ByteArrayOutputStreambaos=newByteArrayOutputStream();ObjectOutputStreamoos=newObjectOutputStream(baos);oos.writeObject(obj);byte[]bs=baos.toByteArray();baos.close();oos.close();returnbs;}catch(IOExceptione){thrownewRuntimeException(e);}}publicstaticObjectdeserialize(byte[]bits){try{ByteArrayInputStreambais=newByteArrayInputStream(bits);ObjectInputStreamois=newObjectInputStream(bais);Objectobj=ois.readObject();bais.close();ois.close();returnobj;}catch(Exceptione){thrownewRuntimeException(e);}} 2.FastjsonSerialize 一个JSON库涉及的最基本功能就是序列化和反序列化。Fastjson支持java bean的直接序列化。 使用com.alibaba.fastjson.JSON这个类进行序列化和反序列化。 [java] view plain copy publicstaticStringserialize(Objectobj){Stringjson=JSON.toJSONString(obj);returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){Objectobj=JSON.parseObject(json,clazz);returnobj;} 3.FSTSerialize FST fast-serialization 是重新实现的 Java 快速对象序列化的开发包。序列化速度更快(2-10倍)、体积更小,而且兼容 JDK 原生的序列化。 要求 JDK 1.7 支持。 Java 快速序列化库 FST 已经发布了 2.0 版本,该版本的包名已经更改,无法平滑升级。另外官方建议为了稳定性考虑还是使用最新的 1.58 版本为好 [java] view plain copy staticFSTConfigurationconfiguration=FSTConfiguration.createDefaultConfiguration();publicstaticbyte[]serialize(Objectobj){returnconfiguration.asByteArray((Serializable)obj);}publicstaticObjectdeserialize(byte[]sec){returnconfiguration.asObject(sec);} 4.GsonSerialize 这里采用JSON格式同时使用采用Google的gson-2.2.4.jar 进行转义. [java] view plain copy staticGsongson=newGson();publicstaticStringserialize(Objectobj){Stringjson=gson.toJson(obj);returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){Objectobj=gson.fromJson(json,clazz);returnobj;} 5.JacksonSerialize Jackson库(http://jackson.codehaus.org),是基于java语言的开源json格式解析工具,整个库(使用最新的2.2版本)包含3个jar包: jackson-core.jar——核心包(必须),提供基于“流模式”解析的API。 jackson-databind——数据绑定包(可选),提供基于“对象绑定”和“树模型”相关API。 jackson-annotations——注解包(可选),提供注解功能。 Jackson的优势: 相对于java json解析的其他库,诸如json-lib、gson包,Jackson具有以下优点: 功能全面,提供多种模式的json解析方式,“对象绑定”使用方便,利用注解包能为我们开发提供很多便利。 性能较高,“流模式”的解析效率超过绝大多数类似的json包。 核心包:JsonPaser(json流读取),JsonGenerator(json流输出)。 数据绑定包:ObjectMapper(构建树模式和对象绑定模式),JsonNode(树节点) [java] view plain copy publicstaticStringserialize(Objectobj){ObjectMappermapper=newObjectMapper();Stringjson=null;try{json=mapper.writeValueAsString(obj);}catch(Exceptione){//TODOAuto-generatedcatchblocke.printStackTrace();}returnjson;}publicstaticObjectdeserialize(Stringjson,Class<?>clazz){ObjectMappermapper=newObjectMapper();Objectobj=null;try{obj=mapper.readValue(json,clazz);}catch(Exceptione){//TODOAuto-generatedcatchblocke.printStackTrace();}returnobj;} 6.KryoSerialize 和KryoRegisterSerialize Kryo的运行速度是java Serializable 的20倍左右 Kryo的文件大小是java Serializable的一半左右 Kryo有两种模式: 一种是先注册(regist),再写对象,即writeObject函数,实际上如果不先注册,在写对象时也会注册,并为class分配一个id。 注意,如果是rpc,则必须两端都按同样的顺序注册,否则会出错,因为必须要明确类对应的唯一id。 另一种是写类名及对象,即writeClassAndObject函数。 writeClassAndObject函数是先写入(-1 + 2)(一个约定的数字),再写入类ID(第一次要先写-1,再写类ID + 类名),写入引用关系(见引用的实现),最后才写真正的数据)。 注意每一次writeClassAndObject调用后信息都会清空,所以不用担心和client交互时会出错。 [java] view plain copy staticKryokryo=newKryo();publicstaticbyte[]serialize(Objectobj){byte[]buffer=newbyte[2048];Outputoutput=newOutput(buffer);kryo.writeClassAndObject(output,obj);byte[]bs=output.toBytes();output.close();returnbs;}publicstaticObjectdeserialize(byte[]src){Inputinput=newInput(src);Objectobj=kryo.readClassAndObject(input);input.close();returnobj;} [java] view plain copy staticKryokryo=null;static{kryo=newKryo();kryo.setReferences(false);kryo.setRegistrationRequired(false);kryo.setInstantiatorStrategy(newStdInstantiatorStrategy());}publicstaticbyte[]serialize(Objectobj){kryo.register(obj.getClass());byte[]buffer=newbyte[2048];Outputoutput=newOutput(buffer);kryo.writeObject(output,obj);byte[]bs=output.toBytes();output.close();returnbs;}publicstaticObjectdeserialize(byte[]src,Class<?>clazz){kryo.register(clazz);Inputinput=newInput(src);Objectobj=kryo.readObject(input,clazz);input.close();returnobj;} Json的优点:明文结构一目了然,可以跨语言,属性的增加减少对解析端影响较小。缺点:字节数过多,依赖于不同的第三方类库。 Object Serializalbe 优点:java原生支持,不需要提供第三方的类库,使用比较简单。缺点:无法跨语言,字节数占用比较大,某些情况下对于对象属性的变化比较敏感。 对象在进行序列化和反序列化的时候,必须实现Serializable接口,但并不强制声明唯一的serialVersionUID,是否声明serialVersionUID对于对象序列化的向上向下的兼容性有很大的影响。 我们通常以为将Java对象序列化成二进制比序列化成XML或Json更快,其实是错误的,如果你关心性能,建议避免Java序列化。

优秀的个人博客,低调大师

Java Bean Copy框架性能对比

一、问题分析 背景 相同server机器上的相同方法在方法调用链任何参数都一致的情况消耗时间差别非常大,举例说明,类A有方法demo(), 通过分析发现同一台机器(也是一个jvm进程)对该方法的两次调用消耗时间竟然有200ms的差距。同时,方法实现上没有使用任何的并发以及缓存,唯一特殊的是方法内使用了Apache BeanUtils.copyProperties,怀疑是这个方法有猫腻,于是开始重点分析该方法实现。 分析过程 现象分析 猜想如果是BeanUtils.copyProperties有问题,那么现象上应该是调用BeanUtils.copyProperties完成bean copy的过程可能会偶然出现性能问题,于是写了一个demo 循环调用BeanUtils.copyProperties完成bean copy,demo可以参考下文 验

优秀的个人博客,低调大师

《.Ne框架程序设计》随记(3)

以往,每个应用程序进程都有自己的虚拟地址空间,通过地址空间的隔离来保证一个进程不会干扰另一个进程的运行。但通过验证托管代码,可以确保不会访问不该访问的内存,因此可以一个单独的虚拟地址空间内运行多个托管应用程序。由于太多的进程会占用过多的系统资源,损伤系统性能,并限制系统可用的资源。因此在一个进程中运行多个托管应用程序可以减少进程的数量,提高系统性能,降低资源需求,而同时应用程序仍然可以保持良好的健壮性。 CLR中,一个托管应用程序叫一个应用程序域(AppDomain)。默认地,一个托管exe仅仅执行在它自己拥有的地址空间中(这个地址空间只含有一个应用程序域),但CLR 的宿主进程(如IIS服务器等)可以决定在一个操作系统进程中运行多个应用程序域。 .net framework提供了一组丰富的类库(FCL),其中含有几千个类型的定义。CLR 和FCL使开发者可以创建以下应用程序:(1)XML Web服务;(2)Web窗体;(3)windows窗体;(4)控制台应用程序;(5)windows服务:windows服务控制管理器(SCM)控制的服务程序;(6)组件库; CLR支持三种互操作: (1) 托管代码调用DLL中的非托管函数。托管代码可以使用一种叫P/Invoke(就是平台调用)的机制来调用DLL中的函数。实际上,许多FCL中定义的类型内部都调用了从Kernel32.dll,User32.dll等DLL中导出的函数。例如,C#程序可以调用从Kernel32.dll中导出的CreateSemaphore函数。 (2) 托管代码使用现存的COM组件(非托管组件作为COM服务器)。利用现有的COM组件的类型库,我们可以创建出描述它们的托管程序集,托管代码可以象访问其他托管代码一样访问这些托管程序集中的类型。有时候没有类型库,我们可以在代码中创建自己的类型,CLR可以用这些类型进行正确的互操作,例如,可以在C# 应用程序中使用DirectX COM 组件。 (3) 非托管代码使用托管类型(托管类型作为COM服务器)。许多现存的非托管代码都需要提供COM组件才能正常运行。而用托管代码来实现这些组件更容易,因为这样可以避免处理引用计数和COM接口。例如,可以用C#来创建ActiveX控件或者shell扩展程序。 #include <stdio.h> #include <mscorlib.dll> using namespace System; void main() { printf("Hello,"); Console::WriteLine("World!"); } 在安装新的应用程序时却损坏了现有的应用程序,这叫“Dll hell”.现在大多数应用程序的安装都会影响系统的各个部分。例如,会复制许多文件到许多目录中,更新注册表设置,安装快捷键到桌面,开始菜单和快速启动中。这就是备份应用程序比较困难,因为必须复制所有的文件和相关的注册表内容,而要将应用程序移植到另外一抬机器也很困难,必须 重新安装。最后,卸载应用程序也很麻烦。.net framework使组件不再需要象COM那样在注册表中进行注册。它还包含了一个叫代码访问安全的安全模型,这是基于程序集的标识来控制的。 一个托管PE文件包含4部分:PE表头,CLR表头,元数据和IL代码。PE表头是系统要求的标准信息。CLR表头专用于那些需要CLR 才能运行的模块(托管模块)。CLR表头中包含和模块一起创建的元数据的主版本号和次版本号,一些标记,若模块是CUI或GUI,可执行文件还有一个标识入口点方法的MethodDef标记,以及一个可选的强命名数字签名。该表头还包括模块内某些元数据表的大小和偏移量。 元数据实际是一块二进制数据,其中包含一些表,可以分为3类:定义表,引用表,清单表。程序集中包含了一个文件用于保存清单(manifest).清单是另外一组元数据的集合,其中主要包含了程序集中一部分文件的名称,还描述了程序集的版本,语言文化,发布者,公有导出类型,以及组成程序集的所有文件。CLR总是先加载包含清单元数据的文件,然后利用该清单来获取程序集中的其他文件。程序集的特性:1)定义了可重用的类型。2)程序集标识有一个版本号。3)可以包含与之相关的安全信息。 可以在应用程序的配置文件中指定一个codeBase元素来配置程序需要下载的程序集文件。codeBase元素标识了一个可以找到程序集所有文件的URL地址。当尝试加载一个程序集的文件时,CLR首先获取codeBase元素的URL地址,然后检查本地机器的下载缓存看是否已经存在该文件,若存在,该文件就被加载,否则,CLR将codeBase元素的URL地址中将该文件下载到缓存,若找不到该文件,CLR将在运行时抛出FileNoFoundException异常。 程序集是一个可重用,可实施版本策略和安全策略的单元,它允许我们将类型和资源划分到不同的文件中,这样程序集的使用者就可以决定将哪些文件打包在一起部署,一旦CLR加载了程序集中包含清单的那个文件,就可以确定程序集的其他文件中包含了程序正在引用的类型和资源,任何程序集的使用者只需要知道包含清单的文件名称,文件的划分对使用者是透明的,并且可以在将来改变,同时又不会破坏现有应用程序的行为。 对于可执行应用程序(exe),配置文件必须位于应用程序的基目录中,并且它的名字必须是exe文件名再加.config扩展名。对于asp.net web窗体和xml web服务应用程序,配置文件必须位于 web应用程序的虚拟根目录下,并且名称总是web.config.另外,子目录也可以包含它们自己的web.config文件,并继承上一目录的配置设置。配置设置可以用于特定的应用程序,也可以用于整个机器。 强命名程序集有一个发布者的公钥/私钥对签名,其中公钥/私钥对唯一地标识了程序集的发布者,利用公钥/私钥对,我们可以对程序集进行唯一的标识,实施安全策略和版本策略。一个程序集有两种部署方式:私有方式和全局方式。私有方式将程序集部署在应用程序的基目录及其子目录下。弱命名程序集只能够进行私有部署。全局方式将程序集部署在一些CLR确知的地方,当CLR搜索程序集时,它就到这些地方去找。强命名程序集即可以进行私有部署,也可以进行全局部署。一个强命名程序集包含四个唯一标识程序集的特性:文件名(没有扩展名),版本号,语言文化标识,和一个公有密钥标记(由公有密钥产生的一个值)。若想唯一标识一个程序集,就必须首先获取一个公钥/私钥对,再将公钥/私钥对与程序集相关联。 CLR能够将名称相同但路径不同的多个文件加载到同一个地址空间,这叫“并存执行”,这是解决”Dell hell”的一个关键技术。在解析一个被引用的类型时,CLR可以在下面三个地方之一找到该类型:(1)同一个文件。对同一个文件中类型的访问在编译时就确定了。CLR直接从该文件中加载被引用的类型。(2)不同的文件,相同的程序集。(3)不同的文件,不同的程序集。当被引用的类型在一个不同的程序集文件中时,CLR会首先加载包含被引用程序集的清单所在的文件。若该文件没有包含需要的类型,CLR则会根据此清单文件加载适当的文件. 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2006/09/01/491831.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

HAS-插件式Kerberos认证框架

HAS解决方案要点 Hadoop服务以及服务之间继续使用原先的Kerberos的认证机制; 在集群部署的时候可以把节点使用的Keytab放到可靠的节点上, 集群运行时,集群内的节点只有通过认证后才能正常使用。企图冒充的节点由于没有事先得到的密钥信息,无法与集群内部的节点通信, 从而防止了恶意的使用或篡改Hadoop集群的问题,确保了Hadoop集群的可靠安全; Hadoop的用户也可以继续使用熟悉的认证方式登录; HAS兼容MIT Kerberos协议,用户还是可以用password或Keytab这种方式进行认证; 在新的认证机制中可以定制实现自己插件与已经存在的认证系统结合; HAS中的新的认证机制采用plugin已有的认证系统,具有高可定制性; 基于新的认证机制安全管理人员不需同步用户账户信息到Kerberos的数据库; 没有用户账户信息的拷

优秀的个人博客,低调大师

提高精简框架集程序的性能

以下编程做法可以节省内存和改善设备应用程序的性能。 使用 Windows 窗体和图形节省内存 · 对提供 BeginUpdate 和 EndUpdate 方法的控件使用这两种方法,提供这两种方法的控件包括 ComboBox、ListBox、ListView、ToolStripComboBox 和 TreeView。 · 重新定位控件时,使用 SuspendLayout 和 ResumeLayout 方法。 · 在后台加载其他窗体,使用数据来填充控件,然后再使用 Show 方法。 · 将事件处理代码限制为仅执行重要任务,以便挂起过程可以继续。 · 使用脱屏位图。有关示例,请参见如何:绘制后台图像。 · 重写控件上的 OnKeyDown、OnKeyPress 和 OnKeyUp 方法,而不是添加按键事件处理程序。 使用数据和字符串节省内存 · 在 for 循环中使用整数变量(Int32 或 Int64),而不使用对象变量。 · 避免使用枚举的 ToString 方法,因为它会搜索元数据表,从而影响性能。 · 避免 OutOfMemoryException 错误。如果没有足够的内存分配给内部使用或分配给新对象实例,公共语言运行库可能会引发此异常。要避免此异常,应避免编写占用 64K 或更多内存的大方法。 · 移除 System.SR.dll,它包含异常对话框的错误信息字符串。部署应用程序时可以不使用此文件,从而节省内存。如果存在 System.SR.dll,则 .NET Compact Framework 将动态加载 System.SR.dll 中包含的错误字符串。 如果设备中不存在此 .dll 文件,则所有异常都包含消息“无法加载资源程序集”。不过,在开发期间将 System.SR.dll 引用添加到 Microsoft Visual Studio 2005 项目中总是有用的,因为这样您将看到有意义的异常。 · 字符串是不可变的,因此,每次修改该字符串时都会创建新的 String 对象。构造需经常修改的字符串时,请考虑使用 StringBuilder。 · 如果您知道用于 DateTime 序列化的确切格式,请为 DateTime 使用 ParseExact 方法。否则,DateTime分析器将按顺序尝试应用多个特定于区域性的格式。 · 限制打开 SqlCeCommand 对象的数量,并在完成后释放它们。 与本机代码进行交互时节省内存 · 在平台调用操作中,使用可直接复制到本机结构中的类型,这样的类型在托管和非托管内存中有一种通用表示形式,如 Int32 或 IntPtr。对于大于 32 位的可直接复制到本机结构中的值类型来说,通过引用传递比通过值传递更快。有关可直接复制到本机结构中的类型的更多信息,请参见 .NET Compact Framework 中可直接复制到本机结构中的类型。 · 为函数签名中的参数使用 InAttribute 和 OutAttribute 属性可以减少不必要的封送处理。 · 使用 Marshal 类中的方法手动在 IntPtr 和托管对象之间转换,如 PtrToStructure、PtrToStringBSTR、GetObjectForNativeVariant 和 GetObjectForIUnknown。 · 使用 Prelink 和 PrelinkAll 方法来引发支持本机到托管调用的存根 (stub) 的 JIT 编译。 · 如果期望您的本机 COM 对象通常情况下返回 S_FALSE,或其他非 S_OK HRESULT 值,则应将 PreserveSig 字段设置为 true,并使托管签名与本机签名匹配。这就避免了运行库将 HRESULT 值转换为 COM 调用上的异常时必需的 try/catch 块的系统开销。 · 尽量使用一个平台调用多做工作,尽量少用多个调用。 在集合中节省内存 · 如果集合基于数组,请使用索引器。 · 一旦有机会,就指定集合的大小,因为动态调整大小可以大大增加额外的存储。 · 使用泛型集合以避免值类型的装箱和取消装箱产生的系统开销。定义您自己的优化集合可实现最佳性能。 在 XML 中节省内存 · 使用 XmlTextReader 和 XmlTextWriter 代替 XmlDocument(因为它占用的内存较多)。 · 指定 XmlReaderSettings 和 XmlWriterSettings 的设置以改善性能。如果 IgnoreWhitespace 和 IgnoreComments 两个属性值适用,它们可以显著改善性能。 · 使用 UTF-8、ASCII 和 UTF-16 字符编码,它们比 ANSI 和 Windows 代码页编码更快。 · 避免使用用于分析的架构,因为这种架构需要更多的验证工作。 · 当从 XML 源填充 DataSet 窗体时,应将列映射为属性并使用类型化 DataSet。 · 填充 DataSet 时,应避免填充以下各项: o 架构推理。 o 嵌套表。 o 多个 DateTime 列。为了获得更好的性能,请使用 Ticks 属性值。 · 使用 XML 反序列化时,遵循以下准则可改善性能: o 使元素和属性名尽量保持简短,因为每个字符都必须经过验证。 o 基于属性数据的 XML 比基于元素数据的 XML 要快。 o 如果适用,使用 System.Xml.XmlNodeReader.Skip 方法。 o 如果性能很重要,应考虑二进制序列化。 · 为 XML 序列化的每一种类型分别使用一个 XmlSerializer 实例,以减少用于搜索元数据的时间。 · 由于序列化大量 XML 可能会耗尽内存,应考虑通过使用 BinaryReader 和 BinaryWriter 生成自定义二进制序列化机制。 使用 Web 服务时节省内存 · 读取和编写 DataSet 时,应使用 DiffGram。有关更多信息,请参见 DiffGram。 · 以 XML 格式将远程 DataSet 及其架构保存到设备。 · 初始屏幕期间创建一个简单的 Web 服务方法调用,因为第一个调用比后面的调用要慢。 · 小心处理网络和数据错误。 · 某些情况下,可以手动将 DataSet 序列化为 XML 字符串,然后执行一个 Web 服务调用,这样可以提高性能。 在高级编程中节省内存 · 异步处理大操作。 · 避免虚拟调用。.NET Compact Framework 运行库虚拟调用比静态调用或实例调用大约慢 30%。由于资源受约束,.NET Compact Framework 不使用 vtable,因此必须通过转换类和接口层次结构来调用方法,但这是一种代价很高的操作。.NET Compact Framework 维护已解析的虚拟调用的缓存,因此在大多数情况下,无须重新解释调用。 · 尽可能使用字段而不使用属性。 · 定义值类型时,重写 GetHashCode 和 Equals 方法。如果未重写它们,则运行库会在基 ValueType 类中使用这些方法的普通版本。 · 谨慎使用映射。出于调研目的将映射与非实例化类一起使用会影响应用程序中的实例化对象的性能。 · 确保 RESX 文件中的托管资源具有完全限定名,并且这些资源准确无误。它们必须具有正确的版本和 PublicKeyToken 字段。为未正确指定的类型查找最合适的替代类型会影响性能。 · 请注意,在某些情况下,直接从文件读取应用程序数据就足够了,这比使用 ResourceManager 效率更高。ResourceManager 可以在定位您的二进制资源之前在文件系统中探测多个位置来查找最匹配的附属程序集。为作业使用适当的工具。 本文转自yefanqiu51CTO博客,原文链接:http://blog.51cto.com/yfsoft/324325,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册