首页 文章 精选 留言 我的

精选列表

搜索[融合分析],共10000篇文章
优秀的个人博客,低调大师

缓存穿透问题分析压测

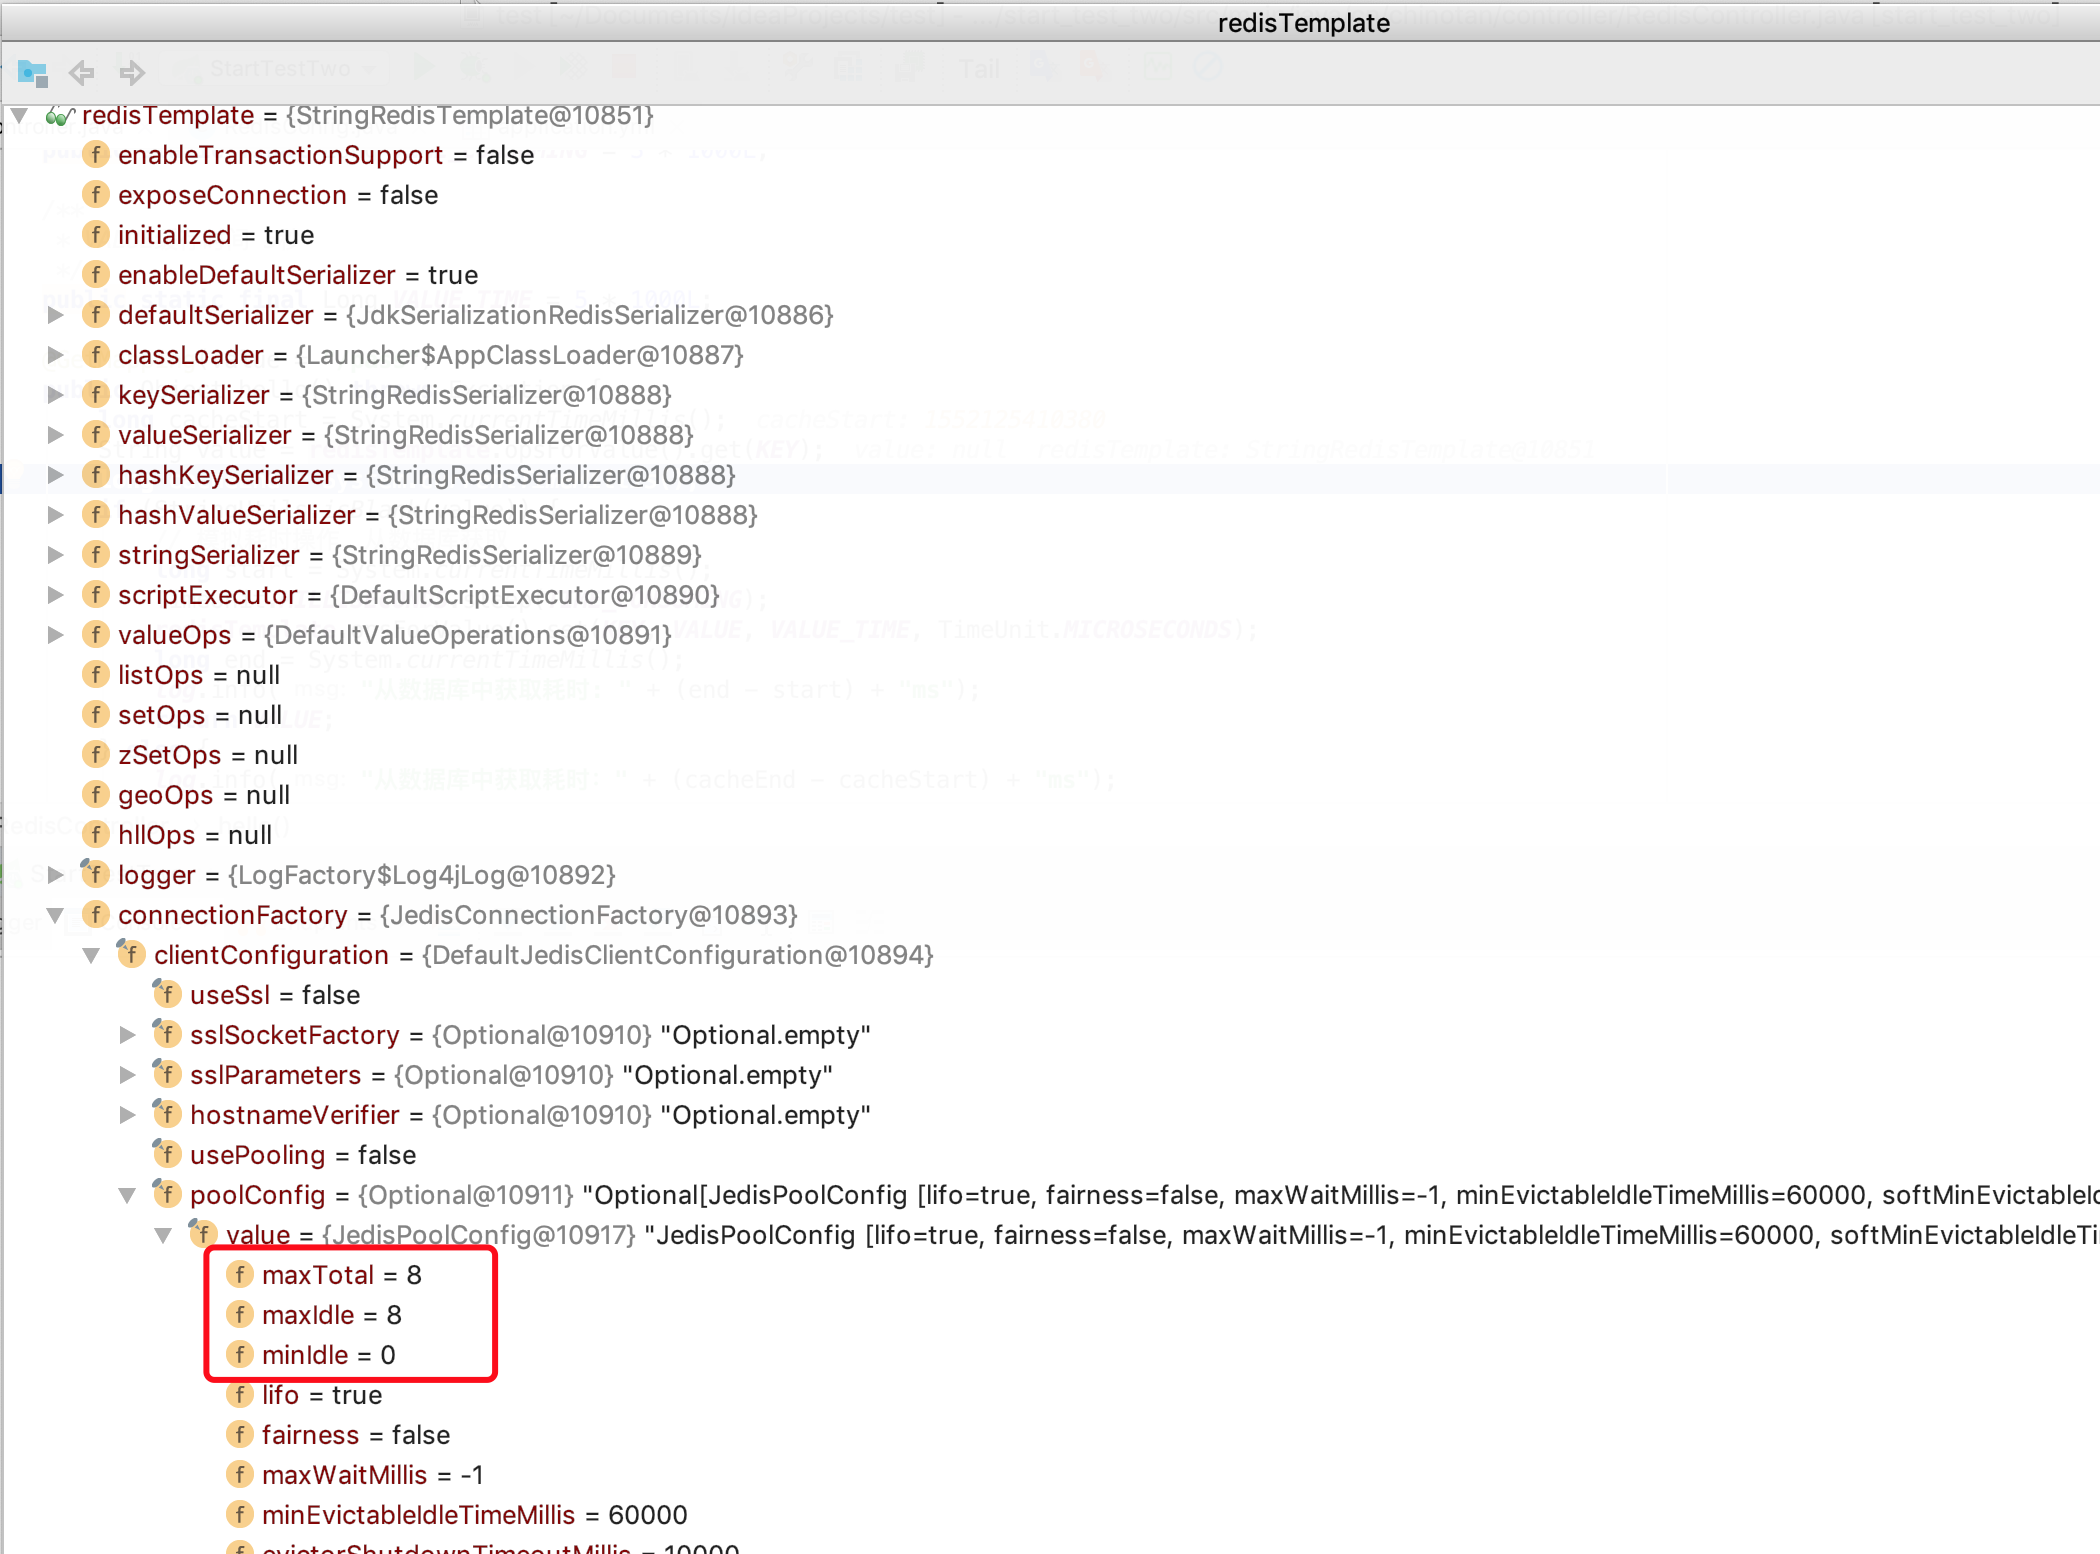
缓存穿透 缓存穿透,是指查询一个数据库一定不存在的数据。正常的使用缓存流程大致是,数据查询先进行缓存查询,如果key不存在或者key已经过期,再对数据库进行查询,并把查询到的对象,放进缓存。如果数据库查询对象为空,则不放进缓存。 本篇讨论缓存击穿的其中一个表现: 对于一些设置了过期时间的key,如果这些key可能会在某些时间点被超高并发地访问,是一种非常“热点”的数据。这个时候,需要考虑另外一个问题:缓存被“击穿”的问题。 概念:缓存在某个时间点过期的时候,恰好在这个时间点对这个Key有大量的并发请求过来,这些请求发现缓存过期一般都会从后端DB加载数据并回设到缓存,这个时候大并发的请求可能会瞬间把后端DB压垮。 如何解决:使用mutex。简单地来说,就是在缓存失效的时候(判断拿出来的值为空),不是立即去load db,而是先使用缓存工具的某些带成功操作返回值的操作(比如Redis的SETNX或者Memcache的ADD)去set一个mutex key,当操作返回成功时,再进行load db的操作并回设缓存;否则,就重试整个get缓存的方法。类似下面的代码: public String get(key) { String value = redis.get(key); if (value == null) { //代表缓存值过期 //设置3min的超时,防止del操作失败的时候,下次缓存过期一直不能load db if (redis.setnx(key_mutex, 1, 3 * 60) == 1) { //代表设置成功 value = db.get(key); redis.set(key, value, expire_secs); redis.del(key_mutex); } else { //这个时候代表同时候的其他线程已经load db并回设到缓存了,这时候重试获取缓存值即可 sleep(50); get(key); //重试 } } else { return value; } } 接下来,进行并发压力测试和优化: 首先是不使用setNX进行并发压力测试 代码如下: package cn.chinotan.controller; import lombok.extern.java.Log; import org.apache.catalina.servlet4preview.http.HttpServletRequest; import org.apache.commons.lang3.StringUtils; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import java.util.concurrent.TimeUnit; /** * @program: test * @description: redis测试 * @author: xingcheng * @create: 2019-03-09 16:26 **/ @RestController @RequestMapping("/redis") @Log public class RedisController { @Autowired StringRedisTemplate redisTemplate; public static final String KEY = "chinotan:redis:pass"; public static final String VALUE = "redis-pass-value"; /** * 模拟耗时操作 3秒 */ public static final Long TIME_CONSUMING = 3 * 1000L; /** * VALUE缓存时间 5秒 */ public static final Long VALUE_TIME = 5 * 1000L; @GetMapping(value = "/pass") public Object hello(HttpServletRequest request) throws Exception { long cacheStart = System.currentTimeMillis(); String value = redisTemplate.opsForValue().get(KEY); long cacheEnd = System.currentTimeMillis(); if (StringUtils.isBlank(value)) { // 模拟耗时操作,从数据库获取 long start = System.currentTimeMillis(); TimeUnit.MILLISECONDS.sleep(TIME_CONSUMING); redisTemplate.opsForValue().set(KEY, VALUE, VALUE_TIME, TimeUnit.MILLISECONDS); long end = System.currentTimeMillis(); log.info("从数据库中获取耗时: " + (end - start) + "ms"); return VALUE; } else { log.info("从缓存中获取耗时:" + (cacheEnd - cacheStart) + "ms"); return value; } } } 很简单的一个get请求,先从缓存中获取数据,如果数据不存在,则从数据库获取,这里用 TimeUnit.MILLISECONDS.sleep(TIME_CONSUMING); 来模拟一个复杂的从数据库获取数据的操作,耗时设定为3秒钟 本次测试采用的是springBoot2.0以上进行部署,jmeter进行压力并发测试 在压力测试之前,进行springboot自带的tomcat并发数和连接数调整以及redis连接池的调整 redis的连接池调整如下: spring: redis: database: 0 host: 127.0.0.1 jedis: pool: #最大连接数据库连接数 max-active: 5000 #最大等待连接中的数量 max-idle: 5000 #最大建立连接等待时间。如果超过此时间将接到异常。设为-1表示无限制。 max-wait: -1 #最小等待连接中的数量,设 0 为没有限制 min-idle: 10 # lettuce: # pool: # max-active: 5000 # max-idle: 5000 # max-wait: -1 # min-idle: 10 # shutdown-timeout: 5000ms password: port: 6379 timeout: 5000 tomcat的调整如下: server: port: 11111 tomcat: uri-encoding: UTF-8 max-threads: 500 max-connections: 10000 这样redis和tomcat可以支持大并发请求 设置完成后查看设置是否生效: redis连接池不生效举例如下: 必须和配置项相同才正确 之后进行压测准备:下载jmeter,之后步骤如下 启动后控制台打印如下: 可以看到大量并发过来后,会有多次的查看操作,并没有走到缓存,缓存命中率低,缓存的意义就少很多 下面进行优化: package cn.chinotan.controller; import lombok.extern.java.Log; import org.apache.commons.lang3.StringUtils; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.redis.core.RedisCallback; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import redis.clients.jedis.JedisCommands; import java.util.Objects; import java.util.concurrent.TimeUnit; /** * @program: test * @description: redis测试 * @author: xingcheng * @create: 2019-03-09 16:26 **/ @RestController @RequestMapping("/redis") @Log public class RedisController { @Autowired StringRedisTemplate redisTemplate; public static final String KEY = "chinotan:redis:pass"; public static final String NX_KEY = "chinotan:redis:nx"; public static final String VALUE = "redis-pass-value"; /** * 间隔时间 3秒 */ public static final Long NX_SLEEP_TIME = 50L; /** * 模拟耗时操作 3秒 */ public static final Long TIME_CONSUMING = 1 * 1000L; /** * VALUE缓存时间 5秒 */ public static final Long VALUE_TIME = 5 * 1000L; /** * 锁缓存时间 5分钟 */ public static final Long NX_TIME = 5 * 60L; @GetMapping(value = "/pass") public Object hello() throws Exception { long cacheStart = System.currentTimeMillis(); String value = redisTemplate.opsForValue().get(KEY); long cacheEnd = System.currentTimeMillis(); if (StringUtils.isBlank(value)) { long start = System.currentTimeMillis(); if (setNX(NX_KEY, NX_KEY)) { // 模拟耗时操作,从数据库获取 TimeUnit.MILLISECONDS.sleep(TIME_CONSUMING); redisTemplate.opsForValue().set(KEY, VALUE, VALUE_TIME, TimeUnit.MILLISECONDS); long end = System.currentTimeMillis(); redisTemplate.delete(NX_KEY); log.info("从数据库中获取耗时: " + (end - start) + "ms"); return VALUE; } else { TimeUnit.MILLISECONDS.sleep(NX_SLEEP_TIME); log.info("缓存穿透递归"); return hello(); } } else { log.info("从缓存中获取耗时:" + (cacheEnd - cacheStart) + "ms"); return value; } } private boolean setNX(String key, String value) { Boolean aBoolean = redisTemplate.opsForValue().setIfAbsent(key, value); redisTemplate.expire(key, NX_TIME, TimeUnit.SECONDS); return aBoolean; } } 通过进行setNX命令操作,这个命令在缓存存在时不会进行覆盖更新写入操作,并返回false,缓存不存在才会进行写入并返回true,通常会被用来分布式锁的设计实现 进行优化后,大量的并发请求不会打到数据库上,而是每隔50ms进行递归重试,这样只有一个请求会请求数据库,其他请求只能从缓存中取数,大大增加了缓存的命中率 下面是压测结果: 可以看到从数据库取数的操作日志只有一条,从而避免了缓存击穿的一个表现问题 下一步优化方向: RedisTemplate提供的setNX操作并不是原子操作(一个是保存数据操作,一个是设置缓存时间操作,是两个请求),在并发环境下可能会有问题,该如何解决呢,欢迎大家留言

优秀的个人博客,低调大师

sync.mutex 源代码分析

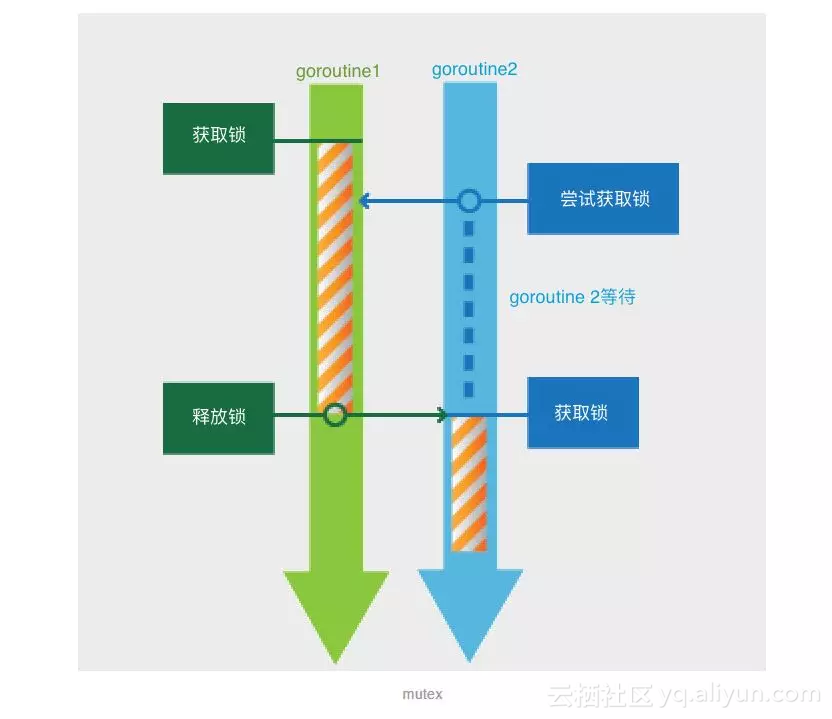
sync.Mutex是Go标准库中常用的一个排外锁。当一个 goroutine 获得了这个锁的拥有权后, 其它请求锁的 goroutine 就会阻塞在 Lock 方法的调用上,直到锁被释放。sync.Mutex的实现也是经过多次的演化,功能逐步加强,增加了公平的处理和饥饿机制。 初版的 Mutex首先我们来看看Russ Cox在2008提交的第一版的Mutex实现。 1type Mutex struct { 2 key int32; 3 sema int32; 4} 5 6func xadd(val *int32, delta int32) (new int32) { 7 for { 8 v := *val; 9 if cas(val, v, v+delta) { 10

优秀的个人博客,低调大师

Spark作业调度阶段分析[转]

Spark作为分布式的大数据处理框架必然或涉及到大量的作业调度,如果能够理解Spark中的调度对我们编写或优化Spark程序都是有很大帮助的; 在Spark中存在转换操作(Transformation Operation)与行动操作(Action Operation)两种;而转换操作只是会从一个RDD中生成另一个RDD且是lazy的,Spark中只有行动操作(Action Operation)才会触发作业的提交,从而引发作业调度;在一个计算任务中可能会多次调用 转换操作这些操作生成的RDD可能存在着依赖关系,而由于转换都是lazy所以当行动操作(Action Operation )触发时才会有真正的RDD生成,这一系列的RDD中就存在着依赖关系形成一个DAG(Directed Acyclc Graph),在Spark中DAGScheuler是基于DAG的顶层调度模块; 相关名词 Application:使用Spark编写的应用程序,通常需要提交一个或多个作业; Job:在触发RDD Action操作时产生的计算作业 Task:一个分区数据集中最小处理单元也就是真正执行作业的地方 TaskSet:由多个Task所组成没有Shuffle依赖关系的任务集 Stage:一个任务集对应的调度阶段 ,每个Job会被拆分成诺干个Stage RDD Action作业提交流程 这里根据Spark源码跟踪触发Action操作时触发的Job提交流程,Count()是RDD中的一个Action操作所以调用Count时会触发Job提交; 在RDD源码count()调用SparkContext的runJob,在runJob方法中根据partitions(分区)大小创建Arrays存放返回结果; RDD.scala /** *ReturnthenumberofelementsintheRDD. */ defcount():Long=sc.runJob(this,Utils.getIteratorSize_).sum SparkContext.scala defrunJob[T,U:ClassTag]( rdd:RDD[T], func:(TaskContext,Iterator[T])=>U, partitions:Seq[Int], resultHandler:(Int,U)=>Unit):Unit={ valcallSite=getCallSite valcleanedFunc=clean(func) logInfo("Startingjob:"+callSite.shortForm) if(conf.getBoolean("spark.logLineage",false)){ logInfo("RDD'srecursivedependencies:\n"+rdd.toDebugString) } dagScheduler.runJob(rdd,cleanedFunc,partitions,callSite,resultHandler,localProperties.get) } 在SparkContext中将调用DAGScheduler的runJob方法提交作业,DAGScheduler主要任务是计算作业与任务依赖关系,处理调用逻辑;DAGScheduler提供了submitJob与runJob方法用于 提交作业,runJob方法会一直等待作业完成,submitJob则返回JobWaiter对象可以用于判断作业执行结果; 在runJob方法中将调用submitJob,在submitJob中把提交操作放入到事件循环队列(DAGSchedulerEventProcessLoop)中; defsubmitJob[T,U]( rdd:RDD[T], func:(TaskContext,Iterator[T])=>U, partitions:Seq[Int], callSite:CallSite, resultHandler:(Int,U)=>Unit, properties:Properties):JobWaiter[U]={ ...... eventProcessLoop.post(JobSubmitted( jobId,rdd,func2,partitions.toArray,callSite,waiter, SerializationUtils.clone(properties))) ...... } 在事件循环队列中将调用eventprocessLoop的onReceive方法; Stage拆分 提交作业时DAGScheduler会从RDD依赖链尾部开始,遍历整个依赖链划分调度阶段;划分阶段以ShuffleDependency为依据,当没有ShuffleDependency时整个Job 只会有一个Stage;在事件循环队列中将会调用DAGScheduler的handleJobSubmitted方法,此方法会拆分Stage、提交Stage; private[scheduler]defhandleJobSubmitted(jobId:Int, finalRDD:RDD[_], func:(TaskContext,Iterator[_])=>_, partitions:Array[Int], callSite:CallSite, listener:JobListener, properties:Properties){ varfinalStage:ResultStage=null ...... finalStage=newResultStage(finalRDD,func,partitions,jobId,callSite) ...... valjob=newActiveJob(jobId,finalStage,callSite,listener,properties) ...... valjobSubmissionTime=clock.getTimeMillis() jobIdToActiveJob(jobId)=job activeJobs+=job finalStage.setActiveJob(job) valstageIds=jobIdToStageIds(jobId).toArray valstageInfos=stageIds.flatMap(id=>stageIdToStage.get(id).map(_.latestInfo)) listenerBus.post( SparkListenerJobStart(job.jobId,jobSubmissionTime,stageInfos,properties)) submitStage(finalStage) submitWaitingStages() } 调度阶段提交 在提交Stage时会先调用getMissingParentStages获取父阶段Stage,迭代该阶段所依赖的父调度阶段如果存在则先提交该父阶段的Stage 当不存在父Stage或父Stage执行完成时会对当前Stage进行提交; privatedefsubmitStage(stage:Stage){ valjobId=activeJobForStage(stage) if(jobId.isDefined){ if(!waitingStages(stage)&&!runningStages(stage)&&!failedStages(stage)){ valmissing=getMissingParentStages(stage).sortBy(_.id) if(missing.isEmpty){ submitMissingTasks(stage,jobId.get) }else{ for(parent<-missing){ submitStage(parent) } waitingStages+=stage } } } ...... } 参考资料:http://spark.apache.org/docs/latest/ 本文链接:http://www.solinx.co/archives/579#comment-47


资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册