首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

解析Node.js通过axios实现网络请求

本次给大家分享一篇node.js通过axios实现网络请求的方法,写的十分的全面细致,具有一定的参考价值,对此有需要的朋友可以参考学习下。如有不足之处,欢迎批评指正。 1、使用Npm 下载axios npm install --save axios var update_url = axios.create({ baseURL:'debug url' }); update_url.get('/debug url').then(function (response){ //response 就是请求url 返回的内容 }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 上述的方法请求文件时候,body的默认格式不是form-data。因此我们需要请求的数据格式为form-data的时候,需要使用下面的库 request npm install --save request 2、request 请求url,可以使用get,post的方式. request.post({url:'http://192.168.1.159/backup/client/interface1s.php?func=getMusicPath', formData:{musicname:task.name}}, function optionalCallback(err,httpResponse,body){ //body为url反馈回来的数据, }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

解析Vue.js中的computed工作原理

我们通过实现一个简单版的和Vue中computed具有相同功能的函数来了解computed是如何工作的。写的十分的全面细致,具有一定的参考价值,对此有需要的朋友可以参考学习下。如有不足之处,欢迎批评指正。 JS属性: JavaScript有一个特性是 Object.defineProperty ,它能做很多事,但我在这篇文章只专注于这个方法中的一个: var person = {}; Object.defineProperty (person, 'age', { get: function () { console.log ("Getting the age"); return 25; } });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 console.log ("The age is ", person.age); // Prints: // // Getting the age // The age is 25 (Obeject.defineProperty是Object的一个方法,第一个参数是对象名称,第二个参数是要设置的属性名,第三个参数是一个对象,它可以设置这个属性是否可修改、可写等,而这篇文章主要使用的是Obeject.defineProperty的访问器属性,感兴趣的朋友可以自行google或者查看Js高及程序设计) 尽管 person.age 看起来像是访问了对象的一个属性,但其实在内部我们是运行了一个函数。 一个基本可响应的Vue.js Vue.js内部构建了一个可以将普通的对象转化为可以被观察的值( 响应属性 ),下面为大家展示一个简化版的如何添加响应属性的案例: function defineReactive (obj, key, val) { Object.defineProperty (obj, key, { get: function () { return val; }, set: function (newValue) { val = newValue; } }) }; // 创建一个对象 var person = {}; // 添加可响应的属性"age"和"country" defineReactive (person, 'age', 25); defineReactive (person, 'country', 'Brazil'); // 现在你可以随意使用person.age了 if (person.age < 18) { return 'minor'; } else { return 'adult'; }//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 // 设置person.country的值 person.country = 'Russia'; 有趣的是, 25 和 ‘Brazil' 还是一个闭包内部的变量,只有当赋给它们新值的时候 val 才会改变。 person.country 并不拥有 'Brazil' 这个值,而是getter这个函数拥有 'Brazil' 这个值。 声明一个计算属性 让我们创建一个定义计算属性的函数 defineComputed 。这个函数就跟大家平时使用computed时的一样。 defineComputed ( person, // 计算属性就声明在这个对象上 'status', // 计算属性的名称 function () { // 实际返回计算属性值的函数 console.log ("status getter called") if (person.age < 18) { return 'minor'; } else { return 'adult'; } }, function (newValue) { // 当计算属性值更新时调用的函数 console.log ("status has changed to", newValue) } }); // 我们可以像使用一般的属性一样使用计算属性 console.log ("The person's status is: ", person.status); 让我们写一个简单的 defineComputed 函数,它支持调用计算方法,但目前不需要它支持 updateCallback function defineComputed (obj, key, computeFunc, updateCallback) { Object.defineProperty (obj, key, { get: function () { // 执行计算函数并且返回值 return computeFunc (); },//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 set: function () { // 什么也不做,不需要设定计算属性的值 } }) } 这个函数有两个问题: 每次访问计算属性时都会执行一次计算函数 computeFunc () 它不知道什么时候更新 (即当我们更新某个data中的属性,计算属性中也会更新这个data属性) // 我希望最终函数执行后是这个效果:每当person.age更新值的时候,person.status也同步更新 person.age = 17; // console: status 的值为 minor person.age = 22; // console: status 的值为 adult 增加一个依赖项 让我们增加一个全局变量 Dep : var Dep = { target: null }; 这是一个依赖项,接着我们用一个骚操作来更新 defineComputed 函数: function defineComputed (obj, key, computeFunc, updateCallback) { var onDependencyUpdated = function () { // TODO }//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 Object.defineProperty (obj, key, { get: function () { // 将onDependencyUpdated 这个函数传给Dep.target Dep.target = onDependencyUpdated; var value = computeFunc (); Dep.target = null; }, set: function () { // 什么也不做,不需要设定计算属性的值 } }) } 现在让我们回到之前设置的响应属性上: function defineReactive (obj, key, val) { // 所有的计算属性都依赖这个数组 var deps = []; Object.defineProperty (obj, key, { get: function () { // 检查是否调用了计算属性,如果调用了,Department.target将等于一个onDependencyUpdated函数 if (Dep.target) { // 把onDependencyUpdated函数push到deos中 deps.push (target); } return val; }, set: function (newValue) { val = newValue; // 通知所有的计算属性,告诉它们有个响应属性更新了 deps.forEach ((changeFunction) => { changeFunction (); });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 }//面向1-3年前端人员 }) }; 我们可以在计算属性定义的函数触发更新回调后更新 onDependencyUpdated 函数。 var onDependencyUpdated = function () { // 再次计算 计算属性的值 var value = computeFunc (); updateCallback (value); }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 把它们整合到一起: 让我们重新访问我们的计算属性 person.status : person.age = 22; defineComputed ( person, 'status', function () { if (person.age > 18) { return 'adult'; } }, function (newValue) { console.log ("status has changed to", newValue) }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 }); console.log ("Status is ", person.status); 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

kodexplorer开源私有云程序配置文件解析

config/setting_user.php 追加内容(一下都是,注意不要使用中文引号、双引号及分号) //【指定多语言只保留中文】 $GLOBALS['config']['settings']['language'] = 'zh-CN'; //【自定义群组创建时自动新建的目录】 $GLOBALS['config']['settingSystemDefault']['newGroupFolder'] = 'share,文档,图片,视频'; //【自定义用户桌面文件夹目录】 $GLOBALS['config']['settingSystemDefault']['desktopFolder'] = 'desktop'; //【配置静态文件CDN访问URL】 // 步骤:先将kod下面static文件夹上传到CDN服务器,配置到如下即可 // 例如官网demo的静态文件cdn路径:http://static.kodcloud.com/kod/static/4.25/ $GLOBALS['config']['settings']['staticPath'] = ""; //【配置插件静态文件到CDN】 $GLOBALS['config']['settings']['pluginHost'] = ''; //【上传速度优化】 $GLOBALS['config']['settings']['updloadThreads'] = 10;//多线程上传,同时上传线程数 $GLOBALS['config']['settings']['updloadChunkSize'] = 1024*1024*20; //分片上传分片大小(不能大于php.ini中设置的上传大小限制,否则文件会上传不成功) //【nginx优化文件下载速度】 // 调用nginx直接输出下载,提升速度 http://www.laruence.com/2012/05/02/2613.html; // https://www.lovelucy.info/x-sendfile-in-nginx.html $GLOBALS['config']['settings']['httpSendFile'] = true; //新用户初始化默认配置 $GLOBALS['config']['settingDefault'] = array( 'listType' => "icon", // 文件列表模式 列表|图标|分栏 ==> list||icon||split 'listSortField' => "name", // 排序字段 文件名|文件大小|扩展名|最后修改时间 ==> name||size||ext||mtime 'listSortOrder' => "up", // 升序降序 默认升序 up||down 'fileIconSize' => "80", // 图标模式图标大小 'animateOpen' => "1", // 界面动画动画,默认开启 'soundOpen' => "0", // 操作音效 'theme' => "win10", // 默认主题; app theme [mac,win7,win10,metro,metro_green,alpha] 'wall' => "8", // 默认壁纸 "fileRepeat" => "replace", // 同名文件默认处理方式: 同时保留,替换,跳过 ==> rename,replace,skip "recycleOpen" => "1", // 是否开启回收站 1 | 0 代表是否开启 'resizeConfig' => // 列表模式不同字段宽度初始值 '{"filename":250,"filetype":80,"filesize":80,"filetime":215,"editorTreeWidth":200,"explorerTreeWidth":200}' ); $GLOBALS['config']['editorDefault'] = array( 'fontSize' => '14px', 'theme' => 'tomorrow', 'autoWrap' => 1, //自适应宽度换行 'autoComplete' => 1, 'functionList' => 1, "tabSize" => 4, "softTab" => 1, "displayChar" => 0, //是否显示特殊字符 "fontFamily" => "Menlo", //字体 "keyboardType" => "ace" //ace vim emacs ); 配置apiLoginTonken同上打开 /config/setting_user.php;追加如下行; //自行设置;长度不小于5,为安全考虑建议尽量复杂;该数值切勿泄露,建议定时更换; $GLOBALS['config']['settings']['apiLoginTonken'] = 'ffmoipwjeij'; 去除随机壁纸 管理员登陆,右上角打开系统设置——选中『其他』tab——在自定义css中追加 #random-wallpaper,.randomImage{display:none;visibility: hidden;} 去除授权标识 系统设置右上角授权版标识 管理员登陆,右上角打开系统设置——选中『其他』tab——在自定义css中追加 .setting-page .version-vip{display:none;visibility: hidden;}


优秀的个人博客,低调大师

深入解析VueJs中的V-bind指令

v-bind 主要用于属性绑定,比方你的class属性,style属性,value属性,href属性等等,只要是属性,就可以用v-bind指令进行绑定.这次主要介绍了VueJs中的V-bind指令,需要的朋友可以参考下 v-bind 主要用于属性绑定,Vue官方提供了一个简写方式 :bind,例如: <!-- 完整语法 --> <a v-bind:href="url"></a> <!-- 缩写 --> <a :href="url"></a> 一、概述 v-bind 主要用于属性绑定,比方你的class属性,style属性,value属性,href属性等等,只要是属性,就可以用v-bind指令进行绑定。 示例: <!-- 绑定一个属性 --> <img v-bind:src="imageSrc"> <!-- 缩写 --> <img :src="imageSrc"> <!-- 内联字符串拼接 --> <img :src="'/path/to/images/' + fileName"> <!-- class 绑定 --> <div :class="{ red: isRed }"></div> <div :class="[classA, classB]"></div> <div :class="[classA, { classB: isB, classC: isC }]"> <!-- style 绑定 --> <div :style="{ fontSize: size + 'px' }"></div> <div :style="[styleObjectA, styleObjectB]"></div> <!-- 绑定一个有属性的对象 --> <div v-bind="{ id: someProp, 'other-attr': otherProp }"></div> <!-- 通过 prop 修饰符绑定 DOM 属性 --> <div v-bind:text-content.prop="text"></div> <!-- prop 绑定。“prop”必须在 my-component 中声明。--> <my-component :prop="someThing"></my-component> <!-- 通过 $props 将父组件的 props 一起传给子组件 --> <child-component v-bind="$props"></child-component> <!-- XLink 欢迎加入全栈开发交流圈一起吹水聊天学习交流:864305860--> <svg><a :xlink:special="foo"></a></svg> 二、绑定 HTML Class 对象语法 我们可以传给 v-bind:class 一个对象,以动态地切换 class <div v-bind:class="{ active: isActive }"></div> 上面的语法表示 active 这个 class 存在与否将取决于数据属性 isActive 的 truthiness 可以在对象中传入更多属性来动态切换多个 class。此外,v-bind:class 指令也可以与普通的 class 属性共存。当有如下模板: <div class="static" v-bind:class="{ active: isActive, 'text-danger': hasError }"> </div> 和如下 data data: { isActive: true, hasError: false }//欢迎加入全栈开发交流圈一起吹水聊天学习交流:864305860 结果渲染为: <div class="static active"></div> 当 isActive 或者 hasError 变化时,class 列表将相应地更新。例如,如果 hasError 的值为 true,class 列表将变为 "static active text-danger" 绑定的数据对象不必内联定义在模板里 <div v-bind:class="classObject"></div> data: { classObject: { active: true, 'text-danger': false } }//欢迎加入全栈开发交流圈一起吹水聊天学习交流:864305860 渲染的结果和上面一样。我们也可以在这里绑定一个返回对象的计算属性。这是一个常用且强大的模式: <div v-bind:class="classObject"></div> data: { isActive: true, error: null }, computed: { classObject: function () { return { active: this.isActive && !this.error, 'text-danger': this.error && this.error.type === 'fatal' }//欢迎加入全栈开发交流圈一起学习交流:864305860 }//面向1-3年前端人员 }//帮助突破技术瓶颈,提升思维能力 数组语法 我们可以把一个数组传给 v-bind:class,以应用一个 class 列表 <div v-bind:class="[activeClass, errorClass]"></div> data: { activeClass: 'active', errorClass: 'text-danger' } 渲染为: <div class="active text-danger"></div> 如果你也想根据条件切换列表中的 class,可以用三元表达式 <div v-bind:class="[isActive ? activeClass : '', errorClass]"></div> 这样写将始终添加 errorClass,但是只有在 isActive 是 truthy 时才添加 activeClass。 不过,当有多个条件 class 时这样写有些繁琐。所以在数组语法中也可以使用对象语法 <div v-bind:class="[{ active: isActive }, errorClass]"></div> 三、用在组件上 当在一个自定义组件上使用 class 属性时,这些类将被添加到该组件的根元素上面。这个元素上已经存在的类不会被覆盖。 例如,如果你声明了这个组件: Vue.component('my-component', { template: '<p class="foo bar">Hi</p>' }) 然后在使用它的时候添加一些 class <my-component class="baz boo"></my-component> HTML 将被渲染为: <p class="foo bar baz boo">Hi</p> 对于带数据绑定 class 也同样适用 <my-component v-bind:class="{ active: isActive }"></my-component> 当 isActive 为 truthy时,HTML 将被渲染成为 <p class="foo bar active">Hi</p> 四、绑定内联样式 对象语法 v-bind:style 的对象语法十分直观——看着非常像 CSS,但其实是一个 JavaScript 对象。CSS 属性名可以用驼峰式 (camelCase) 或短横线分隔 (kebab-case,记得用单引号括起来) 来命名: <div v-bind:style="{ color: activeColor, fontSize: fontSize + 'px' }"></div> data: { activeColor: 'red', fontSize: 30 }//欢迎加入全栈开发交流圈一起学习交流:864305860 直接绑定到一个样式对象通常更好,这会让模板更清晰 <div v-bind:style="styleObject"></div> data: { styleObject: { color: 'red', fontSize: '13px' } }//欢迎加入全栈开发交流圈一起吹水聊天学习交流:864305860 同样的,对象语法常常结合返回对象的计算属性使用 数组语法 v-bind:style 的数组语法可以将多个样式对象应用到同一个元素上 <div v-bind:style="[baseStyles, overridingStyles]"></div> 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

KOA2框架原理解析和实现

koa是一个基于node实现的一个新的web框架,它是由express框架的原班人马打造的。它的特点是优雅、简洁、表达力强、自由度高。它更express相比,它是一个更轻量的node框架,因为它所有功能都通过插件实现,这种插拔式的架构设计模式,很符合unix哲学。 koa框架现在更新到了2.x版本,本文从零开始,循序渐进,讲解koa2的框架源码结构和实现原理,展示和详解koa2框架源码中的几个最重要的概念,然后手把手教大家亲自实现一个简易的koa2框架,帮助大家学习和更深层次的理解koa2,看完本文以后,再去对照koa2的源码进行查看,相信你的思路将会非常的顺畅。 本文所用的框架是koa2,它跟koa1不同,koa1使用的是generator+co.js的执行方式,而koa2中使用了async/await,因此本文的代码和demo需要运行在node 8版本及其以上,如果读者的node版本较低,建议升级或者安装babel-cli,用其中的babel-node来运行本文涉及到的代码。 koa源码结构 上图是koa2的源码目录结构的lib文件夹,lib文件夹下放着四个koa2的核心文件:application.js、context.js、request.js、response.js。 application.js application.js是koa的入口文件,它向外导出了创建class实例的构造函数,它继承了events,这样就会赋予框架事件监听和事件触发的能力。application还暴露了一些常用的api,比如toJSON、listen、use等等。 listen的实现原理其实就是对http.createServer进行了一个封装,重点是这个函数中传入的callback,它里面包含了中间件的合并,上下文的处理,对res的特殊处理。 use是收集中间件,将多个中间件放入一个缓存队列中,然后通过koa-compose这个插件进行递归组合调用这一些列的中间件。 context.js 这部分就是koa的应用上下文ctx,其实就一个简单的对象暴露,里面的重点在delegate,这个就是代理,这个就是为了开发者方便而设计的,比如我们要访问ctx.repsponse.status但是我们通过delegate,可以直接访问ctx.status访问到它。 request.js、response.js 这两部分就是对原生的res、req的一些操作了,大量使用es6的get和set的一些语法,去取headers或者设置headers、还有设置body等等,这些就不详细介绍了,有兴趣的读者可以自行看源码。 实现koa2的四大模块 上文简述了koa2源码的大体框架结构,接下来我们来实现一个koa2的框架,笔者认为理解和实现一个koa框架需要实现四个大模块,分别是: 封装node http server、创建Koa类构造函数 构造request、response、context对象 中间件机制和剥洋葱模型的实现 错误捕获和错误处理 下面我们就逐一分析和实现。 模块一:封装node http server和创建Koa类构造函数 阅读koa2的源码得知,实现koa的服务器应用和端口监听,其实就是基于node的原生代码进行了封装,如下图的代码就是通过node原生代码实现的服务器监听。 let http = require('http'); let server = http.createServer((req, res) => { res.writeHead(200); res.end('hello world'); }); server.listen(3000, () => { console.log('listenning on 3000'); }); 我们需要将上面的node原生代码封装实现成koa的模式: const http = require('http'); const Koa = require('koa'); const app = new Koa(); app.listen(3000); 实现koa的第一步就是对以上的这个过程进行封装,为此我们需要创建application.js实现一个Application类的构造函数: let http = require('http'); class Application { constructor() { this.callbackFunc; } listen(port) { let server = http.createServer(this.callback()); server.listen(port); } use(fn) { this.callbackFunc = fn; } callback() { return (req, res) => { this.callbackFunc(req, res); }; } } module.exports = Application; 然后创建example.js,引入application.js,运行服务器实例启动监听代码: let Koa = require('./application'); let app = new Koa(); app.use((req, res) => { res.writeHead(200); res.end('hello world'); }); app.listen(3000, () => { console.log('listening on 3000'); }); 现在在浏览器输入localhost:3000即可看到浏览器里显示“hello world”。现在第一步我们已经完成了,对http server进行了简单的封装和创建了一个可以生成koa实例的类class,这个类里还实现了app.use用来注册中间件和注册回调函数,app.listen用来开启服务器实例并传入callback回调函数,第一模块主要是实现典型的koa风格和搭好了一个koa的简单的架子。接下来我们开始编写和讲解第二模块。 模块二:构造request、response、context对象 阅读koa2的源码得知,其中context.js、request.js、response.js三个文件分别是request、response、context三个模块的代码文件。context就是我们平时写koa代码时的ctx,它相当于一个全局的koa实例上下文this,它连接了request、response两个功能模块,并且暴露给koa的实例和中间件等回调函数的参数中,起到承上启下的作用。 request、response两个功能模块分别对node的原生request、response进行了一个功能的封装,使用了getter和setter属性,基于node的对象req/res对象封装koa的request/response对象。我们基于这个原理简单实现一下request.js、response.js,首先创建request.js文件,然后写入以下代码: let url = require('url'); module.exports = { get query() { return url.parse(this.req.url, true).query; } }; 这样当你在koa实例里使用ctx.query的时候,就会返回url.parse(this.req.url, true).query的值。看源码可知,基于getter和setter,在request.js里还封装了header、url、origin、path等方法,都是对原生的request上用getter和setter进行了封装,笔者不再这里一一实现。 接下来我们实现response.js文件代码模块,它和request原理一样,也是基于getter和setter对原生response进行了封装,那我们接下来通过对常用的ctx.body和ctx.status这个两个语句当做例子简述一下如果实现koa的response的模块,我们首先创建好response.js文件,然后输入下面的代码: module.exports = { get body() { return this._body; }, set body(data) { this._body = data; }, get status() { return this.res.statusCode; }, set status(statusCode) { if (typeof statusCode !== 'number') { throw new Error('something wrong!'); } this.res.statusCode = statusCode; } }; 以上代码实现了对koa的status的读取和设置,读取的时候返回的是基于原生的response对象的statusCode属性,而body的读取则是对this._body进行读写和操作。这里对body进行操作并没有使用原生的this.res.end,因为在我们编写koa代码的时候,会对body进行多次的读取和修改,所以真正返回浏览器信息的操作是在application.js里进行封装和操作。 现在我们已经实现了request.js、response.js,获取到了request、response对象和他们的封装的方法,然后我们开始实现context.js,context的作用就是将request、response对象挂载到ctx的上面,让koa实例和代码能方便的使用到request、response对象中的方法。现在我们创建context.js文件,输入如下代码: let proto = {}; function delegateSet(property, name) { proto.__defineSetter__(name, function (val) { this[property][name] = val; }); } function delegateGet(property, name) { proto.__defineGetter__(name, function () { return this[property][name]; }); } let requestSet = []; let requestGet = ['query']; let responseSet = ['body', 'status']; let responseGet = responseSet; requestSet.forEach(ele => { delegateSet('request', ele); }); requestGet.forEach(ele => { delegateGet('request', ele); }); responseSet.forEach(ele => { delegateSet('response', ele); }); responseGet.forEach(ele => { delegateGet('response', ele); }); module.exports = proto; context.js文件主要是对常用的request和response方法进行挂载和代理,通过context.query直接代理了context.request.query,context.body和context.status代理了context.response.body与context.response.status。而context.request,context.response则会在application.js中挂载 本来可以用简单的setter和getter去设置每一个方法,但是由于context对象定义方法比较简单和规范,在koa源码里可以看到,koa源码用的是defineSetter和defineSetter来代替setter/getter每一个属性的读取设置,这样做主要是方便拓展和精简了写法,当我们需要代理更多的res和req的方法的时候,可以向context.js文件里面的数组对象里面添加对应的方法名和属性名即可。 目前为止,我们已经得到了request、response、context三个模块对象了,接下来就是将request、response所有方法挂载到context下,让context实现它的承上启下的作用,修改application.js文件,添加如下代码: let http = require('http'); let context = require('./context'); let request = require('./request'); let response = require('./response'); createContext(req, res) { let ctx = Object.create(this.context); ctx.request = Object.create(this.request); ctx.response = Object.create(this.response); ctx.req = ctx.request.req = req; ctx.res = ctx.response.res = res; return ctx; } 可以看到,我们添加了createContext这个方法,这个方法是关键,它通过Object.create创建了ctx,并将request和response挂载到了ctx上面,将原生的req和res挂载到了ctx的子属性上,往回看一下context/request/response.js文件,就能知道当时使用的this.res或者this.response之类的是从哪里来的了,原来是在这个createContext方法中挂载到了对应的实例上,构建了运行时上下文ctx之后,我们的app.use回调函数参数就都基于ctx了。 模块三:中间件机制和剥洋葱模型的实现 目前为止我们已经成功实现了上下文context对象、 请求request对象和响应response对象模块,还差一个最重要的模块,就是koa的中间件模块,koa的中间件机制是一个剥洋葱式的模型,多个中间件通过use放进一个数组队列然后从外层开始执行,遇到next后进入队列中的下一个中间件,所有中间件执行完后开始回帧,执行队列中之前中间件中未执行的代码部分,这就是剥洋葱模型,koa的中间件机制。 koa的剥洋葱模型在koa1中使用的是generator + co.js去实现的,koa2则使用了async/await + Promise去实现的,接下来我们基于async/await + Promise去实现koa2中的中间件机制。首先,假设当koa的中间件机制已经做好了,那么它是能成功运行下面代码的: let Koa = require('../src/application'); let app = new Koa(); app.use(async (ctx, next) => { console.log(1); await next(); console.log(6); }); app.use(async (ctx, next) => { console.log(2); await next(); console.log(5); }); app.use(async (ctx, next) => { console.log(3); ctx.body = "hello world"; console.log(4); }); app.listen(3000, () => { console.log('listenning on 3000'); }); 运行成功后会在终端输出123456,那就能验证我们的koa的剥洋葱模型是正确的。接下来我们开始实现,修改application.js文件,添加如下代码: compose() { return async ctx => { function createNext(middleware, oldNext) { return async () => { await middleware(ctx, oldNext); } } let len = this.middlewares.length; let next = async () => { return Promise.resolve(); }; for (let i = len - 1; i >= 0; i--) { let currentMiddleware = this.middlewares[i]; next = createNext(currentMiddleware, next); } await next(); }; } callback() { return (req, res) => { let ctx = this.createContext(req, res); let respond = () => this.responseBody(ctx); let onerror = (err) => this.onerror(err, ctx); let fn = this.compose(); return fn(ctx); }; } koa通过use函数,把所有的中间件push到一个内部数组队列this.middlewares中,剥洋葱模型能让所有的中间件依次执行,每次执行完一个中间件,遇到next()就会将控制权传递到下一个中间件,下一个中间件的next参数,剥洋葱模型的最关键代码是compose这个函数: compose() { return async ctx => { function createNext(middleware, oldNext) { return async () => { await middleware(ctx, oldNext); } } let len = this.middlewares.length; let next = async () => { return Promise.resolve(); }; for (let i = len - 1; i >= 0; i--) { let currentMiddleware = this.middlewares[i]; next = createNext(currentMiddleware, next); } await next(); }; } createNext函数的作用就是将上一个中间件的next当做参数传给下一个中间件,并且将上下文ctx绑定当前中间件,当中间件执行完,调用next()的时候,其实就是去执行下一个中间件。 for (let i = len - 1; i >= 0; i--) { let currentMiddleware = this.middlewares[i]; next = createNext(currentMiddleware, next); } 上面这段代码其实就是一个链式反向递归模型的实现,i是从最大数开始循环的,将中间件从最后一个开始封装,每一次都是将自己的执行函数封装成next当做上一个中间件的next参数,这样当循环到第一个中间件的时候,只需要执行一次next(),就能链式的递归调用所有中间件,这个就是koa剥洋葱的核心代码机制。 到这里我们总结一下上面所有剥洋葱模型代码的流程,通过use传进来的中间件是一个回调函数,回调函数的参数是ctx上下文和next,next其实就是控制权的交接棒,next的作用是停止运行当前中间件,将控制权交给下一个中间件,执行下一个中间件的next()之前的代码,当下一个中间件运行的代码遇到了next(),又会将代码执行权交给下下个中间件,当执行到最后一个中间件的时候,控制权发生反转,开始回头去执行之前所有中间件中剩下未执行的代码,这整个流程有点像一个伪递归,当最终所有中间件全部执行完后,会返回一个Promise对象,因为我们的compose函数返回的是一个async的函数,async函数执行完后会返回一个Promise,这样我们就能将所有的中间件异步执行同步化,通过then就可以执行响应函数和错误处理函数。 当中间件机制代码写好了以后,运行我们的上面的例子,已经能输出123456了,至此,我们的koa的基本框架已经基本做好了,不过一个框架不能只实现功能,为了框架和服务器实例的健壮,还需要加上错误处理机制。 模块四:错误捕获和错误处理 要实现一个基础框架,错误处理和捕获必不可少,一个健壮的框架,必须保证在发生错误的时候,能够捕获到错误和抛出的异常,并反馈出来,将错误信息发送到监控系统上进行反馈,目前我们实现的简易koa框架还没有能实现这一点,我们接下加上错误处理和捕获的机制。 throw new Error('oooops'); 基于现在的框架,如果中间件代码中出现如上错误异常抛出,是捕获不到错误的,这时候我们看一下application.js中的callback函数的return返回代码,如下: return fn(ctx).then(respond); 可以看到,fn是中间件的执行函数,每一个中间件代码都是由async包裹着的,而且中间件的执行函数compose返回的也是一个async函数,我们根据es7的规范知道,async返回的是一个promise的对象实例,我们如果想要捕获promise的错误,只需要使用promise的catch方法,就可以把所有的中间件的异常全部捕获到,修改后callback的返回代码如下: return fn(ctx).then(respond).catch(onerror); 现在我们已经实现了中间件的错误异常捕获,但是我们还缺少框架层发生错误的捕获机制,我们希望我们的服务器实例能有错误事件的监听机制,通过on的监听函数就能订阅和监听框架层面上的错误,实现这个机制不难,使用nodejs原生events模块即可,events模块给我们提供了事件监听on函数和事件触发emit行为函数,一个发射事件,一个负责接收事件,我们只需要将koa的构造函数继承events模块即可,构造后的伪代码如下: let EventEmitter = require('events'); class Application extends EventEmitter {} 继承了events模块后,当我们创建koa实例的时候,加上on监听函数,代码如下: let app = new Koa(); app.on('error', err => { console.log('error happends: ', err.stack); }); 这样我们就实现了框架层面上的错误的捕获和监听机制了。总结一下,错误处理和捕获,分中间件的错误处理捕获和框架层的错误处理捕获,中间件的错误处理用promise的catch,框架层面的错误处理用nodejs的原生模块events,这样我们就可以把一个服务器实例上的所有的错误异常全部捕获到了。至此,我们就完整实现了一个轻量版的koa框架了。 结尾 前为止,我们已经实现了一个轻量版的koa框架了,我们实现了封装node http server、创建Koa类构造函数、构造request、response、context对象、中间件机制和剥洋葱模型的实现、错误捕获和错误处理这四个大模块,理解了这个轻量版koa的实现原理,再去看koa2的源码,你就会发现一切都豁然开朗,koa2的源码无非就是在这个轻量版基础上加了很多工具函数和细节的处理,限于篇幅笔者就不再一一介绍了。 原文链接:https://www.jianshu.com/p/a64e098ae017

优秀的个人博客,低调大师

Java并发编程中的设计模式解析(一)

Java并发编程,除了被用于各种Web应用、分布式系统和大数据系统,构成高并发系统的核心基础外,其本身也蕴含着大量的设计模式思想在里面。这一系列文章主要是结合Java源码,对并发编程中使用到的、实现的各类设计模式做归纳总结,以便进一步沉淀对Java并发设计的理解。 模板设计模式 Thread类中run和start方法,就是一个典型的模板设计模式的实现,即:父类定义算法逻辑代码,子类实现其细节。 1 public synchronized void start() { 2 /** 3 * 线程对象新建后的New状态,其内部thereadStatus属性为0 4 */ 5 if (threadStatus != 0) 6 throw new IllegalThreadStateException(); 7 8 /* 同时会被添加到一个ThreadGroup */ 9 group.add(this); 10 11 boolean started = false; 12 //调用JNI方法start0()来启动线程 13 try { 14 start0(); 15 started = true; 16 } finally { 17 //线程结束之后,再次启动将抛出异常 18 try { 19 if (!started) { 20 group.threadStartFailed(this); 21 } 22 } catch (Throwable ignore) { 23 /* do nothing. If start0 threw a Throwable then 24 it will be passed up the call stack */ 25 } 26 } 27 } 下面以一个例子演示模板模式: public class TemplateMethod { //相当于Thread类的start方法, 用final修饰避免被更改 public final void print(String message) { System.out.println("-------------"); wrapPrint(message); System.out.println("-------------"); } //相当于Thread的run方法, 用protected修饰限于子类重写 protected void wrapPrint(String message) { } public static void main(String[] args) { //通过匿名内部子类, 重写父类的wrapPrint方法, 从而实现不同的输出模板 TemplateMethod t1 = new TemplateMethod() { @Override protected void wrapPrint(String message) { System.out.println("111" + message + "111"); } }; t1.print("Hello World!"); TemplateMethod t2 = new TemplateMethod() { @Override protected void wrapPrint(String message) { System.out.println("222" + message + "222"); } }; t2.print("Hello World!"); } } 策略模式 创建Java多线程中,实现Runnable接口作为Target并传入Thread类的构造方法来生成线程对象的过程,就体现了GoF中策略模式的设计思想。下面是一个简单的示例: 首先,仿照Runnable接口的思想,定义一个用于处理数据库行的接口 1 /* 2 * RowHandler定义了对数据库查询返回结果操作的方法, 具体实现需要 3 * 实现类完成, 类似于Runnable接口 4 */ 5 public interface RowHandler<T> { 6 T handle(ResultSet rs); 7 } 然后,仿照Thread方法,定义数据库查询的工作类 1 public class RecordQuery { 2 3 private final Connection connection; 4 5 public RecordQuery(Connection connection) { 6 this.connection = connection; 7 } 8 //方法中传入RowHandler的实现类 9 public <T> T query(RowHandler<T> handler, String sql, Object... params) throws SQLException { 10 PreparedStatement stmt; 11 ResultSet resultSet; 12 stmt = connection.prepareStatement(sql); 13 int index = 1; 14 for (Object param : params) { 15 stmt.setObject(index++, param); 16 } 17 resultSet = stmt.executeQuery(); 18 //调用实现类的handle方法来处理数据 19 return handler.handle(resultSet); 20 } 21 } 生产者-消费者模式 生产者-消费者模式是使用Java并发编程通信所实现的经典模式之一。该模式是通过队列这一数据结构来存储对象元素,由多线程分别充当生产者和消费者,生产者不断生成元素、消费者不断消费元素的过程。下面通过代码来演示: 实现一个带有入队和出队的队列 1 /* 2 * 通过一个生产者-消费者队列来说明线程通信的基本使用方法 3 */ 4 public class EventQueue { 5 //定义一个队列元素数量, 一旦赋值则不可更改 6 private final int max; 7 //定义一个空的内部类, 代表存储元素 8 static class Event{ } 9 //定义一个不可改的链表集合, 作为队列载体 10 private final LinkedList<Event> eventQueue = new LinkedList<>(); 11 //如果不指定初始容量, 则容量默认为10 12 private final static int DEFAULT_MAX_EVENT = 10; 13 //使用自定义容量初始化队列 14 public EventQueue(int max) { 15 this.max = max; 16 } 17 //如果不指定初始容量, 则容量默认为10 18 public EventQueue() { 19 this(DEFAULT_MAX_EVENT); 20 } 21 //封装一个输出到控制台的方法 22 private void console(String message) { 23 System.out.printf("%s:%s\n",Thread.currentThread().getName(), message); 24 } 25 //定义入队方法 26 public void offer(Event event) { 27 //使用链表对象作为锁, 通过synchronized代码块实现同步 28 synchronized(eventQueue) { 29 //在循环中判断如果队列已满, 则调用锁的wait方法, 使生产者线程阻塞 30 while(eventQueue.size() >= max) { 31 try { 32 console(" the queue is full"); 33 eventQueue.wait(); 34 } catch (InterruptedException e) { 35 e.printStackTrace(); 36 } 37 } 38 console(" the new event is submitted"); 39 eventQueue.addLast(event); 40 //唤醒所有等待中的消费者;注意如果此处使用notify(),可能导致线程不安全 41 this.eventQueue.notifyAll(); 42 } 43 } 44 //定义出队方法 45 public Event take() { 46 //使用链表对象作为锁 47 synchronized(eventQueue) { 48 //在循环中判断如果队列已空, 则调用锁的wait方法, 使消费者线程阻塞 49 while(eventQueue.isEmpty()) { 50 try { 51 console(" the queue is empty."); 52 eventQueue.wait(); 53 } catch (InterruptedException e) { 54 e.printStackTrace(); 55 } 56 } 57 Event event = eventQueue.removeFirst(); 58 //唤醒所有等待中的生产者;注意如果此处使用notify(),可能导致线程不安全 59 this.eventQueue.notifyAll(); 60 console(" the event " + event + " is handled/taked."); 61 return event; 62 } 63 } 64 } 验证该队列的类 1 /* 2 * producer/client pattern 3 */ 4 public class EventClient { 5 6 public static void main(String[] args) { 7 //定义不可变队列实例 8 final EventQueue eventQueue = new EventQueue(); 9 //新建生产者线程, 可以设置多个 10 new Thread(()->{ 11 while(true) { 12 eventQueue.offer(new EventQueue.Event()); 13 } 14 }, "producer").start(); 15 //新建消费者线程, 可以设置多个 16 new Thread(()->{ 17 while(true) { 18 eventQueue.take(); 19 try { 20 TimeUnit.MILLISECONDS.sleep(10); 21 } catch (InterruptedException e) { 22 e.printStackTrace(); 23 } 24 } 25 }, "consumer").start(); 26 } 27 }

优秀的个人博客,低调大师

Android Handler机制(不含源码解析,适合新手理解)

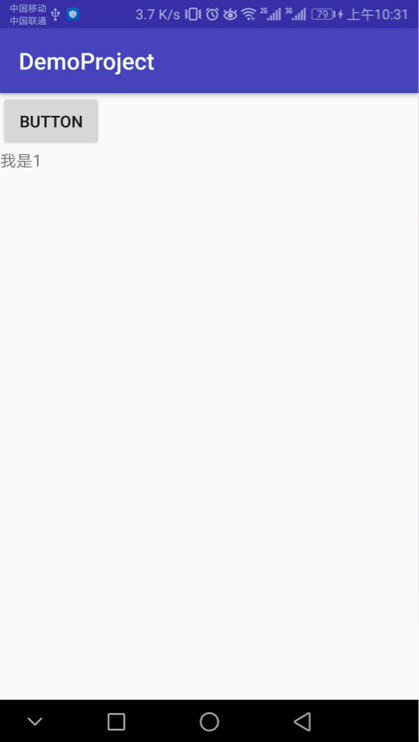
一、官方解释 A Handler allows you to send and process [Message](https://developer.android.com/reference/android/os/Message.html) and Runnable objects associated with a thread's [MessageQueue](https://developer.android.com/reference/android/os/MessageQueue.html). Each Handler instance is associated with a single thread and that thread's message queue. When you create a new Handler, it is bound to the thread / message queue of the thread that is creating it -- from that point on, it will deliver messages and runnables to that message queue and execute them as they come out of the message queue. There are two main uses for a Handler: (1) to schedule messages and runnables to be executed at some point in the future; and (2) to enqueue an action to be performed on a different thread than your own. Scheduling messages is accomplished with the [post(Runnable)](https://developer.android.com/reference/android/os/Handler.html#post(java.lang.Runnable)), [postAtTime(Runnable, long)](https://developer.android.com/reference/android/os/Handler.html#postAtTime(java.lang.Runnable,%20long)),[postDelayed(Runnable, Object, long)](https://developer.android.com/reference/android/os/Handler.html#postDelayed(java.lang.Runnable,%20java.lang.Object,%20long)), [sendEmptyMessage(int)](https://developer.android.com/reference/android/os/Handler.html#sendEmptyMessage(int)), [sendMessage(Message)](https://developer.android.com/reference/android/os/Handler.html#sendMessage(android.os.Message)), [sendMessageAtTime(Message, long)](https://developer.android.com/reference/android/os/Handler.html#sendMessageAtTime(android.os.Message,%20long)), and [sendMessageDelayed(Message, long)](https://developer.android.com/reference/android/os/Handler.html#sendMessageDelayed(android.os.Message,%20long)) methods. The post versions allow you to enqueue Runnable objects to be called by the message queue when they are received; the sendMessageversions allow you to enqueue a [Message](https://developer.android.com/reference/android/os/Message.html) object containing a bundle of data that will be processed by the Handler's [handleMessage(Message)](https://developer.android.com/reference/android/os/Handler.html#handleMessage(android.os.Message)) method (requiring that you implement a subclass of Handler). When posting or sending to a Handler, you can either allow the item to be processed as soon as the message queue is ready to do so, or specify a delay before it gets processed or absolute time for it to be processed. The latter two allow you to implement timeouts, ticks, and other timing-based behavior. When a process is created for your application, its main thread is dedicated to running a message queue that takes care of managing the top-level application objects (activities, broadcast receivers, etc) and any windows they create. You can create your own threads, and communicate back with the main application thread through a Handler. This is done by calling the same post or sendMessage methods as before, but from your new thread. The given Runnable or Message will then be scheduled in the Handler's message queue and processed when appropriate. 翻译: 处理程序允许您发送和处理与线程的MessageQueue相关联的消息和可运行对象。每个处理程序实例都与单个线程和线程的消息队列相关联。当您创建一个新的Handler时,它将绑定到正在创建它的线程的线程/消息队列——从那时起,它将向该消息队列传递消息和可运行文件,并在它们从消息队列中出来时执行它们。 处理程序有两种主要用途:(1)调度消息和将来某个时间点要执行的可运行文件;(2)为要在不同线程上执行的操作排队。 调度消息是通过post(Runnable)、postAtTime(Runnable,long)、postDelayed(Runnable,Object,long)、sendEmptyMessage(int)、sendMessage(Message)、sendMessageAtTime(Message,long)和sendMessageDelayed(Message,long)方法完成的。post版本允许您在收到消息队列时对要由消息队列调用的Runable对象进行排队;sendMessage版本允许您对消息对象进行排队,该消息对象包含将由Handler的handleMessage(Message)方法处理的数据束(需要实现汉德勒的一个亚类。 当发布或发送给处理程序时,您可以允许在消息队列准备就绪时立即处理项,或者指定在处理项之前的延迟或处理项的绝对时间。后两者允许您实现超时、滴答和其他基于时间的行为。 在为应用程序创建进程时,其主线程专用于运行消息队列,该队列负责管理顶级应用程序对象(活动、广播接收器等)及其创建的任何窗口。您可以创建自己的线程,并通过处理程序与主应用程序线程通信。这是通过调用相同的POST或SeNeMeST方法与以前一样,但是从新线程中调用。然后,给定的可运行或消息将被安排在处理程序的消息队列中,并在适当的时候进行处理。 装逼结束 二、个人理解(简书Handler作用与机制) Handler,用于发送消息和处理消息。我们在开发中使用Handler一般用于更新UI,或者延时处理事件。 包括但不限于。 Handler机制,其工作核心主要包括四大部分: Message、MessageQueue、Looper、Handler。这四大部分 其工作流程大致如下: 创建 消息(Massage ), 将消息存到消息队列(MessageQueue)当中, 由消息泵(Looper)将消息从消息队列中抽取出来, 并且交给Handler处理。 来个实践Demo感受一下吧。 代码如下: 注:xml代码我就不贴了,就是一个Button一个TextView。 public class MainActivity extends AppCompatActivity { Button button; TextView textView; private final int HANDLER_FLAG = 1; private Handler handler = new Handler() { @Override public void handleMessage(Message msg) { super.handleMessage(msg); switch (msg.what) { case HANDLER_FLAG: textView.setText("我的点击后的值"); break; default: break; } } }; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); button = findViewById(R.id.main_btn); textView = findViewById(R.id.main_tv); button.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View v) { handler.sendEmptyMessage(HANDLER_FLAG); } }); } } 下面是点击的效果图 点击前 点击前.png 点击之后 点击后.png 不仅仅可以用死值,当然也可以传值: public class MainActivity extends AppCompatActivity { Button button; TextView textView; private final int HANDLER_FLAG = 1; private Handler handler = new Handler() { @Override public void handleMessage(Message msg) { super.handleMessage(msg); switch (msg.what) { case HANDLER_FLAG: textView.setText(msg.obj.toString() + ""); break; default: break; } } }; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); button = findViewById(R.id.main_btn); textView = findViewById(R.id.main_tv); button.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View v) { Message message = new Message(); message.obj = "这是点击后的值11111"; message.what = HANDLER_FLAG; handler.sendMessage(message); } }); } } 下面是效果图: 点击前就不贴了,直接上点击后的吧。 image.png Handler中有很多消息,可以发送空消息,实体消息,还有延迟发送。 具体的使用可以去官方文档上看,或者百度,我这里仅仅贴出基本使用,和经常使用。 如果不足和建议,欢迎提出。 我的博客即将入驻“云栖社区”,诚邀技术同仁一同入驻。

优秀的个人博客,低调大师

Java编程架构深入解析-RPC 消息协议设计

本节我们开始讲解 RPC 的消息协议设计背后的基本原理,了解 RPC 的协议开发背后有哪些需要考虑的基本点。在通晓原理之后,我们就可以自己设计一套协议来开发属于自己的 RPC 系统。 本节主要涉及的知识点和它们之见的关系如下图: 对于一串消息流,我们必须能确定消息边界,提取出单条消息的字节流片段,然后对这个片段按照一定的规则进行反序列化来生成相应的消息对象。 消息表示指的是序列化后的消息字节流在直观上的表现形式,它看起来是对人类友好还是对计算机友好。文本形式对人类友好,二进制形式对计算机友好。 每个消息都有其内部字段结构,结构构成了消息内部的逻辑规则,程序要按照结构规则来决定字段序列化的顺序。 接下来,我们初步详细拆解。 消息边界 RPC 需要在一条 TCP 链接上进行多次消息传递。在连续的两条消息之间必须有明确的分割规则,以便接收端可以将消息分割开来,这里的接收端可以是 RPC 服务器接收请求,也可以是 RPC 客户端接收响应。 基于 TCP 链接之上的单条消息如果过大,就会被网络协议栈拆分为多个数据包进行传送。如果消息过小,网络协议栈可能会将多个消息组合成一个数据包进行发送。对于接收端来说它看到的只是一串串的字节数组,如果没有明确的消息边界规则,接收端是无从知道这一串字节数组究竟是包含多条消息还是只是某条消息的一部分。 比较常用的两种分割方式是特殊分割符法和长度前缀法。 消息发送端在每条消息的末尾追加一个特殊的分割符,并且保证消息中间的数据不能包含特殊分割符。比如最为常见的分割符是 。当接收端遍历字节数组时发现了 ,就立即可以断定 之前的字节数组是一条完整的消息,可以传递到上层逻辑继续进行处理。HTTP 和 Redis 协议就大量使用了 分割符。此种消息一般要求消息体的内容是文本消息。 消息发送端在每条消息的开头增加一个 4 字节长度的整数值,标记消息体的长度。这样消息接受者首先读取到长度信息,然后再读取相应长度的字节数组就可以将一个完整的消息分离出来。此种消息比较常用于二进制消息。 基于特殊分割符法的优点在于消息的可读性比较强,可以直接看到消息的文本内容,缺点是不适合传递二进制消息,因为二进制的字节数组里面很容易就冒出连续的两个字节内容正好就是 分割符的 ascii 值。如果需要传递的话,一般是对二进制进行 base64 编码转变成普通文本消息再进行传送。 基于长度前缀法的优点和缺点同特殊分割符法正好是相反的。长度前缀法因为适用于二进制协议,所以可读性很差。但是对传递的内容本身没有特殊限制,文本和内容皆可以传输,不需要进行特殊处理。HTTP 协议的 Content-Length 头信息用来标记消息体的长度,这个也可以看成是长度前缀法的一种应用。 HTTP 协议是一种基于特殊分割符和长度前缀法的混合型协议。比如 HTTP 的消息头采用的是纯文本外加 分割符,而消息体则是通过消息头中的 Content-Type 的值来决定长度。HTTP 协议虽然被称之为文本传输协议,但是也可以在消息体中传输二进制数据数据的,例如音视频图像,所以 HTTP 协议被称之为「超文本」传输协议。 消息的结构 每条消息都有它包含的语义结构信息,有些消息协议的结构信息是显式的,还有些是隐式的。比如 json 消息,它的结构就可以直接通过它的内容体现出来,所以它是一种显式结构的消息协议。 json 这种直观的消息协议的可读性非常棒,但是它的缺点也很明显,有太多的冗余信息。比如每个字符串都使用双引号来界定边界,key/value 之间必须有冒号分割,对象之间必须使用大括号分割等等。这些还只是冗余的小头,最大的冗余还在于连续的多条 json 消息即使结构完全一样,仅仅只是 value 的值不一样,也需要发送同样的 key 字符串信息。 消息的结构在同一条消息通道上是可以复用的,比如在建立链接的开始 RPC 客户端和服务器之间先交流协商一下消息的结构,后续发送消息时只需要发送一系列消息的 value 值,接收端会自动将 value 值和相应位置的 key 关联起来,形成一个完成的结构消息。在 Hadoop 系统中广泛使用的 avro 消息协议就是通过这种方式实现的,在 RPC 链接建立之处就开始交流消息的结构,后续消息的传递就可以节省很多流量。 消息的隐式结构一般是指那些结构信息由代码来约定的消息协议,在 RPC 交互的消息数据中只是纯粹的二进制数据,由代码来确定相应位置的二进制是属于哪个字段。比如下面的这段代码 如果纯粹看消息内容是无法知道节点消息内容中的哪些字节的含义,它的消息结构是通过代码的结构顺序来确定的。这种隐式的消息的优点就在于节省传输流量,它完全不需要传输结构信息。 消息压缩 如果消息的内容太大,就要考虑对消息进行压缩处理,这可以减轻网络带宽压力。但是这同时也会加重 CPU 的负担,因为压缩算法是 CPU 计算密集型操作,会导致操作系统的负载加重。所以,最终是否进行消息压缩,一定要根据业务情况加以权衡。 如果确定压缩,那么在选择压缩算法包时,务必挑选那些底层用 C 语言实现的算法库,因为 Python 的字节码执行起来太慢了。比较流行的消息压缩算法有 Google 的 snappy 算法,它的运行性能非常好,压缩比例虽然不是最优的,但是离最优的差距已经不是很大。阿里的 SOFA RPC 就使用了 snappy 作为协议层压缩算法。 流量的极致优化 开源的流行 RPC 消息协议往往对消息流量优化到了极致,它们通过这种方式来打动用户,吸引用户来使用它们。比如对于一个整形数字,一般使用 4 个字节来表示一个整数值。 但是经过研究发现,消息传递中大部分使用的整数值都是很小的非负整数,如果全部使用 4 个字节来表示一个整数会很浪费。所以就发明了一个类型叫变长整数varint。数值非常小时,只需要使用一个字节来存储,数值稍微大一点可以使用 2 个字节,再大一点就是 3 个字节,它还可以超过 4 个字节用来表达长整形数字。 其原理也很简单,就是保留每个字节的最高位的 bit 来标识是否后面还有字节,1 表示还有字节需要继续读,0 表示到读到当前字节就结束。 那如果是负数该怎么办呢?-1 的 16 进制数是 0xFFFFFFFF,如果要按照这个编码那岂不是要 6 个字节才能存的下。-1 也是非常常见的整数啊。 于是 zigzag 编码来了,专门用来解决负数问题。zigzag 编码将整数范围一一映射到自然数范围,然后再进行 varint 编码。 zigzag 将负数编码成正奇数,正数编码成偶数。解码的时候遇到偶数直接除 2 就是原值,遇到奇数就加 1 除 2 再取负就是原值。 小结 现在我们知道了 RPC 消息结构的设计原理,遵循这些基本方法,就可以创造出一个又一个不同的消息协议。 感谢阅读, 迎工作一到五年的Java程序员朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=57Uu0p5 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

深入解析阿里 PouchContainer 如何实现容器原地升级

作者:仔仁 PouchContainer 是阿里巴巴集团开源的高效、轻量级企业级富容器引擎技术,拥有隔离性强、可移植性高、资源占用少等特性。可以帮助企业快速实现存量业务容器化,同时提高超大规模下数据中心的物理资源利用率。已助力阿里巴巴集团实现在线业务 100% 容器化,双 11 容器规模达到百万级。 背景 阿里巴巴集团内部,容器使用方式有很大一部分是富容器模式,像这种基于传统虚拟机运维模式下的富容器,其中也有一定数量容器仍然是有状态的。有状态服务的更新和升级是企业内部频率很高的一个日常操作,对于以镜像为交付的容器技术来说,服务的更新和升级,对应的容器操作实际上是两步:旧镜像容器的删除,以及新镜像容器的创建。而有状态服务的升级,则要求保证新容器必须继承旧容器所有的资源,比如网络、存储等信息。下面给出两个实际的业务案例来直观阐述富容器业务发

优秀的个人博客,低调大师

C# 内存分配&&垃圾回收解析

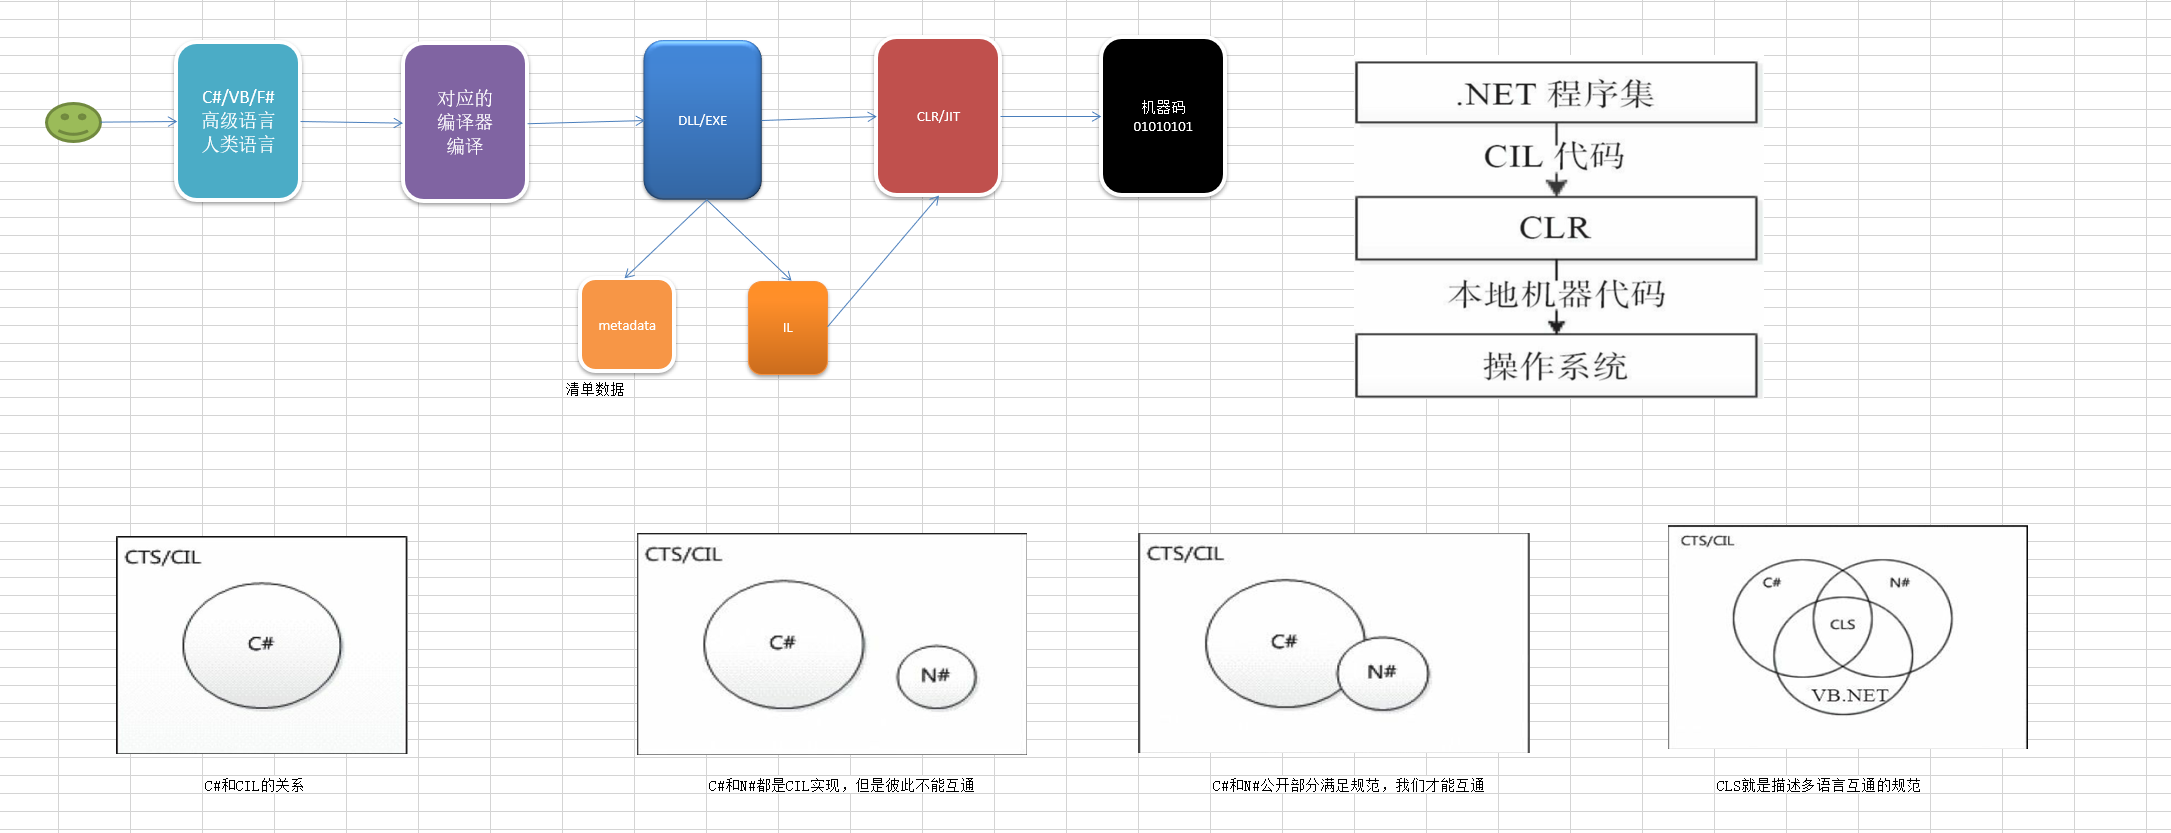
在学习C#的过程中,大家一定会听说过一些CLR、JIT、LR、什么堆栈分配、内存释放的东西,谈到大家对这些元素的理解,多数都是这些是操作系统里面的东西,值类型、引用类型会和堆栈相关,但是在问到这些提到的名称具体是做什么的,或者扮演什么样的角色的时候,大家好像也能讲出点什么,但是也讲得模模糊糊,虽然这些都是一些理论知识,而且在开发的过程中可能也用不到,但还是能尽量多了解一下比较好,今天,笔者就谈一谈自己对这些元素的理解 有说的不准确或者不正确的地方欢迎留言指正 在日常生活中,如果要和其他语种的人交流,而且自己还不懂得情况下我们会怎么办?首先会想到找翻译软件,首先把自己说的话输入到翻译软件中,软件会根据输入文字的语法转到另一种歪果仁说的语言,其中主要步骤会经过检测-----校验-----输出。 其实在计算机的世界中,代码编译成0101这种形式的机器码也是大概如此,首先我们会在编译器中(例如:visual studio 2017)根据逻辑的需求编写C#代码,这个可以理解为我们说的母语,然后经过计算机的翻译编译成机器能听懂的语言(机器码),而下图中显示的 【metadata】【IL】【CLR】【JIT】就是在上面举例中提到翻译,翻译过程中【检测】----【校验】----【输出】需要这些元素的参与 缩写的全称: CTS是通用类型系统(Common Type System) CLR是公共语言运行时(Common language runtime) CLS是公共语言定义(Common Language Specification) 参考链接:https://blog.csdn.net/huang_xw/article/details/8578162 参考链接:https://docs.microsoft.com/zh-cn/dotnet/standard/common-type-system 代码编译后会形成DLL或者EXE文件,在这些文件中含有【metadata】与【IL】两种元素,下面我们逐一说明这两个元素的用途 metadata 通俗的讲:metadata就是一个档案库,一份清单,一个说明里面含有什么东西的列表。他里面详细的说明这个DLL或者EXE文件中都有什么类、函数、属性、字段、版本号等等,而且经常用到的特性(Attribute)的信息也在里面,不熟悉【特性】的小伙伴请看Unity C#基础之 特性,一个灵活的小工具。(也就是举例中需要翻译的是什么语言,多少个字,含有什么标点符号,在什么位置等等这些信息) IL(中间语言) IL又称:中间语言,他在翻译过程中是起到牵线搭桥的作用,类似于我能听懂(编译器),歪果仁也能听懂(计算机)的语言。如果想查看IL可以使用ILSpy反编译工具查看 上面提到的【metadata】【IL】仅仅是翻译前的准备工作,下面才是开始正式的【检测】----【校验】----【输出】 首先说下CLR 说道CLR他就厉害了,正是因为有了CLR这种运行环境,才能让不同语言编译的IL得以在不同的操作系统中运行,例如32位、64位的操作系统,而且不同的操作系统里面额CLR也是不一样的。 然后是JIT 基于上面提到的CLR环境,JIT根据不同的CLR将相同的IL依据清单(metadata)和dll或exe,开始正式的【检测】----【校验】----【输出】生成0101这种的机器码,JIT编译的时候会检测是否编译过机器码。如果编译过拿过来复用 上面说到的整体流程可以看一下托管执行过程 接下来说一下.NET 中的内存管理和垃圾回收 因为下面所提到的都是总结性结论,参考地址MSDN官方文档 .NET 中的内存管理和垃圾回收 什么是“托管代码”? 自动内存管理 线程栈:栈-stack 先进后出的数据结构 随着线程而分配的 默认执行方法分配1MB内存 对象堆:内存,进程中独立画出来的一块儿内存,有一些对象长期使用不释放的,例如static,方便对象重用(多个对象指向一个内存地址) 我们结合代码来说一下堆栈的分配 public struct ValuePoint// : System.ValueType 结构不能有父类,因为隐式继承了ValueType(通过反编译工具可查看) { public int x; public ValuePoint(int x) { this.x = x; } } public void Test() { //内存分配:线程栈 {//值类型分配在线程栈,变量和值都是在线程栈 ValuePoint valuePoint;//先声明变量,没有初始化 但是我可以正常赋值 跟类不同 valuePoint.x = 123; ValuePoint point = new ValuePoint(); Console.WriteLine(valuePoint.x); } } 声明的valuePoint和他对应的x都是在栈上面的 public class ReferencePoint { public int x; public ReferencePoint(int x) { this.x = x; } } public void Test() { ReferencePoint referencePoint = new ReferencePoint(123); } 引用类型分布在堆上面 变量是在栈上的(保存的地址),值是在堆上面 new的时候去堆开辟内存,分配一个地址 调用构造函数(因为在构造函数里可以使用this),才执行构造函数把引用传给变量 /// <summary> /// class 引用类型 /// </summary> public class ReferenceTypeClass { private int _valueTypeField;//堆:因为对象都在堆里,对象里面的属性也在堆里 public ReferenceTypeClass() { _valueTypeField = 0; } public void Method() { int valueTypeLocalVariable = 0;//栈:全新的局部变量,线程栈来调用方法,然后分配内存 } } public void Test() { ReferenceTypeClass referenceTypeClassInstance = new ReferenceTypeClass(); referenceTypeClassInstance.Method(); } _valueTypeField是在堆上面,因为对象都在堆里,对象里面的属性也在堆里 valueTypeLocalVariable是在栈上面,因为全新的局部变量,线程栈来调用方法,然后分配内存 /// <summary> /// 值类型 /// </summary> public struct ValueTypeStruct { private object _referenceTypeField;// 这个对象的变量在栈上,值在堆上 public ValueTypeStruct(int x) { _referenceTypeField = new object(); } public void Method() { object referenceTypeLocalVariable = new object();//这个对象的变量在栈上,值在堆上 } } public void Test() { ValueTypeStruct valueTypeStructInstance = new ValueTypeStruct(); valueTypeStructInstance.Method(); } _referenceTypeField这个对象的变量在栈上(保存地址),值在堆上 referenceTypeLocalVariable这个对象的变量在栈上(保存地址),值在堆上 综上所述: 方法的局部变量:根据变量自身决定,跟所在的环境没关系 对象是引用类型,其属性/字段,都是在堆里面 对象是值类型,其属性/字段,值类型就在栈里 引用类型就在堆里 引用类型任何时候都在堆里;值类型都在栈里, 除非值类型所在对象是在堆里(ReferencePoint这个例子就是) 装箱和拆箱(C# 编程指南) { int i = 0; object oValue = i; i = (int)oValue; } 装箱拆箱(仅仅是说内存的拷贝动作):内存copy 也会浪费性能 通常都是因为object 装箱拆箱只能发生在父子类里面, 否则无法转换 string字符串内存分配 string student = "菜鸟海澜";//开辟一块儿内存 放入“菜鸟海澜“ 返还一个引用(student变量) string student2 = student;//把student的引用copy一份儿给student2 Console.WriteLine(student);//打印结果 菜鸟海澜 Console.WriteLine(student2);//打印结果 菜鸟海澜 student2 = "菜鸟"; Console.WriteLine(student);//打印结果 :菜鸟海澜 Console.WriteLine(student2);//打印结果:菜鸟 改了student2的值 但是不是修改内存;因为string字符串的内存是不可变的 赋值其实是new string(APP),重新开辟内存,返回引用 不可变是因为享元,可能有多个变量指向同一个字符串,字符串变化了,多个变量都会受到影响。(例如多个类中的不同字符串变量都声明 "菜鸟海澜",本质上都是指向一个地址) 还因为堆里面的内存是连续分配的,如果变长度,会导致大量数据的移动 string student = "菜鸟海澜"; string student2 = "菜鸟";//共享 student2 = "菜鸟海澜"; Console.WriteLine(object.ReferenceEquals(student, student2));//打印结果为 True 就是同一个 享元模式 CLR内存分配字符串的时候,会查找相同值,有就重用了 使用享元的主要原因: 因为在堆中每个对象的内存都是紧密连接的,使用享元且不可改变,这样可以提高内存的使用率。 避免导致大量数据的移动,降低内存的重新分配、摆放(有不同的线程栈,但共用一个堆)。 垃圾回收 参考自 垃圾回收 与 清理非托管资源 网上一位开发者的文章:https://kb.cnblogs.com/page/106720/ 首先简述一下线程栈和托管堆的概念 值类型出现在线程栈:每次调用都有线程栈,,用完自己就结束,变量-值类型 都会释放的(不用我们维护) 引用类型出现在堆里:全局就一个堆,空间有限,所以才需要垃圾回收 操作系统里面,内存是链式分配的,可能有碎片的 CLR的堆:连续分配(数组),空间有限,节约空间 大对象策略:如果该对象占用内存大于85000字节,属于大对象,单独管理,用的是链表(碎片),避免频繁的内存移动造成性能消耗 下面要说的垃圾回收主要是以堆中的操作为主要内容 GC(Garbage Collector 的缩写) 1问:什么是垃圾? 垃圾是完全访问不到的东西了。例如临时变量,或者已经赋值为null的引用类型的变量 2问:什么时候会发生GC? gc发生在new的时候 new一个对象时,会开辟内存,看看空间够不够,不够的话就要GC了 gc程序退出的时候也会gc 手动GC。例如定时程序,很久执行一次,而且使用的时长很短,这时候就可以手动GC了 3问:怎么回收? new的时候发现内存不够,然后就去遍历所有堆的对象,标记有引用的对象,然后启动一个线程来清理内存 清除没有标记的对象,挪动其他剩余对象,然后整齐摆放,所以这个时候全部线程停止(开多线程时这个时候是停止的),不允许操作内存 内存不够的是指一级对象的内存,有个临界值,也不是全部的堆的大小 但是类中含有 析构函数【~类名称()】 ,内存的释放就需要单独的处理,把这些对象放入一个队列单独处理,具体哪一时刻调用析构函数不确定 注意:静态的对象是不会被回收的,且持有的引用也是不会被回收的 关于垃圾回收第几代的问题官方文档是这么说明的 在下面的例子中,声明一个静态变量staticStudent ,调用Test方法后主动调用GC,最终 变量【student】【@class】会被回收,但他们对应在堆中的内容不会被回收,因为有staticStudent 持有,变量 【i】会在弹栈之后直接被回收,变量【gCTest】以及它对应在堆中的内容都会被回收 private static Student staticStudent = new Student()//静态的不可能被回收 静态持有的引用也不会被回收 { Id = 123, Name = "菜鸟海澜" }; public void Test() { Student student = staticStudent; Class @class = new Class() { classId = 1, classdata = "数据" }; student.tempdata = @class; int i = 0;//都会被GC GCTest gCTest = new GCTest();//都会被GC } 在下面的示例中,很多开发者会把一个非静态变量设置成null,其实编译器会无视这句话,不是改成null这个对象没有了,其实内存还占用着,把对象赋值成null 意义不大,垃圾回收主要的原因是因为访问不到。但是静态可以把变量设置成null,促进垃圾回收,这样可以让变量不再被引用 Student student = new Student() { Id = 1, Name = "su9257", tempdata = new Class() { classId = 1, classdata = "数据1" } }; student = null; GC.Collect(); 非托管资源的释放 关于释放非托管资源必须要谈到的两个东西:【析构函数】和【Disposable】 析构函数 析构函数 主要是用来释放非托管资源(函数中调用具体释放资源的API或方法),等着GC的时候去把非托管资源释放掉 系统自动执行 GC回收的时候,CLR一定调用的,但是可能有延迟,具体是哪个时刻不确定 Dispose Dispose() 也是释放非托管资源的,主动释放(或手动调用),方法本身是没有意义的,我们需要在方法里面实现对资源的释放 GC不会调用,而是用对象时,使用者主动调用这个方法,去释放非托管资源 不过Dispose有一个自动调用的方法,就是使用【using】关键字,在using语句块运行完时自动调用Dispose方法(前提有的情况下)。且在Dispose方法中调用GC.SuppressFinalize(this);就是告诉CLR这个类我要释放的东西已经释放完了,你就不用调用析构函数了 using (Student student = new Student()) { Console.WriteLine("菜鸟海澜"); } public class People : IDisposable { public string Remark { get; set; } public virtual void Dispose() { Console.WriteLine($"执行{this.GetType().Name}Dispose"); } } public class Student : People, IDisposable { public int Id { get; set; } public string Name { get; set; } public Class tempdata { get; set; } public override void Dispose()//提供主动释放方式 { base.Dispose();//把我引用的其他东西给清理掉 if (this.tempdata != null) { this.tempdata.Dispose(); } //通知垃圾回收机制不再调用终结器(析构器) GC.SuppressFinalize(this); } 本质上是调用try finally try { } finally { //调用的dispose() }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册