首页 文章 精选 留言 我的

精选列表

搜索[notepad  ],共10025篇文章
优秀的个人博客,低调大师

BuildTask & BuildType

Build Tasks 在build文件中使用了Android或者Java插件之后就会自动创建一系列可以运行的任务。 Gradle中有如下一下默认约定的任务: assemble 该任务包含了项目中的所有打包相关的任务,比如java项目中打的jar包,Android项目中打的apk check 该任务包含了项目中所有验证相关的任务,比如运行测试的任务 build 该任务包含了assemble和check clean 该任务会清空项目的所有的输出,删除所有在assemble任务中打的包 assemble, check 和 build 任务实际上并不做任何事情,它们其实只是为插件提供了一个钩子,真正的事情都是由插件来完成的。这样的话,开发人员就不需要关心我到底运行的是一个java项目还是一个Android项目,也不用关心我到底使用了哪些gradle插件,因为我都可以调用这些约定的任务来完成构建。 注意:Gradle会自动检查一个任务的输入和输出。比如连续两次运行build任务的,Gradle会报告所有的任务都已经是最新刚运行过的了,不需要再次运行。这样的话,任务之间就算是有相互依赖,也不会导致重复的执行。 Java项目常用的任务 Java plugin 主要创建了两个任务: jar assemble任务会依赖jar任务,看名字就知道这是负责打jar包的任务。jar任务本身又会依赖很多其他的任务,比如classes任务,classes任务会编译java代码 test check任务会依赖test任务,这个任务会运行所有的测试。测试代码使用testClasses任务编译,但是我们基本不用手动运行testClasses任务因为test任务已经添加了对它的依赖。 通常情况下,我们只要运行assemble和check任务就够了。 Android项目常用的任务 和其他gradle插件一样,Android插件也提供了一些默认的任务,比如assemble,check,build,clean,同时它也提供了一些自己特有的任务,比如: connectedCheck 运行那些需要在真机或者模拟器上执行的检查任务,这些任务会并行地在所有连接的设备上运行 deviceCheck 使用APIs连接远程设备执行检查.主要用于CI(持续集成)服务上. 上面两个任务都会执行 assemble 和 check任务。新加这两个任务是很有必要的,这样可以保证我们可以运行那些不需要连接设备的检查任务。 注意:build任务并不依赖于deviceCheck或者connectedCheck 一个Android项目通常至少会有两种输出:debug apk和release apk。对应的gradle中有两个任务可以分别输出不同的apk:assembleDebug/assembleRelease。 这两个任务又会依赖其他的任务来构建一个apk。assemble任务依赖这两个任务,调用assemble任务就会生成两种apk。 BuildType 默认情况下,Android插件自动为项目构建一个debug和一个release版本的应用。这两个版本的不同主要体现在在非开发机上的调试功能以及APK的签名方式。debug版本使用一个用公开的name/password创建的key来签名(这样构建的时候就不需要提示输入密码了)。release版本在构建的时候不会进行签名,而是稍后在做。 这个可以使用gradle中的BuildType对象来进行配置。默认情况下,2个BuildType的实例会被创建,一个debug,一个release。Android插件允许自定义这两个实例,当然你也可以创建其他的build type。配置由buildTypes这个DSL来完成: android { buildTypes { debug { applicationIdSuffix ".debug" } jnidebug.initWith(buildTypes.debug) jnidebug { packageNameSuffix ".jnidebug" jniDebuggable true } } } 上面的代码完成了下列配置: 配置默认的debug Build Type 设置debug版本的包名为<应用id>.debug,这样就可以在设备上同时安装debug和release版本了。 创建一个新的BuildType,名字是jnidebug,同时配置它是复制自debug Build Type。 配置jnidebug开启debug版本的JNI组件,添加一个不同的包名后缀。 创建一个新的的Build Types非常简单,只需要在buildTypes下面通过调用initWith或者使用闭包添加一个新的元素。下表是可以配置的属性以及默认值: 属性名 debug版本默认值 release或其他版本默认值 debuggable true false jniDebuggable false false renderscriptDebuggable false false renderscriptOptimLevel 3 3 applicationIdSuffix null null versionNameSuffix null null signingConfig android.signingConfigs.debug null zipAlignEnabled false true minifyEnabled false false 除了这些属性,Build Types还可以用来配置代码和资源文件。针对每一个Build Type,一个新的对应的sourceSet会被创建,这个sourceSet使用一个默认的路径src/< buildtype名字>/。这就意味着Build Type的名字不能是main或者androidTest(这是由插件强制的),同时每个Build Type的名字必须是唯一的。 和其他的source sets一样,Build Type中的source set路径也是可以配置 android { sourceSets.jnidebug.setRoot('foo/jnidebug') } 另外,对每一个Build Type,一个新的assemble< BuildType名字>任务会被创建.当debug和release Build Types被预先创建的时候,他们对应的assemble任务也会被一起创建. 上面的build.gradle代码片段还会创建一个assembleJnidebug任务,assemble任务也会添加对assembleJniDebug任务的依赖,正如它对assembleDebug和assembleRelease任务的依赖一样。 可能是使用场景: 仅在debug模式下使用的权限,release模式不使用。 debug时使用不同的实现 debug模式使用不同的资源(比如当一个资源的值依赖于签名的时候) BuildType中的 代码/资源文件 将会被按照下列方式处理: manifest配置会被merge到app manifest中 代码不会被merge,会被当做另一个代码目录(source folder)来使用 资源文件会覆盖同名的main中的资源文件 作者: 我爱物联网 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4821156.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

【Cassandra生态】Cassandra强大的支持力量-商业&amp;大公司&amp;云&amp;生态周边

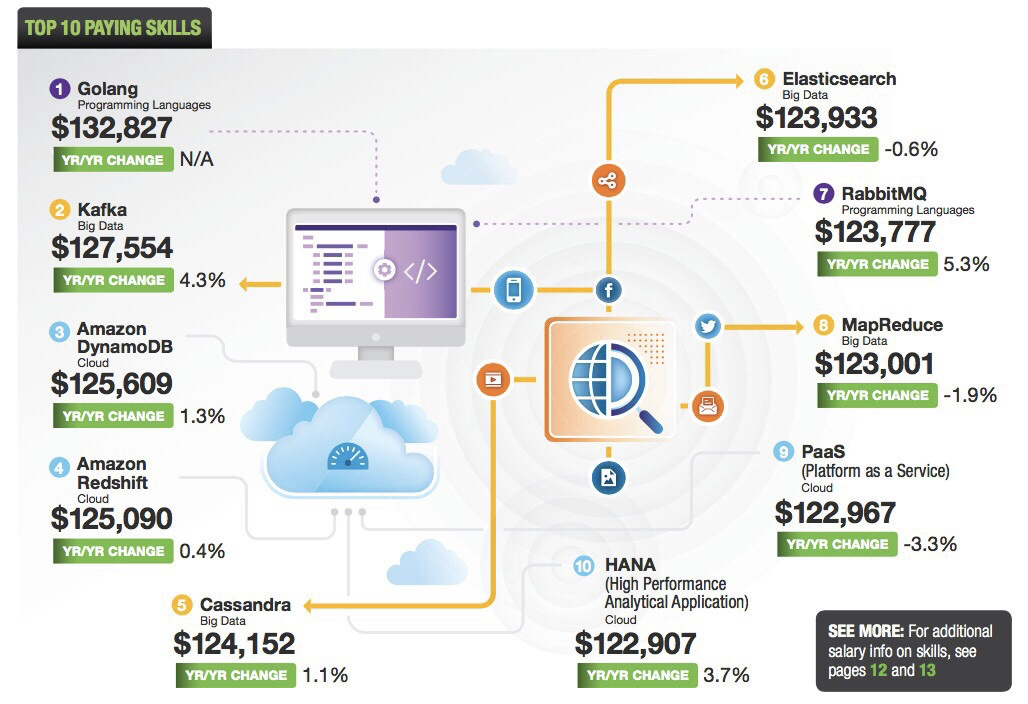
引言 在本次 ApacheCon2019年的会议上,Cassandra的议题多达 30场次:https://www.apachecon.com/acna19/s/#/schedule?search=Cassandra,与最火的Spark类似。其它一些项目只有个位数的分享。这么多的分享,背后必然有一个强大的生态社区,本文将梳理下Cassandra的商业公司、云公司、全球使用的大公司及相关生态的支持。另外有份资料表明,从事Cassandra职业的薪水非常可观,排名第五 商业公司 Datastax:https://www.datastax.com/,是一家位于加州的初创公司,提供了一个商业版本的Apache Cassandra数据库,公司目前已经接近1亿美元的融资。创始人也是Cassandra作者之一,是社区Cassandra较大贡献者。Da

优秀的个人博客,低调大师

Elasticsearch: 权威指南 &amp;#187; 深入搜索 &amp;#187; 多字段搜索 &amp;#187; 多数字段 good

跨字段实体搜索 » 多数字段编辑 全文搜索被称作是召回率(Recall)与精确率(Precision)的战场:召回率——返回所有的相关文档;精确率——不返回无关文档。目的是在结果的第一页中为用户呈现最为相关的文档。 为了提高召回率的效果,我们扩大搜索范围——不仅返回与用户搜索词精确匹配的文档,还会返回我们认为与查询相关的所有文档。如果一个用户搜索 “quick brown box” ,一个包含词语fast foxes的文档被认为是非常合理的返回结果。 如果包含词语fast foxes的文档是能找到的唯一相关文档,那么它会出现在结果列表的最上面,但是,如果有 100 个文档都出现了词语quick brown fox,那么这个包含词语fast foxes的文档当然会被认为是次相关的,它可能处于返回结果列表更下面的某个地方。当包含了很多潜在匹配之后,我们需要将最匹配的几个置于结果列表的顶部。 提高全文相关性精度的常用方式是为同一文本建立多种方式的索引,每种方式都提供了一个不同的相关度信号signal。主字段会以尽可能多的形式的去匹配尽可能多的文档。举个例子,我们可以进行以下操作: 使用词干提取来索引jumps、jumping和jumped样的词,将jump作为它们的词根形式。这样即使用户搜索jumped,也还是能找到包含jumping的匹配的文档。 将同义词包括其中,如jump、leap和hop。 移除变音或口音词:如ésta、está和esta都会以无变音形式esta来索引。 尽管如此,如果我们有两个文档,其中一个包含词jumped,另一个包含词jumping,用户很可能期望前者能排的更高,因为它正好与输入的搜索条件一致。 为了达到目的,我们可以将相同的文本索引到其他字段从而提供更为精确的匹配。一个字段可能是为词干未提取过的版本,另一个字段可能是变音过的原始词,第三个可能使用shingles提供词语相似性信息。这些附加的字段可以看成提高每个文档的相关度评分的信号signals,能匹配字段的越多越好。 一个文档如果与广度匹配的主字段相匹配,那么它会出现在结果列表中。如果文档同时又与signal信号字段匹配,那么它会获得额外加分,系统会提升它在结果列表中的位置。 我们会在本书稍后对同义词、词相似性、部分匹配以及其他潜在的信号进行讨论,但这里只使用词干已提取(stemmed)和未提取(unstemmed)的字段作为简单例子来说明这种技术。 多字段映射编辑 首先要做的事情就是对我们的字段索引两次:一次使用词干模式以及一次非词干模式。为了做到这点,采用multifields来实现,已经在multifields有所介绍: DELETE /my_index PUT /my_index { "settings": { "number_of_shards": 1 }, "mappings": { "my_type": { "properties": { "title": { "type": "string", "analyzer": "english", "fields": { "std": { "type": "string", "analyzer": "standard" } } } } } } } 拷贝为 CURL 在 SENSE 中查看 参考被破坏的相关度. title字段使用english英语分析器来提取词干。 title.std字段使用standard标准分析器,所以没有词干提取。 接着索引一些文档: PUT /my_index/my_type/1 { "title": "My rabbit jumps" } PUT /my_index/my_type/2 { "title": "Jumping jack rabbits" } 拷贝为 CURL 在 SENSE 中查看 这里用一个简单match查询title标题字段是否包含jumping rabbits(跳跃的兔子): GET /my_index/_search { "query": { "match": { "title": "jumping rabbits" } } } 拷贝为 CURL 在 SENSE 中查看 因为有了english分析器,这个查询是在查找以jump和rabbit这两个被提取词的文档。两个文档的title字段都同时包括这两个词,所以两个文档得到的评分也相同: { "hits": [ { "_id": "1", "_score": 0.42039964, "_source": { "title": "My rabbit jumps" } }, { "_id": "2", "_score": 0.42039964, "_source": { "title": "Jumping jack rabbits" } } ] } 如果只是查询title.std字段,那么只有文档 2 是匹配的。尽管如此,如果同时查询两个字段,然后使用bool查询将评分结果合并,那么两个文档都是匹配的(title字段的作用),而且文档 2 的相关度评分更高(title.std字段的作用): GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 我们希望将所有匹配字段的评分合并起来,所以使用most_fields类型。这让multi_match查询用bool查询将两个字段语句包在里面,而不是使用dis_max查询。 { "hits": [ { "_id": "2", "_score": 0.8226396, "_source": { "title": "Jumping jack rabbits" } }, { "_id": "1", "_score": 0.10741998, "_source": { "title": "My rabbit jumps" } } ] } 文档 2 现在的评分要比文档 1 高。 用广度匹配字段title包括尽可能多的文档——以提升召回率——同时又使用字段title.std作为信号将相关度更高的文档置于结果顶部。 每个字段对于最终评分的贡献可以通过自定义值boost来控制。比如,使title字段更为重要,这样同时也降低了其他信号字段的作用: GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title^10", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 title字段的boost的值为10使它比title.std更重要。 https://www.elastic.co/guide/cn/elasticsearch/guide/current/most-fields.html

优秀的个人博客,低调大师

Docker运行操作系统环境(BusyBox&amp;Alpine&amp;Debian/Ubuntu&amp;CentOS/Fedora)

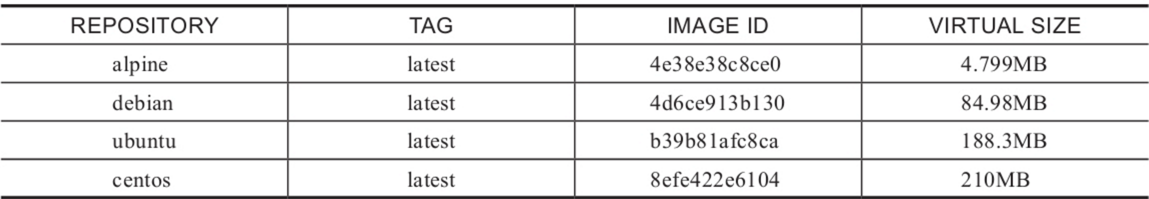
目前常用的Linux发行版主要包括Debian/Ubuntu系列和CentOS/Fedora系列。前者以自带软件包版本较新而出名;后者则宣称运行更稳定一些。选择哪个操作系统取决于读者的具体需求。同时,社区还推出了完全基于Docker的Linux发行版CoreOS。 使用Docker,只需要一个命令就能快速获取一个Linux发行版镜像,这是以往包括各种虚拟化技术都难以实现的。这些镜像一般都很精简,但是可以支持完整Linux系统的大部分功能。 BusyBox BusyBox是一个集成了一百多个最常用Linux命令和工具(如cat、echo、grep、mount、telnet等)的精简工具箱,它只有几MB的大小,很方便进行各种快速验证,被誉为“Linux系统的瑞士军刀”。BusyBox可运行于多款POSIX环境的操作系统中,如Linux(包括Android)、Hurd、FreeBSD等。 在Docker Hub中搜索busybox相关的镜像: $ docker search busybox NAME DESCRIPTION STARS OFFICIAL AUTOMATED busybox Busybox base image. 755 [OK] ... 读者可以看到最受欢迎的镜像。带有OFFICIAL标记说明是官方镜像。 $ docker pull busybox:latest 下载后,可以看到busybox镜像只有2.433MB: 启动一个busybox容器,并在容器内查看挂载信息,如下所示: busybox镜像虽然小巧,但包括了大量常见的Linux命令,可以用它快速熟悉Linux命令。 Alpine Alpine操作系统是一个面向安全的轻型Linux发行版。它不同于通常的Linux发行版,Alpine采用了musl libc和BusyBox以减小系统的体积和运行时资源消耗,但功能上比BusyBox又完善得多。在保持瘦身的同时,Alpine还提供了自己的包管理工具apk,可以通过https://pkgs.alpinelinux.org/packages查询包信息,也可以通过apk命令直接查询和安装各种软件。 Alpine Docker镜像也继承了Alpine Linux发行版的这些优势。相比于其他Docker镜像,它的容量非常小,仅仅只有5MB左右(Ubuntu系列镜像接近200MB),且拥有非常友好的包管理机制。官方镜像来自docker-alpine项目。 目前Docker官方已开始推荐使用Alpine替代之前的Ubuntu作为基础镜像环境。这样会带来多个好处,包括镜像下载速度加快,镜像安全性提高,主机之间的切换更方便,占用更少磁盘空间等。 1.使用官方镜像 由于镜像很小,下载时间往往很短,可以使用docker run指令直接运行一个alpine容器,并指定运行的Linux指令,例如: $ docker run alpine echo '123' 使用time工具测试在本地没有提前pull镜像的情况下,执行echo命令的时间,仅需要3秒左右。 $ time docker run alpineecho'123' Unable to find image 'alpine:latest' locally latest: Pulling from library/alpine e110a4a17941: Pull completeDigest: sha256:3dcdb92d7432d56604d4545cbd324b14e647b 313626d99b889d0626de158f73aStatus: Downloaded newer image for alpine:latest123 real 0m3.367s user 0m0.040s sys 0m0.007s 2.迁移至Alpine基础镜像 目前,大部分Docker官方镜像都已经支持Alpine作为基础镜像,因此可以很容易地进行迁移。 例如: ubuntu/debian -> alpine python:2.7 -> python:2.7-alpine ruby:2.3 -> ruby:2.3-alpine 另外,如果使用Alpine镜像替换Ubuntu基础镜像,安装软件包时需要用apk包管理器替换apt工具,如 $ apk add --no-cache Alpine中软件安装包的名字可能会与其他发行版有所不同,可以在https://pkgs.alpinelinux.org/packages网站搜索并确定安装包的名称。如果需要的安装包不在主索引内,但是在测试或社区索引中,那么可以按照以下方法使用这些安装包: $echo"http://dl-4.alpinelinux.org/alpine/edge/testing">> /etc/apk/repositories $ apk --update add --no-cache Debian/Ubuntu Debian和Ubuntu都是目前较为流行的Debian系的服务器操作系统,十分适合研发场景。Docker Hub上提供了官方镜像,国内各大容器云服务也基本都提供了相应的支持。 1.Debian系统简介及使用 Debian是由GPL和其他自由软件许可协议授权的自由软件组成的操作系统,由Debian Project组织维护。Debian计划是一个独立、分散的组织,由3000个志愿者组成,接受世界多个非盈利组织的资金支持,Software in the Public Interest提供支持并持有商标作为保护机构。Debian以其坚守Unix和自由软件的精神,以及给予用户的众多选择而闻名。现在Debian包括了超过25000个软件包并支持12个计算机系统结构。 作为一个大的系统组织框架,Debian下面有多种不同操作系统核心的分支计划,主要为采用Linux核心的Debian GNU/Linux系统,其他还有采用GNU Hurd核心的Debian GNU/Hurd系统、采用FreeBSD核心的Debian GNU/kFreeBSD系统,以及采用NetBSD核心的Debian GNU/NetBSD系统,甚至还有利用Debian的系统架构和工具,采用OpenSolaris核心构建而成的Nexenta OS系统。在这些Debian系统中,以采用Linux核心的Debian GNU/Linux最为著名。 众多的Linux发行版,例如Ubuntu、Knoppix和Linspire及Xandros等,都基于Debian GNU/Linux。 可以使用docker search搜索Docker Hub,查找Debian镜像,结果如下所示: $ docker search debian NAME DESCRIPTION STARS OFFICIAL AUTOMATED debian Debian is... 1565 [OK] ... 官方提供了大家熟知的debian镜像以及面向科研领域的neurodebian镜像。 可以使用docker run直接运行debian镜像: $ docker run -it debian bash root@668e178d8d69:/# cat /etc/issue Debian GNU/Linux 8 debian镜像很适合作为基础镜像,用于构建自定义镜像。 2.Ubuntu系统简介及使用 Ubuntu是一个以桌面应用为主的GNU/Linux操作系统,其名称来自非洲南部祖鲁语或豪萨语的“ubuntu”一词。Ubuntu意思是“人性”以及“我的存在是因为大家的存在”,是非洲的一种传统价值观。Ubuntu基于Debian发行版和GNOME/Unity桌面环境,与Debian的不同在于它每6个月会发布一个新版本,每2年会推出一个长期支持(Long Term Support,LTS)版本,一般支持3年。 Ubuntu相关的镜像有很多,在Docker Hub上使用-s 10参数进行搜索,只搜索那些被收藏10次以上的镜像: $ docker search -s 10 ubuntu NAME DESCRIPTION STARS OFFICIAL AUTOMATED ubuntu Official Ubuntu base image 840 [OK] Dockerfile/ubuntu Trusted automated Ubuntu (http://www.ubunt... 30 [OK] crashsystems/gitlab-docker A trusted, regularly updated build of GitL... 20 [OK] 注意,Docker 1.12版本中已经不支持--stars参数了,可以使用-f stars=N参数。 下面以Ubuntu 14.04为例,演示如何使用该镜像安装一些常用软件。 首先使用-it参数启动容器,登录bash,查看ubuntu的发行版本号: $ docker run -it ubuntu:14.04 /bin/bash root@7d93de07bf76:/# lsb_release -a No LSB modules are available. Distributor ID: Ubuntu Description: Ubuntu 14.04.1 LTS Release: 14.04 Codename: trusty 当试图直接使用apt-get安装一个软件的时候,会提示E:Unable to locate package: root@7d93de07bf76:/# apt-get install curl Reading package lists... Done Building dependency tree Reading state information... Done E: Unable to locate package curl 这并非系统不支持apt-get命令。Docker镜像在制作时为了精简清除了apt仓库信息,因此需要先执行apt-get update命令来更新仓库信息。更新信息后即可成功通过apt-get命令来安装软件: root@7d93de07bf76:/# apt-get update 安装curl工具: root@7d93de07bf76:/# apt-get install curl -y Reading package lists... Done Building dependency tree Reading state information... Done ... root@7d93de07bf76:/# curl curl:try'curl --help'or'curl --manual'formore information 接下来,再安装apache服务: root@7d93de07bf76:/# apt-get install -y apache2 启动这个apache服务,然后使用curl来测试本地访问: root@7d93de07bf76:/# service apache2 start 配合使用-p参数对外映射服务端口,可以允许外来容器访问该服务。 CentOS/Fedora 1.CentOS系统简介及使用 CentOS和Fedora都是基于Redhat的常见Linux分支。CentOS是目前企业级服务器的常用操作系统;Fedora则主要面向个人桌面用户。 CentOS(Community Enterprise Operating System,社区企业操作系统)是基于Red Hat Enterprise Linux源代码编译而成的。由于CentOS与Redhat Linux源于相同的代码基础,所以很多成本敏感且需要高稳定性的公司就使用CentOS来替代商业版Red Hat Enterprise Linux。CentOS自身不包含闭源软件。 在Docker Hub上使用docker search命令来搜索标星至少为25的CentOS相关镜像,如下所示: $ docker search -f stars=25 centos NAME DESCRIPTION STARS OFFICIAL AUTOMATED centos The official... 2543 [OK] jdeathe/centos-ssh 27 [OK] 使用docker run直接运行最新的CentOS镜像,并登录bash: $ docker run -it centos bash [root@43eb3b194d48 /]# cat /etc/redhat-release CentOS Linux release 7.2.1511 (Core) 2.Fedora系统简介及使用 Fedora是由Fedora Project社区开发,红帽公司赞助的Linux发行版。它的目标是创建一套新颖、多功能并且自由和开源的操作系统。对用户而言,Fedora是一套功能完备的、可以更新的免费操作系统,而对赞助商Red Hat而言,它是许多新技术的测试平台,被认为可用的技术最终会加入到Red Hat Enterprise Linux中。 在Docker Hub上使用docker search命令来搜索标星至少为2的Fedora相关镜像,结果如下: $ docker search -f stars=2 fedora NAME DESCRIPTION STARS OFFICIALAUTOMATED fedora Official Docker builds of Fedora 433 [OK] 使用docker run命令直接运行Fedora官方镜像,并登录bash: $ docker run -it fedora bash [root@196ca341419b /]# cat /etc/redhat-release Fedora release 24 (Twenty Four) 总结意见 在Docker Hub上还有许多第三方组织或个人上传的Docker镜像。可以根据具体情况来选择。一般来说注意如下几点: 官方镜像体积都比较小,只带有一些基本的组件。精简的系统有利于安全、稳定和高效运行,也适合进行定制。 个别第三方镜像(如tutum,已被Docker收购)质量也非常高。这些镜像通常针对某个具体应用进行配置,比如,包含LAMP组件的Ubuntu镜像。 出于安全考虑,几乎所有官方制作的镜像都没有安装SSH服务,无法使用用户名和密码直接登录。

优秀的个人博客,低调大师

Spring MVC &amp; Boot &amp; Cloud 技术教程汇总(长期更新)

昨天我们发布了Java成神之路上的知识汇总,今天继续。 Java成神之路技术整理(长期更新) 以下是Java技术栈微信公众号发布的关于 Spring/ Spring MVC/ Spring Boot/ Spring Cloud 的技术干货,本文长期更新。 Spring 系列 Java 必看的 Spring 知识汇总 Spring 5.0 正式发布了 Spring的核心模块解析 Spring的生态 获取 ApplicationContext 的几种方式 一张图搞懂 Spring bean 的完整生命周期 Spring bean初始化及销毁回调方法及顺序 Spring bean - scope 详解 @Resource,@Autowired,@Inject 3种注入详解 Spring AOP注解使用注意点 Spring import配置文件使用占位符 Spring开启方法异步执行 Spring快速开启计划任务 Spring Aware容器感知技术 Spring Enable*高级应用及原理 Spring零配置之@Configuration详解 Spring MVC 系列 @Controller,@Service,@Repository,@Component详解 Spring MVC表单防重复提交 Spring MVC常用注解 Spring MVC表单验证器使用详解 Spring Boot 系列 Spring Boot 2.0 正式发布 什么是Spring Boot? Spring Boot开启的2种方式 Spring Boot Starters启动器 Spring Boot核心配置 Spring Boot功能实战 Spring Boot定制启动图案 Spring Boot自动配置原理、实战 Spring Boot Runner启动器 Spring Boot - Profile不同环境配置 Spring Boot读取配置的几种方式 Spring Boot Server容器配置 Spring Boot日志集成 Spring Boot整合Thymeleaf模板引擎 Spring Boot国际化支持 Spring Boot Debug调试 Spring Boot实现热部署 Spring Boot发布jar包转为war包 Spring Cloud 系列 7张图了解 Spring Cloud 的整体构架 Spring Cloud是什么,和Dubbo对比 Spring Cloud注册中心高可用搭建 Spring Cloud Eureka自我保护机制 Spring Cloud服务安全连接 Spring Cloud配置中心高可用搭建 Spring Cloud配置中心客户端读取配置 Spring Cloud动态刷新配置信息 Spring Cloud配置中心内容加密 希望我们提供的知识能对所有正在 Java 开发不归路上的码农朋友指点迷津,有不对之处还请指正。 本文章会不断更新,请关注我们的微信公众号。 image

优秀的个人博客,低调大师

Android中&amp;lt;meta-data&amp;gt;的使用

在AndroidManifest.xml中。<meta-data>元素能够作为子元素,被包括在<activity>、<application> 、<service>和<receiver>元素中,但 不同的父元素。在应用时读取的方法也不同。 1 :在Activity的应用。 xml代码段: <activity...> <meta-data android:name="myMsg" android:value="hello my activity"></meta-data> </activity> java代码段: ActivityInfo info=this.getPackageManager() .getActivityInfo(getComponentName(), PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 2:在application的应用。 xml代码段: <application...> <meta-data android:value="hello my application" android:name="myMsg"></meta-data> </application> java代码段: ApplicationInfo appInfo = this.getPackageManager() .getApplicationInfo(getPackageName(), PackageManager.GET_META_DATA); String msg=appInfo.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 3:在service的应用。 xml代码段: <service android:name="MetaDataService"> <meta-data android:value="hello my service" android:name="myMsg"></meta-data> </service> java代码段: ComponentName cn=new ComponentName(this, MetaDataService.class); ServiceInfo info=this.getPackageManager() .getServiceInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 4: 在receiver的应用。 xml代码段: <receiver android:name="MetaDataReceiver"> <meta-data android:value="hello my receiver" android:name="myMsg"></meta-data> <intent-filter> <action android:name="android.intent.action.PHONE_STATE"></action> </intent-filter> </receiver> java代码段: ComponentName cn=new ComponentName(context, MetaDataReceiver.class); ActivityInfo info=context.getPackageManager() .getReceiverInfo(cn, PackageManager.GET_META_DATA); String msg=info.metaData.getString("myMsg"); System.out.println("myMsg:"+msg); 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5113540.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(六)--复制集+sharding分片 &amp;&amp; 总结

复制集+sharding分片 背景 主机 IP 服务及端口 Server A 192.168.50.1 shard1_1:27017 shard2_1:27018 config:20000 mongos:30000 Server B 192.168.51.1 shard1_2:27017 shard2_2:27018 config:20000 mongos:30000 创建数据目录及配置复制集 在Server A上启动shard1所用到的服务节点1 ./mongod --shardsvr --replSet shard1 --port 27017 --dbpath /data/shard1_1 --logpath /data/shard1_1/shaed1_1.log --logappend --fork 在Server B上启动shard1所用到的服务节点2 ./mongod --shardsvr --replSet shard1 --port 27017 --dbpath /data/shard1_2 --logpath /data/shard1_2/shaed1_2.log --logappend --fork 初始化 ./mongo --port 27017 >config={_id:"shard1",members:[ ...{_id:0,host:"192.168.1.50:27017"}, ...{_id:1,host:"192.168.1.51:27017"}] ...} … >re.initiate(config) 在Server A上启动shard2所用到的服务节点1 ./mongod --shardsvr --replSet shard2 --port 27018 --dbpath /data/shard2_1 --logpath /data/shard2_1/shaed2_1.log --logappend --fork 在Server B上启动shard2所用到的服务节点2 ./mongod --shardsvr --replSet shard2 --port 27018 --dbpath /data/shard2_2 --logpath /data/shard2_2/shaed2_2.log --logappend --fork 初始化 ./mongo --port 27018 >config={_id:"shard2",members:[ ...{_id:0,host:"192.168.1.50:27018"}, ...{_id:1,host:"192.168.1.51:27018"}] ...} ... >re.initiate(config) 配置Config Server 在Server A上启动Config Server服务 ./mongod --configsvr --port 20000 --dbpath /data/config --logpath /data/config/config.log --logappend --fork 在Server B上启动Config Server服务 ./mongod --configsvr --port 20000 --dbpath /data/config --logpath /data/config/config.log --logappend --fork 配置mongos 在Server A上启动mongos服务 ./mongos --configdb 192.168.50.1:20000,192.168.51.1:20000 --port 30000 --chunkSize 1 --logpath /data/mongos.log --logappend --fork 在Server B上启动mongos服务 ./mongos --configdb 192.168.50.1:20000,192.168.51.1:20000 --port 30000 --chunkSize 1 --logpath /data/mongos.log --logappend --fork 配置Shard Cluster ./mongo --port 30000 >use admin > db.runCommand({addshard:"shard1/192.168.50.1:27017,192.168.51.1:27017" }) > db.runCommand({addshard:"shard2/192.168.1.50:27018,192.168.51.1:27018"}) 验证Sharding正常工作 ./mongo --port 30000 >for(var i=1;i<=100000;i++) db.user.inser({_id:i,school:"CDUT",name:"yyd"}) > db.user.stats() 查片 >db.shards.find() 查数据库 >db.databases.find() 查块 >db.chunks.find() 获得集合概要 >db.printShardingStatus() 总结 其实上学期就接触了一些NoSQL的一些知识,只是在这个寒假才开始学习。但是也是碰巧,上学期一直没有在图书馆借到仅有的两门MongoDB的书,但是考完试的第二天书就被还到图书馆了,所以果断借了。 后面我还写PHP操作MongoDB。 联想到其他数据库,mysql,对于关系数据表而言,mongodb是提供了一个更快速的视图view;而对于PHP程序而言,mongodb可以作为一个持久化的数组来使用,并且这个持久化的数组还可以支持排序、条件、限制等功能。将mongodb代替mysql的部分功能,主要一个思考点就是:把mongodb当作mysql的一个view(视图),view是将表数据整合成业务数据的关键。比如说对原始数据进行报表,那么就要先把原始数据统计后生成view,在对view进行查询和报表。从这个意义上,mongodb提供了一个更快速,更使用的view。 本文转自我爱物联网博客园博客,原文链接http://www.cnblogs.com/yydcdut/p/3566489.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(二)--Capped集合 &amp;&amp; GridFS存储文件

Capped集合 Capped集合的大小是固定的,如果空间都被用完了,新添加的对象会取代最旧的那个数据。 创建 使用了db.createCollection()方法创建了一个名字为mycapped,空间大小为100000的Capped Colletcion。 限制 如果需要限定Collection中对象的数量,就要设置max参数,如果到了限制的数量,就要移除一个最近的插入。 使用validate()查询mycapped2集合的使用的存储空间。 默认情况下,非Capped集合会在_id上创建索引,而Capped集合不会在_id上创建索引,如果需要在_id上创建索引就需要用到autoIndexID参数。 GridFS存储文件 GridFS存储文件时会分两个集合来存储: files 包含元数据对象。 chunks 包含其他一些相关信息的二进制块。 使用mongofiles put F:\MongoDB\mongodb\bin\bad.txt命令将bad.txt文件保存到了数据库中。 查看数据库中有哪些GridFS文件: 重命名本地的bad.txt文件为bad1.txt,将数据库中文件导出: GridFS的块由单独的集合来存储,默认情况下,使用fs.chunks集合来存储块。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3557578.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker安装初试&amp;&amp;制作centos6.5基础镜像

https://blog.tankywoo.com/docker/2014/05/08/docker-4-summary.html https://yeasy.gitbooks.io/docker_practice/content/basic_concept/container.html centos7.x系列的yum源中自带了docker的rpm包,安装比较简单 # yum install docker -y 安装过程中可能会遇到lvm2包依赖冲突,如不使用,卸载即可 # yum remove lvm2 启动服务 # service docker start 查看版本 # docker -v Docker version 1.10.3, build d381c64-unsupported 获取BusyBox镜像 # docker pull busybox 创建容器并echo一句话 # docker run busybox /bin/echo Starting docker trip? Starting docker trip? centos6.x系列需要安装epel源,并且升级内核到3.10版本否则docker不能正常运行 基于git克隆安装https://github.com/llitfkitfk/docker-tutorial-cn # git clone git://github.com/llitfkitfk/docker-tutorial-cn.git # cd docker-tutorial-cn/ # ./docker_install.sh ##执行此步骤如果报下文错误需要修改/etc/yum.repos.d/epel.repo文件,取消baseurl的注释,注释掉mirrorlist Error: Cannot retrieve metalink for repository: epel. Please verify its path and try again # ./docker_config.sh ##可根据实际情况修改docker image的储存路径,此处配置到/mnt/docker,默认路径是/var/lib/docker # mkdir /mnt/docker # ./start_docker.sh ##开启docker服务 docker: relocation error: docker: symbol dm_task_get_info_with_deferred_remove, version Base not defined in file libdevmapper.so.1.02 with link time reference # yum upgrade device-mapper-libs ##启动报错,需要安装依赖 # docker info ##检查Docker是否正确安装 Containers: 0 Images: 0 Storage Driver: devicemapper Pool Name: docker-253:0-1182180-pool Pool Blocksize: 65.54 kB Backing Filesystem: extfs Data file: /dev/loop0 Metadata file: /dev/loop1 Data Space Used: 305.7 MB Data Space Total: 107.4 GB Data Space Available: 28.35 GB Metadata Space Used: 733.2 kB Metadata Space Total: 2.147 GB Metadata Space Available: 2.147 GB Udev Sync Supported: true Deferred Removal Enabled: false Data loop file: /var/lib/docker/devicemapper/devicemapper/data Metadata loop file: /var/lib/docker/devicemapper/devicemapper/metadata Library Version: 1.02.117-RHEL6 (2016-04-01) Execution Driver: native-0.2 Logging Driver: json-file Kernel Version: 2.6.32-358.6.2.el6.x86_64 Operating System: <unknown> CPUs: 12 Total Memory: 3.662 GiB Name: localhost ID: SAJR:3GXN:LA3H:XV3F:4WUS:PJNS:N7YI:IXS2:LCO2:J6WL:AMCV:AEBW 在docker index中搜索centos相关的image # docker search centos 从docker registry server拉取centos镜像 # docker pull centos 创建一个运行bash应用的容器,一直报错,使用-d命令查看进行运行信息,发现内核版本过低 # docker run -i -t centos /bin/bash Error response from daemon: Cannot start container 317bcef4837ad90112a9021012f243bdf92e594h file or directory # docker -d WARN[0000] You are running linux kernel version 2.6.32-358.6.2.el6.x86_64, which might be pgrade your kernel to 3.10.0. 于是升级内核到3.10 http://my.oschina.net/denglz/blog/487332 安装kernel-lt(long-term) # yum install http://www.elrepo.org/elrepo-release-6-5.el6.elrepo.noarch.rpm # yum --enablerepo=elrepo-kernel install kernel-lt -y 新安装的内核已经自动写入了grub.conf文件,只需修改Grub引导顺序,重启即可 # sed -i 's/default=1/default=0/' /etc/grub.conf 内核已经更新 # uname -a Linux localhost.localdomain 3.10.102-1.el6.elrepo.x86_64 #1 SMP Tue Jun 14 11:40:50 EDT 20 列出images # docker images REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE centos latest d83a55af4e75 2 weeks ago 196.7 MB 使用centos这个镜像创建container进入交互模式,login shell是/bin/bash Docker制作centos6.5基础镜像 http://blog.chinaunix.net/uid-20788636-id-4909654.html # yum install febootstrap # mkdir /dockerimg/centos6.5 创建镜像文件保存目录 # febootstrap -i bash -i wget -i yum -i iputils -i iproute -i man -i vim -i openssh-server -i openssh-clients -i tar -i p7zip -i net-tools centos6.5 /dockerimg/centos6.5 http://vault.centos.org/6.5/os/x86_64/ -i指定安装的包 centos6.5标识OS版本 # cp /etc/skel/.bash* /dockerimg/centos6.5/root/ # cd /dockerimg/centos6.5 # tar -c .|docker import - centos6.5 导入镜像文件 63a8a89d802130fa35f0661402bf776069dcfd2cf83da553d4874c6a6c7ad056 # docker images 已经成功导入,使用docker run命令就可以基于centos6.5创建容器使用了 REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE centos6.5 latest 63a8a89d8021 About a minute ago 372 MB

优秀的个人博客,低调大师

Spark的这些事&amp;lt;二&amp;gt;——几个概念

1、SparkContext [经常简称为 sc] spark app 的起点和入口,一般用来加载数据集,生成第一个 rdd。 2、定义一个 spark 应用程序所需要的三大步骤的逻辑:加载数据集,处理数据,结果展示。 加载数据集 加载数据集,这里的数据集大概分为两组: - 一种是不变的,静态数据集,大多数场景都是从数据库,文件系统上面加载进来 - 另一种是动态的数据集,一般做 streaming 应用的时候用到,大多数场景是通过 socket 来加载数据,复杂场景可以通过文件系统,akka actors,kafka,kinesis 和 一些第三方提供的 streaming api [twitter 等] 来作为数据源加载数据 处理数据 处理数据,这是重点中的重点,不过不外乎都是从三个方面来完成这里的数据清理,逻辑运算等: - 自定义的一些复杂处理函数或者第三方包 [下面我们称为函数集] - 通过 RDD 的 transform,action 和函数集来完成整个处理,计算流程 - 通过 RDD 提供的 cache,persist,checkpoint 方法把一些处理流程中的重要处理节点和常用数据缓存和备份,以加速处理,计算速度 结果展示 结果展示,这里一般情况都是使用 RDD 的 collect,take,first,top 等方法把结果取出来,更常用的是先把结果取出来,放到一个数据库或文件系统上,然后再提供给专门展示结果的另一个 application 使用。 3、有向无环图(DGA): 有向无环图,有向即有方向,无环即不可逆,其实更详细的说是一个时间上的先来后到,即祖先与子孙的关系,是不可逆的。 有向无环图(百度百科) 4、RDD 关于RDD的一篇论文翻译 Spark的这些事系列文章: Spark的这些事<一>——Windows下spark开发环境搭建 Spark的这些事<二>——几个概念 Spark的这些事<三>——spark常用的Transformations 和Actions

优秀的个人博客,低调大师

对比来看java的Runnable&amp;Callable&amp;FutureTask

这篇文章其实主要是想要讲清楚一个概念,就是Runable和Callable的区别,以及当它们和FutureTask、ExecutorService一起执行的原理。 基本概念 java多线程实现方案 说明: 1、上图中java多线程的实现方案就没什么好说的了,基本上搞java的人都是理解的。 2、其实我始终觉得Thread是一个容器,所以和Runnable和Callable应该不在一个层次的概念,Thread应该是cpu真正调度的实体,这个实体会做什么呢,会执行Runnable和Callable的方法,所以特别不喜欢把这三者放在一起。 基本流程 FutureTask基本流程 说明: 1、左边是任务创建过程,右边是任务执行过程。 基本用法 常用方法 说明: 1、这个截图基本上就是Runnable和Callable和ExecutorService结合一起使用的用法。 2、关键是我比较感兴趣submit内部做了什么事情。 FutureTask创建之Callble对象 Callable的futureTask创建过程 说明: 1、在submit一个对象的时候,其实内部是给我们创建了一个FutureTask对象,整个创建过程是层层递进的。 2、FutureTask对象有两个重要属性,一个是callable对象也就是执行对象,一个state,标记这个任务是否完成。 FutureTask创建之Runable Runnable的FutureTask的创建过程 说明: 1、当我们针对Runnable对象创建futureTask的时候内部其实用Callable的适配器包装了一下,然后对外以Callable的对象运行。 2、可以看到call实际上调用的是task的run函数,这个run就不说了吧,线程里面的入口函数。 FutureTask内部属性 futureTask的核心内容 说明: 1、几个核心属性,callable就是刚刚所谓的执行对象,outcome最后执行返回的结果,其他整个线程的执行状态流转。 FutureTask任务提交 futureTask提交过程 说明: 1、这个futureTask的提交过程跟我们跟文章《我发现我不懂你了_JUC》其实是一样的,可以自行参考。 2、ExecutorService里面的worker其实真正调用的是run函数,所以我们还需要进一步搞清楚FutureTask是否包含run函数,当然毫无疑问肯定是有的,可以参考下面这个图。 FutureTask任务执行 futureTask内部实现run接口 说明: 1、接上面描述的文字,所以ExecutorService的worker其实真正执行的是Callable对象的call函数并设置回调结果。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册