【Java I/O】从一行 read() 追到底层:Java IO 到底做了什么
# 从一行 read() 追到底层:Java IO 到底做了什么 只要你在 Java 里读写过一次文件,就一定写过 `new FileInputStream(...)` 和 `read()`。 这一行调用看起来平平无奇,但它背后串起了整个 Java IO 的体系:抽象基类、装饰器、缓冲、字符编码、NIO、系统调用、页缓存、零拷贝。 本文的做法是:**不先讲体系,而是从一行最简单的调用出发,一层层跟进去**,每进一层就带出一个知识点。走完全程,Java IO 的地图也就画完了。 --- ## 起点:一行代码 ```java try (var in = new FileInputStream("a.txt")) { int b = in.read(); // 读一个字节,返回 0~255;读到末尾返回 -1 System.out.println(b); } ``` 这行代码表面上做的事:打开 `a.txt`,取出第一个字节,把它当作整数返回。 注意两个反直觉的细节:返回类型是 `int` 而不是 `byte`,读到末尾返回的是 `-1` 而不是抛异常。这两点后面都会解释——**它们不是随手设计的,而是被协议约束逼出来的**。 这句话背后真正发生的是一次完整的旅行: > Java 堆 → JVM native 方法 → 操作系统内核 → 页缓存(或磁盘)→ 再原路返回。 我们跟着走一遍。 --- ## 第一层:read() 的入口做了什么 **先给结论**:`FileInputStream` 自己没有任何缓冲区,一次 `read()` 就是一次向操作系统要 1 个字节的请求。 看看入口(以 OpenJDK 的 `java.io.FileInputStream` 为例,JDK 8 与 JDK 17 这一段结构基本一致): ```java public class FileInputStream extends InputStream { // 单字节读取:直接进 native public int read() throws IOException { return read0(); } private native int read0() throws IOException; // 批量读取:另走一个 native 方法,一次要一整个数组 public int read(byte b[]) throws IOException { return readBytes(b, 0, b.length); } private native int readBytes(byte b[], int off, int len) throws IOException; } ``` 这里有个容易忽略的要点:**`read()` 和 `read(byte[])` 是两条独立的下沉路径**,不是"批量读取内部循环调单字节读取"。这一点决定了后面的性能差距不是倍数级,而是量级级。 **类比先行**:把文件想象成一座水库,`FileInputStream` 是一根直接插在水库上的细水管,`read()` 就是"拧一下阀门接一滴水",`read(byte[])` 则是"接满一整桶"。 **这个类比不准的地方**:现实中的水管是被动出水,而 Java 的流是"拉"模型——你不调 `read()`,数据永远不会自己送过来;更重要的是,水不会因为管路长而变贵,但**每一次 `read()` 都要付一次固定的"过路费"**,而这笔过路费和你要搬多少水几乎无关。 所谓过路费,就是我们下一层要看的东西。 --- ## 第二层:进入 native,看见"过路费" **先给结论**:`read0()` 的开销大头不是"搬那 1 个字节",而是"从 Java 世界切进内核再切回来"。 一次 `read0()` 大致经过这几步: 1. JVM 通过 native 方法进入 C 代码(OpenJDK 里对应 `FileInputStream.c` 的读取函数); 2. 调用 POSIX 接口 `read(fd, buf, 1)`,`fd` 是文件描述符(内核用来标识"这个打开的文件"的一个整数); 3. 内核先在**页缓存**(page cache,操作系统把文件内容缓存在内存里的那块区域)中查找数据; 4. 命中则直接内存拷贝返回;未命中才真正发起磁盘 IO,并把数据留在页缓存里; 5. 结果拷回用户态缓冲区,返回给 JVM。 由此得到一个重要结论:**读文件并不等于读磁盘**。同一个文件第二次读,往往全程在内存里完成。这也是为什么"IO 性能"更多取决于缓存命中率和访问模式,而不是单纯看磁盘型号。 下面这段代码可以直观感受"过路费"的量级差别。它读同一个文件两遍,一遍每次取 1 字节,一遍每次取 8192 字节: ```java import java.io.FileInputStream; import java.nio.file.Files; import java.nio.file.Path; public class ReadCost { public static void main(String[] args) throws Exception { Path p = Path.of("big.bin"); Files.write(p, new byte[4 = count) { // 缓冲区空了 fill(); // 一次性装满 if (pos >= count) return -1; // 装了还是空 → 真的读到文件末尾 } return getBufIfOpen()[pos++] & 0xff; // 从数组里取,不碰内核 } } ``` `fill()` 内部做的就是调用被它包住的那个流的 `read(buf, 0, buf.length)`——也就是第二层里那个批量 native 方法。 **类比先行**:在水管上串接一个水箱。拧水龙头(`read()`)时先从水箱取水,水箱空了才去水库接一整箱。**取水动作的次数没变,但"跑一趟水库"的次数从 N 次降到约 N/8192 次**。 **这个类比不准的地方**:水箱不会改变总水量,也不改变数据顺序,它只是把"高价动作"批量化了;而且 `BufferedInputStream.read()` 是 `synchronized` 的,多线程共享同一个实例会被串行化——缓冲不等于并发安全。 > **它和 FileInputStream 的关系是"装饰器与底座"**:`BufferedInputStream` 自己不做任何 IO,它只负责包装另一个 `InputStream`。正因为如此,它对 `FileInputStream`、`Socket.getInputStream()`、`ByteArrayInputStream` 一视同仁——这就是装饰器模式的价值。 --- ## 第三层之二:字符流是第二层包装 **先给结论**:字节是"01 序列",字符是"人能读懂的字"。从字节到字符中间必须有一次**解码**,依据是字符集(例如 UTF-8)。`InputStreamReader` 就是这个翻译器。 ```java import java.io.*; import java.nio.charset.StandardCharsets; public class TextRead { public static void main(String[] args) throws IOException { try (var br = new BufferedReader(new InputStreamReader( new FileInputStream("a.txt"), StandardCharsets.UTF_8))) { // 显式指定编码 String line; while ((line = br.readLine()) != null) { System.out.println(line); } } } } ``` 这段代码里有三层包装,各自职责清晰: | 层 | 类 | 负责什么 | |---|---|---| | 底座 | `FileInputStream` | 按字节向内核要数据 | | 桥接 | `InputStreamReader` | 按编码把字节解码成字符 | | 外壳 | `BufferedReader` | 字符缓冲 + 按行切分(`readLine`) | **常见的坑**:`new FileReader(file)` 使用的是**平台默认编码**。在 JDK 18 之前,Windows 中文环境的默认编码常常是 GBK,于是同一份 UTF-8 文本在开发机正常、在服务器上乱码。JDK 18 起默认编码统一为 UTF-8(JEP 400),但**显式指定编码永远是更稳的做法**。 > **它和 InputStreamReader 的关系是"桥与专用实现"**:`FileReader` 本质是 `new InputStreamReader(new FileInputStream(file))` 的语法糖,只不过它替你做了"选编码"这个决定——而这个决定恰恰是乱码的根源。 --- ## 第三层之三:NIO 换了一条路 **先给结论**:NIO 把"流"拆成了两个角色——**通道(Channel)+ 缓冲区(Buffer)**。Channel 是双向管道(可读可写),Buffer 是一个带三个指针的定容容器。 ```java import java.nio.ByteBuffer; import java.nio.channels.FileChannel; import java.nio.file.Path; import java.nio.file.StandardOpenOption; public class NioRead { public static void main(String[] args) throws Exception { try (FileChannel ch = FileChannel.open(Path.of("a.txt"), StandardOpenOption.READ)) { ByteBuffer buf = ByteBuffer.allocate(8192); while (ch.read(buf) != -1) { // 一次读一块 buf.flip(); // 写模式 → 读模式 while (buf.hasRemaining()) { byte b = buf.get(); } buf.clear(); // 复位,复用同一块内存 } } } } ``` Buffer 的三个指针是 NIO 最反直觉的部分:`capacity`(容量)、`position`(当前位置)、`limit`(读写边界)。**写入和读取用的是同一块内存**,所以必须 `flip()` 切换模式,否则读不到任何数据——这是新手最常踩的 NIO 坑。 **类比先行**:Buffer 是一只有刻度的水桶。`position` 是当前水位线,`flip()` 相当于把桶倒过来——倒之前先记住"水装到了哪",倒完之后 `clear()` 把水位归零重新接。 **这个类比不准的地方**:真实水桶倒过来水就流走了,而 `ByteBuffer` 的数据在 `clear()` 后依然留在内存里,只是指针被重置,下次写入会覆盖它。 > **它和 InputStream 的关系是"换赛道"**:`InputStream` 是"拉"模型、单向、数据必须经过用户态数组;`Channel` 支持双向读写,还能直接对接操作系统提供的零拷贝能力。两者不是新旧替代关系,而是针对不同场景的两套接口。 --- ## 设计者的取舍 走到这里,几个"为什么这么设计"的问题可以回答了。 **1. 为什么用装饰器一层层套,而不是搞一个大而全的类?** 因为"搬字节 / 加缓冲 / 解码 / 按行切分"是四件正交的事。用继承表达就是 N 个类的组合爆炸,用装饰器只需要 4 个类任意叠加。**代价是调用栈变深**:一次 `BufferedReader.readLine()` 背后有 4~5 层调用,新手打断点时会觉得"代码像在原地打转"。 **2. 为什么默认缓冲是 8192 字节?** 它是"单次系统调用的固定成本"与"内存占用"之间的折中。512 字节太小,系统调用次数仍然偏多;1MB 太大,小文件一读就浪费,而且会多一次内存拷贝。 **3. 为什么 NIO 不直接复用 InputStream 接口?** 因为要支持非阻塞与多路复用(`Selector`),而阻塞式流的语义是"读不到就卡住",这和非阻塞模型根本冲突。硬塞进 `InputStream` 会让接口对两边都不好用——这是典型的"新增优于改造"。 **4. 为什么 `FileChannel.transferTo` 更快?** 它走的是操作系统的 `sendfile` 系统调用:数据从页缓存直接进入 socket 缓冲区,**不经过用户态**。"零拷贝"零掉的就是用户态这一趟搬运和对应的上下文切换。 --- ## 一路上的关键角色 到这里,把沿途遇到的知识点整理成一张图。**每个节点都附一句"它和 Java IO 的关系"**,这是本文的核心价值所在。 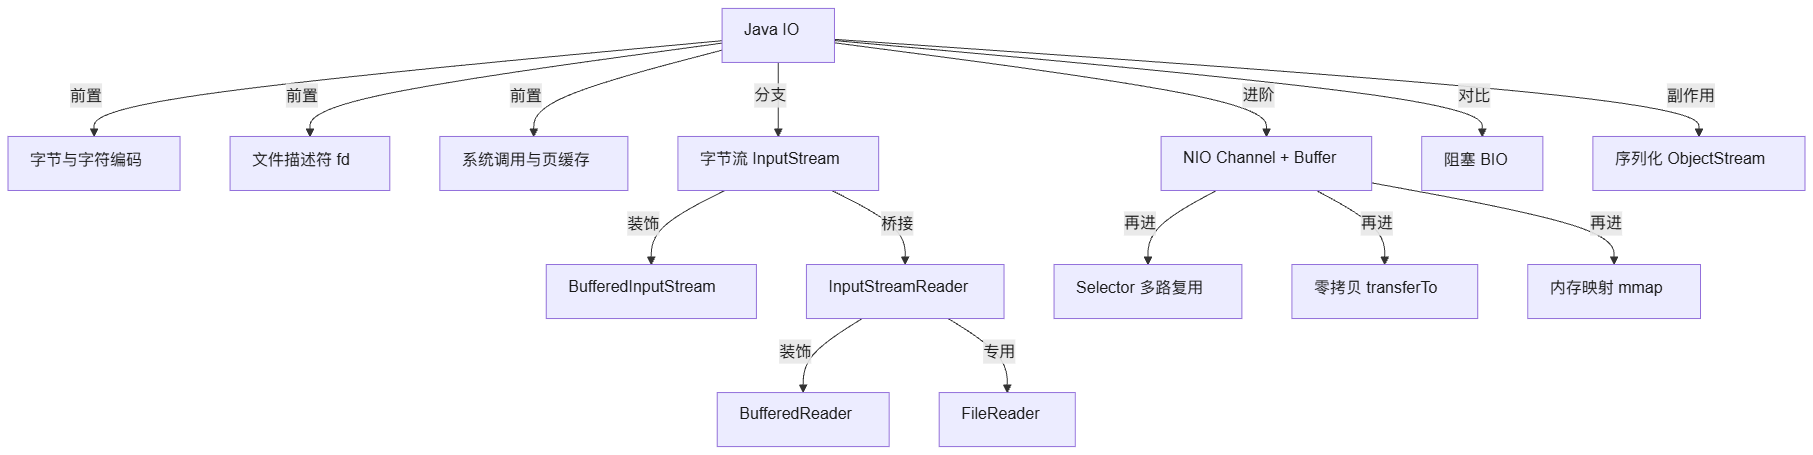 - **前置 · 字节与字符编码**:**它是理解字符流的地基**——不知道"一个汉字在 UTF-8 里占 3 个字节",你就无法理解为什么会读出半个字符,也无法理解 `InputStreamReader` 为什么必须存在。 - **前置 · 文件描述符**:**它是"必须关流"这条规矩的技术原因**——`FileInputStream` 内部攥着一个 fd,不关闭就是 fd 泄漏,最终报 `Too many open files`。 - **前置 · 系统调用与页缓存**:**它解释了 IO 性能的真实分布**——真正的开销在"切换"和"缓存命中率"上,而不在搬运本身。 - **同级 · 字节流 vs 字符流**:**它们是同一道题的两种解法**——处理图片、压缩包等二进制数据用字节流,处理文本用字符流;混用的代价就是乱码。 - **组合 · BufferedXxx 系列**:**它和底座流是黄金搭档**——底座负责"跨进内核",缓冲负责"少跨几次"。 - **因果 · NIO / Channel**:**BIO 的软肋正是 NIO 诞生的原因**——BIO 一个连接占一个线程,1 万连接就意味着 1 万线程(每线程默认约 1MB 栈空间),于是有了 Channel + Selector 这套新模型。 - **进阶 · Selector**:**NIO 用深了必然碰到它**——单线程管理成千上万连接的入口就是它(Linux 上底层是 epoll)。 - **进阶 · 零拷贝**:**它在文件传输场景绕不开**——Kafka、Nginx、Netty 的性能优势都建立在这个机制上。 - **进阶 · 内存映射 mmap**:**它把文件变成了数组**——`MappedByteBuffer` 是它的入口,适合超大文件的随机读取。 - **对比 · AIO(异步 IO)**:**它和 NIO 是同一道题的另一条解法**,但 Linux 上实现长期不成熟,实践中使用较少,不要为了"新"而选。 - **应用 · 序列化 / 对象流**:**它也是流,只是编码对象而非字符**——`ObjectOutputStream` 把对象图转成字节,坑(`serialVersionUID` 不一致、反序列化不安全)比收益多,新系统建议用 JSON。 - **实践 · Closeable / AutoCloseable**:**它是 try-with-resources 的底层契约**——把"释放资源"从代码约定升级成了编译期保证。 --- ## 换个入口会怎样 同一个需求换一种途径,结果可能完全不同。先看 IO 模型层面的对比: | 维度 | BIO(InputStream) | NIO(Channel + Selector) | AIO(异步 Channel) | |---|---|---|---| | 编程模型 | 阻塞,一连接一线程 | 非阻塞 + 多路复用,少量线程管大量连接 | 异步回调,完成后通知 | | 主要开销 | 线程数随连接数线性增长 | 单线程 + 事件轮询(epoll) | 依赖内核 AIO 支持程度 | | 数据载体 | `byte[]` | `ByteBuffer`(三指针,易错) | `ByteBuffer` + `CompletionHandler` | | 典型场景 | 文件读写、低并发连接 | 高并发网关、RPC、长连接服务 | 少见;Windows IOCP 上相对成熟 | | 上手难度 | 低 | 中 | 高 | 再看文件复制的三种写法: | 方案 | 数据路径 | 评价 | |---|---|---| | 手写 `read` / `write` 循环 | 磁盘 → 页缓存 → 用户态 → socket 缓冲区 | 两趟用户态拷贝,最慢 | | `FileChannel.transferTo` | 页缓存 → socket 缓冲区(`sendfile`) | 零拷贝,适合大文件传输 | | `Files.copy` | 内部会尝试走 transferTo 路径 | **业务代码首选** | 如果确实要手写传输,注意一个细节——`transferTo` 单次能传多少受内核限制,必须循环补齐: ```java import java.nio.channels.FileChannel; import java.nio.file.Path; import java.nio.file.StandardOpenOption; public class FastCopy { public static void main(String[] args) throws Exception { try (var in = FileChannel.open(Path.of("src.iso"), StandardOpenOption.READ); var out = FileChannel.open(Path.of("dst.iso"), StandardOpenOption.CREATE, StandardOpenOption.WRITE)) { long size = in.size(), done = 0; while (done < size) { done += in.transferTo(done, size - done, out); // 必须循环 } } } } ``` --- ## 前置知识:读懂这条路需要什么 按重要程度排序,缺哪个补哪个: 1. **字节 / 字符 / 编码**:字节是存储与传输的最小单位,字符是给人看的符号,编码是两者之间的映射表。UTF-8 中一个汉字占 3 字节,GBK 中占 2 字节——**长度不同,这就是乱码和"半个字符"的根源**。 2. **文件描述符(fd)**:内核用一个整数表示一个打开的文件。它不是文件本身,而是一张表里的索引。流不关闭,这个表项就一直被占着。 3. **用户态 / 内核态与系统调用**:应用代码运行在用户态,无权直接操作磁盘和网卡,必须通过系统调用"请求"内核代办。每次请求都有固定的切换开销。 4. **缓冲(buffer)解决什么问题**:它不减少数据总量,也不提升单次搬运速度,**它减少的是"高价动作"的次数**。这是理解整个 IO 体系的钥匙。 5. **阻塞的含义**:线程发起读取后如果数据没就绪,就被挂起,直到数据到达。这是 BIO 一切缺陷的源头。 --- ## 实践映射:写业务代码该注意什么 源码看完了,落回日常编码,下面几条是最直接的收益: 1. **文件与网络流一律包缓冲**:`new BufferedInputStream(new FileInputStream(f))`。裸用 `FileInputStream` 逐字节读是最常见的性能事故。 2. **一律用 try-with-resources**:不只是"更优雅"——它保证了异常路径上 fd 也会被释放。 3. **字符流一律显式指定编码**:`new InputStreamReader(in, StandardCharsets.UTF_8)`,永远不要依赖平台默认值。 4. **大文件不要 `readAllBytes()`**:它会把整个文件读进堆内存,几 GB 的文件直接触发 OOM。用固定大小的缓冲循环读。 5. **别在多线程间共享同一个流**:`BufferedInputStream` 的方法带 `synchronized`,共享会退化成串行;正确做法是每个线程独立打开流。 6. **高并发网络不要一连接一线程**:把模型升级到 NIO(或直接用 Netty),这才是 `Selector` 的价值所在。 --- ## 路上的坑与面试高频 | 问题 | 一句话答案 | 展开要点 | |---|---|---| | `read()` 为什么返回 `int` 而不是 `byte`? | 因为需要用 `-1` 表示结束,而 `byte` 装不下 256 个有效值再加一个 `-1`。 | `byte` 范围是 -128~127,只能靠补码硬塞;`int` 的 0~255 表示字节值,-1 单独表示 EOF。 | | `read(byte[])` 返回 0 代表结束吗? | 不代表。只有在传入长度为 0 的数组时才返回 0,否则要么返回正数,要么返回 -1。 | 用 `!= -1` 判断结束,不要用 `== 0` 或 `<= 0`。 | | `flush()` 和 `close()` 有什么区别? | `flush()` 只把缓冲数据推出去,不释放资源;`close()` 会先 flush 再释放。 | `BufferedOutputStream` 如果既不 flush 也不 close,数据就丢在它的数组里。 | | `BufferedOutputStream` 忘了 close 会怎样? | 最后不足一个缓冲区的数据会丢失。 | 这就是必须用 try-with-resources 的直接理由,而不是"代码规范要求"。 | | 为什么 `FileReader` 读出来是乱码? | 它用了平台默认编码,和文件的实际编码不一致。 | JDK 18 起默认编码统一为 UTF-8,但显式传 `StandardCharsets.UTF_8` 才是跨版本、跨平台都稳的写法。 | | NIO 一定比 BIO 快吗? | 不一定。低并发下 NIO 甚至更慢,它的优势是"用少量线程扛住大量连接"。 | 高并发的瓶颈是线程数与上下文切换,不是单次读写速度。 | | `transferTo` 一定零拷贝吗? | 不一定,取决于操作系统与调用路径是否真的走了 `sendfile`。 | Java 层只是提供了入口。文件→文件、文件→socket 才可能命中;中间插入加密、压缩就会退化。 | | 一个进程最多能打开多少个文件? | 受操作系统 `ulimit -n` 限制,Linux 默认常见为 1024。 | 连接池、流未关闭最典型的症状就是 `Too many open files`。 | --- ## 收尾:一张调用链路图 把全文的电线接回起点。当你写下 `bufferedReader.readLine()` 时,真正发生的事情是:  **三条核心结论**: 1. **Java IO 的性能关键不在"搬得多快",而在"少搬几次"**。缓冲、批量读、零拷贝,本质上都是同一件事的不同层次实现。 2. **字节流是底座,字符流是它的解码层**。任何文本乱码问题,先怀疑编码,再看长度边界,最后才怀疑代码逻辑。 3. **BIO 的缺陷是结构性的**(一连接一线程),所以 NIO 不是一次优化,而是换了一套模型。理解了缺陷,才知道为什么要接受 Buffer 三指针这种"反直觉"的设计。 **延伸学习顺序**(按依赖关系排序,不要跳): 字节与编码 → `BufferedXxx` 系列 → `Reader` / `Writer` 体系 → NIO 的 `Buffer` 与 `Channel` → `Selector` / Netty → 零拷贝与内存映射。 每往前一步,前一步都是后一步的必要条件——这正是本文选择"从一行调用往下走"而不"按目录罗列"的原因。