首页 文章 精选 留言 我的

精选列表

搜索[第三期热点征文-AI工具],共10011篇文章
优秀的个人博客,低调大师

【热点】微信的消息收发机制

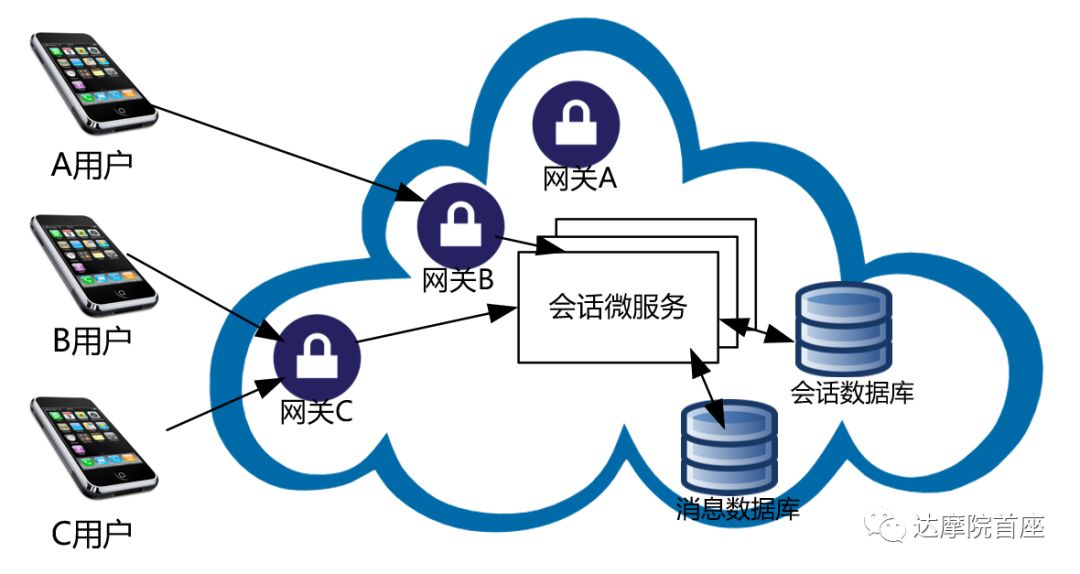
微信可能是国内最早一批做微服务架构体系的,毕竟微服务的理念与腾讯一直倡导的“大系统小做”有很多相通之处,当然微信的功能有很多,衣食住行都能找到入口。我们今天单说它的原生功能:即时通信。 这块内容本座想分两部分来讲,第一部分是点到点聊天,第二部分是群组聊天。这两种聊天模式有共同点,比如说已读信息不会在服务端保留,因此换新手机是找不到历史消息的。也有不同点,比如服务端的架构和数据流等等。 先说点到点聊天,手机端通过打开微信软件建立了到腾讯云的微信网关,当然考虑到就近访问与负载平衡,不同客户端可能连到不同的网关。当A用户通过网关B发送微信给在线用户B时,会话微服务会记录当前所有用户的连入信息,维护如下的用户-网关表: 用户 网关A BB CC C 如果对端用户不在线,则会记录上次连接的网关,如果从来没在线过则随机分配网关。这张表虽然有高达10亿的记录(微信用户数量),但好在只是一张二维表而且可做冷热分离,因此存储量并不大,然后各个网关上会有热数据的分布式缓存。 为什么要这样做呢,因为我们知道让一台网关服务器来维持每一个客户端的TCP连接是非常消耗内存的,鉴于微信用户的数量,一般硬件的性能是无法达到的,因此通过会话微服务来记录这些信息可以很好地为网关减负。 接下来当消息进入到会话微服务找到B对应的网关,然后通过该网关将消息传递给B用户。 等等,什么,网关在没有用户请求的情况下还能直接给用户发消息,这是我认识的CS架构么?当然通过长轮询(Long Polling)可以定期从服务端拉数据,但这就影响了消息的实时性了。传统的HTTP看似无法实现了,我们想到的办法是WebSocket(WSS)。WSS是通过单个TCP连接提供全双工(双向通信)通信信道的计算机通信协议。它允许用户和服务器之间的流连接,并允许即时信息交换。 Ok,消息传递到在线用户B了,B用户回复给服务器“已收到”的回执(不论已读还是未读),会话服务器再以WSS形式将回执转发给A。当然如果B用户离线,消息会存放在消息数据库中直到过期(三天?)。因此点对点聊天在服务器上并不消耗太多的存储资源。 接下去我们说说群组消息,当会话微服务识别到消息的接收方是一个群组时,会去调用群组微服务,群组微服务的表结构是一张一对多的分布式数据表: 群组ID 用户XXX AXXX BXXX CYYY CYYY DYYY E 得到目标群的用户列表后,会话微服务再查询自己的会话数据库找到用户对应的网关,通过WebSocket的形式发送给该群组的所有成员。 当然就像新浪在李晨发“我们”,鹿晗发“官宣”,中国国家男子足球队发“对不起”的时候会发生服务器宕机现象,新浪的处理方式是将粉丝群切片,分批次发给不同子群。微信也会在成员过多的群通过异步的消息队列进行批量组播,但即便如此,与点到点微信不同的是,网关的负担会大很多,因此除了将会话微服务从网关上拆解,还需要进一步将验证服务、语义分析服务(各种网络协议的解包)从网关服务器上拆解下来,由此就形成了微信的群族消息的数据流。

优秀的个人博客,低调大师

热点推荐:为什么JVM需要GC

社区内有人发起了一个讨论,关于JVM是否一定需要GC?他们认为应用程序的回收目标是构建一个仅用来处理内存分配,而不执行任何真正的内存回收操作的 GC。即仅当可用的 Java 堆耗尽的时候,才进行顺序的 JVM 停顿操作。 首先需要理解为什么需要GC。随着应用程序所应对的业务越来越庞大、复杂,用户越来越多,没有GC就不能保证应用程序正常进行。而经常造成STW的GC又跟不上实际的需求,所以才会不断地尝试对GC进行优化。 社区的需求是尽量减少对应用程序的正常执行干扰,这也是业界目标。Oracle在JDK7时发布G1 GC的目的是为了减少应用程序停顿发生的可能性,让我们通过本文来了解G1 GC所做的工作。 JVM发展历史简介 还记得机器猫吗?他和康夫有一张书桌,书桌的抽屉其实是一个时空穿梭通道,让我们操作机器猫的时空机器,回到1998年。那年的12月8日,第二代Java平台的企业版J2EE正式对外发布。为了配合企业级应用落地,1999年4月27日,Java程序的舞台—Java HotSpot Virtual Machine(以下简称HotSpot )正式对外发布,并从这之后发布的JDK1.3版本开始,HotSpot成为Sun JDK的默认虚拟机。 GC发展历史简介 1999年随JDK1.3.1一起来的是串行方式的Serial GC ,它是第一款GC,并且这只是起点。此后,JDK1.4和J2SE1.3相继发布。2002年2月26日,J2SE1.4发布,Parallel GC 和Concurrent Mark Sweep (CMS)GC跟随JDK1.4.2一起发布,并且Parallel GC在JDK6之后成为HotSpot默认GC。 HotSpot有这么多的垃圾回收器,那么如果有人问,Serial GC、Parallel GC、Concurrent Mark Sweep GC这三个GC有什么不同呢?请记住以下口令: 如果你想要最小化地使用内存和并行开销,请选Serial GC; 如果你想要最大化应用程序的吞吐量,请选Parallel GC; 如果你想要最小化GC的中断或停顿时间,请选CMS GC。 那么问题来了,既然我们已经有了上面三个强大的GC,为什么还要发布Garbage First(G1)GC?原因就在于应用程序所应对的业务越来越庞大、复杂,用户越来越多,没有GC就不能保证应用程序正常进行,而经常造成STW的GC又跟不上实际的需求,所以才会不断地尝试对GC进行优化。 为什么名字叫做Garbage First(G1)呢? 因为G1是一个并行回收器,它把堆内存分割为很多不相关的区间(Region),每个区间可以属于老年代或者年轻代,并且每个年龄代区间可以是物理上不连续的。 老年代区间这个设计理念本身是为了服务于并行后台线程,这些线程的主要工作是寻找未被引用的对象。而这样就会产生一种现象,即某些区间的垃圾(未被引用对象)多于其他的区间。 垃圾回收时实则都是需要停下应用程序的,不然就没有办法防治应用程序的干扰 ,然后G1 GC可以集中精力在垃圾最多的区间上,并且只会费一点点时间就可以清空这些区间里的垃圾,腾出完全空闲的区间。 绕来绕去终于明白了,由于这种方式的侧重点在于处理垃圾最多的区间,所以我们给G1一个名字:垃圾优先(Garbage First)。 G1 GC基本思想 G1 GC是一个压缩收集器,它基于回收最大量的垃圾原理进行设计。G1 GC利用递增、并行、独占暂停这些属性,通过拷贝方式完成压缩目标。此外,它也借助并行、多阶段并行标记这些方式来帮助减少标记、重标记、清除暂停的停顿时间,让停顿时间最小化是它的设计目标之一。 G1回收器是在JDK1.7中正式投入使用的全新的垃圾回收器,从长期目标来看,它是为了取代CMS 回收器。G1回收器拥有独特的垃圾回收策略,这和之前提到的回收器截然不同。从分代上看,G1依然属于分代型垃圾回收器,它会区分年轻代和老年代,年轻代依然有Eden区和Survivor区,但从堆的结构上看,它并不要求整个Eden区、年轻代或者老年代在物理上都是连续。 综合来说,G1使用了全新的分区算法,其特点如下所示: 并行性:G1在回收期间,可以有多个GC线程同时工作,有效利用多核计算能力; 并发性:G1拥有与应用程序交替执行的能力,部分工作可以和应用程序同时执行,因此,一般来说,不会在整个回收阶段发生完全阻塞应用程序的情况; 分代GC:G1依然是一个分代收集器,但是和之前的各类回收器不同,它同时兼顾年轻代和老年代。对比其他回收器,或者工作在年轻代,或者工作在老年代; 空间整理:G1在回收过程中,会进行适当的对象移动,不像CMS只是简单地标记清理对象。在若干次GC后,CMS必须进行一次碎片整理。而G1不同,它每次回收都会有效地复制对象,减少空间碎片,进而提升内部循环速度。 可预见性:由于分区的原因,G1可以只选取部分区域进行内存回收,这样缩小了回收的范围,因此对于全局停顿情况的发生也能得到较好的控制。 随着G1 GC的出现,GC从传统的连续堆内存布局设计,逐渐走向不连续内存块,这是通过引入Region概念实现,也就是说,由一堆不连续的Region组成了堆内存。其实也不能说是不连续的,只是它从传统的物理连续逐渐改变为逻辑上的连续,这是通过Region的动态分配方式实现的,我们可以把一个Region分配给Eden、Survivor、老年代、大对象区间、空闲区间等的任意一个,而不是固定它的作用,因为越是固定,越是呆板。 G1 GC垃圾回收机制 通过市场的力量,不断淘汰旧的行业,把有限的资源让给那些竞争力更强、利润率更高的企业。类似地,硅谷也在不断淘汰过时的人员,从全世界吸收新鲜血液。经过半个多世纪的发展,在硅谷地区便形成只有卓越才能生存的文化。本着这样的理念,GC承担了淘汰垃圾、保存优良资产的任务。 G1 GC在回收暂停阶段会回收最大量的堆内区间(Region),这是它的设计目标,通过回收区间达到回收垃圾的目的。这里只有一个例外情况,这个例外发生在并行标记阶段的清除(Cleanup)步骤,如果G1 GC在清除步骤发现所有的区间都是由可回收垃圾组成的,那么它会立即回收这些区间,并且将这些区间插入到一个基于LinkedList实现的空闲区间队列里,以待后用。因此,释放这些区间并不需要等待下一个垃圾回收中断,它是实时执行的,即清除阶段起到了最后一道把控作用。这是G1 GC和之前的几代GC的一大差别。 G1 GC的垃圾回收循环由三个主要类型组成: 年轻代循环 多步骤并行标记循环 混合收集循环 Full GC 在年轻代回收期,G1 GC暂停应用程序线程,然后从年轻代区间移动存活对象到Survivor区间或者老年区间,也有可能是两个区间都会涉及。对于一个混合回收期,G1 GC从老年区间移动存活对象到空闲区间,这些空闲区间也就成为了老年代的一部分。 G1的区间设计灵感 为了加快GC的回收速度,HotSpot的历代GC都有自己的不同的设计方案,区间概念在软件设计、架构领域并不是一个新名词,关系型数据库、列式数据库最先使用这个概念提升数据存、取速度,软件架构设计时也广泛使用这样的分区概念加快数据交换、计算。 为什么会有区间这个设计想法?大家一定看过电视剧《大宅门》吧?大宅门所描述的北京知名医术世家白家是这本电视剧的主角。白家有三兄弟,没有分家之前,由老爷子一手掌管全家,老爷子看似是个精明人,实质是个糊涂的人,否则也不会弄得后来白家家破人散。白家的三兄弟在没有分家之前,老大一家很老实,老二很懦弱,性格像女人,虽然肚子里明白道理,但是不敢出来做主。老三年轻时混蛋一个,每次出外采购药材都要私吞家里的银两,造成账目混乱。老大为了家庭和睦,一直在私下倒贴银两,让老爷子能够看到一本正常的账目。这样的一家子聚在一起,迟早家庭内部会出现问题,倒不如分家,你也不用算计家里的钱了,分给你,分给你的钱有本事守住,没本事就一直拮据下去吧。这就是最原始的分区(Region)概念。 我们回到技术,看看HBase的RegionServer设计方式。在HBase内部,所有的用户数据以及元数据的请求,在经过Region的定位,最终会落在RegionServer上,并由RegionServer实现数据的读写操作。RegionServer是HBase集群运行在每个工作节点上的服务。它是整个HBase系统的关键所在,一方面它维护了Region的状态,提供了对于Region的管理和服务;另一方面,它与Master交互,上传Region的负载信息上传,参与Master的分布式协调管理。 HRegionServer与HMaster以及Client之间采用RPC协议进行通信。HRegionServer向HMaster定期汇报节点的负载状况,包括RS内存使用状态、在线状态的Region等信息。在该过程中HRegionServer扮演了RPC客户端的角色,而HMaster扮演了RPC服务器端的角色。HRegionServer内置的RpcServer实现了数据更新、读取、删除的操作,以及Region涉及到Flush、Compaction、Open、Close、Load文件等功能性操作。 Region是HBase数据存储和管理的基本单位。HBase使用RowKey将表水平切割成多个HRegion,从HMaster的角度,每个HRegion都纪录了它的StartKey和EndKey(第一个HRegion的StartKey为空,最后一个HRegion的EndKey为空),由于RowKey是排序的,因而Client可以通过HMaster快速的定位每个RowKey在哪个HRegion中。HRegion由HMaster分配到相应的HRegionServer中,然后由HRegionServer负责HRegion的启动和管理,和Client的通信,负责数据的读(使用HDFS)。每个HRegionServer可以同时管理1000个左右的HRegion。 再来看看软件系统架构方面的分区设计。以任务调度为例,假设我们有一个中心调度服务,那么当数据量不断增多,这个中心调度服务一定会遇到性能瓶颈,因为所有的请求都会最终指向它。为了解决这个性能瓶颈,我们可以将任务调度拆分为多个服务,即这多个服务都可以处理任务调度工作,那么问题来了,每个任务调度服务处理的源数据是否需要完全一致? 根据华为公司发布的专利发明,显示他们对于每一个任务调度服务有数据来源区分的操作,即按照任务调度数量对源数据进行划分,比如3个任务调度服务,那么源数据按照行号对3取余的方式划分,如果运行了一段时间之后,任务调度服务出现了数量上的增减,那么这个取余划分需要重新进行,要按照那个时候的任务调度数量重新划分区间。 回到G1。在G1中,堆被平均分成若干个大小相等的区域(Region)。每个Region都有一个关联的Remembered Set(简称RS),RS的数据结构是Hash表,里面的数据是Card Table (堆中每512byte映射在card table 1byte)。 简单的说RS里面存在的是Region中存活对象的指针。当Region中数据发生变化时,首先反映到Card Table中的一个或多个Card上,RS通过扫描内部的Card Table得知Region中内存使用情况和存活对象。在使用Region过程中,如果Region被填满了,分配内存的线程会重新选择一个新的Region,空闲Region被组织到一个基于链表的数据结构(LinkedList)里面,这样可以快速找到新的Region。 总结 没有GC机制的JVM是不能想象的,我们只能通过不断优化它的使用、不断调整自己的应用程序,避免出现大量垃圾,而不是一味认为GC造成了应用程序问题。 G1GC优化参考文档 作者介绍 周明耀,2004年毕业于浙江大学,工学硕士,国外投资银行12年工作经验,4年分布式系统、物联网工作经验,10年技术团队管理经验。IBM开发者论坛专家作者、InfoQ专栏作者,著有《大话Java性能优化》、《深入理解JVM&G1 GC》,提交分布式计算领域发明专利超过15项。 来源:51CTO

优秀的个人博客,低调大师

#2020征文-其它#鸿蒙IDE(DevEco Studio)gradle下载缓慢,咋办

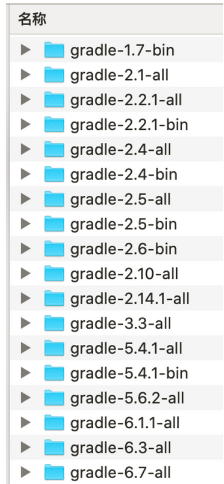
目录: 基于鸿蒙的电子词典项目来了!可以搜索无限单词哦! 调试鸿蒙App源代码的两种方式 开发跨设备的鸿蒙(HarmonyOS)App 我们知道,DevEco Studio是基于IntelliJ IDEA社区版二次开发的,所以免不了要使用Gradle完成项目的构建工作。不过由于国内众所周知的原因,在DevEco Studio中下载Gradle非常慢(并不是无法访问,而是非常慢,而且还经常timeout),所以在网上有很多帖子给出了不同的解决方案。本文先列举一些典型的解决方案。 方案1:使用国内的maven库地址 找到build.gradle文件,然后修改或添加buildscript和allprojects,修改后的代码如下: repositories { maven{url 'http://maven.aliyun.com/nexus/content/groups/public/'} maven { url "https://jitpack.io" } google() } dependencies { classpath 'com.android.tools.build:gradle:3.1.2' } } allprojects { repositories { maven{url 'http://maven.aliyun.com/nexus/content/groups/public/'} google() } } 方案2:事先下载好gradle 下载好的文件是gradle-6.3-all.zip,然后将该文件放在特定的目录。目录的位置与操作系统有关。 Windows下的位置:C:\Users\用户名.gradle macOS下的位置:/Users/用户名/.gradle Linux下的位置:/home/用户名/.gradle 读者根据自己使用的OS进入不同位置的.gradle目录,然后再进入该目录下的wrapper/dists子目录。会看到“gradle-版本号-all”格式 的目录,例如,下图是我的macOS上的目录结构。 然后进入gradle-6.3-all目录(最新的DevEco Studio使用的是gradle6.3),会看到一个由字母和数字组成的目录,如b4awcolw9l59x95tu1obfh9i8,这个目录与gradle版本和路径有关。所以不同版本和路径的gradle,目录名不同。现在将我们下好的gradle-6.3-all.zip文件复制到该目录。再次用DevEco Studio重新打开HarmonyOS工程,就会非常快的同步gradle。这是因为DevEco Studio会优先在特定目录搜索gradle的zip文件是否存在,如果存在,就直接使用了,如果不存在,才会从网上下载。 不过有时特定的gradle目录还没有生成,我们也不知道要将gradle-6.3-all.zip或类似的文件放到哪里,所以也可以采用另外一种方法,换个下载更快的地址。 打开HarmonyOS工程,找到<工程根目录>/gradle/wrapper/gradle-wrapper.properties文件,会看到一个distributionUrl属性,该属性默认指向gradle的官网,可以将其换成国内的地址,或干脆自己用apache、nginx等服务器自己搭建一个本机下载服务,如我将其换成了如下的地址: http://127.0.0.1/gradle-6.3-all.zip 现在再重新打开HarmonyOS工程,就会非常快速地下载(由于是在本地下载,所以在1s之内就能完成gradle的下载任务)和同步gradle及其相关配置了。不过这里还有一个问题,我再创建新的HarmonyOS工程,岂不是还要改一遍这个文件,非常麻烦。所以为了一劳永逸,干脆改一下DevEco Studio的模板。 首先进入<DevEco Studio根目录>/plugins/harmony目录,这是DevEco Studio的插件目录。在该目录下继续找到lib/templates/gradle/wrapper/gradle/wrapper/gradle-wrapper.properties文件,该文件就是每次创建HarmonyOS工程时的gradle-wrapper.properties文件,打开该文件,将distributionUrl改成http://127.0.0.1/gradle-6.3-all.zip即可。然后重新启动DevEco Studio。再创建新的HarmonyOS工程,就会自动使用新的gradle下载地址了。由于此前已经下载了gradle,所以即使不启动本机的http服务器,仍然能快速使用gradle。 作者:李宁 想了解更多内容,请访问: 51CTO和华为官方战略合作共建的鸿蒙技术社区https://harmonyos.51cto.com

优秀的个人博客,低调大师

【AWS征文】AWS安全加固-Fortinet AWS 安全解决方案

作者:昱坤 在公有云方案日益火爆的今天,公有云应用越来越广泛。随之而来的,公有云也遇到了一些挑战:  传统数据中心产品不一定支持云环境 传统的产品不一定支持云弹性的部署以及模块化的部署 云架构的部署思路与传统物理环境部署环境完全不同 传统的安全防护很难在多云环境提供统一安全解决方案 遇到最多的问题就是:我们云环境一定要和物理数据中心架构一样 而在企业进行公有云迁移时对于安全和自动化的要求,AWS上有了新的安全自动部署方案: 在该方案中,可以将防火墙部署在Transit VPC中,以实现VPC与VPC间/VPC与Internet间等的安全加固需求。此文仅介绍Fortinet AWS 的安全解决方案。 Fortinet云部署实例要求 如果要在AWS上部署FortiGate-VM,那么实例需要满足以下要求: Fortinet常见云部署模式 针对AWS云上部署,Fortinet提供两种常见的部署方案: NGFW 和ELB部署形式  两个AZ的FW与WAF工作在AA模式 入向流量通过ELB负载分摊 FW开启NGFW威胁检测功能 FW将流量映射至内部ELB FQDN NGFW以及WAF 和ELB部署形式  FW与WAF完全集成将HTTP转至WAF WAF对HTTP流量进行深度检测 WAF将HTTP流量映射至内部ELB 在该部署模式下,三明治式的部署架构是部署WAF的最佳实践: 入向流量通过ALB负载,并基于内容分流; WAF专注于管理高级WEB安全配置; 两种高级防御模式 • 黑名单提供特征库防御,IP信誉库,HTTP协议规范,防病毒.DLP,高级防御规则,高级APT防护等功能 • 白名单提供网站详细参数设定,扫描报告导入,应用自学,Bot机器学习,参数机器学习等功能云部署的高可用性 Fortinet云部署HA有两种方案: 方案一:  由于AWS VPC中不支持二层协议,所以不能在AWS中运行VRRP HA使用主备模式部署在相同AZ,心跳使用3层 根据事件或SLA自动切换主备 主备切换会自动调用AWS API,备设备将主设备上的secondary IP和EIP切换至备设备 同时备设备将指向主设备网卡的下一条指向自己 方案二:  FortiGate部署在两个不通的可用区,子网信息并不相同 通过Fortinet利用AWS的原生服务AWS API Gateway、Cloudwatch、Lambda构建了一套自动切换VPC路由表的解决方案 当FortiGate自己发现故障,会通过联动API Gateway触发Lambda切换VPC路由表 当Cloud Watch发现设备故障,同样会触发Lambda切换VPC路由表自动扩展模式 自动扩展模式: 在面向公网侧部署NLB,保障公网IP可以透传到FortiGate侧 CloudWatch持续监控FortiGate CPU及MEM信息触发Lambda Lambda在Autoscale成员中增加FW并通过API通知FW同步配置 FW同步完配置通过API通知Lambda Lambda更新ELB配置 DynamoDB存储Autoscaling 状态信息 支持PAYG,Hybrid部署

优秀的个人博客,低调大师

总监课第三期|深入解析数据存储技术原理及发展演进

从传统存储到云存储的转变,其中经历了哪些设计思考与系统架构演变?涵盖硬件与软件的存储系统科学,其中蕴含了哪些精妙的技术设计理念?从磁盘存储到闪存存储的发展,其中进行了哪些翻天覆地的技术革新?对于无价的数据资产,其中蕴含了哪些智慧的数据保护思想? 针对数据存储技术的原理与演进发展,阿里云存储资深专家(储道)将倾囊相授,帮你打开数据存储大门,快来戳链接学习吧~ 本期总监课我们来聊聊关于数据存储技术的那些事儿 吴忠杰(储道),专注存储技术研发十多年,历经中科院计算所存储研究中心、EMC、Memblaze著名存储研发机构,从传统存储阵列、虚拟化集群存储、数据去重、闪存存储一直做到大规模分布式存储。长期从事存储前沿技术的研究与开发,精通软、硬件技术,发表十余篇学术论文,拥有多项海内外存储技术专利,是“存储之道”技术博客作者。他是盘古分布式存储资深

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册