首页 文章 精选 留言 我的

精选列表

搜索[移动解析 HTTPDNS],共10009篇文章
优秀的个人博客,低调大师

ReentrantLock源码解析

谈到多线程,就不避开锁(Lock),jdk中已经为我们提供了好几种锁的实现,已经足以满足我们大部分的需求了,今天我们就来看下最常用的ReentrantLock的实现。 其实最开始是想写一篇关于StampedLock的源码分析的,但发现写StampedLock前避不开ReentrantReadWriteLock,写ReentrantReadWriteLock又避不开ReentrantLock,他们仨是逐层递进的关系。ReentrantReadWriteLock解决了一些ReentrantLock无法解决的问题,StampedLock又弥补了ReentrantReadWriteLock的一些不足,三者有各自的设计和有缺点,这篇文章先和你一起看下ReentrantLock,之后我们会再一起去了解ReentrantReadWriteLock和StampedLock,相信有了ReentrantLock的基础后面的内容也会容易理解很多。 相对于jdk中很多其他的类来说,ReentrantLock提供的接口已经算是非常简单,事实上它只有一个构造参数boolean fair,用来指定是公平锁还是非公平锁,如果你指定的话默认是非公平锁。 public ReentrantLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); } 什么是公平?这里的的公平是指每个线程可以有公平的机会获取到这把锁,10个线程竞争这把锁,某个线程各有10%的机会获取到锁。听起来很理想主义,但大多数时候不建议使用公平锁,因为局部性的存在,每个线程对锁的真正需求度是不同的,有些线程就是需要很频繁的占有锁,有些偶尔占有就行。如果你单纯是为了公平而导致供需不平衡,可能有些线程会浪费锁的持有时间,而有些线程急需用锁但迟迟获取不到,导致线程饥饿,最终导致整个系统的性能不是最大化的。 最大化锁的使用率和代码性能就成了锁设计最重要的目标。试想如果我们提前知道每个线程对锁的需求度,然后按需求度给他们分配锁的占有机会,这样必然能达到锁的最优使用率。但实际上对于jdk的开发者来说,他哪知道你要拿锁去做啥、要开几个线程?所以ReentrantReadWriteLock的设计者用一种很简单粗暴的方式解决了大部分的问题,我们直接上源码。 ReentrantLock中最核心的就是Sync的实现,它默认已经实现了非公平锁的功能,所以你会看到NonfairSync只是简简单单继承了Sync而已。而Sync的主要功能还是继承了AbstractQueuedSynchronizer(AQS)。 AbstractQueuedSynchronizer 简单来说就是维护了一个状态 __state__,和一个等待线程队列(一个双向链表),然后通过VarHandle提供的CAS操作保证线程安全。当你在调用lock()的时候,会直接调用到AbstractQueuedSynchronizer中的acquire(int arg) public final void acquire(int arg) { if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } acquire也很简单,尝试去获取锁,如果获取失败,就把当前线程加到等待队列里(排队),并把当前线程的状态设置为可中断。 回到ReentrantLock,我们来开下它是如何依赖Sync来实现非公平锁的。NonfairSync在执行tryAcquire(int arg)的时候,实际执行的是以下代码。 final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { //如果state是0,说明当前没有线程持有锁,用CAS更新状态,如果CAS成功,就在锁中写入当前线程的信息。 if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { //如果state不是0,也不一定获取锁失败,要看下持有锁的线程是不是自己,如果是更新state int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 从这可以看出来ReentrantLock是可重入锁,state的目的就是为了记录当前锁被同一个线程获取了几次。但是看完这段代码你肯定没看出来哪 __不公平了__。别急,我们来对比下公平锁的实现就知道了。 static final class FairSync extends Sync { private static final long serialVersionUID = -3000897897090466540L; @ReservedStackAccess protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (!hasQueuedPredecessors() && // 不同之处 compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } } FairSync也是继承自Sync,但它重写了加锁tryAcquire方法,打眼一看和上面非公平锁的tryAcquire非常像,唯一不同之处就是在state为0时多了个!hasQueuedPredecessors()的判断。hasQueuedPredecessors()方法是判断是否有线程在等待去获取这把锁,如果有其他线程这次就算是获取锁失败了。 来个易懂的例子,现在办公室只有一间卫生间,很多个同事共用,有人在用卫生间的时候也不会希望别人跑进来和他一起用。公平锁的实现方式就是我来上卫生间,发现卫生间没人用,但有人在排队等卫生间(可能是玩手机没注意卫生间空了),我只能乖乖排队。非公平锁的实现方式是,我来上卫生间,发现卫生间是空的,不管有没有人排队我都占了,这样显然对其他排队的人来说是不公平的。 这种方式在现实世界看起来是非常不合理的,但是如果换种视角,可能越着急的人才是越需要用卫生间的人(可能他拉肚子),让排队的人多等会无所谓,这样才能最大化卫生间的的价值。虽然拉肚子在现实世界不常见,在在计算机中以纳秒计的世界里,有些线程就是比其他线程急很多的情况非常常见,非公平的方式就很合情。再从概率的角度看,如果有个线程需要以更高的频次使用这把锁,不排队去获取锁能舍得锁被获取到的次数最大化,也很合理。所以非公平锁合情合理。但历史告诉我们,凡事没有绝对,还是需要具体问题具体分析,有些情况下,非公平锁会导致线程饥饿。 public void unlock() { sync.release(1); } public final boolean release(int arg) { if (tryRelease(arg)) { Node h = head; if (h != null && h.waitStatus != 0) unparkSuccessor(h); return true; } return false; } unlock()调用了sync中的release(),release()是继承自AQS,跳到AQS中就会发现又调用了tryRelease()。ReentrantLock重写了tryRelease(),源码如下,也比较简单。 protected final boolean tryRelease(int releases) { int c = getState() - releases; if (Thread.currentThread() != getExclusiveOwnerThread()) throw new IllegalMonitorStateException(); boolean free = false; if (c == 0) { free = true; setExclusiveOwnerThread(null); } setState(c); return free; } 释放锁的过程是先判断是否是锁持有线程,然后更新锁状态。如果你进到setExclusiveOwnerThread(null)和setState(c)里面,就会发现这里没有用到CAS,会不会出现线程安全的问题?仔细想想其实不会有线程安全的问题, if (Thread.currentThread() != getExclusiveOwnerThread())判断了是当前线程是否持有锁,保证后续逻辑只有持有锁的线程才会执行到,因为之前获取锁是用CAS保证线程安全的,所以后面的逻辑也一定是线程安全的。 除了加锁和释放锁外,ReentrantLock还提供了和锁、线程相关的的接口,如上图,从函数名就可以看出其作用了,而且实现代码比较简单,这里就不再赘述了,有兴趣可以自行查看源码。

优秀的个人博客,低调大师

Jsp 无法解析${}

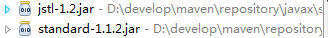
错误原因1:未导包 解决: maven依赖 <!-- JSTL for JSP --> <!-- https://mvnrepository.com/artifact/javax.servlet/jstl --> <dependency> <groupId>javax.servlet</groupId> <artifactId>jstl</artifactId> </dependency> <!-- https://mvnrepository.com/artifact/taglibs/standard --> <dependency> <groupId>taglibs</groupId> <artifactId>standard</artifactId> <version>1.1.2</version> </dependency> 手动导入 图1.png 错误原因2:配置 解决: 在首行设置isELIgnored为false,即不忽略EL表达式 <%@ page language="java" contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" isELIgnored="false"%>

优秀的个人博客,低调大师

__cdecl __stdcall 解析

1.如果函数func是__cdecl(默认调用方式),调用时情况如下 int main() { //参数从右到左压栈 push4 push3 push2 push1 call func add esp0x10//调用者恢复堆栈指针esp,4个参数的大小是0x10(4x4) } 2.如果函数func是__stdcall,调用时情况如下 int main() { //参数从右到左压栈 push4 push3 push2 push1 call func //恢复堆栈指针由被调用者func负责,方法是"ret 0x10" } 3.如果函数func是__pascal,调用情况如下 int main() { //参数从左到右压栈 push1 push2 push3 push4 call func //恢复堆栈指针由被调用者func负责,方法是"ret 0x10" } 3.如果函数func是__fastcall,调用情况如下 int main() { //参数先用ecx, edx, eax传递,然后再压栈 //不进栈 //(不知为什么,帮助中写的是从左到右传递的, //是不是错了,还是bcb6和bcb5的不一样) push4 mov ecx3 mov edx2 mov eax1 call func //恢复堆栈指针由被调用者func负责,方法是"ret 0x04", //因为只进栈一个参数,其余用寄存器传递,所以用ret 0x04恢复 } 发表者:huang_jh #define callback __stdcall #define winapi __stdcall 定义成不同的名字只是为了"望文知意"就像hwnd和hcursor是一样的类型. 他们都是窗口函数(过程)...... 发表者:sinman 我收集的,全仍上来了 左通过栈传递,被调用的函数在返回前清理传送参数的内存栈,但不同的是函数名的修饰部分。 _stdcall是pascal程序的缺省调用方式,通常用于win32 api中,函数采用从右到左的压栈方式,自己在退出时清空堆栈。vc将函数编译后会在函数名前面加上下划线前缀,在函数名后加上"@"和参数的字节数。 2、c调用约定按从右至左的顺序压参数入栈,由调用者把参数弹出栈。对于传送参数的内存栈是由调用者来维护的。另外,在函数名修饰约定方面也有所不同。 _cdecl是c和c++程序的缺省调用方式。每一个调用它的函数都包含清空堆栈的代码,所以产生的可执行文件大小会比调用_stdcall函数的大。函 数采用从右到左的压栈方式。vc将函数编译后会在函数名前面加上下划线前缀。是mfc缺省调用约定。 3、__fastcall调用约定是“人”如其名,它的主要特点就是快,因为它是通过寄存器来传送参数的或更小的参数,剩下的参数仍旧自右向左压栈传送, 被调用的函数在返回前清理传送参数的内存栈),在函数名修饰约定方面,它和前两者均不同。 _fastcall方式的函数采用寄存器传递参数,vc将函数编译后会在函数名前面加上"@"前缀,在函数名后加上"@"和参数的字节数。 4、thiscall仅仅应用于“c++”成员函数。this指针存放于cx寄存器,参数从右到左压。thiscall不是关键词,因此不能被程序员指定。 5、naked call采用1-4的调用约定时,如果必要的话,进入函数时编译器会产生代码来保存esi,edi,ebx,ebp寄存器,退出函数时则产生代码恢复这些 寄存器的内容。naked call不产生这样的代码。naked call不是类型修饰符,故必须和_declspec共同使用。 关键字 __stdcall、__cdecl和__fastcall可以直接加在要输出的函数前,也可以在编译环境的setting...\c/c++ \code generation项选择。当加在输出函数前的关键字与编译环境中的选择不同时,直接加在输出函数前的关键字有效。它们对应的命令行参数分别为/gz、 /gd和/gr。缺省状态为/gd,即__cdecl。 要完全模仿pascal调用约定首先必须使用__stdcall调用约定,至于函数名修饰约定,可以通过其它方法模仿。还有一个值得一提的是winapi 宏,windows.h支持该宏,它可以将出函数翻译成适当的调用约定,在win32中,它被定义为__stdcall。使用winapi宏可以创建自己 的apis。 2)名字修饰约定 1、修饰名(decoration name) “c”或者“c++”函数在内部通过修饰名识别。修饰名是编译器在编译函数定义或者原型时生成的字符串。有些情况下使用函数的修饰名是必要的,如在模块定 义文件里头指定输出“c++”重载函数、构造函数、析构函数,又如在汇编代码里调用“c””或“c++”函数等。 修饰名由函数名、类名、调用约定、返回类型、参数等共同决定。 2、名字修饰约定随调用约定和编译种类(c或c++)的不同而变化。函数名修饰约定随编译种类和调用约定的不同而不同,下面分别说明。 a、c编译时函数名修饰约定规则: __stdcall调用约定在输出函数名前加上一个下划线前缀,后面加上一个“@”符号和其参数的字节数,格式为_functionname@number。 __cdecl调用约定仅在输出函数名前加上一个下划线前缀,格式为_functionname。 __fastcall调用约定在输出函数名前加上一个“@”符号,后面也是一个“@”符号和其参数的字节数,格式为@functionname@number。 它们均不改变输出函数名中的字符大小写,这和pascal调用约定不同,pascal约定输出的函数名无任何修饰且全部大写。 b、c++编译时函数名修饰约定规则: __stdcall调用约定: 1、以“?”标识函数名的开始,后跟函数名; 2、函数名后面以“@@yg”标识参数表的开始,后跟参数表; 3、参数表以代号表示: x--void , d--char, e--unsigned char, f--short, h--int, i--unsigned int, j--long, k--unsigned long, m--float, n--double, _n--bool, .... pa--表示指针,后面的代号表明指针类型,如果相同类型的指针连续出现,以“0”代替,一个“0”代表一次重复; 4、参数表的第一项为该函数的返回值类型,其后依次为参数的数据类型,指针标识在其所指数据类型前; 5、参数表后以“@z”标识整个名字的结束,如果该函数无参数,则以“z”标识结束。 其格式为“?functionname@@yg*****@z”或“?functionname@@yg*xz”,例如 int test1-----“?test1@@yghpadk@z” void test2 -----“?test2@@ygxxz” __cdecl调用约定: 规则同上面的_stdcall调用约定,只是参数表的开始标识由上面的“@@yg”变为“@@ya”。 __fastcall调用约定: 规则同上面的_stdcall调用约定,只是参数表的开始标识由上面的“@@yg”变为“@@yi”。 vc++对函数的省缺声明是"__cedcl",将只能被c/c++调用. cb在输出函数声明时使用4种修饰符号 //__cdecl cb的默认值,它会在输出函数名前加_,并保留此函数名不变,参数按照从右到左的顺序依次传递给栈,也可以写成_cdecl和cdecl形式。 //__fastcall 她修饰的函数的参数将尽肯呢感地使用寄存器来处理,其函数名前加@,参数按照从左到右的顺序压栈; //__pascal 它说明的函数名使用pascal格式的命名约定。这时函数名全部大写。参数按照从左到右的顺序压栈; //__stdcall 使用标准约定的函数名。函数名不会改变。使用__stdcall修饰时。参数按照由右到左的顺序压栈,也可以是_stdcall; 发表者:echoher far是古代的东西 在16位模式下,指针是16位的 指针的寻址空间只有64k 如果指定far,说明这个指针指向的地址要加上基地址 就是说用far可以指定64k以外的区域 现在已经没用了 一点用也没有了 原文http://hi.baidu.com/_%E2d_%B7%B3_%DE%B2%C2%D2/blog/item/4e48666da7c769ff4316948c.html ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/articles/2423120.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

android fastjson 解析

JSONObject jsonObject = JSON.parseObject(wsResponse);String recommends = jsonObject.getString("recommends");Log.i("ss","__________________________recommends:"+recommends); List<Recommend> contents = JSON.parseArray(recommends, Recommend.class); Log.i("ss","____________________________contents.size:"+contents.size());注意: 1:是Integer不是int2:是implements Serializable,不是implements Serializable, Parcelable public class Recommend implements Serializable { private Integer mediaId; private String title; private Integer timeSpan; private Integer roomId; private String roomName; private Integer gameId; private Float overallScore; private Integer scoreType; private Integer totalViews; private Integer definition; private String createTime; } 本文转自wanqi博客园博客,原文链接http://www.cnblogs.com/wanqieddy/p/4655032.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

SecureRandom漏洞解析

SecureRandom漏洞描述 2013年比特币开发商在一篇博客中透露,由于Android系统存在一处关键漏洞,该平台上的比特币电子钱包很容易失窃。比特币开发商称,该漏洞影响到Android平台上的每一个比特币电子钱包应用程序,包括流行的比特币钱包(BitcoinWallet)、blockchain.info钱包(blockchain.infowallet)、BitcoinSpinner钱包(BitcoinSpinnerWallet)和Mycelium钱包(MyceliumWallet)等。 该漏洞存在于Android系统随机生成数字串安全密钥的环节中。该漏洞的生成原因是对SecureRandom类的不正确使用方式导致的。 翻看Android的官方文档会发现。对于SecureRandom类的构造函数SecureRandom(byte[] seed)和SecureRandom#setSeed方法有一段安全性提醒: “Seeds this SecureRandom instance withthe specified Seeding SecureRandom may be insecure” 遗憾的是Android官网并未对此做过多的解释。setSeed方法为什么会引起安全风险?应该怎样使用SecureRandom类? SecureRandom漏洞详情 1. SecureRandom漏洞位置 SecureRandom#SecureRandom(byte[] seed) SecureRandom#setSeed(long seed) SecureRandom#setSeed(byte[] seed) 2.SecureRandom漏洞触发条件 在调用SecureRandom类的构造函数SecureRandom(byte[] seed)。或者在生成随机数之前调用setSeed(long seed)或者setSeed(byte[] seed)方法设置随机种子 3. SecureRandom漏洞原理 SecureRandom随机性是通过它的seed来保证的。如果输入相同的seed会导致生成重复的随机数。SecureRandom内部维护一个internal random state,它生成随机数的方式具有确定性。(如果输入相同的seed那么生成的随机数也相同)具体过程如下图: 在生成一个随机数时internal random state会从seed源中取出一个seed。通过内部运算生成随机数。internal random state具有确定性,不能保证SecureRandom的随机性,所以SecureRandom依靠输入的seed的随机性保证自己能够生成出不相同的随机数。 SecureRandom漏洞POC 在SecureRandom生成随机数时,如果我们不调用setSeed方法,SecureRandom会从系统的中找到一个默认随机源。每次生成随机数时都会从这个随机源中取seed。在linux和Android中这个随机源位于/dev/urandom文件。如果我们在终端可以运行cat /dev/urandom命令,会观察到随机值会不断的打印到屏幕上。 在Android 4.2以下,SecureRandom是基于老版的Bouncy Castle实现的。如果生成SecureRandom对象后马上调用setSeed方法。SecureRandom会用用户设置的seed代替默认的随机源。使得每次生成随机数时都是会使用相同的seed作为输入。从而导致生成的随机数是相同的。下面是一段存在安全风险的使用方法: SecureRandomsecureRandom=newSecureRandom(); byte[]b=newbyte[]{(byte)1}; secureRandom.setSeed(b); //PriortoAndroid4.2,thenextlinewouldalwaysreturnthesamenumber! System.out.println(secureRandom.nextInt()); 在Android4.2 之前使用以上代码, Android会用种子byte b[]代替了系统默认的随机数生成源。导致nextInt()方法总是范围同一个随机数。 4.2以上的SecureRadom类为什么没有这个问题呢?因为经过比特币钱包漏洞之后Google修改了SecureRandom的内部实现,用基于OpenSSL的算法替代了老版的Bouncy Castle。用户调用setSeed时会将用户设置的seed添加到随机源(/dev/urandom)中而不是简单的替换。 SecureRandom漏洞修复建议: 1.不要使用自定义随机源代替系统默认随机源(推荐)除非有特殊需求,在使用SecureRandom类时,不要调用以下函数: SecureRandom#SecureRandom(byte[]seed) SecureRandom#setSeed(longseed) SecureRandom#setSeed(byte[]seed) 2.在调用setSeed方法前先调用任意nextXXX方法。原理如下: 我们可以通过SecureRandom#nextBytes(byte[] bytes)避免这个问题。具体做法是调用setSeed方法前先调用一次SecureRandom#nextBytes(byte[] bytes)方法。为什么这样就可以避免默认随机源被替代呢?我们可以从源码中找到答案。(本文所引用代码全部基于Android API 16) 在SecureRandom初始化时,会生成一个SecureRandomSpi对象。SecureRandom的核心方法都由SecureRandomSpi对象代理。下面是SecureRandomSpi类的子类SHA1PRNG_SecureRandomImpl的初始化源码: 在初始化时会将内部状态机设置为state = UNDEFINED。如果使用者接着调用SecureRandom#nextBytes方法, SecureRandom会调用SecureRandomSpi#engineNextBytes方法 如果state的状态为UNDEFINED,那么nextBytes会使用默认的随机源。并将state设置为NEXT_BYTES之后如果调用setSeed方法,最终会调用到SecureRandomSpi#engineSetSeed方法.源码如下: 当state==NEXT_BYTES时会恢复原有的hash再更新seed,因为nextBytes时已经设置了系统的seed所以setSeed中传入的seed将添加到系统seed的尾部。这样生成随机数时也会在系统的随机源中找seed,从而保证其随机性。 SecureRandom的一种误用模式 最近网上流传一种利用SecureRandom输出固定随机值并用这个随机值当作加密秘钥的用法。这种模式利用前一节中提到的用特定seed代替系统随机源的方法,故意让SecureRandom每次都输出固定的随机值。通过这个固定值作为秘钥加密本地文本。其使用方式和流程如下: 使用例子: 这种方式确实可以对原始秘钥做一定的隐藏。起到混淆的作用。但google官方博客否定了该方式的使用。原因如下: 1.对资深的攻击者而言这种方式的加密太过简单。他们可以轻易的看懂这里在干什么,并构造有效的攻击代码。 2.整个加密的过程依赖SecureRandom的实现细节,这种依赖使得程序健壮性和可扩展性都非常脆弱。例如在Android API 17以后SecureRandom的默认实现方式从Cipher.RSA换到了OpenSSL。SecureRandom新的实现方式不能将自己的seed替换掉系统的seed。造成这段代码在API 17以上不能工作。APP必须强制升级才能继续运作。对某个类内部细节的依赖是软件设计中的大忌。 3.从seed到生成key的过程非常的廉价,时间成本和资源要求的很低。如果攻击者采用暴力破解这种加密方式将显的很脆弱。 如何正确的从password生成一个秘钥? 标准的秘钥生成方式应该使用PKCS#5算法。该算法主要有两个优点。 1.利用随机盐加强秘钥的强度。随机盐可以有效的防止暴力破解。同一个password可以生成多个秘钥。攻击者不得不针对每个salt构造不同的秘钥字典。 2.通过迭代方式增加秘钥生成的时间成本。使得攻击者破解秘钥的时间大大增加。 Android的JCE provider现在能支持PBKDF2WithHmacSHA1。下面的代码将展示如何通过PBK算法将password生成为一个秘钥。 原文链接:阿里聚安全:http://jaq.alibaba.com/blog.htm?id=47

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册