首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10010篇文章
优秀的个人博客,低调大师

python基础知识

1、print()函数print函数用于向控制台、python解释器、cmd命令行输出你想要输出的内容。print函数有输入参数,可以是字符串、数字、变量等等,也可以是它们的混合,不同对象之间可以使用,来分隔,print函数遇到,的时候会输出一个空格来作为分隔输出的效果。注意:在print函数中,如果输入的内容是可以继续计算或者合并的,那么python会先计算或者合并之后再输出。如:print(100+200)print('a'+'b')会输出数字300以及字符串'ab'2、input()函数用于从命令行、python解释器获取用户的输入,从subline text中无法输入。用户的所有输入都会被当做是str类型,即字符串类型,用户可以将input的输入内容放入变量中,即:name=input()用于保存输入的内容用作后续代码的指代。同时,为了更友好的界面,可以给input函数输入参数值,参数值可以是一个字符串,也可以是一个变量的指代,用于在提示用户输入的时候给出详细的说明,即:name=input('inpurt your name:')或者i='please input here:' , name=input(变量i)。3、组织方式python的组织方式是通过统一缩进,主旨是简洁优雅。4、数据类型和变量====整数和浮点数:整数分为正整数、负整数、0浮点数有精度问题,很大的浮点数可以用科学计数法标记,其中的10使用e来表示,即:12300000 = 1.23e7 ,或者类似2.35e-5等等====字符串:字符串,顾名思义,是一串字符序列,使用单引号或者双引号包括起来,外围的单引号或者双引号不算字符串的内容。如果字符串内容有单引号,那么外围要使用双引号包围,反之亦然,如果字符串内容中既有单引号又有双引号,则要使用\来转义其中一个引号如:' i\'am a "good" man ' ,使用\'来表示转义单引号====字符串+转义字符:在print函数中无法通过回车来体现最终打印字符串的换行,必须使用\n来表示换行,使用\t表示制表符,\单引号或者双引号,\\表示\符号注意:默认情况下,一个字符串中的\转义字符是会转义的,转义规则根据上述说明。但是如果在字符串前面加上r,则表示不对字符串内容做转义如:默认转义,print('line1\'line2')---->line1'line2强制不转义,print(r'line1\'line2')----->line1\'line2(可用于re的过滤规则中)这种情况下,不会转义:print('line1\\'+'nline2')------>line1\nline2====字符串+''''''实现简化换行:如果要输出一个段落,涉及字符串内部的多处换行,可以使用\n来实现,也可以使用print(''' ''')来实现,里面的字符串根据实际内容直接回车如:print('''这里是根据传入的页数,形成了所有的链接这里是server端这是一张新图片,准备下载''')====布尔值:True和False,用于各种判断,意味着一件事件为真或者为假,如3>2为真,2==0为假逻辑运算and,or,not,逻辑运算会与布尔值结合计算,如True and True 的结果为True注意:在python中,1可以被认为是True,0被认为是False(可以计算),其他值即不是True也不是False注意is是表示两边是同一个对象====空值:python中的空值使用None表示,注意,None不是0,对于0而言是有意义的,而None是一种特殊的属性,意味着空====变量:python支持多种数据类型,有内置原生数据类型,也有自定义扩展数据类型,任何类型的数据都可以看成一个对象,通过变量来指向它,对变量进行赋值就是让某一个变量指向某一个对象,建立他们两之间的关系。变量类似一个指针,指向某一个内存对象,python是动态语言,所以可以指向不同类型的对象,如str,int,float,list等等,java是静态语言一旦int a,那么a只能指向ini类型对象a='hello' , b=a ,意味着把a指向的对象的地址赋给b,或者说,让b指向a所指向的对象,这时候'hello'对象有两个指向自己的指针。如果此时a='world',那么print(b)还是等于'hello'====常量:约定俗成的使用全部大写变量名来表示常量,如PI对于除法/,python3中是不会取整的,python2是取整的对于地板除//,python3和2都是取整的使用%获取余数5、字符串编码问题====历史:在计算机历史上,计算机被设计成拥有处理数字的功能,计算机底层1个字节定义成8个位,1个字节可以表示的数字最大是255,如果需要表示更大的数字,就需要更多的字节,2个字节可以表示最大65535,4个字节可以表示42亿左右。根据计算机的原本设计是只能处理数字,如果要处理文本,即处理字符串,则需要把字符串与数字进行映射,即通过编码的方式记录每一个字符对应的数字。计算机是美国人发明的,所以当时只需要处理英文字符串,所有英文字符,包括字母大小写、数字、符号等等加在一起一共形成了127个字符,这127个字符通过1个字节就可以完全表示。通过1个字节对应的1个整数,映射到不同的字符,这种编码方式就是ASCII编码方式。随着计算机的发展,不同国家都在使用,都想通过计算机输入本国的语言,如中文,对于中文而言,中文的字符至少需要2个字节即至少需要65535个数字才能表示,所以中国为中文定制了GB2312编码方式,用于将中文编码到计算机的底层整数。同样的,不同国家有不同的编码方式,这就导致:同样的1个编码整数可能会在不同国家有不同的表示,而且,如果多个国家的程序放在一起,计算机就无法识别某一个字符串是属于英文还是中文还是其他国家的字符。为了解决不同国家定制不同的编码标准,出现了unicode统一字符编码标准,unicode标准常常使用2个字节表示1个字符,将世界上所有的语言都包含到这个编码标准中,这样不论计算机在哪里使用,不论计算机使用的是哪种语言,都不会出现混乱和冲突的问题。对于一些生僻的字符,unicode可能需要使用4-6个字符来表示。而如果单纯只使用unicode编码的时候,会出现空间浪费的问题,如果程序全部使用英文编写,所有英文字符默认2个unicode字节对应1个英文字符。所以使用unicode虽然可以很好的解决不同语言之间互通的问题,但是会带来空间浪费和效率不高的问题。这时候就需要使用UTF-8可变长编码方式,使用UTF-8的时候,如果是中文就是2个字节对应1个中文字符,如果是英文就是1个字节对应1个英文字符,即UTF-8的字节使用数量是根据实际使用的语言来灵活变化的,这种好处尤其体现在数据的保存、压缩、传输上。所以现在的计算机保存的数据都是UTF-8编码方式,一旦被程序调用的时候,文件中的数据则转换成unicode编码方式在内存中被处理,在处理完毕再次保存之前又被转换成高效的UTF-8编码方式。我们从网站上获取网页的时候,网页html是以源代码的形式传回给我们的浏览器,源代码中经常有:<meta charset="utf-8" /> 表示该网页使用UTF-8编码的方式来传输数据。====python字符串的编码:python3版本中,所有的字符串str类型对象都是使用unicode编码方式,即python中的所有字符串,都有对应的unicode整数,如:unicode是针对每一个字符做编码的,可以通过ord()函数对任意一个字符求出对应的unicode整数,也可以通过chr()输入unicode整数来得到对应的unicode字符当然,也可以这样写:'\uxxxx'其中要放入unicode整数的十六进制数,如,25991的十六进制数是0x6587:====编码转换:python在内存中的数据都是unicode编码,都是str类型的对象。而数据在保存或者网络传输的时候,必须转换成byte类型的字节流的形式,把unicode转换成byte类型需要依据不同的内容做不同的编码,所有byte类型的对象都是b开头,如:'abc'是str类型的对象,是unicode编码,是英文,所以转换成可传输的字节流就是'abc'.encode('ascii')---->b'abc',此时ascii编码中,1个字节对应1个英文字符'中文'是str类型的对象,是unicode编码,是中文,所以转换成可传输的字节流就是'中文'.encode('utf-8')---->b'\xe4\xb8\xad\xe6\x96\x87',此时utf-8编码中,使用3个字节表示1个中文字符------------------------------------------------------------------------------------------------------'中文'.encode('gb2312')---->b'\xd6\xd0\xce\xc4' ,此时gb2312编码中,使用2个字符表示1个中文字符总结:在计算机内存中,在python3中,所有str对象都是unicode编码,这是为了使不同国家语言可以互通,unicode编码一般是2个字节编码1个字符。而在传输、保存数据的时候,需要把unicode编码的字符转换成其他的编码方式,英文可以转换成ascii或者utf-8,中文可以转换成gb2312或者utf-8,变成可传输的字节流。使用不同的编码方式,1个字符使用的字节数量不同。一般情况下,我们都使用unicode和utf-8这两种,因为中文和英文都可以使用utf-8方式编码。即:str对象.encode('utf-8')可以变成字节流byte类型对象以b开头, byte对象.decode('utf-8')可以变成unicode字符的str类型对象用于计算机和程序的处理,所以在hello.py文件的开头都有:#coding:utf-8就是告诉python解释器:使用utf-8编码方式来decode到unicode来处理,然后将unicode的数据encode到utf-8来保存和传输====python的格式化字符串:last=72today=85rate=(today-last)/lastprint('小明的成绩从去年的%d分提升到了今年的%d分,增长百分比是:%.1f%%' %(last,today,rate))6、list和tuple====list的性质:list是python的内置数据类型,翻译成列表或者数组。list是一组数据或者一组对象或者一组元素的序列,同样的元素不同的排列是不同的列表。列表的元素数量可以通过len(a)来获得,list是可变长数组,可以随时通过append在末尾增加元素,通过pop(i)弹出位置i的元素默认是末尾,通过insert(i,xx)在位置i插入xx元素。除此之外,list还是混合类型数组,即数组内部可以允许不同类型的元素,如:a=[1,True,'abc',2.2],此时的a是一个指向一个list地址的变量(性质上是指针)。list通过下标0~len-1的范围来获取每一个元素。list可以通过-1,-2来从尾部开始获取元素,-1表示倒数第1个元素,-2表示倒数第2个元素,以此类推。list中可以放任何类型的对象,除了python内置的整数、浮点数、布尔值、字符串等,还可以是list,tuple,dict,其他自定义数据类型等等。如果list中还有一个list,则意味着内部的list是一个二维数组,如果内部list的一个对象还是一个list,则最内部list是三维数组,以此类推,通过a[1][2]来获取二维数组的元素。====tuple的性质:tuple的性质和list很相似,最大的不同在于tuple更严格、更安全、数据只能取不能增删改,即tuple一旦初始化后则无法改变内容,而list可以随时增删改元素。====注意:二义性的tuple符号:list在创建的时候使用[],tuple在创建的时候使用(),如果是创建一个空list则是a=[],如果是创建空tuple则是a=(),如果创建一个只含有1个元素的tuple,不应该写成a=(1)这会被python解释成a=1,a是一个int类型的对象因为python遇到()的时候有二义性,到底是tuple还是普通的小括号,python规定当做小括号使用,所以声明一个只有1个元素的tuple应该是:a=(1,)注意不要缺少这个逗号。====注意:“可变的”tupletuple的不可修改指的是每一个tuple中的元素所指向的对象都不发生地址变化,但是所指向的对象的内容却可以改变,如:a=('a','b',['A','B'])a[2][0]='X'a[2][1]='Y'print(a) -- > ('a','b',['X','Y'])这种修改是合法的,因为对于tuple a而言,a[2]这个元素地址并没有发生改变,即并没有指向其他的list,而这个未改变地址的list的内容发生改变并不影响tuple的规定。7、条件判断if,elif,else判断语句,用于分支判断,if可以理解成判断后面的语句是否为真,如果是真则执行if语句块,如果不为真就一定为假,则执行else语句块,使用elif可以增加多个判断条件。连用多个if和elif的判断逻辑类似于ACL访问控制列表,判断顺序也是自上而下,一条没有满足即顺延到下一条判断条件,一旦某一条判断条件是真,则不再进行后续判断,如果所有if和elif都判断为假,则用最后的else作为permit any含义。注意条件判断后面不要遗漏:冒号,条件判断还可以简写成if x: 这个x只要是非零整数、非空列表、非空tuple、非空字符串等等,都认为是True,否则认为是False。input()函数用于获取用户输入,无论用户输入的是数字、字符、还是字符串等等,都被input函数以str的类型返回。可以通过eval()函数获取一个字符串的值,如:'2'就是2,'a'会得到变量a8、循环python中的循环有两类====for循环:for循环用于遍历一个序列,将序列中的每一个元素赋值给自定义的变量以便操作序列中的所有元素值,如:注意:一般会使用list(range(10))来构造一个10个元素的列表,因为从0开始所以是0~9的10个元素。for循环的循环执行依赖于明确的范围遍历(无法依赖条件判断)====while循环:while循环的执行依赖于while关键字后面的条件判断,当为真的时候执行循环体,执行完毕后再次条件判断,为假的时候跳出循环,所以循环体内部需要有一定的限制条件或者手段来保证有限次的循环后可以跳出,即while循环的执行依赖于条件判断+循环体内部限制条件注意:跳出while循环的时候,一定是第一次不满足循环条件判断的时候====break:在循环体内部使用break可以跳出当前一层循环,用于特殊、有需要的程序执行分支流程====continue:在循环体内部使用continue可以省略剩余的循环体语句并立即开始下一次循环,如果是for就中断并提前遍历下一个元素,如果是while就中断并提前执行下一次条件判断注意:大量的、不加规划的使用break和continue的确会导致程序的逻辑、执行流程混乱,加重代码的复杂度以及后期debug的工作量。另外,就像无限迭代会导致机器崩溃一样,无限循环也会导致机器崩溃,所以编写循环首要注意的就是是否可以在必要的时候跳出循环体,尤其是while循环体中是否有足够的限制条件和手段。9、dict和set就像list和tuple非常的类似,并且都是python的内置数据类型一样。dict和set也是python的内置数据类型,也一样非常类似。====dict:dict在python中称为字典,是一种key-value对,其实类似于哈希表,即一个输入(key),有着唯一的输出(value),中间通过hash算法来完成唯一的映射。dict使用{}来表示,里面填写每一个key-value对使用逗号分隔。dict中的key就是哈希表中的输入或者关键字,dict使用哈希算法将key映射成唯一的内存地址,该内存地址上可以保存其他对象即value,所以key被要求不可变(即一旦初始化即不可再改变),如整数、字符串、元祖tuple等等,而value的值却是可变的,但若value变化多次则会以最后一次的值为准。在dict中,key是没有排序的,即无法使用dict[0]这种类似list和tuple的方式来获取第1个元素,dict只能使用d[key名称]的形式来获取这个key所对应的value。dict使用d[key名称]=value的方式来为一个dict新增键值对,也可以使用del d[key]的方式删除一个键值对,或者是d.pop(key)的方式弹出一个键值对,dict使用d[key名称]的方式来访问这个key对应的value,如果没有该key则会报错,所以访问方式还可以是:key in d 使用布尔判断是否含有此key,或者是d.get(key,-1)获取d的key的value,如果没有key则返回-1,默认返回None无法在python解释器中显示结果。遇到任何有联系的两个对象,都可以使其一成为key,另一个成为value放入dict中,在dict中的查找速度是非常快的基本等于O(1)。====set:set在python中称为集合,更确切的说,就是一些不重复的对象的集合,之所以不说是序列,是因为set是无序的,即无法使用s[0]这种序列访问方式来访问,就像dict一样,也是无序的。同时,set的构造使用{}来表示,和dict一样,但是set的对象并不是dict那样的键值对,事实上,set的对象只有key而没有value。可以使用s=set(某个序列)函数来构造一个集合,输入需要是一个序列,可以是list、tuple、range(10)等。set最重要的特性是:1、set中对象无重复2、set作为集合,可用于数学上的集合运算,如交集&,并集|交集:取s1和s2中共有的部分作为结果,即交集是s1的子集,也是s2的子集并集:将s1和s2所有元素整合并消除重复,即s1是并集的子集,s2页是并集的子集3、set可以增加或者减少对象,s.add(100), s.remove(2)如果新增多个重复的对象,set会自动过滤====注意:关于不可变对象:首先,对象不可变指的是某个对象一旦被构造并被初始化值之后,就不能再改变这个对象的地址以及这个对象的值,如:整数、字符串、tuple、dict的key等等。其次,不可变对象的一些函数如果涉及到需要改变对象的值,则一般会复制一份同值的对象并返回,而原来的不可变对象还是没有改变值,以此来保证对象的不可变性。对于可变对象,对象的函数如果涉及改变对象的值,则直接在原有对象上进行改变。如:因为str1不可变,所以replace涉及修改值的时候返回了另一个对象因为list1可变,所以直接在list1对象上直接修改值,并不返回另一个对象

优秀的个人博客,低调大师

日期型数据知识

日期型数据,在 C# 中的参与运算的时候,应该也是转换为长整型数据来运算的。它 的长整型值是自 0001 年 1 月 1 日午夜 12:00 以来所经过时间以 100 毫微秒为间隔表示时 的数字。这个数在 C# 的 DateTime 中被称为 Ticks(刻度)。DateTime 类型有一个名为 Ticks 的长整型只读属性,就保存着这个值。如此,要从一个 DataTime 型数据得到 long 型值就非常简单了,只需要读出 DataTime 对象的 Ticks 值即可,如: long longDate = DateTime.Now.Ticks; DateTime 的构造函数中也提供了相应的,从长整型数据构造 DateTime 型数据的函 数:DateTime(long)。如: DateTime theDate = new DateTime(longDate); 格式化日期型数据 编程的过程中,通常需要将日期型数据按照一定的格式输出,当然,输出结果肯定是 字符串。为此,我们需要使用 System.DateTime 类的 ToString() 方法,并为其指定格式字 符串。 MSDN 中,System.Globalization.DateTimeFormatInfo 类的概述里对模式字符串有非 常详细的说明,因此,这里我只对常用的一些格式进行说明,首先请看下表: d 月中的某一天一位数的日期没有前导零 dd 月中的某一天一位数的日期有一个前导零 ddd 周中某天的缩写名称在 AbbreviatedDayNames 中定义 dddd 周中某天的完整名称在 DayNames 中定义 M 月份数字一位数的月份没有前导零 MM 月份数字一位数的月份有一个前导零 MMM 月份的缩写名称在 AbbreviatedMonthNames 中定义 MMMM 月份的完整名称在 MonthNames 中定义 y 不包含纪元的年份如果不包含纪元的年份小于 10,则显示不具有前导零的年份 yy 不包含纪元的年份如果不包含纪元的年份小于 10,则显示具有前导零的年份 yyyy 包括纪元的四位数的年份 h 12 小时制的小时一位数的小时数没有前导零 hh 12 小时制的小时一位数的小时数有前导零 H 24 小时制的小时一位数的小时数没有前导零 HH 24 小时制的小时一位数的小时数有前导零 m 分钟一位数的分钟数没有前导零 mm 分钟一位数的分钟数有一个前导零 s 秒一位数的秒数没有前导零 ss 秒一位数的秒数有一个前导零 为了便于大家的理解,不妨试试下面的程序: private void TestDateTimeToString() { DateTime now = DateTime.Now; string format; this.textBox1.Text = ""; format = "yyyy-MM-dd HH:mm:ss"; this.textBox1.AppendText(format + ": " +now.ToString(format) + "\n"); format = "yy 年M 日d 日"; this.textBox1.AppendText(format + ": " + now.ToString(format) +"\n"); } 这段程序将输出结果: yyyy-MM-dd HH:mm:ss: 2002-08-26 17:03:04 yy 年M 日d 日: 02 年8 日26 日 这时候,又出现一个问题,如果要输出的文本信息中包含格式字符怎么办?如 format = "year: yyyy, month: MM, day: dd"; this.textBox1.AppendText(now.ToString(format) + "\n"); 将输出: 2ear: 2002, 4on 下5: 08, 26a2: 26 这并不是我想要的结果,怎么办呢?有办法—— format = "\"year\": yyyy, \'month\': MM, \'day\': dd"; this.textBox1.AppendText(now.ToString(format) + "\n"); 看,这次运行结果对了: year: 2002, month: 08, day: 26 可以看出,只需要使用单引号或者双引号将文本信息括起来就好。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/archive/2010/06/21/1761695.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android基础:SlidingDrawer知识

SlidingDrawer抽屉,主要有handler和content组成,handler一般是图片,cotent随意,基本的方法主要有 open()、animateOpen()、close()、animateClose()、SlidingDrawer.setOnDrawerOpenListener()、SlidingDrawer.setOnDrawerCloseListener() lock()、unlock(), 系统自带的抽屉可以从下往上、或者从右往左拉开,通过orientation来设置,如果要使SlidingDrawer按指定高度拉开,应该放到Relativelayout中,同时设置alignParentBotom为true. <?xml version= "1.0" encoding= "utf-8" ?> <RelativeLayout xmlns:android= "http://schemas.android.com/apk/res/android" android:layout_width= "match_parent" android:layout_height= "match_parent" android:orientation= "vertical" > <SlidingDrawer android:id= "@+id/slidingdrawer" android:layout_width= "fill_parent" android:layout_height= "400px" android:content= "@+id/content" android:handle= "@+id/handler" android:orientation= "horizontal" android:layout_alignParentBottom= "true" > <ImageView android:id= "@id/handler" android:layout_width= "wrap_content" android:layout_height= "wrap_content" android:src= "@drawable/handler" /> <TextView android:id= "@+id/content" android:layout_width= "fill_parent" android:layout_height= "fill_parent" android:text= "测试。。。。。。。。" android:textSize= "18px" android:gravity= "center_vertical" android:background= "#ff00ff00" /> </SlidingDrawer> </RelativeLayout> handler = (ImageView) findViewById(R.id.handler); content = (TextView) findViewById(R.id.content); slidingdrawer = (SlidingDrawer) findViewById(R.id.slidingdrawer); slidingdrawer.open(); slidingdrawer.setOnDrawerOpenListener( new OnDrawerOpenListener() { @Override public void onDrawerOpened() { handler.setImageDrawable(MainActivity. this .getResources().getDrawable(R.drawable.p)); ScaleAnimation anim = new ScaleAnimation( 0 .0f, 1 .0f, 0 .0f, 1 .0f); anim.setDuration( 1000 ); // slidingdrawer.setAnimation(anim); // slidingdrawer.startAnimation(anim); } }); slidingdrawer.setOnDrawerCloseListener( new OnDrawerCloseListener() { @Override public void onDrawerClosed() { handler.setImageDrawable(MainActivity. this .getResources().getDrawable(R.drawable.handler)); /**锁定slidingdrawer.lock();**/ // slidingdrawer.lock(); } }); 本文转自demoblog博客园博客,原文链接http://www.cnblogs.com/0616--ataozhijia/archive/2012/11/01/2750165.html如需转载请自行联系原作者 demoblog

优秀的个人博客,低调大师

Android系统小知识

1.添加振动 http://blog.csdn.net/caesardadi/article/details/8251933 2.excel操作 jxl.jar jxcell.jar Appache的poi库 3.保证屏幕黑屏之后CPU继续运作 http://blog.csdn.net/jhope/article/details/53737402 4.文件新建之后,在电脑上看不见。 http://blog.csdn.net/lmw21848/article/details/52297346 5.java文件加解密 http://zhangzhaoaaa.iteye.com/blog/2124700 6.AlarmManager定点提醒 http://blog.csdn.net/fxdaniel/article/details/41150129 几个设置参数的意义 http://blog.csdn.net/wangjia55/article/details/21518931 7. 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/2048586,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android JNI知识简介

Java Native Interface (JNI)标准是java平台的一部分,它允许Java代码和其他语言写的代码进行交互。JNI 是本地编程接口,它使得在 Java 虚拟机 (VM) 内部运行的 Java 代码能够与用其它编程语言(如 C、C++ 和汇编语言)编写的应用程序和库进行交互操作。 1.从如何载入.so档案谈起 由于Android的应用层的类都是以Java写的,这些Java类编译为Dex型式的Bytecode之后,必须靠Dalvik虚拟机(VM: Virtual Machine)来执行。VM在Android平台里,扮演很重要的角色。 此外,在执行Java类的过程中,如果Java类需要与C组件沟通时,VM就会去载入C组件,然后让Java的函数顺利地调用到C组件的函数。此时,VM扮演着桥梁的角色,让Java与C组件能通过标准的JNI介面而相互沟通。 应用层的Java类是在虚拟机(VM: Vitual Machine)上执行的,而C件不是在VM上执行,那么Java程式又如何要求VM去载入(Load)所指定的C组件呢? 可使用下述指令: System.loadLibrary(*.so的档案名); 例如,Android框架里所提供的MediaPlayer.java类,含指令: public classMediaPlayer {static{System.loadLibrary("media_jni");}} 这要求VM去载入Android的/system/lib/libmedia_jni.so档案。载入*.so之后,Java类与*.so档案就汇合起来,一起执行了。 2.如何撰写*.so的入口函数 ---- JNI_OnLoad()与JNI_OnUnload()函数的用途 当Android的VM(Virtual Machine)执行到System.loadLibrary()函数时,首先会去执行C组件里的JNI_OnLoad()函数。它的用途有二: (1)告诉VM此C组件使用那一个JNI版本。如果你的*.so档没有提供JNI_OnLoad()函数,VM会默认该*.so档是使用最老的JNI 1.1版本。由于新版的JNI做了许多扩充,如果需要使用JNI的新版功能,例如JNI 1.4的java.nio.ByteBuffer,就必须藉由JNI_OnLoad()函数来告知VM。 (2)由于VM执行到System.loadLibrary()函数时,就会立即先呼叫JNI_OnLoad(),所以C组件的开发者可以藉由JNI_OnLoad()来进行C组件内的初期值之设定(Initialization) 。 例如,在Android的/system/lib/libmedia_jni.so档案里,就提供了JNI_OnLoad()函数,其程式码片段为: // #defineLOG_NDEBUG0 #defineLOG_TAG"MediaPlayer-JNI" jintJNI_OnLoad(JavaVM*vm, void*reserved) {JNIEnv*env=NULL;jintresult=-1;if(vm->GetEnv((void**)&env,JNI_VERSION_1_4)!=JNI_OK){LOGE("ERROR:GetEnvfailed/n");gotobail;}assert(env!=NULL);if(register_android_media_MediaPlayer(env)<0){LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaRecorder(env)<0){LOGE("ERROR:MediaRecordernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaScanner(env)<0){LOGE("ERROR:MediaScannernativeregistrationfailed/n");gotobail;}if(register_android_media_MediaMetadataRetriever(env)<0){LOGE("ERROR:MediaMetadataRetrievernativeregistrationfailed/n");gotobail;}/*success--returnvalidversionnumber*/result=JNI_VERSION_1_4;bail:returnresult;} 此函数回传JNI_VERSION_1_4值给VM,于是VM知道了其所使用的JNI版本了。此外,它也做了一些初期的动作(可呼叫任何本地函数),例如指令: if(register_android_media_MediaPlayer(env)<0) {LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;} 就将此组件提供的各个本地函数(Native Function)登记到VM里,以便能加快后续呼叫本地函数的效率。 JNI_OnUnload()函数与JNI_OnLoad()相对应的。在载入C组件时会立即呼叫JNI_OnLoad()来进行组件内的初期动作;而当VM释放该C组件时,则会呼叫JNI_OnUnload()函数来进行善后清除动作。当VM呼叫JNI_OnLoad()或JNI_Unload()函数时,都会将VM的指针(Pointer)传递给它们,其参数如下: jintJNI_OnLoad(JavaVM*vm, void*reserved) {} jintJNI_OnUnload(JavaVM*vm, void*reserved) {} 在JNI_OnLoad()函数里,就透过VM之指标而取得JNIEnv之指标值,并存入env指标变数里,如下述指令: jintJNI_OnLoad(JavaVM*vm, void*reserved) {JNIEnv*env=NULL;jintresult=-1;if(vm->GetEnv((void**)&env,JNI_VERSION_1_4)!=JNI_OK){LOGE("ERROR:GetEnvfailed/n");gotobail;}} 由于VM通常是多执行绪(Multi-threading)的执行环境。每一个执行绪在呼叫JNI_OnLoad()时,所传递进来的JNIEnv指标值都是不同的。为了配合这种多执行绪的环境,C组件开发者在撰写本地函数时,可藉由JNIEnv指标值之不同而避免执行绪的资料冲突问题,才能确保所写的本地函数能安全地在Android的多执行绪VM里安全地执行。基于这个理由,当在呼叫C组件的函数时,都会将JNIEnv指标值传递给它,如下: 这JNI_OnLoad()呼叫register_android_media_MediaPlayer(env)函数时,就将env指标值传递过去。如此,在register_android_media_MediaPlayer()函数就能藉由该指标值而区别不同的执行绪,以便化解资料冲突的问题。 例如,在register_android_media_MediaPlayer()函数里,可撰写下述指令: if((*env)->MonitorEnter(env,obj)!=JNI_OK) {} 查看是否已经有其他执行绪进入此物件,如果没有,此执行绪就进入该物件里执行了。还有,也可撰写下述指令: if((*env)->MonitorExit(env,obj)!=JNI_OK) {} 查看是否此执行绪正在此物件内执行,如果是,此执行绪就会立即离开。 3.registerNativeMethods()函数的用途 应用层级的Java类别透过VM而呼叫到本地函数。一般是仰赖VM去寻找*.so里的本地函数。如果需要连续呼叫很多次,每次都需要寻找一遍,会多花许多时间。此时,组件开发者可以自行将本地函数向VM进行登记。例如,在Android的/system/lib/libmedia_jni.so档案里的代码段如下: // #defineLOG_NDEBUG0 #defineLOG_TAG"MediaPlayer-JNI" staticJNINativeMethodgMethods[]= {{"setDataSource","(Ljava/lang/String;)V",(void*)android_media_MediaPlayer_setDataSource},{"setDataSource","(Ljava/io/FileDescriptor;JJ)V",(void*)android_media_MediaPlayer_setDataSourceFD},{"prepare","()V",(void*)android_media_MediaPlayer_prepare},{"prepareAsync","()V",(void*)android_media_MediaPlayer_prepareAsync},{"_start","()V",(void*)android_media_MediaPlayer_start},{"_stop","()V",(void*)android_media_MediaPlayer_stop},{"getVideoWidth","()I",(void*)android_media_MediaPlayer_getVideoWidth},{"getVideoHeight","()I",(void*)android_media_MediaPlayer_getVideoHeight},{"seekTo","(I)V",(void*)android_media_MediaPlayer_seekTo},{"_pause","()V",(void*)android_media_MediaPlayer_pause},{"isPlaying","()Z",(void*)android_media_MediaPlayer_isPlaying},{"getCurrentPosition","()I",(void*)android_media_MediaPlayer_getCurrentPosition},{"getDuration","()I",(void*)android_media_MediaPlayer_getDuration},{"_release","()V",(void*)android_media_MediaPlayer_release},{"_reset","()V",(void*)android_media_MediaPlayer_reset},{"setAudioStreamType","(I)V",(void*)android_media_MediaPlayer_setAudioStreamType},{"setLooping","(Z)V",(void*)android_media_MediaPlayer_setLooping},{"setVolume","(FF)V",(void*)android_media_MediaPlayer_setVolume},{"getFrameAt","(I)Landroid/graphics/Bitmap;",(void*)android_media_MediaPlayer_getFrameAt},{"native_setup","(Ljava/lang/Object;)V",(void*)android_media_MediaPlayer_native_setup},{"native_finalize","()V",(void*)android_media_MediaPlayer_native_finalize},}; static intregister_android_media_MediaPlayer(JNIEnv*env) {returnAndroidRuntime::registerNativeMethods(env,"android/media/MediaPlayer",gMethods,NELEM(gMethods));} jintJNI_OnLoad(JavaVM*vm, void*reserved) {if(register_android_media_MediaPlayer(env)<0){LOGE("ERROR:MediaPlayernativeregistrationfailed/n");gotobail;}} 当VM载入libmedia_jni.so档案时,就呼叫JNI_OnLoad()函数。接着,JNI_OnLoad()呼叫register_android_media_MediaPlayer()函数。此时,就呼叫到AndroidRuntime::registerNativeMethods()函数,向VM(即AndroidRuntime)登记gMethods[]表格所含的本地函数了。简而言之,registerNativeMethods()函数的用途有二: (1)更有效率去找到函数。 (2)可在执行期间进行抽换。由于gMethods[]是一个<名称,函数指针>对照表,在程序执行时,可多次呼叫registerNativeMethods()函数来更换本地函数之指针,而达到弹性抽换本地函数之目的。 4.Andoird 中使用了一种不同传统Java JNI的方式来定义其native的函数。其中很重要的区别是Andorid使用了一种Java 和 C 函数的映射表数组,并在其中描述了函数的参数和返回值。这个数组的类型是JNINativeMethod,定义如下: typedefstruct {constchar*name;/*Java中函数的名字*/constchar*signature;/*描述了函数的参数和返回值*/void*fnPtr;/*函数指针,指向C函数*/}JNINativeMethod; 其中比较难以理解的是第二个参数,例如 "()V" "(II)V" "(Ljava/lang/String;Ljava/lang/String;)V" 实际上这些字符是与函数的参数类型一一对应的。 "()" 中的字符表示参数,后面的则代表返回值。例如"()V" 就表示void Func(); "(II)V" 表示 void Func(int, int); 具体的每一个字符的对应关系如下 字符 Java类型 C类型 V void void Z jboolean boolean I jint int J jlong long D jdouble double F jfloat float B jbyte byte C jchar char S jshort short 数组则以"["开始,用两个字符表示 [I jintArray int[] [F jfloatArray float[] [B jbyteArray byte[] [C jcharArray char[] [S jshortArray short[] [D jdoubleArray double[] [J jlongArray long[] [Z jbooleanArray boolean[] 上面的都是基本类型。如果Java函数的参数是class,则以"L"开头,以";"结尾,中间是用"/" 隔开的包及类名。而其对应的C函数名的参数则为jobject. 一个例外是String类,其对应的类为jstring Ljava/lang/String; String jstring Ljava/net/Socket; Socket jobject 如果JAVA函数位于一个嵌入类,则用$作为类名间的分隔符。 例如 "(Ljava/lang/String;Landroid/os/FileUtils$FileStatus;)Z" Android JNI编程实践 一、直接使用java本身jni接口(windows/ubuntu) 1.在Eclipsh中新建一个android应用程序。两个类:一个继承于Activity,UI显示用。另一个包含native方法。编译生成所有类。 jnitest.java文件: packagecom.hello.jnitest; importandroid.app.Activity; importandroid.os.Bundle; public classjnitest extendsActivity {/**Calledwhentheactivityisfirstcreated.*/@OverridepublicvoidonCreate(BundlesavedInstanceState){super.onCreate(savedInstanceState);setContentView(R.layout.main);Naddcal=newNadd();setTitle("TheNativeAddResultis"+String.valueOf(cal.nadd(10,19)));}} Nadd.java文件: packagecom.hello.jnitest; public classNadd {static{System.loadLibrary("Nadd");}publicnativeintnadd(inta,intb);} 以上在windows中完成。 2.使用javah命令生成C/C++的.h文件。注意类要包含包名,路径文件夹下要包含所有包中的类,否则会报找不到类的错误。classpath参数指定到包名前一级文件夹,文件夹层次结构要符合java类的组织层次结构。 javah -classpath ../jnitest/bin com.hello.jnitest.Nadd com_hello_jnitest_Nadd .h文件: /*DONOTEDITTHISFILE-itismachinegenerated*/ #include<jni.h> /*Headerforclasscom_hello_jnitest_Nadd*/ #ifndef_Included_com_hello_jnitest_Nadd #define_Included_com_hello_jnitest_Nadd #ifdef__cplusplus extern"C" {#endif/**Class:com_hello_jnitest_Nadd*Method:nadd*Signature:(II)I*/JNIEXPORTjintJNICALLJava_com_hello_jnitest_Nadd_nadd(JNIEnv*,jobject,jint,jint);#ifdef__cplusplus} #endif #endif 3.编辑.c文件实现native方法。 com_hello_jnitest_Nadd.c文件: #include<stdlib.h> #include"com_hello_jnitest_Nadd.h" JNIEXPORTjintJNICALLJava_com_hello_jnitest_Nadd_nadd(JNIEnv*env,jobjectc,jinta,jintb) {return(a+b);} 4.编译.c文件生存动态库。 arm-none-linux-gnueabi-gcc -I/home/a/work/android/jdk1.6.0_17/include -I/home/a/work/android/jdk1.6.0_17/include/linux -fpic -c com_hello_jnitest_Nadd.c arm-none-linux-gnueabi-ld -T/home/a/CodeSourcery/Sourcery_G++_Lite/arm-none-linux-gnueabi/lib/ldscripts/armelf_linux_eabi.xsc -share -o libNadd.so com_hello_jnitest_Nadd.o 得到libNadd.so文件。 以上在ubuntu中完成。 5.将相应的动态库文件push到avd的system/lib中:adb push libNadd.so /system/lib。若提示Read-only file system错误,运行adb remount命令,即可。 Adb push libNadd.so /system/lib 6.在eclipsh中运行原应用程序即可。 以上在windows中完成。 对于一中生成的so文件也可采用二中的方法编译进apk包中。只需在工程文件夹中建libs/armeabi文件夹(其他文件夹名无效,只建立libs文件夹也无效),然后将so文件拷入,编译工程即可。 二.使用NDK生成本地方法(ubuntu and windows) 1.安装NDK:解压,然后进入NDK解压后的目录,运行build/host-setup.sh(需要Make 3.81和awk)。若有错,修改host-setup.sh文件:将#!/bin/sh修改为#!/bin/bash,再次运行即可。 2.在apps文件夹下建立自己的工程文件夹,然后在该文件夹下建一文件Application.mk和项project文件夹。 Application.mk文件: APP_PROJECT_PATH:=$(callmy-dir)/project APP_MODULES:=myjni 3.在project文件夹下建一jni文件夹,然后新建Android.mk和myjni.c。这里不需要用javah生成相应的.h文件,但函数名要包含相应的完整的包、类名。 4.编辑相应文件内容。 Android.mk文件: #Copyright(C)2009TheAndroidOpenSourceProject # #LicensedundertheApacheLicense,Version2.0(the"License"); #youmaynotuse thisfileexcept incompliancewiththeLicense. #YoumayobtainacopyoftheLicenseat # #http: // www.apache.org/licenses/LICENSE-2.0 # #Unlessrequiredbyapplicablelaworagreedto inwriting,software #distributedundertheLicense isdistributedonan"ASIS"BASIS, #WITHOUTWARRANTIESORCONDITIONSOFANYKIND,eitherexpressorimplied. #SeetheLicense forthespecificlanguagegoverningpermissionsand #limitationsundertheLicense. # LOCAL_PATH:=$(callmy-dir) include$(CLEAR_VARS) LOCAL_MODULE:=myjni LOCAL_SRC_FILES:=myjni.c include$(BUILD_SHARED_LIBRARY) myjni.c文件: #include< string.h> #include<jni.h> jstring Java_com_hello_NdkTest_NdkTest_stringFromJNI(JNIEnv*env, jobjectthiz) {return(*env)->NewStringUTF(env,"HellofromMy-JNI!");} myjni文件组织: a@ubuntu:~/work/android/ndk-1.6_r1/apps$ tree myjni myjni |-- Application.mk `-- project |-- jni | |-- Android.mk | `-- myjni.c `-- libs `-- armeabi `-- libmyjni.so 4 directories, 4 files 5.编译:make APP=myjni. 以上内容在ubuntu完成。以下内容在windows中完成。当然也可以在ubuntu中完成。 6.在eclipsh中创建android application。将myjni中自动生成的libs文件夹拷贝到当前工程文件夹中,编译运行即可。 NdkTest.java文件: packagecom.hello.NdkTest; importandroid.app.Activity; importandroid.os.Bundle; importandroid.widget.TextView; public classNdkTest extendsActivity {/**Calledwhentheactivityisfirstcreated.*/@OverridepublicvoidonCreate(BundlesavedInstanceState){super.onCreate(savedInstanceState);TextViewtv=newTextView(this);tv.setText(stringFromJNI());setContentView(tv);}publicnativeStringstringFromJNI();static{System.loadLibrary("myjni");}} 对于二中生成的so文件也可采用一中的方法push到avd中运行。

优秀的个人博客,低调大师

Appium知识技巧收集

1、真机调试打开USB调试模式 2、启动脚本提示apk包Could not make a string,是释放string.json出错,由于apk损坏导致,验证是安装到真机上开启APP 3、Activity要写对,否则提示不存在Activity,建议写完整名称,完整包名类似com.xxx.xxx.Activity;启动Activity要写对,否则提示XXX never XXX。包名参数与Activity参数可以在AndroidManifest.xml(获取方法http://code.google.com/p/android-apktool/)中查看,包名: android:name="com.xxx.xxx.SplashActivity" android:launchMode="singleTop" android:screenOrientation="portrait" ,本例中是com.xxx.xxx.SplashActivity 4、Appium支持一个Webdriver元素定位方法的子集 find by "tag name" (i.e., 通过UI的控件类型) find by "name" (i.e., 通过元素的文本, 标签, 或者开发同学添加的id标示, 比如accessibilityIdentifier) find by "xpath" (i.e., 具有一定约束的路径抽象标示, 基于XPath方式) 5、Appium 在 Mac OS X 上安装使用文档,参考:http://testerhome.com/topics/166,Windows平台,参考:http://testerhome.com/topics/155,Linux平台,参考:http://testerhome.com/topics/160,Android平台,参考:http://testerhome.com/topics/153 6、iOS模拟器—>硬件—>设备—>iPhone 7、【坑】Appium在MacOS10.9以及iOS7上面的问题:启动appium脚本没有问题。安装好应用之后log中会报出500,同时instruments会显示simulator session timeout。 8、生成build/Test.appa的方法,进入到目录下面编译 xcodebuild -sdk iphonesimulator6.0 9、安装路径问题 全局路径,也就是带上参数 -g 的安装模式。这个命令会把模块安装在 $PREFIX/lib/node_modules 下,可通过命令 npm root -g 查看全局模块的安装目录。 package.json 里定义的bin会安装到 $PREFIX/bin 目录下,如果模块带有 man page 会安装到 $PREFIX/share/man 目录下。 本地路径,不带 -g 参数的。从当前目录一直查找到根目录/下有没有 node_modules 目录,有模块安装到这个目录下的 node_modules 目录里,如果没有找到则把模块安装到当前目录 node_modules 目录下。package.josn 定义的 bin 会安装到 node_modules/.bin 目录下,man page 则不会安装。 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

Android基础知识

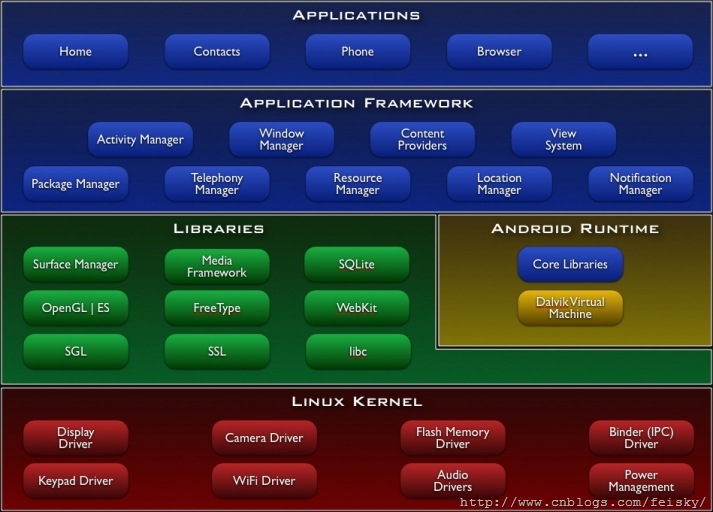
Android特性: Application frameworkenabling reuse and replacement of components Dalvik virtual machineoptimized for mobile devices Integrated browserbased on the open sourceWebKitengine Optimized graphicspowered by a custom 2D graphics library; 3D graphics based on the OpenGL ES 1.0 specification (hardware acceleration optional) SQLitefor structured data storage Media supportfor common audio, video, and still image formats (MPEG4, H.264, MP3, AAC, AMR, JPG, PNG, GIF) GSM Telephony(hardware dependent) Bluetooth, EDGE, 3G, and WiFi(hardware dependent) Camera, GPS, compass, and accelerometer(hardware dependent) Rich development environmentincluding a device emulator, tools for debugging, memory and performance profiling, and a plugin for the Eclipse IDE 框架: 应用程序部件: Activity Services Content Providers Broadcast receiver Manifest 文件 整个程序的功能清单,包括包的定义、版本声明,应用程序Activity、ICON、service、intent filter等的声明。 在Eclipse中可以通过Manifest Editor方便编辑(右键打开)。 <?xml version="1.0" encoding="utf-8"?> <manifest . . . > <application . . . > <activity android:name="com.example.project.FreneticActivity" android:icon="@drawable/small_pic.png" android:label="@string/freneticLabel" . . . > </activity> . . . </application> </manifest> Activities and Tasks 一个task就是用户感觉上的"应用程序",task 是一组相互关联的activity集合组成的栈(这些activity可能属于多个应用程序). 栈底就是应用程序启动时显示的第一个activity。栈顶activity就是用户在屏幕上看到的activity。当一个activity启动一个新的activity时,新的activity就会被压入栈中。当用户点击"back " 按钮时,位于栈顶的activity将会被弹出栈。我们举个例子,假设task中有两个activity,分别是 A 和 B,其中A是位于栈顶的activity,用户点击"back"后, A就被弹出栈, B 就成为了新的栈顶activity,然后 activity B 会显示在屏幕上。 通常来讲,task栈中的activity不会被改变排列顺序,只有出栈和入栈操作。 A task is a stack of activities, not a class or an element in the manifest file. So there's no way to set values for a task independently of its activities. Values for the task as a whole are set in the root activity. For example, the next section will talk about the "affinity of a task"; that value is read from the affinity set for the task's root activity. 一个task中的所有activity是作为一个整体来移动的--移到前台后者后台。就个例子,假设当前 task 栈中有ABCD4个activity,A是栈顶activity,也就是在屏幕上显示的activity,用户点击了"home"键,启动了一个新的应用程序,则 ABCD 4个activity都会被移动到后台。过了一会,用户又点击了"home"键,并重新选择了先前的程序,则 ABCD 都被移动到前台,A 仍然作为栈顶activity 被显示在屏幕上,然后用户点击了"back",A被弹出栈,B作为新的栈顶activity被显示在屏幕上。 前面所讲的都是task的默认行为,我们可以通过某些方法改变task 的默认行为。 不同的task里的activity是由affinity来区别的.默认情况下每个task里面的activities都有相同的affinity。但是可以通过<activity> 标签里taskAffinity属性来修改某个activity的affinity,此时需要设置FLAG_ACTIVITY_NEW_TASK标志,并且allowTaskReparenting 属性设置为true。关于这点的文档解释是:As described earlier, a new activity is, by default, launched into the task of the activity that calledstartActivity(). It's pushed onto the same stack as the caller. However, if the Intent object passed tostartActivity()contains theFLAG_ACTIVITY_NEW_TASKflag, the system looks for a different task to house the new activity. Often, as the name of the flag implies, it's a new task. However, it doesn't have to be. If there's already an existing task with the same affinity as the new activity, the activity is launched into that task. If not, it begins a new task. 注意:在使用FLAG_ACTIVITY_NEW_TASK属性(singleTask和singleInstance类似)时,无法回退到调用者。 activity在task中加载方式主要有四种: 1.standard(the default mode):一个intent发过来之后,都会产生一个新的activity来响应这个intent; 2.singleTop:保持stack顶端的那个activity.也就是说,如果一个intent是由stack顶端的activity处理的话,将不会新建一个新的activity来处理,而是由原来的那个activity处理; 3.singleTask:对于这个activity则会新建一个task.也就是说,对于这个activity,会分配一个新的affinity; 4.singleInstance:identical to "singleTask",并保证这个activity唯一. 既然对初始加载的过程有所规定,那么也就很自然地会有结束过程的一些方式: acitivity在退出的时候,必然会影响到task的stack,因此,android对acitivity的行为方式也做了规定. 1.alwaysRetainTaskState属性.保证stack不变.默认状态下,一个task长期不活动的话,会退化到root activity,也就是弹出stack,只保留底部的一个acitivity. 2.clearTaskOnLaunch属性.这个会在acitivity加载的时候清空task的stack. 3.finishOnTaskLaunch属性.某种程度上说这个属性保证了某项task是唯一的.因为当一个同类的task加载的时候,如果此属性为true,那么就会先退出之前的task,然后再加载这个task. 如果FLAG_ACTIVITY_CLEAR_TOP属性为真,则结束activity时,所有处于该activity堆栈之上的activity都会同时清除,FLAG_ACTIVITY_CLEAR_TOP is most often used in conjunction with FLAG_ACTIVITY_NEW_TASK. When used together, these flags are a way of locating an existing activity in another task and putting it in a position where it can respond to the intent. 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2009/12/30/1636377.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

函数知识点详解

目录 函数的定义 概念: 在函数中输入形参和实参: 函数的参数 规定: 不指定关键字: *args和 **kwargs : 用函数打印乘法表 函数中字典的应用 字典中get的用法: 函数中列表的用法 sort的用法 高阶函数: 1. map 2. filter: 过滤 3. reudce 函数的定义 概念: 定义函数是一个赋值的过程: def => define: 定义 def function_name(args-参数列表): statement1 return values => 有返回值时使用return,可以return多个值,return时,用","隔开 defprint_university(): print("北大") return1,2,3 test_reture=print_university()#以元组形式显示返回值 int_x,int_y,int_z=print_university() print(test_reture) print(int_x,int_y,int_z) 输出结果为: 在函数中输入形参和实参: 形参: 形式参数,定义在函数时的参数叫做形参 实参: 实际参数,实际传递的时候叫做实参 defprint_university(name):#name:形参 print(name) university="北大"#university:实参 print_university(university) print(type(print_university))#函数定义的数据类型为function function_test=print_university#可以将结果赋给另一个变量 print(type(function_test))#查看其数据类型仍未function function_test(university)#调用 输出结果为: 函数的参数 *args: 参数的复数 arguments:可以传递多个参数 规定: 关键字参数必须放在参数列表的末尾。即从第一个关键字开始,后边必须都是关键字参数 没指定关键字,传参根据顺序去找 deftest_arg(arg1,arg2=None):#arg1:位置参数arg2:关键字参数 print(arg1) print(arg2) test_arg("arg1") print(80*"*") test_arg("arg2") print(80*"*") test_arg("arg1","arg2") 输出结果为: 不指定关键字: deftest_function(arg1,arg2=None,arg3=None): print(arg1,arg2,arg3) test_function(arg1=1)#默认按顺序打印关键字参数 其输出结果为: *args和 **kwargs : *args: 将传入的参数打包成一个元组,在不确定传入参数的个数时使用 ** kwargs: keyword args, 是把传入的关键字参数打包成字典 print("*args----------------------------------------") deffunction_args(arg1,arg2,*args): print(args) function_args(1,2,3,4,5,6)#将对应未打印的剩余元素全部打包给*args print("**kwargs--------------------------------------") deffunction_kwargs(arg1,arg2,**kwargs): print(kwargs) function_kwargs(1,2,arg3=1,arg4=6,arg5=8)#将关键字参数打包成字典输出 输出结果为: 用函数打印乘法表 defmul_table(number): ifnumberinrange(1,10): foriinrange(1,number+1): forjinrange(1,i+1): print(i,"*",j,"=",i*j,end="\t") print() else: print("Thenumberisillegal") mul_table() 在mul_table里边输入数字即可打印乘法表 若输入9打印九九乘法表,则输出结果为: 输入超过9的值,比如输入10,则执行结果为: 函数中字典的应用 字典中get的用法: 格式: get(self, key, default=None, /) Return the value for key if key is in the dictionary, else default./ : 表示"/"前边都是仅位置参数,不能使用关键字参数 *:*后边必须使用关键字参数 deftest_get(value,default=None): returndefault#定义函数,要求返回默认值 data=test_get(1,default=4)#返回定义的默认值 print(data) deftest_get(value1,value2,/,*,kwd1,kwd2): print("Test")#/和*的使用 test_get(1,2,kwd1=3,kwd2=4)#返回函数定义的值 返回结果为: 函数中列表的用法 sort的用法 格式: sort(self, /, *, key=None, reverse=False) If a key function is given, apply it once to each list item and sort them, ascending or descending, according to their function values.key: 是指定你排序规则的函数 list_data=[1,7,8,9,0,6,5,3,4]#定义一个列表 print(list_data) defsort_function(element): returnelement%2 list_data.sort(key=sort_function)#按照取余结果由小到大排序 print(list_data) print("lambda--------------------------------------------") #lambda表达式:匿名函数 #格式:lambdaarguments:element%2 list_data.sort(key=lambdaelement:element%2)#和前边函数定义按取余排序一样 print(list_data) 输出结果为: 高阶函数: 1. map 格式: map(fun, *iterrable) -> map object作用: Make an iterator that computes the function using arguments from each of the iterables. Stops when the shortest iterable is exhausted. (创建一个迭代器,使用每个可迭代对象的实参计算函数。当最短的可迭代对象耗尽时停止。) list_data_1=[1,2] list_data_2=[3,4,5] list_data_3=[6,7,8,9] deffunction_test(i,j,x): returni+1,j+1,x+1 第一种用法 foriinmap(function_test,list_data_1,list_data_2,list_data_3): print(i)#将每个列表相同下标的元素以元组形式打包 第二种用法 list_data=list(map(function_test,list_data_1,list_data_2,list_data_3)) print(list_data) 输出结果为:总结: (1)map的结果取决于最短列表元素的个数,也取决于返回值 (2)map的数据类型其实是一个序列 2. filter: 过滤 格式: filter(function or None, iterable) --> filter object作用: Return an iterator yielding those items of iterable for which function(item) is true. If function is None, return the items that are true. (返回一个迭代器,生成对于某一个函数为可迭代的项为真值。如果function为None,则返回为真值的项。) data=list(filter(lambdax:x%2,[1,2,3,0])) print(data)#定义一个lambda函数,按照取余结果返回所有的真值 输出结果为: [1, 3] 3. reudce 迁移到functools这个模块中格式: def reduce(function, sequence, initial=_initial_missing): 作用: Apply a function of two arguments cumulatively to the items of a sequence, from left to right, so as to reduce the sequence to a single value. (将一个有两个参数的函数从左到右累加到序列的项上,以便将序列简化为单个值。) ruduce作用练习 fromfunctoolsimportreduce data=reduce(lambdax,y:x+y,[1,2,3,4,5]) print(data) 输出结果为: 15

优秀的个人博客,低调大师

网络编程基础知识

一、 cs架构和bs架构二、 互联网三、 osi七层 1.应用层 2.表示层 3.会话层 4.传输层 5.网络层 6.数据链路层 7.物理层 tcp/ip5层(5层名字记住:重点) -1.物理层 -网线,光纤 -2.数据链路层 -网卡 -3.网络层 -路由器 -4.传输层(运输层) -四层路由器 -5.应用层(会话层,表示层,应用层) -http协议,ftp协议,websocket协议... 3.1每一层的功能 1 物理层 -网线----》01010101电信号---》从网线中传输电信号 -8个比特位是一个字节 2 数据链路层 -数据帧:一组电信号是一个数据帧,有头和数据部分 -网卡---》mac地址---》全球唯一---》网卡出厂--》烧在了网卡上 -48位二进制---》看到的都是16进制表示 -广播: -局域网内通信,所有人都会接受到,通过mac地址确定给谁的数据报,如果不是自己的就不处理 -广播风暴 3 网络层 -跨局域网通信,需要经过网络层 -IP地址:0.0.0.0-255.255.255.255 -子网掩码: -192.168.1.1 255.255.255.0 -192.168.2.1 255.255.255.0 -ARP:ip和mac的对照表 4 传输层: -端口:0--65535,一个应用程序可以监听多个端口,但是一个端口只能属于一个应用程序 -TCP协议:可靠传输(可靠传输如何保证?三次握手,四次挥手) -UDP协议:不可靠传输 5 应用层 -htpp,ftp,websocket.... 3.2传输层常用接口 应用程序 FTP TFTP TELNET SMTP DNS HTTP SSH MYSQL 熟知端口 21,20 69 23 25 53 80 22 3306 传输层协议 TCP UDP TCP TCP UDP TCP TCP TCP DNS:把网址转换成ip地址 从浏览器发送出去的数据,都是http协议,默认是80端口 3.3传输层TCP的三次握手和四次挥手 1 tcp可靠传输:三次握手,四次挥手保证数据可靠 2 三次握手 -客户端向服务端发送链接请求 1 -服务端回复可以建立,并且带着跟客户端建立链接的数据报 2 -客户端收到后,链接建好了 3 3 这个过程后就可以可靠传输数据 4 断开链接(4四挥手) -客户端告诉服务端,要断开 1 -服务端收到,回复ok 2 -服务端可能还有数据在传递,暂时还没断开---等数据传完 -服务端告诉客户端,我要断了 3 -客户端收到,回复ok 4 四、Socket层 1 Socket抽象层,从osi七层抽象出来的,抽象了网络层和传输层,跟语言无关 2 专门给开发人员用的 五、基于Tcp的socket套接字(重点)服务端 #导入socket模块 import socket import time #第一个socket是模块名,第二个socket是类名 #类实例化得到对象,得到一个socket对象 #server=socket.socket(family=socket.AF_INET,type=socket.SOCK_STREAM) #不写默认就是他 server=socket.socket() #绑定地址跟端口 ,传一个元组,监听的地址,监听的端口 server.bind(('192.168.11.28',8008)) #监听 #半连接池是5,可以缓冲5个 server.listen(5) #等待用户连接(看源码,有两个返回结果) #sock是连接对象,以后这个服务端和客户端交互,使用这个对象交互 #addr是客户端地址(ip和端口) sock,addr=server.accept() #接收客户端发给我的消息 data=sock.recv(1024) #打印 print(data) #服务端给客户端发送消息(必须是byte格式) sock.send(b'helloworld') time.sleep(1) #关闭连接对象 sock.close() #关闭服务 server.close() 客户端 import socket #创建socket对象 client=socket.socket() #连接服务端 client.connect(('127.0.0.1',8008)) #给服务端发了一个sb client.send(b'sb') #收到了服务端给我的 data=client.recv(1024) print(data) #关闭 client.close()

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册