首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10010篇文章
优秀的个人博客,低调大师

基础知识

1. # 这是单行注释 2. """ 这是多行注释 """ IPO input process output python提供了两套索引体系 第一种叫正向递增序号,从0开始,0是第一个元素 arr[0:10] 第二种叫反向递减序号,从-1开始,-1是倒数第一个元素,逐渐反向递减 arr[-5:-1] input()函数,从控制台读取一行,可带参数input("请输入:") 定义一个变量接收返回值 temp = input() print()函数,输出 eval() 评估函数 去掉参数最外侧引号并执行余下的函数 8. if TempStr[-1] in ['F', 'f']: C = (eval(TempStr[0:-1]) - 32) / 1.8 print("转换后的温度是{:.2f}C".format(C)) # {:.2f}是一个占位符, :.2f表示将结果保留两位小数 elif TempStr[-1] in ['C', 'c']: F = 1.8 * eval(TempStr[0:-1]) + 32 print("转换后的温度是{:.2f}F".format(F)) else: print("输入的格式错误") type(eval(N)) == int 判断是不是某种类型 arr[-1]表示取最后一个元素,arr[0,-1] 截取第一个到倒数第二个子串,不包含最后一个 arr[0,arr.len()]

优秀的个人博客,低调大师

android关键知识

1、handler 与Looper 与MessageQueue 、Message关系 handler:是处理主线程(ui线程)处理耗时操作的线程,通过post message到MessageQueue队列中。使用handler须要实现 handlerMessage方法,通过更新主线程ui Looper:每一个Looper相应一个MessageQueue,在handler之前Looper.prepare()会初始化looper和MessageQueue。最后Looper.loop方法会去循环分发message到指定的handler,改api方法中有一句msg.target.dispatchMessage(msg); 这就是looper和handler之间的调用 2、hander与 AsyncTask的优缺点 AsyncTask实现的原理和适用的优缺点 AsyncTask,是android提供的轻量级的异步类,能够直接继承AsyncTask,在类中实现异步操作,并提供接口反馈当前异步运行的程度(能够通过接口实现UI进度更新),最后反馈运行的结果给UI主线程. 使用的长处: 简单,快捷 过程可控 使用的缺点: 在使用多个异步操作和并须要进行Ui变更时,就变得复杂起来. Handler异步实现的原理和适用的优缺点 在Handler 异步实现时,涉及到 Handler, Looper, Message,Thread四个对象,实现异步的流程是主线程启动Thread(子线程)执行并生成Message-Looper获取Message并传递给HandlerHandler逐个获取Looper中的Message,并进行UI变更。 使用的长处: 结构清晰,功能定义明白 对于多个后台任务时。简单,清晰 使用的缺点: 在单个后台异步处理时,显得代码过多,结构过于复杂(相对性) 3、android里面几种常见的存储方式 a、Content provider 1) ContentProvider为存储和读取数据提供了统一的接口 2) 使用ContentProvider,应用程序能够实现数据共享 3) android内置的很多数据都是使用ContentProvider形式,供开发人员调用的(如视频,音频。图片,通讯录等) 首先在Androidmanifest.xml中注冊provider权限,然后通过getContentResolver() 然后得到contentResolver()对象 能够对该应用进行类似数据库操作一样的增删改成,须要的參数是uri 和參数值,查询一般得到游标Cursor 通过遍历游标获取属性值 b、SharedPreferences 实际上SharedPreferences处理的就是一个key-value(键值对)。SharedPreferences经常使用来存储一些轻量级的数据. 通过getSharedPreferences()得到改SharedPreferences对象 然后得到edit对象用来put值到改对象中。最后须要edit.commit()来将改对象存储到文件里,最后是以文件形式保存在data/data的指定路径下 c、sqlite存储 SQLite是一种轻量级的小型数据库,尽管比較小,可是功能相对照较完好,一些常见的数据库基本功能也具有,在如今的嵌入式系统中使用该数据库的比較多。由于它占用系统资源非常少 须要继承SQLiteOpenHelper 然后helper.getWritableDatabase() 得到SQLiteDatabase 对象,该对象能够对数据进行增删改查操作,提供了key value形式的CURD方法 d、io流存储 e、webview网络存储 4。listview你是怎么优化的。 用viewHolder和convertview优化内存,降低view的实例化个数,当item1被滑出屏幕时。这时不须要创建新的item1的view实例,android里面提供了Recycler(重复循环器)构件,并且viewHolder是静态类,最快的方式是定义一个ViewHolder,将convetView的tag设置为ViewHolder,不为空时又一次使用就可以。 4.1,listview图片载入优化 1.decodeStream最大的秘密在于其直接调用JNI>>nativeDecodeAsset()来完毕decode。无需再使用java层的createBitmap,从而节省了java层的空间,而且设置图片的压缩比例,从而缩小内存使用 InputStream is = this.getResources().openRawResource(R.drawable.pic1);BitmapFactory.Options options=new BitmapFactory.Options();options.inJustDecodeBounds = false;options.inSampleSize = 10; //width。hight设为原来的十分一Bitmap btp =BitmapFactory.decodeStream(is,null,options);,2.回收图片缓存 if(!bmp.isRecycle() ){bmp.recycle() //回收图片所占的内存system.gc() //提醒系统及时回收} 5,view的刷新,之前说过 View 能够调用invalidate()和postInvalidate()这两个方法刷新 6,IPC及原理 7,Android多线程 8。Android为什么要设计4大组件,他们之间的联系。不设计行不行(主要是为了实现MVC模式。然而java中最难的模式也是这个,非常少有产品能将这个模式做得非常好【Technicolor的面试官问的这个】) 9,service的周期。activity的周期,谈下你对Android内部应用的了解,比方他做电话,以及联系人等等应用。框架层有非常多东西还是多看看。熟悉Android怎么做的,无论你做应用程开发还是应用框架层开发非常有优点。 版权声明:本文博客原创文章。博客,未经同意,不得转载。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/4750555.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

知识萃取规范指南-三层知识萃取-构建场景-概念-实体的知识元模型

很多长期写作的人都会遇到一个困境——翻看自己过去几年的文章,少则几十篇,多则数百篇,明明每一个字都是自己写的,每一篇文章都花过心思,但回过头来看,却很难说清楚自己到底积累了什么。更尴尬的是,遇到一个新问题时,隐约记得自己以前写过类似的话题,但翻半天找不到;找到了,又发现当时的写法和现在的理解已经对不上了。

优秀的个人博客,低调大师

MongoDB基础知识

微服务流行,我也是越来越喜欢MongoDB了,除非必要要用MySQL,我都会倾向于MongoDB。 MongoDB 什么是MongoDB ? MongoDB 是由C++语言编写的,是一个基于分布式文件存储的开源数据库系统。 在高负载的情况下,添加更多的节点,可以保证服务器性能。 MongoDB 旨在为WEB应用提供可扩展的高性能数据存储解决方案。 MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。 value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。" title="MongoDB 将数据存储为一个文档,数据结构由键值(key=>value)对组成。MongoDB 文档类似于 JSON 对象。字段值可以包含其他文档,数组及文档数组。" data-original="https://raw.githubusercontent.com/fengwenyi/erwin-learn-note/master/images/MongoDB/mongodb-01.png"> MongoDB特点 MongoDB 是一个面向文档存储的数据库,操作起来比较简单和容易。 你可以在MongoDB记录中设置任何属性的索引 (如:FirstName="Sameer",Address="8 Gandhi Road")来实现更快的排序。 你可以通过本地或者网络创建数据镜像,这使得MongoDB有更强的扩展性。 如果负载的增加(需要更多的存储空间和更强的处理能力) ,它可以分布在计算机网络中的其他节点上这就是所谓的分片。 Mongo支持丰富的查询表达式。查询指令使用JSON形式的标记,可轻易查询文档中内嵌的对象及数组。 MongoDb 使用update()命令可以实现替换完成的文档(数据)或者一些指定的数据字段 。 Mongodb中的Map/reduce主要是用来对数据进行批量处理和聚合操作。 Map和Reduce。Map函数调用emit(key,value)遍历集合中所有的记录,将key与value传给Reduce函数进行处理。 Map函数和Reduce函数是使用Javascript编写的,并可以通过db.runCommand或mapreduce命令来执行MapReduce操作。 GridFS是MongoDB中的一个内置功能,可以用于存放大量小文件。 MongoDB允许在服务端执行脚本,可以用Javascript编写某个函数,直接在服务端执行,也可以把函数的定义存储在服务端,下次直接调用即可。 MongoDB支持各种编程语言:RUBY,PYTHON,JAVA,C++,PHP,C#等多种语言。 MongoDB安装简单。 MongoDB与其他数据库的对比 MongoDB 与 MySQL 由于MongoDB独特的数据处理方式,可以将热点数据加载到内存,故而对查询来讲,会非常快(当然也会非常消耗内存);同时由于采用了BSON的方式存储数据,故而对JSON格式数据具有非常好的支持性以及友好的表结构修改性,文档式的存储方式,数据友好可见;数据库的分片集群负载具有非常好的扩展性以及非常不错的自动故障转移(大赞)。 不足:数据库的查询采用了特有的查询方式,有一定的学习成本(不高);索引不咋滴;锁只能提供到collection级别,还做不到行级锁;没有事务机制(不能回滚啊);学习资料肯定没有MySQL的多。 MongoDB与Hadoop的区别 MongoDB侧重于对数据进行操作的应用系统,而Hadoop则侧重于对数据进行分析统计的应用。 MongoDB能够满足对数据库读写性能具有极高要求的应用场景(很消耗memory的),一般这些应用的响应延迟会要求控制在10ms以下,甚至更低。而Hadoop由于每一次的读写操作会包含大量数据(Hadoop更适合少次操作大批量数据的场景),通过聚集分析处理大量数据,这种分析一般都会走MapReduce,会造成很高的延迟(数分钟到数小时不等) MongoDB查询 查询语法 db.collection.find(query, projection).pretty() collection:文档名称,或者可写成 getCollection('col_name') query :可选,使用查询操作符指定查询条件 projection:可选,使用投影操作符指定返回的键。查询时返回文档中所有键值, 只需省略该参数即可(默认省略)。 pretty():易读 条件语法 操作 格式 范例 等于 {<key>:<value>} db.col.find({"by":"菜鸟教程"}).pretty() 小于 {<key>:{$lt:<value>}} db.col.find({"likes":{$lt:50}}).pretty() 小于或等于 {<key>:{$lte:<value>}} db.col.find({"likes":{$lte:50}}).pretty() 大于 {<key>:{$gt:<value>}} db.col.find({"likes":{$gt:50}}).pretty() 大于或等于 {<key>:{$gte:<value>}} db.col.find({"likes":{$gte:50}}).pretty() 不等于 {<key>:{$ne:<value>}} db.col.find({"likes":{$ne:50}}).pretty() AND语法 db.col.find({key1:value1, key2:value2}).pretty() OR语法 db.col.find( { $or: [ {key1: value1}, {key2:value2} ] } ).pretty() AND 与 OR db.col.find( { key1: value1, $or: [ {key2: value2}, {key3: value3} ] } ).pretty() limit() 该参数指定从MongoDB中读取的记录条数。 db.col.find().limit(NUMBER) skip() 跳过指定数量的数据 db.col.find().limit(NUMBER).skip(NUMBER) 排序 db.col.find().sort({KEY:1}) 聚合 db.col.aggregate(AGGREGATE_OPERATION) 举例:现在我们通过以上集合计算每个作者所写的文章数,使用aggregate()计算结果如下: db.mycol.aggregate([{$group : {_id : "$by_user", num_tutorial : {$sum : 1}}}]) 与sql相同: select by_user, count(*) from mycol group by by_user 管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的参数。 MongoDB的聚合管道将MongoDB文档在一个管道处理完毕后将结果传递给下一个管道处理。管道操作是可以重复的。 表达式:处理输入文档并输出。表达式是无状态的,只能用于计算当前聚合管道的文档,不能处理其它的文档。 这里我们介绍一下聚合框架中常用的几个操作: $project:修改输入文档的结构。可以用来重命名、增加或删除域,也可以用于创建计算结果以及嵌套文档。 $match:用于过滤数据,只输出符合条件的文档。$match使用MongoDB的标准查询操作。 $limit:用来限制MongoDB聚合管道返回的文档数。 $skip:在聚合管道中跳过指定数量的文档,并返回余下的文档。 $unwind:将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值。 $group:将集合中的文档分组,可用于统计结果。 $sort:将输入文档排序后输出。 $geoNear:输出接近某一地理位置的有序文档。

优秀的个人博客,低调大师

php知识碎片汇总

1.# php(string)字符串:一个字符串是由一系列字符组成,其中每个字符等同于一个字节。 这意味着php只能支持256的字符集,不支持Unicode. php字符串(四中表达方式)1.1单引号 定义一个字符串的最简单的方法是用单引号把它包围起来(字符 ')。 要表达一个单引号自身,需在它的前面加个反斜线(\)来转义。要表达一个反斜线自身,则用两个反斜线(\\)。其它任何方式的反斜线都 会被当成反斜线本身:也就是说如果想使用其它转义序列例如 \r 或者 \n,并不代表任何特殊含义,就单纯是这两个字符本身。 例如 'ab' 1.2双引号 如果字符串是包围在双引号(")中, PHP 将对一些特殊的字符进行解析: ![_](https://yqfile.alicdn.com/2532758ebb7c58453e0509d59f0e0479865a0b2b.png) 和单引号字符串一样,转义任何其它字符都会导致反斜线被显示出来。PHP 5.1.1 以前,\{$var} 中的反斜线还不会被显示出来。 用双引号定义的字符串最重要的特征是变量会被解析,详见变量解析。 1.3heredoc 句法结构 第三种表达字符串的方法是用 heredoc 句法结构:<<<。在该运算符之后要提供一个标识符,然后换行。接下来是字符串 string 本身,最后要用前面定义的标识符作为结束标志。 结束时所引用的标识符必须在该行的第一列,而且,标识符的命名也要像其它标签一样遵守 PHP 的规则:只能包含字母、数字和下划线,并且必须以字母和下划线作为开头。 例如:$str = << Example of string spanning multiple lines using heredoc syntax. OD; 1.4 就象 heredoc 结构类似于双引号字符串,Nowdoc 结构是类似于单引号字符串的。Nowdoc 结构很象 heredoc 结构,但是 nowdoc 中不进行解析操作。这种结构很适合用于嵌入 PHP 代码或其它大段文本而无需对其中的特殊字符进行转义。与 SGML 的 结构是用来声明大段的不用解析的文本类似,nowdoc 结构也有相同的特征。 一个 nowdoc 结构也用和 heredocs 结构一样的标记 <<<, 但是跟在后面的标识符要用单引号括起来,即 <<<'EOT'。Heredoc 结构的所有规则也同样适用于 nowdoc 结构,尤其是结束标识符的规则。 $str = <<<'EOD' Example of string spanning multiple lines using nowdoc syntax. EOD; (上述内容来自于php中文网站 详细描述与示例 https://php.net/manual/zh/language.types.string.php 查阅)

优秀的个人博客,低调大师

多线程知识回顾

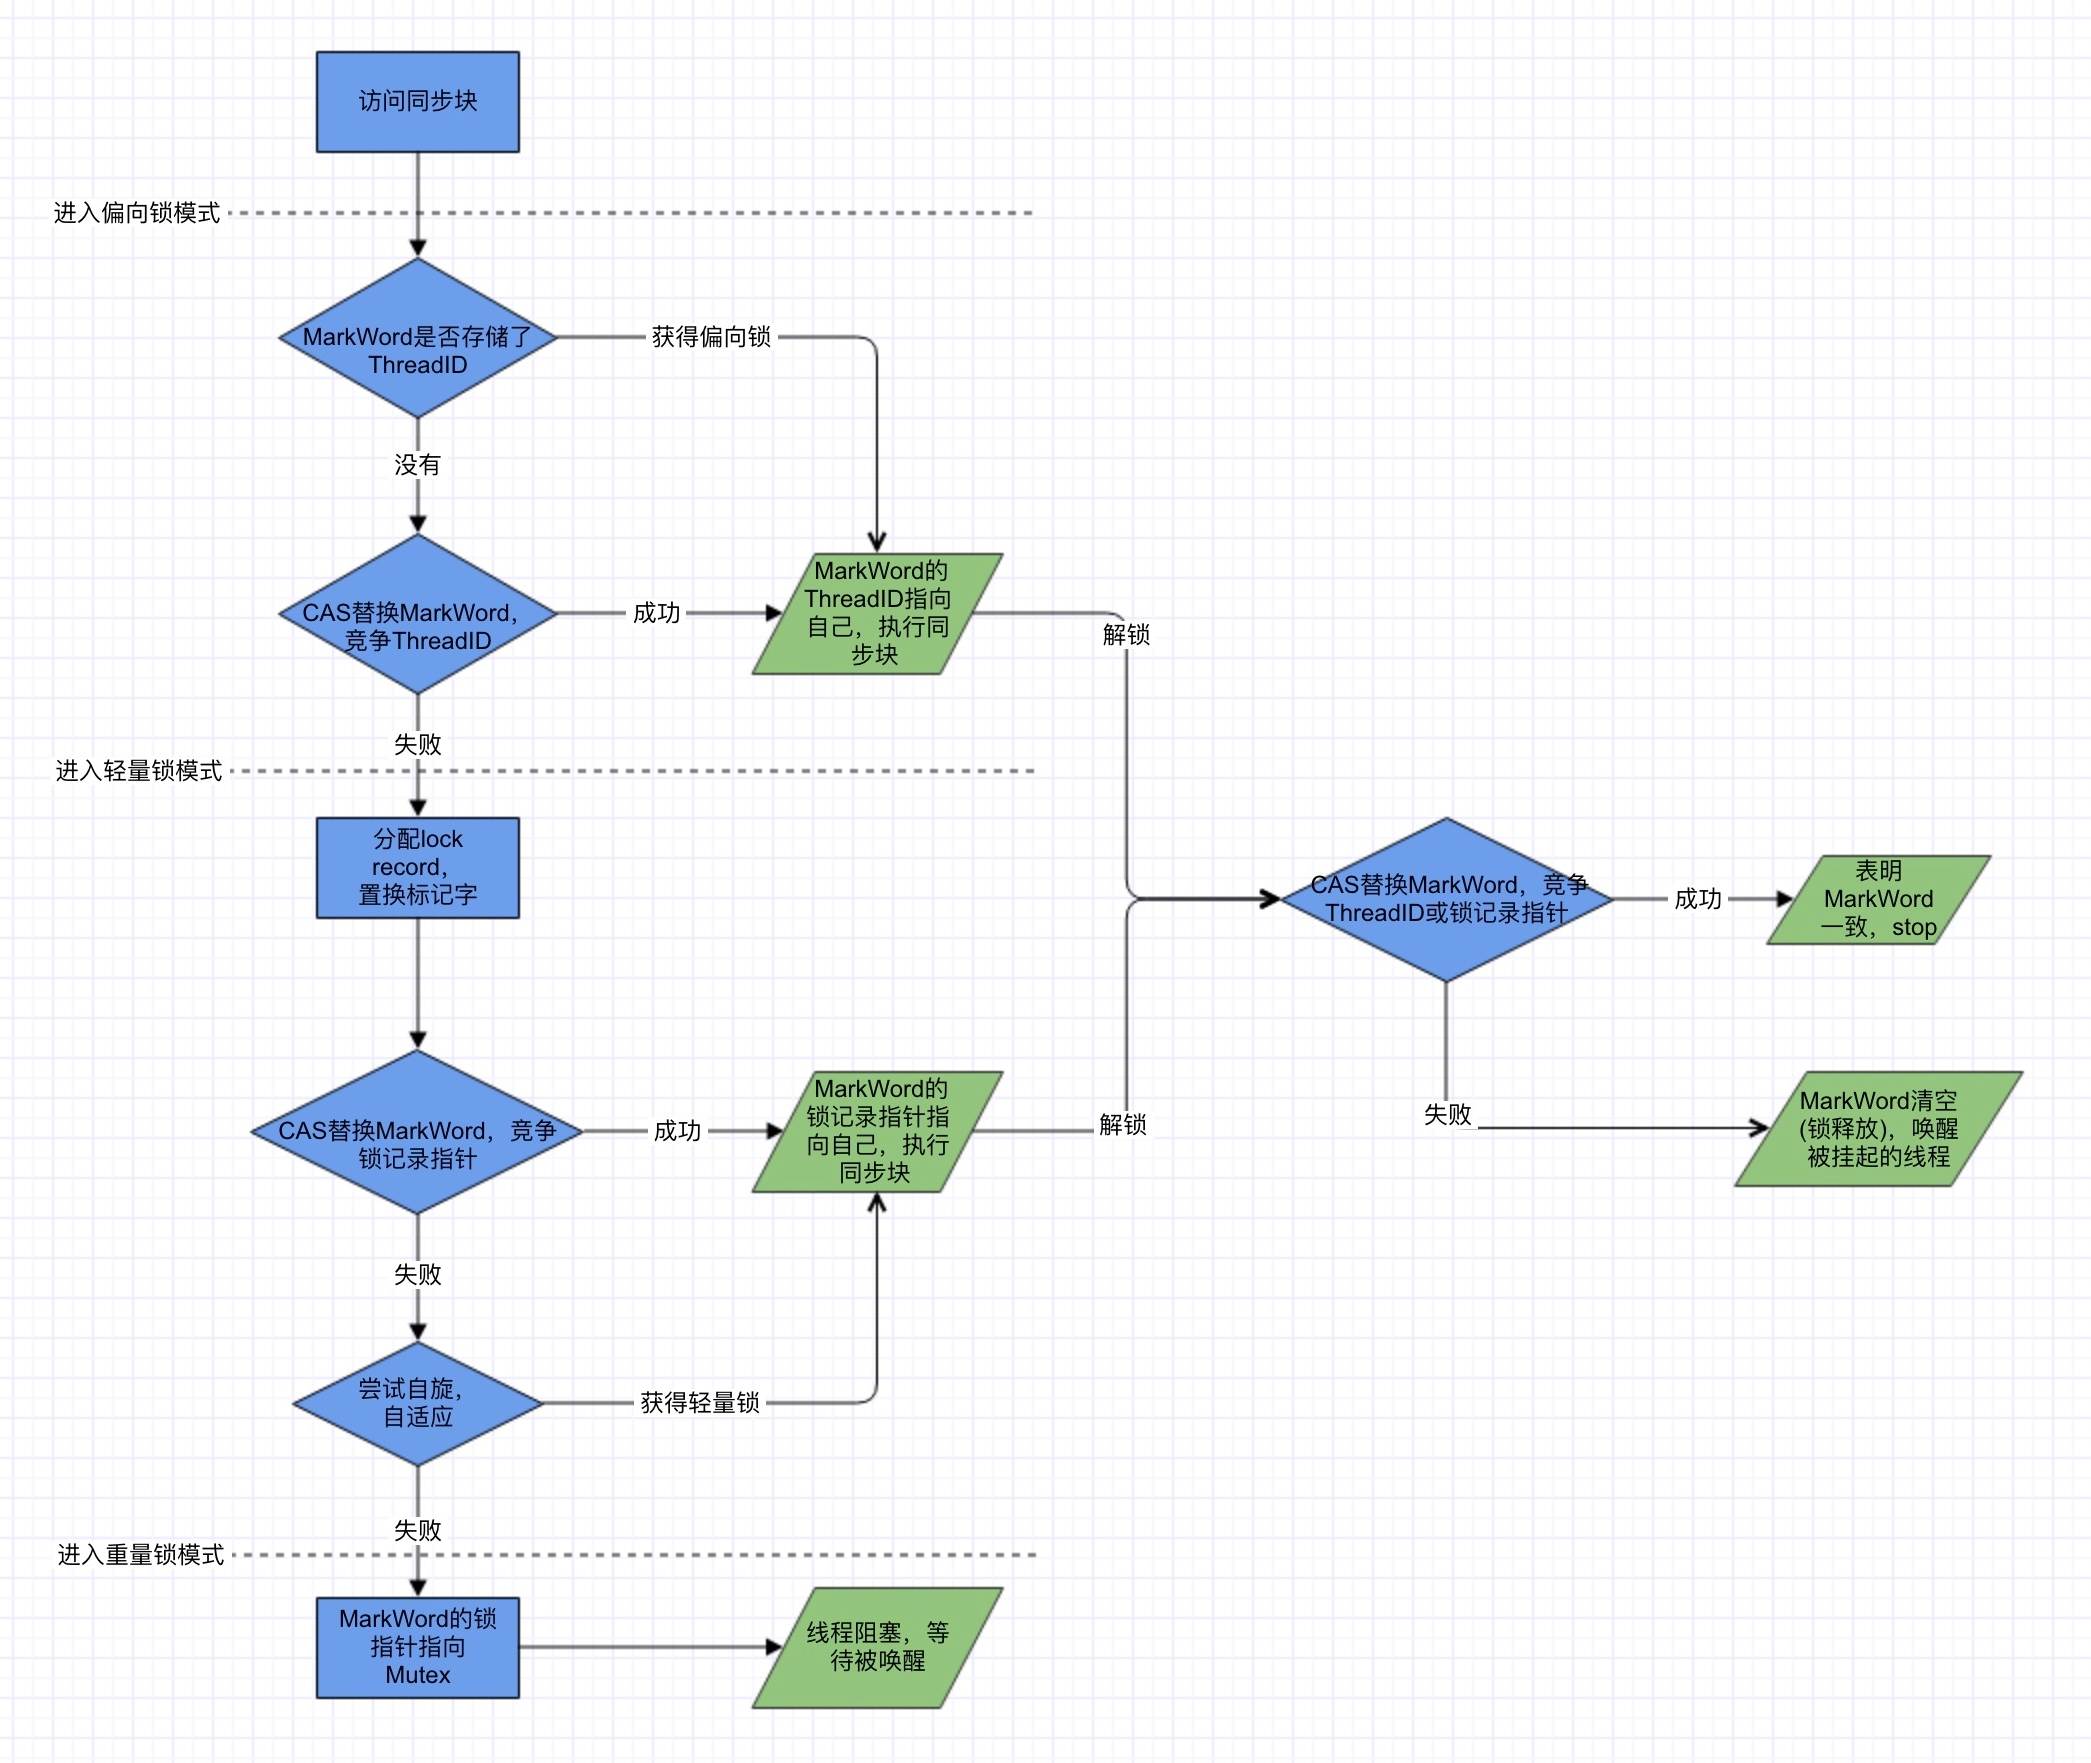
以前看过不少JDK源码,最近回顾了一下笔记,所以在这里对几个很常见到的线程类做个记录。 一、ThreadLocal ThreadLocal是一个线程级的局部变量,“本地线程”只是俗称但并不准确。 假设是拿Map去做线程的局部变量,一般就两种思路:以Thread为key的共享区域,使用上不会有什么问题,但因为是共享区域访问,我们要做并发控制比如synchronized这样的悲观策略来保证线程安全,可同步会限制吞吐。第二种就是线程封闭,ThreadLocal正是使用了这种方式,线程本地维护一个区域ThreadLocalMap,以ThreadLocal实例为key,线程间数据隔离,自然就不存在线程安全的问题了。即ThreadLocal作为句柄、一个入口,来连接ThreadLocalMap和Thread。 内存泄漏问题:ThreadLocalMap的key使用了弱引用,指向某个ThreadLocal实例。当把ThreadLocal实例置为null后,那么它将会被GC回收。但ThreadLocalMap中的value不会被回收,因为存在一条current thread的强引用。因为ThreadLocalMap出现了大量key为null的Entry(key被回收了),且没办法访问Entry的value,只有当前thread结束、强引用断开,当前Thread、ThreadLocalMap,ThreadLocalMap中的value才会被GC回收。 为什么key要使用弱引用?如果key使用强引用,ThreadLocal不会被回收,因为存在一条ThreadLocalMap的key对它的强引用;如果使用弱引用,能保证ThreadLocal能被GC掉。但不管是强引用还是弱引用,都不影响存在无法访问Entry的事实,都需要事后去手动删除无用的Entry,否则都存在内存泄漏的隐患(Thread不死,无用的Entry就一直在增长)。 这也就是为什么会有内存泄漏的问题了:存在一条强引用链 Current Thread -> ThreaLocalMap -> Entry -> value。比如我们使用业务线程池中的线程作为ThreadLocalMap的引用的时候,或者使用单例、static的ThreadLocal时(因为延长了ThreadLocal的生命周期),又或者使用ThreadLocal作为每次调用上下文而又不清理的时候,经管ThreadLocal在get、set、remove方法都会去清除线程ThreadLocalMap里所有key为null的value,但这需要我们主动的显示调用才起作用。 带来的思考: 避免使用同步的方法之一就是不共享数据,比如线程封闭,通过比如转换为单线程,即便对象本身不是线程安全的也不会有什么问题; 给每一个访问共享变量的线程一个独立的副本,可以解决变量并发访问的冲突问题,一种空间换时间的做法; 二、synchronized对象锁 为了保证synchronized的可重入性,JDK为每一个对象的内置锁都关联了一个计数器和所有者线程,为0就是未被持有,为1就是有一个线程,为2就是这个线程再次请求了这个锁,退出则递减。这背后的原理,是synchronized关键字经过编译后,在同步代码块的前后分别形成MonitorEnter和MonitorExit两个字节码指令。执行MonitorEnter指令时获取对象的内置锁,如果没有被锁定,则锁的计数器加1;执行MonitorExit指令时锁的计数器减1,计数器为0时锁就释放了。如果获取锁失败则线程阻塞等待,直到被唤醒。 而关于synchronized锁的状态:无锁,偏向锁,轻量级锁,重量级锁,这存在于Java对象头MarkWord,根据锁标志位复用空间。无锁状态为空,偏向锁时的ThreadID,轻量锁时锁记录的指针,重量锁时指向系统的互斥量Mutex(0|1)。 偏向锁,适用于单线程访问同步块的场景,同步但无竞争的情况,但只要存在不同线程申请锁时即升级为轻量锁。无锁模式下和偏向锁模式下的性能消耗:CAS替换和退出偏向锁时的撤销。 轻量锁是适用于线程交替执行同步块的场景,有竞争但无阻塞的情况,追求响应时间,但只要存在有锁竞争时即升级为重量锁。 三、Lock 1.ReentrantLock ReentrantLock的内部实现,简单来说,就是在获取锁时先判断state是不是0,如果是就先cas一把获取锁对象,如果不是0,则链到CLH等待队列(双端队列)队尾,标记为独占。如果放入失败,则自旋+CAS,然后进入wait状态,等待unpark()。唤醒后尝试能否cas锁资源成功,成功则指向head队头,然后返回中断标识。 Reentrant的可重入性,其实是依靠AQS的内部机制的。 AQS(AbstractQueuedSychronizer)也叫“队列同步器”,是整个Java并发包的核心,多种锁的抽象父类。其内部维护了一个volatile的int类型成员变量state和CLH,并且具有两个Node节点的引用:head和tail: 如果申请锁资源时,当前线程与独占的Owner线程一致,则state值CAS加1,退出则CAS减1,获取多少次就要释放多么次,直到state回到零态,然后unpark。 CLH具体实现上,是由内部类Node构成的FIFO双向同步队列。当竞争锁资源失败后,AQS会将当前线程的引用以及等待状态构造成一个Node并加入到CLH中并阻塞当前线程;每次入CLH队列都要通过CAS操作,使tail指向新节点、新节点prev字段指向原来的尾节点;当首节点锁资源释放后,将后继节点的线程唤醒,而后继节点的线程在尝试获取锁资源成功后将自身设置为首节点。 对于公平锁和非公平锁:它们的差异就是在获取锁资源时,非公平是抢占式的,先cas一把不排队直接插队,失败才走acquire(1);然后第二个差别是在acquire时,公平锁会先判断CLH队列中是否空闲,而非公平是没有的。 对于共享锁和独占锁:共享锁,在竞争到锁资源后成为Head头时,如果CLH队列不为空则还会唤醒下一个线程;在释放锁时,独占锁是state=0才去唤醒其它线程,而共享锁则不管state是否为0都会去尝试唤醒。 2.StampedLock StampedLock是Java8新增的读写锁,除读写分离外,它的亮点在于乐观读模式,就是在读多写少的情况下,先乐观的读(不阻塞写),而后通过冲突检测来决定是做后续操作,还是重新做悲观的读锁定(即ReadWriteLock的读读不互斥、读写互斥)。 虽然没有像其它锁一样定义了内部类来实现AQS,但StampedLock的内部实现还是基于CLH(维护一个等待队列,所有没有成功申请锁的线程都放在这个FIFO队列中,然后通过一个标记位locked判断当前线程是否已释放锁)的,通过状态位来表示锁的状态和类型。而且除乐观读之外,其余锁操作都是典型的CAS操作,先自旋尝试、加入CLH等待队列、再次自旋尝试、直至最终Unsafe.park()挂起线程,成功获取锁资源则CAS操作更新标志位。 StampedLock与ReadWriteLock的区别: StampedLock可以做乐观读,而ReadWriteLock使用的都是悲观策略; StampedLock关注的是读写比例,而ReadWriteLock关注的是读写; StampedLock读写锁可以互相转换,而ReadWriteLock只有锁降级; ReentrantReadWriteLock是可重入的,而StampedLock三种锁模式都是不可重入的,它并没有直接实现AQS; StampedLock对多核CPU做了优化(通过Runtime#availableProcessors()获取CPU核数作为自旋次数); 在性能上,正常情况下,StampedLock比ReadWritLock快4倍的读,快1倍的写 3.Volatile volatile的作用其实就两个:保证线程可见性,禁止指令重排序。 通常情况下,为了保证cache一致性,工作内存发生变化之后需要回写到主内存,不管你通过什么方式。而volatile修饰的变量则要求工作内存与主内存保持同步,发生更新立即回写、读的时候读主内存。其实是,JVM在volatile变量前后会插入一个内存屏障指令Store-Load。一个CPU内存访问的一个同步点,屏障之前的写操作都要写入内存、屏障之后的读操作都可以读到屏障之前的写操作结果。这其实是必须要保证的,CPU硬件级别也是有缓存的,就是寄存器。当一个变量被修改时是在其寄存器上操作,如果没有及时回写到物理内存上,线程可见性也难以保证。 CPU有它自己的指令排序,随机写的性能肯定比不上批处理方式的刷新,而且还可以合并对同一个内存地址的多次写,以减少内存总线的占用。所以,为了保证内存可见性,对于编译器,JVM会禁止volatile变量的编译器重排序;对于处理器,JVM会要求Java编译器在生成指令序列时,插入内存屏障指令,通过内存屏障指定来禁止特定类型的处理器重排序。可想而知这降低了效率,无法被编译器优化。 volatile与sychronized的区别: sychronized也保证了线程可见性,也在锁即将释放之前将工作内存回写到主内存,但它范围更大,它锁定了一块内存区域做同步,而volatile只是锁定一个变量,所以后者无法替代前者。 实际上也没法替代,volatile只保证可见性不保证原子性,而synchronized是保证的。 4.CAS CAS是“Compare And Set”的简称,一种系统原语,JDK通过Unsafe对象来实现CAS,利用native方法的原子性来保证线程安全。 简单来说,就是一个CAS操作包含三个操作数——内存值(V)、预期值(A)和新值(B)。当且仅当预期值A和内存值V相同时,才会将V改为B并返回true,否则什么都不做并返回false。而底层实现,在比如常见的Linux的X86上,是通过调用Atomic:comxchg()指令(这个方法的实现在HotSpot下的os_cpu包中,该方法的实现和操作系统相关)来直接操作内存的,而这个指令在多处理器情况下会通过使用lock-xadd来加锁。 synchronized在JDK1.6之后,通过偏向锁 -> 轻量级锁 -> 重量级锁这样的锁优化,大幅的提高了获取锁和释放锁的效率。但在Java8之后,CAS得到了增强,AtomicI包的性能比synchronized更好了。具体原因是,CAS失败自旋用到了JDK1.8中Unsafe新增的getAndAddXXX方法,如果系统底层支持fetch-and-add,则使用fetch-and-add这样的原子指令(get和cas都是native,自然更快);如果不支持,则使用原来的compare-and-swap原子指令。 CAS使用中要注意的问题主要是ABA和CPU资源浪费: ABA问题:比如内存值变化了之后恢复成原值,但不代表内存值就没有发生变化。一个解决的思路是:通过添加修改计数器或是版本号,来标记是否发生过变更。实际上,JAVA中提供的Atomic原子类型变量就是这么做的,其内部实现是在对象中额外增加了一个标记位来标识对象是否有过变更。 CPU问题:如果自旋时间长,则可能浪费CPU这样的宝贵资源,即使没有任何争用也会做一些无用功。所以要明确适用场景,比如简单的非阻塞操作可以考虑使用CAS操作。而且建议与volatile变量“打配合”,来保证每次拿到的变量是主内存中的最新值,否则旧的预期值对某个线程来说,永远是一个不会变的值,只要某次CAS操作失败,则永远不会成功。 Java8之后,这样的并发处理成为主流:通过双层for循环+CAS自旋这样的无锁算法来处理并发,即外层死循环、里层自旋尝试,成功的话直接return或者goto关键字跳出外层循环并结束CAS操作,而不是通过锁竞争、阻塞的方式。 四、 线程池 拿ThreadPoolExecutor来说,工作队列workQueue和工作线程池works是分开的。它的工作机制是这样的: 关于排队策略,针对workQueue,通常有三种排队策略:直接提交,无界队列,有界队列。 直接提交:使用同步阻塞队列,将任务直接提交给线程,如果当前没有空闲线程则创建一个新的。它是无界的; 无界队列:使用链表阻塞队列,如果没有空闲线程则将任务提交给队列。它也是无界的,而且活跃线程数只会是corePoolSize值; 有界队列:使用列表阻塞队列,这时maxPoolSize有效,队列未满则放入队列阻塞,队列已满则跑拒绝策略; 具体使用哪种排队策略,还是看业务场景和任务量,比如说任务量不大、瞬发情况多,那可以用无界队列;如果任务量大,则要考虑用有界队列去调整。实际情况较常用的是有界队列,以避免耗尽资源导致OOM(同步队列会创建大量线程阻塞,无界队列会堆积大量任务),常见的使用策略是大型队列+小型池(吞吐高、响应慢)或者小型队列+大型池(吞吐低、响应快)。 使用Executors获取线程池的弊端: - newFixedThreadPool()和newSingleThreadPool()方法:允许工作队列⻓度为Integer.MAX_VALUE,这可能会堆积大量请求,从而导致OOM; - newCachedThreadPoolnew和newScheduledThreadPool()方法:允许创建的线程数为Integer.MAX_VALUE,可能会创建大量的线程,从而导致OOM; 关于线程池的饱和(拒绝)策略,主要有四种: 抛异常、丢任务,ThreadPoolExecutor的默认策略; 不抛异常、丢任务; 在pool没有关闭的前提下,丢弃列表头任务,尝试执行新任务; 尝试用调用者线程即主线程去执行任务(由于池中已无任何资源,这其实是风险最高的); 关于线程池大小设置,其实常见的参数就那么几个:corePoolSize核心线程数、maxPoolSize最大线程数、queueCapacity队列容量、keepAliveSeconds空闲时间,前两个比较重要。总结来说,主要是这三种: CPU密集型:CPU使用率高,为减少线程上下文切换开销,将池设置大小为CPU核数+1; I/O密集型:因为IO操作不占CPU,为了充分利用CPU,将池设置大小为CPU核数*2+1; 混合型:预估I/O密集型和CPU密集型的执行时间,执行时间差不多就拆分开,差很多就选其一; CPU密集型会考虑上下文切换的开销,儿I/O密集型会考虑I/O等待耗时。具体到实践中,主要也是看业务场景、什么样的任务。一般规律是:线程等待时间占比越高,需要越多线程数;CPU时间占比越高,需要越少线程数。当然,实际上还要考虑容量占比,不要超过阈值,保持应用的健康状态。

优秀的个人博客,低调大师

Vue重要知识小结

vue sync修饰 (1)双向数据绑定,父子组件之间信息的交互 1⃣️在自组件中使用this.emmit('toFather'),子组件产生一个tofather事件,然后在父组件中通过@进行监听,那么可以实现通信过程 2⃣️使用简单的方式传递,如上图中emmit(update:title),然后在v-bind:title.sync='title',从而实现双向数据绑定 (2)双向数据绑定,使用v-model 通过在自组件中使用model 定义 prop event ,从而可以实现父子组件之间通过v-model实现通信,或者不定义model ,使用默认的的prop:value,enent:input keep-alive <keep-alive><My-component /> <keep-alive> 可以实现缓存 作用域插槽 这个其实就是可以使用自组件中的数据,使用slot-scope接受自组件中的数据 自组件访问父级组件 1⃣️ let father = this.$parent 2⃣️通过依赖注入 计算属性 刚开始在学习计算属性的时候,一直默认的认为是一个函数,但是在调用的时候,是不用加()的,这样的话,在认为是一个函数就不对了,其实就是类似于 data中的数据,只不过会有缓存和更新。例如使用的时候直接{{computed}},通俗的说,可以单纯的将它作为一个data值 method方法 调用方法的时候,如果不传递值的话,那么可以不用加入() 混入 minxins 自定义指令 通过Vue.directive(name,{}) Vuex 三部分构成 state actions mutations state 此部分存放数据,可以通过mapStated获取到数据。 actions 可以使用异步,通过this.$store.dispathc()触发 mutatios mutatios 必须是同步,通过this.emmit()触发 步骤: Vue.use(Vuex) const store = new Vuex.Store({ state: { //前端全栈交流学习圈:886109386 count: //针对一到五年前端开发人员 }, //帮助突破技术瓶颈,提升思维能力。 mutations: { increment (state) { state.count++ } }, actions: { increment (context) { context.commit('increment') } } })

优秀的个人博客,低调大师

HTML DOM详细知识

1:节点 HTML DOM中,所有的事物都是节点。 整个文档是一个文档节点; 每个HTML元素是一个元素节点; 每个元素内的文本是一个文本节点; 每个属性是一个属性节点; 每个注释是一个注释节点; 2:方法 首先理解“编程接口”的概念:我们可以通过编程语言(如javaScript)对HTML DOM进行访问,这里把HTML元素视为对象,编程接口就是对象的方法和属性。通过方法和属性来对对象进行操作。 HTML DOM方法是可以在节点上执行的动作。 常用的HTML DOM方法: getElementById(id):获取带有指定id的节点(元素); getElementsByTagName(tagName):获取包含指定标签名称的所有元素的节点列表(集合、数组); getElementsByClassName(className):获取包含指定类名的所有元素的节点列表(集合、数组); appendChild(node):插入新的子节点; removeChild(node):删除子节点; 点击查看更多 3:属性 HTML DOM属性是节点上能够获取或设置的值。 innerHTML属性:获取元素内容,对于获取或替换HTML元素的内容很有用。 nodeName属性:规定节点的名称。它是只读的。元素节点的nodeName与标签名相同,属性节点的nodeName与属性名相同,文本节点的nodeName为#text,文档节点的nodeName为#document。 nodeValue属性:规定节点的值。元素节点的nodeValue为undefined或者null,文本节点的nodeValue为文本内容,属性节点的nodeValue为属性值。 nodeType属性:返回节点的类型,是只读的。元素节点的nodeType为1,属性节点的nodeType为2,文本节点的nodeType为3,注释节点的nodeType为8,文档节点的nodeType为9。 4:访问 访问节点也就是查找HTML的元素。 对HTML DOM节点的访问主要通过上文所说的方法来进行。 5:修改 修改HTML DOM意味着很多方面的内容,如: 该表HTML内容、改变CSS样式、改变HTML属性、创建新的HTML元素等等。 创建HTML内容:最简单的方式是使用innerHTML属性。如: document.getEmlemntById("p1").innerHTML="新文本"; 改变HMTL样式:如: document.getElementById("p1").style.color="red"; document.getElementById("p1").style.fontSize="larger"; 创建新的HTML元素:需要先创建新节点,然后把它追加到已有的元素节点上。如: var para = document.creatElement("p"); var node = document.creatTextNode("这是一个新段落"); para.appendChild(node); document.getElementById("div1").appendChild(para); 6:事件 HTML DOM允许JavaScript对HTML事件做出反应。当事件发生时,可以执行JavaScript。比如用户点击某个元素时执行代码。 事件属性:使用事件属性来向元素分配事件。如: <button onclick="displayDate()">点我</button>//向botton属性分配了onclick事件。 使用HTML DOM来分配事件:如: document.getElementById("p1").onclick=function(){displayDate()}; onload和onunload事件:当用户进入和离开页面时,会触发onload和onunload事件。它们可用于检查浏览器类型、处理cookies。 onchange时间:常用于输入字段的验证。当焦点离开时会触发。如: <input type="text" id="fname" onchange="upperCase()"> onmouseover和onmouseout事件:当鼠标指针移动到或离开元素时会触发。 onmousedowm、onmouseup及onclick事件:他们是一次鼠标点击的全部过程。当鼠标按钮被点击时,出发onmousedown,鼠标按钮松开时,触发nomouseup,最后鼠标点击完成,触发onclick。也就意味着,需要定义一次点击事件时,可以直接使用onclick。当需要点击和松开事件时,需要另外两个。 7:导航 在HTML DOM中通过节点关系来进行导航。 节点列表:节点列表是一个节点数组,通过下标可以访问相应的节点。与数组相似,通过length属性可以返回数组长度(节点个数)。 节点关系:可以使用三个节点属性,分别是:parentNode、firstChild及lastChild。 根属性:document.documentElement:全部文档; document.body:文档的主体。 childNodes和nodeValue:除了使用innerHTML,还可以使用childNodes和nodeValue属性来获取元素内容。如: txt = document.getElementById("intro").childNodes[0].nodeValue;//获取id为intro的元素的第一个子元素的值 原文发布时间:2018-6-19 原文作者:WARGON 本文来源 CSDN博客如需转载请紧急联系作者

优秀的个人博客,低调大师

python基础知识

1、print()函数print函数用于向控制台、python解释器、cmd命令行输出你想要输出的内容。print函数有输入参数,可以是字符串、数字、变量等等,也可以是它们的混合,不同对象之间可以使用,来分隔,print函数遇到,的时候会输出一个空格来作为分隔输出的效果。注意:在print函数中,如果输入的内容是可以继续计算或者合并的,那么python会先计算或者合并之后再输出。如:print(100+200)print('a'+'b')会输出数字300以及字符串'ab'2、input()函数用于从命令行、python解释器获取用户的输入,从subline text中无法输入。用户的所有输入都会被当做是str类型,即字符串类型,用户可以将input的输入内容放入变量中,即:name=input()用于保存输入的内容用作后续代码的指代。同时,为了更友好的界面,可以给input函数输入参数值,参数值可以是一个字符串,也可以是一个变量的指代,用于在提示用户输入的时候给出详细的说明,即:name=input('inpurt your name:')或者i='please input here:' , name=input(变量i)。3、组织方式python的组织方式是通过统一缩进,主旨是简洁优雅。4、数据类型和变量====整数和浮点数:整数分为正整数、负整数、0浮点数有精度问题,很大的浮点数可以用科学计数法标记,其中的10使用e来表示,即:12300000 = 1.23e7 ,或者类似2.35e-5等等====字符串:字符串,顾名思义,是一串字符序列,使用单引号或者双引号包括起来,外围的单引号或者双引号不算字符串的内容。如果字符串内容有单引号,那么外围要使用双引号包围,反之亦然,如果字符串内容中既有单引号又有双引号,则要使用\来转义其中一个引号如:' i\'am a "good" man ' ,使用\'来表示转义单引号====字符串+转义字符:在print函数中无法通过回车来体现最终打印字符串的换行,必须使用\n来表示换行,使用\t表示制表符,\单引号或者双引号,\\表示\符号注意:默认情况下,一个字符串中的\转义字符是会转义的,转义规则根据上述说明。但是如果在字符串前面加上r,则表示不对字符串内容做转义如:默认转义,print('line1\'line2')---->line1'line2强制不转义,print(r'line1\'line2')----->line1\'line2(可用于re的过滤规则中)这种情况下,不会转义:print('line1\\'+'nline2')------>line1\nline2====字符串+''''''实现简化换行:如果要输出一个段落,涉及字符串内部的多处换行,可以使用\n来实现,也可以使用print(''' ''')来实现,里面的字符串根据实际内容直接回车如:print('''这里是根据传入的页数,形成了所有的链接这里是server端这是一张新图片,准备下载''')====布尔值:True和False,用于各种判断,意味着一件事件为真或者为假,如3>2为真,2==0为假逻辑运算and,or,not,逻辑运算会与布尔值结合计算,如True and True 的结果为True注意:在python中,1可以被认为是True,0被认为是False(可以计算),其他值即不是True也不是False注意is是表示两边是同一个对象====空值:python中的空值使用None表示,注意,None不是0,对于0而言是有意义的,而None是一种特殊的属性,意味着空====变量:python支持多种数据类型,有内置原生数据类型,也有自定义扩展数据类型,任何类型的数据都可以看成一个对象,通过变量来指向它,对变量进行赋值就是让某一个变量指向某一个对象,建立他们两之间的关系。变量类似一个指针,指向某一个内存对象,python是动态语言,所以可以指向不同类型的对象,如str,int,float,list等等,java是静态语言一旦int a,那么a只能指向ini类型对象a='hello' , b=a ,意味着把a指向的对象的地址赋给b,或者说,让b指向a所指向的对象,这时候'hello'对象有两个指向自己的指针。如果此时a='world',那么print(b)还是等于'hello'====常量:约定俗成的使用全部大写变量名来表示常量,如PI对于除法/,python3中是不会取整的,python2是取整的对于地板除//,python3和2都是取整的使用%获取余数5、字符串编码问题====历史:在计算机历史上,计算机被设计成拥有处理数字的功能,计算机底层1个字节定义成8个位,1个字节可以表示的数字最大是255,如果需要表示更大的数字,就需要更多的字节,2个字节可以表示最大65535,4个字节可以表示42亿左右。根据计算机的原本设计是只能处理数字,如果要处理文本,即处理字符串,则需要把字符串与数字进行映射,即通过编码的方式记录每一个字符对应的数字。计算机是美国人发明的,所以当时只需要处理英文字符串,所有英文字符,包括字母大小写、数字、符号等等加在一起一共形成了127个字符,这127个字符通过1个字节就可以完全表示。通过1个字节对应的1个整数,映射到不同的字符,这种编码方式就是ASCII编码方式。随着计算机的发展,不同国家都在使用,都想通过计算机输入本国的语言,如中文,对于中文而言,中文的字符至少需要2个字节即至少需要65535个数字才能表示,所以中国为中文定制了GB2312编码方式,用于将中文编码到计算机的底层整数。同样的,不同国家有不同的编码方式,这就导致:同样的1个编码整数可能会在不同国家有不同的表示,而且,如果多个国家的程序放在一起,计算机就无法识别某一个字符串是属于英文还是中文还是其他国家的字符。为了解决不同国家定制不同的编码标准,出现了unicode统一字符编码标准,unicode标准常常使用2个字节表示1个字符,将世界上所有的语言都包含到这个编码标准中,这样不论计算机在哪里使用,不论计算机使用的是哪种语言,都不会出现混乱和冲突的问题。对于一些生僻的字符,unicode可能需要使用4-6个字符来表示。而如果单纯只使用unicode编码的时候,会出现空间浪费的问题,如果程序全部使用英文编写,所有英文字符默认2个unicode字节对应1个英文字符。所以使用unicode虽然可以很好的解决不同语言之间互通的问题,但是会带来空间浪费和效率不高的问题。这时候就需要使用UTF-8可变长编码方式,使用UTF-8的时候,如果是中文就是2个字节对应1个中文字符,如果是英文就是1个字节对应1个英文字符,即UTF-8的字节使用数量是根据实际使用的语言来灵活变化的,这种好处尤其体现在数据的保存、压缩、传输上。所以现在的计算机保存的数据都是UTF-8编码方式,一旦被程序调用的时候,文件中的数据则转换成unicode编码方式在内存中被处理,在处理完毕再次保存之前又被转换成高效的UTF-8编码方式。我们从网站上获取网页的时候,网页html是以源代码的形式传回给我们的浏览器,源代码中经常有:<meta charset="utf-8" /> 表示该网页使用UTF-8编码的方式来传输数据。====python字符串的编码:python3版本中,所有的字符串str类型对象都是使用unicode编码方式,即python中的所有字符串,都有对应的unicode整数,如:unicode是针对每一个字符做编码的,可以通过ord()函数对任意一个字符求出对应的unicode整数,也可以通过chr()输入unicode整数来得到对应的unicode字符当然,也可以这样写:'\uxxxx'其中要放入unicode整数的十六进制数,如,25991的十六进制数是0x6587:====编码转换:python在内存中的数据都是unicode编码,都是str类型的对象。而数据在保存或者网络传输的时候,必须转换成byte类型的字节流的形式,把unicode转换成byte类型需要依据不同的内容做不同的编码,所有byte类型的对象都是b开头,如:'abc'是str类型的对象,是unicode编码,是英文,所以转换成可传输的字节流就是'abc'.encode('ascii')---->b'abc',此时ascii编码中,1个字节对应1个英文字符'中文'是str类型的对象,是unicode编码,是中文,所以转换成可传输的字节流就是'中文'.encode('utf-8')---->b'\xe4\xb8\xad\xe6\x96\x87',此时utf-8编码中,使用3个字节表示1个中文字符------------------------------------------------------------------------------------------------------'中文'.encode('gb2312')---->b'\xd6\xd0\xce\xc4' ,此时gb2312编码中,使用2个字符表示1个中文字符总结:在计算机内存中,在python3中,所有str对象都是unicode编码,这是为了使不同国家语言可以互通,unicode编码一般是2个字节编码1个字符。而在传输、保存数据的时候,需要把unicode编码的字符转换成其他的编码方式,英文可以转换成ascii或者utf-8,中文可以转换成gb2312或者utf-8,变成可传输的字节流。使用不同的编码方式,1个字符使用的字节数量不同。一般情况下,我们都使用unicode和utf-8这两种,因为中文和英文都可以使用utf-8方式编码。即:str对象.encode('utf-8')可以变成字节流byte类型对象以b开头, byte对象.decode('utf-8')可以变成unicode字符的str类型对象用于计算机和程序的处理,所以在hello.py文件的开头都有:#coding:utf-8就是告诉python解释器:使用utf-8编码方式来decode到unicode来处理,然后将unicode的数据encode到utf-8来保存和传输====python的格式化字符串:last=72today=85rate=(today-last)/lastprint('小明的成绩从去年的%d分提升到了今年的%d分,增长百分比是:%.1f%%' %(last,today,rate))6、list和tuple====list的性质:list是python的内置数据类型,翻译成列表或者数组。list是一组数据或者一组对象或者一组元素的序列,同样的元素不同的排列是不同的列表。列表的元素数量可以通过len(a)来获得,list是可变长数组,可以随时通过append在末尾增加元素,通过pop(i)弹出位置i的元素默认是末尾,通过insert(i,xx)在位置i插入xx元素。除此之外,list还是混合类型数组,即数组内部可以允许不同类型的元素,如:a=[1,True,'abc',2.2],此时的a是一个指向一个list地址的变量(性质上是指针)。list通过下标0~len-1的范围来获取每一个元素。list可以通过-1,-2来从尾部开始获取元素,-1表示倒数第1个元素,-2表示倒数第2个元素,以此类推。list中可以放任何类型的对象,除了python内置的整数、浮点数、布尔值、字符串等,还可以是list,tuple,dict,其他自定义数据类型等等。如果list中还有一个list,则意味着内部的list是一个二维数组,如果内部list的一个对象还是一个list,则最内部list是三维数组,以此类推,通过a[1][2]来获取二维数组的元素。====tuple的性质:tuple的性质和list很相似,最大的不同在于tuple更严格、更安全、数据只能取不能增删改,即tuple一旦初始化后则无法改变内容,而list可以随时增删改元素。====注意:二义性的tuple符号:list在创建的时候使用[],tuple在创建的时候使用(),如果是创建一个空list则是a=[],如果是创建空tuple则是a=(),如果创建一个只含有1个元素的tuple,不应该写成a=(1)这会被python解释成a=1,a是一个int类型的对象因为python遇到()的时候有二义性,到底是tuple还是普通的小括号,python规定当做小括号使用,所以声明一个只有1个元素的tuple应该是:a=(1,)注意不要缺少这个逗号。====注意:“可变的”tupletuple的不可修改指的是每一个tuple中的元素所指向的对象都不发生地址变化,但是所指向的对象的内容却可以改变,如:a=('a','b',['A','B'])a[2][0]='X'a[2][1]='Y'print(a) -- > ('a','b',['X','Y'])这种修改是合法的,因为对于tuple a而言,a[2]这个元素地址并没有发生改变,即并没有指向其他的list,而这个未改变地址的list的内容发生改变并不影响tuple的规定。7、条件判断if,elif,else判断语句,用于分支判断,if可以理解成判断后面的语句是否为真,如果是真则执行if语句块,如果不为真就一定为假,则执行else语句块,使用elif可以增加多个判断条件。连用多个if和elif的判断逻辑类似于ACL访问控制列表,判断顺序也是自上而下,一条没有满足即顺延到下一条判断条件,一旦某一条判断条件是真,则不再进行后续判断,如果所有if和elif都判断为假,则用最后的else作为permit any含义。注意条件判断后面不要遗漏:冒号,条件判断还可以简写成if x: 这个x只要是非零整数、非空列表、非空tuple、非空字符串等等,都认为是True,否则认为是False。input()函数用于获取用户输入,无论用户输入的是数字、字符、还是字符串等等,都被input函数以str的类型返回。可以通过eval()函数获取一个字符串的值,如:'2'就是2,'a'会得到变量a8、循环python中的循环有两类====for循环:for循环用于遍历一个序列,将序列中的每一个元素赋值给自定义的变量以便操作序列中的所有元素值,如:注意:一般会使用list(range(10))来构造一个10个元素的列表,因为从0开始所以是0~9的10个元素。for循环的循环执行依赖于明确的范围遍历(无法依赖条件判断)====while循环:while循环的执行依赖于while关键字后面的条件判断,当为真的时候执行循环体,执行完毕后再次条件判断,为假的时候跳出循环,所以循环体内部需要有一定的限制条件或者手段来保证有限次的循环后可以跳出,即while循环的执行依赖于条件判断+循环体内部限制条件注意:跳出while循环的时候,一定是第一次不满足循环条件判断的时候====break:在循环体内部使用break可以跳出当前一层循环,用于特殊、有需要的程序执行分支流程====continue:在循环体内部使用continue可以省略剩余的循环体语句并立即开始下一次循环,如果是for就中断并提前遍历下一个元素,如果是while就中断并提前执行下一次条件判断注意:大量的、不加规划的使用break和continue的确会导致程序的逻辑、执行流程混乱,加重代码的复杂度以及后期debug的工作量。另外,就像无限迭代会导致机器崩溃一样,无限循环也会导致机器崩溃,所以编写循环首要注意的就是是否可以在必要的时候跳出循环体,尤其是while循环体中是否有足够的限制条件和手段。9、dict和set就像list和tuple非常的类似,并且都是python的内置数据类型一样。dict和set也是python的内置数据类型,也一样非常类似。====dict:dict在python中称为字典,是一种key-value对,其实类似于哈希表,即一个输入(key),有着唯一的输出(value),中间通过hash算法来完成唯一的映射。dict使用{}来表示,里面填写每一个key-value对使用逗号分隔。dict中的key就是哈希表中的输入或者关键字,dict使用哈希算法将key映射成唯一的内存地址,该内存地址上可以保存其他对象即value,所以key被要求不可变(即一旦初始化即不可再改变),如整数、字符串、元祖tuple等等,而value的值却是可变的,但若value变化多次则会以最后一次的值为准。在dict中,key是没有排序的,即无法使用dict[0]这种类似list和tuple的方式来获取第1个元素,dict只能使用d[key名称]的形式来获取这个key所对应的value。dict使用d[key名称]=value的方式来为一个dict新增键值对,也可以使用del d[key]的方式删除一个键值对,或者是d.pop(key)的方式弹出一个键值对,dict使用d[key名称]的方式来访问这个key对应的value,如果没有该key则会报错,所以访问方式还可以是:key in d 使用布尔判断是否含有此key,或者是d.get(key,-1)获取d的key的value,如果没有key则返回-1,默认返回None无法在python解释器中显示结果。遇到任何有联系的两个对象,都可以使其一成为key,另一个成为value放入dict中,在dict中的查找速度是非常快的基本等于O(1)。====set:set在python中称为集合,更确切的说,就是一些不重复的对象的集合,之所以不说是序列,是因为set是无序的,即无法使用s[0]这种序列访问方式来访问,就像dict一样,也是无序的。同时,set的构造使用{}来表示,和dict一样,但是set的对象并不是dict那样的键值对,事实上,set的对象只有key而没有value。可以使用s=set(某个序列)函数来构造一个集合,输入需要是一个序列,可以是list、tuple、range(10)等。set最重要的特性是:1、set中对象无重复2、set作为集合,可用于数学上的集合运算,如交集&,并集|交集:取s1和s2中共有的部分作为结果,即交集是s1的子集,也是s2的子集并集:将s1和s2所有元素整合并消除重复,即s1是并集的子集,s2页是并集的子集3、set可以增加或者减少对象,s.add(100), s.remove(2)如果新增多个重复的对象,set会自动过滤====注意:关于不可变对象:首先,对象不可变指的是某个对象一旦被构造并被初始化值之后,就不能再改变这个对象的地址以及这个对象的值,如:整数、字符串、tuple、dict的key等等。其次,不可变对象的一些函数如果涉及到需要改变对象的值,则一般会复制一份同值的对象并返回,而原来的不可变对象还是没有改变值,以此来保证对象的不可变性。对于可变对象,对象的函数如果涉及改变对象的值,则直接在原有对象上进行改变。如:因为str1不可变,所以replace涉及修改值的时候返回了另一个对象因为list1可变,所以直接在list1对象上直接修改值,并不返回另一个对象

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册