首页 文章 精选 留言 我的

精选列表

搜索[知识管理],共10010篇文章
优秀的个人博客,低调大师

JS基础知识整合

1、执行环境:有时也叫环境,是JavaScript中最为重要的一个概念,执行环境定义了变量或函数有权访问的其他数据。 2、变量对象:每一个执行环境都有一个与之关联的变量对象,环境中定义的所有的变量和函数都保存在这个的对象中。 3、作用域链:代码在环境中执行时,会创建变量对象的作用域链,保证对执行环境有权访问的所有变量和函数的有序访问。作用域链的前端,始终是当前执行代码所在环境的变量对象。 4、活动对象:如果当前执行环境是函数,则将活动对象作为变量对象。 5、可执行代码: 1)全局代码:例如加载外部的JS文件或者本地标签内的代码,全局代码不包括function体内的代码; 2)函数代码:function体内的代码; 3) eval代码:eval()函数计算某个字符串,并执行其中的JS代码,比如 eval("alert('helloworld')")。 6、执行上下文栈:在一个JS程序中,必定会产生多个执行上下文,JS引擎会以栈的方式来处理它们,也就是执行上下文栈。 7、作用域:JS是一种没有块级作用域的语言(包括if、for等语句的花括号代码块或者单独的花括号代码块都不能形成一个局部作用域),所以js的局部作用域的形成有且只有函数的花括号内定义的代码块形成的,既函数作用域。 8、作用域链:是作用域规则的实现,通过作用域链的实现,变量在它的作用域内可被访问,函数在它的作用域内可被调用。 作用域链是一个只能单向访问的链表,这个链表上的每个节点就是执行上下文的变量对象,单向链表的头部(可被第一个访问的节点)始终都是当前正在被调用执行的函数的变量对象(活动对象),尾部始终是全局活动对象。 9、闭包:函数对象可以通过作用域链相互关联起来,函数体内的数据(变量和函数声明)都可以保存在函数作用域内,这种特性在计算机科学文献中被称为“闭包”。 从技术角度来说,JS的函数都是闭包:函数都是对象,都关联到作用域链,函数内数据都被保存在函数作用域内。

优秀的个人博客,低调大师

线程最最基础的知识

Java 多线程系列文章第 5 篇。 什么是线程 试想一下没有线程的程序是怎么样的?百度网盘在上传文件时就无法下载文件了,得等文件上传完成后才能下载文件。这个我们现在看起来很反人性,因为我们习惯了一个程序同时可以进行运行多个功能,而这些都是线程的功劳。 之前的文章 进程知多少 中讲到,为了实现多个程序并行执行,引入了进程概念。现在引入线程是为了让一个程序能够并发执行。 线程的组成 线程ID:线程标识符。 当前指令指针(PC):指向要执行的指令。 寄存器集合:存储单元寄存器的集合。 堆栈:暂时存放数据和地址,一般用来保护断点和现场。 线程与进程区别 线程和进程之间的区别,我觉得可以用这个例子来看出两者的不同,进程就是一栋房子,房子住着 3 个人,线程就是住在房子里的人。进程是一个独立的个体,有自己的资源,线程是在进程里的,多个线程共享着进程的资源。 线程状态 我们看到 Java 源代码里面,线程状态的枚举有如下 6 个。 public enum State { //新建状态 NEW, //运行状态 RUNNABLE, //阻塞状态 BLOCKED, //等待状态 WAITING, //等待状态(区别在于这个有等待的时间) TIMED_WAITING, //终止状态 TERMINATED; } 下面给这 6 个状态一一做下解释。 NEW:新建状态。在创建完 Thread ,还没执行 start() 之前,线程的状态一直是 NEW。可以说这个时候还没有真正的一个线程映射着,只是一个对象。 RUNNABLE:运行状态。线程对象调用 start() 之后,就进入 RUNNABLE 状态,该状态说明在 JVM 中有一个真实的线程存在。 BLOCKED:阻塞状态。线程在等待锁的释放,也就是等待获取 monitor 锁。 WAITING:等待状态。线程在这个状态的时候,不会被分配 CPU,而且需要被显示地唤醒,否则会一直等待下去。 TIMED_WAITING:超时等待状态。这个状态的线程也一样不会被分配 CPU,但是它不会无限等待下去,有时间限制,时间一到就停止等待。 TERMINATED:终止状态。线程执行完成结束,但不代表这个对象已经没有了,对象可能还是存在的,只是线程不存在了。 线程既然有这么多个状态,那肯定就有状态机,也就是在什么情况下 A 状态会变成 B 状态。下面就来简单描述一下。 结合下图,我们 new 出线程类的时候,就是 NEW 状态,调用 start() 方法,就进入了 RUNNABLE 状态,这时如果触发等待,则进入了 WAITING 状态,如果触发超时等待,则进入 TIMED_WAITING 状态,当访问需要同步的资源时,则只有一个线程能访问,其他线程就进入 BLOCKED 状态,当线程执行完后,进入 TERMINATED 状态。 其实在 JVM 中,线程是有 9 个状态,如下所示,有兴趣的同学可以深入了解一下。 javaClasses.hpp enum ThreadStatus { NEW = 0, RUNNABLE = JVMTI_THREAD_STATE_ALIVE + // runnable / running JVMTI_THREAD_STATE_RUNNABLE, SLEEPING = JVMTI_THREAD_STATE_ALIVE + // Thread.sleep() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_SLEEPING, IN_OBJECT_WAIT = JVMTI_THREAD_STATE_ALIVE + // Object.wait() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_INDEFINITELY + JVMTI_THREAD_STATE_IN_OBJECT_WAIT, IN_OBJECT_WAIT_TIMED = JVMTI_THREAD_STATE_ALIVE + // Object.wait(long) JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_IN_OBJECT_WAIT, PARKED = JVMTI_THREAD_STATE_ALIVE + // LockSupport.park() JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_INDEFINITELY + JVMTI_THREAD_STATE_PARKED, PARKED_TIMED = JVMTI_THREAD_STATE_ALIVE + // LockSupport.park(long) JVMTI_THREAD_STATE_WAITING + JVMTI_THREAD_STATE_WAITING_WITH_TIMEOUT + JVMTI_THREAD_STATE_PARKED, BLOCKED_ON_MONITOR_ENTER = JVMTI_THREAD_STATE_ALIVE + // (re-)entering a synchronization block JVMTI_THREAD_STATE_BLOCKED_ON_MONITOR_ENTER, TERMINATED = JVMTI_THREAD_STATE_TERMINATED }; Java 线程实现 下面讲一讲在 Java 中如何创建一个线程。众所周知,实现 Java 线程有 2 种方式:继承 Thread 类和实现 Runnable 接口。 继承 Thread 类 继承 Thread 类,重写 run() 方法。 class MyThread extends Thread { @Override public void run() { System.out.println("MyThread"); } } 实现 Runnable 接口 实现 Runnable 接口,实现 run() 方法。 class MyRunnable implements Runnable { public void run() { System.out.println("MyRunnable"); } } 这 2 种线程的启动方式也不一样。MyThread 是一个线程类,所以可以直接 new 出一个对象出来,接着调用 start() 方法来启动线程;而 MyRunnable 只是一个普通的类,需要 new 出线程基类 Thread 对象,将 MyRunnable 对象传进去。 下面是启动线程的方式。 public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); Thread myRunnable = new Thread(new MyRunnable()); System.out.println("main Thread begin"); myThread.start(); myRunnable.start(); System.out.println("main Thread end"); } } 打印结果如下: main Thread begin main Thread end MyThread MyRunnable 看这结果,不像咱们之前的串行执行依次打印,主线程不会等待子线程执行完。 敲重点:不能直接调用 run(),直接调用 run() 不会创建线程,而是主线程直接执行 run() 的内容,相当于执行普通函数。这时就是串行执行的。看下面代码。 public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); Thread myRunnable = new Thread(new MyRunnable()); System.out.println("main Thread begin"); myThread.run(); myRunnable.run(); System.out.println("main Thread end"); } } 打印结果: main Thread begin MyThread MyRunnable main Thread end 从结果看出只是串行的,但看不出没有线程,我们看下面例子来验证直接调用 run() 方法没有创建新的线程,使用 VisualVM 工具来观察线程情况。 我们对代码做一下修改,加上 Thread.sleep(1000000) 让它睡眠一段时间,这样方便用工具查看线程情况。 调用 run() 的代码: public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); myThread.setName("MyThread"); Thread myRunnable = new Thread(new MyRunnable()); myRunnable.setName("MyRunnable"); System.out.println("main Thread begin"); myThread.run(); myRunnable.run(); System.out.println("main Thread end"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } class MyThread extends Thread { @Override public void run() { System.out.println("MyThread"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } class MyRunnable implements Runnable { public void run() { System.out.println("MyRunnable"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果: main Thread begin MyThread 只打印出 2 句日志,观察线程时也只看到 main 线程,没有看到 MyThread 和 MyRunnable 线程,印证了上面咱们说的:直接调用 run() 方法,没有创建线程。 下面我们来看看有 调用 start() 的代码: public class ThreadImpl { public static void main(String[] args) { MyThread myThread = new MyThread(); myThread.setName("MyThread"); Thread myRunnable = new Thread(new MyRunnable()); myRunnable.setName("MyRunnable"); System.out.println("main Thread begin"); myThread.start(); myRunnable.start(); System.out.println("main Thread end"); try { Thread.sleep(1000000); } catch (InterruptedException e) { e.printStackTrace(); } } } 运行结果: main Thread begin main Thread end MyThread MyRunnable 所有日志都打印出来了,并且通过 VisualVM 工具可以看到 MyThread 和 MyRunnable 线程。看到了这个结果,切记创建线程要调用 start() 方法。 今天就先讲到这,继续关注后面的内容。 推荐阅读 老板叫你别阻塞了 吃个快餐都能学到串行、并行、并发 泡一杯茶,学一学同异步 进程知多少? 设计模式看了又忘,忘了又看? 后台回复『设计模式』可以获取《一故事一设计模式》电子书 觉得文章有用帮忙转发&点赞,多谢朋友们!

优秀的个人博客,低调大师

几个集合工具知识回顾

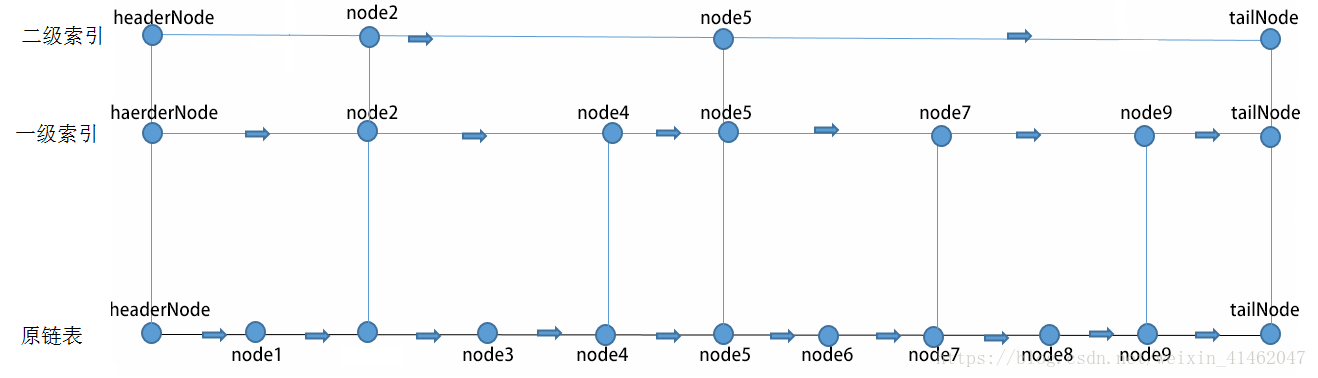
以前看过一些JDK源码,最近回顾了一下笔记,所以在这里对几个常见的集合工具做个记录。 一、跳表 跳表SkipList就是有序链表+二分搜索的组合。它的效率可以做到和二分相同,时间复杂度是O(logn),空间复杂度是O(n)。 它的基本特征是: 它是一个多层结构,每一层都是一个有序链表,且至少包含两个链表节点(头head节点和尾tail节点); 如果一个元素出现在某一层的链表中,那么在该层之下的链表也全都会出现(上一层的元素是当前层的元素的子集),最底层的链表包含了所有的元素; 链表中的每个节点都包含两个指针,一个指向下一个兄弟链表节点,一个指向下一层的子链表节点; 理想情况下,第二层只有第一层一半的节点数,而且均匀间隔,第三层则是1/4的节点数,以此类推,这样理想的层数就是logN。 工作过程: 搜索过程很简单,就是从最高层链表开始,如果比当前节点大、比下一个节点小,那么去下一层查找,以此类推,一直找到最底层的最后一个节点; 插入过程需要确定插入的层数,通常给定一个统计概率p,产生一个0到1之间的随机数,如果这个随机数小于p,则将高度加1,直到产生的随机数大于概率p才停止。当概率为1/2或者是1/4的时候,整体的性能会比较好(当p为1/2的时候,也就是抛硬币的方法了)。而后,就是将元素插入到从最底层到第k层; 1.ConcurrentSkipListMap ConcurrentSkipListMap内部的数据结构就是Index,它是跳表中的索引,本身是一个bucket(KV链表),同时包含右指针和下指针。它通过HeadIndex(包含level层级)作为跳表每层的头结点,将整张表拎出来。 先说删除操作,对于跳表而言主要是定位待删结点+删除该结点的一个复合操作,而在并发跳表中则是这样: ⑴ 先通过key和HeadIndex定位到待删除节点(二分搜索定位,比较器比较key是否相等); ⑵ 将待删结点value值置为null(即标记待删除),失败则自旋; ⑶ 向待删结点的next后继位置新增一个空的marker标记结点(用于分散并发冲突,即key值是否对应、value值是否为null、marker节点为空,如果不是则重试); ⑷ 断链操作,让待删结点的pre前驱节点越过本身指向后继结点(非marker节点),那么待删结点和marker标记结点将游离结点,最终被GC掉; 插入操作类似,简单来说就是:先通过概率随机得到level值,然后新增一个结点到最底层的链表上,并新增一个纵向的引用关联,最后链接各个索引层次上的新节点。 二、哈希表 HashMap的底层是基于“数组+链表”组成的,不过在JDK1.7和1.8中具体实现稍有不同。 默认的负载因子0.75(4/3),默认容量为16,也就意味着当容量达到了16*0.75=12就需要进行2的n次幂扩容,rehash、数据拷贝而耗性能,所以对大数据、性能敏感的应用通常提前预估好HashMap大小,减少rehash次数。 工作过程:对传入key值做hash运算,而后与数组长度取模得到数组下标index。因为性能问题,HashMap规定数组的长度为2次幂,这样用2^n-1做位运算与取模效果一致,并且效率还要高的多。而判定key值是否相等的条件,是hashcode+key。 谈hashmap就不得不说它存在的这两个问题: 链表过深: 当hash冲突严重时,每个桶的链表越来越深,遍历效率越来越低。而在Java7之后,通过红黑树来对大链表做优化,提升查询效率。 比如在put时,如果当前bucket(链表)的大小大于阈值(默认是8)时,将其转为红黑树;而get时,判断当前Node如果是TreeNode就按照树的方式查找,不是则按照链表的方式遍历查找。 并发时环形链表: 在rehash时,链表拷贝是逐个进行的(头插法),这意味着顺序会颠倒。如果这个时候刚好有另外一个线程在操作,就可能会出现A->B->A的情况,即环形链表。 这个问题在Java8得到了解决,通过尾插法,使用2次幂扩展长度的方式,即用key的高位运算结果,如果扩容后判断原来hash值新增的1个bit是0还是1,0的话索引没变,1的话变成“原索引+oldCap”。这样就省去了重新hash值的操作和时间,避免了环形链表的问题。 一般在JDK集合类里都会有“Fail-Fast机制”,这在hashmap里也有: 快速失败策略在源码中的实现是通过modCount域,就是修改次数,对HashMap内容的修改都将增加这个值,那么在迭代器初始化过程中会将这个值赋给迭代器的expectedModCount。在迭代过程中,判断modCount跟expectedModCount是否相等,如果不相等就表示已经有其他线程修改了Map。 注意:经管modCount被声明为volatile,保证线程之间修改的可见性。但迭代器的快速失败行为并不能得到保证,比如,存在非同步的并发修改的时候。 1.ConcurrentHashMap ConcurrentHashMap由Segment[]数组+里面的Entry组成,通过锁分段的方式来降低并发度(16等分,每个Segment一个ReentrantLock)。即:并发读不加锁,并发写对操作的segment加独占锁。ConcurrentHashMap也有全量锁的时候,比如扩容、rehash的时候。主要目标还是最小化更新竞争的同时保持并发可读性,使得空间消耗与HashMap大致相同。 工作过程: 1)put时,第一次hash确定key在哪个segment中; 2)tryLock尝试获取锁,失败则阻塞(Java7是会自旋一阵而后升级为阻塞锁,默认是64次); 3)而后第二次hash在segment中确定key在链表的哪个Entry链表中; 4)遍历判断hashcode和key值是否相等,相等就覆盖,不相等就new一个; 5)最后判断要不要扩容,在返回前解锁分段锁。 在Java8之后,ConcurrentHashMap的数据结构发生了很大变化,首先抛弃了分段锁的方案,使用Unsafe的CAS+阻塞锁。虽然仍是Node数组+链表的形式,但将锁分段更细化了。 工作过程:如果根据key定位是一个空的话,尝试利用CAS new一个新的bucket,失败则自旋保证;如果不是空的话,则对链表头加阻塞锁,使用同步块来细化。实际上,在每一个桶中,头node都作为这个bucket的锁而锁住整个bucket。这样的策略,使得对HashMap的并发粒度呈线性减低,因为一个桶中node节点不会太多,不会总是冲突,扩容时更会均匀打散,当链表过深时(默认为8)则用红黑树保证查询效率。 跨段操作: 某些操作需要涉及到多个segment,比如size()。HashMap统计各个bucket基本的思路是“提前做”,结构性更新时对计数器加1减1,而在ConcurrentHashMap中因为存在并发,情况就不同了。 在JDK1.7中,先不加锁计算三次,比较前后计算结果,结果一致就认为是准确的,不一致就对Segment加锁再计算; 在JDK1.8之后,先CAS的对baseCount加减,如果CAS失败,则自旋对counterCells加减(每个bucket一个counterCells)。然后在调用size()或mappingCount()的时候,累加baseCount和counterCells数组。 三、延时队列 这里,我们不妨先谈谈优先级队列。 1.PriorityQueue PriorityQueue是一个优先级的无界队列,意味着每次从队列取出的都是最小的元素。内部使用小顶堆来实现。 工作过程: PriorityQueue的建堆过程和大顶堆的建堆过程基本一样,从上往下做siftDown操作。siftDown的过程就是将一个节点和它的左右子节点进行比较,然后和最小的子节点交换位置,一直向下到叶子节点,保证它比它所有的子节点都要小。 而每次添加新元素实际上是在数组的后面追加。先判断数组长度是否需要扩容,而后做siftUp操作。和siftDown类似,一个节点和它的父节点比较,如果果它比父节点小则交换位置,一直向上到根节点这样,就变成符合条件的小顶堆了。 默认情况下元素采用自然顺序升序排序。默认的长度为11,扩容时若容量小于64,则新容量是oldCap * 2 + 2,否则是oldCap * 1.5。即容量越小增长得越快。 PriorityQueue在JDK中对应的实现类是PriorityBlockingQueue,优先级的无界阻塞队列。与ConcurrentHashMap不同,PriorityBlockingQueue在扩容时没有全量锁的时候,事实上为了获得更好的并发性,在扩容开始时PriorityBlockingQueue就释放了全局锁,后面的扩容操作通过乐观锁来进行并发控制。 2.DelayQueue DelayQueue等同于BlockingQueue + PriorityQueue + Delayed接口。 DelayQueue是一个延时的无界阻塞队列。其实就是使用PriorityQueue进行元素的排序,以元素过期时间为排序条件,以ReentrantLock作为主锁,即头元素是最先过期的元素。它会根据time的先后时间排序,若time相同则根据sequenceNumber序号排序。 DelayQueue核心字段是:全局独占锁,优先级队列(用于存储元素),leader即当前消费者线程,和available条件变量。DelayQueue的内部实现,其实就是你在offer一个过期时间为N的元素时,先入优先级队列,之后你take一个任务的时候,判断列表头的到期时间,到期就去消费,没到期则通过available条件变量进行await阻塞等待,过N个时间单位到期唤醒后再去消费。 具体的工作过程: 当你offer一个元素时: 1)先加锁,入优先级队列; 2)然后peek一下,如果队首元素是刚插入的元素,则设置leader为null,并唤醒阻塞在available上的线程进行消费; 3)释放锁; 当你要take一个元素时: 1)先加锁; 2)然后peek一下,如果队首元素为空则阻塞,不为空则获取队首元素的超时时间,已超时则poll出队; 3)如果leader不为null,说明消费者线程已拿到锁,阻塞当前线程; 4)如果leader为null则将leader指向当前线程,阻塞等待剩余的到期时间,唤醒后将leader置为null。这时再判断一次,如果leader为null并且队列不为空,说明没有其他线程在等待,则唤醒available上的线程; 5)释放锁; 3.TimingWheel JDK的Timer和DelayQueue插入和删除操作的平均时间复杂度为O(nlogn),不能满足一般分布式系统的性能要求,而基于时间轮(TimingWheel)算法则可以将插入和删除操作的时间复杂度降为O(1)。 Kafka中的时间轮(TimingWheel)是一个存储定时任务的环形队列,队列中的每个元素是一个用于存储定时任务的双端链表,链表中的每一项就是定时任务项,里面是真正的定时任务。 环形队列中的每个元素就是一个个时间格,每个时间格代表当前时间轮的基本时间跨度(tickMs)。时间格的个数是固定的(wheelSize),整个时间轮的总体时间跨度(interval)为 tickMs × wheelSize。时间轮有一个表盘指针(currentTime),表示时间轮当前所处的时间,它是tickMs的整数倍。currentTime指向的当前时间格,就需要处理此时间格所对应的TimerTaskList的所有任务。 时间轮 = 时间格(环形队列) » 定时任务列表(双端链表) » 定时任务项 初始情况下表盘指针currentTime指向时间格0。当对某个时间格做相应的到期操作时,同时有定时任务插入,则复用时间轮,这就是环形队列的好处了。整个时间轮的总体跨度是不变的,随着指针currentTime的推进,当前时间轮所能处理的时间段也在不断后移。 对于每个使用到的TimerTaskList都会加入到DelayQueue中,根据TimerTaskList对应的到期时间来排序,这意味着最短到期时间的会在列表头,优先执行。 超长任务问题:现在看来情况良好,没有什么问题,但倘若有个定时时长大于或者远大于interval的任务进来,如果直接扩充wheelSize是没有底限的,而且对于超长定时任务,过多的内存占用,性能效率都不会太好。因此引入了层级时间轮的概念,通过时间轮升/降级来解决大于当前时间周期的定时任务。 当任务的到期时间超过了当前时间轮的时间跨度时,尝试添加到上层时间轮中。每一层时间轮的时间格个数wheelSize是差不多固定的,但上一层的基本时间跨度tickMs为下一层的总体时间跨度interval,以此类推。 你应该注意到,越上层的时间轮时间跨度越大,即便currentTime当前指向某个时间格,任务的到期操作也很难执行。这时又会有一个时间轮降级的动作,会将这个定时任务重新提交到下一层的时间轮中,依次类推。可想而知,底层的时间轮,基本时间跨度很小,比如在Kafka默认实现中,tickMs=1ms,wheelSize=20,而在Quartz中,tickMs=1ms,wheelSize=60,秒、分、时。 性能调优: 在插入任务之前先检查任务是否完成,因为存在有些任务超时直接就完成超时操作的场景; 每个双向链表TimerTaskList都会有一个哨兵节点,来简化边界条件。它是一个附加的链表节点,作为第一个节点,值域中并不存储任何东西; 每一层的currentTime都必须是tickMs的整数倍,这是用一个单线程来维护的,也叫“到期操作收割机”,通过“拨动”执行指针来触发定时任务; “空推进”问题: DelayQueue中的列表头到期时间是确定的,这里获取DelayQueue的队头只需要O(1)的时间复杂度,但如果是每秒定时推进的话,比如到期时间200s,那么获取到这个定时任务需要执行200次推进且有199次属于“空推进”,这样无疑会无故空耗机器的性能资源。 所以,为了避免“空推进”,引入DelayQueue来做时间“拨动”,以少量空间换时间,优化性能。简单来说就是,用时间轮TimingWheel来做任务的插入和删除操作,用延迟队列DelayQueue来做时间推进的工作。 4.RingBuffer 这里说的是Disruptor的RingBuffer,它不像传统的队列和其它RingBuffer,具有head、tail、count这三个指针,也是三个冲突点。每次操作元素时,入队列、出队列还有区分是否空队列都会有竞争,而且这三个变量,通常也在一个缓冲行里,又会有“伪共享”问题,无论操作哪一个都会导致其它缓存不命中。而而Disruptor的RingBuffer的优点是:通过减少竞争点,比如不删除数据而是直接覆盖,所以不需要tail尾指针;通过RingBuffer重复利用数组,来减少GC;利用数组对CPU Cache友好的特性,缓存行填充,来避免伪共享,提高效率。 伪共享问题: 缓存是由缓存行组成的,通常是64字节(比较旧的处理器缓存行是32字节),引用主内存中的一块地址。若数据结构中的项在内存中不是彼此相邻的(比如链表),就得不到这种缓存加载所带来的性能优势。 如果有一个单独的变量head,然后又有另一个变量紧挨着它,tail。那么当加载head到缓存的时候,也免费加载了tail。那么,如果你更新了head的值,缓存中的值和内存中的值都被更新了,再想要读tail值时,整个缓存行都要重新从内存中读取,也就意味着应用程序被缓存未命中给拖慢了。如果两个独立的线程同时写这两个不同的值会更糟,因为遇到两个线程之间的写冲突了,尽管它们写入的是不同的变量。这就叫作“伪共享”,无声的性能杀手。 一般的解决方案是,增大数组元素的间隔使得由不同线程存取的元素位于不同的缓存行上,以空间换时间。俗称“缓存行填充”,将32字节、64字节或者128字节填满,不填满一样有伪共享问题,但这肯定是会浪费空间的。在JDK1.7中,Sun官方提供了一个优化方案,通过添加@Contended注解,JVM会自动的进行缓存行填充,但应用程序运行时必须加上虚拟机参数-XX:-RestrictContended,这个注解才会生效。 Disruptor的RingBuffer,只需要一个序号指向下一个可用的空间,同时做缓存行填充,通过补全来确保RingBuffer的序号不会和其他东西同时存在于一个缓存行中,所以没有伪共享问题和非预期的竞争。 Disruptor的RingBuffer的工作原理,简单来说,就是把争抢多个窗口买票的行为,通过Barrier规范为:所有人先到Barrier处取号,然后凭序号去对应窗口买票。取号消耗的时间很短,一个Barrier就足够,而买票消耗时间很长,各个窗口独立服务。 具体的工作过程: 在定位元素时,与HashMap类似的,按size进行位运算来定位出数组的下标(所以数组长度也是2^n)。RingBuffer中每格都有序号,并用一个变量来指向可用的位置。 在插入元素时,为2阶段提交,首先申请sequence序号,如果发现所有数据都没被被消费,会等待(为了避免RingBuffer重叠)直到有可用的sequence;获取到可用的sequence后,再进行publish操作。 那么,Disruptor如何防止多个线程重复写同一个元素呢?在多个生产者的情况下,Disruptor让每个线程获取不同的一段数组空间进行操作,就是在分配元素的时候,通过CAS判断一下这段空间是否已经分配出去即可。但这样做,意味着很有可能出现“脏读”,读到还未写的旧数据。“如何防止读取的时候读到还未写的元素”,Disruptor是这样做的,在多个生产者的情况下,引入了一个与RingBuffer大小相同的buffer:available Buffer。当某个位置写入成功的时候,便把availble Buffer相应的位置标记为写入成功。读取的时候,会遍历available Buffer,来判断元素是否已经就绪。 Disruptor的等待策略: 名称 措施 备注 BlockingWaitStrategy 加锁 CPU资源占用少,延迟大、吞吐低 BusySpinWaitStrategy 自旋 通过自旋,来减少线程切换导致的系统调用。CPU资源占用高,延迟大 PhasedBackoffWaitStrategy 自旋+yield+自定义策略 混合上面多种策略,根据时间参数和传入的等待策略来决定使用哪种等待策略。 SleepingWaitStrategy 自旋+yield+sleep 多次自旋尝试不成功后,选择让出CPU,等待下次调度,多次调度后仍不成功,尝试睡眠一个纳秒级别的时间后再尝试。这种策略平衡了延迟和CPU资源占用,但延迟不均匀。 TimeoutBlockingWaitStrategy 加锁,有超时限制 相对于BlockingWaitStrategy来说,设置了等待时间,超时后抛异常 YieldingWaitStrategy 自旋+yield+自旋 多次自旋尝试不成功后,选择让出CPU,等待下次调度。这种策略平衡了延迟和CPU资源占用,延迟比较均匀。 四、COW列表 在更新时申请写锁,复制对象并修改,修改完毕后切换对象引用,而读取则不加锁。这种方式被称为“写时复制(copy-on-write)”,即COW机制。CopyOnWriteArrayList就是COW的典型实现。 CopyOnWriteArrayList的内部实现,拿add()方法来说,就是当对列表进行修改操作时,先lock一把(使用ReentrantLock),copy一个数组(使用Arrays.copyOf()方法,其内部使用System.arraycopy函数拷贝数据,因为是native方法,效率比普通数组拷贝效率要高),数组长度在当前基础上加1,然后在新数组追加新数据,再将该新数组的引用赋予当前数组,最后解锁。因为对更新操作是在副本中进行的,所以无锁,适合于读远多于写的情况。 与Java的COW不同的是,Linux下,不是直接将父进程的数据拷贝到子进程中,而是子进程共享父进程的物理空间,当父子进程有内存写入操作时触发异常中断,再将内存页复制一份。当我们通过fork()函数创建出的子进程,它会与父进程共享物理内存空间(其实是直接引用父进程的物理空间)。当父子进程中有更改数据段的行为发生时,再为子进程相应的分配物理空间。 具体来说,就是fork()之后,kernel把父进程中的内存页的权限都设为read-only,子进程的地址空间指向父进程。当父子进程都只读共享内存时,相安无事。当其中某个进程写内存时,CPU检测到内存页是read-only,触发页异常中断(page-fault),开始走kernel的一个中断例程。在中断例程中,kernel就会把触发异常的页复制一份,父子进程各自持有独立的一份。 这样做是为了减少不必要的资源分配,如果没有修改数据就不会有副本。

优秀的个人博客,低调大师

Kotlin 模糊知识

1,as 关键字的作用,表示强转类型,example 打开软键盘的代码 fun openKeyboard(context: Context, editText: EditText) { val imm = context.getSystemService(Context.INPUT_METHOD_SERVICE) as InputMethodManager imm.showSoftInput(editText, InputMethodManager.RESULT_SHOWN) imm.toggleSoftInput(InputMethodManager.SHOW_FORCED, InputMethodManager.HIDE_IMPLICIT_ONLY) } 解释:注意一点即可以观察出来,如果不进行强转,本身默认是 Object 类型,那么怎么会有 showSoftInput 方法和 toggleSoftInput 的方法呢。 2,object 关键字和 companion object 关键字都可以用来实现单例模式。不但如此,object 还常用来实现匿名内部类。 object 可以定义在全局也可以在类的内部使用 object 就是单例模式的化身 object 可以实现 Java 的匿名内部类 companion object 就是 Java 中的 static 变量 companion object 只能定义在对应的类中 tips:除此之外,除此之外,除此之外 object 可以作为变量的定义也可以是表达式 object 匿名类可以继承并超越 Java 中匿名类而实现多个接口 object 表达式当场实例化,但定义的 object 变量是延迟实例化的 object 匿名内部类还可以引用并更改局部变量 companion object 甚至还可以被扩展 object 可以实现 kotlin 的单例模式,可以定义在全局中,也可以定义在类的内部。但是需要注意: 1.object 定义后即刻实例化 2.因此 object 不能有定义构造函数 3.定义在类内部的 object 并不能访问类的成员 companion object 的定义完全属于类的本身,所以 companion object 肯定不能脱离类而定义在全局中。有些像 Java 中的 static 变量。也可以实现接口,因为 companion object 寄生于类,甚至类还可以直接作为相对应的接口的参数形式传入。 在 Java 中,内部类是不可以访问外部的非 final 成员变量的,也就是说:它不允许更改变量值!但是,kotlin 的 object 可以。 3,var 和 val 的唯一区别是 var 既有 getter 又有 setter,val 只有 getter 没有 setter。其中 val 与 Java 中的 final 不完全相同。只有一种情况他们完全相同,就是像 private val foo = 3 这样,以 private 修饰,赋予初始值,并且不提供自定义的 getter,不被委托的属性,这个属性完全等同于 Java 中的 private final int foo = 3。因为 kotlin 默认是 public 属性,如果是权限修饰符是 private 的话那么就不能外部访问,再加上是以 val 修饰的,所以没有 getter 和 setter 方法。 4,kotlin 中 open 关键字什么时候使用,init 关键字什么时候使用。 Kotlin 类默认是 final,这点可以自己尝试反编译下 Kotlin 代码就可以发现。所以如果你想扩展一个类的话,就必须使用 open 修饰符才行。 Kotlin 中的类可以有一个主构造器,以及一个或多个次构造器,主构造器是类头部的一部分,位于类名称之后 class Person constructor(firstName: String) {} 一般情况下 constructor 关键字可以省略。tips:主构造器中不能包含任何代码,初始化代码可以放在初始化代码段中,使用 init 关键字作为前缀。 class Person constructor(firstName: String) { init { System.out.print("FirstName is $firstName") } } 5,kotlin 代码转换成 Java 代码,选择 tools -> kotlin -> show kotlin bytecode (展示字节码文件) -> Decompile 即可以显示出来相对应的 Java 代码。 6,注意在 kotlin 中之所以可以直接访问属性名来获取值就是因为 kotlin 自动生成了 getter 和 setter 方法。

优秀的个人博客,低调大师

python 关键知识

学习资源:笨方法学习 python3 将变量传递给脚本——argv 脚本:你编写的 .py 文件。 argv 参数变量(argument variable)保存着你运行 python 脚本的参数。 input() 脚本运行过程需要输入参数 from sys import argv script, user_name = argv # 解包 prompt = '> ' # 提示符 print(f"Hi {user_name}, I'm the {script} script.") print("I'd like to ask you a few question.") print(f"Do you like me {user_name}?") likes = input(prompt) print(f"Where do you live {user_name}?") lives = input(prompt) print("What kind of computer do you have?") computer = input(prompt) print(f''' Alright, so you said {likes} about liking me. You live in {lives}. Not sure where that is. And you have a {computer} computer. Nice. ''') x = input('sd ffg') sd ffgdf type(x) str x 'df' echo 'This is a text file.' > a.txt # 创建文件 cat a.txt # 查看文件 man cat # 查看 cat 的帮助文档 函数中的 *args 告诉 python 把函数的所有参数都接收进来,然后放到名叫 args 的列表中去。 def print_two(*args): arg1, arg2 = args print(f'arg1: {arg1}, arg2: {arg2}') print_two('Zed', 'Shaw') arg1: Zed, arg2: Shaw 字符串 & 字节串 & 字符编码 import sys script, encoding, error = sys.argv def main(language_file, encoding, errors): line = language_file.readline() if line: print_line(line, encoding, errors) return main(language_file, encoding, errors) def print_line(line, encoding, errors): next_lang = line.strip() raw_bytes = next_lang.encode(encoding, errors = errors) cooked_string = raw_bytes.decode(encoding, errors = errors) print(raw_bytes, "<===>", cooked_string) languages = open('E:/Data/languages.txt', encoding = 'utf-8') main(languages, encoding, error) PowerShell: python .\str_bytes_test.py utf-8 strict def main(language_file, encoding, errors): line = language_file.readline() if line: print_line(line, encoding, errors) return main(language_file, encoding, errors) def print_line(line, encoding, errors): next_lang = line.strip() # 删除每行结尾的 "\n" raw_bytes = next_lang.encode(encoding, errors = errors) cooked_string = raw_bytes.decode(encoding, errors = errors) print(raw_bytes, "<===>", cooked_string) with open('E:/Data/languages.txt', encoding = 'utf-8') as fp: main(fp, 'utf-8', 'strict') b'Afrikaans' <===> Afrikaans b'\xe1\x8a\xa0\xe1\x88\x9b\xe1\x88\xad\xe1\x8a\x9b' <===> አማርኛ b'\xd0\x90\xd2\xa7\xd1\x81\xd1\x88\xd3\x99\xd0\xb0' <===> Аҧсшәа b'\xd8\xa7\xd9\x84\xd8\xb9\xd8\xb1\xd8\xa8\xd9\x8a\xd8\xa9' <===> العربية b'Aragon\xc3\xa9s' <===> Aragonés b'Arpetan' <===> Arpetan b'Az\xc9\x99rbaycanca' <===> Azərbaycanca b'Bamanankan' <===> Bamanankan b'\xe0\xa6\xac\xe0\xa6\xbe\xe0\xa6\x82\xe0\xa6\xb2\xe0\xa6\xbe' <===> বাংলা b'B\xc3\xa2n-l\xc3\xa2m-g\xc3\xba' <===> Bân-lâm-gú b'\xd0\x91\xd0\xb5\xd0\xbb\xd0\xb0\xd1\x80\xd1\x83\xd1\x81\xd0\xba\xd0\xb0\xd1\x8f' <===> Беларуская b'\xd0\x91\xd1\x8a\xd0\xbb\xd0\xb3\xd0\xb0\xd1\x80\xd1\x81\xd0\xba\xd0\xb8' <===> Български b'Boarisch' <===> Boarisch b'Bosanski' <===> Bosanski b'\xd0\x91\xd1\x83\xd1\x80\xd1\x8f\xd0\xb0\xd0\xb4' <===> Буряад b'Catal\xc3\xa0' <===> Català b'\xd0\xa7\xd3\x91\xd0\xb2\xd0\xb0\xd1\x88\xd0\xbb\xd0\xb0' <===> Чӑвашла b'\xc4\x8ce\xc5\xa1tina' <===> Čeština b'Cymraeg' <===> Cymraeg b'Dansk' <===> Dansk b'Deutsch' <===> Deutsch b'Eesti' <===> Eesti b'\xce\x95\xce\xbb\xce\xbb\xce\xb7\xce\xbd\xce\xb9\xce\xba\xce\xac' <===> Ελληνικά b'Espa\xc3\xb1ol' <===> Español b'Esperanto' <===> Esperanto b'\xd9\x81\xd8\xa7\xd8\xb1\xd8\xb3\xdb\x8c' <===> فارسی b'Fran\xc3\xa7ais' <===> Français b'Frysk' <===> Frysk b'Gaelg' <===> Gaelg b'G\xc3\xa0idhlig' <===> Gàidhlig b'Galego' <===> Galego b'\xed\x95\x9c\xea\xb5\xad\xec\x96\xb4' <===> 한국어 b'\xd5\x80\xd5\xa1\xd5\xb5\xd5\xa5\xd6\x80\xd5\xa5\xd5\xb6' <===> Հայերեն b'\xe0\xa4\xb9\xe0\xa4\xbf\xe0\xa4\xa8\xe0\xa5\x8d\xe0\xa4\xa6\xe0\xa5\x80' <===> हिन्दी b'Hrvatski' <===> Hrvatski b'Ido' <===> Ido b'Interlingua' <===> Interlingua b'Italiano' <===> Italiano b'\xd7\xa2\xd7\x91\xd7\xa8\xd7\x99\xd7\xaa' <===> עברית b'\xe0\xb2\x95\xe0\xb2\xa8\xe0\xb3\x8d\xe0\xb2\xa8\xe0\xb2\xa1' <===> ಕನ್ನಡ b'Kapampangan' <===> Kapampangan b'\xe1\x83\xa5\xe1\x83\x90\xe1\x83\xa0\xe1\x83\x97\xe1\x83\xa3\xe1\x83\x9a\xe1\x83\x98' <===> ქართული b'\xd2\x9a\xd0\xb0\xd0\xb7\xd0\xb0\xd2\x9b\xd1\x88\xd0\xb0' <===> Қазақша b'Krey\xc3\xb2l ayisyen' <===> Kreyòl ayisyen b'Latga\xc4\xbcu' <===> Latgaļu b'Latina' <===> Latina b'Latvie\xc5\xa1u' <===> Latviešu b'L\xc3\xabtzebuergesch' <===> Lëtzebuergesch b'Lietuvi\xc5\xb3' <===> Lietuvių b'Magyar' <===> Magyar b'\xd0\x9c\xd0\xb0\xd0\xba\xd0\xb5\xd0\xb4\xd0\xbe\xd0\xbd\xd1\x81\xd0\xba\xd0\xb8' <===> Македонски b'Malti' <===> Malti b'\xe0\xa4\xae\xe0\xa4\xb0\xe0\xa4\xbe\xe0\xa4\xa0\xe0\xa5\x80' <===> मराठी b'\xe1\x83\x9b\xe1\x83\x90\xe1\x83\xa0\xe1\x83\x92\xe1\x83\x90\xe1\x83\x9a\xe1\x83\xa3\xe1\x83\xa0\xe1\x83\x98' <===> მარგალური b'\xd9\x85\xd8\xa7\xd8\xb2\xd9\x90\xd8\xb1\xd9\x88\xd9\x86\xdb\x8c' <===> مازِرونی b'Bahasa Melayu' <===> Bahasa Melayu b'\xd0\x9c\xd0\xbe\xd0\xbd\xd0\xb3\xd0\xbe\xd0\xbb' <===> Монгол b'Nederlands' <===> Nederlands b'\xe0\xa4\xa8\xe0\xa5\x87\xe0\xa4\xaa\xe0\xa4\xbe\xe0\xa4\xb2 \xe0\xa4\xad\xe0\xa4\xbe\xe0\xa4\xb7\xe0\xa4\xbe' <===> नेपाल भाषा b'\xe6\x97\xa5\xe6\x9c\xac\xe8\xaa\x9e' <===> 日本語 b'Norsk bokm\xc3\xa5l' <===> Norsk bokmål b'Nouormand' <===> Nouormand b'Occitan' <===> Occitan b'O\xca\xbbzbekcha/\xd1\x9e\xd0\xb7\xd0\xb1\xd0\xb5\xd0\xba\xd1\x87\xd0\xb0' <===> Oʻzbekcha/ўзбекча b'\xe0\xa8\xaa\xe0\xa9\xb0\xe0\xa8\x9c\xe0\xa8\xbe\xe0\xa8\xac\xe0\xa9\x80' <===> ਪੰਜਾਬੀ b'\xd9\xbe\xd9\x86\xd8\xac\xd8\xa7\xd8\xa8\xdb\x8c' <===> پنجابی b'\xd9\xbe\xda\x9a\xd8\xaa\xd9\x88' <===> پښتو b'Plattd\xc3\xbc\xc3\xbctsch' <===> Plattdüütsch b'Polski' <===> Polski b'Portugu\xc3\xaas' <===> Português b'Rom\xc3\xa2n\xc4\x83' <===> Română b'Romani' <===> Romani b'\xd0\xa0\xd1\x83\xd1\x81\xd1\x81\xd0\xba\xd0\xb8\xd0\xb9' <===> Русский b'Seeltersk' <===> Seeltersk b'Shqip' <===> Shqip b'Simple English' <===> Simple English b'Sloven\xc4\x8dina' <===> Slovenčina b'\xda\xa9\xd9\x88\xd8\xb1\xd8\xaf\xdb\x8c\xdb\x8c \xd9\x86\xd8\xa7\xd9\x88\xdb\x95\xd9\x86\xd8\xaf\xdb\x8c' <===> کوردیی ناوەندی b'\xd0\xa1\xd1\x80\xd0\xbf\xd1\x81\xd0\xba\xd0\xb8 / srpski' <===> Српски / srpski b'Suomi' <===> Suomi b'Svenska' <===> Svenska b'Tagalog' <===> Tagalog b'\xe0\xae\xa4\xe0\xae\xae\xe0\xae\xbf\xe0\xae\xb4\xe0\xaf\x8d' <===> தமிழ் b'\xe0\xb8\xa0\xe0\xb8\xb2\xe0\xb8\xa9\xe0\xb8\xb2\xe0\xb9\x84\xe0\xb8\x97\xe0\xb8\xa2' <===> ภาษาไทย b'Taqbaylit' <===> Taqbaylit b'\xd0\xa2\xd0\xb0\xd1\x82\xd0\xb0\xd1\x80\xd1\x87\xd0\xb0/tatar\xc3\xa7a' <===> Татарча/tatarça b'\xe0\xb0\xa4\xe0\xb1\x86\xe0\xb0\xb2\xe0\xb1\x81\xe0\xb0\x97\xe0\xb1\x81' <===> తెలుగు b'\xd0\xa2\xd0\xbe\xd2\xb7\xd0\xb8\xd0\xba\xd3\xa3' <===> Тоҷикӣ b'T\xc3\xbcrk\xc3\xa7e' <===> Türkçe b'\xd0\xa3\xd0\xba\xd1\x80\xd0\xb0\xd1\x97\xd0\xbd\xd1\x81\xd1\x8c\xd0\xba\xd0\xb0' <===> Українська b'\xd8\xa7\xd8\xb1\xd8\xaf\xd9\x88' <===> اردو b'Ti\xe1\xba\xbfng Vi\xe1\xbb\x87t' <===> Tiếng Việt b'V\xc3\xb5ro' <===> Võro b'\xe6\x96\x87\xe8\xa8\x80' <===> 文言 b'\xe5\x90\xb4\xe8\xaf\xad' <===> 吴语 b'\xd7\x99\xd7\x99\xd6\xb4\xd7\x93\xd7\x99\xd7\xa9' <===> ייִדיש b'\xe4\xb8\xad\xe6\x96\x87' <===> 中文 现代的计算机本质上是一个巨大的开关阵列。计算机用电来触发这些开关的开启或关闭。这些开关用 1 表示开启、有电、接通,用 0 表示关闭、没电、切断。我们称这些 1 和 0 为『位』(bit)。 我们用「字节」(byte)表示一个 \(8\) 位(0 和 1)的序列。 美国信息交换标准代码(ASCII)把数字与字母相对应。 0b1011010 # 二进制的 90 90 ord('Z') # 字母 Z 的对应数字 90 chr(90) 'Z' 有了 ASCII 这个约定,我们就可以用 \(8\) 位(也就是 \(1\) 字节)编码一个字符,然后就可以把字符串联在一起,合成一个单词。例如:'Zed A. Shaw' 我们可以用一组字节序列来表示:[90, 101, 100, 32, 65, 46, 32, 83, 104, 97, 119],代码如下: [ord(name) for name in 'Zed A. Shaw'] [90, 101, 100, 32, 65, 46, 32, 83, 104, 97, 119] 再说一遍,类似上面的约定的序列最终还是会转换为开关的通断。 一个字节可以存放 \(256\)(即 \(2 ^ 8\))个数字:\[ 0 \sim 255 \; \text{或} \; 00000000 \sim 11111111 \] 为了统一编码方式,Unicode(universal encoding)便出现了。 UTF-8(Unicode Transformation Format 8 Bits):把大部分常用的字符用 \(8\) 位编码,如果需要编码更多的字符,就「逃」去使用更大的数;这种编码方式很大的程度节省了存储空间。 在 python 中,string 是 UTF-8 编码的字符序列,是显示和处理文本的基础。bytes 则是 python 用来存储 UTF-8 字符串的原始字节序列,使用b"" 表示字节串。 因而,如果要处理的是原始字节串(bytes),那么你就需要通过 .decode() 来获取字符串(string)。原始字节串不包含编码方式,它们就是字节序列,一堆数字而已,所以你必须告诉 python 把它解码成 UTF 字符串。即 解码字节串,编码字符串 (decode bytes, encode strings) 短路逻辑 任何以 False 开头的 and 语句都会直接处理成 False,不会继续检查后面的语句。 任何包含 True 的 or 语句,只要处理到 True,就不会继续向下推算,而是直接返回 True 了。 Python 只会运行它遇到的是 True 的第一个块,所以如果有多个 elif 块,只有第一个为 True 的块才会运行。 from sys import exit def glod_room(): print("This room is full of gold. How much do you take?") choice = input('> ') if '0' in choice or '1' in choice: how_much = int(choice) else: dead("Man, learn to type a number.") if how_much < 50: print("Nice, you're not greedy, you win!") exit(0) else: dead("You greedy bastard!") def dead(why): print(why, "Good Job!") exit(0) glod_room() This room is full of gold. How much do you take? > 7 Man, learn to type a number. Good Job! An exception has occurred, use %tb to see the full traceback. SystemExit: 0 C:\ProgramData\Anaconda3\lib\site-packages\IPython\core\interactiveshell.py:2971: UserWarning: To exit: use 'exit', 'quit', or Ctrl-D. warn("To exit: use 'exit', 'quit', or Ctrl-D.", stacklevel=1) exit(0) 可以中止某个程序,而其中的数字参数用来表示程序是否是遇到错误而中止的。exit(0) 表示程序正常退出。 if 语句的规则 每一条 if 语句必须包含一个 else。(为了防止出现未考虑到的条件出现) 若这个 else 永远都不应该被执行到,因为它本身没有任何意义,则必须在 else 语句后面使用一个叫 die 的函数,让它打印出出错消息并且「死」给你看。 if 语句的嵌套不要超过两层,最好尽量保持只有一层。 将 if 语句当作段落来对待,其中的每一个 if-elif-else 组合就跟一个段落的句子组合一样。在这种组合的最前面和最后面留一个空行以作区分。 你的布尔测试应该很简单,如果它们很复杂,你需要在函数里面将它们的运算顺序事先放到一个变量里,并且为变量取一个名字。 调试小技巧 最好的调试方法是使用 print 在各个要检查的关键点将变量打印出来,从而检查那里是否有错。 让程序一部分一部分地运行起来。不要等到写了一大堆代码文件后才去运行它们,写一点,运行一点,再修改一点。 .join() & .split() ten_things = 'Apples Oranges Crows Telephone Light Sugar' stuff = ten_things.split(' ') stuff ['Apples', 'Oranges', 'Crows', 'Telephone', 'Light', 'Sugar'] ' & '.join(stuff) 'Apples & Oranges & Crows & Telephone & Light & Sugar' 面向对象(OOP) 练习: import random from urllib.request import urlopen import sys WORD_URL = 'http://learncodethehardway.org/words.txt' WORDS = [] PHRASES = { 'class %%%(%%%):': "Make a class named %%% that is-a %%%.", 'class %%%(object):\n\tdef __init__(self, ***)': 'class %%% has-a __init__ that takes self and *** params.', 'class %%%(object):\n\tdef ***(self, @@@)': 'class %%% has-a function *** that takes self ang @@@ params.', '*** = %%%()': 'Set *** to an instance of class %%%', "***.***(@@@)": 'From *** get *** function, call it with params self, @@@.', "***.*** = '***'": "From *** get the attribute and set it to '***'." } # do they want to drill phrases(短语) first if len(sys.argv) == 2 and sys.argv[1] == 'english': PHRASES_FIRST = True else: PHRASES_FIRST = False # load up the words from website for word in urlopen(WORD_URL).readlines(): WORDS.append(str(word.strip(), encoding = 'utf-8')) def convert(snippet, phrase): class_names = [w.capitalize() for w in random.sample(WORDS, snippet.count("%%%"))] other_names = random.sample(WORDS, snippet.count("***")) results = [] param_names = [] for i in range(0, snippet.count('@@@')): param_count = random.randint(1, 3) param_names.append(', '.join(random.sample(WORDS, param_count))) for sentence in snippet, phrase: result = sentence[:] # fake class names for word in class_names: result = result.replace("%%%", word, 1) # fake other names for word in other_names: result = result.replace("***", word, 1) # fake parameter lists for word in param_names: result = result.replace("@@@", word, 1) results.append(result) return results # keep going until they hit CTRAL-D try: while True: snippets = list(PHRASES.keys()) random.shuffle(snippets) for snippet in snippets: phrase = PHRASES[snippet] question, answer = convert(snippet, phrase) if PHRASES_FIRST: question, answer = question, answer print(question) input("> ") print(f"ANSWER: {answer}\n\n") except EOFError: print('\nBye') 关于 class Name(object) 在 python 3 中,你不需要在类名后面添加 object,但是 python 圈子的人相信「显式优于隐式」,所以,一般还是需要写上。 关于 super() 在 python 3 中 super() 等价于 super(Child, self) class Parent(object): def altered(self): print("PARENT altered()") class Child(Parent): def altered(self): print("CHILD, BEFORE PARENT altered()") super(Child, self).altered() print("CHILD, AFTER PARENT altered()") dad = Parent() son = Child() dad.altered() print('=='* 20) son.altered() PARENT altered() ======================================== CHILD, BEFORE PARENT altered() PARENT altered() CHILD, AFTER PARENT altered() class Parent(object): def altered(self): print("PARENT altered()") class Child(Parent): def altered(self): print("CHILD, BEFORE PARENT altered()") super().altered() print("CHILD, AFTER PARENT altered()") dad = Parent() son = Child() dad.altered() print('=='* 20) son.altered() PARENT altered() ======================================== CHILD, BEFORE PARENT altered() PARENT altered() CHILD, AFTER PARENT altered() 探寻有趣之事!

优秀的个人博客,低调大师

CentOS基本操作与知识

首先我要说明的问题是对于centOS系统,我们不应该抱着浅尝辄止的态度,有时候有些东西必须要深入,要记录下来。我写这篇文章就是为了把我在学习过程中了解到的东西记录下来,防止以后我有用的时候能够迅速的拾起来! 首先就是对于ls这个基本命令的认识,这是学习Linux命令都是放在第一位去了解的。但是在这之前,我们先来了解一下CentOS系统的目录结构。我以前学的时候就是吃了这个亏,搞不懂目录结构,东西乱放还不知道放在哪里了,安装什么东西全靠教程去搞,很迷糊;下面就来说说这个非常简单的目录结构: 这个图片中root代表当前登录用户,localhost代表主机名, ~代表当前主机目录,#代表用户权限 #表示超级用户,$表示普通用户; 注意除了波浪号,我们发现还会有/的情况,这其实就是根目录。也就是说我们可以明白~和/是不一样的,明白了这一点,东西装在哪里就好说了,值得一提的是/root这个文件就是~代表的目录位置!也就是超级用户的家目录。 了解了这些,我们再来看一下对于LS的命令的一些使用: 我们用 -l 或者 -la 组合 列出详细信息; [root@localhost ~]# ls -l 总用量 4 -rw-------. 1 root root 1237 6月 10 05:24 anaconda-ks.cfg [root@localhost ~]# ls -la 总用量 24 dr-xr-x---. 2 root root 135 6月 11 21:13 . dr-xr-xr-x. 17 root root 224 6月 10 05:23 .. -rw-------. 1 root root 1237 6月 10 05:24 anaconda-ks.cfg -rw-------. 1 root root 0 6月 11 21:13 .bash_history -rw-r--r--. 1 root root 18 12月 29 2013 .bash_logout -rw-r--r--. 1 root root 176 12月 29 2013 .bash_profile -rw-r--r--. 1 root root 176 12月 29 2013 .bashrc -rw-r--r--. 1 root root 100 12月 29 2013 .cshrc -rw-r--r--. 1 root root 129 12月 29 2013 .tcshrc [root@localhost ~]# 这里第一列 比如dr-xr-xr-x. 代表文件类型以及所有者,所属组以及其他者权限 第一位d代表文件类型 常见的有 - 文件 d目录 | 软件链接文件 后面9位 每3位一个组 分别是 所有者u 所属组g 以及 其他者o的权限 权限分三种 r读 w写 x执行 比如dr-xr-xr-x 这个目录 所有者 所属组 以及其他者 都有 读和执行权限; 比如 -rw------- 这个文件 所有者有读写权限 所属组以及其他者没有权限; 第二列 那个数字 是 硬链接次数 后面再说; 第三列 root 是 所有者; 第四列 root 是 所属组; 第五列 是文件大小;假如看不惯 可用 ls -lh [root@localhost ~]# ls -lh 总用量 4.0K -rw-------. 1 root root 1.3K 6月 10 05:24 anaconda-ks.cfg 第六列的日期是该文件最后一次修改时间; 最后一列 是文件名称; 查看目录属性 要加 -d [root@localhost ~]# ls -ld /etc/ drwxr-xr-x. 78 root root 8192 6月 13 15:50 /etc/ [root@localhost ~]# 查看文件的inode属性 类似 主键 唯一识别文件的Id 用 -i [root@localhost ~]# ls -li 总用量 4 33574979 -rw-------. 1 root root 1237 6月 10 05:24 anaconda-ks.cfg [root@localhost ~]# 33574979 就是inode属性 以上就是ls的几个操作,觉得有用的话可以一起交流

优秀的个人博客,低调大师

区块链开发知识框架

区块链学习更多的是去理解这种去中心化的思想和去中心化的价值所在,语言倒是其次的东西。 不过由于以太坊和Hyperledger Fabric 对go语言支持最好,所以go语言肯定是要学习的。 下面把我另外一个问题的答案copy过来,希望对你有所帮助。 背景介绍:本人从2015年开始研究区块链技术,也算是对区块链有一定的了解吧。 申明:预估看到本问题的知乎er应该都是想要入门区块链,那么本回答也主要是进行一个入门级别的介绍。只是入门级别介绍,不适合区块链从业人员提升学习。 ----------------------------------- 回答的目录如下: 一、区块链是什么? 二、从业务角度学习区块链技术? 三、从技术角度学习区块链技术? 四、学习资料推荐与共享? ------------------------------------- 一、区块链是什

优秀的个人博客,低调大师

CSS相关知识

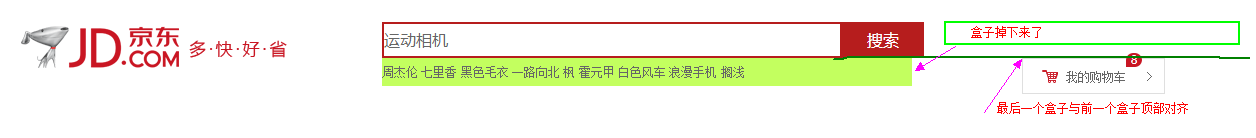
1、高和行高也可以撑开盒子,背景图不行。 2、文字若不设置行高,是包含文字的盒子的行高。 4、如果给了定位,但是没有给left,top等值,默认会腾出行内元素、padding的位置,有的时候我们可以使用这些特性,有的时候我们不熟悉的话可能产生bug。 5、较少功能使用较少代码(a代替ui>li>a) 6、如果盒子都是左对齐的话,最后一个盒子在右边的位置不够的话,会掉下来,如果第一个盒子A比第二个盒子B高,那么最后一个盒子C掉下来后跟第二个盒子B左对齐,而不是跟第一个盒子A左对齐。如果最后一个盒子C后面还有一个盒子D的话,D盒子的顶端跟C对齐。(下图 JD logo 是 A 盒子, 搜索框是 B 盒子, 周杰伦的歌是 C 盒子,我的购物车是 D 盒子。) 7、标准流中的文字不会被浮动的盒子盖住。所以一个大盒子中的小盒子要么都浮动要么都不浮动。 8、父盒子高度为0 ,子盒子如果是浮动的话不占位置,下面的标准流盒子将会跑到子盒子下面。 或者使用了定位,父盒子高度为0,然后子绝父相,下面的标准流盒子依然会跑到子盒子下面。 (这个可以做类似京东的侧边栏,如果侧边栏挡住了跑上来的标准流盒子,那么把包含标准流的整个大盒子定位:position: relative ,因为定位的层级高,所以就可以显示标准流的所有内容了。) 9、想要盒子随着界面变大变小,而盒子随着界面的中线能够移动的时候(类似定位/脱标的盒子居中对齐),不要加版心(margin: 0 auto;)。 10、父盒子有高度,但是子盒子太高,父盒子会被撑破;如果父盒子没有高度,那么父盒子会被撑开,是所有子盒子最高的高度。撑开的盒子可能会产生影响。(不要让浮动的盒子超出父盒子) 11、浮动盒子的相互影响,不管是否在一个大盒子里面(蓝盒子是包含在粉红盒子里面的,紫盒子和粉红盒子是并列的)。 12、谷歌浏览器不支持12号以下字体大小。 13、子盒子不占位置,父盒子高度为0,会导致下面的盒子顶上来了。(清除浮动) 14、curser: pointer; 模拟鼠标小手样式。 15、<a href=""></a> 如果 href 值为空,刷新页面。 如果 href 值为#,跳转到页面顶端,不刷新页面。 如果 href 值为javascript:; 或者javascript:void(0) ,不刷新页面,也不跳转。 16、定位的时候,left 的权限比 right 权限高,top 比 bottom 高,提高权限也没用。 17、图片半透明 opacity:0.4; 优点方便。缺点:里面的内容也会半透明。 CSS3的技术来解决半透明: background: rgba(0,0,0,0.3); background: rgba(0,0,0, .3); 18、行高可以继承。 19、如果一个大盒子装的是 li 标签,而且 li 标签是浮动的,如果 li 里面的内容超过了大盒子的话,会有 li 标签掉下来,如何使得所有的 li 标签在一行显示呢?用一个辅助盒子装下所有的 li 标签,然后大盒子只装辅助盒子,这样对于大盒子来说,所有的 li 标签都会在一行显示,即使大盒子很小。而辅助盒子可以使用 ul 来代替,给 ul 一个所有 li 加起来的宽度多一点即可,但是多的一点要少于一个 li 的宽度。 20、行内元素给了定位,不需要转block,只有static, relative定位的时候需要转 block。 21、盒子的border有重叠怎么办,可以往左上移动border的margin来覆盖。 22、background: url("spirit.png") -135px 0; 关于背景の问题: 有时候我发现background后面两个px可以调节位置,有的时候又必须使用left,top等调位置。其实后面的两个px本来就是调位置的,而且调的是整个背景的位置,当背景是整张图片的时候,调节这两个px就可以了,但是精灵图因为需要的只是背景图中的某一个区域,调节这两个px只是将选中的区域移动到定位的原点,然后再使用left,top等将选定的区域调节到定位的具体位置。

优秀的个人博客,低调大师

JSP必备知识

servlet VS CGI 1)servlet 可移植 跨平台 CGI 不行 2)在传统 CGI 中每个请求都要启动一个新进程,若 CGI 程序的本身执行时间较短,启动进程所需要的进行所需要的开销很可能反而超过实际执行的时间;servlet,每个请求由轻量级的 java 线程处理 3)在传统 CGI 中,若有 N 个并发的对同一个 CGI 的请求,该 CGI 的程序代码在内存中重载了 N 次,对于 servlet,处理请求的是 N 个线程,只要一份 servlet 类代码 如何实现 servlet 单线程模式 要实现单线程模式,可以在配置文件中修改 isThreadSafe 属性,比如,<%@page isThreadSafe=”false”%> servlet 页面间对象传递的方法有几种 用 request,session,application。Cookie 等方法实现页面间的对象传递。 jsp VS servlet jsp 是 servlet 技术的扩展,本质上是 servlet 的简单方式,jsp 编译后是“类 servlet”。他们最主要额不同在于:servlet 的应用逻辑在 java 文件中,并且完全从表示层中的 html 分离出来。Jsp 是 java 和 html 可以组合为一个扩展名为.jsp 的文件。Jsp 侧重视图, servlet 侧重控制逻辑。 <jsp:include page=”include.jsp” flash=”true”> <jsp:forword page=”next.jsp”> 前者页面不会转向 include 所指向的页面,只显示该页的结果,主页面还是原来的页面,指向完以后还会回来,相当于函数调用,并且可以带参数。后者完全转向新页面,不会再回来,相当于 goto 语句。 内置对象 1)request:用户端的请求,此请求会包含来着 get or post 请求的参数。 2)response:网页传回用户端的响应。 3)pageContext:网页的属性 4)session:与请求有关的会话 5)application:servlet 正在执行的内容 6)out:传送回应的输出 7)conig:servlet 的部件 8)page:gsp 网页本身 9)exception:网页错误 哪些动作(6 个) 1)jsp:include 在页面被请求时,引入一个文件 2)jsp:useBean 寻找 or 实例化一个 JavaBean 3)jsp:setProperty 这只 javaBean 的属性 4)jsp:getProperty 输出某个 javaBean 的属性 5)jsp:forword 把请求转到一个新页面 6)jsp:plugin 根据浏览器类型为 java 插件生成 object or embed 标配 动态 include 与静态 include 动态 include 用 jsp:include 动作实现,它总是会检查所包含文件中的变化,使用于包含动态页面 静态 include 用 include 伪码实现,不会检查所含文件的变化,适用于包含静态页面。

优秀的个人博客,低调大师

PHP知识点笔记

显示错误:PDOException could not find driver. 是表示PDO没有安装对应数据库的扩展,比如没有安装PDO_mysql http://pecl.php.net/package/PDO_MYSQL 下载源码 phpize ./configure --with-php-config=/usr/local/php/bin/php-config ./make ./make install phpExcel的使用需要使用到php的xmlreader和xmlwriter扩展 如果你是使用yum安装php 就直接使用yum install php-xml来进行安装 php的define不能重复定义 比如: 1 2 3 4 5 6 7 <?php define( "TEST" , "11" ); define( "TEST" , "22" ); echo TEST; 1 1 2 3 4 5 6 7 [yejianfeng@xen193v ~/handcode]$ php test.php PHP Notice: Constant TEST already defined in /home/yejianfeng/handcode/test.php on line 4 Notice: Constant TEST already defined in /home/yejianfeng/handcode/test.php on line 4 11 PHP如何获取本地所有变量 $localVariables = compact(array_keys(get_defined_vars())); 安装php模块可以这么安装 PHP_PDO_SHARED=1 pecl install pdo_mysql mysql的字符编码 mysql一般默认的客户端字符编码为:latin1 mysql的字符编码有几种: mysql> show variables like "character_set_%"; +--------------------------+----------------------------+ | Variable_name | Value | +--------------------------+----------------------------+ | character_set_client | utf8 | | character_set_connection | utf8 | | character_set_database | latin1 | | character_set_filesystem | binary | | character_set_results | utf8 | | character_set_server | latin1 | | character_set_system | utf8 | | character_sets_dir | /usr/share/mysql/charsets/ | +--------------------------+----------------------------+ 其中信息输入路径是 client - connection - server 信息输出路径是 server - connection - result 输入set names utf8是临时设置client和connection的字符编码 如何在PHP中初始化mysql的字符编码? 有两种方法可以初始化设置: 1 1 2 3 $pdo = new PDO( "mysql:host={$config['host']};dbname={$config['dbname']};port={$config['port']}" , $config [ 'user' ], $config [ 'password' ], array (PDO::MYSQL_ATTR_INIT_COMMAND => "SET NAMES utf8" )); 2 1 2 3 4 5 $pdo = new PDO( "mysql:host={$config['host']};dbname={$config['dbname']};port={$config['port']}" , $config [ 'user' ], $config [ 'password' ]); $pdo -> exec ( 'set names utf8' ); PHP的PDO扩展 使用php如果要使用PDO,你需要安装的扩展除了PDO,还要各种数据库的驱动,PDO扩展是定义了一系列接口,但是你不可以使用PDO扩展直接操作数据库,需要安装制定PDO驱动扩展 PDO扩展的说明:http://www.php.net/manual/en/intro.pdo.php PDO扩展只能在PHP 5.0之上使用(使用了php的OO属性) 针对不同的数据库的扩展有: 为什么PDO的prepare不能打出最后的sql 使用PDO一直有一个郁闷的地方,就是使用prepare的时候想要将最后执行的sql打出来做log,发现没有方法。。。 后来想了想,prepare是mysql的语句,那么PDO的prepare和execute实际上是对mysql发送了几次请求,prepare,set,execute mysql> PREPARE stmt1 FROM 'SELECT SQRT(POW(?,2) + POW(?,2)) AS hypotenuse'; mysql> SET @a = 3; mysql> SET @b = 4; mysql> EXECUTE stmt1 USING @a, @b; +------------+ | hypotenuse | +------------+ | 5 | +------------+ mysql> DEALLOCATE PREPARE stmt1; 所以,如果要打出log,只有自己拼sql了。。。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/archive/2013/05/10/3070760.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

C#基础知识

1.c#概述,c#语言及其特点;c#与.net框架关系 C#概述:C#是微软公司发布的一种面向对象的、运行于.NET Framework之上的高级程序设计语言,C#是一种安全的、稳定的、简单的、优雅的,由C和C++衍生出来的面向对象的编程语言 特点:1.简单 2.现代 3.面向对象 4.类型安全 5.相互兼容性 6.可伸缩性和可升级性 关系:.NET框架是由微软开发的,致力于敏捷软件开发、快速应用开发、平台无关性和网络透明化的软件开发平台。 C#只是用于编写运行在该平台上的一种语言。 2.编写第一个c#程序(注释,命名空间,类,Main方法,标识符,关键字,输入,输出语句,) [csharp] view plain copy using System; namespace ConsoleApp2 { class Program { static void Main(string[] args) { //输出 Hello word Console.WriteLine("Hello word"); //输入 Console.ReadLine(); } } } 3.变量与常量(值类型,引用类型,两者区别,枚举类型,类型转换,变量声明,变量作用域,变量赋值,常量) 值类型 引用类型 1、值类型的数据存储在内存的栈中;引用类型的数据存储在内存的堆中 2、值类型表示实际数据,引用类型表示指向存储在内存堆中的数据的指针或引用 枚举: 枚举使用enum关键字来声明,与类同级。 枚举是值类型,隐式继承自System.Enum,不能手动修改。System.Enum本身是引用类型,继承自System.ValueType。 枚举都是隐式密封的,不允许作为基类派生子类。 枚举类型的枚举成员均为静态,且默认为Int32类型。 每个枚举成员均具有相关联的常数值。 枚举成员不能相同,但枚举的值可以相同。 枚举最后一个成员的逗号和大括号后面的分号可以省略 类型转换: 1.(int)变量名[强制类型转换] 2.int.Parse(string 变量名) 3.int.TryParse(string s, out int result) Convert.ToInt32 变量赋值: 值类型变量的赋值:值类型变量中保存的是实际数据,在赋值的时候只是把数据复制一份,然后赋给另一个变量。 引用类型变量的赋值: 引用类型变量中保存的是“指向实际数据的引用指针”。在进行赋值操作的时候,它和值类型一样,也是先有一个复制的操作,不过它复制的不是实际的数据,而是引用(真实数据的内存地址)。所以引用类型的变量在赋值的时候,赋给另一变量的实际上是内存地址。这样赋值完成后,2个引用变量中保存的是同一引用,他们的指向完全一样。 变量声明: 数据类型 变量名=值; 常量: C#常量主要分为两种:编译时和运行时常量 1、编译时常量,在编译时便用该常量的值代替常量变量。 2、运行时常量,在运行时返回一个运行时常量的变量引用 4.表达式与运算符(表达式概念,运算符种类,运算符优先级) 表达式概念:变量常量运算符组成 1.带( )号,[ ]号, . 号的,new,typeof,sizeof,checked,x++,x--级别最高,先计算. 2.++x,--x,+,! 3.算术运算符,先,/,%,再+,- 4.关系运算符,先>,<,>=,<=,is ,as再==和!= 5.条件逻辑运算符&&和|| 6.条件运算符b?x:y 7,赋值运算符=,=,/=,+=,-= 5.字符与字符串(Char类,Char类的使用,String的基本使用,StringBulider的使用) 字符串是由多个字符组成,字符串是引用类型 字符:Char类在C#中表示一个Unicode字符。 3)ToUpper(转换为大写)和ToLower(转换为小写) string s="RaSer"; string s1=s.ToUpper();//s1="RASER"; string s2=s.ToLower();//s2="raser"; Trim() 出去两边的空格 string str=" dd "; string s=str.Trim();//s="dd"; Substring 截取字符<str>以index开始截取,并截取lenth个字符(string <str>.Substring(index,lenth)) string str="还在下雨"; string s=str.Substring(2,2);//s="下雨"; Remove删除字符串(字符) 在字符串中移除从startIndex开始,长度为length的字符串,剩下的字符合为一个新的字符串 、Insert 插入 在字符串的index位置上插入字符,原来的字符依次后移,变成一个新的字符串 string str="夜深了"; string s=str.Insert(1,"已经");// s="夜已经深了" Replace 字符串(字符也是可以的)替换,返回新的字符串 string str="好困呀"; string s=str.Replace("困","精神");//s="好精神呀"; 、Equals 比较两个字符串是否相等 6.流程控制语句(选择包括switch,迭代语句即循环(搞明白为什么可以循环),跳转(break,continue,goto,return)) [csharp] view plain copy int a=6; switch(a) { case:"4" console.writeline("4"); break; case:"5" console.writeline("5"); break; default console.writeline("666"); break; } break从循环体跳出 continue结束本次循环 goto无条件转移语句 return 跳出循环的同时也做函数返回 7.数组和集合(一维数组和二维数组的声明以及使用,ArrayList类,HashTable,List,Directory字典等常用集合(泛型和非泛型)) [csharp] view plain copy string[] names = new string[5];//动态初始化 string[] names1 = new string[3] { "张三", "李四", "王二" };//定义并且赋予初值 动态初始化 int[] array = { 1, 2, 3, 4, 5 };//静态初始化变量,系统会自动分配内存空间 int[,] array = new int[2, 3];//声明一个两行3列的数组 声明并且进行初始化 [csharp] view plain copy int[,] array = new int[2, 3] { { 1, 2, 3 }, { 1, 3, 4 } }; ArrayList类是一个特殊的数组。通过添加和删除元素,就可以动态改变数组的长度。 Dictionary表示键和值的集合。 8.属性和方法(属性和方法的概念以及使用,注意,新特性中的自动属性,方法的重载) 1、类的属性:对象所拥有的特征,在类中表示时称为类的属性。 2、类的方法:对象执行的操作称为类的方法。 重载: 方法名相同。 方法的参数类型、个数、顺序至少有一项不相同。 方法的返回类型可以不相同,但只有返回类型不同是不可以的。 方法的修饰符可以不相同,但只有修饰符不同是不可以的 9.结构和类(结构的概念,类的概念,声明,构造函数,对象的实例化,类和对象的关系,实例的和静态的) 10.密封类和密封方法 密封类使用sealed关键字进行修饰,它不能用作其他类的基类,并且他没有派生类,密封类的作用是防止其他类继承该类,密封方法是使用sealed关键字进行修饰的方法,他并不能影响类的继承,但它可以防止重写基类中特定的虚方法。 [csharp] view plain copy public sealed class SealClass { } public sealed override void MyMethod() { Console.WriteLine("这是一个密封方法!"); } 本文转自 宁金峰 51CTO博客,原文链接:http://blog.51cto.com/13243523/2047608,如需转载请自行联系原作者

优秀的个人博客,低调大师

Activity的基础知识

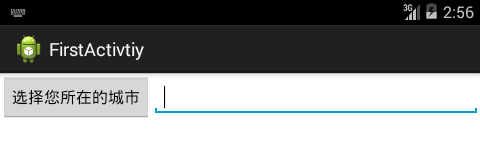
前言 长风破浪会有时,直挂云帆济沧海。 关于Activity的启动和关闭 一个Android应用程序通常都包含多个Activity,但只有一个Activity会作为程序的入口——当该Android应用运行时将会自动启动并执行该Activity。至于应用中的其他Activity,通常都由入口Activity启动,或由入口Activity启动的Activity启动。 Activity启动其他Activity有如下两个方法。 startActivity(Intent intent):启动其他Activity。 startActivityForResult(Intent intent,int requestCode):以指定的请求码(requestCode)启动Activity,而且程序将会获取新启动的Activity返回的结果(通过重写OnActivityResult(...)方法)。 上面两个方法都用到了Intent参数,Intent是Android应用里各组件之间同通信的重要方式,一个Activity通过Intent来表达自己“意图”——想要启动哪个组件,被启动的组件既可是Activity组件,也可是Service组件。 Android为关闭Activity准备了如下两个方法。 finish():结束当前Activity。 finishActivity(int requestCode):结束以startActivityForResult(Intent intent,int requestCode)方法启动的Activity。 代码示例 FirstActivity.java public class FirstActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); Button bt = (Button) findViewById(R.id.bt); bt.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(FirstActivity.this,SecondActivity.class); //启动intent对应的Activity startActivity(intent); } }); } } SecondActivity.java public class SecondActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.seconde_layout); Button back = (Button) findViewById(R.id.back); Button back_finish = (Button) findViewById(R.id.back_finish); back.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(SecondActivity.this,FirstActivity.class); //启动intent对应的Activity startActivity(intent); } }); back_finish.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要启动的Activity对应的Intent Intent intent = new Intent(SecondActivity.this,FirstActivity.class); //启动intent对应的Activity startActivity(intent); //结束当前Activity finish(); } }); } } 提示 上述程序的布局文件就只包含简单的按钮来实现跳转,第二个Activity唯一的区别就是finish()方法,它表明该Activity会结束自己。 使用Bundle在Activity之间交换数据 当一个Activity启动另一个Activity时,常常会有一些数据需要传过去。这时Intent就相当于一个“信使”,我们将需要传送的数据存入Intent中即可。、 Intent提供了多个方法来“携带”额外的数据,如下所示。 putExtras(Bundle data):向Intent中放入需要“携带”的数据包。 Bundle getExtras():取出Intent中所“携带”的数据包。 putExtra(String name,Xxx value):向Intent中按key-value对的形式存入数据。 getXxxExtra(String name):从Intent中按key取出指定类型的数据。 上述方法中的Bundle就是一个简单的数据携带包,该Bundle对象包含了多个方法来存入数据。 putXxx(String key, Xxx value):向Bundle中放入Int、Long等各种类型的数据。 putSerializable(String key, Serializable data):向Bundle中放入一个可序列化的对象。 getXxx(String key):从Bundle中取出Int、Long等各种类型的数据。 getSerializable(String key):从Bundle中取出一个可序列化的对象。 下面我通过一个实例来介绍Activity之间如何通过Bundle交换数据。 本程序包含两个Activity,其中第一个Activity用于收集用户的输入信息,当用户单击该Activity的“注册”按钮时,应用进入第二个Activity,第二个Activity将会获取第一个Activity中的数据。 代码示例 FirstActivity.java public class FirstActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); Button bn = (Button) findViewById(R.id.bn); bn.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { EditText name = (EditText) findViewById(R.id.name); EditText passwd = (EditText) findViewById(R.id.passwd); RadioButton male = (RadioButton) findViewById(R.id.male); String gender = male.isChecked() ? "男" : "女"; Person p = new Person(); p.setName(name.getText().toString()); p.setPasswd(passwd.getText().toString()); p.setGender(gender); //创建一个Bundle对象 Bundle data = new Bundle(); data.putSerializable("person", p); //创建一个Intent Intent intent = new Intent(FirstActivity.this,SecondActivity.class); intent.putExtras(data); //启动intent对应的Activity startActivity(intent); } }); } } first_layout.xml <?xml version="1.0" encoding="utf-8"?> <TableLayout xmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" > <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="请输入您的注册信息" android:textSize="20sp" /> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="用户名:" android:textSize="16sp" /> <EditText android:id="@+id/name" android:layout_width="match_parent" android:layout_height="wrap_content" android:hint="请填写想注册的账号" android:selectAllOnFocus="true" /> </TableRow> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="密码:" android:textSize="16sp" /> <EditText android:id="@+id/passwd" android:layout_width="match_parent" android:layout_height="wrap_content" android:password="true" android:selectAllOnFocus="true" /> </TableRow> <TableRow> <TextView android:layout_width="match_parent" android:layout_height="wrap_content" android:text="性别:" android:textSize="16sp" /> <RadioGroup android:layout_width="match_parent" android:layout_height="wrap_content" android:orientation="horizontal" > <RadioButton android:id="@+id/male" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="男" android:textSize="16sp" /> <RadioButton android:id="@+id/female" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="女" android:textSize="16sp" /> </RadioGroup> </TableRow> <Button android:id="@+id/bn" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="注册" android:textSize="16sp" /> </TableLayout> SecondActivity.java public class SecondActivity extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.seconde_layout); TextView name = (TextView) findViewById(R.id.name); TextView passwd = (TextView) findViewById(R.id.passwd); TextView gender = (TextView) findViewById(R.id.gender); //获取启动该Activity的Intent Intent intent = getIntent(); //直接通过Intent取出它所携带的Bundle数据包中的数据 Person p = (Person) intent.getSerializableExtra("person"); name.setText("您的用户名为:" + p.getName()); passwd.setText("您的密码为:" + p.getPasswd()); gender.setText("您的性别为:" + p.getGender()); } } seconde_layout.xml <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" android:gravity="center_horizontal" > <TextView android:id="@+id/name" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> <TextView android:id="@+id/passwd" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> <TextView android:id="@+id/gender" android:layout_width="match_parent" android:layout_height="wrap_content" android:textSize="18sp" /> </LinearLayout> 效果 [图片上传失败...(image-e4b6ea-1514096470518)] [图片上传失败...(image-2ca6b1-1514096470519)] 提示 需要传送数据如果是对象,这个对象应该实现Serializable接口。 启动其他Activity并返回结果 前面已经提到,Activity还提供了一个startActivityForResult(Intent intent,int requestCode)方法来启动其他Activity。该方法用于启动指定Activity,而且期望获取指定Activity返回的结果。这种情况很常见,例如应用程序第一个界面需要用户进行选择,但需要选择的列表数据比较复杂,必须启动另一个Activity让用户选择。当用户在第二个Activity中选择完成后,程序返回第一个Actvity,第一个Activity必须能获取并显示用户在第二个Activity中选择的结果。在这种应用场景下,也通过Bundle进行数据交换的。 为了获取被启动的Activity所返回的结果,需要从两方面着手。 当前Activity需要重写onActivityResult(int requestCode,int resultCode,Intent intent),当被启动的Activity返回结果时,该方法会被触发,其中requestCode代表请求码,而resultCode代表Activtiy返回的结果码,由开发者自行设定。 被启动的Activtiy需要调用setResult()方法设置处理结果。 一个Activity中可能包含多个按钮,并调用多个startActivityForResult()方法来打开多个不同的Activity处理不同的业务,当这些新Activity关闭后,系统将回调前面Activity的onActivityResult(int requestCode,int resultCode,Intent data)方法。为了知道该方法是由哪个请求的结果所触发的,可利用requestCode请求码;为了知道返回的数据来自于哪个新的Activity,可利用resultCode结果码。 代码示例 FirstActivity.java public class FirstActivity extends Activity { Button bt; EditText city; @Override protected void onCreate(Bundle savedInstanceState) { // TODO Auto-generated method stub super.onCreate(savedInstanceState); setContentView(R.layout.first_layout); bt = (Button) findViewById(R.id.bt); city = (EditText) findViewById(R.id.city); bt.setOnClickListener(new OnClickListener() { @Override public void onClick(View v) { //创建需要对应于目标Activity的Intent Intent intent = new Intent(FirstActivity.this, SelectCityActivity.class); //启动指定Activity并等待返回的结果,其中0是请求码,用于标识该请求 startActivityForResult(intent, 0); } }); } //重写该方法,该方法以回调的方式来获取指定Activity返回的结果 @Override protected void onActivityResult(int requestCode, int resultCode, Intent intent) { //当requestCode、resultCode同时为0时,也就是处理特定的结果 if(requestCode == 0 && resultCode == 0) { //取出Intent里德Extras数据 Bundle data = intent.getExtras(); //取出Bundle中的数据 String resultCity = data.getString("city"); //修改city文本框的内容 city.setText(resultCity); } } } SelectCityActivity.java public class SelectCityActivity extends ExpandableListActivity { //定义省份数组 private String[] provinces = new String[] {"广西","广东","湖南","云南"}; private String[][] cities = new String[][] { {"桂林","柳州","南宁","北海"}, {"广州","深圳","珠海","中山"}, {"长沙","岳阳","衡阳","株洲"}, {"昆明","玉溪","大理","丽江"} }; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); ExpandableListAdapter adapter = new BaseExpandableListAdapter() { @Override public boolean isChildSelectable(int groupPosition, int childPosition) { return true; } @Override public boolean hasStableIds() { return true; } private TextView getTextView() { AbsListView.LayoutParams lp = new AbsListView.LayoutParams(ViewGroup.LayoutParams.MATCH_PARENT, 64); TextView textView = new TextView(SelectCityActivity.this); textView.setLayoutParams(lp); textView.setGravity(Gravity.CENTER_VERTICAL|Gravity.LEFT); textView.setPadding(36, 0, 0, 0); textView.setTextSize(20); return textView; } @Override public View getGroupView(int groupPosition, boolean isExpanded, View convertView, ViewGroup parent) { LinearLayout ll = new LinearLayout(SelectCityActivity.this); ll.setOrientation(LinearLayout.HORIZONTAL); ImageView logo = new ImageView(SelectCityActivity.this); logo.setImageResource(R.drawable.ic_launcher); ll.addView(logo); TextView textView = getTextView(); textView.setText(getGroup(groupPosition).toString()); ll.addView(textView); return ll; } @Override public long getGroupId(int groupPosition) { return groupPosition; } @Override public int getGroupCount() { return provinces.length; } @Override public Object getGroup(int groupPosition) { return provinces[groupPosition]; } @Override public int getChildrenCount(int groupPosition) { return cities[groupPosition].length; } @Override public View getChildView(int groupPosition, int childPosition, boolean isLastChild, View convertView, ViewGroup parent) { TextView textView = getTextView(); textView.setText(getChild(groupPosition, childPosition).toString()); return textView; } @Override public long getChildId(int groupPosition, int childPosition) { // TODO Auto-generated method stub return childPosition; } @Override public Object getChild(int groupPosition, int childPosition) { // TODO Auto-generated method stub return cities[groupPosition][childPosition]; } }; setListAdapter(adapter); //为列表项设置监听 getExpandableListView().setOnChildClickListener(new OnChildClickListener() { @Override public boolean onChildClick(ExpandableListView parent, View v, int groupPosition, int childPosition, long id) { //获取启动该Activity之前的Activity对应的Intent Intent intent = getIntent(); intent.putExtra("city", cities[groupPosition][childPosition]); //设置该SelectCityActivity的结果码,并设置结束之后退回的Activity SelectCityActivity.this.setResult(0, intent); //结束SelectCityActivity SelectCityActivity.this.finish(); return false; } }); } } 效果 Screenshot_20171101-145622.png Screenshot_20171101-145711.png Screenshot_20171101-145743.png 提示 别忘记每创建一个新的Activity,都要去清单文件里注册这个Activity。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册