首页 文章 精选 留言 我的

精选列表

搜索[实时风控],共10001篇文章
优秀的个人博客,低调大师

WorkBuddy量化Skill实操

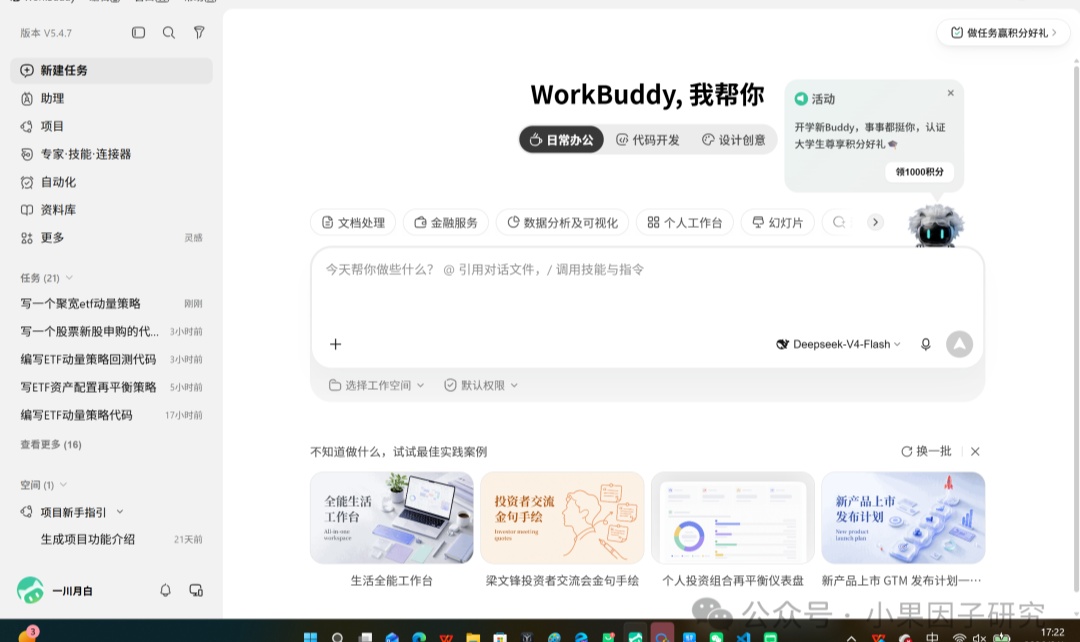
现在ai运用越来越广泛,我今天去看了一下量化方面的skill真的少,怎么样使用的教程很少,调用skill一般需要Agent平台,Agent平台很多公司都有,可以分析代码等功能,前面我们介绍了怎么样去编写skill给ai使用 量化研究-怎么样编写ptrade量化交易skill 今天我们介绍一下怎么样运行ai去调用skill,解决我们的问题WorkBuddy是腾讯推出的一款全场景AI智能体(Agent)桌面工作台,你可以把它理解为一个能直接在你电脑里"替你干活"的AI同事,而不是一个只会聊天的机器人,我安我的经验编写了一些skill,帮我解决量化问题,虽然手写叶没有问题,有时候不想手动写代码,让ai替代自己写方便 ![](https://developer.qcloudimg.com/http-save/audit-12698924/4096b60ff40f0caada612ead2bf71c85.webp) ![](https://developer.qcloudimg.com/http-save/audit-12698924/f4df5d4b7f5eab6caefbe71e4040df19.png) 第一步安装workbuddy ![](https://developer.qcloudimg.com/http-save/audit-12698924/74e45f2363db1bdc8964ad4e8609dc9c.png) skill安装方式有很多,第一个方式就是下载skill压缩包,放在软件下面的skill文件夹就可以 第二个方式一般也是常见的,比如广场里面安装,node.js安装都可以,在workbuddy安装点击专家 ![](https://developer.qcloudimg.com/http-save/audit-12698924/a3529ce0f9d8eda404b763fb722bcd75.png) 点击技能就可以搜索自己感兴趣的skill ![](https://developer.qcloudimg.com/http-save/audit-12698924/a74b45751def3da10378a74a0eec1657.webp) 比如我安装的 ![](https://developer.qcloudimg.com/http-save/audit-12698924/83ab93e8eb359503ca4c60ed0563d193.png) 安装完成我们就可以调用skill,在建立任务对话框输入/会显示我们的全部skill安装的,不输入的ai会自动匹配skill ![](https://developer.qcloudimg.com/http-save/audit-12698924/347e80f561f94c07b6597d97a6aa03fd.png) 比如我调用ptrade来实现一个动量策略输入内容 ```javascript /小果量化交易Ptrade全能助手 帮我实现一个etf动量的策略,每天的14点30轮动策略,不需要分析过程,直接给我输出完整源代码 ``` ![](https://developer.qcloudimg.com/http-save/audit-12698924/6de251232cfe7ce021241a24e4df22b4.png) 这个需要你自己代码能力看能不能看出代码的错误提示ai修改,比如这个地方就是错误的,run_daily应该有3个参数 ![](https://developer.qcloudimg.com/http-save/audit-12698924/93d56ae977176c642200d445cf689a7a.png) 重新让ai修改 ![](https://developer.qcloudimg.com/http-save/audit-12698924/3271b38307c83b35524bcf255319de75.webp) ![](https://developer.qcloudimg.com/http-save/audit-12698924/da2d887ccd7ba744871ec8f1b8364fbc.webp) 这个需要自己代码去仔细的看看比如这个就是错误的, ![](https://developer.qcloudimg.com/http-save/audit-12698924/be7959f1d304dab5916ffe9efe615f52.png) 在提示ai修改就可以,也可以换一个模型 ![](https://developer.qcloudimg.com/http-save/audit-12698924/7fe1b88f0e932e551f86862c2476a3f1.png) 也有可能是我提示内容太简单了,需要优化提示内容,这个就没有问题了 ![](https://developer.qcloudimg.com/http-save/audit-12698924/ec63ad701b5bbc026bc75010016ed00b.png) 不懂的问我 输出代码 - ```javascript # ETF动量轮动策略(每日14:30调仓) # 平台:Ptrade量化交易平台 def initialize(context): # ===== 策略参数设置 ===== # ETF标的池(可自行增删) g.etf_pool = [ '510.SS', # 沪深TF '500.SS', # 中证 '115.SZ', # 创 '550.SS', # 上 '580.SS', # 红利ETF '590.SS', # 酒 '580.SS', # 半导 '530.SS', # 新能 '510.SS', # 医 ] # 动量回看周期(交易日) g.momentum_period = 20 # 每次持有动量排名前N只ETF g.top_n = 1 # 单只ETF最大仓位比例 g.max_position = 1 # 每天14:30触发轮动 # run_daily(context, func, time='9:31') run_daily(context, momentum_rotation, time='14:30') log.info('ETF动量轮动策略初始化完成') def momentum_rotation(context): # ===== 计算各ETF动量 ===== momentum_dict = {} for etf in g.etf_pool: try: # 获取最近N+1个交易日的收盘价(DataFrame,含当前bar) df = get_history(g.momentum_period + 1, '1d', 'close', etf) # 数据不足则跳过 if df is None or len(df) < g.momentum_period + 1: log.warn('数据不足,跳过 %s' % etf) continue close_prices = df['close'].values.astype(float) current_price = close_prices[-1] past_price = close_prices[0] if past_price == 0: continue # 动量 = (当前价 / 周期前价格) - 1 momentum = (current_price / past_price) - 1.0 momentum_dict[etf] = momentum log.info('%s 动量: %.4f' % (etf, momentum)) except Exception as e: log.error('获取 %s 数据失败: %s' % (etf, str(e))) if len(momentum_dict) == 0: log.warn('无有效动量数据,本次不调仓') return # ===== 按动量降序排序,选出前N只 ===== sorted_etfs = sorted(momentum_dict.items(), key=lambda x: x[1], reverse=True) target_etfs = [etf for etf, _ in sorted_etfs[:g.top_n]] log.info('本轮选中的ETF: %s' % target_etfs) # ===== 先卖出不在目标池中的持仓 ===== for position in context.portfolio.positions.values(): stock = position.security if stock not in target_etfs: log.info('卖出 %s' % stock) order_target(stock, 0) # ===== 买入/调整目标ETF仓位,平均分配 ===== # 每只目标ETF的目标市值 = 总资产 / N,并受最大仓位限制 avg_value = context.portfolio.total_value / len(target_etfs) for etf in target_etfs: target_value = min(avg_value, g.max_position * context.portfolio.total_value) log.info('调仓 %s,目标市值 %.2f' % (etf, target_value)) order_target_value(etf, target_value) ```

优秀的个人博客,低调大师

GEO优化实操:如何让内容被AI捕捉

## 一、被AI"捕捉"意味着什么 在生成式引擎时代,一段内容要被用户看到,前提是被AI"捕捉"——即被生成式引擎检索到、理解并纳入其合成的答案之中。理解"被捕捉"的完整含义,是进行GEO优化的起点。 生成式引擎生成答案的过程通常分为三个阶段:检索、排序、合成。**检索**阶段,系统根据用户问题从内容索引中召回一批候选文档;**排序**阶段,候选文档按相关性、新鲜度、来源权威性等维度排列;**合成**阶段,大语言模型从排序靠前的文档中抽取信息,组织成一段连贯答案。 "被AI捕捉"贯穿这三个阶段:内容要能被检索系统发现,要在排序中获得靠前位置,更要在合成阶段被实际采用。其中第三阶段最为关键——研究者的实验表明,仅优化内容表达方式,就可使内容在合成答案中的可见度显著提升,且原本排序靠后的内容收益更大。这说明,"被捕捉"并非单纯依赖排名,更取决于内容本身是否适合机器抽取与整合。 理解这一机制后,GEO优化的目标就清晰了:让内容同时满足"可发现、可理解、可信赖"三个条件。下文从五个层面展开具体做法。 ## 二、前提:让内容处于"可见"状态 任何优化都建立在一个前提之上——内容必须能够被系统抓取和索引。如果内容无法进入生成式引擎的检索范围,后续的一切优化都无从谈起。 确保"可见"通常涉及几个基本条件。其一,内容发布在可被公开访问的位置,且链接可被爬虫正常抓取;其二,页面建立起了有效的索引,系统知道这段内容的存在;其三,内容与目标话题存在明确的相关性,能够在相关问题的检索中被召回。 这一层面虽然基础,却最容易被忽略。许多内容精心打磨,却因为技术上不可访问或未被索引,从一开始就退出了被捕捉的候选范围。因此,做GEO优化,第一步是确认内容处于"可见"状态,这相当于为后续优化打下地基。 ## 三、内容表达:让AI"读得懂" 被检索到之后,内容能否在合成阶段被实际采用,很大程度上取决于其表达方式是否便于机器理解。生成式引擎通过语义理解来抽取信息,因此内容的表达应当清晰、具体、可验证。 **用具体数据替代模糊表述。** 大语言模型在整合答案时,更倾向于采用带有明确数字和出处的事实性表述。例如,"很多用户"这类模糊量词,远不如"62%的用户"这样带具体数值的表述容易被采信;"增长很快"不如"从2024年的12亿增长到2026年的38亿"来得清晰。具体数字让信息具有可验证性,而可验证性正是机器判断内容可信的重要依据。 **提供具名引述。** 一段来自具体人物、附带职务与机构的明确引述,为AI提供了一个可以直接抽取、原样转述的信息单元。相比之下,"专家表示"这类匿名表述,既无法提供可验证的来源,也缺乏被采信的依据,反而可能被视为弱证据。 **采用清晰肯定的语气。** 生成式引擎的训练语料以专业、清晰的表达为主,它更倾向于从"读起来像专业写作"的内容中抽取信息。犹豫的措辞、绕弯子的长句、模棱两可的判断,都会降低内容被选中的概率。直接陈述、用证据支撑、避免无意义的重复,是提升被采用概率的简单有效方法。 需要强调的是,传统SEO中的关键词堆砌在这里不仅无用,反而有害。生成式引擎能够识别内容的自然度与质量,刻意堆砌关键词会降低内容的可信度,从而降低被采信的概率。 ## 四、结构组织:让AI"好切、好摘" 内容被理解之后,能否被顺利抽取,取决于结构是否清晰。生成式引擎在合成阶段是"段落级"地抽取信息,因此内容的组织结构至关重要。 **结论前置。** 将核心答案放在开头,再展开细节。生成式引擎的核心能力是快速回答,它偏好结论清晰、结构直接的内容。一个实用的自检方法是:遮住正文,只看小标题和每段首句,能否拼出一条完整的答案?如果能,说明结构是合格的。 **设计"可独立抽取"的内容单元。** 这是实务中最有效的手法之一:写出一段语义完整、可脱离上下文独立理解的内容单元,让AI能够直接引用而无需拼接前后文。典型结构是——开头给出清晰观点,随后跟上一条带出处的数据或研究,再补充一个具体场景或案例,结尾以简短总结收束。这样的段落同时提升了机器抽取的效率和人类读者的阅读体验。 **使用结构化标记与语义标签。** 正确使用标题层级、有序列表等语义化HTML标签,以及Schema.org等结构化数据标记,能帮助机器更准确地判断内容的结构与含义。对生成式引擎而言,结构化程度高的内容,关键信息更容易被准确识别和提取。对照实验显示,相同内容在结构化处理后,其被AI采用的比例较纯文字版本有大幅提升。 **采用问答式组织。** 以问题本身作为小标题,紧跟简短答案,再展开说明。这种组织方式既贴近用户的实际提问方式,也符合生成式引擎抽取答案的逻辑,能够提高内容在多种问题场景下被采用的概率。 ## 五、可信度建设:让AI"愿意信" 即使内容表达清晰、结构完整,若缺乏可信度,生成式引擎仍可能选择不采用。可信度是决定内容能否被"信任"的关键因素。 **保持信息一致性。** 同一实体的关键信息——名称、描述、数据——在不同来源中保持一致,是机器评估可信度的基础信号。如果同一信息在不同地方相互矛盾,AI会降低对该内容的信任度。实践数据显示,信息一致性的提升能够显著提高内容被采用的概率。 **依托权威来源。** 内容出现在权威平台、官方渠道或高权重来源中,其被采信的概率远高于仅出现在不知名渠道的内容。生成式引擎本质上是在做可信度判断,权威来源天然占优。这提示内容建设者,将信息发布到可信赖的平台、与权威信源建立关联,是提升可信度的有效途径。 **构建主题深度。** 对某一话题进行系统、完整的覆盖,比零散地发布孤立内容更能获得机器的信任。以核心内容为中心,延伸多个相关子主题并相互关联,形成完整的主题集群,能让内容在更多问题场景下被采用。系统性、完整性的内容,在机器眼中是专业与可靠的体现。 ## 六、持续更新:保持时效与活跃 生成式引擎对内容的新鲜度有明显偏好。研究观测到,被生成式引擎引用的来源,平均比同话题的传统搜索结果更新。这意味着,保持内容的时效性是GEO优化中不可忽视的一环。 持续更新体现在两个层面:一是对已有内容进行定期修订,确保其中的信息、数据仍然准确、不过时;二是保持内容源的活跃度,持续产出新的相关内容。一个持续更新、活跃运转的内容源,在机器眼中是"可靠"的信号。不过,时效性的权重相对有限,不应为了追求新而牺牲内容的深度与准确性。 ## 七、多模态:让AI从更多维度理解 随着生成式引擎对图片、视频、音频理解能力的增强,内容优化正从纯文本扩展到多模态形态。让内容"被捕捉"的机会,也存在于文本之外。 **图片的优化**,核心是让机器"看懂"图。为图片提供描述性的文本说明,使机器能够理解图片所表达的内容与涉及的核心概念;对图表等关键信息,应在正文中用文字重述其要点,因为机器对图片中文字的识别仍可能存在误差。 **视频与音频的优化**,核心是提供机器可解析的文本层。为视频配置字幕、为音频提供文字稿,使机器能够理解其中表达的信息。一段缺乏文本层的音视频内容,对生成式引擎而言几乎是不存在的内容。 多模态优化的本质,是把不同形态的内容转化为机器能够理解的结构化信息,让内容在更广泛的场景下有机会被捕捉。 ## 八、效果验证与迭代 GEO优化并非一劳永逸,而是一个"测试—观察—调整"的循环过程。由于生成式引擎的算法不透明,优化效果的验证需要依靠持续的外部观察。 **定期测试。** 围绕核心话题向生成式引擎提问,观察答案中是否出现自己的内容、以何种方式被提及。记录结果,建立基线,跟踪变化趋势。 **对照实验。** 在调整内容前后各跑一遍同一组问题,对比内容被采用的情况,用差异来判断哪类优化手段真正有效。这种方法虽然朴素,却是应对"黑盒"引擎最可行的手段。 **持续迭代。** 生成式引擎的算法在持续演进,内容被捕捉的规律也在不断变化。定期回顾、及时调整,是GEO优化的常态。 ## 九、常见误区 在GEO优化的实践中,有几个误区需要避免。 **误区一:认为GEO就是让AI"说想说的话"。** GEO不是操控AI,而是通过改善内容本身的表达与可信度,让机器在自主判断中更倾向于采用它。任何试图"欺骗"机器的做法,最终都会被识别并适得其反。 **误区二:沿用关键词堆砌的思路。** 生成式引擎以语义理解为核心,堆砌关键词不仅无效,还会降低内容质量与可信度。 **误区三:只重内容忽视前提。** 如果内容根本无法被系统抓取和索引,再好的优化也无从谈起。技术层面的"可见"是优化的地基。 **误区四:期待立竿见影。** 内容要被机器检索、评估、信任并采用,需要时间。短期波动是正常的,判断效果应看长期趋势。 ## 十、结语 GEO优化的核心,是让内容在生成式引擎的信息处理链条中,尽可能顺畅地通过"检索—排序—合成"三个环节,最终被纳入AI合成的答案。它要求内容同时做到:技术上可见、表达上清晰、结构上可抽取、可信度上达标、时效上常新。 纵观这些要求可以发现,GEO优化所倡导的方向——内容更具体、更清晰、更完整、更可信——与内容质量本身的追求是一致的。它本质上不是一套投机取巧的技巧,而是提醒内容建设者:在机器开始替人阅读和整合信息的时代,真实、清晰、可验证的信息,依然拥有不变的价值。理解了这一点,也就理解了GEO优化真正的意义。

优秀的个人博客,低调大师

云存储数据加密合规配置实操技巧

# 3个云存储数据合规配置技巧,新手看完就能上手操作 做企业数据管理或者日常隐私存储的朋友,最近肯定都关注到了数据合规要求收紧,不少人用云存储的时候,不知道怎么配置加密才能符合合规标准,要么漏配置留下风险,要么过度加密影响使用效率。今天就分享几个实用的云存储数据合规配置技巧。 ## 为什么不能所有数据都开最高加密? 很多人配置云存储加密的第一误区,就是不管什么数据全都默认最高等级加密,不仅拖慢访问速度,还增加了不必要的管理成本。其实合规配置的第一步,是先给云存储里的数据做分级分类。我接触过一个做电商的小老板,之前把所有客户信息、日常办公文档全都存在一个云存储桶里,统一开了最高级加密,结果每次找普通备货文档都要等半天解密,还因为混合存储被抽查提醒风险。按照合规要求,我们只需要把数据分成三类:公开办公数据、敏感内部数据、核心隐私数据,对应不同加密等级就可以。 ## 双重加密怎么开才不会漏项? 现在大部分主流云存储服务,都默认只开了存储加密,传输过程其实是裸奔的,这也是很多企业过不了合规检查的重灾区。想要满足基础合规要求,一定要把传输加密和存储加密同时打开。具体操作其实很简单,先在云存储的域名配置里,强制开启HTTPS传输加密,关闭未加密的HTTP访问端口,这一步就能挡住大部分传输过程中的数据窃听风险。然后针对静态存储的数据,打开服务器端加密,选择平台自带的合规加密算法就可以,如果是核心敏感数据,可以再开通客户端自主加密,把加密密钥掌握在自己手里。我帮朋友配置的时候,这两步走完,基础合规检查基本都能一次性通过。 ## 权限配置怎么补全合规漏洞? 很多人加密配置做对了,却栽在了访问权限这一步,云存储数据合规里,权限配置本身就是合规要求的一部分,就算加密做的再好,随便一个员工都能下载核心敏感数据,照样不合规。这里分享一个亲测好用的配置方法:给不同岗位的账号配置最小权限原则,比如普通运营只能访问公开办公数据,部门负责人可以访问内部敏感数据,只有核心管理员能下载导出核心隐私数据,同时开启访问日志记录功能,所有访问、下载、修改操作都自动留痕,方便后续合规溯源。另外还要定期清理闲置账号,关掉过期的共享链接,这两个小操作能解决80%的权限泄露风险。 以上就是三个容易上手的云存储数据合规配置技巧,其实云存储数据合规配置没有大家想的那么复杂,只要把基础步骤做对,就能满足绝大多数的合规要求。你在配置云存储加密的时候遇到过什么问题?欢迎在评论区留言交流,也可以点赞收藏这篇云存储数据合规配置技巧,用到的时候直接拿出来对照操作。

优秀的个人博客,低调大师

小白指南:Apache DolphinScheduler 补数据功能实操演示

最近使用 Apache DolphinScheduler 调度任务,不可避免地使用到【补数据】功能,经过不断尝试,终于成功运行了【补数据】功能,以此帖记录。 版本说明:3.1.9 补数据功能简介 "补数据" 在 Apache DolphinScheduler 中指的是 补数据(Complement Data) 功能,用于补充执行历史时间段内的工作流实例。 补数据功能概述 补数据是工作流执行的一种特殊模式,让用户可以为过去的时间段批量创建和执行工作流实例<cite />。这在以下场景中特别有用: 需要重新处理历史数据 系统故障后需要补充缺失的数据处理 新增数据处理逻辑后需要回填历史数据 定期批量数据处理 补数据配置参数 在工作流启动界面中,补数据功能包含以下配置选项: 是否是补数据 (whether_complement_data): 开关选项,启用补数据模式 调度日期 (schedule_date): 指定需要补数据的时间范围 : 支持日期选择和手动输入两种方式 格式为 yyyy-MM-dd HH:mm:ss,多个日期用逗号分隔 限制最多输入100条日期 执行方式 (mode_of_execution): 串行执行: 按顺序逐个执行补数据任务 并行执行: 同时执行多个补数据任务 并行度 (parallelism): 当选择并行执行时,可以设置自定义并行度来控制同时执行的任务数量 这有助于避免大量补数据任务对服务器造成过大影响 执行顺序 (order_of_execution) : 按日期升序执行: 从最早的日期开始执行 按日期降序执行: 从最近的日期开始执行 使用补数据功能操作步骤 首先是工作流的任务配置,见下图 接着,保存工作流,未设置全局变量。上线工作流。 最后,运行工作流,运行参数见下图 选择补数据的日期范围 【启动参数】为定义任务时设置的参数dt,value为空即可。 点击【确定】后自动运行 验证结果 点击【工作流实例】,查看运行结果。 点击第1个实例进入,查看日志 结果显示,SQL 运行结果为补数据选择的日期,补数据功能正常可用。 Notes 补数据功能是 Apache DolphinScheduler 工作流管理中的重要特性,通过灵活的配置选项(执行方式、并行度、执行顺序等)来满足不同的数据补充需求<cite />。在使用时需要注意合理设置并行度,避免对系统资源造成过大压力。

优秀的个人博客,低调大师

阿里通义开源实首个音频生成模型 ThinkSound

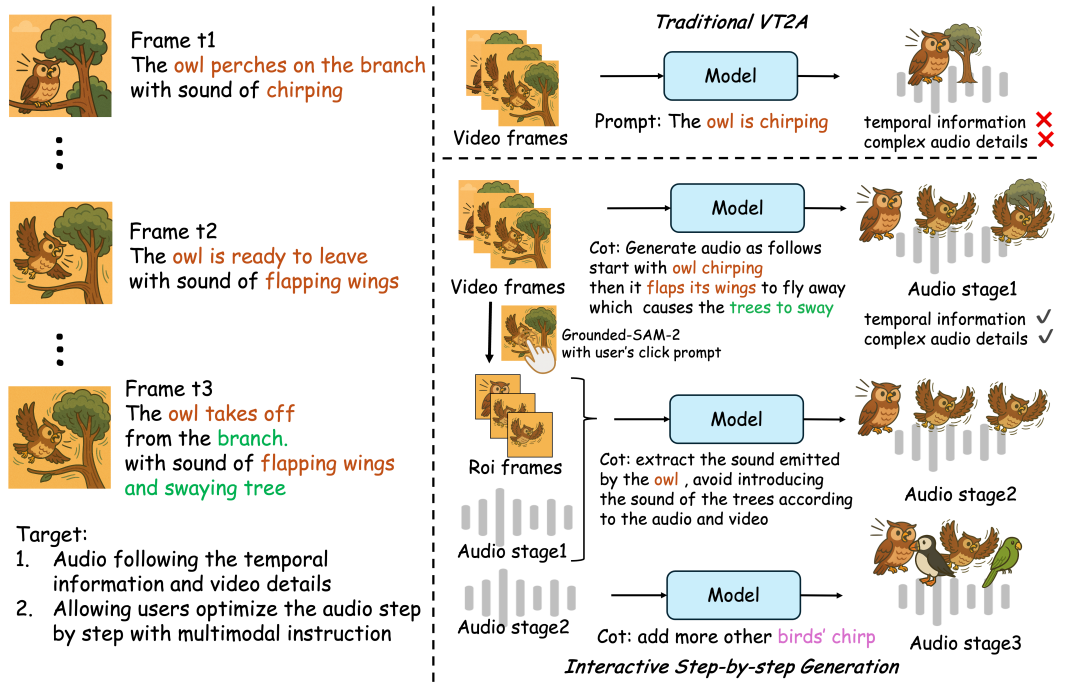
通义实验室首个音频生成模型 ThinkSound 现已正式开源,将打破“静音画面”的想象力局限。 该模型首次把多模态大模型的思维链推理引入音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。 目前,ThinkSound的代码和模型已在Github、HuggingFace、魔搭社区开源,开发者可免费下载和体验。 https://github.com/FunAudioLLM/ThinkSound https://huggingface.co/spaces/FunAudioLLM/ThinkSound https://www.modelscope.cn/studios/iic/ThinkSound 据介绍,ThinkSound 首次将 CoT(Chain-of-Thought,思维链)应用到音频生成领域,让 AI 学会一步步“想清楚”画面事件与声音之间的关系,从而实现高保真、强同步的空间音频生成 —— 不只是“看图配音”,而是真正“听懂画面”。 据悉,AudioCoT 融合了来自 VGGSound、AudioSet、AudioCaps、Freesound 等多个来源的 2531.8 小时高质量样本。这些数据覆盖了从动物鸣叫、机械运转到环境音效等多种真实场景,为模型提供了丰富而多样化的训练基础。为了确保每条数据都能真正支撑 AI 的结构化推理能力,研究团队设计了一套精细化的数据筛选流程,包括多阶段自动化质量过滤和不少于 5% 的人工抽样校验,层层把关以保障数据集的整体质量。

优秀的个人博客,低调大师

实操上手TinyEngine低代码引擎插件化开发

1.背景介绍 1.1 TinyEngine 低代码引擎简介 低代码开发是近些年非常热门的一种开发方式,用户可以通过可视化的方式,简单拖拽,不写代码或者编写少量代码,类似搭积木一样搭建业务应用。 TinyEngine是一个强大的低代码引擎,可以帮助开发者快速定制自己的低代码设计器或者低代码平台。 TinyEngine可以作为低代码平台的底座,提供可视化搭建页面等基础能力,既可以通过线上搭配组合使用,也可以通过cli创建个人工程进行二次开发,实时定制出自己的低代码平台。适用于多场景的低代码平台开发,如:资源编排、服务端渲染、模型驱动、移动端、大屏端、页面编排等。 TinyEngine 由OpenTiny 团队2023年开源,也欢迎大家点 Star 和 提Issue、PR 进行反馈。 TinyEngine 官网:https://opentiny.design/tiny-engine#/home TinyEngine 在线demo:https://opentiny.design/tiny-engine#/tiny-engine-editor TinyEngine 代码库:https://github.com/opentiny/tiny-engine 1.2 TinyEngine 插件化构建简介 TinyEngine引擎使用插件化架构,功能模块都由一个个插件构成,例如图片中页面上方的工具栏、左侧的插件栏、右侧的属性配置栏,以及中间的画布区域,都由一个个插件构成,通过插件化的架构,可以灵活配置、自由组装出个性化的设计器。 1.3 TinyEngine CLI简介 TinyEngine还提供了CLI工具方便用户二次开发,通过CLI,一行命令即可基于TinyEngine创建出全新的低代码项目、低代码插件项目,未来还会陆续增加创建设置器插件,创建新主题,新布局,新物料包等能力。 实验介绍 本实验主要通过体验使用TinyEngine几行命令快速创建一个用户专属低代码设计器,及通过开发一个新的侧边栏插件, 帮助开发者快速了解基于TinyEngine二次开发定制的能力。 2.1 实验目标 使用 TinyEngine CLI,通过一行命令创建全新低代码设计器,了解基于 TinyEngine 创建个性化低代码设计器/平台、二次开发的能力。 体验 TinyEngine 简单拖拽、配置 的开发形式帮助开发者快速了解低代码开发使用流程。 完成开发一个新的基础侧边栏插件,并集成到设计器中,了解基于 TinyEngine 扩展设计器功能的能力。 2.2 实验环境准备 在开始实验步骤之前,先确保我们的开发环境以及工具齐全: Node.js v18+版本、pnpm 包管理工具。 vscode 代码编辑器、git 代码版本管理工具。 chrome浏览器 110+ 版本。 必要的开发前端开发环境、工具等。 实践步骤 3.1 一行命令创建自己的专属低代码设计器 3.1.1 创建低代码设计器 执行engine-cli create,选择platform以创建一个新的设计器 npx @opentiny/tiny-engine-cli@alpha create 执行后首次会提示是否安装@opentiny/tiny-engine-cli,输入"Y"并回车 之后会提示选择要创建类型,选择platform之后,输入设计器名称,如:lowcode-designer,即可完成新设计器项目的创建。 查看当前文件目录,看发现已经创建出了 lowcode-designer 代码目录。 3.1.2 启动低代码设计器 执行下面命令安装依赖并启动项目: # 安装依赖 npm install # 启动项目 npm run dev 启动完项目之后,我们应该能看到浏览器打开的默认的低代码设计器: 3.1.3 体验低代码设计器 之后可以体验下低代码开发方式: 拖拽物料面板中组件到中间画布中 在右侧属性面板中修改属性值观察画布中的变化 在画布中拖拽组件调整组件的布局与位置 3.2 通过开发插件扩展设计器新功能 3.2.1 一行命令创建新插件 另起一个终端,输入下面命令,选择创建plugin类型,创建一个新的插件 npx @opentiny/tiny-engine-cli@alpha create 输入插件名称:demo-plugin 之后就可以在demo-plugin目录看到新创建的插件,进去该目录安装依赖: cd demo-plugin && npm install 3.2.2 将插件接入设计器 使用VS Code打开设计器项目,修改registry.js import { Breadcrumb, Fullscreen, /* ... */, GenerateCodeService } from '@opentiny/tiny-engine' import engineConfig from './engine.config' ++ import DemoPlugin from './demo-plugin' export default { // ... -- plugins: [Materials, Tree, Page, Block, Datasource, Bridge, I18n, Script, State, Schema, Help, Robot], ++ plugins: [DemoPlugin, Materials, Tree, Page, Block, Datasource, Bridge, I18n, Script, State, Schema, Help, Robot], dsls: [{ id: 'engine.dsls.dslvue' }], settings: [Props, Styles, Events], canvas: Canvas } 3.2.3 开发调试插件 重新打开项目页面,可以看到侧边栏多了一个新的插件: 修改插件代码,设计器界面也会实时刷新。 之后可以尝试完成以下功能: 为插件实现一个"添加按钮",点击按钮展开插件二级页面 在二级面板中添加一个输入框,并实现保存功能,点击保存按钮将输入框内容显示到一级面板中 如此即完成了一个简单的TinyEngine侧边栏插件开发全流程。 总结 本实践活动指导通过使用TinyEngine CLI创建一个全新设计器,上手体验低代码能力,并开发新的侧边栏插件扩展设计器能力,掌握基于TinyEngine定制设计器与插件的方式,了解TinyEngine的插件化架构与插件扩展能力。但实验中的部分只是TinyEngine扩展定制能力的一个缩影,TinyEngine提供了各种灵活的自定义能力,期待您的继续使用。 关于OpenTiny OpenTiny官网:https://opentiny.design TinyVue 源码:https://github.com/opentiny/tiny-vue(欢迎 Star ⭐) TinyEngine 源码:https://github.com/opentiny/tiny-engine(欢迎 Star ⭐) B站:https://space.bilibili.com/15284299 欢迎加入 OpenTiny 开源社区。添加微信小助手 opentiny-official 一起参与交流前端技术~

优秀的个人博客,低调大师

HBase实操:Spark-Read-HBase-Snapshot-Demo 分享

前言:之前给大家分享了Spark通过接口直接读取HBase的一个小demo:HBase-Spark-Read-Demo,但如果在数据量非常大的情况下,Spark直接扫描HBase表必然会对HBase集群造成不小的压力。基于此,今天再给大家分享一下Spark通过Snapshot直接读取HBase HFile文件的方式。 首先我们先创建一个HBase表:test,并插入几条数据,如下: hbase(main):003:0> scan 'test' ROW COLUMN+CELL r1 column=f:name, timestamp=1583318512414, value=zpb r2 column=f:name, timestamp=1583318517079, value=lisi r3 column=f:name, timestamp=1583318520839, value=wang 接着,我们创建该HBase表的快照,其在HDFS上路径如下: hbase(main):005:0> snapshot 'test', 'test-snapshot' 0 row(s) in 0.3690 seconds $ hdfs dfs -ls /apps/hbase/data/.hbase-snapshot Found 1 items drwxr-xr-x - hbase hdfs 0 2020-03-21 21:24 /apps/hbase/data/.hbase-snapshot/test-snapshot 代码如下: import org.apache.hadoop.fs.Path import org.apache.hadoop.conf.Configuration import org.apache.hadoop.hbase._ import org.apache.hadoop.mapreduce.Job import org.apache.hadoop.hbase.client.Scan import org.apache.hadoop.hbase.mapreduce.{TableInputFormat, TableSnapshotInputFormat} import org.apache.hadoop.hbase.protobuf.ProtobufUtil import org.apache.hadoop.hbase.util.{Base64, Bytes} import org.apache.spark.{SparkConf, SparkContext} object SparkReadHBaseSnapshotDemo { // 主函数 def main(args: Array[String]) { // 设置spark访问入口 val conf = new SparkConf().setAppName("SparkReadHBaseSnapshotDemo") .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer") .setMaster("local")//调试 val sc = new SparkContext(conf) // 获取HbaseRDD val job = Job.getInstance(getHbaseConf()) TableSnapshotInputFormat.setInput(job, "test-snapshot", new Path("/user/tmp")) val hbaseRDD = sc.newAPIHadoopRDD(job.getConfiguration, classOf[TableSnapshotInputFormat], classOf[org.apache.hadoop.hbase.io.ImmutableBytesWritable], classOf[org.apache.hadoop.hbase.client.Result]) hbaseRDD.map(_._2).map(getRes(_)).count() } def getRes(result: org.apache.hadoop.hbase.client.Result): String = { val rowkey = Bytes.toString(result.getRow()) val name = Bytes.toString(result.getValue("f".getBytes, "name".getBytes)) println(rowkey+"---"+name) name } // 构造 Hbase 配置信息 def getHbaseConf(): Configuration = { val conf: Configuration = HBaseConfiguration.create() conf.set(TableInputFormat.SCAN, getScanStr()) conf } // 获取扫描器 def getScanStr(): String = { val scan = new Scan() // scan.set.... 各种过滤 val proto = ProtobufUtil.toScan(scan) Base64.encodeBytes(proto.toByteArray()) } } 注:上述代码需将core-site.xml&hdfs-site.xml&hbase-site.xml文件放在资源目录resources下。否则,应在代码中进行配置,代码如下: package com.xcar.etl import org.apache.hadoop.fs.Path import org.apache.hadoop.conf.Configuration import org.apache.hadoop.hbase._ import org.apache.hadoop.mapreduce.Job import org.apache.hadoop.hbase.client.Scan import org.apache.hadoop.hbase.mapreduce.{TableInputFormat, TableSnapshotInputFormat} import org.apache.hadoop.hbase.protobuf.ProtobufUtil import org.apache.hadoop.hbase.util.{Base64, Bytes} import org.apache.spark.{SparkConf, SparkContext} object SparkReadHBaseSnapshotDemo2 { val HBASE_ZOOKEEPER_QUORUM = "xxxx.com.cn" // 主函数 def main(args: Array[String]) { // 设置spark访问入口 val conf = new SparkConf().setAppName("SparkReadHBaseSnapshotDemo2") .set("spark.serializer", "org.apache.spark.serializer.KryoSerializer") .setMaster("local")//调试 val sc = new SparkContext(conf) // 获取HbaseRDD val job = Job.getInstance(getHbaseConf()) TableSnapshotInputFormat.setInput(job, "test-snapshot", new Path("/user/tmp")) val hbaseRDD = sc.newAPIHadoopRDD(job.getConfiguration, classOf[TableSnapshotInputFormat], classOf[org.apache.hadoop.hbase.io.ImmutableBytesWritable], classOf[org.apache.hadoop.hbase.client.Result]) hbaseRDD.map(_._2).map(getRes(_)).count() } def getRes(result: org.apache.hadoop.hbase.client.Result): String = { val rowkey = Bytes.toString(result.getRow()) val name = Bytes.toString(result.getValue("f".getBytes, "name".getBytes)) println(rowkey+"---"+name) name } // 构造 Hbase 配置信息 def getHbaseConf(): Configuration = { val conf: Configuration = HBaseConfiguration.create() conf.set("hbase.zookeeper.property.clientPort", "2181") conf.set("zookeeper.znode.parent", "/hbase") conf.set("hbase.zookeeper.quorum", HBASE_ZOOKEEPER_QUORUM) conf.set("hbase.rootdir", "/apps/hbase") // 设置查询的表名 conf.set(TableInputFormat.INPUT_TABLE, "test") conf.set("fs.defaultFS","hdfs://xxxxxx:8020") conf.set(TableInputFormat.SCAN, getScanStr()) conf } // 获取扫描器 def getScanStr(): String = { val scan = new Scan() // scan.set.... 各种过滤 val proto = ProtobufUtil.toScan(scan) Base64.encodeBytes(proto.toByteArray()) } } TableSnapshotInputFormat.setInput 方法参数解析: public static void setInput(org.apache.hadoop.mapreduce.Job job, String snapshotName, org.apache.hadoop.fs.Path restoreDir) throws IOException 参数解析: job - the job to configure snapshotName - the name of the snapshot to read from restoreDir - a temporary directory to restore the snapshot into. Current user should have write permissions to this directory, and this should not be a subdirectory of rootdir. After the job is finished, restoreDir can be deleted. 项目用到的 pom.xml 文件: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.zpb.test</groupId> <artifactId>spark-read-hbase-snapshot-demo</artifactId> <version>1.0-SNAPSHOT</version> <packaging>jar</packaging> <name>spark-read-hbase-snapshot-demo</name> <url>http://maven.apache.org</url> <repositories> <repository> <id>cloudera</id> <url>https://repository.cloudera.com/artifactory/cloudera-repos/</url> </repository> </repositories> <properties> <cdh.hbase.version>1.2.0-cdh5.7.0</cdh.hbase.version> <cdh.spark.version>1.6.0-cdh5.7.0</cdh.spark.version> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> </properties> <dependencies> <dependency> <groupId>junit</groupId> <artifactId>junit</artifactId> <version>3.8.1</version> <scope>test</scope> </dependency> <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson</artifactId> <version>1.2.62</version> </dependency> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spark-core_2.10</artifactId> <version>${cdh.spark.version}</version> <!--<scope>provided</scope>--> </dependency> <dependency> <groupId>org.apache.hbase</groupId> <artifactId>hbase-server</artifactId> <version>${cdh.hbase.version}</version> </dependency> </dependencies> </project> 欢迎关注本人公众号【HBase工作笔记】,解锁更多姿势~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册