首页 文章 精选 留言 我的

精选列表

搜索[实时数仓],共9518篇文章
优秀的个人博客,低调大师

Scrum 实操流程

Scrum 是用于开发、交付和持续支持复杂产品的一个框架,是一个增量的、迭代的开发过程。 敏捷的原则和方法 必须在每天的实践中落地,对人和管理要求高。所以有scrum master 为了适应变化,敏捷的迭代周期短 特征 迭代开发 :这意味着你应该重复开发过程。 增量交付 :意味着你应该一步一步地创建产品的“可用”子集,而不是在项目结束时一次性交付。 原则 迭代是受时间框限制的,也就是说即使放弃一些功能,也必须结束迭代。 每次迭代结束的时候让产品达到可交付状态十分重要, 每次迭代都以一个可运行的产品的公布而结束。 迭代开发是在变与不变中寻求平衡,在迭代开始的时候寻求变,而在迭代开发期间不能改变,以期集中精力完成已经确定的工作。由于一次迭代的时间并不长,所以就使稳定性和易变性得到很好的平衡。经验证明:4周是非常好的时间。 能否每个Sprint生成满足质量定义的PSPI 是Scrum 执行效果的试金石。 角色 product owner 作为产品负责人,PO清楚地知道产品的愿景,需要对产品待办列表的梳理、优化、优先级排序等负责。PO决定Why和What,一般可以对应为我们理解的产品经理和业务分析师的角色。 主要负责确定产品的功能和达到要求的标准,指定软件的发布日期和交付的内容,同时有权力接受或拒绝开发团队的工作成果。 Scrum master 主要负责整个Scrum流程在项目中的顺利实施和进行,以及清除挡在客户和开发工作之间的沟通障碍, 一般可以对应为我们理解的项目经理的角色。 Scrum team 主要负责软件产品在Scrum规定流程下进行开发工作。每位成员可能负责不同的技术方面(开发、测试),要求团队有很强的自组织能力,能够交付一个端到端的真正对客户有价值的产品。 曾经需要由经理或者lead来分配任务的团队,现在需要自己评审,估算,制定故事点数来管理BUG,然后再自己承诺在一个sprint中要解决的问题。 开发小组的工作 作为一个整体工作 :开发团队、测试团队、客服团队和product owner一起工作 按短迭代周期工作 :大部分是 2~4周,在 Scrum中采用的是 30个日历天,也就是 4 周。 每次迭代包括:分析、设计、编码、测试,变成可交付的软件(称之为功能增量) 关注业务优先级:按照PO制定的优先级交付功能 检查与调整 :每次新迭代开始,敏捷小组都会结合上一次迭代中获得新知识做出相应调整。 概念/工具 产品代办列表 Product backlog 使用产品Backlog来管理产品的需求, 产品backlog是一个按照商业价值排序的需求列表 PO首先将需求按照优先级进行排列,产生一个Product Backlog。作用类似于传统开发中项目经理确定需求文档 用户故事 user story :尽量减少依赖 冲刺代办列表 Sprint backlog 先有product backlog 产品经理和项目团队紧密协作,一起定义目标、梳理产品需求清单。清单中通常会包含产品特性、修复bug、非必要功能需求以及其他要在交付时完成的工作。 当研发团队制定了迭代清单后,除了团队成员外,任何人都不能再加入需求。 看板 工作流可视化 高度可视化的调度系统 DOD 用户故事完成dod 迭代完成dod 发布完成dod CI/CD 持续集成/部署 一次集成要做哪些事情呢?它至少包括:获得所有源代码、编译源代码、运行所有测试,包括单元测试、功能测试等; 会议 Sprint计划会议, sprint planning meeting 每日站会 Daily scrum meeting, 短期会议固定的日常循环下,每一位团队成员都回答三个问题: 上一次会议我完成了什么? 达到我的目标碰到了什么障碍? 下一次会议之前我需要做些什么? 调整,优化次日工作。 Sprint 评审会议 检验发布目标的进展,优化下一个sprint Sprint回顾会议 回顾已经完成的sprint, 并且确定做出什么改善使下个sprint更高效,快乐,满意 流程 1、我们首先需要确定一个Product Backlog(按优先顺序排列的一个产品需求列表),这个是由Product Owner 负责的; 2、Scrum Team根据Product Backlog列表,做工作量的预估和安排; 3、有了Product Backlog列表,我们需要通过 Sprint Planning Meeting(Sprint计划会议)来从中挑选出一个Story作为本次迭代完成的目标,这个目标的时间周期是1~4个星期,然后把这个Story进行细化,形成一个Sprint Backlog; 4、Sprint Backlog是由Scrum Team去完成的,每个成员根据Sprint Backlog再细化成更小的任务(细到每个任务的工作量在2天内能完成); 5、在Scrum Team完成计划会议上选出的Sprint Backlog过程中,需要进行 Daily Scrum Meeting(每日站立会议),每次会议控制在15分钟左右,每个人都必须发言,并且要向所有成员当面汇报你昨天完成了什么,并且向所有成员承诺你今天要完成什么,同时遇到不能解决的问题也可以提出,每个人回答完成后,要走到黑板前更新自己的Sprint burn down(Sprint燃尽图); 6、做到每日集成,也就是每天都要有一个可以成功编译、并且可以演示的版本;很多人可能还没有用过自动化的每日集成,其实TFS就有这个功能,它可以支持每次有成员进行签入操作的时候,在服务器上自动获取最新版本,然后在服务器中编译,如果通过则马上再执行单元测试代码,如果也全部通过,则将该版本发布,这时一次正式的签入操作才保存到TFS中,中间有任何失败,都会用邮件通知项目管理人员; 7、当一个Story完成,也就是Sprint Backlog被完成,也就表示一次Sprint完成,这时,我们要进行Srpint Review Meeting(演示会议),也称为评审会议,产品负责人和客户都要参加(最好本公司老板也参加),每一个Scrum Team的成员都要向他们演示自己完成的软件产品(这个会议非常重要,一定不能取消); 8、最后就是Sprint RetrospectiveMeeting(回顾会议),也称为总结会议,以轮流发言方式进行,每个人都要发言,总结并讨论改进的地方,放入下一轮Sprint的产品需求中; 本文分享自微信公众号 - PM吃瓜(wu_lian_club)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

【实操】VPC迁移

现在阿里云要求所有的云上用户在本月底之前将所有经典网络环境的产品迁移至专有网络VPC中,需要迁移而且还没有操作的用户需要抓紧时间了。下面给大家分享一个用户的迁移案例。 这个案例的产品架构是一个SLB下面挂着两台ECS,后端连接着RDS。因此需要将SLB、ECS、RDS都迁移至专有网络VPC下。 既然要迁移到VPC,我们就需要先来创建一个VPC。点击阿里云控制台下的“专有网络VPC”,然后点击“创建专有网络”。注意要选择和我们的云产品在同一地域。 然后需要我们配置专有网络和虚拟交换机,注意虚拟交换机要选择和我们的云产品在同一可用区,点击“确定”。 创建好VPC之后我们顺便来配置一下安全组(也可以之后再配置,但是必须要配置)。点击我们刚刚创建的VPC,再点击安全组进入安全组列表。点击右上角的“创建安全组”。 之后会弹出安全组配置窗口,阿里云给用户提供了windows和linux两种模板可以直接使用。两种模板开通的端口是完全一样的,当然我们也可以自行配置要开通的端口。然后输入安全组的名称,网络类型一定要选择专有网络,再选择我们刚刚创建的VPC。选择好以后点击“确定”。 以上工作都做好之后我们先来迁移RDS,点击我们要迁移的RDS实例,在数据库连接页面中点击“切换为专有网络”。 之后会弹出切换为专有网络的配置窗口,选择我们刚刚之前创建的VPC和虚拟交换机。勾选“保留原经典网络”的话可以保留现有经典网络的RDS实例最多120天,超过保留期限之后将会被释放。最后点击“确定”就可以完成RDS经典网络往专有网络VPC的切换了。切换过程中数据库会中断连接,请在不影响业务的情况下操作。 有的时候会提示我们无法操作,需要开启高安全模式才能切换为专有网络。高安全模式需要我们到数据库代理页面中开启。需要注意的是开启高安全模式会降低数据库的相应时间20%以上,另外开启的时候数据库连接会中断10秒左右。 RDS迁移完之后我们再来迁移ECS,ECS的迁移需要先跟阿里云预约。选择我们要迁移的服务器,点击“更多”-“网络和安全组”-“预约迁移至专有网络”。 接下来会弹出窗口提示我们一些注意事项,点击“确定”就完成预约了。之后我们需要等待阿里云审批。 审批进度可以在“云服务器ECS”-“概览”-“待处理事件”中查看。 审批通过之后就可以进行后续的操作了,同样到“待处理事件”中查看,可以看到现在的状态是等待预约。 勾选我们需要迁移的实例,然后点击“预约迁移”。 接下来需要选择我们之前创建的VPC、虚拟交换机、和专有网络安全组,下面还需要设置迁移的时间,一般时间会默认在当前操作时间的1小时之后。确认没问题之后点击“确定”。 操作完之后阿里云会在到达我们预约迁移时间的时候自动执行ECS实例的迁移。这时候实例需要重启,注意设定预约时间的时候选择不影响业务的时间来迁移。另外ECS从经典网络迁移到专有网络VPC之后公网地址不会改变,但是无法在ECS实例端查看到ECS公网地址,所以如果部署的应用对ECS操作系统上可见的公网IP有依赖,迁移后会有影响,请谨慎评估。最后当我们把ECS的迁移工作完成之后SLB会自动添加新的ECS地址,不需要我们去操作。 注意事项1、ECS和RDS的迁移过程都有一段时间无法正常工作,迁移操作请选择合适的时间进行。2、ECS迁移之后内网地址会改变,所以需要在RDS白名单中配置新的ECS内网IP来保证ECS和RDS之间的正常访问。3、部分Windows操作系统的用户在迁移之后出现web应用无法访问的问题,基本都是因为host配置中的地址还是原经典网络的IP造成的。 更多内容请关注

优秀的个人博客,低调大师

运行时数据区——Java堆

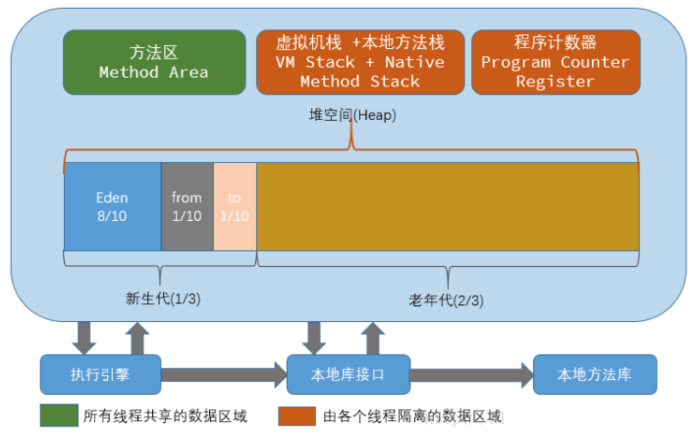
Java程序在运行时创建的所有类实例或数组都放在同一个堆中。一个Java虚拟机实例中只存在一个堆空间, 因此所有线程都将共享这个堆,它在虚拟机启动时创建。 又由于一个Java程序独占一个Java虚拟机实例, 因而每个Java程序都有它自己的堆空间——它们不会彼此干预 。但是同一个Java程序的多个线程却共享着同一个堆空间,在这种情况下,就得考虑多线程访问对象(堆数据)的同步问题了。 堆在JVM启动时创建。该内存区域存放了对象实例及数组(所有new的对象)。其大小通过-Xms(最小值)和-Xmx(最大值)参数设置,-Xms为JVM启动时申请的最小内存,默认为操作系统物理内存的1/64但小于1G,-Xmx为JVM可申请的最大内存,默认为物理内存的1/4但小于1G,默认当空余堆内存小于40%时,JVM会增大Heap到-Xmx指定的大小,可通过-XX:MinHeapFreeRation=来指定这个比列;当空余堆内存大于70%时,JVM会减小heap的大小到-Xms指定的大小,可通过XX:MaxHeapFreeRation=来指定这个比列,对于运行系统,为避免在运行时频繁调整Heap的大小,通常-Xms与-Xmx的值设成一样。 Java虚拟机有一条在堆中分配新对象的指令, 却没有释放内存的指令。正如你无法用Java代码去明确释放一个对象一样,字节码指令也没有对应的功能。虚拟机自已负责决定如何以及何时释放不再被运行的程序引用的对象所占据的内存 。程序本身不用去考虑何时需回收对象所占用的内存,通常虚拟机把这个任务交给垃圾收集器。由于Java堆是垃圾收集器管理的主要区域,因此很多时候也被称做“GC堆'' 。 和方法区一样, 堆空间也不必是连续的内存区。 在程序运行时, 它可以动态扩展或收缩。事实上, 一个实现的方法区可以在堆顶实现。 换句话说, 就是当虚拟机需要为一个新加载的类分配内存时, 类型信息和实际对象可以都在同一个堆上。 因此, 负责回收无用对象的垃圾收集器可能也要负责无用类的释放(卸载)。另外,某些实现可能也允许用户或程序员指定堆的初始大小、最大最小值等等 由于现在收集器都是采用分代收集算法,堆被划分为新生代和老年代。 新生代主要存储新创建的对象和尚未进入老年代的对象。程序新创建的对象都是从新生代分配内存,新生代由Eden Space和两块相同大小的Survivor Space(通常又称S0和S1或From和To)构成,可通过-Xmn参数来指定新生代的大小,也可以通过-XX:SurvivorRation来调整Eden Space及Survivor Space的大小。 老年代存储经过多次新生代GC(Minor GC)任然存活的对象,例如缓存对象,新建的对象也有可能直接进入老年代,主要有两种情况: 1、大对象,可通过启动参数设置-XX:PretenureSizeThreshold=1024(单位为字节,默认为0)来代表超过多大时就不在新生代分配,而是直接在老年代分配。 2、大的数组对象,切数组中无引用外部对象。 老年代所占的内存大小为-Xmx对应的值减去-Xmn对应的值。 Young Generation 即图中的Eden + From Space + To Space Eden 存放新生的对象 Survivor Space 有两个,存放每次垃圾回收后存活的对象 Old Generation 或者叫Tenured Generation 即图中的Old Space 主要存放应用程序中生命周期长的存活对象 参考: http://www.hollischuang.com/archives/80

优秀的个人博客,低调大师

Java运行时数据区详解

Java虚拟机在执行java程序的过程中会把它所管理的内存划分为若干个不同的数据区域.根据 <<java虚拟机规范>> 中的规定,将内存区域划分为 程序计数器(Program Counter Register),虚拟机栈(VM Stack),本地方法栈(Native Method Stack),方法区(Method Area)和堆(Heap)五大区域. 运行时内存区域 程序计数器(Program Counter Register) 程序计数器是一块很小的内存区域,可以当成当前线程所执行的字节码的行号指示器.java解释器通过改变计数器值来选取下一条指令.分治,循环,跳转,异常处理,线程恢复等需要依赖计数器完成 特点: 每一个线程都有一个独立的程序计数器,互不影响.(线程私有) 线程执行Java方法,计数器记录的是正在执行的虚拟机字节码指令的地址. 线程执行Native方法,计数器则为空. 唯一一个没有定义 OutOfMemoryError的区域. 虚拟机栈(VM Stack) 虚拟机栈它的栈元素是一种叫做栈帧(Stack Frame)的结构.每一个栈帧都包括了 局部变量表(Local Variable Table),操作数栈(Operand Stack),动态链接(Dynamic Linking),方法返回地址(Return Address)和一些额外信息. 栈帧是用于支持虚拟机进行方法调用和方法执行的数据结构,每一个方法从调用开始至执行完成的过程,都对应着一个栈帧在虚拟机栈里面从入栈到出栈的过程. 栈帧结构 特点: Java虚拟机栈是线程私有的,生命周期与线程一致 局部变量表所需的内存空间在编译期间确定,并完成分配. 在方法运行期间不会改变局部变量表的大小. 如果请求的栈深度大于虚拟机允许的深度,抛出StackOverflowError. 虚拟机栈扩展时无法申请足够的内存,抛出OutOfMemoryError 本地方法栈(Native Method Stack) 功能与虚拟机栈类似,java线程在调用本地方法时,该区用来存储本地方法的局部变量表,本地方法的操作数栈等等信息.区别在于虚拟机栈执行的是java方法, 本地方法栈执行的是native方法(c/c++方法). java是高级编程语言,当对一些底层的如操作系统或某些硬件交换信息时,我们使用java来编程实现起来不容易,再者使用java来编程效率也很低下.这时候就可以通过 JNI方式来调用 native方法来实现. 本地方法栈与java栈 如果,展示了java与native方法交互的过程,java方法中调用了C语言方法,产生在本地方法栈中产生一个本地栈帧,这个C语言方法调用了另一个C语言方法,并且把结果回调回java方法中. 一个线程可能在整个生命周期中都执行Java方法,操作他的Java栈;或者他可能毫无障碍地在Java栈和本地方法栈之间跳转。 特点 : 线程私有,生命周期与线程一致 调用的是 c/c++方法(一般用于底层交互,或者性能优化) 可抛出StackOverflowError和OutOfMemoryError java堆(Heap) java虚拟机中最大的内存区域,几乎所有类实例和数组的内存均从此处分配。 线程共享 在 Java 虚拟机启动时创建的 GC管理的主要区域 可位于物理内存不连续的空间. 可以是固定大小的,也可以是可扩展的. 在没有内存空间并且无法扩展时,抛出OutOfMemoryError hotspot中的实现 在hotspot虚拟机中,从内存回收的角度来看是采用 分代收集策略.将堆划分为两个不同的区域:新生代(Young Gen)和老年代(Old Gen). 堆的空间大小 = 新生代 + 老年代; 默认情况下,新生代和老年代的比例是 1:2; 新生代又被划分为Eden,From Survivor和To Survivor三个区域;大小比例为 8:1:1 由于新生代采用复制算法来管理空间,因此,无论什么时候,总是有一块 Survivor 区域是空闲着的。 新生代实际可用的内存空间为90%的新生代空间。 方法区(Mthod Area) 方法区中,存储着已加载的类信息,常量,静态变量,即时编译后的代码等数据. 其中类相关的信息,如类名,访问修饰符,常量池,字段描述,方法描述等. 方法区逻辑上属于堆的一部分,但是为了与堆进行区分,通常又叫“非堆”。 方法区的数据是线程共享的. 为何叫方法区? 方法区中除了包括“已加载的类的基本信息、常量、静态变量等”外,还包括编译器编译后的代码,而且这应该是方法区中主要的一部分,这可能是为何把这部分内存成为方法区的原因. 注释 : 类的对象和实例对象存放在 java堆中, 类的元数据存放在 方法区中. 不同jdk(hotspot)版本,方法区数据的变化 JDK 1.6以及之前,方法区的实现为 永久代(Permanent Gen)的方式,目的是为了垃圾收集器能像管理java堆一样管理这部分内存.垃圾回收目标是针对常量池的回收和对类型的卸载. JDK 1.7中,存储在永久代的部分数据就已经转移到Java Heap或者Native Heap。但永久代仍存在于JDK 1.7中,并没有完全移除,如符号引用(Symbols)转移到了native heap;字面量(interned strings)转移到了Java heap;类的静态变量(class statics)存放于定义类型的class对象中,存放在Java heap中. JDK 1.8中, 完全移除了永久代,取而代之的实现方式成为元空间(Metaspace),将类元数据放到本地内存中,将字符常量池和静态变量放到Java堆里。虚拟机会为类的元数据明确分配和释放本地内存。 元空间的本质和永久代类似,都是对JVM规范中方法区的实现。不过元空间与永久代之间的最大区别在于:元空间并不在虚拟机中,而是使用本地内存。 Native memory:本地内存,也称为C-Heap,是供JVM自身进程使用的。当Java Heap空间不足时会触发GC,但Native memory空间不够却不会触发GC。即GC不管理元空间(Metaspace)的内存. 为什么移除永久代? 字符串存在永久代中,容易出现性能问题和内存溢出。 永久代大小不容易确定,PermSize指定太小容易造成永久代OOM 永久代会为 GC 带来不必要的复杂度,并且回收效率偏低。 Oracle 可能会将HotSpot 与 JRockit 合二为一。 参考 深入理解java虚拟机_第二版(周志明) 图解JVM字节码执行引擎之栈帧结构 Java8内存模型 Java —— 运行时栈帧结构

优秀的个人博客,低调大师

运行时数据区——方法区

在Java虚拟机中, 关于被装载类的信息存储在一个逻辑上被称为方法区的内存中。 当虚拟机加载某个类型时,它使用类加载器定位相应的class文件,然后读入这个class文件——一个线性二进制数据流,然后将它传输到虚拟机中 ,紧接者虚拟机提取其中的类型信息, 并将这些信息存储到方法区。该类型中的类(静态)变量同样也是存储在方法区中。 由于所有线程都共享方法区, 因此它们对方法区数据的访问必须被设计为是线程安全的 。假设同时有两个线程都企图访问一个类, 而这个类还投有被装入虚拟机, 那么,这时只应该有一个线程去加载它,而另一个线程则只能等待。 方法区的大小不必是固定的, 虚拟机可以根据应用的需要动态调整。同样, 方法区也不必是連续的, 方法区可以在一个堆(甚至是虚担机自已的谁)中自由分配。 另外, 虚拟机也可以允许用户或者程序员指定方法区的初始大小以及最小和最大尺寸等 。 方法区也可以被垃圾收集, 因为虚拟机允许通过用户定又的类加载器来动态扩展Java程序, 因此一些类也会成为程序“不再引用”的类。当某个类变为不再被引用的类时, Java虚拟机可以卸裁这个类(垃圾收集),从而使方法区占据的内存保持最小。 运行时常量池 运行时常量池(RuntimeConstant Pool)是方法区的一部分。 Class文件中除了有类的版本、字段、方法、接口等描述等信息外。还有一项信息是常量池(ConstantPooI Tabte), 用于存放编译期生成的各种字面量和符号引用, 这部分内容将在类加载后存放到方法区的运行时常量池中 。 类型信息 类型信息 对每个装载的类, Java虚拟机都会在方法区中存储以下类型信息: 这个类的全限定名 这个类的直接超类的全限定名(除非这个类型是java.]ang.0t,ject,它没有超类)。 这个类是类类型还是接口类型 这个类的访问修饰符( public、 abstract或final的某个子集)。 任何直接超接口的全限定名的有序列表 在Java class文件和虚拟机中, 类型名总是以全限定名出现。 在Java源代码中,全限定名由类所属包的名称加一个“.”,再加上类名组成。例如,类0bject的所属包为java.iang,那它的全限定名应该是java.lang.0bject,但在class文件里,所有的“.”都被斜杠 “/”代替,这样就成为java/lang/0bject。 至于全限定名在方法区中的表示, 则因不同的设计者有不同的选择而不同, 可以用任何形式和数据结构来代表。 参考: http://www.hollischuang.com/archives/80 https://mritd.me/2016/03/22/Java-%E5%86%85%E5%AD%98%E4%B9%8B%E6%96%B9%E6%B3%95%E5%8C%BA%E5%92%8C%E8%BF%90%E8%A1%8C%E6%97%B6%E5%B8%B8%E9%87%8F%E6%B1%A0/

优秀的个人博客,低调大师

《Storm实时数据处理》一导读

前 言 开源已经在许多方面从根本上改变了软件的原有面貌。在很多应用环境中,人们都会争论使用开源带来的好处和坏处,主要体现在支持、风险以及总体拥有成本等方面。开源在某些领域比其他领域流行,比如在研究机构中就比在大型金融服务提供商中应用得多。在某些新兴领域,比如Web服务供应商、内容供应商以及社交网络等,开源软件占据主导地位。其原因是多方面的,其中成本是一个非常大的因素。怎么说呢?如果方案要上升到网络规模,那么一般会应用“大数据”解决方案,以期获得更好的效果。凭借极佳的可用性,这些解决方案每秒处理数百万条请求,同时通过各式各样的服务为客户提供定制体验。这种规模的系统设计需要我们用不同的方式思考问题,采用不同的架构解决方案,而且要了解什么时候应该接受系统的复杂性以及什么时候应该避免这种复杂性。作为行业中人,我们应该掌握这种大规模批处理系

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册