首页 文章 精选 留言 我的

精选列表

搜索[实时数仓],共2200篇文章
优秀的个人博客,低调大师

负面舆情应对处置方案:大型企业落地指南(2026年实操版)

2026年大型企业负面舆情应对处置落地指南:避开部门推诿、口径不一、预案不演练三坑,搭建分级响应、统一发言人、跨部门协同、常态化演练四模块,并选用全渠道监测工具,理顺组织架构,实现危机时快速联动、统一发声、降低影响。   ![](https://developer.qcloudimg.com/http-save/audit-12849220/22ccc84ab0086babd69a654a72d2986c.jpg) **一、大型企业做舆情方案,最容易踩的3个坑** 别觉得公司大、制度全,做出来的舆情方案就一定好用,很多时候反而因为机构太复杂,落不了地。 第一个坑:部门墙太厚,出事了互相踢皮球。公关说产品问题该找质量部,质量说流程问题该找运营,运营说该找客服,一圈转下来,黄金响应时间就耽误了。方案里没写清楚谁牵头、谁配合、谁拍板,真出事的时候就是一锅粥。 第二个坑:对外口径不统一。大公司部门多、层级多,官方账号说一套,区域分公司说一套,产品经理接受采访又说一套。本来不是多大的事,几个不同的说法放一起,反而让网友觉得企业心虚、前后矛盾,小事越闹越大。 第三个坑:预案写了厚厚一本,从来没演练过。真出事的时候,大家对着手册翻半天,不知道该找哪个部门、不知道该走什么流程,方案写得再全也是摆设。 **二、大企业的方案,核心要搭这4个模块** 大公司的方案不能像小公司那样一页纸搞定,但也不能搞成几十上百页的官样文章,把下面这四个模块搭清楚,基本就够用了。 **第一块:分级响应机制,明确不同级别谁牵头** 别搞太复杂,就分三级就行: 一般负面:零星投诉、个别差评,客服部门跟进处理就行,周报里同步给公关部。 较大负面:开始有媒体关注、传播范围扩大,由公关部牵头,拉上产品、客服、法务一起开个短会,24小时内出初步回应。 重大危机:上了热搜、涉及安全问题、政府部门介入,直接由公司高层牵头成立应急指挥部,全公司资源配合,随时同步进展。 **第二块:统一发言人制度,对外只一个出口** 大公司最怕的就是人人都出来说话。方案里必须明确:对外只有指定的发言人和官方账号能发声,其他部门、其他员工一律不能随便接受采访、不能在个人账号上评论相关事件。所有对外口径必须经过公关部审核,确保说出来的话前后一致。 **第三块:跨部门协同小组,平时就固定下来** 不要等出事了再临时拉群,平时就把舆情应对的跨部门小组固定下来:公关、产品、质量、法务、客服,每个部门指定一个对接人,平时就认识、就知道出事了找谁。这样真出事的时候,不用再花时间协调人,直接拉群就能干活。 **第四块:常态化演练,每半年至少一次** 方案好不好用,练一次就知道了。每半年搞一次模拟演练,随便出个虚拟场景,看各个部门多久能响应、口径统不统一、流程顺不顺。练完哪里卡壳就改哪里,别等真出事了才发现问题。 **三、工具要选能支撑全公司需求的** 小企业选基础版不一样,大企业选工具要看几点:能不能覆盖全渠道、能不能按部门分账号权限、能不能自动出报告、响应速度够不够。毕竟大公司要监测的点多,光靠人盯是盯不过来的,工具能帮你省掉大量重复劳动,把人力放在研判和处置上。 说到底,大型企业的负面舆情应对处置方案,核心就是把组织架构理顺——谁牵头、谁配合、谁说话、怎么练,把这些写清楚了,真出事的时候就不会乱。方案不是写给监管看的,是真出事的时候能让整个公司快速转起来,把影响降到最低。 **常见问题(FAQ)** **Q1:大型企业需要专门成立一个舆情部门吗?** 不一定。看公司规模和行业敏感度,一般是公关部下面带几个人做专职监测和研判,不需要单独成立一级部门。关键是要把跨部门的协同机制建起来,不是靠一个部门单打独斗。 **Q2:重大舆情发生后,多长时间出第一份回应比较合适?** 一般建议在2到4小时内出初步回应,哪怕只是说“我们已经关注到这件事,正在核实情况”,也好过一声不吭。大型企业体量大,关注度高,沉默很容易被解读成默认。当然,回应之前一定要把基本情况核实清楚,不能乱说话。 **Q3:分公司和总部的口径不一样怎么办?** 方案里必须明确:涉及公司层面的重大舆情,对外统一由总部公关部发声,分公司不能随便表态。日常的属地小问题,分公司可以自己处理,但口径要报总部备案。这样就不会出现总部和分公司说法打架的情况。

优秀的个人博客,低调大师

Sim4Life 实操笔记:横切面 + 电流源 +调变波形

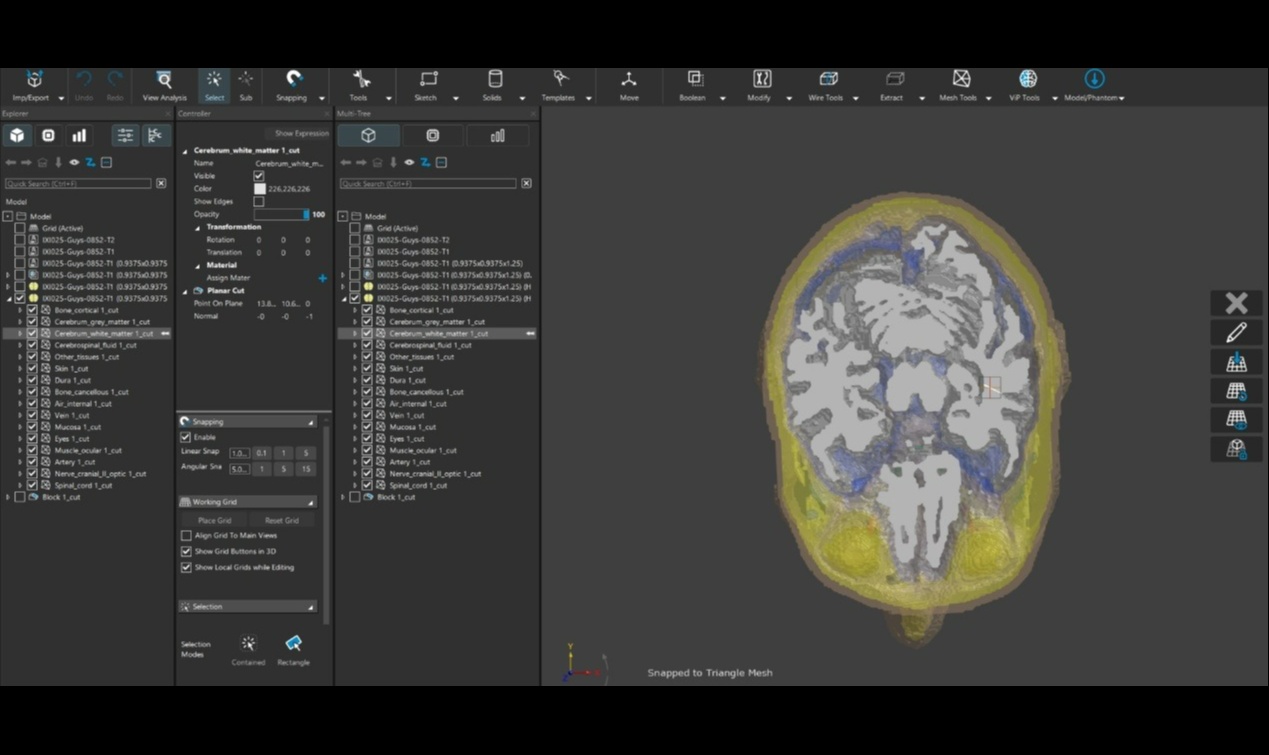
# 本文解决三个具体问题: 1\. 如何在 Sim4Life 中快速生成模型的横切面(Planar Cut),并准确识别各几何组织的归属; 2\. 如何将求解器输出的场结果做电流归一化,并导出为 Cache 文件供新来源调用; 3\. 如何将 Modulation 调变波形分别套用到神经求解器(电场)与热求解器(功率损 耗)中。 每步都给出菜单路径、关键勾选项和结果确认方式,适合边看边操作。 # 一、Sim4Life 中产生模型横切面(Planar Cut 操作步骤) ## 1.建立包覆整个模型的方框(Block) 点选上方选单的 Solid → 选择 Block 在视图中绘制一个能完全包住 MRI 模型的方形方块 调整尺寸和位置,确认模型已完整包覆 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/748a2eb1f438885625ce1f4ef8ae0141.jpg) ## 2.复制模型为可剪切版本 (原厂模型汇入才需此操作) 在左边 Explorer 区中,找到原始模型文件夹 对该模型右键 → 选择 Clone with Expressions 新复制出来的模型会出现在 Explorer 区中 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/3efda763ef3b31954fe4e90752560ab6.jpg) ## 3.展开模型、选取所有对象 点选新复制模型旁的小三角形,展开内容物 按住 Ctrl 或 Shift + 左键,将所有内容物一一选取 (注:不要只选资料夹,必须展开后逐个选物件 ) 接着也把刚刚绘制的 Block 一并选取 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/854983ff742efea0fe35074459577ce9.jpg) ## 4.执行 Planar Cut 点选上方选单的 Modify → 选择 Planar Cut 会出现一个半透明的切割平面 + 三轴移动控制器 可以在左侧 Controller 面板中调整: 切割平面方向(XY、YZ、XZ) 三轴坐标翻转 使用蓝色、红色、黄色箭头拖动平面到你想要的位置 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/d696e64aae8e99f396a8c3f174431eca.jpg) ## 5.完成切割 确认位置无误后,点选右侧的 Create Cut 模型会被裁切,留下平面法线(蓝色箭头)所指的那一侧 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/95a26fca23183465961eb3c3a7a69c28.jpg) ## 6.隐藏 Block、观察横切面 回到 Explorer 区域 找到先前绘制的 Block,取消前方的勾勾,隐藏它 此时你会看到一个清楚的横切面模型 在画面中点选横切面上任一区块 左侧将会自动亮起显示所属的几何或组织名称 可以快速辨识是哪个结构或组织 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/1074edc0beca047168c499c1cb0a1c4f.jpg) # 二、电流规一化设作电流源 1.前往 Analysis 分页,选择求解器结果,并提取 Overall Field ![](https://developer.qcloudimg.com/http-save/yehe-12547743/b75a2e36c91a76748fa3c8d7ee845c46.png) 2.点选该 Overall Field 物件,展开右侧的 Controller 区块,并将画面滑至最底 部,勾选「Normalize Frequency-Domain Results」选项,此操作会在下方显示出 电流设定栏位 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/bdf9ab560e8cf93bcd342a29910f2c91.png) 3.设定所需的电流大小,在下方栏位中找到电场结果 EM E(x,y,z,f0),右键点选并 选择 Export > Data Cache ![](https://developer.qcloudimg.com/http-save/yehe-12547743/c55f2c222fa8a18f806e668f49de659b.png) 4.设定存档路径,并按下右上角的「Refresh」按钮,使档案成功储存在指定位置 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/e23afe46b6c0609c6a319af52d32f758.png) 5.切换至 Simulation 分页,选择求解器,点选左侧的 Sources 区块,然后按下右 侧的 New Setting,建立一个新的来源设定 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/89a5f14717a826d0d1a50806c11995dc.png) 6.点选新增出来的 Source 资料夹,在 Source Type 下拉选单中可见三种选项 第一个:使用其他求解器(如 EM Solver)所产生的 Overall Sensor 作为来源 第二个:导入从 Analysis 块导出的结果(即 Cache 文件) 第三个:导入自定义的 Modulation Signal ![](https://developer.qcloudimg.com/http-save/yehe-12547743/4dde2b4fc380fe2828a4a353742e8d45.png) 7.本范例选择第二项,并载入于之前步骤所汇出的 Cache 档案,即可将其作为电流来源使用 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/22d3d7c11e21e562f2566ce0b03982fc.png) # 三、将 Modulation 套用至 LF 场结果 ## 1.汇入调变波形 在 Analysis 介面选择 Imp/Export → Import,汇入调变波形。 导入后,结果中会出现 Extract Mod. ![](https://developer.qcloudimg.com/http-save/yehe-12547743/09af3044ecfb98eddd65f1010b6f6ed7.png) ## 2.选取欲调变的场结果与波形 选取 LF 模拟 Overall Field 中欲使用的结果,例如 EM E(x,y,z,f0) 或 El. Loss Density(x,y,z,f0); 再同时选取 Extract Mod. 下的 Modulation(t) 点选 Modulation → Modulate 建立调变分析 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/64163cd254bcadde7583bdb4aed72750.png) ## 3.在神经求解器选择调变分析来源 进入神经求解器 → Sources → Source Settings,将 Source Type 改为 Modulated Analysis / Cache ![](https://developer.qcloudimg.com/http-save/yehe-12547743/52e69a12ae87d1cdc65c5894868ff953.png) ## 4.指定神经求解器的资料来源 在 Origin of the Modulated Source Data 中,将 Data Origin Type 设为 Analysis Output ![](https://developer.qcloudimg.com/http-save/yehe-12547743/83d52a8755ffbaed39d2be418362c75f.png) ## 5.选取调变后的电场结果 点选 Output Name 旁的 ...,选取建立完成的 Modulated EM E(x,y,z,f0)。 此结果即作为神经求解器的时变外加电场来源 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/30d79920263096268fff9e57c23bd3de.png) ## 6.确认神经刺激波形 点选 Show Pulse,确认调变波形的振幅、周期与刺激时间是否符合预期 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/228767e71d1736dd301f96b06a7eab14.png) ## 7.确认可供热分析使用的调变功率损耗结果 若要进行热分析,于 Analysis 中确认 选取 LF 模拟 Overall Field 中欲使用的结果 El. Loss Density(x,y,z,f0)和点选 Modulation → Modulate 建立调变分析 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/11f533fbe937c23e2ddb612a45a0d935.png) ## 8.在热求解器指定热源 来到热求解器 → Sources → Transient Heat Source。 将 Source Type 设为 Modulated Analysis / Cache、Data Origin Type 设为 Analysis Output,并选取 Modulated El. Loss Density(x,y,z,f0)。 如此即可将相同调变波形套用至热求解器 ![](https://developer.qcloudimg.com/http-save/yehe-12547743/1858d431ddabf5fcf53dffd1047dbc09.png) 到这里,整条配置链路其实只有一条主线:Planar Cut 负责看清结构,Overall Field 的 Cache 文件负责在 Analysis 与 Simulation 之间搬运电场,Modulation 则把时变波形挂到这 份电场上。神经求解器与热求解器共享的正是同一份数据,区别只在它们取的是场量还是 损耗——理解了这一点,菜单里那十几个选项就不再是散点,而是一张有方向的图。

优秀的个人博客,低调大师

Web 协议详解与抓包:从报文到根因的完整实操

抓包不是“打开 Wireshark 看一眼”,而是一套从**定位抓包点 → 解密 → 逐层读协议 → 归因**的方法论。Web 排障的难点在于三层协议叠在一起:TCP 决定“通不通、快不快”,TLS 决定“握没握上、证不证书”,HTTP 决定“语义对不对”。下面按这个顺序给出可执行的命令与代码。 ## 一、抓包点与过滤:先收窄再抓 抓包第一原则是**贴着故障侧抓**。客户端慢抓客户端网卡,服务端处理慢抓回环,链路问题抓网关。容器里抓 `eth0`,注意 sidecar 会改变流量路径。抓之前先写 BPF 过滤,避免 pcap 被无关流量撑爆。 ``` # 只抓目标主机与端口,全量载荷,带绝对时间 tcpdump -i eth0 -s 0 -nn -tttt \ 'host 10.0.2.15 and (port 80 or port 443)' -w web.pcap # 只保留有载荷的 TCP 包(过滤纯 ACK),直接看明文请求行 tcpdump -i eth0 -A -s 0 \ 'tcp port 80 and (((ip[2:2]-((ip[0]&0xf)>2))!=0)' ``` 第二条表达式用 IP 总长减 IP 头减 TCP 头算载荷长度,非零才打印,日志立刻清爽。 ## 二、HTTPS 解密:keylog 最干净 TLS 让内容不可见,但排障必须解密。生产可用的合法路径是**客户端导出会话密钥**(`SSLKEYLOGFILE`),Wireshark 加载后自动解密,不涉及中间人。 ``` export SSLKEYLOGFILE=/tmp/keys.log curl -v https://api.example.com/health -o /dev/null # Wireshark: Preferences → Protocols → TLS → (Pre)-Master-Secret log 填 /tmp/keys.log ``` 只做单次请求排查时,用 mitmproxy 插件更方便,还能顺手改写请求头注入 traceId: ``` # addon.py → mitmproxy -s addon.py from mitmproxy import http def request(flow: http.HTTPFlow) -> None: if "api.example.com" not in flow.request.pretty_host: return flow.request.headers["X-Capture-Trace"] = "cap-001" print(f"[REQ] {flow.request.method} {flow.request.path}") print(" host:", flow.request.headers.get("host")) def response(flow: http.HTTPFlow) -> None: if flow.response.status_code >= 400: print(f"[{flow.response.status_code}] {flow.request.path}") print(flow.response.text[:300]) ``` 解密后第一件事是核对 **ClientHello 的 SNI** 与 HTTP 的 `Host` 是否一致——不一致会导致 CDN 返回错误证书或错误站点,是“证书错误”类工单的头号原因。 ## 三、HTTP 报文:三类高发问题 明文 HTTP 要读三处:请求行/响应行的**语义**、`Content-Length` 与 `Transfer-Encoding` 是否冲突、`Set-Cookie` 的属性组合。 用 Wireshark 显示过滤器快速收敛:`http.request.method == "POST"`、`http.response.code >= 500`、`http.content_type contains "json"`。批量分析用 scapy 还原事务: ``` from scapy.all import rdpcap, TCP, Raw def http_requests(path): out = [] for pkt in rdpcap(path): if TCP not in pkt or Raw not in pkt: continue data = pkt[Raw].load if data.startswith((b"GET", b"POST", b"PUT", b"DELETE")): head = data.split(b"\r\n\r\n")[0].decode("latin1") out.append({"ts": float(pkt.time), "head": head}) return out for r in http_requests("web.pcap")[:5]: print("---", r["ts"]) print(r["head"][:400]) ``` `Content-Length` 与 `Transfer-Encoding: chunked` 同时出现是协议违规,代理行为不确定,直接导致响应截断或挂起。 ## 四、HTTP/2:按帧读,不按行读 HTTP/2 是二进制分帧,看不到请求行。用 tshark 直接按流导出帧,关注 `:method`、`:path`、`:status` 伪头,以及 `RST_STREAM` 错误码——`RST_STREAM` 常意味着服务端主动取消或流控异常。 ``` tshark -r web.pcap -Y "http2" \ -T fields -e http2.streamid -e http2.headers.method \ -e http2.headers.path -e http2.headers.status -e http2.type ``` 多路复用下一条 TCP 连接承载多个流,读包必须同时看 **stream id** 与**帧类型**,否则会误判“请求丢失”。 ## 五、WebSocket:101 之后是帧 握手阶段仍是 HTTP,看 `Upgrade: websocket` 与 `Sec-WebSocket-Accept` 是否正确回显;升级成功后转帧视图。抓包过滤器 `websocket` 直接定位。 ``` const ws = new WebSocket("wss://api.example.com/ws"); ws.onopen = () => ws.send(JSON.stringify({ type: "sub", ch: "ticker" })); ws.onmessage = e => console.log("frame:", e.data); ``` 常见问题是代理不支持长连接、心跳缺失被中间设备掐断——抓包看 `Ping/Pong` 帧间隔即可判断。 ## 六、TCP 层:把“慢”翻译成事件 HTTP 慢,九成能在 TCP 层找到答案。用 tshark 统计重传与握手耗时: ``` tshark -r web.pcap -q -z io,stat,0 \ -z "io,stat,0,COUNT(tcp.analysis.retransmission)tcp.analysis.retransmission" \ -z "io,stat,0,AVG(tcp.time_delta)tcp.time_delta" ``` 判据速查:`SYN → SYN/ACK` 时间差即建连 RTT;重传间隔按 1s/2s/4s 翻倍是丢包;`TCP ZeroWindow` 是接收方应用读得太慢,问题在应用;`TCP Window Full` 叠加小载荷是发送窗口被卡。**看到 RST 要确认是谁发的**,网关 RST 常见于上游超时。 ## 七、归因表与结论 |现象|抓包点|关键判据| | --- | --- | --- | |首屏慢|客户端|建连 RTT、TLS 轮次、队头阻塞| |偶发 502|网关|上游 RST、超时值、连接池耗尽| |登录态丢失|双端|Set-Cookie 属性、SNI/Host 不一致| |上传中断|双向|重传密度、零窗口、PMTU 黑洞| 抓包排障的本质是**分层归因**:HTTP 看语义,TLS 看握手与证书,TCP 看时序与窗口。固定变量(同一时间窗、同一 traceId、同一版本),配好 keylog 解密与 tshark 统计,任何“感觉慢”都能收敛到一行可复现的协议事件——这就是抓包的价值。

优秀的个人博客,低调大师

测开必看|可落地实操:用独立验收和反例检查 AI 自测

![image.png](https://developer.qcloudimg.com/http-save/yehe-9678105/3c5fc673fc0e221572ac28e604a300df.png) ## 摘要 OpenAI发布的Harness Engineering文章记录了一种agent-first研发实验:团队让Codex承担代码、测试、CI、文档和内部工具的实现,人负责设计环境、明确意图并建立反馈环。本文核对公开数字的性质,分析这对测试角色的启发、不能推出的结论和团队可落地的试验方式。 一个研发任务交给Agent后,代码很快出现,单测也跟着生成,CI还显示通过。此时测试工程师真正要回答的,可能已经不是“它有没有写测试”,而是“测试覆盖的风险是不是由一个独立标准定义的”。当同一个Agent既写实现、又写测试、再按自己生成的标准解释结果,速度的确可能提升,质量判断也可能在无意中失去独立性。 OpenAI发布的《Harness engineering: leveraging Codex in an agent-first world》分享了一项公开工程实验。文章称,一个由Agent承担代码、测试、CI配置、文档、可观测性和内部工具实现的团队,先从空仓库起步,约五个月后代码规模达到约百万行;期间约1500个PR被打开并合并,最初由三名工程师驱动Codex,后来团队扩展到七人。文章还写明,“约为手写所需时间的十分之一”是团队估算,不是独立对照实验或通用生产效率保证。这里的数字是OpenAI对自身实验的公开描述,不能直接外推到任何公司的交付速度。 这个案例适合测试工程师关注,因为它把问题从“AI能不能补全代码”推到了“研发团队主要工作是否会转向环境、规格、反馈和治理”。本文将围绕四件事展开:公开文章真正披露了什么;哪些流行解读超出了证据;当Agent负责实现和自测时,独立质量判断怎么保留;小团队怎样做一轮可回滚的试验。核心判断是:代码生产比例可以变化,但系统的验收权、风险边界和责任归属不能因为产出速度上升而变模糊。 ### 从“人写代码”到“人设计工作环境” 过去的软件工程任务大致围绕需求、设计、编码、测试和发布展开。代码是最可见的工作产物,测试往往在代码形成后检查行为是否符合需求。Agent-first流程把一部分实现交给模型,人的时间开始更多花在组织仓库知识、说明约束、构造工具、配置反馈机制和决定何时停止。OpenAI文章用“Humans steer. Agents execute.”概括其经验,但这个口号是团队对自身实践的总结,不应被理解成所有工程师都已退出编码。 如果把研发活动拆成五个部分,可以看到变化并非简单的“人少做、AI多做”。 | 工作部分 | Agent可承担的工作 | 人仍要负责的判断 | 质量证据 | |---|---|---|---| | 目标定义 | 将任务转成计划与改动清单 | 目标是否正确、边界是否遗漏 | 需求与验收条件 | | 实现 | 生成代码与配置 | 设计是否符合业务和系统约束 | 差异审查、架构检查 | | 自测 | 生成并运行测试 | 测试是否独立覆盖失败风险 | 反例、变异测试、人工样本 | | 集成 | 调用CI、修复失败 | 是否允许重试、合并或部署 | 运行记录、状态、权限日志 | | 运营 | 生成文档和监控工具 | 事故责任、回滚与用户影响 | 可观测性、审计、回滚验证 | 这张表是本文的岗位分析框架,不是OpenAI公开团队的角色表。它表达的重点是:Agent接手某些操作后,人类工作会向“定义目标、选择证据、批准风险”迁移,而不是工作消失。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-9678105/af03201ae851d7b4986c0122456308ee.png) ### 这份公开材料能证明什么,不能证明什么 能核验的事实包括:OpenAI公布了一个Agent承担多类工程产物的实验;文章给出时间、PR、代码规模和团队人数等自报信息;团队强调仓库结构、测试、CI、文档、可观测性和内部工具共同构成工作环境。文章还展示了他们如何把约束写进代码库、用自动化检查保护结构,并在开发中持续修复问题。 不能从中直接推出:所有团队都能以相同比例提速;百万行代码天然代表产品质量;小团队不再需要测试;人类审查可以完全去掉;或Agent生成的测试已经独立证明了实现正确。尤其“十分之一时间”是团队自己的估计,比较对象和工作量边界依赖原文口径,不能在标题里包装成客观行业基准。百万行和1500个PR也只是规模信号,不是用户价值或缺陷率指标。 因此更值得分析的是机制。Agent能够连续工作,依赖的不是单个模型,而是仓库上下文、可调用工具、任务约束、自动反馈和人类判断组成的Harness。提示词不足时,Agent可能做出看似合理但与系统约定冲突的改动;工具权限过大时,错误可能被执行;反馈不完整时,测试通过也不能排除关键路径没有被覆盖。所谓生产力变化,来自任务拆解、信息准备、并行执行和快速反馈共同作用。 ### 最容易被忽略的反常识:Agent越会自测,越要检查谁定义了“通过” 一条最简单的风险链是:Agent看到需求,写实现;同一Agent根据需求写单测;它运行单测并修改实现直到通过;最后再生成测试报告。如果测试只覆盖Agent已经理解到的需求,它可能把同一个误解同时写进实现与测试。结果是“测试通过”只说明二者相互一致,不说明业务目标被正确理解。 这与传统开发里开发者写测试并非完全不同,但Agent的生成速度会让同源偏差更快扩大:需求遗漏可以被复制到多个文件,假设不清会被传播到mock、断言、文档和验收说明中。因此“代码通过测试”需要回答:测试断言来自哪里?是否有独立的业务规则来源?是否保留了能够击中错误实现的反例?数据与环境是否真实?关键断言是否能在实现发生错误时失败? #### 一份独立质量证据清单 - **需求证据**:由产品规则、监管要求或业务负责人确认的约束,不由Agent自行补全后当成事实。 - **测试证据**:至少有一部分样本由不同角色或不同机制制定;对高风险条件加入边界值、反例和状态迁移。 - **运行证据**:保留具体提交、环境、测试版本、工具调用、失败信息和重试次数。 - **结果证据**:检查业务状态和外部副作用,不以进程退出码或Agent自述替代。 - **责任证据**:标记哪些操作由模型建议、哪些由人批准、哪些由自动化执行,确保出现问题时能够回溯。 ### 小团队怎么做一次低风险Agent-first试验 不必先把整个项目交给Agent。选一个边界清楚、可回滚、失败代价可控的任务,例如生成一个只读API的测试适配层,或为已有CLI补一组文档和测试。先明确试验不是“看模型能不能写代码”,而是比较工作流:哪些步骤交给Agent后能减少等待,哪些步骤仍需要工程师判断,哪些新错误是由权限、上下文或反馈不足导致。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-9678105/a78fbb5e5d23ce043e1032a332293dfb.png) **试验准备**:给Agent只读仓库、创建分支、运行测试的权限;将生产密钥、生产写权限和部署凭证隔离。仓库里放清晰的目录说明、测试命令、编码约定和“不允许改变的业务不变量”。任务开始前由工程师写出可观察的验收条件和至少一个负例。 **执行过程**:Agent每次改动应关联任务目标和验证结果。限制并行工作范围,避免两个Agent同时修改同一核心文件。出现失败时,先保留首次失败的输出,再让Agent修复,防止最终通过结果掩盖中间发生过的破坏。测试人员不需要逐行复述所有代码,但要能追问改动影响了哪些状态、外部调用和异常路径。 **验收对照**:不只看平均耗时。记录人类审查时间、无效改动、遗漏的业务条件、测试有效性、回滚难度、Agent重试次数和新增工具风险。速度变快但审查负担翻倍,可能只是把瓶颈从编码转移到了验收;生成了更多测试但反例变少,也不等于覆盖更好。 | 观察项 | 需要保留的证据 | 怎样解读 | |---|---|---| | 交付速度 | 从任务开始到满足验收条件的用时 | 同时记录等待、返工和人工审查时间 | | 测试独立性 | 需求来源、断言来源、负例来源 | 若都来自同一Agent,不能当作独立验证 | | 变更风险 | 无效改动、越权动作、重试和回滚记录 | 速度提升不能抵消高后果副作用 | | 结果可信度 | 业务状态、CI记录、Trace与人工复核 | 说明“为什么通过”,而非只报通过率 | 这张表是本文建议的试验记录模板,不是OpenAI公布的内部指标。把每个判断对应到一条证据,试验复盘才有机会区分真正提效与把工作量转移到验收端。 ![image.png](https://developer.qcloudimg.com/http-save/yehe-9678105/cb26a54a9a4cb6b45429302aae955b37.png) **结束条件**:出现未授权写操作、无法解释的测试删除、测试仅通过修改断言实现、关键状态不可观测、重复副作用无法控制时,立即停止并回滚。试验成果可以是失败模式清单,不必强行宣布Agent-first成功。 ### 角色变化不是“少写代码”,而是把边界和证据设计清楚 OpenAI原文没有提出一个新的职称。它提供的是一次特定团队实践:随着Agent承担更多实现工作,工程师把更多精力放在设计环境、拆分目标、设定可执行约束和构建反馈机制。对测试工程师而言,可迁移的变化不是换一个头衔,而是更早参与验收标准、独立证据和风险边界的设计。 这里也有反方边界。Agent持续依赖模型能力、上下文窗口、工具生态、权限治理和组织流程;对于复杂需求、隐性业务规则、物理设备、法规责任等场景,人类判断仍然关键。某个内部项目的效率数据不等同于外部团队可复现结果。即便实现成本下降,产品方向错误、权限过宽、质量证据不足和运维责任缺位,造成的损失也不会自动变小。 未来6—18个月,测试团队可以观察几类可验证信号:Agent改动是否能稳定通过独立验收;跨仓库任务是否更少依赖人工补上下文;测试缺陷是否因同源生成而增多;审查时间是否随代码产量同步上升;工具调用是否具有可审计、可撤销和最小权限控制;生产问题是否能从Trace还原到具体动作。这些信号比“团队说效率提高了”更能说明研发方式是否真的改变。 ### 测试工程师的具体行动 ![image.png](https://developer.qcloudimg.com/http-save/yehe-9678105/702dc166ef33433cc08f671934de9531.png) 先把你负责的一条业务流程写成四列:目标、允许动作、禁止动作、结果证据。再选一个Agent可以安全执行的子任务,让它在隔离环境里跑,记录每一步工具调用。最后,单独设计一条“实现和自测都可能一起错”的反例,用来检查验收是否独立。这个练习不要求先学会训练模型,却能让你看清Agent到底替代了什么、扩大了什么风险,以及团队还缺哪种质量证据。 OpenAI这篇文章值得测试工程师读,不是因为它证明所有公司都应照搬,而是因为它把研发工作的稀缺资源说得很具体:人的时间和注意力。当编码动作变得更容易,选择做什么、如何验证、何时停止反而变成更重要的工程判断。测试不一定消失,但只检查“功能有没有跑”可能不够;能定义验收边界并证明结果可信的人,会更接近研发决策的中心。 >本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

优秀的个人博客,低调大师

AI 内容溯源与检测合规实操:从水印原理到接入清单

## 一、为什么现在必须关心内容溯源 如果你在做 UGC 平台、内容审核、出海产品,或者任何会对外发布 AI 生成内容的系统,这一两个月的变化和你直接相关。 欧盟《人工智能法案》第 50 条(Article 50)的透明度义务已于 2026 年 8 月 2 日正式生效:所有生成式 AI 系统产出的文本、图像、音频、视频,都要以机器可读的方式打上标记,并且可被识别为人工生成或 manipulated。10 月 5 日至 6 日,OpenAI 宣布在欧盟境内的 ChatGPT 与 Codex 文本中植入名为 textGrain 的隐形水印,以履行这一义务;在此之前,Anthropic 已经给 Claude 生成的文本加了水印。 一句话:内容溯源从"可选项"变成了"合规刚需"。对开发者来说,问题不再是"要不要做检测",而是"怎么把检测接得稳、接得合规"。 ## 二、检测原理速成(给 builder 看的版本) 内容检测主要有三类信号,工程上通常是组合使用: - 统计水印(textGrain 式):生成时用一把密钥,在选词分布上做极轻微的偏向,让文本内部形成一种肉眼不可察觉、但检测器能识别的统计信号。好处是复制粘贴也不丢失;坏处是编辑会削弱它。 - 困惑度 / 突发度(Perplexity / Burstiness,Gptzero 式):AI 文本的统计特征往往更"平"、更可预测,人类写作的起伏更大。检测器据此给一个"像不像 AI 写"的概率。 - 元数据 + 集成:图像/音频侧用 SynthID、C2PA / Content Credentials 等元数据标记;文本侧则是"水印 + 困惑度 + 元数据"多信号集成,比单信号稳得多。 理解这一点很关键:没有哪种单信号是铁证。水印会丢,困惑度会误判,元数据会被剥离。 ## 三、5 个最容易被误杀的真实场景 检测不是越严越好,过度拦截的代价往往是把正常内容误杀。以下 5 类是工程里最常踩的坑: - 技术文档 / 代码注释:措辞规整、句式统一,很容易被判定"太像 AI"。 - 非母语写作:第二语言使用者句式偏"平",困惑度偏低,容易被误判。 - 机翻稿:翻译腔 + 低突发度,常被标成 AI 生成。 - 列表 / 公式密集文本:结构高度规整,困惑度天然低。 - 短文本 / 数学解答:水印信号弱,OpenAI 自己披露,400 词段落替换 10% 同义词后,检测率从约 92% 跌到 66%;更短的文本几乎不可靠。 记住一条铁律:检测不到水印,不等于"这是人写的"。反过来,有水印也只能说明某家系统生成或处理过部分内容,不能反映其中融入了多少人工判断。 ## 四、更稳的检测工作流(工程清单) 把检测从"玄学"变成可量化流程,核心是这样几步: - 阈值分档:低分直接放行、高分直接拦截、中间区间一律人工复核,别让模型替你做不可逆决定。 - 人在回路(human-in-the-loop):发布、删除、封号、付费这类不可逆动作,必须过人工,等你有数月干净审计记录再考虑放开。 - 独立留痕:每次检测都记录信号强度、用的模型、版本号,并和业务日志对账,而不是只信 agent 自己汇报的摘要。 - 元数据优先:能拿 C2PA / Content Credentials 元数据的,优先用元数据,它比纯统计信号可靠。 - 别把"无 watermark"当"人写":误报风险真实存在,高风险场景宁可多一道人工。 ## 五、调用范式示意 下面用一个统一的调用范式说明"接一个 key 就能调用检测能力"的思路——实际路径以你接入的服务商文档为准。 # 统一调用范式:接入文本检测类接口(实际路径以服务商文档为准) from openai import OpenAI client = OpenAI( api_key="YOUR_API_KEY", base_url="https://easy88ai.com/v1" # 同一套调用范式,连上 key 即可 ) # 调用内容检测:返回 ai_probability 与 watermark_signal resp = client.chat.completions.create( model="text-detection", messages=[{"role": "user", "content": "待检测文本..."}], ) print(resp.choices[0].message.content) ## 六、现成能力,开箱即用 已经有人把内容安全相关的调用范式整理好:检测、留痕、阈值分档,导入即可用,不必从零造轮子。 想看都准备了哪些现成能力?不少平台已经把内容安全相关的调用范式整理成公开文档,接入即可用——具体地址见上方代码里的调用范式说明。

优秀的个人博客,低调大师

负面舆情应对处置方案:中小企业落地指南(2026年实操版)

很多中小企业做舆情应对,第一反应是找大公司模板 —— 什么 "跨部门应急小组""CEO 总指挥 ",结果写了厚厚几十页,真出事的时候没人翻。小公司本来人就少,舆情方案根本不需要照搬大厂那套流程。本文从中小企业实际情况出发,先讲 3 个最容易踩的弯路,再拆解一页纸方案的核心内容,最后聊聊工具选型怎么不花冤枉钱。 ## 一、做舆情方案最容易踩的 3 个弯路 **弯路 1:照着大公司模板抄。** 十几个人的团队,搞什么 "跨部门应急指挥部",最后方案写了两页纸,谁也不看。小公司的优势就是快,不需要层层审批。 **弯路 2:觉得公司小不会出大事。** 现在短视频传播门槛极低,一个餐馆菜里有异物,顾客随手拍条视频,一晚上就能上本地热搜。小公司抗风险能力弱,一次负面就能吃掉半年积累的口碑。 **弯路 3:一出事就想删帖。** 现在的环境,删得越快,网友越觉得你心虚,截图传得越广。小公司更没资源去做删帖操作,不如把精力放在解决问题本身。 ## 二、一页纸方案写这 3 块就够了 不用搞复杂,一张 A4 纸写清楚,出事的时候每个人都知道自己该干嘛。 ### 1. 分级响应清单:就分 3 级 - **轻度负面**:个别人吐槽、单条差评,客服 / 前台顺手跟进,不用惊动管理层。 - **中度负面**:开始有转发、多个账号讨论,运营负责人牵头判断要不要发说明,控制扩散范围。 - **重大危机**:上了本地热搜、有媒体来联系、涉及安全问题,老板直接上,别层层汇报耽误时间。 ### 2. 对外发声定 3 条规矩 - 对外只有一个出口:要么老板,要么指定的负责人,其他人不要随便回应。 - 不说 "无可奉告",不跟网友对骂。 - 真错了就大方承认,说清楚整改措施就行。 ### 3. 事后半小时复盘 事情平息后,不用开长篇总结会,几个人坐下来聊半小时:这次为什么出问题?哪个环节慢了?下次怎么避免?把结论记下来,下次就不会踩同一个坑。 ## 三、舆情监测工具选型:够用就好 小公司早期基本靠运营每天刷一遍大众点评、抖音、小红书看评论,一天下来光刷内容就耗掉小半天。随着业务量上来,可以考虑引入第三方舆情监测工具,自动抓取公开渠道的提及,有负面时主动推送提醒,把人力省出来做真正重要的事。 选型时注意几点: - **不要追求大而全**:先看基础的关键词监测、多平台覆盖、预警通知这几个核心功能够不够用。 - **按团队规模选版本**:小公司不需要集团级的复杂权限和定制功能,基础版完全够用。 - **工具是辅助不是替代**:系统能告诉你 "出事了",但怎么回应、怎么跟用户沟通,最终还得人来判断。 核心原则:能第一时间发现问题,就已经赢过一半对手了。 ## FAQ **Q1:3 个人的小团队,真的需要做舆情方案吗?** 需要,但不用复杂。哪怕就写三句话:谁日常看评论、谁来对外回应、重大问题找谁拍板。小公司船小好调头,最怕的是出事的时候大家都懵了,任由事情发酵。 **Q2:刚发现负面的时候第一时间该干嘛?** 先核实事实,别急着回应。先确认事情是不是真的、目前传播到什么范围、有没有人刻意带节奏。情况没搞清楚就急着发声明,很容易说错话,反而把事情闹大。 **Q3:用户在网上吐槽,直接道歉会不会太怂?** 完全不会。消费者要的不是你硬刚,而是你愿不愿意解决问题。真出了问题大方承认、赶紧整改,反而能拉好感;躲着不说话、或者跟用户对着吵,才是真的把口碑做死。

优秀的个人博客,低调大师

用模板加LLM API批量生成方案初稿,交付提速的实操做法

做自由职业或接单的人常遇到一类重复劳动:每个客户都要出一份结构相同、内容不同的方案或报告初稿。这类工作适合模板化:固定结构用Jinja2模板,个性化部分交给大模型生成,最后导出成Word。本文给出完整实现。 ## 模板先行:把结构固化下来 ``` # pip install jinja2 from jinja2 import Template PROPOSAL_TEMPLATE = Template(""" # {{ client_name }} 项目方案初稿 ## 需求理解 {{ requirement_summary }} ## 执行思路 {{ approach }} ## 周期与报价 {{ schedule_price }} """) ``` 模板只负责结构,三个变量由模型按客户背景填充。 ## 用模型生成个性化内容 ``` from openai import OpenAI client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.hunyuan.cloud.tencent.com/v1") def fill_section(client_info: str, section: str) -> str: prompt = ( f"客户背景:{client_info}\n" f"请为项目方案的「{section}」部分撰写内容,150字以内," "语气专业,不使用夸大词汇,不承诺确定结果。" ) resp = client.chat.completions.create( model="hunyuan-turbo", messages=[{"role": "user", "content": prompt}], temperature=0.4, # 交付物场景调低随机性,减少跑题 ) return resp.choices[0].message.content def build_proposal(client_info: str, client_name: str) -> str: return PROPOSAL_TEMPLATE.render( client_name=client_name, requirement_summary=fill_section(client_info, "需求理解"), approach=fill_section(client_info, "执行思路"), schedule_price=fill_section(client_info, "周期与报价"), ) ``` `temperature`调到0.4是交付场景的经验值:太高容易发挥过度,太低又容易千篇一律,0.3到0.5之间通常比较合适。 ## 导出Word交付 ``` # pip install python-docx from docx import Document def export_docx(markdown_text: str, path: str): doc = Document() for line in markdown_text.strip().split("\n"): if line.startswith("# "): doc.add_heading(line[2:], level=1) elif line.startswith("## "): doc.add_heading(line[3:], level=2) elif line.strip(): doc.add_paragraph(line.strip()) doc.save(path) text = build_proposal("一家本地餐饮连锁,想做短视频获客,预算有限", "某餐饮品牌") export_docx(text, "proposal.docx") ``` ## 量产时的两个注意点 批量调用要加间隔和重试,避免触发限流(第五篇会详细讲重试写法)。更重要的是,生成结果必须人工过一遍再发客户:模型对客户行业的理解可能出错,初稿的价值是省掉"从空白页开始"的时间,而不是替代专业判断。

优秀的个人博客,低调大师

实操看看是真的吗

# AI 泡沫规模达互联网泡沫 17 倍,零基础半小时用 AiPy 做个「AI 泡沫预警小工具」(附Prompt) > 不会编程也能做。全程复制粘贴,半小时后你手里会有一个能自动盯盘、自动预警的小工具。 ## 一、先看结论:AI 泡沫规模达互联网泡沫 17 倍,这事到底有多大 **结论前置:AI 泡沫规模达互联网泡沫 17 倍,这是当前全球资本市场最值得盯的一个数字。** 据每经网报道,OpenAI 已与英伟达、AMD、甲骨文、软银等达成**超 1 万亿美元**的算力与芯片协议,而其年化营收约 **120 亿美元**、年化亏损约 **80 亿美元**。英国央行与 IMF 相继警告,AI 概念股市值"与互联网泡沫高峰相似"。 几个关键数字,建议直接记住: |指标|数值|来源| | --- | --- | --- | |AI 泡沫规模|互联网泡沫的 17 倍|每经网报道| |OpenAI 算力/芯片协议|超 1 万亿美元|公开报道| |OpenAI 年化营收|约 120 亿美元|公开报道| |OpenAI 年化亏损|约 80 亿美元|公开报道| |泡沫风险指数|约 60%|赛富基金蒋驰华| |核心争议点叫**"循环融资"**——供应商向客户投资,客户再拿这笔钱买供应商的产品,账面双赢,但风险高度集中。||| |反方观点也存在:高盛测算认为 AI 有真实需求支撑,更可能是"估值消化 + 结构分化",而非 2000 年式崩盘。||| |不管哪一方对,有一件事是确定的:这个数字会持续波动,而你需要一个能自动盯住它的工具。||| |这就是本文要带你做的事——零基础、半小时、用 AiPy 做一个「AI 泡沫预警小工具」。||| --- ## 二、这个小工具做什么?(先看交付物) **工具名称:AI 泡沫预警小工具** **它干三件事:** 1. **抓数据**:定时抓取 AI 相关指数、龙头股价格、行业融资新闻; 1. **算指标**:计算涨跌幅、波动率、新闻情绪分值,合成一个"泡沫温度分"; 1. **发预警**:当温度分超过你设定的阈值,自动生成预警提示。 **最终你会得到:** - 一份可以每天自动更新的数据表(CSV / Excel); - 一张泡沫温度趋势图; - 一条到点自动触发的预警文案。 **全程不需要你写一行代码。** --- ## 三、准备工作(3 分钟) 1. 安装 **AiPy**(Windows / macOS 均可); 1. 新建一个对话; 1. 准备好下面这段 Prompt,直接复制粘贴。 就这三步,没有第四步。 --- ## 四、核心 Prompt(直接复制) ### 4.1 第一步:抓数据 ``` 帮我做一个「AI 泡沫监测」数据抓取脚本。 要求: 1. 抓取以下数据,每天更新一次: - 纳斯达克 100 指数(^NDX)最近 90 天收盘价 - 英伟达(NVDA)、AMD、甲骨文(ORCL)最近 90 天收盘价 2. 数据来源用公开免费接口(如 yfinance) 3. 结果保存为 ai_bubble_data.csv,包含日期、各标的价格列 4. 输出前 5 行预览,确认数据正常 请直接给出可运行的完整代码,并帮我运行。 ``` ### 4.2 第二步:算"泡沫温度分" ``` 基于 ai_bubble_data.csv,帮我计算「AI 泡沫温度分」。 计算逻辑: 1. 计算纳斯达克 100 指数相对 90 日均线的偏离度(偏离越大,泡沫越热) 2. 计算英伟达、AMD、甲骨文三只股票的 20 日波动率均值 3. 将偏离度和波动率分别归一化到 0-100,加权求和(偏离度权重 0.6,波动率权重 0.4) 4. 得到 0-100 的「泡沫温度分」,分数越高代表泡沫越热 输出: - 一张泡沫温度分的时间序列折线图 - 当前最新的温度分数值 ``` ### 4.3 第三步:自动预警 ``` 基于泡沫温度分,帮我做预警逻辑。 规则: 1. 温度分 > 80:红色预警,提示「泡沫高温,注意风险」 2. 温度分 60-80:黄色提示,「泡沫偏热,保持关注」 3. 温度分 80 红色预警;60-80 黄色提示;<60 绿色正常 - 生成预警文案,写入 alert_log.txt(带时间戳) - 给出每天早上 9 点自动运行的定时任务方案 ``` **复制 → 粘贴 → 运行,半小时后你就有自己的 AI 泡沫预警小工具了。**

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册