首页 文章 精选 留言 我的

精选列表

搜索[Windows应用SDK],共10000篇文章
优秀的个人博客,低调大师

免费的容器架构可视化工具 | 阿里云应用高可用服务 AHAS 发布重大新特性

工具下载链接:点这里。活动发布链接:点这里。 采用容器服务后,了解容器之间的关系及依赖是一个比较有挑战的问题。容器化改造后的实际架构模型可能与预想的架构存在较大的差异,架构师或系统运维人员需要精确地了解资源实例的构成和交互情况,存在一定的困难。其次,系统架构在动态演化过程中可能引入了一些不可靠的因素,比如弱依赖变强依赖、局部容量不足、系统耦合过重等,给系统的稳定性带了极大的安全隐患。所以我们每次在面对系统改造、业务大促、迁移上云以及稳定性治理工作之前,都会通过梳理架构图的方式,呈现系统架构中个组件之间的交互方式,架构可视化能够清晰的协助我们识别架构中存在的问题以及建立高可用的系统。 近日,阿里云高可用服务 AHAS 针对阿里云容器服务发布重大特性,推出阿里云容器服务架构可视化功能,帮助用户识别容器服务架构。 一键实现架构可视化 通过阿里云

优秀的个人博客,低调大师

【阿里内部应用】基于Blink构建亲听项目以及全链路debug项目实时响应能力

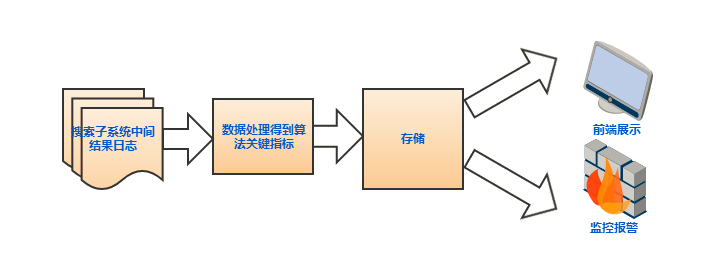
案例与解决方案汇总页:阿里云实时计算产品案例&解决方案汇总 本文全面总结了大数据项目组在亲听项目以及全链路debug项目上进行的实时流处理需求梳理,架构选型,以及达成效果 一、背景介绍 1.1亲听项目 亲听项目专注于帮助用户收集、展示、监控和处理用户体验问题,是保证产品的主观评价质量的利器,关于其具体功能可参考在ata搜索"亲听"查看系列文章。目前亲听项目的实时流处理需求来自算法效果监控,算法效果监控需要对上游TimeTunnel日志进行解析后经过处理得到一些关键指标,亲听通过对这些指标的前端展示和阈值监控报警达到算法效果监控目的。 需求要点可以总结如下: 上游需要处理的TimeTunnel日志的实时数据量大约在日常峰值每秒数万条记录,大促峰值每秒几十万条记录 从用户搜索行为到亲听系统得到搜索行为指标数据秒级的低延时 数据的处理逻辑较为复

优秀的个人博客,低调大师

修改HBase的rowkey设计把应用的QPS从5W提升到50W

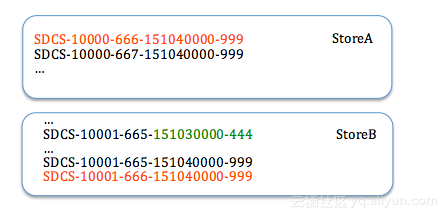
UTT是Aliexpress的营销消息运营平台,运营希望促销活动时APP消息推送的QPS达到34W。 UTT刚接入APP消息推送时,QPS只能达到5W,离运营的要求有很大的距离。 通过改造,QPS达到了50W,其中最主要的改造是对Hbase的rowkey的改造。 首先介绍一下UTT大致工作流程: 1、运营人员在UTT的小二控制台配置运营任务(job),在任务中设置商品选择参数、目标人群参数和消息发送渠道; 2、UTT调用算法平台计算出要发送的消息,数据生成在阿里云飞天系统的云梯表中; 3、UTT把云梯表中的数据导入到hbase,并生成N个可以并发执行的发送任务(segment),segment的信息存储在mysql表中; 4、UTT按计划发送时间捞取segment,把存储在Hbase中的segment对应的消息读取出来调用阿里巴巴移动消息推送网关发送出去。 步骤1、2、3是提前执行的,我们要优化的是步骤4。 改造中,我们主要做了如下几件事: 1、修改了Hbase的rowkey规则和数据读取方式; 2、优化了记录发送进度的逻辑; 3、优化了消息发送到阿里巴巴移动消息推送网关的流程。 其中最主要的是对Hbase的rowkey的修改。 改造前的rowkey设计: rowkey=segmentSalt+”_"+dataIndexInSegment+”_”+segmentId+”_”+jobTime+”_”+jobId 说明如下: job:job对应运营在后台页面配置的任务,一个job可能多次运行,用jobId+jobTime可以唯一标识一个job的一次发送任务。 segment:一个job的一次发送任务拆分为多个segment,每个segment对应10万条消息。多个segment的消息可以并行发送。 segmentSalt:4位的随机字母,每个segment有一个salt,用于把数据均匀分散到Hbase的不同region中; dataIndexInSegment:每条消息在segment中的序号,从0到99999; 改造前UTT按计划发送时间捞出要发送的segment后,从按0到99999的顺序从Hbase中读取消息,然后发送出去。为了提高效率使用了hbase的批量get方法。 这个设计存在一个很大的问题,同一个segment里的相邻消息的rowkey不是连续的,之间可能隔的非常远。 如下图所示,10000号消息rowkey和100001号消息rowkey之间可能隔了很多rowkey。 这会带来啥问题?这就需要了解Hbase的存储机制。 Hbase的存储是以storeFile为单位,以LSM树(Log-structured merge tree)方式存储。 此结构优化写性能,牺牲读性能。写数据的时候先按rowkey计算出region和store,顺序写入到store的memeStoreFile中,memoStoreFile达到指定大小后flush到磁盘的storeFile中。因此同一个store里,多个storeFile的rowkey的范围是会有重叠的。 按rowkey读取数据时,计算该rowkey可能存储的storeFile,把这些storeFile全部读取到内存中,最后把多个storeFile里查询到的结果合并后输出。 为了提高读性能,Hbase会在后台把多个storeFile进行merge,形成rowkey范围互不重叠的storeFile。 另外Hbase采用按列值KV方式存储数据,也就是说每个列的值都是独立存储的。每个列值KV对里的key包括了rowkey和列名,key里的大部分数据是重复的,storeFile采用压缩算法减小空间。 改造前同一个segment里的消息的rowkey很分散,读取一个segment的消息时要从磁盘上装载大量的storeFile,消耗大量的cpu进行解压缩,这也会导致storeFile 的cache命中率不高。并且读出来的大部分storeFile是没有包含所需数据的。 分析UTT的场景,多个segment是并发读写的,每个segment有segmentSalt,保证了读写均匀分布到Hbase的不同region。如果读取一个segment的消息时能从尽量少的storeFile读取数据,就能够减少磁盘IO,减少解压缩及数据查找的CPU,还能提高storeFile cache的命中率。 改造后的rowkey设计: rowkey=segmentSalt+”_”+jobTime+”_”+jobId+”_”+segmentId+”_”+dataIndexInSegment(前补零到定长5位) 这样多个segment并发读写均匀分散到不同region,同一个segment的消息顺序写到相同的storeFile中,读取的时候不再使用get方法而是使用scan方法。最后qps提升了一个数量级。 附一个hbase的知识脑图,不知道作者是谁,挺好的。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册