首页 文章 精选 留言 我的

精选列表

搜索[腾讯云 WAND],共10000篇文章
优秀的个人博客,低调大师

【实践篇】推荐算法PaaS化探索与实践 | 京东云技术团队

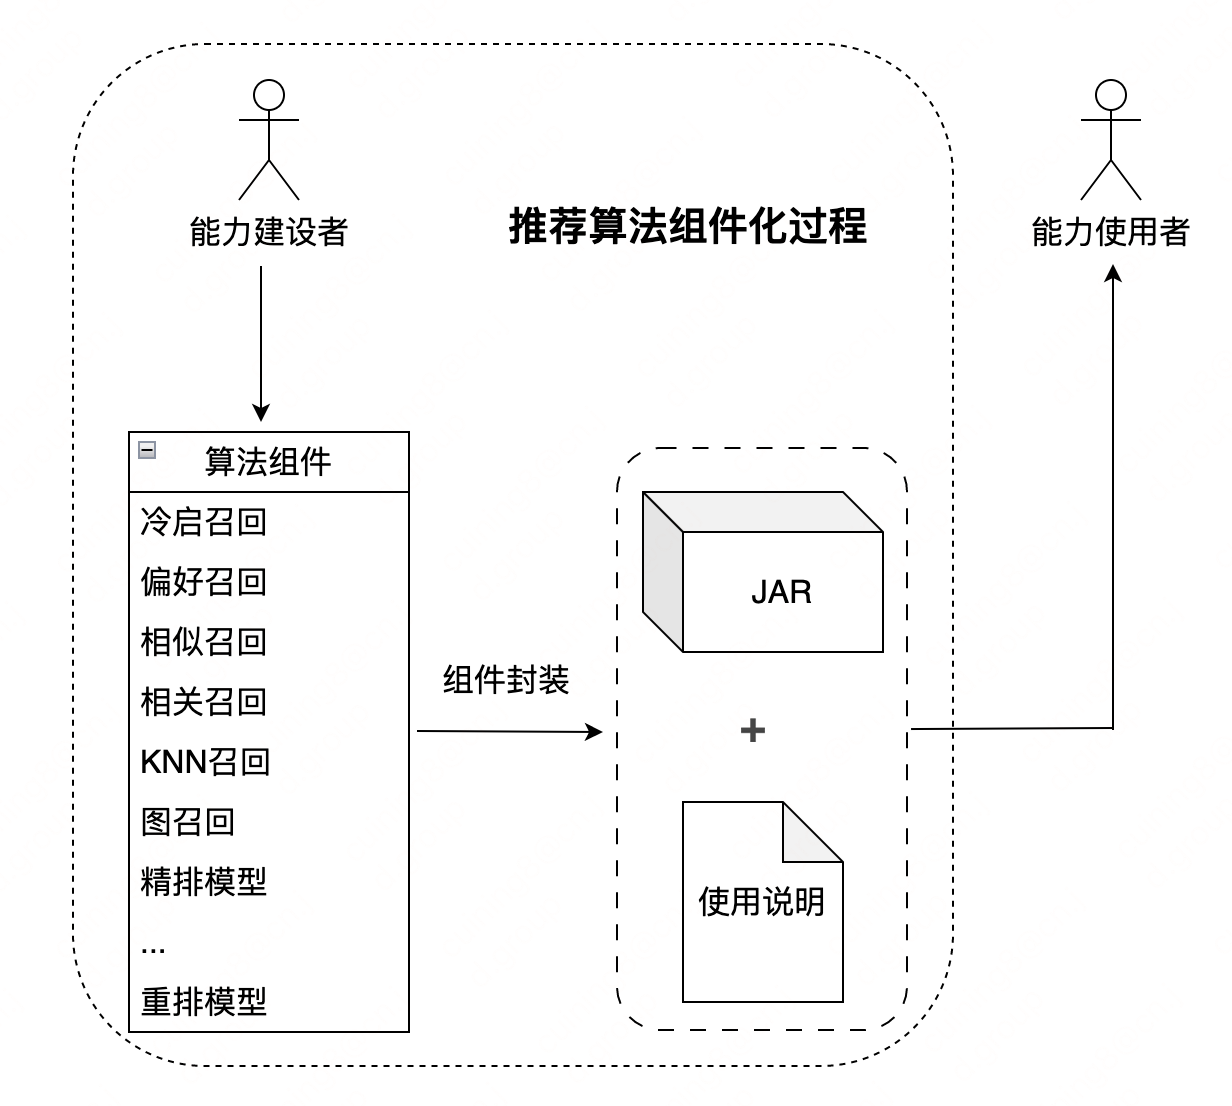
作者:京东零售 崔宁 1. 背景说明 目前,推荐算法部支持了主站、企业业务、全渠道等20+业务线的900+推荐场景,通过梳理大促运营、各垂直业务线推荐场景的共性需求,对现有推荐算法能力进行沉淀和积累,并通过算法PaaS化打造通用化的推荐能力,提升各业务场景推荐赋能效率,高效赋能业务需求。 为什么是PaaS化:首先,我们认为PaaS化是一个比较好的解决办法和方案,因为它提供了一种解决超级公司复杂业务的可变化、可扩展、可复用能力的基础框架,在这样的框架下,可以极大的释放重复劳动力,实现业务的高效提升;其次,我们也看到一些行业中的其它玩家,他们也是在自己的业务中台基础上进行PaaS化,并通过PaaS化提供的能力不断的孵化自己的创新项目,去减少他们的人力投入,减少他们的投入成本,而且他们还推出了很多用于商用的PaaS化工具,为实现更大的社会价值去创造机会;因此,我们认为PaaS化应当是我们当前会选择的一个比较好的解决问题方法; 如何助力推荐业务能力提升:通过梳理推荐场景下的共性需求,在可变化、可扩展、可复用能力的基础框架内,我们对业务需求进行分类和能力抽象,提供阶梯化的应对策略;针对通用类需求,我们提供一站式个性化推荐能力,满足业务快速接入的诉求;针对定制类需求,通过打造高效易用的PaaS化工具,一方面,减少算法人力的投入,另一方面,缩短业务需求交付的周期; 2. 方案设计 在对推荐业务需求梳理的过程中,我们将业务方诉求归结为以下两个大类: 新增推荐位类业务需求 依据推荐场景划分,大致可以分为首推、我京、商详、购物车、短视频、直播、频道等推荐场景的接入; 依据个性化推荐能力划分,大致可以分为数据接入、召回、排序、过滤/调权、多样性、渲染等推荐算法模块以及AB实验、数据分析能力; 依据运营诉求划分,大致可以分为提权,定投,非定投,定坑等扶持能力; 已有推荐位推荐策略迭代优化类业务需求 效果提升类业务需求:大致可以分为新增商品底池、召回新增数据源、业务标签/特征因子接入模型、扶持类、数据分析等; 用户体验类业务需求:大致可以分为调权/过滤、负反馈、多样性排序、新颖性、多素材穿插等; 可运营类需求:大致可以分为特殊商品流量扶持、赛马机制、提权,定投,定坑等可运营能力; 为了更高效的支持上述业务需求,推荐算法PaaS化围绕数据/算法组件/数据分析/算子/场景模板/服务6个PaaS化方向进行建设,以缩短需求交付周期为目标进行建设,切实提升使用者感知。 2.1 推荐算法PaaS化能力分类 作为个性化推荐能力的提供者,我们希望通过业务赋能技术,通过推荐算法PaaS化,将推荐系统透明的展示给大家,在重新认识推荐系统的基础之上,更好的推演未来;我们将推荐算法PaaS化分为数据/算法组件/数据分析/算子/场景模板/服务共6个一级能力、20个二级能力,具体如下 一级能力 一级能力定义 二级能力 二级能力定义 数据复用 推荐各个环节的数据复用 召回数据直接复用  召回数据简单加工复用  排序模型文件复用  代码(算法组件)复用  非模型召回 冷启召回、画像召回、相似相关召回等(每类召回源之间的区别在于调用的计算脚本不同) KNN召回  精排模型  数据分析复用  基础中间表   项目中间表  算子复用 包括算子相关功能的复用,和关联数据复用 过滤算子  调权算子 置顶算子 去重算子 渲染类算子 多样性算子 场景模板复用 全站商品综合推荐 商详 购物车 直播 ... 种草秀 为你推荐套餐首页feed流形式功能,基于用户行为偏好和商品相似相关的综合推荐 多素材支持(店铺、排行榜、图文、聚合类素材),支持配置knn召回,支持业务调整模型目标,业务自主配置模型特征 主商品推荐套餐商详、购物车、针对有入参商品的场景 支持入参商品的相似相关召回,免运费凑单推荐(价格重量过滤),同店铺商品推荐,支持自营非自营过滤,支持业务指定类目的加购弹窗推荐,支持业务调整模型目标,业务自主配置模型特征,LBS推荐 商品池推荐营销活动(年货节等)、tab排序,tab分类商品推荐,门店+suk推荐,O2O类型推荐 支持tab排序,基于tab入参的排序,品牌推荐,新场景的大促需求,秒杀等推荐功能:基于时间召回、过滤功能、特殊底池的创建和召回(kv) 服务复用  单素材服务单品 单店铺 短视频 好物集市 ... LBS  过滤服务 已有 精排推理服务 已有 上述分类是基于我们现阶段对业务需求的认知,随着推荐算法PaaS化的不断推进,定义及分类也会不断迁移; 2.2 推荐算法PaaS化能力建设 2.2.1 推荐算法组件化 推荐算法组件化是平台化、配置化的前置步骤,通过组件化,我们可以将算法能力可视化,让沉淀在代码中的一些信息展示在公众面前,让算法能力成为一种真正可传承的资产,高效赋能业务需求;具体而言,我们通过将算法能力抽象及封装,集成在一个可运行的代码包中,使用者通过算法组件的介绍及使用说明,就可以“插拔式”的应用在自己的业务领域; 算法组件化建设主要包含两部分,一是推荐算法PaaS化能力建设者将推荐算法能力进行集成,二是推荐算法PaaS化能力使用者将算法组件应用在任何想应用的场景中,而且使用者自己就可以把握需求交付的节奏; 推荐算法组件化示意图 2.2.2 通用算法能力平台化 平台化的主要目的是简化推荐算法组件使用的复杂度,因此,我们对平台工具的要求是具备可用、可视、可改的特点;值得注意的是,平台化这里我们可以分为两个大类,其一是推荐能力全链路的平台化,目的是能够快速支持新增推荐位这类业务需求;其二是推荐算法模块的平台化,通过这样的平台工具,希望能够快速支持已有推荐位推荐策略迭代优化类业务需求; 针对推荐能力全链路的平台化,我们和产品、架构、平台侧合作,通过打造丰富的推荐场景模板,并提供通用的个性化分发能力,满足业务快速接入的诉求;具体来说,对于业务方对不同推荐场景接入的不同诉求,PaaS化项目组已经建设了诸如全站商品综合推荐、主sku相似相关推荐、业务灵活底池推荐、全渠道门店+商品推荐、小助手商品推荐等多类通用模板,在这些模板上,推荐算法PaaS化依据可变化、可复用的基础逻辑,通过提供丰富的推荐策略供业务方选择使用,覆盖更多新增推荐位需求; 场景模板列表示意图 针对推荐算法模块的平台化,我们计划和平台侧合作,通过建设一批提效工具,提高算法同学的工作效率,缩短需求的交付周期; 2.2.3 通用算法策略配置化 为了提升算法人员支持业务需求的效率,立足目前的推荐系统,同推荐架构合作,完成建设通用算子库,包括常用的取数、召回、排序、过滤、多样性等算子;在未来,这批通用算子可以直接进入小流量实验验证效果,降低算子配置的成本,提高代码的复用度,达到缩短需求交付周期的目标; 实现通用算法策略配置化前后的流程对比 2.2.4 定制化算法策略低代码开发 在支持业务需求的过程中,我们发现一个小小的算子开发也要耗费算法人员大量的时间,包括不限于:前期的开发沟通、策略的开发、环境部署、策略的验证及算子上线等,我们希望将开发流程进行精简,从而达到提效的目标,基于此,同推荐架构、平台达成共识,建设面向算法等专业人员的低代码开发工具,使定制化需求能够快速的通过低代码环节进行快速开发和发布上线; 整体思路,参考大数据的 easy studio 系统 2.2.5 推荐算法PaaS化工具建设 这里我们主要考虑定制类需求,比如召回新增数据源、敏感商品过滤、case排查工具等;对于定制类需求,我们希望提供一些高效易用的PaaS化工具,一方面,解放算法的重复劳动力,另一方面,缩短业务需求交付的周期; 3. 落地实施 3.1 案例一 场景模板个性化推荐能力建设 3.1.1 场景模板开发 场景模板作为承接新增推荐位需求的一种工具,直接开放给业务方使用,针对不同推荐场景,我们建设了丰富的模板供业务方选择使用,包括:全站商品综合推荐、商详、购物车、直播、短视频等,在每个模板上,我们配置了基础的推荐分发策略,业务方可以根据自己的需求选择使用哪些推荐策略;下面以商品聚合tab推荐为例,介绍模板个性化推荐能力的落地实施情况; 首先,在模板建设的前期,我们会和产品共同确认类似需求的量级,作为评估是否建设模板的依据;比如说,我们评估商品聚合tab推荐这类需求在每个季度平均会存在3-4个,且该类需求对算法能力的要求基本相似,因此,我们认为商品聚合tab推荐是属于通用类且比较频繁的一类需求,需要建设模板高效承接该类需求; 其次,作为算法人员,我们需要针对该类需求进行算法能力的梳理,通过过去十几个类似需求对推荐能力的要求,大致可以整理出一版功能完善,覆盖度极高的算法方案;以商品聚合tab推荐为例,在数据接入时,大部分需求中,业务方提供的数据是包含商品池(did)、虚拟类目/品牌(vcateid)及真实类目/品牌(cate_id)的底池数据,而在召回时,往往通过冷启和画像两路召回完成虚拟类目/品牌及真实类目/品牌的召回,再通过一个线性排序模型完成rank阶段的打分,辅以过滤、调权及多样性策略完成整个推荐分发能力的搭建,通过上述描述不难发现,如果大部分需求都是按照上述流程推进,那我们就可以设计完善的算法方案高效承接类似需求; 然后,在算法方案评审完成的基础上,由架构侧完成功能的开发,由平台侧完成前端页面的开发; 最后,当再存在类似业务需求时,我们对业务方开放模板能力,业务方自己就可以通过点选式的页面完成需求,且这个过程的进度均由业务方自己把控; 场景模板开发流程图 3.1.2 全自动召回词表/索引库能力建设 在我们承接业务需求的过程中,大部分情况下,每个业务方都有自己的商品底池,面对不同的商品底池,我们需要根据商品底池的变化动态的调整召回词表或者索引库,假如我们想要个性化分发能力完全自动化,那就需要打造一套新的召回词表/索引库构建工具,基于此,我们联合平台侧共同提出了一键底池/索引库创建落地方案,具体来说,算法人员将模板上所需的所有召回词表/索引库生产脚本进行抽象封装,预留入参及出参,平台侧通过前端界面获取具体召回词表/索引库创建的命令,并将该命令作为入参输入算法人员预先封装好的代码包,为了每天定时更新任务,同时自动创建BDP调度任务,代码包的出参通过DUCC回传给平台侧,作为后续创建词表/索引库的依据,从而完成召回词表或者索引库的全自动化创建; 一键底池/索引库创建落地实施 3.1.3 多业务排序模型支持 为了覆盖更多业务需求,在排序模块我们主要考虑不同业务模式下对排序能力的要求,比如,在下沉场景,更多的是需要提升UCVR指标,而主站的一些业务需求希望提升用户的UCTR指标,因此,为了兼顾多样的业务需求,我们梳理了三个常用的模型,分别是主站的多领域排序模型,特价版的下沉排序模型以及ToB的企业排序模型,将上述三个模型集成到每个模板里,并提供每个模型的介绍及使用说明,业务方可以根据需求的具体内容进行选择; 排序模型选择 3.2 案例二 打造高效易用的PaaS化工具 工具的合理使用,不仅可以提高我们的工作效率,还可以使我们的工作变得更加轻松;这里以我们在用户体验中打造的啄木鸟为例,为大家讲解PaaS化工具在业务中的应用;(名词解释之啄木鸟:支持离线过滤/解禁自主配置的平台化工具) 3.2.1 需求梳理 在用户体验模块,常常有业务需求需要对商品、类目、敏感词等进行过滤,或者在某一段时间内进行过滤,时间过后要求再释放出来;在没有打造啄木鸟之前,我们接到类似需求后,会手动将商品、类目或者是敏感词写到一个文本中,然后再将文本push到hdfs的某一个路径下,第二天的BDP调度任务执行时,会更新数据表,达到过滤或者释放的目的;观察上述流程不难发现,手动修改文本极易导致出错,无心的删除或者增加可能就会导致第二天的调度任务挂掉,不稳定;另外,有新人接手这样的需求后,培训成本极高,需要手把手教几遍才敢把这样的工作交给他,操作难度大; 为了解决这样的难题,我们计划打造一款高效易用的PaaS化工具,这样的工具可以提供稳定的增删改查,而且还要操作简单,最好是一看就知道怎么操作,基于这样的想法,我们联合平台一起打造了啄木鸟; 3.2.2 啄木鸟的设计及开发 设计思路: 通过jrec平台,能够将所有的离线过滤/释放进行paas化配置,平台需要具备如下能力: 啄木鸟平台提供过滤、释放配置入口,由jrec平台提供; 在平台配置的长期规则可以下沉至离线,降低对线上服务资源的占用; 离线过滤能够灵活配置,且支持离线释放,减少手工操作成本; 方案设计: 整体方案设计如下图所示,通过平台WEB界面配置后,数据经DUCC流转到离线计算任务部分,待离线计算任务完成后,导数到jimdb进行缓存,线上配置过滤服务或者ps的过滤算子后即可完成商品、类目或者是敏感词的过滤与释放; 啄木鸟落地实施 3.3.3 啄木鸟使用 啄木鸟建设好交付对应的算法人员进行使用,我们也提供了详细的使用手册供新人学习; 4. 实践经验总结 在推荐算法PaaS化探索与实践的过程中,我们作为能力的提供者和能力的使用者,一方面从能力提供者的角度出发,总结梳理出需要提供的PaaS化工具,另一方面,从能力使用者的角度出发,去评估工具是否高效易用; 作为能力的提供者:通过对业务需求的梳理及PaaS化建设者长期的业务经验,立足现有推荐系统,通过对推荐算法的组件化,重新认识系统,重新规划流程; 作为能力的使用者:从被动到主动,切实感知到工具对效率的提升,善于利用工具,通过PaaS化工具,轻轻松松完成复杂的业务需求,只要想干,就可以自己把握需求交付的节奏; 5. 未来工作展望 我们希望在长期主义的复利下,将推荐算法PaaS化积累成一个奇迹;基于我们目前对业务需求的认知,未来,我们将从如下几个方面不断深耕: 5.1 场景模板分层个性化推荐能力建设 在未来一段时间里,我们会针对模板的个性化能力进行升级,基于现在基础版的现状下,提供进阶版及高阶版能力,满足业务更多样的诉求; 5.2 打造高效易用的PaaS化工具 5.2.1 单素材服务能力建设 首先需要阐述一下我们为什么要建设单素材服务能力,一个重要的原因是场景模板仅能支持新增推荐位需求,且该类需求不能很复杂,而对于复杂的新增推荐位需求或者是已有推荐位的迭代优化场景模板无法提供支持;基于此,我们提出了服务复用的概念,具体来说,我们计划将单素材打造成一个一个的服务,算法人员专注的对服务进行全方位优化,而需要进行效果优化的新增推荐位需求以及已有推荐位的迭代优化则通过服务进行赋能,此举不仅可以减少算法人力的投入,还可缩短业务需求交付的周期; 5.2.2 算法组件平台化进一步升级 为了提升推荐算法PaaS化能力使用者的使用体验,我们计划将部分通用的算法能力平台化,以摆脱目前仍然需要算法人员手动复制的操作工作,真正实现点选式的操作方法,因此,后续我们也会联合平台侧,共同打造这样的平台能力,进一步释放算法人员的重复劳动力;

优秀的个人博客,低调大师

虚拟云网络系列 | Antrea 应用于 VMware 方案功能简介(十一)

本篇推文继续之前讨论 Antrea 与 NSX Manager 整合的手动安装流程,接下来要讨论流程四、五、六。这几篇讨论的安装流程图如下,相关的步骤于官方文件内有正式的说明。 流程四: 修改安装配置档,输入 NSX 及凭证相关资讯 流程一内我们由 VMware 官网下载了 NSX interworking agent 的配置档,包含了 interworking.yaml, bootstrap-config.yaml, deregisterjob.yaml 这几个。本流程内要修改这些 YAML 档内相关的参数。首先在 interworking.yaml 以及 deregisterjob.yaml 这两个档内,我们要告知这个 NSX interworking agent 的 image 档来源在哪。 在大部分的安装环境有Internet连线的话,上述的 image 于 VMware Public Harbor Registry 都有。路径可以这样找: 1. 在流程一内,先确定了 Kubernetes Cluster 内安装的 Antrea 商业版本。此时,请到这个对应 Antrea 商业版本的 Release Note 页面。 2. 确认安装的 TKC 或是原生 Kubernetes Cluster 内,Worker Node 的作业系统是哪种。在 Tanzu 部署的 TKC 配置时,通常底层 Worker Node 的作业系统是 Ubuntu 或是 Photon OS。在 Release Note 内,依据作业系统型态,找到对应的 NSX interworking agent 的下载路径。 在这几篇推文的展示内,我利用 vSphere with Tanzu 建立的 TKC 1.22.9,内建的 Antrea 商业版本是 v1.3.1-1.2.3(请参阅流程一)。同时,配置 TKC 时选择的底层 OS 是 Photon。下图是 VMware Container Networking with Antrea 1.3.1-1.2.3 版的 Release Notes: 请注意上图内的红框部分,就是对应到不同 K8S Node 作业系统的 NSX interworking agent 的下载路径。因为我的 K8S 底层是 photon,因此路径就是这里所标示的 projects.registry.vmware.com/antreainterworking/interworking-photon:0.2.0 。 本步骤内,请到 interworking.yaml 与 deregisterjob.yaml 这两个 YAML 配置档内,找到所有的 image 部分,把上述的 image 下载路径输入进去,像是下面这张图。在 v1.3.1-1.2.3 的 interworking.yaml 有六个地方要改,deregisterjob.yaml 有一处。 如果是 Air-Gap,没有 Internet 连结到 VMware Public Harbor Registry 的环境呢?此时的做法就是将在流程一内同时已有下载的 image 档案,放到内部 Harbor Registry,或是手动装到每个 Worker Node 里面。请参考正式文件“Registering an Antrea Container Cluster to NSX-T Data Center” 里面的最后一段,有相关指令说明,如下图: 接着下个步骤:在 bootstrap-config.yaml 配置档内,请找到下列四个栏位输入: • clusterName: 请输入这个 K8S Cluster 的名称。必须与流程二与流程三内输入的 CN Name 与 Node ID 完全一致。在这个范例内,是 tkgs-122-cluster。 • NSXManagers: 在括弧内填入 NSX Manager 的 IP 地址,依据环境是有单台或三台 NSX Managers,把 IP 全部填入。 • tls.crt: 请利用 cat <流程二-凭证档名> | base64 -w 0 的指令,将结果复制贴上。 • tls.key: 请利用 cat <流程二-私钥档名> | base64 -w 0 的指令,将结果复制贴上。 在前面流程二,我们建立的凭证档是 tkgs-122-cluster.crt,私钥档是 tkgs-122-cluster-private.key。下图内,利用 cat / base64 指令,取得的结果为 请把上图的凭证 / 私钥完整剪贴到 bootstrap-config.yaml 内,千万不要遗漏了。下图就是我们要修改的 bootstrap-config.yaml 范例图,包含前面讨论要修改的四个部分。 这样所有的配置档就修改完成了。上述参数的详细输入与范例,也请参考正式文件说明,有很完整的讨论。 流程五: 启用配置档 流程五极为直接,请将上述配置档放到可控制这个 Kubernetes Cluster 的跳板机内,执行下列 kubectl 指令进行安装: # kubectl apply -f bootstrap-config.yaml -f interworking.yaml 接着,可以利用 kubectl get pods -n vmware-system-antrea 这个指令看 NSX interworking-agent 的安装状态。若一段时间后,STATUS 停留在 Running,4 个内部 container 都是写 READY,此时就安装完成了。 流程六: 在 NSX Manager 内检视相关 Kubernetes Cluster Inventory 资讯 当前面步骤顺利完成,此时到 NSX Manager – Inventory – Containers – Clusters 就可以看到我们安装的 Kubernetes Cluster 出现,也可以查询相关的 Cluster / Nodes / Pods / Services 资讯,如下图。接着,大家就可以如推文内第六第七篇的说明,来进行微分段功能相关配置了。 多说一句,在上图内,大家可以看到同一个 NSX Manager 可以管理多个 Kubernetes Cluster。上面的配置内我们接了一个 Tanzu Kubernetes Grid 产出的 Cluster (tkgm-122-tkc03)、本范例内以 vSphere with Tanzu 配置的 Cluster (tkgs-122-cluster)、以及另一个手动建立的原生 K8S 丛集 (vanilla-cluster)。如前所述,这些不同方式建立的 Kubernetes 丛集,都可以透过一模一样的流程,连接到 NSX Manager 内进行管理。 在这三篇推文内我们详细讨论了如何将一个采用 Antrea 作为 Container Networking Interface 的 K8S 丛集,注册到 NSX Manager 内的完整流程。以 NSX 来管理 Kubernetes Pod 东西向防火墙是很多 Tanzu 客户喜爱或打算部署的功能,因此大家应该也会有机会在自己或客户的环境内进行相关配置,希望前面的讨论有顺利涵盖到安装时需要注意的各个面向。 到目前我们讨论的都着重在使用 Antrea 整合 NSX 做容器环境的安全保护。下一篇推文开始我想介绍完全不同的课题,针对 Antrea 的两个网络与 IP 管理功能,分别是 Antrea Egress 以及 Antrea IPAM,与大家进行说明。 本文作者:Colin Jao (饶康立), VMware 资深技术顾问,主要负责 VMware NSX 产品线,目前致力于网络虚拟化、分布式安全防护技术与新应用递送方案的介绍与推广。 内容来源|公众号:VMware 中国研发中心 有任何疑问,欢迎扫描下方公众号联系我们哦~

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册