首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5791篇文章
优秀的个人博客,低调大师

国产数据库管理工具 CloudDM v2.4.1发布,StarRocks 兼容修复

CloudDM 是 ClouGence 公司推出的一款一站式多数据源开发管理工具,使用它可以方便地访问和管理 MySQL、Oracle、PostgreSQL、阿里云RDS、Greenplum、TiDB、Redis、StarRocks、Doris、SelectDB、SQL SERVER、ClickHouse、OceanBase 、PolarDB-X 、IBM Db2 等多种不同类型的数据库。通过 CloudDM 丰富的数据源支持可以避免在多个专业工具之间切换,从而提高工作效率。 它是本地化的应用程序,没有后台进程。和 DataGrip、Navicat 一样在安装完成后,只需要双击应用程序图标,便可以方便的管理位于本地计算机或远程计算机上的数据库。已经支持 Windows、MacOS 和 Linux 主流操作系统。 更新内容 [优化] 优化 PostgreSql 和 GreenPlum 数据库表编辑内容描述 优化 PostgreSql 和 GreenPlum 数据库表编辑生成SQL,关键字进行大写 [修复] ​​​​​​​修复 StarRocks 数据库版本获取错误的问题 修复 StarRocks 数据库 Decimal32 等类型不支持的问题 修复 SQL SERVER 数据库添加数据源失败的问题 修复 设计表选择列组件选中错误的问题 修复 SQL编辑多条SQL在一行的时候,无法正确识别光标所在SQL的问题 修复 编辑器页面修改 Schema,聚焦功能不能正确跳到左边数据源树的对应 Schema节点的问题 修复 在弹窗时,窗体后端UI组件没有被遮盖的问题 修复 没有新版本仍然会调用更新详情接口的问题 下载与反馈 产品官网:https://www.clougence.com/clouddm-personal 问题反馈:https://gitee.com/clougence/clouddm-issue/issues Release Node:https://www.clougence.com/dmp-doc/releaseinfo/desktop_2_4_1 微信交流群:访问产品官网,扫描右侧二维码即可加入

优秀的个人博客,低调大师

新一代国产 ORM 框架,sqltoy-orm 5.2.77 发版,优化同比环比计算!

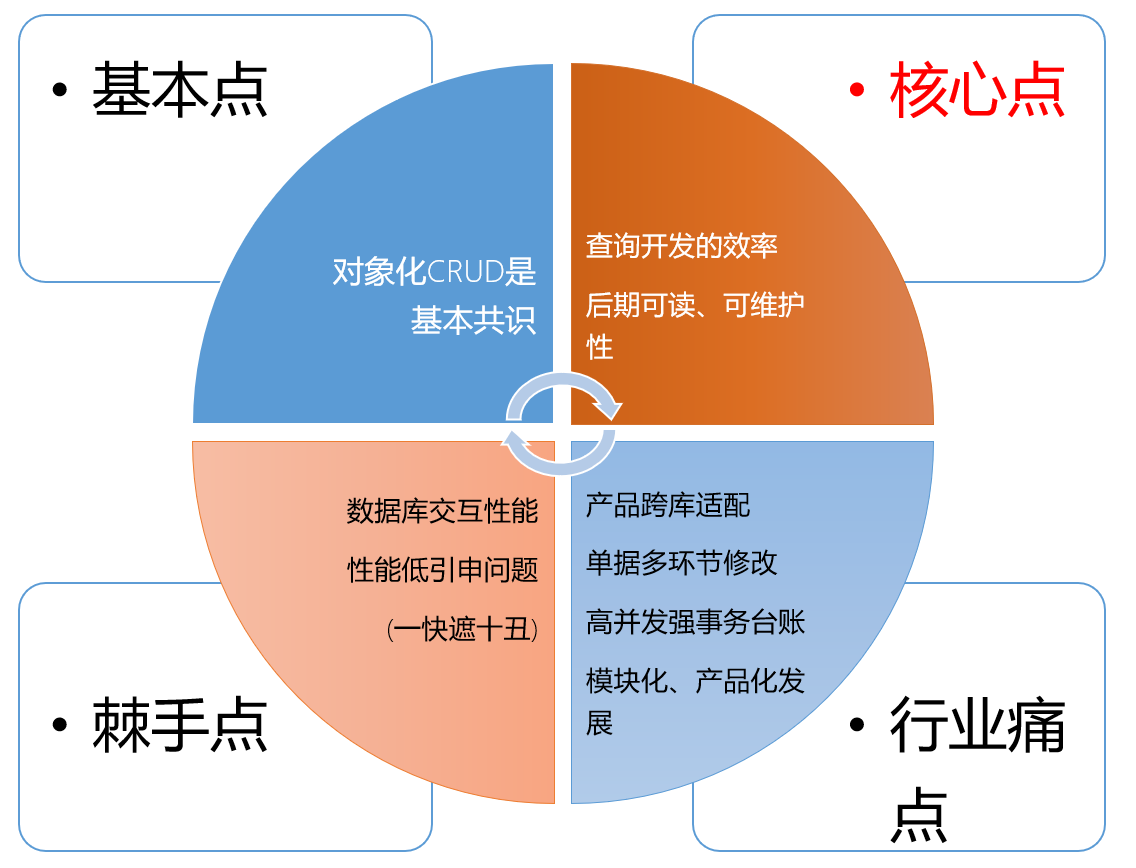
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、优化环比计算默认值设置 2、优化分页总记录数的逻辑(5.2.75版本) sqltoy-orm 是 JPA 和超强查询的融合体 JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

在芒果派麻雀全志D1s上运行国产开源rt-smart系统

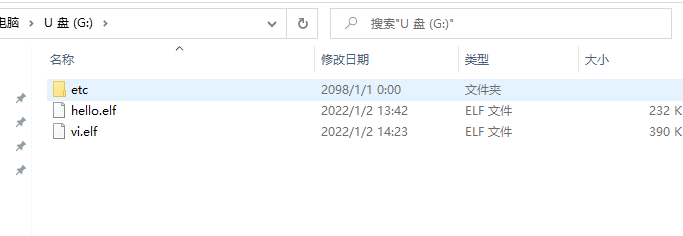
想必RT-Thread系统大家不陌生了,RT-Thread Smart(简称 rt-smart)是基于 RT-Thread 操作系统衍生的新分支,面向带 MMU,中高端应用的芯片,例如 ARM Cortex-A 系列芯片,MIPS 芯片,带 MMU 的 RISC-V 芯片等。rt-smart 在 RT-Thread 操作系统的基础上启用独立、完整的进程方式,同时以混合微内核模式执行。 官方文档:https://www.rt-thread.org/document/site/#/rt-thread-version/rt-thread-smart/rt-smart-quickstart/rt-smart-quickstart 内核:rt_smart_kernel.bin 硬件:麻雀,MQ1或MQ1W RT-smart包(自带编译器):mango_rtsmart_app.zip 1. 分区 使用fdisk分区。 将u盘挂载到ubuntu系统后,笔者设备路径是/dev/sdb。使用的32GB TF卡,扇区大小512字节,根据说明预留8M的空闲,那么计算得知分区扇区开始于:16384 命令:sudo fdisk /dev/sdb 选:o,n,p,1,16384,回车 Command (m for help): o Created a new DOS disklabel with disk identifier 0x3668b987. Command (m for help): n Partition type p primary (0 primary, 0 extended, 4 free) e extended (container for logical partitions) Select (default p): p Partition number (1-4, default 1): 1 First sector (2048-62410751, default 2048): 16384 Last sector, +sectors or +size{K,M,G,T,P} (16384-62410751, default 62410751): Created a new partition 1 of type 'Linux' and of size 29.8 GiB. Command (m for help): w The partition table has been altered. 正确的分区效果如下: mango@virtual:/dev$ sudo fdisk -l /dev/sdb Disk /dev/sdb: 29.8 GiB, 31954305024 bytes, 62410752 sectors Units: sectors of 1 * 512 = 512 bytes Sector size (logical/physical): 512 bytes / 512 bytes I/O size (minimum/optimal): 512 bytes / 512 bytes Disklabel type: dos Disk identifier: 0x3668b987 Device Boot Start End Sectors Size Id Type /dev/sdb1 16384 62410751 62394368 29.8G 83 Linux mango@virtual:/dev$ 然后格式化sdb1: $ sudo mkfs -t fat /dev/sdb1 2. 刷入RT-SMART内核 $ sudo dd if=rt_smart_kernel.bin of=/dev/sdb bs=1024 2888+1 records in 2888+1 records out 2957313 bytes (3.0 MB, 2.8 MiB) copied, 8.32574 s, 355 kB/s $ sync 3. 启动RTT 此时将TF卡放入麻雀,串口0(底部排针的7,8脚),串口波特率500000,然后上电: [26]HELLO! BOOT0 is starting! [27]BOOT0 commit : fb73c68 [28]set pll start [28]periph0 has been enabled [29]set pll end [30]board init ok [30]ZQ value = 0x2f*********** [31]get_pmu_exist() = -1 [32]ddr_efuse_type: 0xa [33][AUTO DEBUG] single rank and full DQ! [34]ddr_efuse_type: 0xa [35][AUTO DEBUG] rank 0 row = 13 [36][AUTO DEBUG] rank 0 bank = 4 [37][AUTO DEBUG] rank 0 page size = 2 KB [37]DRAM BOOT DRIVE INFO: V0.24 [38]DRAM CLK = 528 MHz [39]DRAM Type = 2 (2:DDR2,3:DDR3) [40]DRAMC read ODT off. [40]DRAM ODT off. [41]ddr_efuse_type: 0xa [42]DRAM SIZE =64 M [44]DRAM simple test OK. [45]dram size =64 [45]card no is 0 [45]sdcard 0 line count 4 [46][mmc]: mmc driver ver 2021-04-2 16:45 [52][mmc]: Wrong media type 0x0 [53][mmc]: ***Try SD card 0*** [60][mmc]: HSSDR52/SDR25 4 bit [61][mmc]: 50000000 Hz [61][mmc]: 30474 MB [62][mmc]: ***SD/MMC 0 init OK!!!*** [98]Loading boot-pkg Succeed(index=0). [99]*******************TOC1 Item Message************************* [100]Entry_name = opensbi [101]Entry_data_offset = 0x600 [102]Entry_data_len = 0x188e0 [103]encrypt = 0x0 [103]Entry_type = 0x0 [104]run_addr = 0x40000000 [105]index = 0x0 [105]Entry_end = 0x3b454949 [106]************************************************************* [108]*******************TOC1 Item Message************************* [109]Entry_name = dtb [110]Entry_data_offset = 0x19000 [111]Entry_data_len = 0x7475 [111]encrypt = 0x0 [112]Entry_type = 0x0 [113]run_addr = 0x40200000 [114]index = 0x0 [114]Entry_end = 0x3b454949 [115]************************************************************* [117]*******************TOC1 Item Message************************* [118]Entry_name = kernel [119]Entry_data_offset = 0x20600 [120]Entry_data_len = 0xa6cf0 [120]encrypt = 0x0 [121]Entry_type = 0x0 [122]run_addr = 0x40400000 [123]index = 0x0 [123]Entry_end = 0x3b454949 [124]************************************************************* [126]Jump to second Boot. OpenSBI v0.9-165-gefbc2b8 ____ _____ ____ _____ / __ \ / ____| _ \_ _| | | | |_ __ ___ _ __ | (___ | |_) || | | | | | '_ \ / _ \ '_ \ \___ \| _ < | | | |__| | |_) | __/ | | |____) | |_) || |_ \____/| .__/ \___|_| |_|_____/|____/_____| | | |_| Platform Name : Allwinner D1 NeZha Platform Features : medeleg Platform HART Count : 1 Platform IPI Device : aclint-mswi Platform Timer Device : aclint-mtimer @ 24000000Hz Platform Console Device : uart8250 Platform HSM Device : --- Platform Reboot Device : sunxi-wdt-reset Platform Shutdown Device : --- Firmware Base : 0x40000000 Firmware Size : 248 KB Runtime SBI Version : 0.3 Domain0 Name : root Domain0 Boot HART : 0 Domain0 HARTs : 0* Domain0 Region00 : 0x0000000014008000-0x000000001400bfff (I) Domain0 Region01 : 0x0000000014000000-0x0000000014007fff (I) Domain0 Region02 : 0x0000000040000000-0x000000004003ffff () Domain0 Region03 : 0x0000000000000000-0xffffffffffffffff (R,W,X) Domain0 Next Address : 0x0000000040400000 Domain0 Next Arg1 : 0x0000000040200000 Domain0 Next Mode : S-mode Domain0 SysReset : yes Boot HART ID : 0 Boot HART Domain : root Boot HART ISA : rv64imafdcvsux Boot HART Features : scounteren,mcounteren,mcountinhibit,time Boot HART PMP Count : 16 Boot HART PMP Granularity : 2048 Boot HART PMP Address Bits: 38 Boot HART MHPM Count : 0 Boot HART MIDELEG : 0x0000000000000222 Boot HART MEDELEG : 0x000000000000b1ff heap: [0x404fbdf4 - 0x41cfbdf4] [I/I2C] I2C bus [i2c2] registered \ | / - RT - Thread Smart Operating System / | \ 5.0.0 build Dec 31 2021 2006 - 2020 Copyright by rt-thread team lwIP-2.1.2 initialized! SDC:hal_sdc_create host:000000004051bdf8 id:0 SDC:Not implement __mci_restore_io,798 SDC:Not imp hal_sdc_init,2218 SDC:hal_sdc_init,2251 no imp SDC:hal_sdc_init,2259 no imp SDC:SDC Host Capability:0x3820f Ocr avail:0x3f0000 SDC:SDC cd_mode:2 present_val:0 SDC:SDC id:0 dma_use:1 present:1 driver version SD/MMC/SDIO Host Controller Driver(v0.27 2021-04-30 16:50) init ok. card_detect insert SD:mmc_card_create card:000000004052e1a8 id:0 SDC:Not implement __mci_restore_io,798 SDC:SDC clock=400000 kHz,src:0, n:1, m:14 SDC:SDC clock=400000 kHz,src:0, n:1, m:14 SD:***** Try sd ***** SD:card ocr: ffffffffc0ff8000 SD:Card CID number:55 SD:card raw cid: SD:card raw csd: SD:card raw scr: SD:card raw SD status: SDC:SDC clock=50000000 kHz,src:1, n:0, m:5 SD:card is switched to high speed mode, clk:50000 KHz SD:Set bus width type: 2 SD: ============= card information ============== SD:Card Type : SDHC SD:Card Spec Ver : 5.0 SD:Card RCA : 0x0001 SD:Card OCR : 0x40ff8000 SD: vol_window : 0x00ff8000 SD: to_1v8_acpt : 0 SD: high_capac : 0 SD:Card CSD : SD: speed : 50000 KHz SD: cmd class : 0x5b5 SD: capacity : 30474MB SD:Card CUR_STA : SD: speed_mode : HS: 50 MHz SD: bus_width : 2 SD: speed_class : 10 SD:============================================= SD:***** sd init ok ***** Initial card success [I/sal.skt] Socket Abstraction Layer initialize success. file system initialization done! gt9xx_probe Hello RISC-V msh />[D/TOUCH.gt9xx] 39 31 31 0 0 [I/TOUCH.gt9xx] Found chip gt911 [I/TOUCH.gt9xx] GT9xx Config version: 0x00 [I/TOUCH.gt9xx] GT9xx Sensor id: 0xFF msh /> 4. 运行应用程序 祭出祖传hello程序:根据说明自行编译,输出为:hello.elf 文件,直接 拷贝到TF卡的文件系统中 然后重新将tf卡放进麻雀,开机启动: msh />ls Directory /: System Volume Information<DIR> etc <DIR> hello.elf 237512 vi.elf 398544 msh /> msh />./hello.elf msh />hello world! 至此,hello程序就运行起来了! 5. 扩展之编译 请在Linux下使用此开发环境包(已经自带64位Linux系统的编译器环境),如果要在Windows下使用,请自行配置安装编译在tools目录下,然后参照smart-env.sh里的脚本配置好环境变量。 在Linux下使用步骤: 首先执行source smart-env.sh riscv64,也可以根据自己的环境稍作修改。 进入userapp目录进行应用编译,例如编译自带的hello应用程序,只需要执行scons --app=hello。 编译好的应用程序会生成在root/bin目录下,将其拷贝到SD卡中(注意是8M偏移的起始分区),然后进入rt-smart系统中,启动挂载成功后即可运行。 本帖整理自全志在线:https://bbs.aw-ol.com/topic/908/

优秀的个人博客,低调大师

下一代英伟达H100 GPU发布时,国产芯片能追上吗?

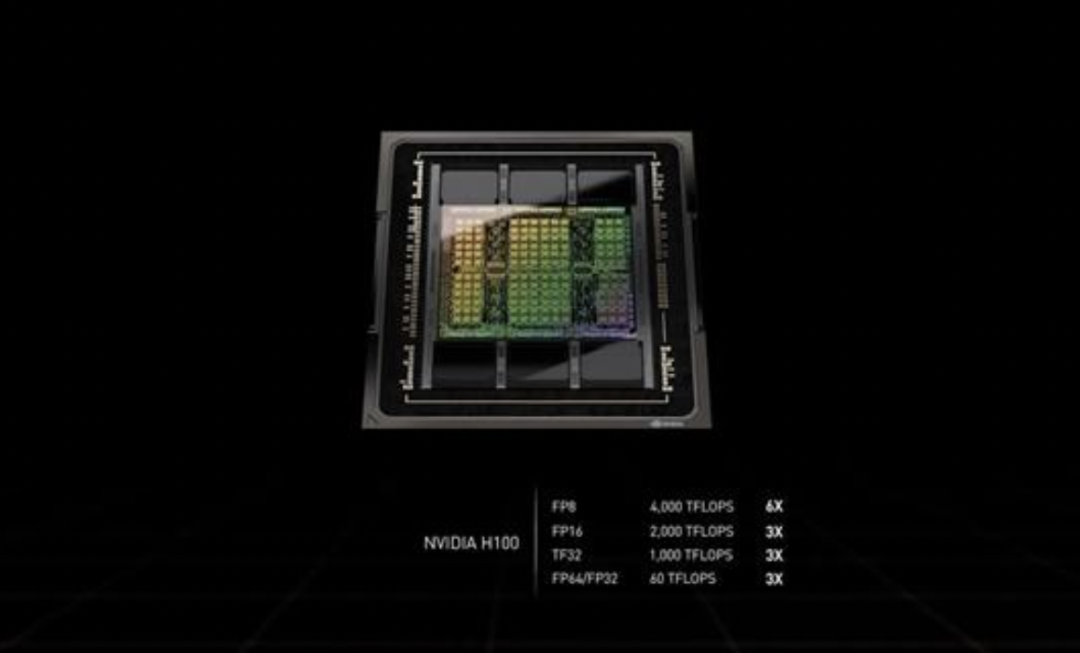
撰文|吕坚平 继2020年GTC(GPU技术大会)发布A100 GPU,时隔两年,英伟达如所预期在今年(2022年)上GTC公布了媒体形容为“核弹”GPU的H100。 2020年GTC后,国内很多GPU 初创公司争先恐后的宣称能超赶A100;2021年GTC上英伟达发布的DPU也让很多芯片精英竞相创业投入DPU开发,谓为风潮;今年的H100会造成什么样的回响,且让我们拭目以待。 媒体已经有很多关于H100的介绍,对H100的技术进行详细报道,例如芯东西标题为《800亿晶体管核弹GPU架构深入解读,又是“拼装货”?》,以及半导体行业观察的《深入解读英伟达“HOPPER”GPU 架构》,这里就不再赘述。这篇文章目的是要探讨H100背后的技术思路及市场策略对中国的启发,是否值得国内业界完全跟随效仿?到2024年的GTC,H100的下一代问世,我们是不是又更落后了? 1 解读英伟达 英伟达这些年一直致力于宣称,在后摩尔时代,其新产品还是可以超越传统摩尔定律,为行业提供相对于两年前产品,两倍以上的性能提升,淡化功耗增加的代价。每代产品之间(以Turing、Ampere、Hopper为例)基本上寄希望于四个性能提升潜力来达成目标:1) 工艺提升为频率带来1.5倍以内提升;2)在不计功耗成本下,计算单元数倍增;3) 领域专用架构(Domain-Specific Architecture,DSA)设计带来性能加倍,如Turing的Tensor Core, Ampere的硬件Sparsity, Hopper的Transformer Engine;4)引入新的数据精度类型,用低精度来代替高精度单元比如Turing的INT4, Ampere的TF32, Hopper的FP8 带来加倍性能。 综合这些因子,理论上,英伟达的代际产品之间有1.5 x 2 x 2 x 2 = 12,也就是一个数量级的性能提升空间。然而,受限于后摩尔定律时代的现实及功耗墙的限制,性能提升总远小于一个数量级。运用这个思路,英伟达用以下图示,宣称H100性能达到A100的六倍: H100相对于上一代A100的性能提升 然而,要注意的是,这六倍性能提升是峰值中的峰值,特例中的特例,并非是一般情况下的平均性能。原因在于,这是在跑Transformer之类网络的性能峰值,而且只有在数据完全能以FP8来表示的情况下才会发生。更何况,在后摩尔定律时代,谈到性能,我们一定还要考虑功耗,性能功耗比是更重要指标。 除此之外,我们还应该排除工艺带来的性能功耗比提升,才能确切了解H100相较于A100,架构的创新贡献了多少性能功耗比。此外,现实中,英伟达产品的很多创新需要时间被行业消化,有些新功能需要时间被市场接受,最终的普适效果不见得会发生,也不会真的有那么大影响。具体来说,大部分客户在迭代时会先做平移,也就是将上代代码直接移到下代。由下表可以看出, H100相较于A100,峰值算力的提升在一般状况下应该可以达到3.2倍。 H100 VS A100 假设台积电的N7到N4工艺进步使得性能功耗比提升了26%,那么H100相较于A100,在一般状况下,H100在性能功耗比上提升了3.2 x 350/700 - 1 = 60%, 而滤除工艺加持,纯架构创新只贡献 (3.2 x 350) / (1.26 x 700) -1 ≈ 30% 的峰值算力效能提升。 那么,客户到最后要多付出多少代价换取60% 性能功耗比的提升?我们还不知道最终H100系列产品性价比有没有进步,但已知的是,这次GTC并没有透露基于H100的DGX价格,也不再重复那句名言 “你买的越多,省得也越多“ (“The more you buy, the more you save”)。 2 技术路线分析 我们接下来分析H100几个重要技术路线。 GPU走DSA路线是从H100开始的吗? 芯东西的报道结尾提到H100设计是英伟达的GPU朝DSA(Domain Specific Architecture,领域专用架构)的方向发展的开始。然而,GPU传统上就一直接纳DSA,并非从H100开始,这也是英伟达能从容应付DSA挑战者一大制胜关键。让一般人甚至包括提出DSA的大师John Hennessey 及David Patterson 教授都没有理解的是,GPU架构师向来的理念都是融合DSA于通用架构。但他们是在核心,而不是在芯片上层异构化。这一点可以用以下图来说明。 传统DSA架构图(左)GPU融合DSA架构的示意图(右) 图左是一般人认同的DSA架构示意图,谷歌的TPU AI加速芯片大致就是这个样子。图右是GPU融合DSA架构的示意图,如,从早期的纹理单元(Texture Unit),特殊函数单元 (Special Function Unit), 到最近的张量核心(Tensor Core)及光追核心(RT Core)。这些例子有些共通之处: 1.一个DSA设计的硬件资源平均分布到每个运算单元,以特殊指令或是程序调用的方式引用,成为各单元通用计算核心的一部分,不在芯片最上层成为一个独立处理器,而是原可编程生态的自然延伸,不影响原先的编程方式。 2.适配于市场上的成熟应用,譬如说纹理运算之于绝大部分图形应用,张量计算之于几乎所有AI算法,而且资源投入多少,可以基于应用的频率,不会被过度闲置。 我们可以将GPU这种融合DSA设计的方式称为“DSA通用化”,在提升效能的同时,持续强化通用优势。这可以解释,为什么号称为AI专门设计的芯片,包括TPU在内,都无法碾压GPU,而且在通用性上彻底对GPU称臣。 这次英伟达在H100上加了为Transformer类型网络优化的Transformer Engine 以及相对应的FP8数据格式,与针对Dynamic Programing 优化的DPX 特殊指令集,可以说是延续了DSA 通用化的传统。就Transformer Engine 来说,Transformer类型网络已公认能通用到各样应用领域,跳脱源起的自然语言处理范畴,而Transformer Engine 也是配置到Tensor Core中,针对网络层数据做统计分析,未来有可能可以通用化到其他类型网络。 对DPX来说,英伟达也列举了基因排序以及机器人路径规划等应用。与先前针对市场成熟应用DSA加速器不同的是,Transformer Engine 及 DPX 的应用范围在短期内还是比较小,也尚未被市场广泛接受,英伟达这次走在了市场之前。这是不是GPU未来DSA通用化的趋势,尚未得知。对天数智芯来说,我们愿意跟国内客户密切合作,走出一条适配国内市场又兼具国际技术视野的DSA通用化道路。 H100以“非同步执行”(Asynchronous Execution)提升通用计算效率 H100延伸A100开始的非同步执行路线,提升通用计算效率,增加Tensor Memory Accelerator(TMA)处理芯外内存及核心内共享记忆体(SMEM)或是 SMEM之间搬移大张量的问题。SMEM附属于一个SM(Streaming Multiprocessor,英伟达的计算单元)。现在为了能支持SMEM之间数据搬移,以及整合成一块SMEM,SM之间现在也有了一个互联网络。 因为AI算法的多样性及快速演进,鱼与熊掌不可兼得,我们不得不走向通用,而舍弃专用的好处。在我看来,非同步执行技术方向的终极目标是要填补通用与专用之间的效能差距,使得鱼与熊掌可以兼得,让GPU的通用计算效率更接近ASIC (Application- Specific IC)中常见的专用流水线。 ASIC这个字眼现在几乎已经完全被DSA掩盖,我采用ASIC,而不是DSA,是因为后者不一定以流水线为主。专用流水线的特色是在把数据从生产者(Producer)传送到消费者(Consumer)的同时,生产者及消费者还是继续工作。 我将这个技术方向更强化为“计算图形化”,因为图形流水线,如下图左边所示,是专用流水线的代表作。虽然中间数个节点已被跑在通用算力池的着色器(Shader)程序取代,它的流水线结构依然存在。非同步执行以不浪费时间等待数据传输,来接近专用流水线的效率。面对后摩尔定律时代的到来,通用计算借鉴ASIC风格的专用流水线精神,是条必须走下去的路线。 图形管线 传统图形无法充分利用H100 的AI算力 H100 SMX版本的66个TPC,以及PCIe版本的57个TPC中,只有两个TPC具备图形功能。这个设计或许是因为,虽然图形专用硬件的面积在1个TPC中不算大,但乘上三十倍左右之后,在面积及功耗已经都爆表的状况下,也是难以消受。 因为H100的图形与通用计算如此不成比例,我们可以称H100为通用GPU。可想而知,像H100这样级别的通用GPU要有与之匹配的图形能力,前提是图形必须在功能不减,性能不降的条件下,充分运用AI算力,并简化图形专用硬件。 利用mesh shader简化图形 随着图形流水线多个节点被跑在通用算力池的着色器程序取代,为什么不减少几个着色器节点?如上图所示,先进图形标准中,崭新的、更加利用计算功能的mesh shader 可以取代从vertex shader 到 geometry shader的着色器,从而在不减功能的前提下,将图形流水线节点数大量减少,并移除一些连接节点的专用硬件。性能还可能因为mesh shader 拥有的弹性,而有所提升。这是简化图形的第一步。 在英伟达的元宇宙/数字孪生蓝图中,H100 通用GPU系列与RTX 图形GPU 各司其职。然而图形GPU 需要通用计算加持才能支持数字孪生所需要的物理模拟运算,更需要AI做超分及为光追所需要的降噪。反而言之,通用GPU需要渲染才能广泛地从事基于AI的内容生成及三维建模。 我的看法是,通用与图形GPU应该融合。但H100没这么做,原因是作为通用GPU的H100已经高度为AI优化。更正确的说法是,张量计算已经由协同处理的角色,演变为通用GPU的算力中心,因为AI以张量计算为主。 然而传统的图形渲染着色器算法并非基于张量。这意味着要让以支援张量计算为主的通用GPU实现匹配的图形,唯一的途径就是要能够融合图形与AI,使得图形渲染着色器必须也采用基于AI的算法。我称该走向为“图形计算化”。 这一点,英伟达作为图形显卡市场领导者,是很难办到的,因为着色器算法的选择及编写在于图形应用开发者。对于天数智芯来说,我们做图形的目标是支援元宇宙/数字孪生的云端渲染,有机会与客户开发属于中国的生态,促使图形应用开发都以AI为基础,而使得为张量计算优化的通用GPU也能在图形领域大显身手。 3 深层合作与良性竞争的大联盟 大家最关心的话题是,我们如何接近甚至超赶英伟达?就如同前文所分析的,在一般的状况下,滤除工艺及功耗等因子,H100架构上的创新相较于A100贡献了30%左右效能提升。我们要能在2024年超赶英伟达,走不一样的路,在技术路线上,我们应该: 1.与国内客户合作,做出适合国内市场的DSA通用化来持续通用优势 2.以计算图形化,提升通用计算效能,媲美图形流水线 3.与国内生态合作,借由图形计算化,直接跨接先进图形标准,并使专精于张量计算的通用GPU可以在图形领域大显身手 我们也不能忽略“开发全自主、技术广通用”在GPU赛道的重要性。只有坚持自主创新,从底层硬件到上层软件独立设计开发,不走购买国外GPU IP的捷径,才能确保完全自主知识产权,打破国内长期作为国外IP代理的局面。也只有全自研的架构、计算核、指令集及基础软件栈,才能立即响应快速变化的市场需求,实现持续自主发展,完全不受国外IP制约。而且针对客户要求的不同技术层面开放性测试,才能从根本上保障了客户使用安全、信息安全。 就如同The Information 在题为“China’s 'Little Nvidia' Has a Big Secret: Its Homegrown AI Chip Isn’t”的报导中引述我的话,“只有一行一行地写代码来实现GPU的核心功能,才是走向自主的唯一途径“。有了开发全自主,技术广通用的GPU芯片之后,我们也要能在测试、客户适配、稳定供货,成功量产并实现规模应用等方面与英伟达对标,流片及点亮等只能说是初步站上赛道。 最后,我们还要探讨借鉴英伟达的根本意义在哪里。我们是要看到一家公司,在算力上, 席卷芯片、板卡、服务器、小集群、大集群到数据中心甚至算力中心, 在网络上, 涵盖芯间、片间、机箱间、到集群间互联,以及在应用上,坐拥芯片实力,广及医药、互联网、工厂、自动驾驶、生物医药吗? 中国所需要的,或许是个在技术深度及广度上,足以与英伟达相比拟,以深层合作及良性竞争为基调的大联盟。 吕坚平,天数智芯首席技术官(CTO)。毕业于耶鲁大学并获计算机科学博士学位,曾在英伟达、英特尔、三星等跨国半导体巨头担任要职,是GPU领域的著名专家。 (本文经授权后发布。原文: https://mp.weixin.qq.com/s/rtO8PxRj08GVimT3bfbplA) 其他人都在看 资源依赖的“诅咒” “远见者”特斯拉AI主管Karpathy 我,机器学习工程师,决定跑路了 对抗软件系统复杂性:恰当分层,不多不少 解读Pathways(二):向前一步是 OneFlow OneFlow v0.7.0发布:全新分布式接口,LiBai、Serving等一应俱全 点击“ 阅读原文 ” ,欢迎下载体验OneFlow v0.7.0最新版本 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Erupt 1.6.14 发布,国产!Admin 开发仅需注解,零前端代码,不生成代码有多爽?

本次更新内容 🐞 修复一对多组件excel导入出错的bug 🌟 search注解增加notNull配置 🌟 app.js支持module语法 🌟 由于很多框架不兼容gson的http消息转化器,所以将gson消息转化器设计成erupt私有,降低侵入性 🚀 Erupt 通用后台管理框架 Erupt 是一个低代码全栈类框架,它使用Java 注解动态生成页面以及增、删、改、查、权限控制等后台功能。 零前端代码、零 CURD、自动建表,仅需一个类文件+简洁的注解配置,快速开发企业级 Admin 管理后台。 提供企业级中后台管理系统的全栈解决方案,大幅压缩研发周期,专注核心业务。 Github 码云 后端源码 https://github.com/erupts/erupt https://gitee.com/erupt/erupt 前端源码 https://github.com/erupts/erupt-web https://gitee.com/erupt/erupt-web 项目官网:www.erupt.xyz 特性 | Features 自动建表:表结构自动生成,无需手动建表 易于上手:会简单的Spring Boot基础知识即可 使用简单:仅需了解@Erupt与@EruptField两个注解即可上手开发 代码简洁:仅需一个.java文件, template、controller、service、dao 都不需要创建 功能强大:动态条件处理,逻辑删除,LDAP,自定义登录逻辑,RedisSession,操作日志等 多数据源:支持:MySQL、Oracle、SQL Server、PostgreSQL、H2,甚至支持MongoDB 高扩展性:支持自定义数据源实现、自定义登录逻辑、动态权限管理、生命周期函数、自定义 OSS 大量组件:滑动输入、时间选择、一对多、图片上传、代码编辑器、自动完成、树、多对多、地图等23类组件 丰富展示:普通文本、二维码、链接、图片、HTML、代码段、iframe、swf等 低侵入性:几乎所有功能都围绕注解而展开,不影响Spring Boot其他功能或三方库库的使用 前后端分离:后端与前端可分开部署 响应式布局:支持PC端手机端等各种规格的设备中使用 自定义页面:支持自定义页面,自定义弹出层,且支持:原生H5 / Freemarker / Thymeleaf等方式渲染 前端零代码:前端布局自动构建,一行前端代码都不用写 无需二次开发:仅需引用 jar 包即可 ! 为什么要放弃代码生成器? 虽然近些年来代码生成器成了后台开发的新宠,但它真的是后台开发的最优解吗? 代码生成器的本质还是生成繁琐的前端与后台代码,一旦修改后期生成的代码很难合并,想想 Mybatis-Generator,基本上就是一次性的东西,虽然减轻了部分工作,可解决方式并非最佳。 开发后台管理系统大部分情况下只想做个普通的增删改查界面,用于数据管理,类似下面这种: PS: erupt支持定义复杂的页面自定义,详见erupt-tpl模块 @Erupt( name = "简单的例子", power = @Power(importable = true, export = true) ) @Table(name = "t_simple") //数据库表名 @Entity public class Simple extends BaseModel { @EruptField( views = @View(title = "文本"), edit = @Edit(title = "文本", notNull = true, search = @Search) ) private String input; @EruptField( views = @View(title = "数值", sortable = true), edit = @Edit(title = "数值", search = @Search) ) private Float number; @EruptField( views = @View(title = "布尔"), edit = @Edit(title = "布尔", search = @Search) ) private Boolean bool; @EruptField( views = @View(title = "时间"), edit = @Edit(title = "时间", search = @Search(vague = true)) ) private Date date; @EruptField( views = @View(title = "滑动条"), edit = @Edit(title = "滑动条", type = EditType.SLIDER, search = @Search, sliderType = @SliderType(max = 90, markPoints = {0, 30, 60, 90}, dots = true)) ) private Integer slide; @EruptField( views = @View(title = "下拉选择"), edit = @Edit( search = @Search, title = "下拉选择", type = EditType.CHOICE, choiceType = @ChoiceType(fetchHandler = SqlChoiceFetchHandler.class, fetchHandlerParams = "select id,name from e_upms_menu" ) ) ) private Long choice; } 这个界面虽然用 Vue + Ant Design + SSM 也能做出个大概,但仔细观察会发现它有大量细节功能如: 有按钮可以查询、新增、批量删除、excel 导入导出 可以对数据做筛选、隐藏某列、按某列排序 表格有分页与汇总,可预览单行数据 多种组件、有校验规则 全部实现这些仅前端就需要大量的代码,后端的接口与业务逻辑更不在少数。 但可以看到,用 erupt 只需要30几行代码就能完成 ! 完全不需要了解Angular / React / Vue / Jquery 而且不需要了解JavaScript / HTML / CSS 甚至不需要了解Spring MVC / Mybatis / SQL 即便没学过 erupt 也能猜到大部分配置的作用,只需要简单配置就能完成所有后台页面开发。 这正是建立 erupt 的初衷,对于大部分常用页面,应该使用最简单的方法来实现,甚至不需要学习各种框架和工具,专注核心业务。 ⛰ 演示截图 | Screenshot 在线体验 | Demo 演示地址:https://www.erupt.xyz/demo 账号密码:guest / guest 支持主流 4 款现代浏览器,以及 Internet Explorer 11+,可直接运行在 Electron 等基于 Web 标准的环境上 Edge / IE Firefox Chrome Safari Opera Electron Edge 16 / IE 11+ 522 57 11 44 Chromium 57

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册