首页 文章 精选 留言 我的

精选列表

搜索[web应用框架],共10000篇文章
优秀的个人博客,低调大师

GO从入门到进阶教程系列 - 研发高性能ORM框架操作mysql篇

上一篇教程我们了解到了基础的GO语法,今天我们来学习如何使用GO操作mysq,下面就直接进入步骤操作环节 技术版权归属 广州市金狮网络科技有限公司 (https://kingc.cn/) ,如需商用请联系公司 1. 先获取mysql驱动,类似Java加载驱动jar, 通过window cmd命令或者Linux控制台执行 go get github.com/go-sql-driver/mysql 2. 我们先写个数据库连接对象方便扩展 // 数据库配置 type DBConfig struct { Host string // 地址IP Port int // 数据库端口 Database string // 数据库名称 Username string // 账号 Password string // 密码 } 3. 通过数据库配置进行mysql实例化 func NewMysql() (*sql.DB, error) { // 初始化mysql连接参数 conf := DBConfig{ Host: "127.0.0.1", Port: 3306, Database: "test", Username: "root", Password: "123456", } // 定义占位符字符串,使用配置值替换%s和%d link := fmt.Sprintf("%s:%s@tcp(%s:%d)/%s?charset=utf8", conf.Username, conf.Password, conf.Host, conf.Port, conf.Database) // 打开mysql获得实例对象 db, err := sql.Open("mysql", link) // 打开mysql失败,返回nil对象,以及返回err对象 if err != nil { panic(util.AddStr("mysql初始化失败: ", err.Error())) return nil, errors.New("mysql初始化失败: " + err.Error()) } // 打开mysql成功返回db对象,err=nil return db, nil } 4. 获得mysql操作实例后,进行增删查改操作(由于时间关系,暂时只写了新增示例,包含事务和非事务) func CRUD(db *sql.DB) error { // 编写需要执行的sql createSql := "insert test_user(username, password, age, sex) values(?,?,?,?)" // 预编译sql stmt, err := db.Prepare(createSql) if err != nil { panic("预编译失败: " + err.Error()) } // 提交编译sql对应参数 ret, err := stmt.Exec("zhangsan", "123456", 18, 1) if err != nil { panic("提交数据失败: " + err.Error()) } // 保存成功后获取自增ID fmt.Println(ret.LastInsertId()) return nil } func CRUD1(db *sql.DB) error { // 编写需要执行的sql createSql := "insert test_user(username, password, age, sex) values(?,?,?,?)" // 预编译sql,事务模式 tx, err := db.Begin() if err != nil { panic("开启事务失败: " + err.Error()) } stmt, err := tx.Prepare(createSql) if err != nil { tx.Rollback() // 回滚事务 panic("预编译失败: " + err.Error()) } // 提交编译sql对应参数 ret, err := stmt.Exec("zhangsan", "123456", 18, 1) if err != nil { tx.Rollback() // 回滚事务 panic("提交数据失败: " + err.Error()) } // 保存成功后获取自增ID fmt.Println(ret.LastInsertId()) tx.Commit() // 提交事务 return nil } 5. 最后执行测试用例test func TestMysql1(t *testing.T) { db, err := NewMysql() if err != nil { panic(err) } CRUD(db) } func TestMysql2(t *testing.T) { db, err := NewMysql() if err != nil { panic(err) } CRUD1(db) } 上面的几个示例基本涵盖GO操作mysql的用法,下一篇文章我会讲解如何封装可扩展性强的mysql底层,敬请期待!


优秀的个人博客,低调大师

go微服务框架go-micro深度学习(五) stream 调用过程详解

上一篇写了一下rpc调用过程的实现方式,简单来说就是服务端把实现了接口的结构体对象进行反射,抽取方法,签名,保存,客户端调用的时候go-micro封请求数据,服务端接收到请求时,找到需要调用调用的对象和对应的方法,利用反射进行调用,返回数据。 但是没有说stream的实现方式,感觉单独写一篇帖子来说这个更好一些。上一篇帖子是基础,理解了上一篇,stream实现原理一点即破。先说一下使用方式,再说原理。当前go-micro对 rpc 调用的方式大概如下:普通的rpc调用 是这样: 1.连接服务器或者从缓存池得到连接 2.客户端 ->发送数据 -> 服务端接收 3.服务端 ->返回数据 -> 客户端处理数据 4.关闭连接或者把连接返回到缓存池 当前 rps stream的实现方式 是这样子: 1. 连接服务器 2. 客户端多次发送请求-> 服务端接收 3. 服务端多次返回数据-> 客户端处理数据 4. 关闭连接 当数据量比较大的时候我们可以用stream方式分批次传输数据。对于客户端还是服务端没有限制,我们可以根据自己的需要使用stream方式,使用方式也非常的简单,在定义接口的时候在参数或者返回值前面加上stream然后就可以多次进行传输了,使用的代码还是之前写的例子,代码都在github上: 比如我的例子中定义了两个使用stream的接口,一个只在返回值使用stream,另一个是在参数和返回值前都加上了stream,最终的使用方式没有区别 rpc Stream(model.SRequest) returns (stream model.SResponse) {} rpc BidirectionalStream(stream model.SRequest) returns (stream model.SResponse) {} 看一下go-micro为我们生成的代码rpcapi.micro.go里,不要被吓到,生成了很多代码,但是没啥理解不了的Server端 // Server API for Say service type SayHandler interface { // .... others Stream(context.Context, *model.SRequest, Say_StreamStream) error BidirectionalStream(context.Context, Say_BidirectionalStreamStream) error } type Say_StreamStream interface { SendMsg(interface{}) error RecvMsg(interface{}) error Close() error Send(*model.SResponse) error } type Say_BidirectionalStreamStream interface { SendMsg(interface{}) error RecvMsg(interface{}) error Close() error Send(*model.SResponse) error Recv() (*model.SRequest, error) } // .... others Client端 // Client API for Say service type SayService interface { //... others Stream(ctx context.Context, in *model.SRequest, opts ...client.CallOption) (Say_StreamService, error) BidirectionalStream(ctx context.Context, opts ...client.CallOption) (Say_BidirectionalStreamService, error) } type Say_StreamService interface { SendMsg(interface{}) error RecvMsg(interface{}) error Close() error Recv() (*model.SResponse, error) } type Say_BidirectionalStreamService interface { SendMsg(interface{}) error RecvMsg(interface{}) error Close() error Send(*model.SRequest) error Recv() (*model.SResponse, error) } 你会发现参数前面加了 Stream后,生成的代码会把你的参数变成一个接口,这个接口主要要的方法是 SendMsg(interface{}) error RecvMsg(interface{}) error Close() error 剩下的两个接口方法是根据你是发送还是接收生成的,如果有发送就会有Send(你的参数),如果有接收会生成Rev() (你的参数, error),但这两个方法只是为了让你使用时方便,里面调用的还是SendMsg(interface)和RecvMsg(interface)方法,但是他们是怎么工作的,如何多次发送和接收传输的数据,是不是感觉很神奇。 我就以TsBidirectionalStream 方法为例开始分析,上一篇和再早之前的帖子已经说了服务端启动的时候都做了哪些操作,这里就不再赘述,服务端的实现,很简单,不断的获取客户端发过来的数据,再给客户端一次一次的返回一些数据。 /* 模拟数据 */ func (s *Say) BidirectionalStream(ctx context.Context, stream rpcapi.Say_BidirectionalStreamStream) error { for { req, err := stream.Recv() if err == io.EOF { break } if err != nil { return err } for i := int64(0); i < req.Count; i++ { if err := stream.Send(&model.SResponse{Value: []string {lib.RandomStr(lib.Random(3, 6))}}); err != nil { return err } } } return nil } 启动服务,服务开始监听客户端传过来的数据.....客户端调用服务端方法: // 调用 func TsBidirectionalStream(client rpcapi.SayService) { rspStream, err := client.BidirectionalStream(context.Background()) if err != nil { panic(err) } // send go func() { rspStream.Send(&model.SRequest{Count: 2}) rspStream.Send(&model.SRequest{Count: 5}) // close the stream if err := rspStream.Close(); err != nil { fmt.Println("stream close err:", err) } }() // recv idx := 1 for { rsp, err := rspStream.Recv() if err == io.EOF { break } else if err != nil { panic(err) } fmt.Printf("test stream get idx %d data %v\n", idx, rsp) idx++ } fmt.Println("Read Value End") } 当客户端在调用rpc的stream方法是要很得到stream rspStream, err := client.BidirectionalStream(context.Background()) // func (c *sayService) BidirectionalStream(ctx context.Context, opts ...client.CallOption) (Say_BidirectionalStreamService, error) { req := c.c.NewRequest(c.name, "Say.BidirectionalStream", &model.SRequest{}) stream, err := c.c.Stream(ctx, req, opts...) if err != nil { return nil, err } return &sayServiceBidirectionalStream{stream}, nil } 这个调用c.c.Stream(ctx, req, opts...)是关键,他的内部实现就是和服务器进行连接,然后返回一个stream,进行操作。 客户端:和服务端建立连接,返回Stream,进行接收和发送数据 服务端:接收客户端连接请求,利用反射找到相应的方法,组织Strem,传给方法,进行数据的发送和接收 建立连接的时候就是一次rpc调用,服务端接受连接,然后客户端发送一次调用,但是传输的是空数据,服务端利用反射找到具体的方法,组织stream,调用具体方法,利用这个连接,客户端和服务端进行多次通信。

优秀的个人博客,低调大师

业界 | 英伟达新利剑:发布RTX20系列新显卡,图灵框架铺垫

英伟达在2018科隆国际游戏展宣布,新款高端显卡GeForce RTX 2070,RTX 2080和RTX 2080 Ti正式问世。 这些RTX20系列显卡会接替英伟达目前的顶级GPU,包括GeForce GTX 1070,GTX 1080和GTX 1080 Ti。虽然英伟达通常会发布更强大的Ti版GPU,但这一次,它同时发布了RTX 2080和RTX 2080 Ti两款GPU。 点击观看宣传视频 当然,价格绝对不会便宜。英伟达CEO黄仁勋在演讲中也提到,这几款不同的显卡价格不同。黄仁勋说,RTX 2070的起售价为499美元,RTX 2080的起售价为699美元,RTX 2080 Ti的起售价为999美元。当被问到为何如此定价时,英伟达的一位代表说道,这些价格反映了第三方制造商的零售价。 英伟达还为这三款显卡提供了Founders Ed

优秀的个人博客,低调大师

python+pytest单元测试框架之在Jenkins上生成Allure测试报告

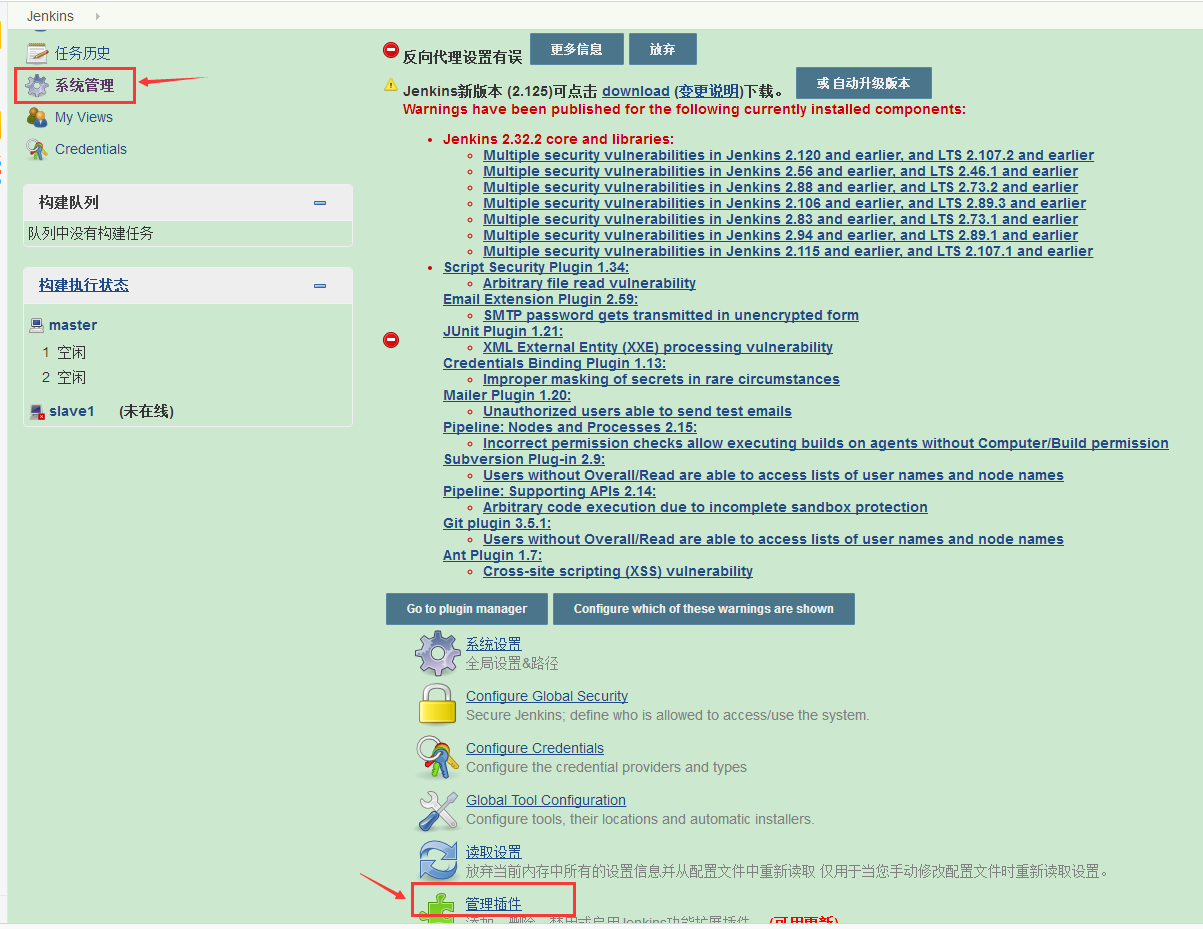
上篇我们通过Allure插件生成了测试report,并通过打开浏览器的方式查看图形化测试report,那要集成都Jenkins中去,并以邮件的方式发送测试report要怎么做呢?请看以下操作 一、搭建环境 1.jenkins环境搭建见《手把手教你搭建Jenkins+Jmeter+Ant自动化集成环境》中的Jenkins部分,这里不做介绍 二、在jenkins中配置插件 1.分别安装插件 Allure Jenkins Plugin 、HTML Publisher plugin a.在Jenkins的页面中点击“系统管理”->"管理插件",搜索“allure”,在搜索结果页,选择“Allure Jenkins Plugin”进行安装。安装完成之后重启一下Jenkins。 Jenkins界面 进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"Allure",按回车键,然后勾选Allure,点击直接安装 安装Allure插件 b.进入插件管理界面,选择“可选插件”->在右上角过滤编辑框中写入"HTML",按回车键,然后勾选HTML Publisher,点击直接安装 安装HTML Publisher 安装过程 安装完成 重启Jenkins 重启后可在“插件管理”界面查看到已安装成功的插件和插件版本 查看安装好的插件1 查看安装好的插件2 2.添加allure执行工具 下载allure压缩文件allure-commandline.zip,解压并添加allure路径至path环境变量 配置path 3.在Jenkins的主界面中找到并进入“(Global Tool Configuration)全局工具管理”页面 Global Tool Configuration管理界面 找到Allure Commandline安装 字样,点击新增Allure Commandline 安装Allure Commandline 点击后,在弹出下面的页面,输入Allure的命令别名和版本(这里我选择最新版本号)后,点击Apply 和Save 保存Allure配置 三、配置Job 1.在Jenkins主界面点击新建,进入如下界面,建立 jenkins 持续集成项目, 这里选择自由风格的项目,按照步骤执行操作后点击OK 输入项目名称 2.点击OK后进入Allure Report界面,如下图所示 进入项目配置界面 3.在Allure Report界面,分别配置“构建”和“构建后操作” a.配置构建步骤:进入Allure Report界面,找到“构建”下方的“增加构建步骤”,下来选择Excute Windows batch command 配置构建步 b.输入如下配置步骤指令: D: cd \work\pytest py.test -s -q --alluredir ${WORKSPACE}/report 配置指令 查看输出的log信息 原因:jenkins执行命令,会把命令生成一个批处理文件执行,而pytest命令对于批处理来说是外部命令,所以要加call表示调用。而jenkins执行windows命令,若退出代码不为0 ,则jenkins会将构建标记为失败,所以需要加上exit 0表示执行完成退出 解决方法:构建命令在py.test前面加上call,最后加上exit 0 重构指令 运行结果打印信息 c.在构建后操作下拉一栏选择“Allure Report”,进入“Allure Report”界面,写入保存报告的路径名称“report”,在“Properties”一栏分别写入Key和Value对应的变量值和存放测试用例文件的路径,如下图所示: 配置report路径 这里需要注意一点就是:执行指令生成测试报告的路径名称和保存测试报告的路径名称必须一致,不然会提示错误。如下图设置 设置测试报告名称 四、查看运行结果 在Jenkins界面点击“立即构建”,会在左下角出现进度条显示,当进度条显示完成后,刷新下当前界面,可以在页面右侧看到运行结果,点击界面的“Allure Report”字样,可查看该测试用例运行的详细情况 运行用例 运行结果1 运行结果2 运行结果3 运行结果4

优秀的个人博客,低调大师

探索分布式服务框架Dubbo9:Dubbo整体架构与实现原理

Dubbo剖析-整体架构分析 一、前言 工欲善其事,必先利其器,前面通过几篇文章简单的介绍了如何使用Dubbo搭建一个简单的分布式系统,在接下来的的一段时间就来研究Dubbo原理设计,本文作为原理设计的开篇先整体介绍下dubbo的架构。 二、整体架构 image.png dubbo官方的这个图很复杂,但是一开始没有必要深入细节,下面我们简单讲解主要模块。 其中Service 和 Config 层为 API,对应服务提供方来说是使用ServiceConfig来代表一个要发布的服务配置对象,对应服务消费方来说ReferenceConfig代表了一个要消费的服务的配置对象。可以直接初始化配置类,也可以通过 spring 解析配置生成配置类。 其它各层均为 SPI,SPI意味着下面各层都是组件化可以被替换的,这也是dubbo比较好的一点,主要功能组件都可以插件化替换。dubbo增强了JDK中的SPI功能,在dubbo中其它各层都是使用扩展点进行提供服务的,dubbo增强的SPI增加了对扩展点 IoC 和 AOP 的支持,一个扩展点可以直接 setter 注入其它扩展点;并且不会一次性实例化扩展点的所有实现类,这避免了有扩展实现初始化很耗时,但如果没用上也加载,会很浪费资源的情况,增强的SPI是在具体用某一个实现类时候才进行实例化。后续会具体讲解增强的SPI的实现原理。 proxy 服务代理层:扩展接口为 ProxyFactory,dubbo实现的SPI主要JavassistProxyFactory(默认使用)和JdkProxyFactory,用来对服务提供方和服务消费方的服务进行代理。 registry 注册中心层:封装服务地址的注册与发现,扩展接口为 Registry , RegistryService,Dubbo提供的扩展接口实现为ZookeeperRegistry,RedisRegistry,MulticastRegistry,DubboRegistry。 扩展接口RegistryFactory,dubbo提供的扩展接口实现DubboRegistryFactory,DubboRegistryFactory,RedisRegistryFactory,ZookeeperRegistryFactory。 cluster 路由层:封装多个提供者的路由及负载均衡,并桥接注册中心, 扩展接口为 Cluster , Directory , Router ,LoadBalance。 monitor 监控层:RPC 调用次数和调用时间监控,扩展接口为 MonitorFactory , Monitor , MonitorService。 protocol 远程调用层:封将 RPC 调用,扩展接口为 Protocol , Invoker , Exporter。 exchange 信息交换层:封装请求响应模式,同步转异步,扩展接口为 Exchanger , ExchangeChannel ,ExchangeClient , ExchangeServer transport 网络传输层:抽象 mina 和 netty 为统一接口扩展接口为 Channel , Transporter , Client , Server , Codec serialize 数据序列化层:可复用的一些工具,扩展接口为 Serialization , ObjectInput , ObjectOutput , ThreadPool 关于dubbo扩展点一个简单的例子: 以扩展 Dubbo 的协议为例,在协议的实现 jar 包内放置文本文件: METAINF/dubbo/com.alibaba.dubbo.rpc.Protocol ,内容为: myprotocol=com.alibaba.user.MyProtocol MyProtocol内容如下: package com.alibaba.user; import com.alibaba.dubbo.rpc.Protocol; public class MyProtocol implemenets Protocol { // ... } 配置模块中的配置 Dubbo 配置模块中,扩展点均有对应配置属性或标签,通过配置指定使用哪个扩展 实现。比如: <dubbo:protocol name="myprotocol" /> 三、远程调用细节 3.1 服务提供者暴露一个服务的详细过程 image.png 首先 ServiceConfig 类拿到对外提供服务的实际类 ref(如:UserServiceImpl),然后通过 ProxyFactory 类的 getInvoker 方法使用 ref 生成一个 AbstractProxyInvoker 实例,到这一步就完成具体服务到 Invoker 的转化。 接下来就是 Invoker 转换到 Exporter 的过程。Dubbo 处理服务暴露的关键就在 Invoker 转换到 Exporter 的过程,上图中的红色部分。 Dubbo 协议的 Invoker 转为 Exporter 发生在 DubboProtocol 类的 export 方法,它主要是打开创建一个Netty Server 侦听服务,并接收客户端发来的各种请求,通讯细节由 Dubbo 自己实现,然后注册服务到服务注册中心。 3.2 服务消费者消费一个服务的详细过程 image.png 首先 ReferenceConfig 类的 init 方法调用 Protocol 的 refer 方法生 成 Invoker 实例(如上图中的红色部分),这是服务消费的关键。接下来把 Invoker 转换为客户端需要的接口(如:UserServiceBo)。 dubbo协议的invoker转换为客户端需要的接口是发生在DubboProtocol的refer方法,他主要是创建一个netty client 链接服务提供者,通讯细节由 Dubbo 自己实现。 四、总结 本文简单的介绍了dubbo整体架构,后续具体介绍,dubbo增强的spi的实现,服务提供方如何发布服务,比如何时如何创建netty Server来监听服务消费者的链接,何时如何注册服务到服务治理中心;dubbo的filter链如何构建;服务消费方如何消费服务,何时创建netty client…. 微信公众号【Java技术江湖】一位阿里 Java 工程师的技术小站。(关注公众号后回复”Java“即可领取 Java基础、进阶、项目和架构师等免费学习资料,更有数据库、分布式、微服务等热门技术学习视频,内容丰富,兼顾原理和实践,另外也将赠送作者原创的Java学习指南、Java程序员面试指南等干货资源) ​

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册