船用柴油机智能故障诊断:基于深度同心孪生网络的难例样本挖掘方法
本文针对发表于期刊《Measurement》(2024年)的论文《DCSN: Focusing on hard samples mining in small-sample fault diagnosis of marine engine》进行技术解读。在船用柴油机的状态监测与故障诊断任务中,设备绝大多数时间运行于正常状态,采集到的故障样本极其匮乏,且不同故障模式之间往往存在机理耦合与特征混叠,容易出现类间差异小、类内分散度大的“难例样本”(Hard samples)。针对小样本及难例干扰问题,该研究提出了一种深度同心孪生网络(Deep Concentric Siamese Network, DCSN),从样本配对机制、残差特征提取主干、同心损失函数(Concentric Loss)以及自适应边界收缩四个维度构建了度量学习诊断框架。 --- ## 1. 总体架构与基本建模思路 DCSN 的核心构思是将多分类问题转化为样本对之间的二分类度量学习问题,并通过几何边界约束使模型将优化重点聚焦于难例样本。系统的总体工作流程主要由三部分构成:**样本配对模块**、**特征学习模块**与**优化目标模块**。 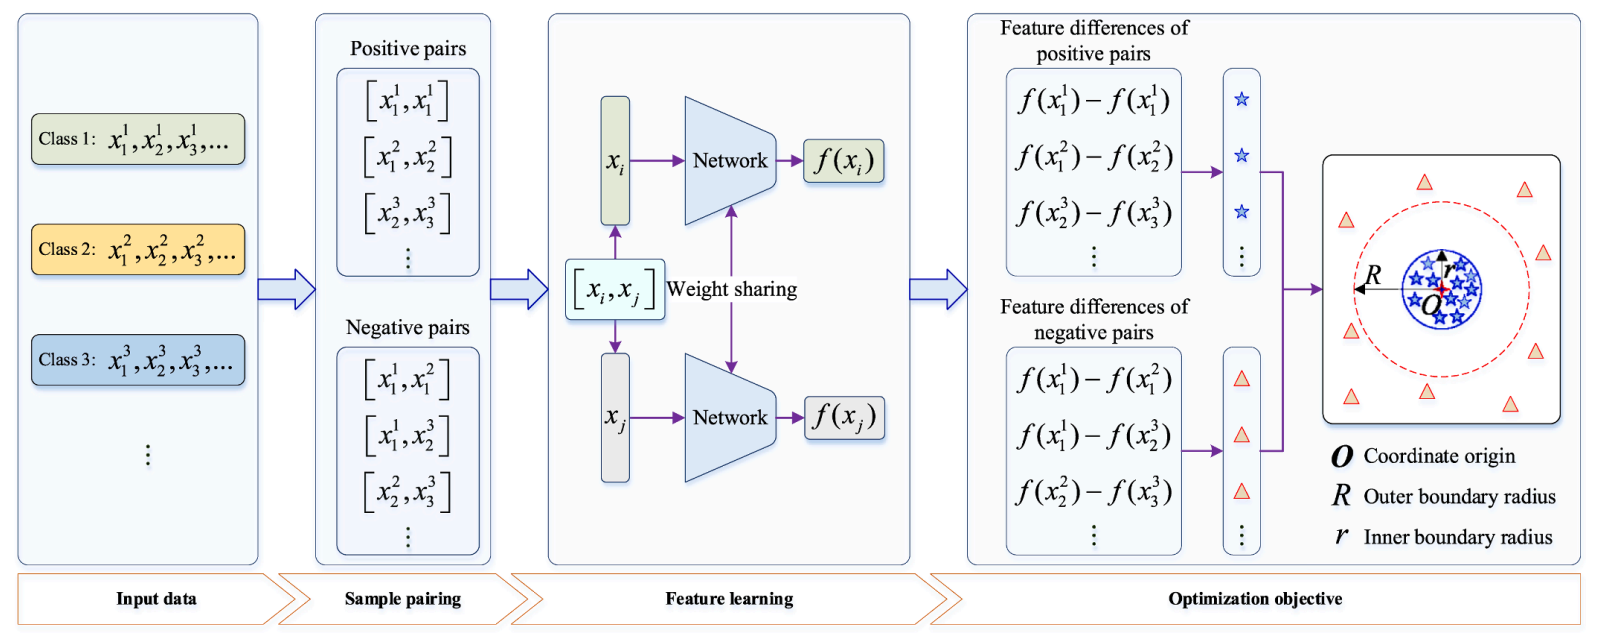 *(论文Fig.3: DCSN总体架构)* 1. **样本配对模块**:将相同类别或不同类别的样本组合成样本对 $[x_i, x_j]$,输入至孪生网络。 2. **特征学习模块**:通过共享权重的双分支深度残差网络(DRN),将样本映射至度量特征空间,输出对应的低维特征向量 $f(x_i)$ 与 $f(x_j)$。 3. **优化目标模块**:计算样本对的特征差分向量 $V_d = f(x_i) - f(x_j)$,以其到度量坐标原点 $O$ 的欧氏距离作为差异度量 $M_d$。利用同心边界区分简单样本与难例样本,实施差异化梯度更新。 --- ## 2. 类别均衡样本配对策略 在小样本工况下,正常状态样本(H类)数量通常远多于各类故障状态样本(F1–F7类)。直接进行全样本两两组合会导致正样本对与负样本对比例极度失衡,进而引发模型偏向多数类的表征偏差。  *(论文Table 1: 交叉组合样本配对形式)* 为此,算法采用受控的交叉组合配对机制(如上表所示): - **故障样本间配对**:将训练集中所有故障样本进行两两组合 $[x_i, x_j]$(满足索引 $i \le j$)。若 $x_i$ 与 $x_j$ 同属一类,赋予正样本标签 $Y = 0$;若分属不同类别,则赋予负样本标签 $Y = 1$。 - **正常样本间配对**:对训练集中的正常样本按同等规则两两组合,形成标签为 $Y = 0$ 的正样本对。 - **均衡化下采样配对**:统计当前已生成的正样本对数量 $K$ 与负样本对数量 $N$。随机抽取特定数量的正常样本与各类故障样本配对生成负样本对,使正、负样本对的总数完全相等($K = N$)。 该策略在成倍扩充训练样本规模、避免特征空间过拟合的同时,消除了由于源数据类别不平衡导致的先验偏置。 --- ## 3. 基于残差结构的孪生特征提取网络 DCSN 采用双分支权重共享的深度残差网络(Deep Residual Network, DRN)作为特征映射主干,其分支结构细节如下图所示:  *(论文Fig.4: 孪生网络分支拓扑结构)* 网络输入为一维特征向量(如经气缸压力曲线与飞轮振动信号提取的时域、频域及相位特征)。每个网络分支由若干残差块单元(Residual Block Unit, RBU)串联构成。单个RBU的数学表达为: $$X_{l+1} = X_l + \mathcal{F}(X_l)$$ 其中 $X_l$ 和 $X_{l+1}$ 分别为第 $l$ 个 RBU 的输入与输出,$\mathcal{F}(\cdot)$ 表示残差映射。每个 RBU 包含两层卷积(Conv)、两层批归一化(Batch Normalization, BN)和修正线性单元(ReLU),排列顺序遵循 BN-ReLU-Conv-BN-ReLU-Conv,并通过恒等快捷连接(Identity shortcut)将输入跨层相加。 双分支网络的参数矩阵 $W$ 完全共享,输入样本经一系列RBU提取深层特征后,通过全局平均池化层(GAP)与全连接层(FC),最终映射为低维特征向量 $f(x_i)$ 与 $f(x_j)$。 --- ## 4. 同心损失函数与自适应边界收缩机制 ### 4.1 同心损失(Concentric Loss)原理 为量化样本对间的差异,定义差分向量 $V_d$ 及其度量距离 $M_d$: $$V_d = f(x_i) - f(x_j)$$ $$M_d = \|V_d - O\|_2$$ 其中 $O$ 为度量空间的坐标原点。 在理想的度量空间中,同类样本对($Y=0$)的 $M_d$ 应趋近于 0,异类样本对($Y=1$)的 $M_d$ 应远离原点。然而在难例干扰下,部分同类对距离过远,部分异类对距离过近。为此,设计内外同心圆边界(内边界半径为 $r$,外边界半径为 $R$),同心损失函数 $L_C$ 定义为: $$L_C(W, (x_i, x_j, Y), O) = (1 - Y) \cdot \{\max(0, M_d - r)\}^2 + Y \cdot \{\max(0, R - M_d)\}^2$$  *(论文Fig.2: 同心损失在度量空间中的拉压作用机制)* ### 4.2 梯度属性与难例加权 该损失函数对网络参数 $W$ 的梯度特性如下: - **对于正样本对($Y = 0$)**: $$\frac{\partial L_C}{\partial W} = \begin{cases} 0, & M_d \le r \\ 2(M_d - r) \cdot \frac{\partial M_d}{\partial W}, & M_d > r \end{cases}$$ 当同类样本对位于内边界以内($M_d \le r$)时,判定为已正确分类的简单正样本,损失与梯度均为 0;若落在内边界之外($M_d > r$),则判定为难例正样本对,模型产生非零梯度,施加向原点收缩的拉力。 - **对于负样本对($Y = 1$)**: $$\frac{\partial L_C}{\partial W} = \begin{cases} 0, & M_d \ge R \\ 2(M_d - R) \cdot \frac{\partial M_d}{\partial W}, & M_d < R \end{cases}$$ 当异类样本对位于外边界之外($M_d \ge R$)时,判定为简单负样本,梯度为0;若侵入外边界之内($M_d < R$),则判定为难例负样本对,模型施加背离原点向外推斥的强推力。 对包含 $K$ 个正样本对与 $N$ 个负样本对的批次数据,总体目标函数为两者损失的均值求和: $$L_{\text{total}} = \frac{1}{K} \sum_{i=1}^K L_C(W, (x_i, x_j, 0), O) + \frac{1}{N} \sum_{i=K+1}^{K+N} L_C(W, (x_i, x_j, 1), O)$$ 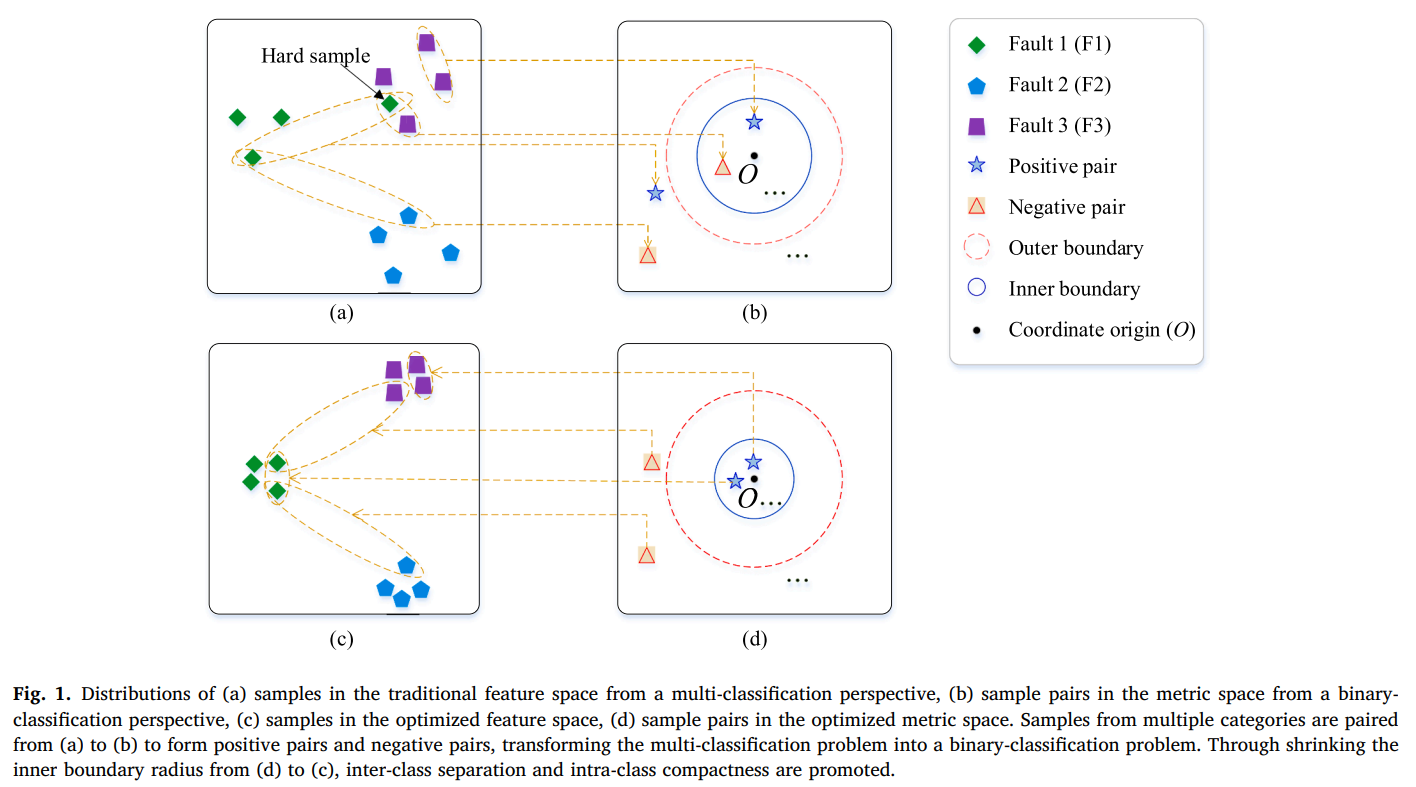 *(论文Fig.1: 样本对由多分类向二分类转换及收缩内边界的分布演化示意)* ### 4.3 内边界自适应收缩机制 固定外边界半径 $R$ 为常数,若内边界半径 $r$ 保持不变,类内紧凑度的提升将受到限制。算法通过迭代动态缩小内边界半径: 1. 在迭代步 $t$,计算所有样本对的差异度量并降序排列: $$\text{Differ} = \{M_d^{t,1}, M_d^{t,2}, \dots, M_d^{t,K+N}\}$$ 2. 取出第 $K$ 小的度量值,记为 $M_d^{t,K}$。 3. 判定更新条件:若 $M_d^{t,K} < r^t$,则更新内边界半径 $r^{t+1} = M_d^{t,K}$;否则保持 $r^{t+1} = r^t$。 通过在训练过程中动态衰减 $r$,强制正样本对逐步压缩至更狭窄的超球体内,从而扩大了间距区间 $(R - r)$,促进类内紧凑性与类间可分性。整个前向-反向优化过程如下示意图所示:  *(论文Fig.6: 算法1训练过程示意图)* --- ## 5. 小样本推理诊断流程 在测试阶段,DCSN采用少样本测试策略(Few-shot testing)进行类别判决,以避免单样本测试(One-shot testing)因单个参考样本偏离分布中心而引发的偶然误判。  *(论文Fig.5: 单样本测试与少样本测试对比)* 诊断流程(见下图)具体步骤如下: 1. **测试配对**:将待测未知样本与训练集中各已知类别随机抽取的 $n$ 个参考样本(文中取 $n=5$)分别组合。 2. **前向度量**:输入经训练收敛的孪生网络,提取特征并计算各样本对的度量距离 $M_d$。 3. **最小差分判决**:计算待测样本与各参考样本之间的差异测度,依据最小差异原则判定归属,即: $$\hat{Y} = \arg\min_c \left( \min_{j \in \text{Class } c} M_d(x_{\text{test}}, x_j^c) \right)$$ 待测样本被判定为产生最小度量差别的已知参考样本所在类别。  *(论文Fig.7: 基于DCSN的小样本故障诊断完整流程)* --- ## 6. 技术总结 DCSN方法针对船用柴油机小样本故障诊断中存在的难例与类别不平衡问题,建立了相对严密的度量优化逻辑: - 在数据组织层,通过受控交叉配对平衡正负对比例,解决小样本及类别失衡下的特征学习偏置; - 在特征提取层,借助残差结构的恒等映射特性保证深层度量表征的稳定性; - 在损失监督层,利用双同心球边界切断简单样本的梯度贡献,使反向传播梯度完全由跨越边界的难例样本对主导; - 在边界控制层,以统计分位数自适应驱动内球边界单调收缩,在度量空间内显式拉伸类间隔离间距。 --- ## 参考文献 DCSN: Focusing on hard samples mining in small-sample fault diagnosis of marine engine[J]. Measurement, 2024, 235: 114929. https://www.sciencedirect.com/science/article/abs/pii/S0263224124008145