首页 文章 精选 留言 我的

精选列表

搜索[独立开发者],共10000篇文章
优秀的个人博客,低调大师

开发者笔记:Windows下搭建简易单机Redis集群测试环境

本文背景 由于业务需要,有些时候我们需要使用Redis缓存,我相信还是有很大一部分小伙伴和我一样,开发环境是在WIndows下(虽然实际生产环境可能是在Linux),有时候我们需要模拟一些环境,比如今天要介绍的Redis环境,这里我们采用集群的方式,由于资源有限,我们可以采用单机搭建集群的方式进行模拟,在开发环境下是已经足够的! Redis版本 笔者采用的是Windows下的5.0.9的64位版本 https://github.com/tporadowski/redis/releases 开始 首先你得到上面Github页面下载最新版本的Redis版本,解压到某个文件夹下,笔者目录结构如下: 每一个文件夹除了配置不一样以外,其它的都一样。 接下来我们就来说配置: 1、分别打开各个文件下的 redis.windows.conf,修改以下的所有配置(每个文件夹下都要修改) port6380//修改为与当前文件夹名字一样的端口号 appendonlyyes//指定是否在每次更新操作后进行日志记录,Redis在默认情况下是异步的把数据写入磁盘,如果不开启,可能会在断电时导致一段时间内的数据丢失。yes表示:存储方式,aof,将写操作记录保存到日志中 cluster-enabledyes//开启集群模式 cluster-config-filenodes-6380.conf//保存节点配置,自动创建,自动更新(建议命名时加上端口号) cluster-node-timeout15000//集群超时时间,节点超过这个时间没反应就断定是宕机 2、在每个文件夹下面新建一个批处理文件start.bat,用于快捷启动 titleredis-6380;# redis-server.exeredis.windows.conf 注意:在修改配置文件这几项配置时,配置项前面不能有空格 以上操作都完成后,可以尝试启动每一个节点测试一下是否能启动成功 编写启动集群的批处理,我们可以在其中一个文件夹下新建一个批处理,内容如下 redis-cli--clustercreate--cluster-replicas1192.168.3.12:6375192.168.3.12:6376192.168.3.12:6377192.168.3.12:6378192.168.3.12:6379192.168.3.12:6380 pause 如果你设置了密码,那么命令可以修改如下,pwd是你设置的密码,在redis配置文件中设置密码 redis-cli-apwd--clustercreate--cluster-replicas1192.168.3.12:6375192.168.3.12:6376192.168.3.12:6377192.168.3.12:6378192.168.3.12:6379192.168.3.12:6380 pause 启动 打开刚才新建的每一个文件下下的启动批处理,我们分别启动,在启动成功后我们在打开启动集群的批处理,笔者为了方便将每一个启动都放在了外面,方面测试,也就是上面看到的文件夹中的内容,其实要想更方便也可以直接在文件夹外编写一个统一的批处理!如下 这个时候我们就可以测试一下是否搭建成功了,笔者刚好有一个可视化界面( AnotherRedisDesktopManager),就用它吧! 随便选择两个节点连接,看图 以下是结果 总结 总体来说搭建没什么难度,毕竟只是测试环境,也不需要考虑太多,如果小伙伴们有此需求又懒得折腾,我会将整个环境上传,包括我使用的可视化管理界面!不妨点个关注,感谢!

优秀的个人博客,低调大师

使用Chrome开发者工具研究JavaScript里函数的原生实现

As the size of my blog Chrome Development Tool tips used in my daily work turns to be larger I create a separate post to record down this small tip.Are you curious about the “native code” here? At least I am. Today I find that the Profiles tab in Chrome development tool can help us to unveil the mysteries to some degree.In Chrome development, just select this checkbox: And then execute the simple JavaScript code below: var arr = []; for (var i=0; i<1000; i++){ arr.push(i) } console.profile("Array toString"); for( var i = 0; i < 1000; i++){ var a = arr.toString(); } console.profileEnd("Array toString"); Once done, you can see a profile record with the name specified in JavaScript code above, “Array toString”. Hover the mouse to the first row, “anonymous function”, we find the hint “array.js”. Switch display style from Chart to Tree: From here the callstack of native implementation of toString is displayed: The next step is to look into in array.js.Launch url: https://cs.chromium.org/Click this hyperlink: now you can find the array.js file via path: src/v8/src/js/array.js The callstack analyzed through the source code exactly matches the one we get in Chrome development tool Profile tab:ArrayToString will delegate to Join if current caller is an Array: Join will call DoJoin: DoJoin will first call UseSparseVariant to evaluate the possibility to perform Join via SparseVariant. If not possible, call ConvertToString as fall back. ( The line number of source code may vary with the one you see in Chrome Development Tool profile tab due to the different version of Chrome being used. ) If you could not tolerate the poor performance of this online source code repository, you could download the whole source code of V8 to your local laptop by cloning this github repository:https://chromium.googlesource.com/v8/v8.git/ 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

使用Chrome开发者工具研究JavaScript的垃圾回收机制

I use the following simple JavaScript code to illustrate: var JerryTestArray = []; (function(){ for( var i = 0; i < 100; i++){ JerryTestArray[i] = document.createElement("div"); } })(); Create a new empty tab in your Chrome, and first create a snapshot with empty heap status by click “Take Snapshot” button: The Snapshot1 is generated. Now switch to tab Console, paste the JavaScript code and execute it in console. And switch to Profiles tab again to make the second snapshot: Once done, select the second snapshot, choose “Comparison” and “Snapshot1” as filter: We can find out from column “New” that 100 div nodes are created as we expect. Since these nodes are not appended to document node so they are invisible to end user, so displayed as “Detached DOM”. The JerryTestArray still holds the reference to each div node so Garbage collector will not touch these nodes. In order to make Garbage collector recycle the memory occupied by these nodes, just assign another value to JerryTestArray in console: Once done, make the third snapshot and compare it with the second. Now we can find that the re-assignment to JerryTestArray will trigger the destruction of those 100 div nodes by Garbage collector: Meanwhile, the string we use in assignment could also be inspected via the combination of filters below: There is another kind of profile in Chrome development tool which can give you an overview about timeline of memory allocation: Click Start button in above screenshot, and paste the following code in console and executed: var JerryTestArray = []; (function(){ for( var i = 0; i < 98; i++){ JerryTestArray[i] = document.createElement("span"); JerryTestArray[i].className = "JerryClassName" + i; } })(); After the code is executed, paste the following code and execute: JerryTestArray[30] = "this is a long test............................end"; Now stop the profile. The profile is displayed as below. The highlighted vertical blue line indicates the timeslot when the 97 Span elements are created. Note that the number of Span elements displayed here is not 98 but 97 since Chrome development tool displays the final status of objects after “stop profile” button is clicked ( the reference to 30th Span element is replaced by String, so it is recycled by GC ). You can drag the two vertical bars to define the time range between which you would like to inspect. For example the time range below contains the timeslot when the below assignment occurs: JerryTestArray[30] = "this is a long test............................end"; With this gained knowledge now we can check the memory allocation and destruction in some real application. For example click tile “My Tasks” to enter this application, make the first snapshot and click back button within application to return to launchpad, and make the second snapshot and review the comparison result. From the result we find out lots of stuff are deleted after we return to launchpad: Hover your mouse to a given destructed object and you can review its detail: For more tips How I use Chrome development tool in my daily work, please refer to this blog Chrome Development Tool tips used in my daily work 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

【开发者成长】一文详解JS垃圾回收机制

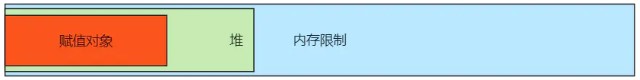
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! V8的内存限制 我们先抑后扬,Node不同于其他后端语言,Node在对系统的内存使用中,只能使用到系统的部分内存,比如64位系统只能使用1.4GB,32位系统只能使用0.7GB。随之到来的问题是Node采用单线程,就导致每个线程无法对大的内存对象进行处理,比如将一个2GB的文件读入内存进行字符串分析处理,即使你有16G的物理内存。 V8的对象分配 在javascript中我们的基本类型存储在栈中,所有对象都分配给了堆处理。我们每赋值一个对象,该对象的内存就会分配在堆中。如果已申请堆所剩内存不足以分配新的对象,将会继续申请新内存,直到堆的大小超过V8的内存大小限制为止。 至于V8的内存限制,起源于V8本身是chrome为浏览器设计而生,而浏览器中对于网页来说,V8控制的内存绰绰有余。还源于V8设计者对于V8的垃圾回收机制的限制,官方以1.5GB的垃圾回收堆内存为例,V8执行一个小的垃圾回收要使用50毫秒以上,做一次常规非增量式垃圾回收要在1秒以上。 最关键的,javascript的垃圾回收会对javascript执行线程形成阻塞,作为一个开发人员你应该能够清楚时长1秒的进程阻塞,对你的项目性能的影响,故此V8的设计者采用了对堆内存进行限制的策略。 V8的内存分代 V8的垃圾回收策略主要基于分代,那么怎么分代呢? 在V8中,主要将内存分为新生代和老生代两类。新生代指的是那些存活时间较短的对象,老生代指的是存活时间较长的或者常驻内存的对象。而新生代加老生代的对象所占空间大小就是V8的堆的整体大小。 补充知识点:V8提供了设置新生代和老生代最大内存值的方式,从而可以调整V8的整体内存限制,使用更多的内存空间。 V8的主要垃圾回收算法 **Scanvenge算法**Scanvenge是一种复制形式的垃圾回收算法,是应用于新生代对象中的一种垃圾回收算法,算法首先将堆内存一分为二,两部分空间一半用来分配赋值的对象,叫做From空间,另一半处于空闲的叫做To空间。 为什么要有一半空间用来闲置呢?这不是让我们的可用内存更小了吗? 当我们为堆分配对象时,会将分配对象放到From空间中存储,在V8的垃圾和回收过程中,会首先检查From中存活的对象(什么是存活的对象,就是指那些还被继续引用没有完全释放的对象),V8会将From中存活的对象夫妇复制到To空间中,同时清理掉已经被释放的对象空间。完成该过程From空间和To空间即完成了角色对换,也就是在下一次回收中,之前的From空间变成了To空间,之前的To空间变成了From空间。 这样我们来重新定义一下: 用来存放对象的一半是From空间,处于闲置状态的一半是To空间。 Scanvenge算法明显的缺点就是只能使用堆内存的一半,但是随之带来的好处就是它在时间效率上的优异的表现,属于典型的牺牲空间换取时间的算法。 需要强调的是,开头提到的Scanvenge算法是应用于新生代对象中的一种垃圾回收算法,因为新生代对象中的生命周期较短的特性,也契合于该算法优先时间考虑的特性。 怎样算生命周期较长的对象? 当一个对象经过多次复制依然存活时,它将会被认为是生命周期较长的对象。这种生命周期较长的对象随后会被移动到老生代对象中,采用新的算法(Mark-Sweep&Mark-Compact)进行管理,这个过程称为晋升。 通过上图可以了解到,对象进行垃圾回收是怎样从From到To之间转换的,那么这个晋升的过程在哪儿体现呢? 在默认情况下,V8对新生代对象进行从From到To空间进行复制时,会先检查它的内存地址来判断这个对象是否已经经历过一次Scanvenge回收。如果已经经历过,那么会将该对象从From空间直接复制到老生代空间,如果没有,才会将其复制到To空间。 以上,我们讲述的就是一个新生代对象如何晋升为老生代对象的第一个条件“对象是否经历过Scanvenge回收”,那么第二个条件也许你会更困惑,超出限制?多少算在限制?怎么超出? 假设一个对象像刚才说的没有经历过Scanvenge回收,要将它复制到To空间之前,还要再进行一次检查。检查To空间是否已经使用了超过25%,如果To空间超过25%,该对象将直接被晋升到老生代空间进行管理。 完整看一下这个流程: 对象晋升后,该对象即成为老生代中的存活周期较长的对象,所以我们可以重新对老生代进行定义:老生代对象为存活周期较长或常驻内存的对象,或为新生代对象回收中溢出的对象。 至于为什么设置25%的原因是,当一次Scanvenge回收完成时,To空间变为From空间,如果新的From空间使用占比过高,将对接下来的内存分配到这个新的From空间过程存在很大的影响。 Mark-Sweep&Mark-Compact算法 接下来,讲一下老生代中的对象使用的回收算法,这种算法(Mark-Sweep)也是我们常说的垃圾回收中的标记清除算法。 首先,老生代空间不会一分为二,老生代空间进行垃圾回收时,首先是标记阶段。V8会在标记阶段遍历老生代空间中的所有对象,并标记存活的对象(即还没有被完全释放的对象),在随后的清除阶段,会将所有未标记的老生代对象全部回收。 再来张图: 如果你稍微有点强迫症,你就发现这张图有点问题。Mark-Sweep在执行完清除之后,导致内存空间出现不连续的情况,就像你的磁盘分析图一样。 这样会带来的一个问题就是,当你需要分配一个较大的对象时,剩余的内存因为碎片化的原因,没有任何一个内存碎片足以分配给这个大的对象内存空间,就会导致提前触发垃圾回收,而这次回收是不必要的。 所以Mark-Compact算法随之而生,Mark-Compact比Mark-Sweep增加了一个整理的概念,它的回收执行顺序是标记—整理—清除。Mark-Compact所谓的整理概念是指在对象同样被标记为存活后,会将活着的对象往一端移动,移动完成后在直接清理掉死亡的对象内存。 不要晕,来张图,你就可以的: 两种差别显而易见,Mark-Compact算法执行后的内存空间更合理。但是因为Mark-Compact算法需要移动对象,随之导致的就是它的执行速度没有Mark-Sweep快。 所以在V8中主要使用Mark-Sweep算法,只有在空间不足以对新生代中晋升过来的对象进行分配时,才会使用Mark-Compact算法进行回收。 Incremental Marking算法 因为垃圾回收会阻塞javascript的运行,故此老生代对象又因为其占用空间大,存活对象多的特点,对其进行标记,整理,回收的过程引起的阻塞要远远比新生代对象回收过程一起的阻塞要严重的多,Incremental Marking算法成为了优化老生代对象耗时的算法选择。 为了降低老生代空间垃圾回收带来的停顿影响,V8 采用了增量标记(incremental marking)的算法。将原本一口气停顿完成的来及回收过程拆分为许多小“步进”,每做完一“步进”就让JavaScript应用逻辑继续执行一小会儿,垃圾回收与应用逻辑交替执行直到标记阶段完成。取得的效果就是,将老生代空间垃圾回收的最大停顿时间可以减少到原本的1/6左右。 有点晕,不要怕,咱有图: V8 后续还引入了延迟清理(lazy sweeping)、增量式整理(incremental compaction)、并发标记 等技术,其实看名字你也能理解大概,可以自行查阅。 扩展知识 相信上面的东西已经让你们明白,V8的垃圾回收机制是如何运行的。但是你还需要知道我们的代码中是如何触发、影响垃圾回收的,这就不得不掏出老生常谈的作用域和闭包。 作用域 在javascript中作用域有全局作用域和局部作用域,在这里,我们着重关注作用域对垃圾回收的影响。假设一个函数调用产生的作用域: 这是一个函数表达式,foo()函数在每次调用时会创建一个作用域,同时也会在该作用域创建一个局部变量local。函数执行结束,该作用域也会随之销毁,同时该作用域中声明的局部变量也会随作用域销毁而销毁。在这个实例中,由于局部变量引用的对象存活周期较短,将会分配在新生代空间的From中。作用域销毁后,其中的变量也随之被释放,该对象所占用的空间在下次垃圾回收时将会被清理。 作用域链 在这个实例中,bar()中执行console,在当前函数作用于查找不到local变量,将会继续向上查找,查找上级最近的作用域,如果找到变量local,就会停止查找。如果找不到会一直查找到全局作用域,如果该变量在所有作用域都不存在,将会抛出未定义错误。 变量的主动释放 如果变量是全局变量,需要注意的是全局作用域中的变量不会执行垃圾回收过程,此类对象将会常驻内存(在老生代空间)。如果需要释放该类对象空间,只能通过delete或重新赋值变量为undefind或者null来释放对象的引用。 闭包 什么叫闭包,历史争议问题啊。我们暂可以将能使外部作用域访问内部作用于中的变量的方法叫做闭包。 闭包对垃圾回收带来的影响也随之出现,一旦有变量引用中间函数,这个中间函数将无法被释放,同时也会是该作用域无法释放,自然作用域中的变量也不会被释放并回收,除非不在被引用,该函数才会被逐渐释放。 不得不说全局变量和闭包是项目中不可缺少的角色,但是需对该类变量谨慎使用,防止在你的项目中这种无法轻易被释放的变量所占内存越来越多,结果就是你不想看到的内存泄露。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-03-20本文作者:龙小胖本文来自:“掘金”,了解相关信息可以关注“掘金”

优秀的个人博客,低调大师

为什么说这 5 大趋势,开发者不容错过?

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 作为开发人员,不断更新自己的技能栈是非常重要的。我们不仅要在日常所用技术方面成为专家,还要了解最新的技术。只有这样才能为团队和产品做出最好的决策。了解最新的技术和所需的技能还有一个重要作用,就是让我们不会面临失业的窘境。 本文介绍2020年作为开发人员需要了解的5个技术趋势。 开发语言——Python 和 Rust 如果你想要学习一门新的开发语言,那么 Python 和 Rust 是2个很好的选择。这两门编程语言都非常成熟,而且有固定和大量的用户基础。这两门语言短期内可能不会超越 JavaScript,但在未来的几年内会继续增长,变得更加主流。 Rust 和 C/C++ 类似,用户数较少,但其安全性、易用性、高效性和速度也保证了一定的用户数量。调研发现 Rust 是最受喜爱的开发语言,2020年可能是Rust成为主流开发语言的一年。 另一方面,Python目前已经广受数学科学、AI和脚本语言开发人员的欢迎。过去5年,Python语言的流行性也不断增加。在最近的一项开发语言流行性调研中,Python已经超过Java语言,排名第二的是Rust。因此,选择Python开发语言绝对没错。 区块链——大量缺乏开发人员 在过去几年间,区块链技术和应用不断发展,正在悄悄进入我们的现实生活中。Solidity(Ethereum编程语言)在LinkedIn 2019期望技术技能中排名第一。Twitter称其未来将迁移到去中心化的(区块链)平台。此外,微软、Salesforce这样的大公司也在发布了可应用的区块链产品。 随着复杂和开创性项目的启动,以及市场上出现的真实用例,我们预测区块链项目将会爆发。因此,区块链开发人员会有大量的需求。自由区块链开发人员的平均薪资为165美元~255美元每小时。 SaaS 和 PaaS 持续增长 公司仍不希望托管自己的数据和应用程序带来的麻烦、费用和风险。但在未来几年,数据中心(基础设施即服务,IaaS)、SaaS和PaaS提供商提供的服务会持续增加,预测2020到2022年,每年增长15-20%。 如果你所在的公司使用SaaS或PaaS,那么就是个好机会。Salesforce和Heroku这样的公司会继续为dev团队提供快速和易用的解决方案来快速迭代产品。如果当前你所在的公司还不想外包基础设施、开发运营和服务的想法,那么花点时间来了解当前提供的服务,放弃技术方面的控制,将更多的时间用于业务差异分析上。 混合云和多云环境 与上一个趋势类似,企业未来可能会使用不止一家云服务提供商,而是使用多元环境(AWS, Heroku, Azure等),即使用多个云服务提供商来尽可能多地获利。事实上,Gartner的调研数据表明有81%的企业使用至少两家云服务提供商。其中使用多元环境的原因有: 尽可能减少厂商锁定 性能 监管要求 人力成本 治理 灾难恢复 更容易地数据迁移 考虑到以上原因,如果您当前未使用多元环境,那么未来多元环境将是一个好的选择。此外,如果你了解超过一个云服务提供商的专业知识,就可以在相关领域立住脚。 人工智能 过去几年,人工智能有了快速地发展。在工程领域,既有乐观的进展,也有悲观的进展。乐观的进展包括自动驾驶汽车、识别假新闻、识别仇恨性言论,悲观的进展包括面部识别、深度未知和隐私入侵。Facebook和Google这样的大公司都在使用人工智能技术来帮助其成长,并带来收入。 根据斯坦福大学的报告,AI初创公司的投资、AI人才需求、使用AI技术的全球公司所占比例都在增长,也就是说工作职位也在增长。该报告指出,在过去5年里,AI工作发布的职位数量增加了1倍,占美国总发布的职位数量的近1%。但一些专家认为这些技术会变得越来越贵和中心化,并形成壁垒。但学习人工智能相关技术不管在现在还是将来都是一个双保险。AI入门的一种方法就是学习Python。 开发的趋势是很难预测的,但拓宽知识面是非常重要的。不要让你的技能停滞不前,那就开始学习上面提到的工具和技术吧! 云栖号在线课堂:https://c.tb.cn/F3.Z8gvnK更多系列直播,请关注 云栖号在线课堂 圈子 及时了解课程更新动态! 原文发布时间:2020-03-10本文作者:Michael本文来自:“CSDN公众号”,了解相关信息可以关注“CSDN”

优秀的个人博客,低调大师

开发者必备Mysql数据库的常用命令

前言 关于mysql数据库的一些常用命令操作,经常不用就很容易忘记,今天再次复习做了一些笔记加深印象,如何用命令连接mysqla数据库进行增删改查,以下是操作过程。 一、连接数据库 首先连接数据库一定要下载好环境安装,至于安装方面我就不多说了,操作步骤如下: 第一步:➜ ~ nginx 连接服务器 第二步:➜ ~ mysql.server start //连接数据库 第三步:mysql -h localhost -u root -p 回车 //登陆数据库password:*****登陆密码 (如果没有密码,也可以不用输入 -p 直接就不用输入密码) 第四步:create database txt; //添加数据库 第五步:show databases; //查看数据库通过这条命令我们可以看到刚刚添加的库‘txt’如下: 第六步:use txt; //选择数据库,就可以看到数据库的文件,由于数据库里面暂时没有数据,所以是空的。 第七步:那么我们可以创建表一个表,表的名字为user1: 第八步:show tables; //查看表 第九步:drop database txt;(txt为数据库名字)// 删除数据库 二、创建一张表 1.创建一个简单的数据表 注意: 需要先选中库,才能创建表。 字段最后一行没有逗号。 insert 增加数据 id name age 三列 CREATE TABLE IF NOT EXISTS user1( id int UNSIGNED AUTO\_INCREMENT PRIMARY KEY, name varchar(255) NOT NULL, age tinyint NOT NULL DEFAULT 0 )ENGINE\=MyISAM DEFAULT CHARSET\=utf8; insert into 表名('字段','字段','字段') valuer('值','值','值'); INSERT INTO user (id,name,age) VALUES (1,'lisi',23); 2. 插入信息在需要增加数据的情况下我们也可以插入新的数据: insert into user valuer('4','zhangsan','25'); insert into user valuer (5,zhangsan,25); insert into user valuer (5,'test1',44),(6,'test2',23),(7,'test3',18); 3、update 修改操作 如果不小心输入错了,我们还可以修改操作: update user id='1',name='xiaowang' age='18' 4、查询内容 查询添加的数据: select*from user; 查询不重复的记录: select distinct deptno from user; 5、 删除操作 删除整个表: delete user; 删除单条信息: delete from user where age='18' 三、退出服务器 1. exit 回车退出 2. \q 回车退出 注意: 1.每个 SQL 命令都需要使用分号来结尾。2.可以将一行命令拆分成为多行命令。 3.可以通过 \c 来取消本行命令。4.可以通过 exit 或者 \q 退出。 我们可以通过一些快捷键进行使用 help 将查询结果立起来 : \G 取消当前为完成的操作:\c 退出客户端 \q 显示当前服务器状态:\s e. 显示帮助信息:\h


优秀的个人博客,低调大师

Mozilla 将要求所有扩展开发者启用双因素认证

Mozilla 本周宣布,所有 Firefox 扩展开发人员都必须为其帐户启用双因素身份验证(2FA)。 “从 2020 年初开始,扩展开发人员将需要在 AMO(addons.mozilla.org)上启用 2FA,” Mozilla 扩展社区经理 Caitlin Neiman 在官方博客这样写道。“这是为了防止恶意攻击者控制合法的扩展及其用户。” 发生这种情况时,黑客可以使用开发人员的帐户向 Firefox 用户发送受感染的扩展更新。攻击者还可以使用受感染的扩展来窃取密码、身份验证/会话cookie,监视用户的浏览习惯,或将用户重定向到网络钓鱼页面或恶意软件下载站点等等。这些类型的事件通常称为供应链攻击。发生这种情况时,最终用户无法检测到扩展更新是否是恶意的,尤其是当受感染的更新来自官方 Mozilla AMO——所有 Firefox 用户都认为是安全的来源时。 而双因素身份验证(2FA)通过在登录过程中增加其他步骤来证明用户的真实身份,能够为帐户增加一层安全保护。Mozilla 决定强制扩展开发人员启用 2FA,以此防止可能会发生的供应链攻击。 尽管近年来没有针对 Firefox 扩展的 AMO 帐户被劫持的案例,但有许多 Chrome 扩展程序被劫持的案例。Chrome 扩展程序的开发人员经常受到网络钓鱼电子邮件的攻击,黑客试图通过这些电子邮件来尝试访问其 Chrome 网络应用商店的帐户。 通常,这类攻击主要针对 Chrome 扩展程序开发人员,因为 Chrome 浏览器的市场占有率为 65%-70%。仅占 10% 的 Firefox 对攻击者的吸引力相对较小。但是,Mozilla 足够警惕,采取了先发制人的行为。 Mozilla 告知,用户可以按照support.mozilla.org 中的说明,在新规则生效之前为自己的帐户启用双因素身份验证(2FA)。 消息来源:https://www.zdnet.com/article/mozilla-to-force-all-add-on-devs-to-use-2fa-to-prevent-supply-chain-attacks/

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册