首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

Apache BookKeeper 一致性协议解析

导语 Apache Pulsar 是一个多租户、高性能的服务间消息传输解决方案,支持多租户、低延时、读写分离、跨地域复制(GEO replication)、快速扩容、灵活容错等特性。Pulsar 存储层依托于 BookKeeper 组件,所以本文简单探讨一下 BookKeeper(下文简称 BK) 的一致性协议是如何实现的。 背景 Pulsar相对于 Kafka 根本的区别在于数据一致性协议,这也是为什么 Pulsar 可以做到两副本就能保障高可用、高可靠,在磁盘使用方面更均衡,也不会存在单分区容量上限,同时在扩缩容、故障屏蔽等日常运维方面更加灵活和方便。 一致性协议简介 我们常见的一致性协议,比如 Raft、Kafka、ZAB 等,都是服务端集成协议(协议控制和数据存储绑定),简单来说一致性协议由服务端存储节点来执行。数据流向通常是客户端写数据到 Leader 节点,其他节点再通过推或拉的方式从 Leader 获取数据。 而 BK 的一致性协议控制和存储是分开的,协议控制是在客户端执行,可以称之为外部一致性协议,或者客户端一致性协议。数据流向为客户端向多台存储节点同时写入数据,存储节点之间基本不通信。 由于一致性协议主要是在客户端执行,本文聚焦于 BK 客户端的实现。所以,外部一致性协议需要解决的问题就简化成,给定 N 个 KV 存储(Bookie 高性能、低可靠)和一个分布式协调系统(下文以 ZK 为例, 低性能,高可靠),如何实现高可用、高可靠、低时延的读写服务。这里引入 ZK 集群的原因是 Bookie 节点会动态增减,需要有注册中心能让客户端拉取存活 Bookie 的 IPPort,同时客户端不具备存储能力,协议控制必要的元信息信息也需要存储到外部。在详细了解 BK 一致性协议之前, 我们先简单介绍一下BK 提供的基础能力。 BookKeeper 基本能力 协议作者设计 BK 初衷是提供分布式日志段(Ledger)而不是无界日志(如 Raft、Kafka)。所以 BK 提供是主要能力就是创建删除 Ledger 以及 Ledger 的读写操作。代码片段如下: public interface BookKeeper extends AutoCloseable { CreateBuilder newCreateLedgerOp(); // 创建新 Ledger OpenBuilder newOpenLedgerOp(); // 打开已存在Ledger DeleteBuilder newDeleteLedgerOp(); // 删除 Ledger } public interface ReadHandle extends Handle { CompletableFuture<LedgerEntries> readAsync(long firstEntry, long lastEntry); // 从 ledger 里读数据} public interface WriteHandle extends ReadHandle, ForceableHandle { CompletableFuture<Long> appendAsync(ByteBuf data); // 往ledger 写数据 } 而 MQ 场景需要提供无界数据流,所以 Pulsar 为每一个分区维护一组 Ledger,每个 Ledger 只会写一定量数据(条数 | 大小 | 时间限制),写满就会创建新的 Ledger 来继续写入,只有最新的 Ledger 可以写入,历史的 Ledger 只能读取。再根据用户配置的数据保存策略逐步删除历史 Ledger。Pulsar 内分区 Legder 组成如下: Pulsar 内分区的元数据如下: { "lastLedgerCreatedTimestamp": "2024-06-06T17:03:54.666+08:00", "waitingCursorsCount": 0, "pendingAddEntriesCount": 2, "lastConfirmedEntry": "11946613:185308", "state": "LedgerOpened", "ledgers": [{ "ledgerId": 11945498, "entries": 194480, "size": 420564873, "offloaded": false, "underReplicated": false }, { "ledgerId": 11946057, "entries": 194817, "size": 420583702, "offloaded": false, "underReplicated": false }, { "ledgerId": 11946613, "entries": 0, // 未关闭的ledger,还没有条数 "size": 0, // 未关闭的ledger,还没有大小 "offloaded": false, "underReplicated": false }] } 创建 Ledger BK 以 Ledger 维度对外提供服务,第一步就是创建 Ledger。一致性协议高可用是由数据的多副本存储来实现的,所以创建 Ledger 时需要明确指定该 Ledger 的数据存储在几台 Bookie(E),每条数据写几份(Qw),需要等到多少台 Bookie 确认收到数据后才认为数据写入成功(Qa)。代码片段如下: public interface CreateBuilder extends OpBuilder<WriteHandle> { // E: 接收该 Ledger 数据的节点数 默认值3 CreateBuilder withEnsembleSize(int ensembleSize); /** * Qw: 每条数据需要写几个节点, 默认值2 * 如果 E > Qw, 数据会条带化均匀写入到 Bookie 节点,按照默认配置, * 写入顺序为: 消息0=0,1; 消息1=1,2; 消息3=2,0 */ CreateBuilder withWriteQuorumSize(int writeQuorumSize); // Qa: 需要等待几台节点确认写入成功,默认值2 CreateBuilder withAckQuorumSize(int ackQuorumSize); ps: 配置条带化写入(E > Qw)可以让多个节点分摊该 Ledger 的读写压力,但是由于数据会更分散且不连续,会影响服务端读写优化(顺序写、预读、批读等), 所以生产环境建议配置 E=Qw。而 Qa < Qw 可以让客户端在避免等待慢节点返回从而降低写入时延,但是优化效果有限,同时增加了存储成本,可以配合客户端熔断以及服务端指标来剔除慢节点。简单来说,建议生产环境配置 E=Qw=Qa。 在创建 Ledger 时,客户端会从 ZK 中拉取全部 Bookie,根据 EnsemblePlacementPolicy 放置策略挑选节点,默认策略会随机挑选出 E 个数的节点作为初始存储节点以保证存储节点使用均衡。同时 BK 提供丰富的放置策略满足用户实现跨机房、地区容灾的需求。 现在我们已经有了 Ledger 基本元数据,包含 Ledger 配置信息以及初始的 Bookie 列表,由于 Ledger 需要全局唯一,所以还需要使用 ZK 获取一个全局唯一的ID,最后把全部元数据写入到 ZK 集群即可(创建过程无需与 Bookie 节点交互)。代码如下: BK 中 Ledger 元数据信息如下: LedgerMetadata { formatVersion = 3, ensembleSize = 3, writeQuorumSize = 3, ackQuorumSize = 3, state = CLOSED, length = 461178392, lastEntryId = 203045, digestType = CRC32C, password = base64: , ensembles = { 0 = [127.0 .0 .1: 3181, 127.0 .0 .2: 3181, 127.0 .0 .3: 3181] }, customMetadata = { component = base64: bWFYWdlZC1sZWRnZXI = , pulsar / managed - ledger = base64: cHVibGjL2RlZmF1bHQvcGVyc2lzdGVudC9kd2RfMjEwODQtcGFydGl0aW9uLTA = , application = base64: cHVsc2Fy } } 数据写入 Ledger 已经创建好了,现在可以往里面写数据了。由于 Bookie 是个 KV 存储,数据需要全局唯一的 Key, Ledger Id 已经是全局唯一了,并且只有创建这个 Ledger 的客户端才能往里面写数据,所以数据的 Key 为 LedgerId + EntryId(客户端单调自增即可)。 每次写入都从 E 个Bookie 中顺序挑选出 Qw 个节点(writeSet)并行发送数据。 可以看到客户端并行写入 Bookie 节点,Bookie 间也不需要做数据同步,所以 Pulsar 即使加了一层 Broker 层,但是写入时延还是能做到和 Kafka 基本一致(2RTT)。 正常返回 发送数据后,如果收到 Qa 个数成功响应, 就可以认为这条数据写入成功了。同时这条数据也可以被读取。 LAC(LastAddConfirmed) 由于 EntryId 单调递增,数据按顺序写入,当一个位置的数据成功写入到 Qa 个存储节点后,就意味着该条数据以及之前的所有数据都可以被消费走,这个位置就是可读位置(不考虑事务),由于已写入多副本,也意味着这些数据可以在部分存储节点故障下存活,从而保证读一致性。不同协议中有不同的叫法。在 BK 中,这个位置称为 LAC(LastAddConfirmed),Kafka 中称为 HW(High Watermark**),在 Raft 中称为 Commitindex。 下面代码可以看到,成功写入一条数据后会立即更新可读位置。 LAC 是一致性协议至关重要的信息,正常情况下,LAC 只需要维护在内存中,写入成功后更新。读取时使用 LAC 来限制读取位置即可。如果当前 Ledger 写满了,正常关闭,需要把 LAC 也保存在 ZK 的元数据中。这样重新打开 Ledger 用于读取时,才能加载 LAC 回内存中,用来正确限制读取位置,同时 LAC 值也能标识 Ledger 中存储的数据条数。 而异常情况下,故障会直接导致内存中的 LAC 丢失,这是不可接受的。最简单粗暴的方式是每次更新 LAC 都直接同步到 ZK 中,但显然 ZK 性能无法满足高频率写入,所以 BK 的做法是在每条数据都携带 LAC 信息一起写入到 Bookie 中。 如下图,由于最新的 LAC 需要等下一轮的消息写入才会一起存储到 Bookie,所以 Bookie 中存储的 LAC 与实际的 LAC 相比是存在一定滞后。 上图可看到初始时客户端和 Bookie 中的 LAC 都为-1,在一轮写入后,Bookie 中的 LAC 就会滞后于客户端了,好在这个问题并不会影响到一致性协议的正确性,下文中会提到。 故障处理 因为需要容忍一定数据的节点故障,所以一致性协议复杂的部分都在故障处理逻辑。接下来我们先看写入失败场景。 写入失败 Kafka、Raft 等集成一致性协议,部分存储节点异常处理相对简单,如果是 Leader 节点故障,切换到其他节点进行读写即可。如果是 Follower 节点异常,通常不需要做任何操作,只需要等节点恢复后,从 Leader 节点同步数据补齐差异。由于节点是带存储的,所以可以容忍较长时间的节点故障。而 BK 是在客户端实现的一致性协议,客户端不带存储,没写成功的数据需要缓存在内存里,显然可缓存的数据是非常有限的,同时没有写成功 LAC 是不能推进的,整个写入也就停止了。所以 BK 在写入失败时,最好是方式就是挑选新的 Bookie 节点重新写入,创建 Ledger 时已经指定了初始的 Bookie 列表,后续的 Bookie 列表变更都称为 EnsembleChange。 EnsembleChange 如下图所示,写入失败时会替换新节点重新写入,同时也会把新元数据更新到 ZK。每次 EnsembleChange,Ensembles 中就会新增一个 Fragment,起始位置为当前 LAC+1。 写入存储节点失败简单可以分两种情况,如果还没有收到Qa 个数成功响应前,收到了错误响应(比如超时等),会立即执行 EnsembleChange。如果已经收到了 Qa 个数成功响应(更新 LAC),后续的错误响应只会记录下失败 Bookie 节点,在下一次写入时再触发 EnsembleChange。如果是不可恢复的异常,会直接返回写入失败,不会做 EnsembleChange。 EnsembleChange 和初始创建 Ledger 一样,需要先选择新的 Bookie 节点列表,替换掉失败的 Bookie 节点列表,然后把替换后的元数据更新回 ZK,代码如下: 更新完元数据后,重写数据到新节点,或者根据条件重新触发 EnsembleChange,代码如下: 简而言之,在写入 Bookie 异常时,BK 客户端都会尝试切换 Bookie 节点重写数据。如果遇到无法恢复的状态码,就会直接往外层抛出异常。上层使用方比如 Pulsar 侧接收到这个异常后,会正常关闭当前 Ledger,然后创建新的 Ledger 继续写入。 客户端故障 如果存储 Bookie 节点故障,客户端可以切换其他 Bookie 继续完成写入。接下来我们看看如果正在写入的客户端故障了,应该怎么处理。在 Pulsar 架构里,BK 客户端是 Pulsar Broker 内的一个组件,当 Pulsar Broker 故障后,分区的 Leader 会切换到新 Broker 继续服务。由于 BK 客户端故障时没有来得及正确关闭 Ledger。当前 Ledger 数据是不可读的,因为 LAC 信息已经丢失。所以新 Broker 主要任务就是要恢复 LAC 信息,然后正确关闭 Ledger,这样 Ledger 内数据就可以正确读取。最后再创建新的 Ledger 来恢复写入。由于恢复过程对应分区无法写入,所以要求恢复过程越快越好,不可存在长时间阻塞。 Fence Bookie 在恢复之前,由于老 Broker 有可能是短暂假死(比如长时间 gc、网络隔离等),后续可能还会持续向当前 Ledger 写入数据导致脑裂。所以恢复的第一步就是要通知对应 Bookie 节点,后续禁止往这个 ledger 里面写任何数据,这个过程称为 Fence。过程相对简单,就是向所有 Essemble 中的 Bookie 节点发送请求让其禁止该 Ledger 的后续写入。如下图所示: 由于当前 Bookie 节点不能保证全部存活,同时需要满足快速恢复,所以需要考虑客户端至少收到多少个成功响应,才能认为 Fence 操作执行成功。这里可以反过来想一下,客户端每次需要写入 Qw 个节点,然后收到 Qa 个成功响应就能认为写入成功,我们只需要让其凑不足 Qa 个成功响应就好了,也就是我们 Fence 掉的节点数只要大于 Qw - Qa,那写入客户端就一定凑不足 Qa 个成功响应,我们暂且称这个数量为 Qf。例子如下: Qw = 5, Qa = 3 ==> Qf = 5 - 3 + 1 = 3 Qw = 3, Qa = 2 ==> Qf = 3 - 2 + 1 = 2 Qw = 3, Qa = 3 ==> Qf = 3 - 3 + 1 = 1 // Qw=Qa 场景需要fence的节点数最少,恢复最快 由于每次写入都要从 E 个 Bookie 中挑选出 Qw 个节点来条带化写入,所以还需要保证任意一组 Qw,我们都 Fence 掉了对应的 Qf 个节点。例子如下: 假设 E=3,Qw=Qa=2, Bookies列表为0,1,2, Qf=2-2+1=1 由于会条带化写入,每次写入挑选两台节点,全部组合为: 0,1 // 0,1节点至少要成功fence 掉一台 1,2 // 1,2节点至少要成功fence 掉一台 2,0 // 2,0节点至少要成功fence 掉一台 易得 0,1,2 三台节点节点至少要成功fence 掉两台, 同理可证如果按上文中推荐配置 E=Qw=Qa, 任何情况下都只需要fence掉任意1台节点即可,fence 节点数量最少,恢复最快。 实际 BK 中实现的代码逻辑是统计任意 writeSet 未成功响应数大于等于 Qa 都认为未成功(功能一致),代码如下: 恢复 LAC 恢复主要的任务就是恢复 LAC 信息,上文中已经介绍 LAC 信息位于每条数据中存储在 Bookie 里面。接下来看看恢复整个过程。 修改元数据状态 第一步: 把 Ledger 状态改成 Recovery 状态。 读取初始 LAC 第二步: 读取 Bookie 中的 LAC,下图代码中可以看到 Fence Bookie 操作其实与查询最后 LAC 为同一个请求,只是携带了 Fence 标识。 取最大的 Bookie LAC 值返回。 初始 LAC = max(zkLac, bookieLac)作为初始 LAC。 恢复真实 LAC 由于 Bookie 中存储的 LAC 有滞后性,也就是真实 LAC(故障前内存中的LAC)往往大于目前从 Bookie 查询到的 LAC 最大值。所以我们还需要恢复真实的 LAC,在找到真实的 LAC之前,我们先确定一个基本的原则。最终恢复的 LAC 可以大于真实 LAC,但是绝对不能小于真实 LAC(会导致数据丢失)。比如一条数据已经成功写入到 Qa 个节点中,但是客户端还没来得及接受到 Qa 个成功响应(不更新 LAC)就故障了,那么恢复时把这条数据 EntryID 更新到 LAC 也是合理的。换句话说,当数据成功写入到了 Qa 节点中的那一刻,真实 LAC 就应该立即更新,只不过客户端内存中的 LAC 也存在一定的滞后(需等收到响应)。所以恢复过程可以以当前读取到的 LAC 作为起始 LAC, 依次往后面查询下一条数据(LAC + 1),如果这条数据已经存在到 Qa 个节点中,那这条数据就是可恢复的,向前推进 LAC 并查询下一条数据。直到某条数据存在的节点数少于 Qa , 就可以认定这条数据是不可恢复的。那当前的 LAC 就是真实的 LAC, 恢复过程结束。以上方案判断某条数据是否可恢复是根据收到的存在响应大于等于 Qa,所以对于每条数据都需要查询全部节点。BK 客户端实际上使用另一种更加快速的方式来判断数据是否可恢复。数据是否可恢复判断方式如下: 串行发送读请求 如果收到存在响应,认定数据可恢复,推进 LAC, 继续恢复下一条数据。 其余响应依次读取下一个 Bookie 存储节点 如果已经有 Qf (Fence 章节中定义)个节点明确返回不存在该数据,表明该数据不可能存在于 Qa 个节点上,后续的数据也不用查询了,恢复结束,当前 LAC 为最终需要恢复的 LAC。 下面使用伪代码描述如果判断单条数据是否可恢复。 int notFoundCount = 0; for(Bookie bookie : writeSet) { result = bookie.query(lac + 1); switch( result) { case : "found" return "数据可恢复"; // 可恢复,推进LAC 读取下一条数据 case : "not found" if( ++ notFoundCount >= Qf) { // 终止恢复,当前 LAC 作为最终 LAC return "数据无法恢复"; }; break; case : "unkonwn" // 连接不上、超时等 } } throw Exception("多节点未知,终止恢复") // 无法恢复,等待重试 举例如下: Qw=3, Qa = 2, Qf = 3 - 2 + 1 = 2 向bookie0, bookie1, bookie2 同时发出读取请求 1. 收到 bookie0 或 bookie1 或 bookie2 存在响应,可恢复 2. bookie0 否定回答,bookie1 否定回答, bookie2 未知回答,不可恢复 3. bookie0 否定回答,bookie1 未知回答, bookie2 未知回答,恢复失败,需要重试 需要特别注意,由于 LAC 非常重要,如果最终恢复的 LAC 小于实际 LAC,就会发生日志截断,相当于这段数据就丢失了。所以我们恢复过程中,需要明确收到 Qf 个Bookie 节点返回数据不存在,而未知返回(节点暂时不可用,超时等)不能等同于数据不存在。 以上方案为了快速恢复,只需要任意一台节点返回数据存在,就认为可恢复,从而推进 LAC。假设这条数据实际上存在份数不足 Qa,就不能容忍后续对应的存储节点故障了。所以会把这条数据覆盖写入全部的存储节点(写成功后自然 LAC 会更新),写入失败(未收到 Qa 个成功)会导致恢复失败。Bookie 是 KV 存储,支持幂等覆盖写。 代码如下: 开始执行恢复 LAC。 发起读请求。 返回失败后,向下一个节点发送读请求,如果收到 Qf 个不存在响应,恢复终止。 读取成功(包含失败重试其他节点): 回写这条数据回 Bookie(LAC自然推进), 触发下一条数据恢复 读取失败(Qf 个节点明确返回数据不存在): 当前 LAC 就为需要恢复的真正 LAC,恢复成功。 消费 消费逻辑相对简单,当前 Ledger 在写入时,只有当前写入的客户端可以读取数据,使用内存中的 LAC 防止读取越线。其他客户端只能读取已关闭的 Ledger,首先从 ZK 中获取元数据(包含 LAC),然后正常向对应 Bookie 发起请求即可。失败后尝试下一个 Bookie 节点,直到成功或者所有节点都尝试过。恢复 LAC 的读取过程和正常读取数据使用同一套逻辑,且相对简单,这里就不做代码分析。 可以看到 BK 客户端读取消息是按单条消息来读取的,会造成请求数较多。高版本 BK 已经做了一定优化,客户端提供了批读能力,可以和服务端一次交互就读到多条消息。这里有个前提条件,就是数据不能条带化写入,因为条带化写入会让数据分散到多台节点,单台节点内数据不连续,所以生产环境还是建议配置 E=Qw=Qa 。 结语 本文主要从客户端视角分析 BK 一致性协议设计理念以及实现原理,包含 Leger 创建、数据的写入、读取以及客户端服务端故障恢复等内容。可以看到 BK 的一致性协议还是有一些有趣的地方,并且实实在在的解决了一些问题,也能理解到 Pulsar 的存算分离并不是简单的加一层无状态代理层来实现的。

优秀的个人博客,低调大师

深入解析LLaMA如何改进Transformer的底层结构

本文分享自华为云社区《大语言模型底层架构你了解多少?LLM大底层架构之LLM模型结构介绍》,作者: 码上开花_Lancer 。 大语言模型结构当前绝大多数大语言模型结构都采用了类似GPT 架构,使用基于Transformer 架构构造的仅由解码器组成的网络结构,采用自回归的方式构建语言模型。但是在位置编码、层归一化位置以及激活函数等细节上各有不同。上篇文章 介绍了GPT-3 模型的训练过程,包括模型架构、训练数据组成、训练过程以及评估方法。 由于GPT-3 并没有开放源代码,根据论文直接重现整个训练过程并不容易,因此根据GPT-3 的描述复现的过程,并构造开源了系统OPT(OpenPre-trained Transformer Language Models)。Meta AI 也仿照GPT-3 架构开源了LLaMA 模型,公开评测结果以及利用该模型进行有监督微调后的模型都有非常好的表现。由于自GPT-3 模型之后,OpenAI 就不再开源也没有开源模型,因此并不清楚ChatGPT 和GPT-4 所采用的模型架构。 本篇文章将以LLaMA 模型为例,介绍大语言模型架构在Transformer 原始结构上的改进,并介绍Transformer 模型结构中空间和时间占比最大的注意力机制优化方法。 一、 LLaMA 的模型结构 上篇文章有介绍了LLaMA 所采用的Transformer 结构和细节,与在本篇文章所介绍的Transformer架构不同的地方包括采用了前置层归一化(Pre-normalization)并使用RMSNorm 归一化函数(Normalizing Function)、激活函数更换为SwiGLU,并使用了旋转位置嵌入(RoP),整体Transformer架构与GPT-2 类似,如图1.1所示。 图1.1 GPT-2 模型结构 接下来,将分别介绍RMSNorm 归一化函数、SwiGLU 激活函数和旋转位置嵌入(RoPE)的具体内容和实现。 1.1. RMSNorm 归一化函数 为了使得模型训练过程更加稳定,GPT-2 相较于GPT 就引入了前置层归一化方法,将第一个层归一化移动到多头自注意力层之前,第二个层归一化也移动到了全连接层之前,同时残差连接的位置也调整到了多头自注意力层与全连接层之后。层归一化中也采用了RMSNorm 归一化函数。针对输入向量aRMSNorm 函数计算公式如下: 此外,RMSNorm 还可以引入可学习的缩放因子gi 和偏移参数bi,从而得到 RMSNorm 在HuggingFace Transformer 库中代码实现如下所示: class LlamaRMSNorm(nn.Module): def __init__(self, hidden_size, eps=1e-6): """ LlamaRMSNorm is equivalent to T5LayerNorm """ super().__init__() self.weight = nn.Parameter(torch.ones(hidden_size)) self.variance_epsilon = eps # eps 防止取倒数之后分母为0 def forward(self, hidden_states): input_dtype = hidden_states.dtype variance = hidden_states.to(torch.float32).pow(2).mean(-1, keepdim=True) hidden_states = hidden_states * torch.rsqrt(variance + self.variance_epsilon) # weight 是末尾乘的可训练参数, 即g_i return (self.weight * hidden_states).to(input_dtype) 1.2. SwiGLU 激活函数 SwiGLU[50] 激活函数是Shazeer 在文献中提出,并在PaLM等模中进行了广泛应用,并且取得了不错的效果,相较于ReLU 函数在大部分评测中都有不少提升。在LLaMA 中全连接层使用带有SwiGLU 激活函数的FFN(Position-wise Feed-Forward Network)的计算公式如下: 其中,σ(x) 是Sigmoid 函数。图1.2给出了Swish 激活函数在参数β 不同取值下的形状。可以看到当β 趋近于0 时,Swish 函数趋近于线性函数y = x,当β 趋近于无穷大时,Swish 函数趋近于ReLU 函数,β 取值为1 时,Swish 函数是光滑且非单调。在HuggingFace 的Transformer 库中Swish1 函数使用silu 函数 代替。 图1.2 Swish 激活函数在参数β 不同取值下的形状 1.3. 旋转位置嵌入(RoPE) 在位置编码上,使用旋转位置嵌入(Rotary Positional Embeddings,RoPE)[52] 代替原有的绝对位置编码。RoPE 借助了复数的思想,出发点是通过绝对位置编码的方式实现相对位置编码。其目标是通过下述运算来给q,k 添加绝对位置信息: 经过上述操作后, ˜qm 和˜kn 就带有位置m 和n 的绝对位置信息。 最终可以得到二维情况下用复数表示的RoPE: 根据复数乘法的几何意义,上述变换实际上是对应向量旋转,所以位置向量称为“旋转式位置编码”。还可以使用矩阵形式表示: 根据内积满足线性叠加的性质,任意偶数维的RoPE,都可以表示为二维情形的拼接,即: 由于上述矩阵Rn 具有稀疏性,因此可以使用逐位相乘⊗ 操作进一步加快计算速度。RoPE 在HuggingFace Transformer 库中代码实现如下所示: class LlamaRotaryEmbedding(torch.nn.Module): def __init__(self, dim, max_position_embeddings=2048, base=10000, device=None): super().__init__() inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float().to(device) / dim)) self.register_buffer("inv_freq", inv_freq) # Build here to make `torch.jit.trace` work. self.max_seq_len_cached = max_position_embeddings t = torch.arange(self.max_seq_len_cached, device=self.inv_freq.device, dtype=self.inv_freq.dtype) freqs = torch.einsum("i,j->ij", t, self.inv_freq) # Different from paper, but it uses a different permutation # in order to obtain the same calculation emb = torch.cat((freqs, freqs), dim=-1) dtype = torch.get_default_dtype() self.register_buffer("cos_cached", emb.cos()[None, None, :, :].to(dtype), persistent=False) self.register_buffer("sin_cached", emb.sin()[None, None, :, :].to(dtype), persistent=False) def forward(self, x, seq_len=None): # x: [bs, num_attention_heads, seq_len, head_size] # This `if` block is unlikely to be run after we build sin/cos in `__init__`. # Keep the logic here just in case. if seq_len > self.max_seq_len_cached: self.max_seq_len_cached = seq_len t = torch.arange(self.max_seq_len_cached, device=x.device, dtype=self.inv_freq.dtype) freqs = torch.einsum("i,j->ij", t, self.inv_freq) # Different from paper, but it uses a different permutation # in order to obtain the same calculation emb = torch.cat((freqs, freqs), dim=-1).to(x.device) self.register_buffer("cos_cached", emb.cos()[None, None, :, :].to(x.dtype), persistent=False) self.register_buffer("sin_cached", emb.sin()[None, None, :, :].to(x.dtype), persistent=False) return ( self.cos_cached[:, :, :seq_len, ...].to(dtype=x.dtype), self.sin_cached[:, :, :seq_len, ...].to(dtype=x.dtype), ) def rotate_half(x): """Rotates half the hidden dims of the input.""" x1 = x[..., : x.shape[-1] // 2] x2 = x[..., x.shape[-1] // 2 :] return torch.cat((-x2, x1), dim=-1) def apply_rotary_pos_emb(q, k, cos, sin, position_ids): # The first two dimensions of cos and sin are always 1, so we can `squeeze` them. cos = cos.squeeze(1).squeeze(0) # [seq_len, dim] sin = sin.squeeze(1).squeeze(0) # [seq_len, dim] cos = cos[position_ids].unsqueeze(1) # [bs, 1, seq_len, dim] sin = sin[position_ids].unsqueeze(1) # [bs, 1, seq_len, dim] q_embed = (q * cos) + (rotate_half(q) * sin) k_embed = (k * cos) + (rotate_half(k) * sin) return q_embed, k_embed 1.4. 模型整体框架 基于上述模型和网络结构可以实现解码器层,根据自回归方式利用训练语料进行模型的过程与本文介绍的过程基本一致。不同规模LLaMA 模型所使用的具体超参数如表1.3所示。但是由于大语言模型的参数量非常大,并且需要大量的数据进行训练,因此仅利用单个GPU 很难完成训练,需要依赖分布式模型训练框架(后面文章将详细介绍相关内容)。 表1.3 LLaMA 不同模型规模下的具体超参数细节 HuggingFace Transformer 库中LLaMA 解码器整体实现代码实现如下所示: class LlamaDecoderLayer(nn.Module): def __init__(self, config: LlamaConfig): super().__init__() self.hidden_size = config.hidden_size self.self_attn = LlamaAttention(config=config) self.mlp = LlamaMLP( hidden_size=self.hidden_size, intermediate_size=config.intermediate_size, hidden_act=config.hidden_act, ) self.input_layernorm = LlamaRMSNorm(config.hidden_size, eps=config.rms_norm_eps) self.post_attention_layernorm = LlamaRMSNorm(config.hidden_size, eps=config.rms_norm_eps) def forward( self, hidden_states: torch.Tensor, attention_mask: Optional[torch.Tensor] = None, position_ids: Optional[torch.LongTensor] = None, past_key_value: Optional[Tuple[torch.Tensor]] = None, output_attentions: Optional[bool] = False, use_cache: Optional[bool] = False, ) -> Tuple[torch.FloatTensor, Optional[Tuple[torch.FloatTensor, torch.FloatTensor]]]: residual = hidden_states hidden_states = self.input_layernorm(hidden_states) # Self Attention hidden_states, self_attn_weights, present_key_value = self.self_attn( hidden_states=hidden_states, attention_mask=attention_mask, position_ids=position_ids, past_key_value=past_key_value, output_attentions=output_attentions, use_cache=use_cache, ) hidden_states = residual + hidden_states # Fully Connected residual = hidden_states hidden_states = self.post_attention_layernorm(hidden_states) hidden_states = self.mlp(hidden_states) hidden_states = residual + hidden_states outputs = (hidden_states,) if output_attentions: outputs += (self_attn_weights,) if use_cache: outputs += (present_key_value,) return outputs 二、注意力机制优化 在Transformer 结构中,自注意力机制的时间和存储复杂度与序列的长度呈平方的关系,因此占用了大量的计算设备内存和并消耗大量计算资源。因此,如何优化自注意力机制的时空复杂度、增强计算效率是大语言模型需要面临的重要问题。一些研究从近似注意力出发,旨在减少注意力计算和内存需求,提出了包括稀疏近似、低秩近似等方法。此外,也有一些研究从计算加速设备本身的特性出发,研究如何更好利用硬件特性对Transformer 中注意力层进行高效计算。本文将分别介绍上述两类方法。 2.1. 稀疏注意力机制 通过对一些训练好的Transformer 模型中的注意力矩阵进行分析发现,其中很多通常是稀疏的,因此可以通过限制Query-Key 对的数量来减少计算复杂度。这类方法就称为稀疏注意力(SparseAttention)机制。可以将稀疏化方法进一步分成两类:基于位置信息和基于内容。基于位置的稀疏注意力机制的基本类型如图2.6所示,主要包含如下五种类型: (1)全局注意力(Global Attention):为了增强模型建模长距离依赖关系,可以加入一些全局节点; (2)带状注意力(Band Attention):大部分数据都带有局部性,限制Query 只与相邻的几个节点进行交互; (3)膨胀注意力(Dilated Attention);与CNN 中的Dilated Conv 类似,通过增加空隙以获取更大的感受野; (4)随机注意力(Random Attention):通过随机采样,提升非局部的交互; (5)局部块注意力(Block Local Attention):使用多个不重叠的块(Block)来限制信息交互。 图2.1 五种基于位置的稀疏注意力基本类型 现有的稀疏注意力机制,通常是基于上述五种基本基于位置的稀疏注意力机制的复合模式,图2.2给出了一些典型的稀疏注意力模型。 Star-Transformer[54] 使用带状注意力和全局注意力的组合。具体来说,Star-Transformer 只包括一个全局注意力节点和宽度为3 的带状注意力,其中任意两个非相邻节点通过一个共享的全局注意力连接,而相邻节点则直接相连。 Longformer使用带状注意力和内部全局节点注意力(Internal Global-node Attention)的组合。此外,Longformer 还将上层中的一些带状注意力头部替换为具有扩张窗口的注意力,在增加感受野同时并不增加计算量。Extended Transformer Construction(ETC)利用带状注意力和外部全局节点注意力(External Global-node Attention)的组合。ETC 稀疏注意力还包括一种掩码机制来处理结构化输入,并采用对比预测编码(Contrastive Predictive Coding,CPC)进行预训练。 BigBird使用带状和全局注意力,还使用额外的随机注意力来近似全连接注意力,此外还揭示了稀疏编码器和稀疏解码器的使用可以模拟任何图灵机,这也在一定程度上解释了,为什么稀疏注意力模型可以取得较好的结果原因。 图2.2 基于位置复合稀疏注意力类型 基于内容的稀疏注意力是是根据输入数据来创建稀疏注意力,其中一种很简单的方法是选择和给定查询(Query)有很高相似度的键(Key)。Routing Transformer 采用K-means 聚类方法,针对和一起进行聚类,类中心向量集合为,其中k 是类中心个数。每个Query 只与其处在相同簇(Cluster)下的Key 进行交互。中心向量采用滑动平均的方法进行更新: 其中|μ| 表示在簇μ 中向量的数量。Reformer[60] 则采用局部敏感哈希(Local-Sensitive Hashing,LSH)方法来为每个Query 选择Key-Value 对。其主要思想使用LSH 函数将Query 和Key 进行哈希计算,将它们划分到多个桶内。提升在同一个桶内的Query 和Key 参与交互的概率。假设b 是桶的个数,给定一个大小为[Dk, b/2]随机矩阵R,LSH 函数定义为: 如果hqi = hkj 时,qi 才可以与相应的Key-Value 对进行交互。 2.2. FlashAttention NVIDIA GPU 中的内存(显存)按照它们物理上是在GPU 芯片内部还是板卡RAM 存储芯片上,决定了它们的速度、大小以及访问限制。GPU 显存分为全局内存(Global memory)、本地内存(Local memory)、共享内存(Shared memory,SRAM)、寄存器内存(Register memory)、常量内存(Constant memory)、纹理内存(Texture memory)等六大类。图2.8给出了NVIDIA GPU 内存的整体结构。其中全局内存、本地内存、共享内存和寄存器内存具有读写能力。 全局内存和本地内存使用的高带宽显存(High Bandwidth Memory,HBM)位于板卡RAM 存储芯片上,该部分内存容量很大。全局内存是所有线程都可以访问,而本地内存则只能当前线程访问。NVIDIA H100 中全局内存有80GB 空间,其访问速度虽然可以达到3.35TB/s,但是如果全部线程同时访问全局内存时,其平均带宽仍然很低。共享内存和寄存器位于GPU 芯片上,因此容量很小,并且共享内存只有在同一个GPU 线程块(Thread Block)内的线程才可以共享访问,而寄存器仅限于同一个线程内部才能访问。 NVIDIA H100 中每个GPU 线程块在流式多处理器(Stream Multi-processor,SM)可以使用的共享存储容量仅有228KB,但是其速度非常快,远高于全局内存的访问速度。 图2.2 NVIDIA GPU 的整体内存结构图 在本章第2.2 节中介绍自注意力机制的原理,在GPU 中进行计算时,传统的方法还需要引入:两个中间矩阵S 和P 并存储到全局内存中。具体计算过程如下: 按照上述计算过程,需要首先从全局内存中读取矩阵Q 和K,并将计算好的矩阵S 再写入全局内存,之后再从全局内存中获取矩阵S,计算Softmax 得到矩阵P,再写入全局内容,之后读取矩 阵P 和矩阵V ,计算得到矩阵矩阵O。这样的过程会极大占用显存的带宽。在自注意力机制中,计算速度比内存速度快得多,因此计算效率越来越多地受到全局内存访问的瓶颈。 FlashAttention就是通过利用GPU 硬件中的特殊设计,针对全局内存和共享存储的I/O 速度的不同,尽可能的避免HBM 中读取或写入注意力矩阵。 FlashAttention 目标是尽可能高效地使用SRAM 来加快计算速度,避免从全局内存中读取和写入注意力矩阵。达成该目标需要能做到在不访问整个输入的情况下计算Softmax 函数,并且后向传播中不能存储中间注意力矩阵。 标准Attention 算法中,Softmax 计算按行进行,即在与V 做矩阵乘法之前,需要将Q、K 的各个分块完成一整行的计算。在得到Softmax 的结果后,再与矩阵V 分块做矩阵乘。而在FlashAttention 中,将输入分割成块,并在输入块上进行多次传递,从而以增量方式执行Softmax 计算。 自注意力算法的标准实现将计算过程中的矩阵S、P 写入全局内存中,而这些中间矩阵的大小与输入的序列长度有关且为二次型。因此,FlashAttention 就提出了不使用中间注意力矩阵,通过存储归一化因子来减少全局内存的消耗。 FlashAttention 算法并没有将S、P 整体写入全局内存,而是通过分块写入,存储前向传递的Softmax 归一化因子,在后向传播中快速重新计算片上注意力,这比从全局内容中读取中间注意力矩阵的标准方法更快。由于大幅度减少了全局内存的访问量,即使重新计算导致FLOPs 增加,但其运行速度更快并且使用更少的内存。具体算法如代码2.2所示,其中内循环和外循环所对应的计算可以参考下图。 2.3 FlashAttention 计算流程图 2.3. 多查询注意力 多查询注意力(Multi Query Attention)[62] 是多头注意力的一种变体。其主要区别在于,在多查询注意力中不同的注意力头共享一个键和值的集合,每个头只单独保留了一份查询参数。 因此键和值的矩阵仅有一份,这大幅度减少了显存占用,使其更高效。由于多查询注意力改变了注意力机制的结构,因此模型通常需要从训练开始就支持多查询注意力。文献[63] 的研究结果表明,可以通过对已经训练好的模型进行微调来添加多查询注意力支持,仅需要约5% 的原始训练数据量就可以达到不错的效果。包括Falcon、SantaCoder、StarCoder等在内很多模型都采用了多查询注意力机制。 以LLM Foundry 为例,多查询注意力实现代码如下: 代码2.2: FlashAttention 算法,简单来说我梳理下逻辑: class MultiQueryAttention(nn.Module): """Multi-Query self attention. Using torch or triton attention implemetation enables user to also use additive bias. """ def __init__( self, d_model: int, n_heads: int, device: Optional[str] = None, ): super().__init__() self.d_model = d_model self.n_heads = n_heads self.head_dim = d_model // n_heads self.Wqkv = nn.Linear( # Multi-Query Attention 创建 d_model, d_model + 2 * self.head_dim, # 只创建查询的头向量,所以只有1 个d_model device=device, # 而键和值则共享各自的一个head_dim 的向量 ) self.attn_fn = scaled_multihead_dot_product_attention self.out_proj = nn.Linear( self.d_model, self.d_model, device=device ) self.out_proj._is_residual = True # type: ignore def forward( self, x, ): qkv = self.Wqkv(x) # (1, 512, 960) query, key, value = qkv.split( # query -> (1, 512, 768) [self.d_model, self.head_dim, self.head_dim], # key -> (1, 512, 96) dim=2 # value -> (1, 512, 96) ) context, attn_weights, past_key_value = self.attn_fn( query, key, value, self.n_heads, multiquery=True, ) return self.out_proj(context), attn_weights, past_key_value 与LLM Foundry 中实现的多头自注意力代码相对比,其区别仅在于建立Wqkv 层上: # Multi Head Attention self.Wqkv = nn.Linear( # Multi-Head Attention 的创建方法 self.d_model, 3 * self.d_model, # 查询、键和值3 个矩阵, 所以是3 * d_model device=device ) query, key, value = qkv.chunk( # 每个tensor 都是(1, 512, 768) 3, dim=2 ) # Multi Query Attention self.Wqkv = nn.Linear( # Multi-Query Attention 的创建方法 d_model, d_model + 2 * self.head_dim, # 只创建查询的头向量,所以是1* d_model device=device, # 而键和值不再具备单独的头向量 ) query, key, value = qkv.split( # query -> (1, 512, 768) [self.d_model, self.head_dim, self.head_dim], # key -> (1, 512, 96) dim=2 # value -> (1, 512, 96) ) 本篇文章将以LLaMA 模型为例,从底层详细的介绍了大语言模型架构在Transformer 原始结构上的改进,并介绍Transformer 模型结构中空间和时间占比最大的注意力机制优化方法。看起来确实比较“干”货一点,但是只有从底层更加了解大模型原理,才能更加知道怎么使用。 点击关注,第一时间了解华为云新鲜技术~


优秀的个人博客,低调大师

每日一博 | Promise 规范与原理解析

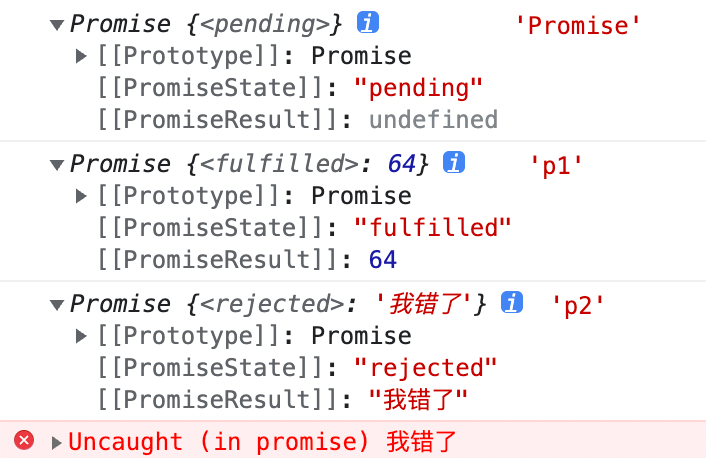
摘要 Promise对象用于清晰的处理异步任务的完成,返回最终的结果值,本次分享主要介绍Promise的基本属性以及Promise内部的基础实现,能够帮我们更明确使用场景、更快速定位问题。 Promise出现的原因 首先我们先来看一段代码:异步请求的层层嵌套 function fn1(params) { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn1Data = {name: 'fn1'} console.log(fn1Data, 'fn1Data'); // 请求2 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn2Data = {name: `${fn1Data.name}-fn2`} console.log(fn2Data, 'fn2Data'); // 请求3 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn3Data = {name: `${fn2Data.name}-fn3`} console.log(fn3Data, 'fn3Data'); } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } fn1() 或者我们可以将上面的代码优化为下面这样 function fn1(params) { console.log(`我是fn1,我在函数${params}中执行!!!`); } function fn2(params) { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log(`我是fn2,我在函数${params}中执行!!!结果是:`,params.data); fn1('fn2') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } catch (error) { console.error(error); } } function fn3() { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('fn3请求已完成'); fn2('fn3') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); console.log('我是f3函数呀'); } catch (error) { console.error(error); } } fn3() 由上面的两种写法的请求可见,在promise之前,为了进行多个异步请求并且依赖上一个异步请求的结果时,我们必须进行层层嵌套,大多数情况下,我们又对异步结果进行数据处理,这样使得我们的代码非常难看,并且难以维护,这就形成了回调地狱,由此Promise开始出现了。 回调地狱缺点 代码臃肿 可读性差 耦合性高 不好进行异常处理 Promise的基本概念 含义 ES6将其写进了语言标准里统一了用法,是一个构造函数,用来生成Promise实例 参数为一个执行器函数(执行器函数是立即执行的),该函数有两个函数作为参数,第一个参数是成功时的回调,第二个参数是失败时的回调 函数的方法有resolve(可以处理成功和失败)、reject(只处理失败)、all等方法 then、catch、finally方法为Promise实例上的方法 状态 pending --- 等待状态 Fulfilled --- 执行状态 (resolve回调函数,then) Rejected --- 拒绝状态 (reject回调函数,catch) 状态一旦改变就不会再变,状态只可能是两种改变,从pending->Fulfilled,pending->Rejected 有两个关键的属性:PromiseState --- 状态改变,PromiseResult --- 结果数据改变 const p1 = Promise.resolve(64) const p2 = Promise.reject('我错了') const p3 = Promise.then() const p4 = Promise.catch() // 状态改变PromiseState 结果改变PromiseResult console.log(new Promise(()=>{}), 'Promise'); // PromiseState='pending' PromiseResult=undefined console.log(p1,'p1'); // PromiseState='Fulfilled' PromiseResult=64 console.log(p2,'p2'); // PromiseState="Rejected" PromiseResult='我错了' console.log(p3, 'p3'); // then为实例上的方法,报错 console.log(p4, 'p4'); // catch为实例上的方法,报错  特点 1. 错误信息清晰定位:可以在外层捕获异常信息(网络错误、语法错误都可以捕获),有“冒泡”性质,会一直向后传递,直到被捕获,所以在最后写一个catch就可以了 2. 链式调用:每一个then和catch都会返回一个新的Promise,把结果传递到下一个then/catch中,因此可以进行链式调用 --- 代码简洁清晰 结果由什么决定 resolve 如果传递的参数是非Promise类型的对象,则返回的结果是成功状态的Promise对象,进入下一个then里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是失败的状态,进入下一个catch里 reject 如果传递的参数是非Promise类型的对象,则返回的结果是拒绝状态的Promise对象,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是拒绝的状态,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 这在我们自己封装的API里面也有体现:为什么code为1时都是then接收,其他都是catch接收,就是因为在then里面也就是resolve函数中对code码进行了判断,如果是1则返回Promise.resolve(),进入then里处理,如果是非1则返回Promise.reject(),进入catch里处理。 流程图  简单使用 // 模拟一个promise的get请求 let count = 0 function customGet(url){ count += 1 return new Promise((resolve, reject)=>{ const xmlHttp = new XMLHttpRequest(); xmlHttp.open("GET",url, true); xmlHttp.onload = ()=>{ console.log(xmlHttp, 'xmlHttp---onload'); if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('customGet请求成功了'); // 返回非Promise,结果为成功状态 resolve({data:`第${count}次请求获取数据成功`}) // 返回Promise,结果由Promise决定 // resolve(Promise.reject('resolve中返回reject')) } else { reject('customGet请求错误了') } } // Promise状态改变就不会再变 // onreadystatechange方法会被执行四次 // 当地次进来的时候,readyState不等于4,执行else逻辑,执行reject,状态变为Rejected,所以即使再执行if,状态之后不会再改变 // xmlHttp.onreadystatechange = function(){ // console.log(xmlHttp,'xmlHttp---onreadystatechange') // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // console.log('customGet请求成功了'); // resolve({data:`第${count}次请求获取数据成功`}) // } else { // reject('customGet请求错误了') // } // } xmlHttp.send(); }) } // 使用Promise,并且进行链式调用 customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=').then((res)=>{ console.log(res.data); return '第一次请求处理后的数据' }).then((data)=>{ console.log(data) // console.log(data.toFixed()); return customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=') }).then((res)=>{ console.log(res.data); }).catch((err)=>{ // 以类似'冒泡'的性质再外层捕获所有的错误 console.error(err, '这是catch里的错误信息'); }) 手写实现简单的Promise 通过上面的回顾,我们已经了解了Promise的关键属性和特点,下面我们一起来实现一个简单的Promise吧 // 1、封装一个Promise构造函数,有一个函数参数 function Promise(executor){ // 7、添加对象属性PromiseState PromiseResult this.PromiseState = 'pending' this.PromiseResult = null // 14、创建一个保存成功失败回调函数的属性 this.callback = null // 8、this指向问题 const that = this // 4、executor有两个函数参数(resolve,reject) function resolve(data){ // 10、Promise状态只能修改一次(同时记得处理reject中的状态) if(that.PromiseState !== 'pending') return // console.log(this, 'this'); // 5、修改对象的状态PromiseState that.PromiseState = 'Fulfilled' // 6、修改对象的结果PromiseResult that.PromiseResult = data // 15、异步执行then里的回调函数 if(that.callback?.onResolve){ that.callback.onResolve(that.PromiseResult) } } function reject(data){ console.log(that.PromiseState, 'that.PromiseState'); if(that.PromiseState !== 'pending') return // 9、处理失败函数状态 that.PromiseState = 'Rejected' that.PromiseResult = data console.log(that.PromiseResult, 'that.PromiseResult'); console.log(that.PromiseState, 'that.PromiseState'); // 16、异步执行then里的回调函数 if(that.callback?.onReject){ that.callback.onReject(that.PromiseResult) } } // 3、执行器函数是同步调用的,并且有两个函数参数 executor(resolve,reject) } // 2、函数的实例上有方法then Promise.prototype.then = function(onResolve,onReject){ // 20、处理onReject没有的情况 if(typeof onReject !== 'function'){ onReject = reason => { throw reason } } // 21、处理onResolve没有的情况 if(typeof onResolve !== 'function'){ onResolve = value => value } // 17、每一个then方法都返回一个新的Promise,并且把上一个then返回的结果传递出去 return new Promise((nextResolve,nextReject)=>{ // 11、处理成功或失败 if(this.PromiseState === 'Fulfilled'){ // 12、将结果传递给函数 // onResolve(this.PromiseResult) // 18、拿到上一次执行完后返回的结果,判断是不是Promise const result = onResolve(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) },(r)=>{ nextReject(r) }) } else { nextResolve(result) } } // 当你一步步写下来的时候有没有怀疑过为什么不用else if(this.PromiseState === 'Rejected'){ // 第12步同时处理此逻辑 // onReject(this.PromiseResult) // 22、处理catch异常穿透捕获错误 try { const result = onReject(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) }).catch((r)=>{ nextReject(r) }) } else { nextReject(result) } } catch (error) { nextReject(this.PromiseResult) } } // 13、异步任务时处理成功或失败,想办法等异步任务执行完成后才去执行这两个函数 if(this.PromiseState === 'pending'){ this.callback = { onResolve, onReject } console.log(this.callback, 'this.callback'); } }) } // 19、函数实例上有方法catch Promise.prototype.catch = function(onReject) { return this.then(null,onReject) } // 使用自定义封装的Promise const customP = new Promise((resolve,reject)=>{ // 模拟异步执行请求 // const xmlHttp = new XMLHttpRequest(); // xmlHttp.open("GET",'https://v0.yiketianqi.com/api/cityall?appid=&appsecret=', true); // xmlHttp.onload = ()=>{ // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // resolve('success') // } else { // reject('error') // } // } // xmlHttp.send(); // 同步执行 resolve('success') // reject('error') }) console.log(customP, 'customP'); customP.then((res)=>{ console.log(res, 'resolve回调'); return '第一次回调' // return new Promise((resolve,reject)=>{ // reject('错错错') // }) },(err)=>{ console.error(err, 'reject回调'); return '2121' }).then(()=>{ console.log('then里面输出'); }).then().catch((err)=>{ console.error(err, 'catch里的错误'); }) 针对resolve中返回Promise对象时的内部执行顺序  总结 以上就是我们常用的Promise基础实现,在实现过程中对比了Promise和函数嵌套处理异步请求的优缺点,Promise仍存在缺点,但是的确方便很多,同时更清晰的理解到错误处理如何进行异常穿透的,也能帮助我们更规范的使用Promise以及快速定位问题所在。 作者:京东物流孙琦 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

限速神器RateLimiter源码解析 | 京东云技术团队

作者:京东科技李玉亮 目录指引 限流场景 软件系统中一般有两种场景会用到限流: •场景一、高并发的用户端场景。 尤其是C端系统,经常面对海量用户请求,如不做限流,遇到瞬间高并发的场景,则可能压垮系统。 •场景二、内部交易处理场景。 如某类交易任务处理时有速率要求,再如上下游调用时下游对上游有速率要求。 •无论哪种场景,都需要对请求处理的速率进行限制,或者单个请求处理的速率相对固定,或者批量请求的处理速率相对固定,见下图: 常用的限流算法有如下几种: •算法一、信号量算法。 维护最大的并发请求数(如连接数),当并发请求数达到阈值时报错或等待,如线程池。 •算法二、漏桶算法。 模拟一个按固定速率漏出的桶,当流入的请求量大于桶的容量时溢出。 •算法三、令牌桶算法。 以固定速率向桶内发放令牌。请求处理时,先从桶里获取令牌,只服务有令牌的请求。 本次要介绍的RateLimiter使用的是令牌桶算法。RateLimiter是google的guava包中的一个轻巧限流组件,它主要有两个java类文件,RateLimiter.java和SmoothRateLimiter.java。两个类文件共有java代码301行、注释420行,注释比java代码还要多,写的非常详细,后面的介绍也有相关内容是翻译自其注释,有些描述英文原版更加准确清晰,有兴趣的也可以结合原版注释进行更详细的了解。 使用介绍 RateLimiter使用时只需引入guava jar便可,最新的版本是31.1-jre, 本文介绍的源码也是此版本。 <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>31.1-jre</version> </dependency> 源码中提供了两个直观的使用示例。 示例一、有一系列任务列表要提交执行,控制提交速率不超过每秒2个。 final RateLimiter rateLimiter = RateLimiter.create(2.0); // 创建一个每秒2个许可的RateLimiter对象. void submitTasks(List<Runnable> tasks, Executor executor) { for (Runnable task : tasks) { rateLimiter.acquire(); // 此处可能有等待 executor.execute(task); } } 示例二、以不超过5kb/s的速率产生数据流。 final RateLimiter rateLimiter = RateLimiter.create(5000.0); // 创建一个每秒5k个许可的RateLimiter对象 void submitPacket(byte[] packet) { rateLimiter.acquire(packet.length); networkService.send(packet); } 可以看出RateLimiter的使用非常简单,只需要构造限速器,调用获取许可方法便可,不需要释放许可. 算法介绍 在介绍之前,先说一下RateLimiter中的几个名词: •许可( permit ): 代表一个令牌,获取到许可的请求才能放行。 •资源利用不足( underunilization ): 许可的发放一般是匀速的,但请求未必是匀速的,有时会有无请求(资源利用不足)的场景,令牌桶会有贮存机制。 •贮存许可( storedPermit ): 令牌桶支持对空闲资源进行许可贮存,许可请求时优先使用贮存许可。 •新鲜许可( freshPermit ): 当贮存许可为空时,采用透支方式,下发新鲜许可,同时设置下次许可生效时间为本次新鲜许可的结束时间。 •如下为一个许可发放示例,矩形代表整个令牌桶,许可产生速度为1个/秒,令牌桶里有一个贮存桶,容量为2。 以上示例中,在T1贮存容量为0,许可请求时直接返回1个新鲜许可,贮存容量随着时间推移,增长至最大值2,在T2时收到3个许可的请求,此时会先从贮存桶中取出2个,然后再产生1个新鲜许可,0.5s后在T3时刻又来了1个许可请求,由于最近的许可0.5s后才会下发,因此先sleep0.5s再下发。 RateLimiter的核心功能是限速,我们首先想到的限速方案是记住最后一次下发令牌许可(permit)时间,下次许可请求时,如果与最后一次下发许可时间的间隔小于1/QPS,则进行sleep至1/QPS,否则直接发放,但该方法不能感知到资源利用不足的场景。一方面,隔了很长一段再来请求许可,则可能系统此时相对空闲,可下发更多的许可以充分利用资源;另一方面,隔了很长一段时间再来请求许可,也可能意味着处理请求的资源变冷(如缓存失效),处理效率会下降。因此在RateLimiter中,增加了资源利用不足(underutilization)的管理,在代码中体现为贮存许可(storedPermits),贮存许可值最开始为0,随着时间的增加,一直增长为最大贮存许可数。许可获取时,首先从贮存许可中获取,然后再根据下次新鲜许可获取时间来进行新鲜许可获取。这里要说的是RateLimiter是记住了下次令牌发放的时间,类似于透支的功能,当前许可获取时立刻返回,同时记录下次获取许可的时间。 代码结构和主体流程 代码结构 整体类图如下: RateLimiter类 RateLimiter类是顶级类,也是唯一暴露给使用者的类,它提供了工厂方法来创建RateLimiter方法。 create(double permitsPerSecond) 方法创建的是突发限速器,create(double permitsPerSecond, Duration warmupPeriod)方法创建的是预热限速器。同时它提供了acquire方法用于获取令牌,提供了tryAcquire方法用于尝试获取令牌。该类的内部实现上,一方面有一个SleepingStopWatch 用于sleep操作,另一方面有一个mutexDoNotUseDirectly变量和mutex()方法进行互斥加锁。 SmoothRateLimiter类 该类继承了RateLimiter类,是一个抽象类,含义为平滑限速器,限制速率是平滑的,maxPermits和storedPermits维护了最大存储许可数量和当前存储许可数量;stableIntervalMicros指规定的稳定许可发放间隔,nextFreeTicketMicros指下一个空闲许可时间。 SmoothBursty类 平滑突发限速器,该类继承了SmoothRateLimiter,它存储许可的发放频率同设置的stableIntervalMicros,有一个成员变量maxBurstSeconds,代表最多存储多长时间的令牌许可。 SmoothWarmingUp类 平滑预热限速器,继承了SmoothRateLimiter,与SmoothBursty平级,它的预热算法需要一定的理解成本。 主体流程 获取许可的主体流程如下: 主体流程主要是对贮存许可数量和新鲜许可数量进行计算和更新,得到当前许可请求的等待时间。SmoothBursty算法和SmoothWarmingUp算法共用这一套主体流程,差异主要是贮存许可的管理策略,两种算法的不同策略在两个子类中各自实现,SmoothBursty算法相对简单一些,下面先介绍该算法,然后再介绍SmoothWarmingUp算法。 SmoothBursty算法 限速器创建 采用的是工厂模式创建,源码如下: public static RateLimiter create(double permitsPerSecond) { // permitsPerSecond指每秒允许的许可数. 该方法调用了下面的方法 return create(permitsPerSecond, SleepingStopwatch.createFromSystemTimer()); } // 创建SmoothBursty(固定贮存1s的贮存许可), 然后设置速率 static RateLimiter create(double permitsPerSecond, SleepingStopwatch stopwatch) { RateLimiter rateLimiter = new SmoothBursty(stopwatch, 1.0 /* maxBurstSeconds */); rateLimiter.setRate(permitsPerSecond); return rateLimiter; } 1、SmoothBursty的构造方法相对简单: SmoothBursty(SleepingStopwatch stopwatch, double maxBurstSeconds) { super(stopwatch); this.maxBurstSeconds = maxBurstSeconds; } 2、rateLimiter.setRate的定义在父类RateLimiter中 public final void setRate(double permitsPerSecond) { checkArgument( permitsPerSecond > 0.0 && !Double.isNaN(permitsPerSecond), "rate must be positive"); synchronized (mutex()) { doSetRate(permitsPerSecond, stopwatch.readMicros()); } } 该方法使用synchronized(mutex())方法对互斥锁进行同步,以保证多线程调用的安全,然后调用子类的doSetRate方法。 第二个参数nowMicros传的值是调用了stopwatch的方法,将限速器创建的时间定义为0,然后计算了当前时间和创建时间的时间差,因此采用的是相对时间。 2.1 mutex方法的实现如下: // Can't be initialized in the constructor because mocks don't call the constructor. // 从上行注释可看出,这是因为mock才用了懒加载, 实际上即时加载代码更简洁 @CheckForNull private volatile Object mutexDoNotUseDirectly; // 双重检查锁的懒加载模式 private Object mutex() { Object mutex = mutexDoNotUseDirectly; if (mutex == null) { synchronized (this) { mutex = mutexDoNotUseDirectly; if (mutex == null) { mutexDoNotUseDirectly = mutex = new Object(); } } } return mutex; } 该方法使用了双重检查锁来对锁对象mutexDoNotUseDirectly进行懒加载,另外该方法通过mutex临时变量来解决了双重检查锁失效的问题。 2.2 doSetRate方法的主体实现在SmoothRateLimiter类中: final void doSetRate(double permitsPerSecond, long nowMicros) { // 同步贮存许可和时间 resync(nowMicros); double stableIntervalMicros = SECONDS.toMicros(1L) / permitsPerSecond; this.stableIntervalMicros = stableIntervalMicros; doSetRate(permitsPerSecond, stableIntervalMicros); } 该方法在限速器创建时会调用,创建后调用限速器的setRate重置速率时也会调用。 2.2.1 resync方法用于基于当前时间刷新计算最新的storedPermis和nextFreeTicketMicros. /** Updates {@code storedPermits} and {@code nextFreeTicketMicros} based on the current time. */ void resync(long nowMicros) { // if nextFreeTicket is in the past, resync to now if (nowMicros > nextFreeTicketMicros) { double newPermits = (nowMicros - nextFreeTicketMicros) / coolDownIntervalMicros(); storedPermits = min(maxPermits, storedPermits + newPermits); nextFreeTicketMicros = nowMicros; } } 该方法从现实场景上讲,代表的是随着时间的流逝,贮存许可不断增加,但从技术实现的角度,并不是真正的持续刷新,而是仅在需要时调用刷新。该方法如果当前时间小于等于下次许可时间,则贮存许可数量和下次许可时间不需要刷新;否则通过 (当前时间-下次许可时间)/贮存许可的发放间隔计算出的值域最大贮存数量取小,则为已贮存的许可数量,需要注意的是贮存许可数量是double类型的。 限速器使用 限速器常用的方法主要有accquire和tryAccquire。 先说一下accquire方法, 共有两个共有方法,一个是无参的,每次获取1个许可,再一个是整数参数的,每次调用获取多个许可。 // 获取1个许可 public double acquire() { return acquire(1); } // 获取多个许可 public double acquire(int permits) { // 留出permits个许可,得到需要sleep的微秒数. long microsToWait = reserve(permits); // 该方法如果小于等于零则直接返回,否则sleep stopwatch.sleepMicrosUninterruptibly(microsToWait); // 返回休眠的秒数. return 1.0 * microsToWait / SECONDS.toMicros(1L); } 从以上源码可看出,获取许可的逻辑很简单:留出permits个许可,根据返回值决定是否sleep等待。留出许可的方法实现如下: // 预留出permits个许可 final long reserve(int permits) { checkPermits(permits); synchronized (mutex()) { return reserveAndGetWaitLength(permits, stopwatch.readMicros()); } } // 预留出permits个需求,得到需要等待的时间 final long reserveAndGetWaitLength(int permits, long nowMicros) { long momentAvailable = reserveEarliestAvailable(permits, nowMicros); return max(momentAvailable - nowMicros, 0); } abstract long reserveEarliestAvailable(int permits, long nowMicros); reserveEarliestAvailable为抽象方法,实现在SmoothRateLimiter类中,该方法是核心主链路方法,该方法先从贮存许可中获取,如果数量足够则直接返回,否则先将全部贮存许可取出,再计算还需要的等待时间,逻辑如下: final long reserveEarliestAvailable(int requiredPermits, long nowMicros) { // 刷新贮存许可和下个令牌时间 resync(nowMicros); // 返回值为当前的下次空闲时间 long returnValue = nextFreeTicketMicros; // 要消耗的贮存数量为需要的贮存数量 double storedPermitsToSpend = min(requiredPermits, this.storedPermits); // 新鲜许可数=需要的许可数-使用的贮存许可 double freshPermits = requiredPermits - storedPermitsToSpend; // 等待时间=贮存许可等待时间(实现方决定)+新鲜许可等待时间(数量*固定速率) long waitMicros = storedPermitsToWaitTime(this.storedPermits, storedPermitsToSpend) + (long) (freshPermits * stableIntervalMicros); // 透支后的下次许可可用时间=当前时间(nextFreeTicketMicros)+等待时间(waitMicros) this.nextFreeTicketMicros = LongMath.saturatedAdd(nextFreeTicketMicros, waitMicros); // 贮存许可数量减少 this.storedPermits -= storedPermitsToSpend; return returnValue; } 该方法有两点说明:1、returnValue为之前计算的下次空闲时间(前面有说RateLimiter采用预支的模式,本次直接返回,同时计算下次的最早空闲时间) 2、贮存许可的等待时间不同的实现方逻辑不同,SmoothBursty算法认为贮存许可直接可用,所以返回0, 后面的SmoothWarmingUp算法认为贮存许可需要消耗比正常速率更多的预热时间,有一定算法逻辑. 至此整个accquire方法的调用链路分析结束,下面再看tryAccquire方法就比较简单了,tryAccquire比accquire差异的逻辑在于tryAccquire方法会判断下次许可时间-当前时间是否大于超时时间,如果是则直接返回false,否则进行sleep并返回true. 方法源码如下: public boolean tryAcquire(Duration timeout) { return tryAcquire(1, toNanosSaturated(timeout), TimeUnit.NANOSECONDS); } public boolean tryAcquire(long timeout, TimeUnit unit) { return tryAcquire(1, timeout, unit); } public boolean tryAcquire(int permits) { return tryAcquire(permits, 0, MICROSECONDS); } public boolean tryAcquire() { return tryAcquire(1, 0, MICROSECONDS); } public boolean tryAcquire(int permits, Duration timeout) { return tryAcquire(permits, toNanosSaturated(timeout), TimeUnit.NANOSECONDS); } public boolean tryAcquire(int permits, long timeout, TimeUnit unit) { long timeoutMicros = max(unit.toMicros(timeout), 0); checkPermits(permits); long microsToWait; synchronized (mutex()) { long nowMicros = stopwatch.readMicros(); // 判断超时微秒数是否可等到下个许可时间 if (!canAcquire(nowMicros, timeoutMicros)) { return false; } else { microsToWait = reserveAndGetWaitLength(permits, nowMicros); } } // 休眠等待 stopwatch.sleepMicrosUninterruptibly(microsToWait); return true; } // 下次许可时间-超时时间<=当前时间 private boolean canAcquire(long nowMicros, long timeoutMicros) { return queryEarliestAvailable(nowMicros) - timeoutMicros <= nowMicros; } SmoothWarmingUp算法 SmoothWarmingUp算法的主体处理流程同SmoothBurstry算法,主要在贮存许可时间计算上的两个方法进行了新实现,该算法不像SmoothBurstry算法那么直观好理解,需要先了解算法逻辑,再看源码。 算法说明 该算法在源码注释中已经描述的比较清晰了,主要思想是限流器的初始贮存许可数量便是最大贮存许可值, 贮存许可执行时按一定算法由慢到快的产生,直至设定的固定速率,以此来达到预热过程。该算法涉及到一些数学知识,如果不是很感兴趣,则了解其主要思想便可。下面详细说一下该算法。 说到该算法前,我们再回头看一下SmoothRateLimiter的贮存许可,贮存许可有当前数量和最大数量,另外还有两个算法逻辑,一个是贮存许可生产的速率控制,再一个是贮存许可消费速率的控制,在Bursty算法中,生产的速率同设定的固定速率,而消费的速率为无穷大(立刻消费,不占用时间);在WarmingUp算法中,需对照下图进行分析: 该图可这样理解,每个贮存许可的消费耗时为右侧梯形面积,梯形面积=(上边长+下边长)/2 * 高. 可以看到每个贮存许可的面积越来越小,直到固定速率的长方形面积。 在限速器初始化时,输入的变量有固定速率和预热时间,另外冷却因子是固定值3;在作者算法中,首先计算的是阈值许可数 = 0.5 * 预热周期 / 固定速率. 然后计算的是最大许可数,我们知道了梯形的面积、上边(大速率)、下边(小速率),便能推到出高,最大许可=阀值许可数 + 高。 void doSetRate(double permitsPerSecond, double stableIntervalMicros) { double oldMaxPermits = maxPermits; double coldIntervalMicros = stableIntervalMicros * coldFactor; thresholdPermits = 0.5 * warmupPeriodMicros / stableIntervalMicros; maxPermits = thresholdPermits + 2.0 * warmupPeriodMicros / (stableIntervalMicros + coldIntervalMicros); slope = (coldIntervalMicros - stableIntervalMicros) / (maxPermits - thresholdPermits); if (oldMaxPermits == Double.POSITIVE_INFINITY) { // if we don't special-case this, we would get storedPermits == NaN, below storedPermits = 0.0; } else { storedPermits = (oldMaxPermits == 0.0) ? maxPermits // initial state is cold : storedPermits * maxPermits / oldMaxPermits; } } 在具体使用中,一个是生产的速率,固定为预热时间/最大许可数,源码如下: double coolDownIntervalMicros() { return warmupPeriodMicros / maxPermits; } 再一个是消费的速率,按如上曲线从右至左的面积=梯形面积+长方形面积,梯形面积=(上边+下边) /2 * 高 ,源码如下: long storedPermitsToWaitTime(double storedPermits, double permitsToTake) { double availablePermitsAboveThreshold = storedPermits - thresholdPermits; long micros = 0; // measuring the integral on the right part of the function (the climbing line) if (availablePermitsAboveThreshold > 0.0) { double permitsAboveThresholdToTake = min(availablePermitsAboveThreshold, permitsToTake); // TODO(cpovirk): Figure out a good name for this variable. double length = permitsToTime(availablePermitsAboveThreshold) + permitsToTime(availablePermitsAboveThreshold - permitsAboveThresholdToTake); micros = (long) (permitsAboveThresholdToTake * length / 2.0); permitsToTake -= permitsAboveThresholdToTake; } // measuring the integral on the left part of the function (the horizontal line) micros += (long) (stableIntervalMicros * permitsToTake); return micros; } 源码分析 了解了以上算法后,再看下面的源码就相对简单了。 static final class SmoothWarmingUp extends SmoothRateLimiter { // 预热时间 private final long warmupPeriodMicros; //斜率 private double slope; //阈值许可 private double thresholdPermits; //冷却因子 private double coldFactor; SmoothWarmingUp( SleepingStopwatch stopwatch, long warmupPeriod, TimeUnit timeUnit, double coldFactor) { super(stopwatch); this.warmupPeriodMicros = timeUnit.toMicros(warmupPeriod); this.coldFactor = coldFactor; } // 参数初始化 @Override void doSetRate(double permitsPerSecond, double stableIntervalMicros) { double oldMaxPermits = maxPermits; double coldIntervalMicros = stableIntervalMicros * coldFactor; thresholdPermits = 0.5 * warmupPeriodMicros / stableIntervalMicros; maxPermits = thresholdPermits + 2.0 * warmupPeriodMicros / (stableIntervalMicros + coldIntervalMicros); slope = (coldIntervalMicros - stableIntervalMicros) / (maxPermits - thresholdPermits); if (oldMaxPermits == Double.POSITIVE_INFINITY) { // if we don't special-case this, we would get storedPermits == NaN, below storedPermits = 0.0; } else { storedPermits = (oldMaxPermits == 0.0) ? maxPermits // initial state is cold : storedPermits * maxPermits / oldMaxPermits; } } // 有storedPermits个贮存许可,要使用permitsToTake个时的等待时间计算 @Override long storedPermitsToWaitTime(double storedPermits, double permitsToTake) { double availablePermitsAboveThreshold = storedPermits - thresholdPermits; long micros = 0; // measuring the integral on the right part of the function (the climbing line) if (availablePermitsAboveThreshold > 0.0) { double permitsAboveThresholdToTake = min(availablePermitsAboveThreshold, permitsToTake); // TODO(cpovirk): Figure out a good name for this variable. double length = permitsToTime(availablePermitsAboveThreshold) + permitsToTime(availablePermitsAboveThreshold - permitsAboveThresholdToTake); micros = (long) (permitsAboveThresholdToTake * length / 2.0); permitsToTake -= permitsAboveThresholdToTake; } // measuring the integral on the left part of the function (the horizontal line) micros += (long) (stableIntervalMicros * permitsToTake); return micros; } // 许可耗时=固定速率+许可值*斜率 private double permitsToTime(double permits) { return stableIntervalMicros + permits * slope; } // 冷却间隔固定为预热时间/最大许可数. @Override double coolDownIntervalMicros() { return warmupPeriodMicros / maxPermits; } } 思考总结 sleep说明和相对时间 RateLimiter内部使用类StopWatch进行了一个相对时间的度量,RateLimiter创建时,时间为0,然后向后累计,sleep时不受interrupt异常影响。 double浮点数 RateLimiter暴露的API的许可数量入参为整数类型,但内部计算时实际是浮点double类型,支持小数许可数量,一方面浮点存在丢失精度,另一方面也不便于理解;是否可以使用整数值得考虑。 只支持单机 RateLimiter的这几种算法只支持单机限流,如要支持集群限流,一种方式是先根据负载均衡的权重计算出单机的限速值,再进行单节点限速;另一种方式是参考该组件使用redis等中心化数量管理的中间件,但性能和稳定性会降低一些。 扩展性 RateLimiter提供了有限的扩展能力,自带的SmoothBursty和SmoothWarmingUp类不是公开类,不能直接创建或调整参数,如关闭贮存功能或调整预热系数等。这种场景需要继承SmoothRateLimiter进行重写,贮存许可的生产和消费算法是容易变化和重写的点,将整个源码拷贝出来进行二次修改也是一种方案。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册