首页 文章 精选 留言 我的

精选列表

搜索[python解释器],共10000篇文章
优秀的个人博客,低调大师

Python爬虫入门教程 31-100 36氪(36kr)数据抓取 scrapy

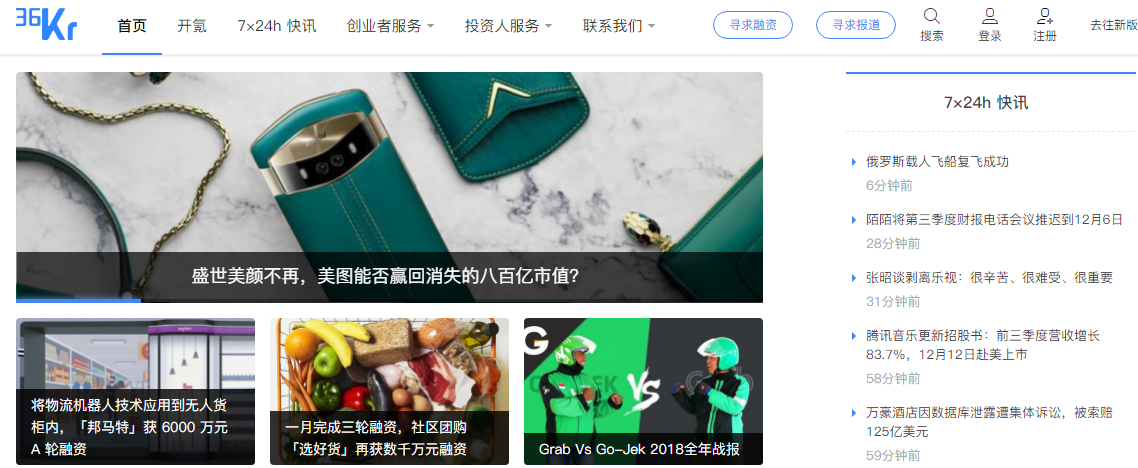
1. 36氪(36kr)数据----写在前面 今天抓取一个新闻媒体,36kr的文章内容,也是为后面的数据分析做相应的准备的,预计在12月底,爬虫大概写到50篇案例的时刻,将会迎来一个新的内容,系统的数据分析博文,记得关注哦~ 36kr 让一部分人先看到未来,而你今天要做的事情确实要抓取它的过去。 网址 https://36kr.com/ 2. 36氪(36kr)数据----数据分析 36kr的页面是一个瀑布流的效果,当你不断的下拉页面的时候,数据从后台追加过来,基于此,基本可以判断它是ajax异步的数据,只需要打开开发者工具,就能快速的定位到想要的数据,我们尝试一下! 捕获链接如下 https://36kr.com/api/search-column/mainsite?per_page=20&page=1&_=15438401

优秀的个人博客,低调大师

躁动不安的年代,你需要读几本好书(python爬虫及数据分析)

公众号:pythonislover 当今社会,速度已经深入人心了,“快”成了大家默认的办事境界,看机器上一件件飞一般传递着的产品,听办公室一族打电话时那种无人能及的语速......休闲的概念已日渐模糊,大家似乎都变成了在“快咒”控制下的小人儿,似乎连腾出点时间来松口气的时间都没有了,看得见的、看不见的规则约束着我们;有形的、无形的的鞭子驱赶着我们,我们马不停蹄追求事业、爱情、地位、财富,似乎自己慢一拍,就会被这个世界抛弃 工作仅仅是生活的一部分,千万不要忽略了其他乐趣,人生本是一幅美丽的风景画,不必对所有的事情都抱有强烈的目的性,人的一生总有做不完的事情,只要我们有一个平和之心,就不会错过沿途风景。 一个阳光明媚的早晨,手拿一杯咖啡,翻开一本喜欢的书,也不失为一种人生乐趣,作为IT一族,我们不能只是局限于IT类的数据,要广大自己的视野

优秀的个人博客,低调大师

Python爬虫入门教程 7-100 蜂鸟网图片爬取之二

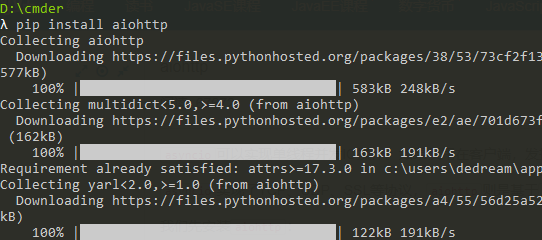
1. 蜂鸟网图片-简介 今天玩点新鲜的,使用一个新库 aiohttp ,利用它提高咱爬虫的爬取速度。 安装模块常规套路 pip install aiohttp 运行之后等待,安装完毕,想要深造,那么官方文档必备 :https://aiohttp.readthedocs.io/en/stable/ 接下来就可以开始写代码了。 我们要爬取的页面,这一次选取的是 http://bbs.fengniao.com/forum/forum_101_1_lastpost.html 打开页面,我们很容易就获取到了页码 好久没有这么方便的看到页码了。 尝试用 aiohttp 访问这个页面吧,模块的引入,没有什么特殊的,采用 import 即可 如果我们需要 使用 Asyncio + Aiohttp异步IO 编写爬虫,那么需要注意,你需要异步的方法前面加上 async 接下来

优秀的个人博客,低调大师

Python爬虫入门教程 8-100 蜂鸟网图片爬取之三

1. 蜂鸟网图片-啰嗦两句 前几天的教程内容量都比较大,今天写一个相对简单的,爬取的还是蜂鸟,依旧采用aiohttp 希望你喜欢爬取页面https://tu.fengniao.com/15/ 本篇教程还是基于学习的目的,为啥选择蜂鸟,没办法,我瞎选的。 一顿熟悉的操作之后,我找到了下面的链接https://tu.fengniao.com/ajax/ajaxTuPicList.php?page=2&tagsId=15&action=getPicLists 这个链接返回的是JSON格式的数据 page =2页码,那么从1开始进行循环就好了 tags=15 标签名称,15是儿童,13是美女,6391是私房照,只能帮助你到这了,毕竟我这是专业博客 ヾ(◍°∇°◍)ノ゙ action=getPicLists接口地址,不变的地方 2.

优秀的个人博客,低调大师

Python爬虫入门教程 6-100 蜂鸟网图片爬取之一

1. 蜂鸟网图片简介 国庆假日结束了,新的工作又开始了,今天我们继续爬取一个网站,这个网站为 http://image.fengniao.com/ ,蜂鸟一个摄影大牛聚集的地方,本教程请用来学习,不要用于商业目的,不出意外,蜂鸟是有版权保护的网站。 2. 蜂鸟网图片网站分析 第一步,分析要爬取的网站有没有方法爬取,打开页面,找分页 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=1&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=2&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=3&not_in_id=5352384,5352410 http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page=4&not_in_id=5352384,5352410 上面的页面发现一个关键的参数page=1这个就是页码了,但是另一个比较头疼的问题是,他没有最后的页码,这样我们没有办法确定循环次数,所以后面的代码编写中,只能使用while了 这个地址返回的是JSON格式的数据,这个对爬虫来说,非常友好!省的我们用正则表达式分析了。 分析这个页面的头文件,查阅是否有反爬措施 发现除了HOST和User-Agent以外,没有特殊的点,大网站就是任性,没啥反爬,可能压根不在乎这个事情。 第二步,分析图片详情页面,在我们上面获取到的JSON中,找到关键地址 关键地址打开之后,这个地方有一个比较骚的操作了,上面图片中标注的URL选的不好,恰好是一个文章了,我们要的是组图,重新提供一个新链接 http://image.fengniao.com/slide/535/5352130_1.html#p=1 打开页面,你可能直接去找规律了,找到下面的一堆链接,但是这个操作就有点复杂了,我们查阅上述页面的源码 http://image.fengniao.com/slide/535/5352130_1.html#p=1 http://image.fengniao.com/slide/535/5352130_1.html#p=2 http://image.fengniao.com/slide/535/5352130_1.html#p=3 .... 网页源码中发现了,这么一块区域 大胆的猜测一下,这个应该是图片的JSON,只是他打印在了HTML中,我们只需要用正则表达式进行一下匹配就好了,匹配到之后,然后进行下载。 第三步,开始撸代码。 3. 蜂鸟网图片写代码 from http_help import R # 这个文件自己去上篇博客找,或者去github找 import threading import time import json import re img_list = [] imgs_lock = threading.Lock() #图片操作锁 # 生产者类 class Product(threading.Thread): def __init__(self): threading.Thread.__init__(self) self.__headers = {"Referer":"http://image.fengniao.com/", "Host": "image.fengniao.com", "X-Requested-With":"XMLHttpRequest" } #链接模板 self.__start = "http://image.fengniao.com/index.php?action=getList&class_id=192&sub_classid=0&page={}&not_in_id={}" self.__res = R(headers=self.__headers) def run(self): # 因为不知道循环次数,所有采用while循环 index = 2 #起始页码设置为1 not_in = "5352384,5352410" while True: url = self.__start.format(index,not_in) print("开始操作:{}".format(url)) index += 1 content = self.__res.get_content(url,charset="gbk") if content is None: print("数据可能已经没有了====") continue time.sleep(3) # 睡眠3秒 json_content = json.loads(content) if json_content["status"] == 1: for item in json_content["data"]: title = item["title"] child_url = item["url"] # 获取到链接之后 代码来源,公众号:非本科程序员 img_content = self.__res.get_content(child_url,charset="gbk") pattern = re.compile('"pic_url_1920_b":"(.*?)"') imgs_json = pattern.findall(img_content) if len(imgs_json) > 0: if imgs_lock.acquire(): img_list.append({"title":title,"urls":imgs_json}) # 这个地方,我用的是字典+列表的方式,主要是想后面生成文件夹用,你可以进行改造 imgs_lock.release() 上面的链接已经生成,下面就是下载图片了,也非常简单 # 消费者 class Consumer(threading.Thread): def __init__(self): threading.Thread.__init__(self) self.__res = R() def run(self): while True: if len(img_list) <= 0: continue # 进入下一次循环 if imgs_lock.acquire(): data = img_list[0] del img_list[0] # 删除第一项 imgs_lock.release() urls =[url.replace("\\","") for url in data["urls"]] # 创建文件目录 for item_url in urls: try: file = self.__res.get_file(item_url) # 记得在项目根目录先把fengniaos文件夹创建完毕,代码来源,公众号:非本科程序员 with open("./fengniaos/{}".format(str(time.time())+".jpg"), "wb+") as f: f.write(file) except Exception as e: print(e) 代码走起,结果

优秀的个人博客,低调大师

python设计模式(三):原型模式—快速实例化类的一种途径

原型是相对于复制、克隆而言,但是不同于模板,模板创造出的东西是一模一样,而原型创造的东西是允许差异化和个性化存在,这就是原型。 原型模式最为核心的两点是:拷贝、属性更新;拷贝指深拷贝copy.deepcopy,属性更新是类的自有属性__dict__的更新。 实例代码: #-*-coding:utf-8-*-importcopyclassInformation: """个人信息""" def__init__(self): self.name=None self.ager=None self.height=None defrun(self): """ 自我介绍方法 :return: """ print("我叫{}:年龄:{}身高:{}".format(self.name,self.ager,self.height))classPrototype: def__init__(self,obj): self.copy_object=obj() defclone(self,**attr): obj=copy.deepcopy(self.copy_object) obj.__dict__.update(attr) returnobjif__name__=='__main__': test=Prototype(Information) a=test.clone(name='张山',ager="30",height='170cm') a.run() b=test.clone(name='李飞',ager="20",height='190cm') b.run() 要实现多个人的自我介绍,一般方法是每个人都创建一个对象,但是使用原型模式之后,只需要实例化一个对象(标准人),后面的人都已这个标准人为基础来实现个性化。 这就是原型模式的精要:定义一个原型,设计一个拷贝接口,不需要频繁实例化类,只需要拷贝yuanxing 。他的好处是可以减少因为对象实例化而产生的损耗,并实行动态装载。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册