首页 文章 精选 留言 我的

精选列表

搜索[AIPC技术],共10000篇文章
优秀的个人博客,低调大师

TrafficGPT:利用大模型技术解决交通问题

来自北航、海河大学等学校的研究者近日发布论文(Arxiv 地址),介绍了一款名为 TrafficGPT 的大模型产品。 TrafficGPT将ChatGPT和交通基础模型融合在一起,具备查看、分析、处理交通数据的能力,并为城市交通系统管理提供有深度的决策支持。 TrafficGPT 运行框架 TrafficGPT 整体架构概览 TrafficGPT 能力演示 同时,它还可以智能地分解复杂任务,并逐步利用交通基础模型完成任务。此外,TrafficGPT还可以通过自然语言对话辅助人类的交通控制决策,并允许交互式反馈和修订结果。

优秀的个人博客,低调大师

浅析Java - SPI机制 | 京东云技术团队

SPI是什么 SPI全称Service Provider Interface,是Java提供的一套用来被第三方实现或者扩展的API,它可以用来启用框架扩展和替换组件。 整体机制如下图 Java SPI 实际上是“基于接口的编程+策略模式+配置文件”组合实现的动态加载机制。 使用场景 适用于:调用者根据实际使用需要,启用、扩展、或者替换框架的实现策略 比较常见的例子: 数据库驱动加载接口实现类的加载,JDBC加载不同类型数据库的驱动 日志门面接口实现类加载,SLF4J加载不同提供商的日志实现类 Spring中大量使用了SPI,比如:对servlet3.0规范对ServletContainerInitializer的实现、自动类型转换Type Conversion SPI(Converter SPI、Formatter SPI)等 Dubbo中也大量使用SPI的方式实现框架的扩展, 不过它对Java提供的原生SPI做了封装,允许用户扩展实现Filter接口 使用介绍 要使用Java SPI,需要遵循如下约定: 当服务提供者提供了接口的一种具体实现后,在jar包的META-INF/services目录下创建一个以“接口全限定名”为命名的文件,内容为实现类的全限定名; 接口实现类所在的jar包放在主程序的classpath中; 主程序通过java.util.ServiceLoder动态装载实现模块,它通过扫描META-INF/services目录下的配置文件找到实现类的全限定名,把类加载到JVM; SPI的实现类必须携带一个不带参数的构造方法; 总结 优点:使用Java SPI机制的优势是实现解耦,使得第三方服务模块的装配控制的逻辑与调用者的业务代码分离,而不是耦合在一起。应用程序可以根据实际业务情况启用框架扩展或替换框架组件。 缺点: 虽然ServiceLoader也算是使用的延迟加载,但是基本只能通过遍历全部获取,也就是接口的实现类全部加载并实例化一遍。如果你并不想用某些实现类,它也被加载并实例化了,这就造成了浪费。获取某个实现类的方式不够灵活,只能通过Iterator形式获取,不能根据某个参数来获取对应的实现类。 多个并发多线程使用ServiceLoader类的实例是不安全的。 作者:京东零售 曹志飞 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Elasticsearch Mapping类型修改 | 京东云技术团队

背景 通常数据库进行分库分表后,目前比较常规的作法,是通过将数据异构到Elasticsearch来提供分页列表查询服务;在创建Elasticsearch索引时,基本都是会参考目前的业务需求、关系数据库中的类型以及对数据的相关规划来定义相关字段mapping的类型. 在Elasticsearch的mapping中的列(或则叫属性),有几个比较重要的参数(更多参数参考官方文档) 列类型:type 指定了该列的数据类型,常用的有text,keyword,date,long,double,boolean以及object和nested,不同的类型也有对应的不同查询方式,创建之后是不能修改的; 是否可索引:index 该index选项控制字段值是否被索引。它接受trueorfalse,并且默认为true. 未索引的字段不可查询,当然也不能做为排序字段。 但是在实际的开发过程中,又会有需求对现有的mapping的type进行修改(类似对MySQL数据表的字段进行DDL操作)的诉求。比如商品上的价格price字段,按原来的业务分析,只需要提供数据返回即可,在创建索引时类型定义了keyword了,并且index设置成了false,这时我们需要根据价格的范围查询或则进行排序操作,就希望对mapping进行调整,将类型修改成数字类型,索引也需要加上;今天针对Elasticsearch的Mapping类型进行修改,讨论几个可行的方案 方案1:运用reindex 遇到问题第一时间,我们应该是查询官方文档是否有相关的操作说明,在官方文档中,确实还能找到对已有mapping更新的相关apiput-mapping,通过这个文档,很快可以找到文档中对修改已有mapping的列的方式(参考官方文档),同时也提到的通过reindex的方式来修改已有类型的方式; 除了支持的mapping parameters外,您不能更改现有字段的映射或字段类型。更改现有字段可能会使已编制索引的数据无效。如果您需要更改字段的映射,请使用正确的映射创建一个新索引并将您的数据重新索引reindex到该索引中。 如原来索引的mapping如下 PUT /users { "mappings" : { "properties": { "user_id": { "type": "long" } } } } //加一了两条数据 POST /users/_doc?refresh=wait_for { "user_id" : 12345 } POST /users/_doc?refresh=wait_for { "user_id" : 12346 } 这时想修改user_id的类型为keyword,我们直接是修改不了的。 //尝试直接修改type,行不通,会报错 PUT /users/_mapping { "properties": { "user_id": { "type": "keyword" } } } //报错信息 { "error": { "root_cause": [ { "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" } ], "type": "illegal_argument_exception", "reason": "mapper [user_id] of different type, current_type [long], merged_type [keyword]" }, "status": 400 } 按官方文档说的reindex重新索引可按以下步骤操作 操作步骤 第一步:创建新的索引new_users将user_id的类型定义成keyword PUT /new_users { "mappings" : { "properties": { "user_id": { "type": "keyword" } } } } 第二步:将原user索引标记为只读 控制我们的应用系统,数据停写不再向老索引中写数据,并且最好对老索引进行只读操作设置,保证在reindex的过程中,不要生产新数据,导致新老索数据不一致; //设置索引为读写的 PUT /users/_settings { "settings": { "index.blocks.write": true } } 第三步:将原user索引中的数据迁移到new_users中 POST /_reindex { "source": { "index": "users" }, "dest": { "index": "new_users" } } reindex还有很多的参数可以配置,包括从远程的一个集群迁移数据都是可以的,详细可参考:Reindex API 如果新的索引的mapping的定义与原索引的定义有差异的,会按新索引定义的dynamic规则进行数据的迁移,具体的,可以参考:dynamic 该dynamic设置控制是否可以动态添加新字段。它接受三种设置: 值 说明 true 新检测到的字段被添加到映射中。(默认); 新增的数据类型的规则,可以参考:dynamic-mapping false 忽略新检测到的字段。这些字段不会被编入索引,因此将无法搜索,但仍会出现在_source返回的命中字段中。这些字段不会添加到映射中,必须明确添加新字段。 strict 如果检测到新字段,则会抛出异常并拒绝文档。必须将新字段显式添加到映射中。 同时将原user索引标记为可读写 //设置索引为可读写 PUT /users/_settings { "settings": { "index.blocks.write": false } } 第四步:切换到使用新的mapping 可以将应用系统中的配置改成新索引 也可以通过索引的别名的方式为新索引增加原来老索引的别名来操作,为索引增加别名参考文档:Add index alias API,在增加别名前,需要删除原来的老索引; //为索引增加别名 基本格式 PUT /<index>/_alias/<alias> POST /<index>/_alias/<alias> //为new_users索引增加别名users PUT /new_users/_alias/users //没有删除老索引前,是增加不了别名的,需要先删除老别名 { "error": { "root_cause": [ { "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" } ], "type": "invalid_alias_name_exception", "reason": "Invalid alias name [users], an index exists with the same name as the alias", "index_uuid": "8Rbq_32BTHC4CoO_CqWdXA", "index": "users" }, "status": 400 } 方案优劣分析 【优点】操作简单,官方方案 该方案,不需要对原索引做操作,在线即可进行,并且操作步骤也简单;也是官方文档提供的方案。 【缺点】数据量大迁移耗时长 当数据最大时,这个数据迁移会比较耗时 结论 当数据量小时,并且希望mapping比较规整好看,该方案是比较推荐的。当数据量大时,可能该方案在数据迁移过程中会比较耗时,需要评估是否可行; 方案2:运用multi-fields 为不同的目的以不同的方式索引同一个字段通常很有用。这就是multi-fields的目的。例如,一个string字段可以映射为text用于全文搜索的字段,也可以映射keyword为用于排序或聚合的字段; 在这个方案中,应用的是mapping参数fields来对同一个列,定义多种数据类型;详细[【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) 操作步骤 第一步:为列增加fields属性 还是以上面的users这个索引为例,我们还是想将user_id的类型定义成keyword; PUT /users/_mapping { "properties":{ "user_id":{ "type":"long", "fields":{ "raw":{ "type":"keyword" } } } } } 操作完成后,在users的user_id列下,就会多出一个raw的子属性;在我们正常写数据user_id时,会自动生成这两个索引,一个是long类型的user_id,以及keyword类型的user_id.raw(注意这里有个点,跟子对象访问方式一样); 在put mapping时,type参数必需给,并且需要跟原来的类型一致,fields中新定义的子属性可以多个; 【可选】第二步:历史数据更新 针对历史数据需要处理,可以借助_update_by_query来更新数据,只需要将原来的索引再写一次,即可将新加的字段写入数据。 POST /users/_update_by_query { "query":{ "exists":{ "field":"user_id" } }, "script":{ "source":"ctx._source.user_id=ctx._source.user_id ", "lang":"painless" } } // query 部分为需要更新数据过滤条件,可根据业务规则写 // script 更数据的逻辑,这个基本可以不改 方案优劣分析 【优点】不影响原索引,同一列可以定义多种类型 通过这方式不会影响原来的索引数据,可以不用修改现在的应用程序的读写方式,对应用程序一切按原来逻辑执行,对应用方无感知,非常优化。只需要有使用新类型的场景使用即可,可以说影响是最小的; 同时只是做了一个定义,执行速度是非常快的,对Elasticsearch服务基本不会有太大影响;并且对于同一个列可以定义多个类型,比如商品名称,在多国多语言环境下可以根据不同语言定义多个列,对应使用不同的分词器; 【缺点】老数据不会自动创建子索引,多出额外的存储 老数据不会自动创建索引,因为需要多出新的索引来,会增加额外的存储; 结论 1、需要对多一列创建多个索引类型时,是一个非常推荐的方案; 2、对于新索引,只有新业务使用,对老数据没有诉求的,也非常推荐该方案; 方案3:运用copy_to copy_to是将多个字段的值,合并到一个字段中,便于搜索。但是也可以实现一个字段存在多个类型的需求。详细参考【官方文档】copy_to 操作步骤 还是用上面的users这个索引为例,为user_id创建一个copy列:user_id_raw类型定义成keyword PUT /users/_mapping { "properties":{ "user_id_raw":{ "type":"keyword", "copy_to":"user_id" } } } 这个方案与方案2:multi-fields基本是一样的,只是创建列的方式不同,优缺点都一样; 参考资料 [1]【官方文档】Mapping parameters [2]【官方文档】Mapping Field datatypes [3] [【官方文档】multi-fields] (https://www.elastic.co/guide/en/elasticsearch/reference/7.5/multi-fields.html) [4]Elasticsearch Rename Index [5]elasticSearch7.x—mapping中的fields属性||copy_to配置(同一个字段两种类型) [6]《Elasticsearch:权威指南》Mapping -- Mapping parameters -- fields(multi-fields) 作者:京东零售 周德东 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

当小白遇到FullGC | 京东云技术团队

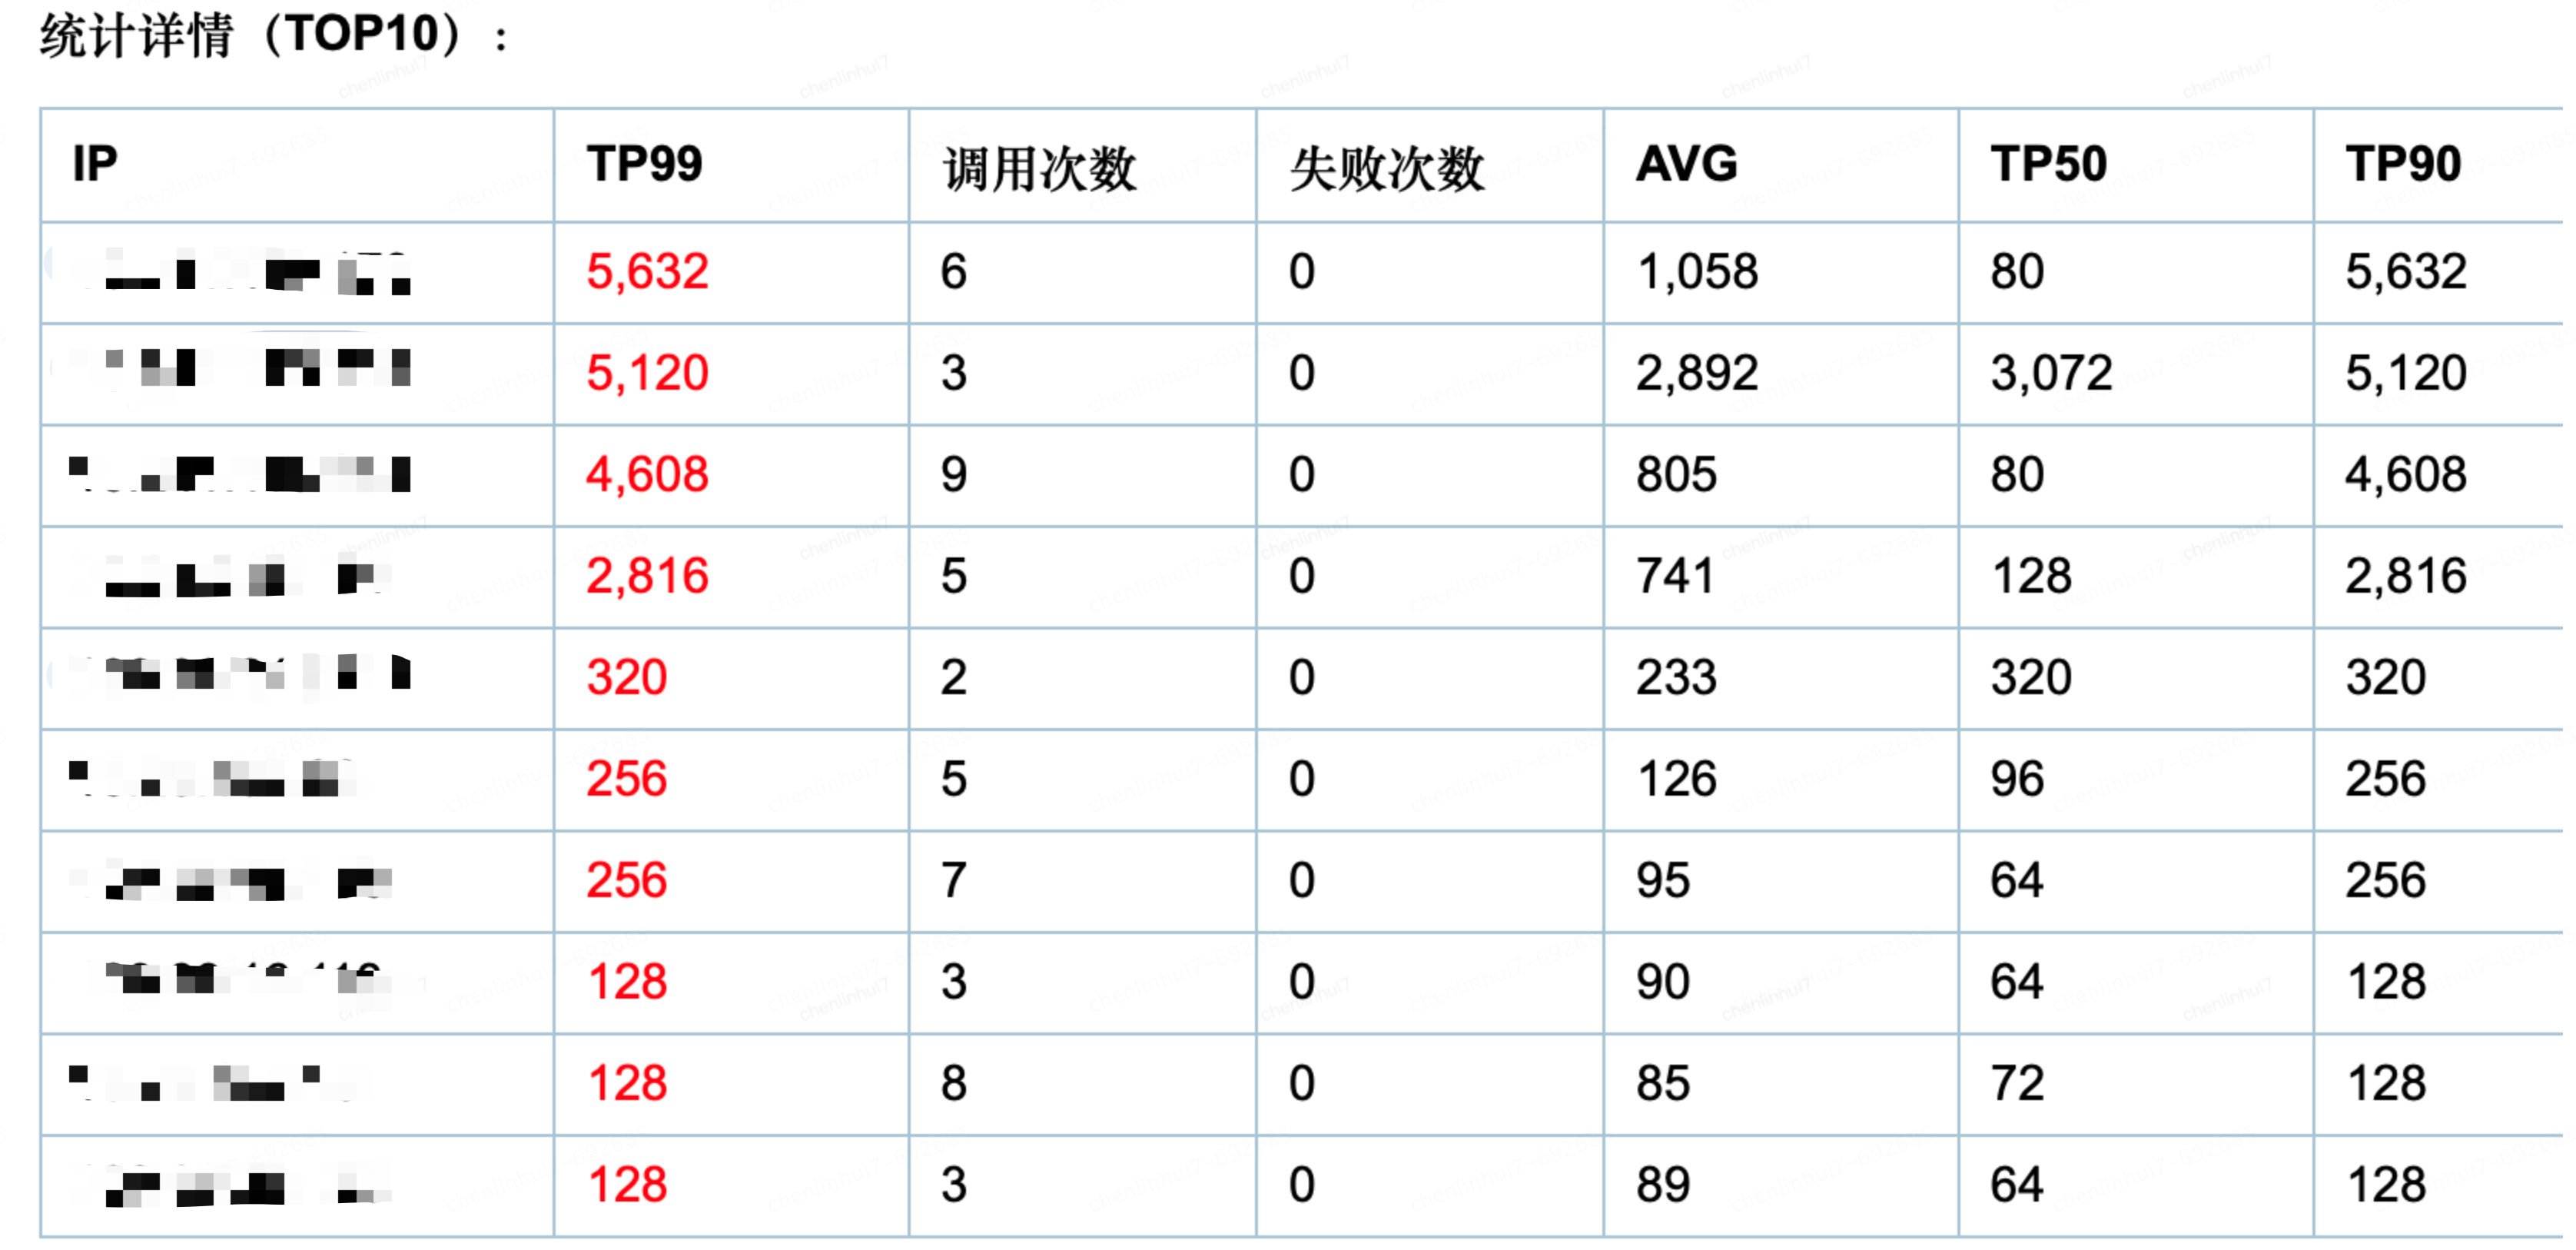
起初没有人在意这场GC,直到它影响到了每一天! 前言 本文记录了一次排查FullGC导致的TP99过高过程,介绍了一些排查时思路,线索以及工具的使用,希望能够帮助一些新手在排查问题没有很好的思路时,提供一些思路,让小白也能轻松解决FullGC问题,文中实际提到的参数配置不一定适合其他业务场景,在调优自己的项目时还是需要实际试验过才能得出最佳参数配置 我也是小白,如有不合理的地方,欢迎大佬们进行指正 因为线上服务器,我们大部分是没有SSH权限的,没有办法直接执行命令获取容器信息,所以排查过程中只能借助平台提供的工具,平台提供的工具还是挺全的,本文主要用到的工具有: JDOS容器智能监控,JDOS进程查询,SGM容器监控信息,SGM方法调用查询 以下几个工具简单介绍: http://sgm-server.jd.com/ http://jagile.jd.com/jdosCD/jdt/apps JDOS容器智能监控: 查看容器的CPU,内存,磁盘,IO等信息 JDOS进程查询: 查看Java进程编号,执行常用的Java内存进程查看命令 SGM容器监控信息: 查看JVM虚拟机内存变更历史记录 SGM方法调用查询: 查看某一次关键接口调用的上下依赖,时间分布 起因 - 偶尔出现接口超时 一开始偶尔会收到报警邮件,显示有些接口调用时间比较长,抽查了一些接口,发现大部分都是调用下游JSF时间比较长,导致响应比较慢,这时候就没太在意,接下来继续观察了几天,发现一个规律,大部分邮件都是每天10点  排查定位问题 1. 首先确认了10点这个时间点有没有定时任务之类的操作,经过询问确定这个时间点是仓库出库高峰期,导致业务量出现峰值(调用量变大可能是激发FullGC问题,成为问题暴漏的导火线) 2. 第二部就是确认是数据库原因,还是业务代码,还是JSF下游接口达到极限原因,到这一步还是未知的,在这用到了SGM的接口调用查询工具,下图中我们看到,这次调用JSF也是挺高的(这个没有太好办法,除非让下游优化,所以暂时忽略),但是还有一个是logic,这个就是逻辑处理,如果没有那个FullGC提示,就需要去分析代码的处理是否有问题,这通过那行红色字体的提示,很显然我们确定了是FullGC导致的问题 3. 我们去查看一下容器的FullGC情况,确实发现这个时间点的FullGC特别频繁,到此已经把问题范围定位到就是FullGC导致的     FullGC问题排查 Full GC 触发条件: 到这里我们需要确定一个问题 : “触发FullGC的条件是什么?”,新手可以去博客搜索,当然最好是能记住这个知识点。注意这不是确定“什么原因导致的FullGC?”,因为这个问题原因太多了,我们要一步一步排查。 下面是我查到的资料,粘到这里供参考. 1. Minor GC触发条件:当Eden区满时,触发Minor GC。 2. Full GC触发条件: (1)调用System.gc()时,系统建议执行Full GC,但是不必然执 (2)老年代空间不足 (3)方法区空间不足 (4)通过Minor GC后进入老年代的平均大小大于老年代的可用内存 (5)由Eden区、From Space区向To Space区复制时,对象大小大于To Space可用内存,则把该对象转存到老年代 这里在代码中并没有找到System.gc()的显示调用,一般我们也不会调用这个方法,所以我们直接看第二种情况,到SGM中查看老年代变化,结果发现老年代频繁达到90%,而这个时间正好可以跟上面GC时间对上.  对象进入老年代的几种情况 我们都知道,老年代的对象应该是存活时间很长的对象,但是我们发现这些对象都在FullGC时被释放掉了,他们为什么到了老年代呢? 这时候我们需要确定的第二个问题是:“什么情况下对象会进入老年代?” 查资料后有以下几种情况 1. 年龄够了: 躲过15次(默认配置是15次) minorGC 之后从新生代进入老年代; 2. 大对象: 大对象直接进入老年代。有一个 JVM 参数 '-XX:PretenureSizeThreshold' 设置值为字节数,创建超过该大小的对象直接进入老年代,如果没有配置这个参数,这个值好像默认是1M。 3. 动态年龄判断:当前放对象的 Survivor 区,相同年龄的一批对象(以及小于该年龄)的总内存大于该区的内存的50%,大于该年龄的其他老对象,就会进入老年代(例如1,2,3岁年龄的对象占了 S 区的50%以上,就会把大于3岁的对象移动到老年代去。所以尽量让 S 区中的对象,占比尽量少于 50%); 4. 剩的总量太多: Eden 区存活对象太多,超过了 Survivor 的大小,就直接把这些对象都转移到老年代去。(JDK1.8 空间担保机制) 首先分析第一种情况,如果出现大批量这样的对象,代码中出现了长时间引用(例如:静态Map只加不删),但是我们可以看到,这些对象在每次FullGC都被释放掉了,说明这批对象存活的时间并不长, 而且代码排查也没发现这种代码,暂时排除这种情况(这的代码因为是工具包的代码,所以没有太深纠,这为续集留个伏笔). 第二种情况,大对象,我们到JDOS下载下来JMap-dump内存快照和JMap-Histo对象统计信息,经过对FullGC钱dump分析,结合GC前GC后对象统计结果,并没有发现大量的大对象,这个基本也排除 通过JMAT(Eclipse Memory Analysis Tools)导入dump文件进行分析,内存泄漏问题一般我们直接选Leak Suspects即可,mat给出了内存泄漏的建议。另外也可以选择Top Consumers来查看最大对象报告。和线程相关的问题可以选择thread overview进行分析。除此之外就是选择Histogram类概览来自己慢慢分析,大家可以搜搜mat的相关教程。    接下来就是第三种和第四种情况,这时候我们需要取查看年轻代三块区域的变化,尤其是Survivor区域,下图是当时一个情况,S区大小一直在变化,而且基本一致保持在50%以上,这时候想到了一个JVM高版本特性,会自动打开UseAdaptiveSizePolicy(动态调整),查资料后发现,好多人反应这个参数会导致对象跨过S区,直接跑到老年代的情况,我们看到在调用量持续很高的情况,尽然调整到了17M,这肯定会导致容纳不下当时存活的对象 UseAdaptiveSizePolicy开关参数-XX:+UseAdaptiveSizePolicy是一个开关参数,当这个参数打开之后,虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或最大的吞吐量,这种调节方式称为GC自适应的调节策略(GC Ergonomics)。  定位到UseAdaptiveSizePolicy问题 既然这有问题,我们尝试关闭一下这个参数看下效果,下面是老年代,S区和FullGC,在关闭前和关闭后的效果,关闭之后S区大多数时间有充足的空间,而且,老年代和FullGC图也安稳了很多 关闭AdaptiveSizePolicy的方式 开启:-XX:+UseAdaptiveSizePolicy(JDK1.8 Parallel Scavenge收集器默认) 关闭:-XX:-UseAdaptiveSizePolicy    发现新的问题 上图中虽然已经安稳了很多,但是还是有一点小问题,频繁FullGC虽然没有了,但是一个小时还是会出现一次FullGC,而且这时候老年代还没有满,这种频率的FullGC,理论上也是不允许的. 我们回到第一个问题,FullGC触发条件,第三个,我们赶紧看了下永久代,也就是元空间,如下图,这一看不得了,元空间也在频繁变动,而且达到300M左右时会触发一次FullGC释放掉. tips: 这里是没有配置元空间的大小的,也没有配置元空间的理论上元空间无限大,不会满,查询资料后解释是,元空间也会根据当前已使用进行动态调整,当达到上次调整值90%后就会FullGC,所以每次FullGC元空间大小在200M到500M不等 元空间内存排查 这时猜测可能是代码中出现了大量的动态类的声明,想要定位哪些类需要jvm启动参数加上打印类加载和卸载的参数,顺带把GC日志开关也打开 -XX:+TraceClassUnloading -XX:+TraceClassLoading -XX:+PrintGCDetails  打开后查看日志发现一个频繁加载和卸载的类[com.googlecode.aviator.Expression], 经查询资料,这个是aviator 工具的一个规则引擎类,在加载规则时会动态加载一个类,默认不使用缓存,可以打开缓存防止频繁声明新类    修改代码后重新部署,一小时一次的FullGC也没了,如下图  总结 发现的问题: 问题一: AdaptiveSizePolicy导致对象提前进入老年代,老年代增长速度快,导致频繁FullGC 解决方式: 关闭:-XX:-UseAdaptiveSizePolicy 问题二: 元空间不断增长,导致一小时一次FullGC 解决方式: 修改逻辑代码防止频繁加载新类 在排查问题时尽可能先找直接原因,缩小排查跨度,不要一步就想知道根本原因,每个线索都要问个为什么,不正常的现象肯定是有原因的. 下面是FullGC排查思路参考脑图 作者:京东保险 陈林辉 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

精准测试探索 | 京东云技术团队

一、背景 什么是精准测试?通常研发提测的需求有代码变更,针对研发的代码变更点以及关联点进行测试,我们称之为精准测试。 很多时候,对变更点、影响范围的评估并不是很准确,偶尔会出现影响范围评估不全或者影响范围评估过大的情况。对于影响范围不全,我们所执行的测试用例,就会出现覆盖不全的情况,导致部分功能漏测,进而产生线上问题。对于影响范围过大,我们所执行的用例会过多,占用大量时间来测试完全和本次提测无关的功能,浪费人力物力。因此在这里提出测试精准化。 对于精准化的测试,我们目前做了两部分探索,静态链路分析和增量代码覆盖率分析。 二、静态链路分析 1. 当前解决问题: 部分代码耦合度高,多业务之间存在方法依赖:由于代码框架问题,部分代码可扩展性不强,代码间耦合度高,随着接入的业务线增多,代码间的依赖关系越来越多。一个微小的改动,可能就会影响到其他不相干的业务线,而这种影响由于代码并不会报错,开发人员也无法及时评估到。 本次改动对其他业务线是否有影响,无法准确评估:测试人员一般是根据本次需求改动进行用例编写,无法评估代码的改动是否会影响到其他业务线。所以在用例评审阶段,产品、开发、测试人员均无法准确评估影响范围,这样就可能会导致本次需求上线完成后,等到其他业务发生调用错误,才发现业务被影响到了。 通过改动方法,生成对应上下游方法调用链,查看影响的上下游方法,帮助开发人员分析是否有未考虑到代码影响范围;帮助测试人员检查是否需要补充测试用例 2. 架构设计: 整体项目包括前端UI界面、codeDiff、maven命令打包、静态链路生成、代码注释扫描、执行结果同步等几部分。提供界面化操作,使用者只需要提供应用名称以及提测分支,即可一键生成链路分析报告,包含改动方法数、改动方法关联上下游方法对应链路数,通过分析链路即可快速准确发现本次改动影响范围 架构设计图如下:  3. 使用效果: 截止到目前,风控业务线接入应用5个,评审需求7个,覆盖供应链金融,天盾,鉴权等业务线,后续会有更多业务接入。 三、增量代码覆盖率分析 提到覆盖率统计,我们最先想到的单元测试中的代码覆盖率,这也是通常我们最先接触的,但我们这里要做的是服务端的代码覆盖率,也是能够度量测试用例执行效果的一种统计。 做覆盖率度量的工具有很多,我们这里采用的是开源工具jacoco,也是最常用的工具之一。 首先来看一下,我要做全量代码覆盖率统计,需要哪些步骤: 全量代码覆盖率统计 1. 启动服务 无论是tomcat启动,还是springboot启动,我们都需要修改启动脚本,将JACOCO_AGENT加入到 JAVA_OPTS里,这样我们在启动应用服务的时候,自动加载jacoco agent,并同时开始对我们所测试的服务进行监听,采集被测试类和方法的数据。 JACOCO_AGENT="-javaagent:/export/content/jacocoagent.jar=destfile=/export/content/jacoco/jacoco.exec,append=true,includes=com.*,output=tcpserver,address=0.0.0.0,port=8181" 2. 执行测试用例 3. 生成exec文件 这里的exec文件,就是我们这次执行测试用例所覆盖类、方法的原始数据,通过dump指令来和服务端进行通信来进行采集。 java -jar org.jacoco.cli.jar dump --address 127.0.0.1 --port 8181 --destfile ./jacoco.exec 4. 生成report文件 这里的report文件,就是我们全量的代码覆盖率的jacoco原始报告,通过report指令来生成。 java -jar org.jacoco.cli.jar report jacoco.exec --classfiles D:/workspace/git_code/code-domain/target/classes --sourcefiles D:/workspace/git_code/code-domain/src/main/java --html report --xml jacoco.xml --encoding utf8 需要指定class文件和source文件,对于项目中有多个模块的情况,可以指定多个 classfiles和sourcefiles路径。 这样我们就生成了jacoco原始的代码覆盖率报告,如下:  增量代码覆盖率统计 那么对于增量代码覆盖率统计,我们还需要做哪些事情呢 启动服务、执行测试用例、生成exec文件,这些都不要做任何改变,但是在生成report报告之前,我们需要添加一些步骤: a. 获取增量代码 通过org.eclipse.jgit.api.Git和org.eclipse.jgit 来对我们所测试分支和master分支进行比对,生成list,看看有哪些类、哪些方法有变更 b. 改造org.jacoco.cli.jar包 在report命令后扩展 --diffCode @Option(name = "--diffCode", usage = "input String for diff", metaVar = "<file>") String diffCode; c. 执行report,生成报告 java -jar org.jacoco.cli.jar report jacoco.exec --classfiles D:/workspace/git_code/code-domain/target/classes --sourcefiles D:/workspace/git_code/code-domain/src/main/java --html report --xml jacoco.xml --diffCode '[]' --encoding utf8  这样,我们就生成了只对增量代码进行染色的覆盖率报告。通过报告,我们就可以看出本次提测所修改的代码,是否被我们的测试用例覆盖到,以后我们可以有针对性的补充哪些用例,可以覆盖没有被覆盖的代码。 四、未来规划 目前只做到了静态链路分析以及增量代码覆盖率的统计,后面通过用例的执行生成出动态链路,可以更精准的匹配出用例和链路之间的关系,对于后面我们要做的用例推荐,有着更好的指导意义。  相信精准测试的落地推广,可以更有效的保证我们的测试质量和提高我们的测试效率。 作者:京东科技 闵琦 来源:京东云开发者社区

优秀的个人博客,低调大师

商品推荐系统浅析 | 京东云技术团队

一、综述 本文主要做推荐系统浅析,主要介绍推荐系统的定义,推荐系统的基础框架,简单介绍设计推荐的相关方法以及架构。适用于部分对推荐系统感兴趣的同学以及有相关基础的同学,本人水平有限,欢迎大家指正。 二、商品推荐系统 2.1 推荐系统的定义 推荐系统本质上还是解决信息过载的问题,帮助用户找到他们感兴趣的物品,深度挖掘用户潜在的兴趣。 2.2 推荐架构 其实推荐系统的核心流程只有召回、排序、重排。 请求流程 当一个用户打开一个页面,这个时候前端会携带用户信息(pin或者uuid等)去请求后台接口(通过color间接调用),当后台收到请求后一般会先根据用户标识进行分流获取相关策略配置(ab策略),这些策略去决定接下来会调用召回模块、排序模块以及重排模块的哪个接口。一般召回模块分多路召回,每路召回负责召回多个商品,排序和重排负责调整这些商品的顺序。最后挑选出合适的商品并进行价格、图片等相关信息补充展现给用户。用户会根据自己是否感兴趣选择点击或者不点击,这些涉及用户的行为会通过日志上报到数据平台,为之后效果分析和利用用户行为推荐商品奠定基础。 其实有些问题想说一说: 为什么要采取召回、排序、重排这种漏斗分层架构? (1)从性能方面 终极:从百万级的商品库筛选出用户感兴趣的个位数级别的商品。 复杂的排序模型线上推断耗时严重,需要严格控制进入排序模型的商品数量。需要进行拆解 (2)从目标方面 召回模块:召回模块的任务是快速从大量的物品中筛选出一部分候选物品,目的是不要漏掉用户可能会喜欢的物品。召回模块通常采用多路召回,使用一些简化的特征或模型。 排序模块:排序模块的任务是精准排序,根据用户的历史行为、兴趣、偏好等信息,对召回模块筛选出的候选物品进行排序。排序模块通常使用一些复杂的模型。 重排模块:重排模块的任务是对排序模块的结果进行二次排序或调整,以进一步提高推荐的准确性和个性化程度。重排模块通常使用一些简单而有效的算法。 什么是ab实验? 参考论文:Overlapping Experiment Infrastructure: More, Better, Faster Experimentation(google2010) 只有在线实验才能真正评估模型优劣,ab实验可以快速验证实验的效果,快速迭代模型。减少上线新功能的风险。 ab算法:Hash(uuid+实验id+创建时间戳)%100 特性:分流+正交 2.3召回 召回层的存在仅仅是为用户从广阔的商品池子中初筛出一批还不错的商品。为了平衡计算速度与召回率(正样本占全部正样本的比例)指标之间的矛盾,采用多路召回策略,每路召回策略只考虑其中的单一特征或策略。 2.3.1多路召回的优劣 多路召回:采用不同的策略、特征或者简单模型分别召回一部分候选集,然后把候选集混合在一起供排序使用。召回率高,速度快,多路召回相互补充。 多路召回中每路召回的截断个数K是个超参数,需要人工调参,成本高;召回通路存在重合问题,冗余。 是否存在一种召回可以替代多路召回,向量召回应用而生,就目前而言,仍然是以向量召回为主,其他召回为辅的架构。 2.3.2召回分类 主要分为非个性化召回,个性化召回两大类。非个性化召回主要是进行热点推送,推荐领域马太效应严重,20%的商品贡献80%的点击。个性化召回主要是发掘用户感兴趣的商品,着重处理每个用户的差异点,提高商品的多样性,保持用户的粘性。 非个性化召回 (1) 热门召回 近7天高点击、高点赞、高销量商品召回 (2)新品召回 最新上架的商品召回 个性化召回 (1)标签召回、地域召回 标签召回:用户感兴趣的品类、品牌、店铺召回等 地域召回:根据用户的地域召回地域内的优质商品。 (2)cf召回 协同过滤算法是基于用户行为数据挖掘用户的行为偏好,从而根据用户的行为偏好为其推荐物品,其根据的是用户和物品的行为矩阵(共现矩阵)。用户行为一般包括浏览、点赞、加购、点击、关注、分享等等。 协同过滤分为三大类:基于用户的协同过滤(UCF)和基于物品的协同过滤(ICF)和基于模型的协同过滤(隐语义模型)。是否为用户推荐某个物品,首先要把用户和物品进行关联,而进行关联的点是另一个物品还是另一个用户,决定了这属于哪个类型的协同过滤。而基于隐语义模型是根据用户行为数据进行自动聚类挖掘用户的潜在兴趣特征。从而通过潜在兴趣特征对用户和物品进行关联。 基于物品的协同过滤(ICF):判断是否为用户推荐某个物品,首先根据用户历史行为记录的物品和这个物品的相似关系来推断用户对这个物品的兴趣度,从而判断我们是否推荐这个物品。整个协同过滤过程主要分为以下几步:计算物品之间的相似度,计算用户对物品的兴趣度,排序截取结果。 商品相似度计算: 衡量相似度主要有以下几种方式:夹角余弦距离,杰卡德公式。由于用户或物品的表示方式的多样性,使得这些相似度的计算非常灵活。我们可以利用用户和物品的行为矩阵来去计算相似度,也可以根据用户行为、物品属性和上下文关系构造用户和物品的向量表示去计算相似性。 夹角余弦距离公式: cos⁡θ=(x1*x2+y1*y2)/(√(x12+y12 )*√(x22+y22 )) 杰卡德公式J(A,B)=(|A⋂B|)/(|A⋃B|) 商品a 商品b 商品c 商品d 用户A 1 0 0 1 用户B 0 1 1 0 用户C 1 0 1 1 用户D 1 1 0 0 夹角余弦距离公式计算商品a和b的相似度: Wab=(1*0+0*1+1*0+1*1)/(√(1^2+0^2+1^2+1^2 )*√(0^2+1^2+0^2+1^2 ))=1/√6 spark实现ICF:https://zhuanlan.zhihu.com/p/413159725 问题:冷启动问题,长尾效应。 (3)向量召回 向量化召回:通过学习用户与物品低维向量化表征,将召回建模成向量空间内的近邻搜索问题,有效提升了召回的泛化能力与多样性,是推荐引擎的核心召回通道。 向量:万物皆可向量化,Embedding就是用一个低维稠密的向量表示一个对象(词语或者商品),主要作用是将稀疏向量转换成稠密向量(降维的效果),这里的表示蕴含着一定的深意,使其能够表达出对象的一部分特征,同时向量之间的距离反映对象之间的相似性。 向量召回步骤:离线训练生成向量,在线向量检索。 1.离线训练生成向量 word2vec:词向量的鼻祖,由三层神经网络:输入层,隐藏层,输出层,隐藏层没有激活函数,输出层用了softmax计算概率。 目标函数 网络结构: 总的来说:输入是词语的序列,经过模型训练可以得到每个词语对应的向量。应用在推荐领域就是输入是用户的点击序列,经过模型训练得到每个商品的向量。 优劣:简单高效,但是只考虑了行为序列,没有考虑其他特征。 双塔模型: 网络结构:分别称为User塔和物品塔;其中User塔接收用户侧特征作为输入比如用户id、性别、年龄、感兴趣的三级品类、用户点击序列、用户地址等;Item塔接受商品侧特征,比如商品id、类目id、价格、近三天订单量等。数据训练:(正样本数据,1)(负样本,0)正样本:点击的商品,负样本:全局随机商品样本(或者同批次其他用户点击样本) 优劣:高效,完美契合召回特性,在线请求得到用户向量,检索召回item向量,泛化性高;用户塔和item塔割裂,只在最后做了交互。 2.在线向量检索 向量检索:是一种基于向量空间模型(Vector Space Model)的信息检索方法,用于在大规模文本集合中快速查找与查询向量最相似的文档向量。在信息检索、推荐系统、文本分类中得到广泛应用。 向量检索的过程是计算向量之间的相似度,最后返回相似度较高的TopK向量返回,而向量相似度计算有多种方式。计算向量相似性得方式有欧式距离、内积、余弦距离。归一化后,内积与余弦相似度计算公式等价。 向量检索的本质是近似近邻搜索(ANNS),尽可能减小查询向量的搜索范围,从而提高查询速度。 目前在工业界被大规模用到的向量检索算法基本可以分为以下3类: 局部敏感性哈希(LSH) 基于图(HNSW) 基于乘积量化 简单介绍LSH LSH算法的核心思想是:将原始数据空间中的两个相邻数据点通过相同的映射或投影变换后,这两个数据点在新的数据空间中仍然相邻的概率很大,而不相邻的数据点被映射到同一个桶的概率很小。 相比于暴力搜索遍历数据集中的所有点,而使用哈希,我们首先找到查询样本落入在哪个桶中,如果空间的划分是在我们想要的相似性度量下进行分割的,则查询样本的最近邻将极有可能落在查询样本的桶中,如此我们只需要在当前的桶中遍历比较,而不用在所有的数据集中进行遍历。当哈希函数数目H取得太大,查询样本与其对应的最近邻落入同一个桶中的可能性会变得很微弱,针对这个问题,我们可以重复这个过程L次(每一次都是不同得哈希函数),从而增加最近邻的召回率。 案例:基于word2vec实现向量召回 2.4排序 推荐系统的掌上明珠 排序阶段分为粗排和精排,粗排一般出现在在召回结果的数据量级比较大的时候。 进化历程 简单介绍Wide&Deep 背景:手动特征组合实现记忆性效果不错但是特征工程太耗费人力,并且未曾出现的特征组合无法记忆,不能进行泛化。 目的:使模型同时兼顾泛化和记忆能力(有效的利用历史信息并具有强大的表达能力)​ (1)记忆能力 模型直接学习并利用历史数据中物品或者特征共现频率的能力,记忆历史数据的分布特点,简单模型容易发现数据中对结果影响较大的特征或者组合特征,调整其权重实现对强特征的记忆 (2)泛化能力 模型传递特征的相关性,以及发掘稀疏或者从未出现过的稀有特征和最终标签相关性的能力,即使是非常稀疏的特征向量输入也能得到稳定平滑的推荐概率。提高泛化性的例子:矩阵分解,神经网络 兼顾记忆和泛化能力 (结果的准确性和扩展性) wide部分专注模型记忆,快速处理大量历史行为特征,deep部分专注模型泛化,探索新世界,模型传递特征的相关性,发掘稀疏甚至从外出现过的稀有特征与最终标签的相关性的能力,具有强大的表达能力。最终将wide部分和deep部分结合起来,形成统一的模型。 wide部分就是基础的线性模型,表示为y=W^T X+b X特征部分包括基础特征和交叉特征。交叉特征在wide部分很重要,可以捕捉到特征间的交互,起到添加非线性的作用。 deep部分为embeding层+三层神经网络(relu),前馈公式 联合训练 优劣:为推荐/广告/搜索排序算法之后的发展奠定了重要基础,从传统算法跨越到深度学习算法,里程碑意义。兼顾记忆和泛化能力但是Wide侧仍需要手工组合特征。 参考论文:Wide & Deep Learning for Recommender Systems 2.5 重排 定义:对精排后的结果顺序进行微调,一方面实现全局最优、一方面满足业务诉求提升用户体验。比如打散策略,强插策略,提高曝光,敏感过滤 MMR算法 实现商品多样性问题​ 目的:在推荐结果准确性的同时保证推荐结果的多样性,为了平衡推荐结果的多样性和相关性​ 算法原理,如公式​ D:商品集合,Q:用户,S:已被选中的商品集合, R\S:R中未被选中的商品集合​ def MMR(itemScoreDict, similarityMatrix, lambdaConstant=0.5, topN=20): #s 排序后列表 r 候选项 s, r = [], list(itemScoreDict.keys()) while len(r) > 0: score = 0 selectOne = None # 遍历所有剩余项 for i in r: firstPart = itemScoreDict[i] # 计算候选项与"已选项目"集合的最大相似度 secondPart = 0 for j in s: sim2 = similarityMatrix[i][j] if sim2 > second_part: secondPart = sim2 equationScore = lambdaConstant * (firstPart - (1 - lambdaConstant) * secondPart) if equationScore > score: score = equationScore selectOne = i if selectOne == None: selectOne = i # 添加新的候选项到结果集r,同时从s中删除 r.remove(selectOne) s.append(selectOne) return (s, s[:topN])[topN > len(s)] 意义是选择一个与用户最相关的同时跟已选择物品最不相关的物品。时间复杂度O(n2) 可以通过限制选择的个数进行降低时间复杂度​ 工程实现:需要用户和物品的相关性和物品之间的相似性作为输入,用户和物品的相关性可以用排序模型的结果作为代替,物品之间的相似性可以通过协同过滤等算法得到商品向量,计算余弦距离。也可以简单得是否同一三级类目、同一店铺等表征​ 三、总结 就简单唠叨这么多啦,主要想让大家了解一下推荐系统,向大家介绍一下整个推荐架构,以及整个推荐都有哪些模块。由于本人水平有限,每个模块也没有讲的特别细,希望之后能在工作中继续学习这个领域,深挖细节,产出更好的东西呈现给大家。感谢!!! 作者:京东零售 闫先东 来源:京东云开发者社区

优秀的个人博客,低调大师

并发编程-CompletableFuture解析 | 京东物流技术团队

1、CompletableFuture介绍 CompletableFuture对象是JDK1.8版本新引入的类,这个类实现了两个接口,一个是Future接口,一个是CompletionStage接口。 CompletionStage接口是JDK1.8版本提供的接口,用于异步执行中的阶段处理,CompletionStage定义了一组接口用于在一个阶段执行结束之后,要么继续执行下一个阶段,要么对结果进行转换产生新的结果等,一般来说要执行下一个阶段都需要上一个阶段正常完成,这个类也提供了对异常结果的处理接口 2、CompletableFuture的API 2.1 提交任务 在CompletableFuture中提交任务有以下几种方式: public static CompletableFuture<Void> runAsync(Runnable runnable) public static CompletableFuture<Void> runAsync(Runnable runnable, Executor executor) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier) public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier, Executor executor) 这四个方法都是用来提交任务的,不同的是supplyAsync提交的任务有返回值,runAsync提交的任务没有返回值。两个接口都有一个重载的方法,第二个入参为指定的线程池,如果不指定,则默认使用ForkJoinPool.commonPool()线程池。在使用的过程中尽量根据不同的业务来指定不同的线程池,方便对不同线程池进行监控,同时避免业务共用线程池相互影响。 2.2 结果转换 2.2.1 thenApply public <U> CompletableFuture<U> thenApply(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn, Executor executor) thenApply这一组函数入参是Function,意思是将上一个CompletableFuture执行结果作为入参,再次进行转换或者计算,重新返回一个新的值。 2.2.2 handle public <U> CompletableFuture<U> handle(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn) public <U> CompletableFuture<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn, Executor executor) handle这一组函数入参是BiFunction,该函数式接口有两个入参一个返回值,意思是处理上一个CompletableFuture的处理结果,同时如果有异常,需要手动处理异常。 2.2.3 thenRun public CompletableFuture<Void> thenRun(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action) public CompletableFuture<Void> thenRunAsync(Runnable action, Executor executor) thenRun这一组函数入参是Runnable函数式接口,该接口无需入参和出参,这一组函数是在上一个CompletableFuture任务执行完成后,在执行另外一个接口,不需要上一个任务的结果,也不需要返回值,只需要在上一个任务执行完成后执行即可。 2.2.4 thenAccept public CompletableFuture<Void> thenAccept(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action) public CompletableFuture<Void> thenAcceptAsync(Consumer<? super T> action, Executor executor) thenAccept这一组函数的入参是Consumer,该函数式接口有一个入参,没有返回值,所以这一组接口的意思是处理上一个CompletableFuture的处理结果,但是不返回结果。 2.2.5 thenAcceptBoth public <U> CompletableFuture<Void> thenAcceptBoth(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action) public <U> CompletableFuture<Void> thenAcceptBothAsync(CompletionStage<? extends U> other, BiConsumer<? super T, ? super U> action, Executor executor) thenAcceptBoth这一组函数入参包括CompletionStage以及BiConsumer,CompletionStage是JDK1.8新增的接口,在JDK中只有一个实现类:CompletableFuture,所以第一个入参就是CompletableFuture,这一组函数是用来接受两个CompletableFuture的返回值,并将其组合到一起。BiConsumer这个函数式接口有两个入参,并且没有返回值,BiConsumer的第一个入参就是调用方CompletableFuture的执行结果,第二个入参就是thenAcceptBoth接口入参的CompletableFuture的执行结果。所以这一组函数意思是将两个CompletableFuture执行结果合并到一起。 2.2.6 thenCombine public <U,V> CompletableFuture<V> thenCombine(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn, Executor executor) thenCombine这一组函数和thenAcceptBoth类似,入参都包含一个CompletionStage,也就是CompletableFuture对象,意思也是组合两个CompletableFuture的执行结果,不同的是thenCombine的第二个入参为BiFunction,该函数式接口有两个入参,同时有一个返回值。所以与thenAcceptBoth不同的是,thenCombine将两个任务结果合并后会返回一个全新的值作为出参。 2.2.7 thenCompose public <U> CompletableFuture<U> thenCompose(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T, ? extends CompletionStage<U>> fn, Executor executor) thenCompose这一组函数意思是将调用方的执行结果作为Function函数的入参,同时返回一个新的CompletableFuture对象。 2.3 回调方法 public CompletableFuture<T> whenComplete(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action) public CompletableFuture<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action, Executor executor) whenComplete方法意思是当上一个CompletableFuture对象任务执行完成后执行该方法。BiConsumer函数式接口有两个入参没有返回值,这两个入参第一个是CompletableFuture任务的执行结果,第二个是异常信息。表示处理上一个任务的结果,如果有异常,则需要手动处理异常,与handle方法的区别在于,handle方法的BiFunction是有返回值的,而BiConsumer是没有返回值的。 以上方法都有一个带有Async的方法,带有Async的方法表示是异步执行的,会将该任务放到线程池中执行,同时该方法会有一个重载的方法,最后一个参数为Executor,表示异步执行可以指定线程池执行。为了方便进行控制,最好在使用CompletableFuture时手动指定我们的线程池。 2.4 异常处理 public CompletableFuture<T> exceptionally(Function<Throwable, ? extends T> fn) exceptionally是用来处理异常的,当任务抛出异常后,可以通过exceptionally来进行处理,也可以选择使用handle来进行处理,不过两者有些不同,hand是用来处理上一个任务的结果,如果有异常情况,就处理异常。而exceptionally可以放在CompletableFuture处理的最后,作为兜底逻辑来处理未知异常。 2.5 获取结果 public static CompletableFuture<Void> allOf(CompletableFuture<?>... cfs) public static CompletableFuture<Object> anyOf(CompletableFuture<?>... cfs) allOf是需要入参中所有的CompletableFuture任务执行完成,才会进行下一步; anyOf是入参中任何一个CompletableFuture任务执行完成都可以执行下一步。 public T get() throws InterruptedException, ExecutionException public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException public T getNow(T valueIfAbsent) public T join() get方法一个是不带超时时间的,一个是带有超时时间的。 getNow方法则是立即返回结果,如果还没有结果,则返回默认值,也就是该方法的入参。 join方法是不带超时时间的等待任务完成。 3、CompletableFuture原理 join方法同样表示获取结果,但是join与get方法有什么区别呢。 public T join() { Object r; return reportJoin((r = result) == null ? waitingGet(false) : r); } public T get() throws InterruptedException, ExecutionException { Object r; return reportGet((r = result) == null ? waitingGet(true) : r); } public T get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { Object r; long nanos = unit.toNanos(timeout); return reportGet((r = result) == null ? timedGet(nanos) : r); } public T getNow(T valueIfAbsent) { Object r; return ((r = result) == null) ? valueIfAbsent : reportJoin(r); } 以上是CompletableFuture类中两个方法的代码,可以看到两个方法几乎一样。区别在于reportJoin/reportGet,waitingGet方法是一致的,只不过参数不一样,我们在看下reportGet与reportJoin方法。 private static <T> T reportGet(Object r) throws InterruptedException, ExecutionException { if (r == null) // by convention below, null means interrupted throw new InterruptedException(); if (r instanceof AltResult) { Throwable x, cause; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if ((x instanceof CompletionException) && (cause = x.getCause()) != null) x = cause; throw new ExecutionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } private static <T> T reportJoin(Object r) { if (r instanceof AltResult) { Throwable x; if ((x = ((AltResult)r).ex) == null) return null; if (x instanceof CancellationException) throw (CancellationException)x; if (x instanceof CompletionException) throw (CompletionException)x; throw new CompletionException(x); } @SuppressWarnings("unchecked") T t = (T) r; return t; } 可以看到这两个方法很相近,reportGet方法判断了r对象是否为空,并抛出了中断异常,而reportJoin方法没有判断,同时reportJoin抛出的都是运行时异常,所以join方法也是无需手动捕获异常的。 我们在看下waitingGet方法 private Object waitingGet(boolean interruptible) { Signaller q = null; boolean queued = false; int spins = -1; Object r; while ((r = result) == null) { if (spins < 0) spins = SPINS; else if (spins > 0) { if (ThreadLocalRandom.nextSecondarySeed() >= 0) --spins; } else if (q == null) q = new Signaller(interruptible, 0L, 0L); else if (!queued) queued = tryPushStack(q); else if (interruptible && q.interruptControl < 0) { q.thread = null; cleanStack(); return null; } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q != null) { q.thread = null; if (q.interruptControl < 0) { if (interruptible) r = null; // report interruption else Thread.currentThread().interrupt(); } } postComplete(); return r; } 该waitingGet方法是通过while的方式循环判断是否任务已经完成并产生结果,如果结果为空,则会一直在这里循环,这里需要注意的是在这里初始化了一下spins=-1,当第一次进入while循环的时候,spins是-1,这时会将spins赋值为一个常量,该常量为SPINS。 private static final int SPINS = (Runtime.getRuntime().availableProcessors() > 1 ? 1 << 8 : 0); 这里判断可用CPU数是否大于1,如果大于1,则该常量为 1<< 8,也就是256,否则该常量为0。 第二次进入while循环的时候,spins是256大于0,这里做了减一的操作,下次进入while循环,如果还没有结果,依然是大于0继续做减一的操作,此处用来做短时间的自旋等待结果,只有当spins等于0,后续会进入正常流程判断。 我们在看下timedGet方法的源码 private Object timedGet(long nanos) throws TimeoutException { if (Thread.interrupted()) return null; if (nanos <= 0L) throw new TimeoutException(); long d = System.nanoTime() + nanos; Signaller q = new Signaller(true, nanos, d == 0L ? 1L : d); // avoid 0 boolean queued = false; Object r; // We intentionally don't spin here (as waitingGet does) because // the call to nanoTime() above acts much like a spin. while ((r = result) == null) { if (!queued) queued = tryPushStack(q); else if (q.interruptControl < 0 || q.nanos <= 0L) { q.thread = null; cleanStack(); if (q.interruptControl < 0) return null; throw new TimeoutException(); } else if (q.thread != null && result == null) { try { ForkJoinPool.managedBlock(q); } catch (InterruptedException ie) { q.interruptControl = -1; } } } if (q.interruptControl < 0) r = null; q.thread = null; postComplete(); return r; } timedGet方法依然是通过while循环的方式来判断是否已经完成,timedGet方法入参为一个纳秒值,并通过该值计算出一个deadline截止时间,当while循环还未获取到任务结果且已经达到截止时间,则抛出一个TimeoutException异常。 4、CompletableFuture实现多线程任务 这里我们通过CompletableFuture来实现一个多线程处理异步任务的例子。 这里我们创建10个任务提交到我们指定的线程池中执行,并等待这10个任务全部执行完毕。 每个任务的执行流程为第一次先执行加法,第二次执行乘法,如果发生异常则返回默认值,当10个任务执行完成后依次打印每个任务的结果。 public void demo() throws InterruptedException, ExecutionException, TimeoutException { // 1、自定义线程池 ExecutorService executorService = new ThreadPoolExecutor(5, 10, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(100)); // 2、集合保存future对象 List<CompletableFuture<Integer>> futures = new ArrayList<>(10); for (int i = 0; i < 10; i++) { int finalI = i; CompletableFuture<Integer> future = CompletableFuture // 提交任务到指定线程池 .supplyAsync(() -> this.addValue(finalI), executorService) // 第一个任务执行结果在此处进行处理 .thenApplyAsync(k -> this.plusValue(finalI, k), executorService) // 任务执行异常时处理异常并返回默认值 .exceptionally(e -> this.defaultValue(finalI, e)); // future对象添加到集合中 futures.add(future); } // 3、等待所有任务执行完成,此处最好加超时时间 CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).get(5, TimeUnit.MINUTES); for (CompletableFuture<Integer> future : futures) { Integer num = future.get(); System.out.println("任务执行结果为:" + num); } System.out.println("任务全部执行完成!"); } private Integer addValue(Integer index) { System.out.println("第" + index + "个任务第一次执行"); if (index == 3) { int value = index / 0; } return index + 3; } private Integer plusValue(Integer index, Integer num) { System.out.println("第" + index + "个任务第二次执行,上次执行结果:" + num); return num * 10; } private Integer defaultValue(Integer index, Throwable e) { System.out.println("第" + index + "个任务执行异常!" + e.getMessage()); e.printStackTrace(); return 10; } 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

并发编程-FutureTask解析 | 京东物流技术团队

1、FutureTask对象介绍 Future对象大家都不陌生,是JDK1.5提供的接口,是用来以阻塞的方式获取线程异步执行完的结果。 在Java中想要通过线程执行一个任务,离不开Runnable与Callable这两个接口。 Runnable与Callable的区别在于,Runnable接口只有一个run方法,该方法用来执行逻辑,但是并没有返回值;而Callable的call方法,同样用来执行业务逻辑,但是是有一个返回值的。 Callable执行任务过程中可以通过FutureTask获得任务的执行状态,并且可以在执行完成后通过Future.get()方式获取执行结果。 Future是一个接口,而FutureTask就是Future的实现类。并且FutureTask实现了 RunnableFuture(Runnable + Future),说明我们可以创建一个FutureTask并直接把它放到线程池执行,然后获取FutureTask的执行结果。 2、FutureTask源码解析 2.1 主要方法和属性 那么FutureTask是如何通过阻塞的方式来获取到异步线程执行的结果的呢?我们看下FutureTask中的属性。 // FutureTask的状态及其常量 private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; // callable对象,执行完后置空 private Callable<V> callable; // 要返回的结果或要引发的异常来自 get() 方法 private Object outcome; // non-volatile, protected by state reads/writes // 执行Callable的线程 private volatile Thread runner; // 等待线程的一个链表结构 private volatile WaitNode waiters; FutureTask中几个比较重要的方法。 // 取消任务的执行 boolean cancel(boolean mayInterruptIfRunning); // 返回任务是否已经被取消 boolean isCancelled(); // 返回任务是否已经完成,任务状态不为NEW即为完成 boolean isDone(); // 通过get方法获取任务的执行结果 V get() throws InterruptedException, ExecutionException; // 通过get方法获取任务的执行结果,带有超时,如果超过给定时间则抛出异常 V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException; 2.2 FutureTask执行 当我们在线程池中执行一个Callable方法时,其实是将Callable任务封装成一个RunnableFuture对象去执行,同时将这个RunnableFuture对象返回,这样我们就拿到了FutureTask的引用,可以随时获取到任务执行的状态,并且可以在任务执行完成后通过该对象获取执行结果。 以下为ThreadPoolExecutor线程池提交一个callable方法的源码。 public <T> Future<T> submit(Callable<T> task) { if (task == null) throw new NullPointerException(); RunnableFuture<T> ftask = newTaskFor(task); execute(ftask); return ftask; } protected <T> RunnableFuture<T> newTaskFor(Callable<T> callable) { return new FutureTask<T>(callable); } 2.3 run方法介绍 RunnableFuture其实也是一个可以执行的runnable,我们看下他的run方法。其主要流程就是执行call方法,正常执行完毕后将result结果赋值到outcome属性上。 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { // 将callable赋值到本地变量 Callable<V> c = callable; // 判断callable不为空并且FutureTask的状态必须为新创建 if (c != null && state == NEW) { V result; boolean ran; try { // 执行call方法(用户自己实现的call逻辑),并获取到result结果 result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; // 如果执行过程出现异常,则将异常对象赋值到outcome上 setException(ex); } // 如果正常执行完毕,则将result赋值到outcome属性上 if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } 以下逻辑为正常执行完成后赋值的逻辑。 // 如果任务没有被取消,将future执行完的返回值赋值给result结果 // FutureTask任务的执行状态是通过CAS的方式进行赋值的,并且由此可知,COMPLETING其实是一个瞬时状态 // 当将线程执行结果赋值给outcome后,状态会修改为对应的NORMAL,即正常结束 protected void set(V v) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = v; UNSAFE.putOrderedInt(this, stateOffset, NORMAL); // final state finishCompletion(); } } 以下为执行异常时赋值逻辑,直接将Throwable对象赋值到outcome属性上。 protected void setException(Throwable t) { if (UNSAFE.compareAndSwapInt(this, stateOffset, NEW, COMPLETING)) { outcome = t; UNSAFE.putOrderedInt(this, stateOffset, EXCEPTIONAL); // final state finishCompletion(); } } 无论是正常执行还是异常执行,最终都会调用一个finishCompletion方法,用来做工作的收尾工作。 2.4 get方法介绍 Future的get方法有两个重载的方法,一个是get()获取结果,一个是get(long, TimeUnit)带有超时时间的获取结果,我们看下FutureTask中的这两个方法是如何实现的。 // 不带有超时时间,一直阻塞直到获取结果 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) // 等待结果完成,带有超时的get方法也是调用的awaitDone方法 s = awaitDone(false, 0L); // 返回结果 return report(s); } // 带有超时时间的获取结果,如果超过时间还没有获取到结果则抛出异常 public V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException { if (unit == null) throw new NullPointerException(); int s = state; // 如果任务未中断,调用awaitDone方法等待任务结果 if (s <= COMPLETING && (s = awaitDone(true, unit.toNanos(timeout))) <= COMPLETING) throw new TimeoutException(); // 返回结果 return report(s); } 我们主要看下awaitDone方法的执行逻辑。此方法会通过for循环的方式一直阻塞等待任务执行完成。如果带有超时时间,则超过截止时间后会直接返回。 // timed:是否需要超时获取 // nanos:超时时间单位纳秒 private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; // 此方法会一直for循环判断任务状态是否已经完成,是Future.get阻塞的原因 for (;;) { if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } int s = state; // 任务状态大于COMPLETING,则表明任务结束,直接返回 if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet // Thread.yield() 方法,使当前线程由执行状态,变成为就绪状态,让出cpu时间,在下一个线程执行时候,此线程有可能被执行,也有可能没有被执行。 // COMPLETING状态为瞬时状态,任务执行完成,要么是正常结束,要么异常结束,后续会被置为NORMAL或者EXCEPTIONAL Thread.yield(); else if (q == null) // 每调用一次get方法,都会创建一个WaitNode等待节点 q = new WaitNode(); else if (!queued) // 将该等待节点添加到链表结构waiters中,q.next = waiters 即在waiters的头部插入 queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); // 如果方法带有超时判断,则判断当前时间是否已经超过了截止时间,如果超过了及截止日期,则退出循环直接返回当前状态,此时任务状态一定是NEW else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) { removeWaiter(q); return state; } LockSupport.parkNanos(this, nanos); } else LockSupport.park(this); } } 我们在看下report方法,在调用get方法时是如何返回结果的。 这里首先获取outcome的值,并判断任务是否已经执行完成,如果执行完成,则将outcome对象强转成泛型指定的类型;如果任务被取消了,则抛出一个CancellationException异常;如果都不是,则说明任务在执行过程中发生了异常,此时任务状态位EXCEPTIONAL,此时的outcome即为Throwable对象,所以将outcome强转为Throwable并抛出异常。 由此可以知道,我们将一个FutureTask任务submit到线程池中执行的时候,如果发生了异常,是会在调用get方法的时候抛出的。 private V report(int s) throws ExecutionException { Object x = outcome; if (s == NORMAL) return (V)x; if (s >= CANCELLED) throw new CancellationException(); throw new ExecutionException((Throwable)x); } 2.5 cancel方法介绍 cancel方法用于取消正在运行的任务,如果任务取消成功,则返回TRUE,如果取消失败则返回FALSE。 // mayInterruptIfRunning:允许中断正在运行的任务 public boolean cancel(boolean mayInterruptIfRunning) { // mayInterruptIfRunning如果为true则将状态置为INTERRUPTING,如果未false则将状态置为CANCELLED if (!(state == NEW && UNSAFE.compareAndSwapInt(this, stateOffset, NEW, mayInterruptIfRunning ? INTERRUPTING : CANCELLED))) return false; // 如果状态修改成功后,判断是否允许中断线程,如果允许,则调用Thread的interrupt方法中断 try { // in case call to interrupt throws exception if (mayInterruptIfRunning) { try { Thread t = runner; if (t != null) t.interrupt(); } finally { // final state UNSAFE.putOrderedInt(this, stateOffset, INTERRUPTED); } } } finally { // 取消后的收尾工作 finishCompletion(); } return true; } 2.6 isDone/isCancelled方法介绍 isDone方法用于判断FutureTask是否已经完成;isCancelled方法用来判断FutureTask是否已经取消,这两个方法都是通过状态位来判断的。 public boolean isCancelled() { return state >= CANCELLED; } public boolean isDone() { return state != NEW; } 2.7 finishCompletion方法介绍 我们看下finishCompletion方法都做了哪些工作。 // 删除所有等待线程并发出信号,最后执行done方法 private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t); } WaitNode next = q.next; if (next == null) break; q.next = null; // unlink to help gc q = next; } break; } } done(); callable = null; // to reduce footprint } 我们看到done方法是一个受保护的空方法,此处没有任何逻辑,由其子类去根据自己的业务去实现相应的逻辑。例如:java.util.concurrent.ExecutorCompletionService.QueueingFuture。 protected void done() { } 3、总结 通过源码解读可以了解到Future的原理: 第一步:主线程将任务封装成一个Callable对象,通过submit方法提交到线程池去执行。 第二步:线程池执行任务的run方法,主线程则可以继续执行其他逻辑。 第三步:线程池中方法执行完成后将结果赋值到outcome属性上,并修改任务状态。 第四步:主线程在需要拿到异步任务结果的时候,主动调用fugure.get()方法来获取结果。 第五步:如果异步线程在执行过程中发生异常,则会在调用future.get()方法的时候抛出来。 以上就是对于FutureTask的分析,我们可以了解FutureTask任务执行的方式以及Future.get已阻塞的方式获取线程执行的结果原理,并且从代码中可以了解FutureTask的任务执行状态以及状态的变化过程。 作者:京东物流 丁冬 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

JVM GC配置指南 | 京东云技术团队

本文旨在简明扼要说明各回收器调优参数,如有疏漏欢迎指正。 1、JDK版本 以下所有优化全部基于JDK8版本,强烈建议低版本升级到JDK8,并尽可能使用update_191以后版本。 2、如何选择垃圾回收器 响应优先应用:面向C端对响应时间敏感的应用,堆内存8G以上建议选择G1,堆内存较小或低版本JDK选择CMS; 吞吐量优先应用:对响应时间不敏感,以高吞吐量为目标的应用(如MQ、Worker),建议选择ParallelGC; 3、各回收器优化参数 1)基本参数配置(所有应用、所有回收器都需要): -Xmx(一般为容器内存的50%) -Xms(与Xmx一致) -XX:MetaspaceSize(通常256M~512M) -XX:ParallelGCThreads=容器核数 -XX:CICompilerCount=容器核数(必须大于等于2) 2)ParallelGC 除以上参数外,一般不需要额外调优(JDK8默认回收器) 3)CMS -XX:+UseConcMarkSweepGC -Xmn (一般为堆内存的三分之一),尤其是配置了ParallelGCThreads后必须配置此参数 -XX:ConcGCThreads=n(默认为ParallelGCThreads/4,可视情况调整至ParallelGCThreads/2) -XX:+UseCMSInitiatingOccupancyOnly -XX:CMSInitiatingOccupancyFraction=70(推荐值) 4)G1 -XX:+UseG1GC -XX:ConcGCThreads=n(默认为ParallelGCThreads/4,可视情况调整至ParallelGCThreads/2) -XX:G1HeapRegionSize=8m(若堆内存在8G以内且有较多大对象推荐设置此值) *注意不要设置-Xmn 和 XX:NewRatio 5)其他调优参数 -XX:+ParallelRefProcEnabled 如果GC时Reference处理时间较长,例如大量使用WeakReference对象,可以通过此参数开启并行处理 4、开启GC日志 -XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/export/Logs/gc.log 5、如何判断GC是否正常 1)GC是否频繁:YoungGC频率一般几十秒钟一次,FullGC一般每天几次,注意G1回收器不应该出现FullGC; 2)GC耗时:耗时主要取决于堆内存大小及垃圾对象数量。YoungGC时间通常应在几十毫秒,FullGC通常在几百毫秒; 3)每次GC内存是否下降:应用刚启动时,每次YoungGC内存应该回收到较低水位,随着时间推移老年代逐步增多,内存水位会逐步上涨,直到FullGC/MixedGC(G1),内存会再次回到较低水位,否则可能存在内存泄漏; 4)如果使用ParallelGC,堆内存耗尽才会触发FullGC,所以不用配置堆内存使用率告警,但需关注GC频率; 5)泰山上可以巡检部分JVM配置。 作者:京东零售王利辉 来源:京东云开发者社区

优秀的个人博客,低调大师

SpringIoc容器之Aware | 京东云技术团队

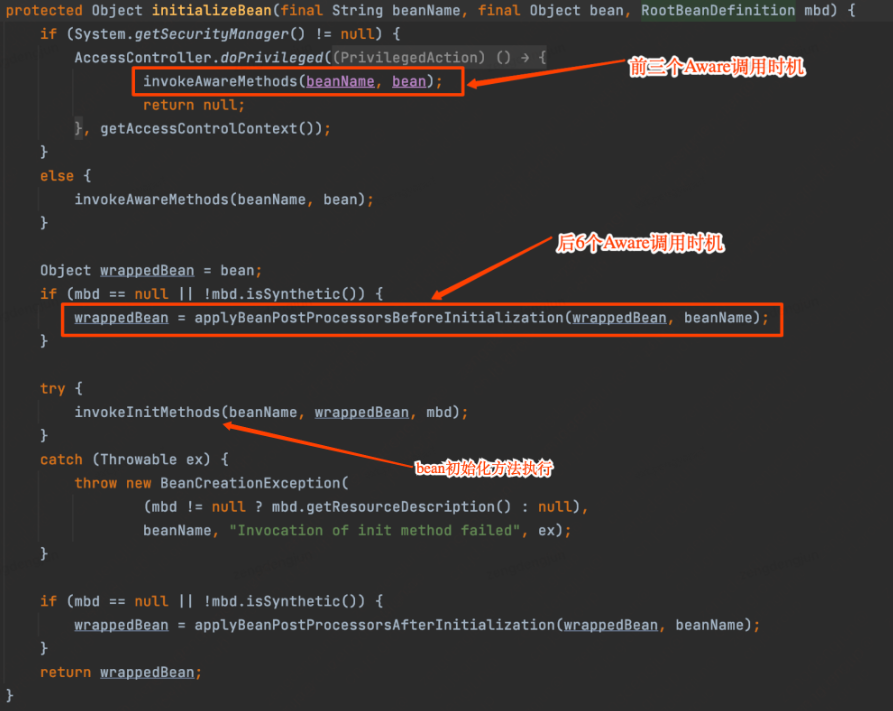
1 前言 Aware是Spring提供的一个标记超接口,指示bean有资格通过回调样式的方法由Spring容器通知特定的框架对象,以获取到容器中特有对象的实例的方法之一。实际的方法签名由各个子接口确定,但通常只包含一个接受单个参数的void返回方法。 2 Spring中9个Aware内置实现 |--Aware |--BeanNameAware |--BeanClassLoaderAware |--BeanFactoryAware |--EnvironmentAware |--EmbeddedValueResolverAware |--ResourceLoaderAware |--ApplicationEventPublisherAware |--MessageSourceAware |--ApplicationContextAware 9个内置实现又分两类,前三个为直接调用,后6个通过ApplicationContextAwareProcessor后置处理器,间接回调 2.1 BeanNameAware public interface BeanNameAware extends Aware { /** *设置创建此bean的bean工厂中的bean的名称。 *在普通bean属性填充之后但在 *初始化之前回调,如{@link InitializingBean#afterPropertiesSet()} *或自定义初始化方法。 * @param name工厂中bean的名称。 *注意,此名称是工厂中使用的实际bean名称,这可能 *与最初指定的名称不同:特别是对于内部bean * names,实际的bean名称可以通过添加 *“#…”后缀。使用{@link BeanFactoryUtils#originalBeanName(String)} *方法提取原始bean名称(不带后缀),如果需要的话。 * / void setBeanName(String name); } 实现BeanNameAware接口需要实现setBeanName()方法,这个方法只是简单的返回我们当前的beanName,这个接口表面上的作用就是让实现这个接口的bean知道自己在spring容器里的名字,而且官方的意思是这个接口更多的使用在spring的框架代码中,实际开发环境应该不建议使用,因为spring认为bean的名字与bean的联系并不是很深,(的确,抛开spring API而言,我们如果获取了该bean的名字,其实意义不是很大,我们没有获取该bean的class,只有该bean的名字,我们也无从下手,相反,因为bean的名称在spring容器中可能是该bean的唯一标识,也就是说再beanDefinitionMap中,key值就是这个name,spring可以根据这个key值获取该bean的所有特性)所以spring说这个不是非必要的依赖。 2.2 BeanClassLoaderAware public interface BeanClassLoaderAware extends Aware { /** *提供bean {@link ClassLoader}类加载器的回调 *一个bean实例在属性的填充之后但在初始化回调之前调用 * {@link InitializingBean * {@link InitializingBean#afterPropertiesSet()} *方法或自定义初始化方法。 * @param类加载器拥有的类加载器;可能是{@code null}在例如,必须使用默认的{@code ClassLoader} * 获取的{@code ClassLoader} * {@link org.springframework.util.ClassUtils#getDefaultClassLoader()} * / void setBeanClassLoader(ClassLoader classLoader); } 在bean属性填充之后初始化之前,提供类加制器的回调。让受管Bean本身知道它是由哪一类装载器负责装载的。 2.3 BeanFactoryAware public interface BeanFactoryAware extends Aware { /** * 为bean实例提供所属工厂的回调。 * 在普通bean属性填充之后调用但在初始化回调之前,如 * {@link InitializingBean#afterPropertiesSet()}或自定义初始化方法。 * @param beanFactory拥有beanFactory(非空)。bean可以立即调用工厂上的方法。 * @在初始化错误时抛出BeansException * @参见BeanInitializationException * / void setBeanFactory(BeanFactory beanFactory) throws BeansException; } 在bean属性填充之后初始化之前,提bean工厂的回调。实现 BeanFactoηAware 接口的 bean 可以直接访问 Spring 容器,被容器创建以后,它会拥有一个指向 Spring 容器的引用,可以利用该bean根据传入参数动态获取被spring工厂加载的bean 2.4 EnvironmentAware public interface EnvironmentAware extends Aware { /** * 设置该对象运行的{@code环境}。 */ void setEnvironment(Environment environment); } 设置该对象运行的。所有注册到 Spring容器内的 bean,只要该bean 实现了 EnvironmentAware接口,并且进行重写了setEnvironment方法的情况下,那么在工程启动时就可以获取得 application.properties 的配置文件配置的属性值,这样就不用我们将魔法值写到代码里面了。 2.5 EmbeddedValueResolverAware public interface EmbeddedValueResolverAware extends Aware { /** * 设置StringValueResolver用于解析嵌入的定义值。 */ void setEmbeddedValueResolver(StringValueResolver resolver); } 在基于Spring获取properties文件属性值的时候,一般使用@Value的方式注入配置文件属性值,但是@Value必须要在Spring的Bean生命周期管理下才能使用,比如类被@Controller、@Service、@Component等注解标注。如有的抽象类中,基于Spring解析@Value的方式,使用EmbeddedValueResolverAware解析配置文件来实现。 2.6 ResourceLoaderAware public interface ResourceLoaderAware extends Aware { /** *设置该对象运行的ResourceLoader。这可能是一个ResourcePatternResolver,它可以被检查 *通过{@code instanceof ResourcePatternResolver}。另请参阅 * {@code ResourcePatternUtils。getResourcePatternResolver}方法。 * <p>在填充普通bean属性之后但在init回调之前调用 *像InitializingBean的{@code afterPropertiesSet}或自定义初始化方法。 *在ApplicationContextAware的{@code setApplicationContext}之前调用。 * @param resourceLoader该对象使用的resourceLoader对象 * @ @ springframework.core. io.support.resourcepatternresolver * @ @ resourcepatternutils #获取resourcepatternresolver * / void setResourceLoader(ResourceLoader resourceLoader); } ResourceLoaderAware 是特殊的标记接口,它希望拥有一个 ResourceLoader 引用的对象。当实现了 ResourceLoaderAware接口的类部署到application context(比如受Spring管理的bean)中时,它会被application context识别为 ResourceLoaderAware。 接着application context会调用setResourceLoader(ResourceLoader)方法,并把自身作为参数传入该方法(记住,所有Spring里的application context都实现了ResourceLoader接口)。 既然 ApplicationContext 就是ResourceLoader,那么该bean就可以实现 ApplicationContextAware接口并直接使用所提供的application context来载入资源,但是通常更适合使用特定的满足所有需要的 ResourceLoader 实现。 这样一来,代码只需要依赖于可以看作辅助接口的资源载入接口,而不用依赖于整个Spring ApplicationContext 接口。 2.7 ApplicationEventPublisherAware public interface ApplicationEventPublisherAware extends Aware { /** *设置该对象运行的ApplicationEventPublisher。 * <p>在普通bean属性填充之后但在init之前调用像InitializingBean的afterPropertiesSet或自定义初始化方法。 *在ApplicationContextAware的setApplicationContext之前调用。 *该对象使用的事件发布者 * / void setApplicationEventPublisher(ApplicationEventPublisher applicationEventPublisher); } ApplicationEventPublisherAware 是由 Spring 提供的用于为 Service 注入 ApplicationEventPublisher 事件发布器的接口,使用这个接口,我们自己的 Service 就拥有了发布事件的能力。 2.8 MessageSourceAware public interface MessageSourceAware extends Aware { /** *设置该对象运行的MessageSource。 * <p>在普通bean属性填充之后但在init之前调用像InitializingBean的afterPropertiesSet或自定义初始化方法。 *在ApplicationContextAware的setApplicationContext之前调用。 * @param messageSource消息源 * / void setMessageSource(MessageSource messageSource); } 获得message source这样可以获得文本信息,使用场景如为了国际化。 2.9 ApplicationContextAware public interface ApplicationContextAware extends Aware { /** *设置该对象运行的ApplicationContext。通常这个调用将用于初始化对象。 * <p>在普通bean属性填充之后但在init回调之前调用 *作为{@link org.springframework.beans.factory.InitializingBean#afterPropertiesSet()} *或自定义初始化方法。在{@link ResourceLoaderAware#setResourceLoader}之后调用, * {@link ApplicationEventPublisherAware#setApplicationEventPublisher}和 * {@link MessageSourceAware},如果适用。 * @param applicationContext该对象将使用的applicationContext对象 * @在上下文初始化错误时抛出ApplicationContextException如果由应用程序上下文方法抛出,则抛出BeansException * @see org.springframework.beans.factory.BeanInitializationException * / void setApplicationContext(ApplicationContext applicationContext) throws BeansException; } ApplicationContextAware的作用是可以方便获取Spring容器ApplicationContext,从而可以获取容器内的Bean。ApplicationContextAware接口只有一个方法,如果实现了这个方法,那么Spring创建这个实现类的时候就会自动执行这个方法,把ApplicationContext注入到这个类中,也就是说,spring 在启动的时候就需要实例化这个 class(如果是懒加载就是你需要用到的时候实例化),在实例化这个 class 的时候,发现它包含这个 ApplicationContextAware 接口的话,sping 就会调用这个对象的 setApplicationContext 方法,把 applicationContext Set 进去了。 3 Spring中调用时机 Aware接口由Spring在AbstractAutowireCapableBeanFactory.initializeBean(beanName, bean,mbd)方法中通过调用invokeAwareMethods(beanName, bean)方法和applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName)触发Aware方法的调用 3.1 invokeAwareMethods private void invokeAwareMethods(final String beanName, final Object bean) { if (bean instanceof Aware) { if (bean instanceof BeanNameAware) { ((BeanNameAware) bean).setBeanName(beanName); } if (bean instanceof BeanClassLoaderAware) { ((BeanClassLoaderAware) bean).setBeanClassLoader(getBeanClassLoader()); } if (bean instanceof BeanFactoryAware) { ((BeanFactoryAware) bean).setBeanFactory(AbstractAutowireCapableBeanFactory.this); } } } 判断并直接回调 3.2 applyBeanPostProcessorsBeforeInitialization public Object applyBeanPostProcessorsBeforeInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; for (BeanPostProcessor beanProcessor : getBeanPostProcessors()) { result = beanProcessor.postProcessBeforeInitialization(result, beanName); if (result == null) { return result; } } return result; } 通过ApplicationContextAwareProcessor.postProcessBeforeInitialization(Object bean, String beanName)间接调用,并在方法invokeAwareInterfaces中进行回调。 public Object postProcessBeforeInitialization(final Object bean, String beanName) throws BeansException { AccessControlContext acc = null; if (System.getSecurityManager() != null && (bean instanceof EnvironmentAware || bean instanceof EmbeddedValueResolverAware || bean instanceof ResourceLoaderAware || bean instanceof ApplicationEventPublisherAware || bean instanceof MessageSourceAware || bean instanceof ApplicationContextAware)) { acc = this.applicationContext.getBeanFactory().getAccessControlContext(); } if (acc != null) { AccessController.doPrivileged(new PrivilegedAction<Object>() { @Override public Object run() { invokeAwareInterfaces(bean); return null; } }, acc); } else { invokeAwareInterfaces(bean); } return bean; } private void invokeAwareInterfaces(Object bean) { if (bean instanceof Aware) { if (bean instanceof EnvironmentAware) { ((EnvironmentAware) bean).setEnvironment(this.applicationContext.getEnvironment()); } if (bean instanceof EmbeddedValueResolverAware) { ((EmbeddedValueResolverAware) bean).setEmbeddedValueResolver( new EmbeddedValueResolver(this.applicationContext.getBeanFactory())); } if (bean instanceof ResourceLoaderAware) { ((ResourceLoaderAware) bean).setResourceLoader(this.applicationContext); } if (bean instanceof ApplicationEventPublisherAware) { ((ApplicationEventPublisherAware) bean).setApplicationEventPublisher(this.applicationContext); } if (bean instanceof MessageSourceAware) { ((MessageSourceAware) bean).setMessageSource(this.applicationContext); } if (bean instanceof ApplicationContextAware) { ((ApplicationContextAware) bean).setApplicationContext(this.applicationContext); } } } 4 总结 通过上面的分析,可以知道Spring生命周期中的初始化方法里,在真正执行初始化方法之前,分别通过invokeAwareMethods方法和后置处理器ApplicationContextAwareProcessor来触发Aware的调用,那么,Spring为什么要使用两种方式而不使用其中之一呢? 通过本章我们了解了9中内置接口的作用,以及它们能够获取到的不同上下文信息。 作者:京东零售 曾登均 来源:京东云开发者社区

优秀的个人博客,低调大师

Spring源码核心剖析 | 京东云技术团队

前言 SpringAOP作为Spring最核心的能力之一,其重要性不言而喻。然后需要知道的是AOP并不只是Spring特有的功能,而是一种思想,一种通用的功能。而SpringAOP只是在AOP的基础上将能力集成到SpringIOC中,使其作为bean的一种,从而我们能够很方便的进行使用。 一、SpringAOP的使用方式 1.1 使用场景 当我们在日常业务开发中,例如有些功能模块是通用的(日志、权限等),或者我们需要在某些功能前后去做一些增强,例如在某些方法执行后发送一条mq消息等。 如果我们将这些通用模块代码与业务代码放在一块,那么每个业务代码都要写这些通用模块,维护成本与耦合情况都十分严重。 因此,我们可以将此模块抽象出来,就有了”切面“的概念。 1.2 常用方式 AOP的使用方式相对比较简单,首先我们需要完成业务代码 @Service public class AopDemo implements AopInterface{ public Student start(String name) { System.out.println("执行业务逻辑代码....."); return new Student(name); } } 业务逻辑比较简单,接收一个name参数。 接下来我们需要创建其对应的切面 //将该切面加入spring容器 @Service //声明该类为一个切面 @Aspect class AopAspect { //声明要进行代理的方法 @Pointcut("execution(* com.example.demo.aop.AopInterface.start(..))") public void startAspect() { } //在方法执行之前的逻辑 @Before(value = "startAspect()") public void beforeAspect() { System.out.println("业务逻辑前代码....."); } //在方法执行之后的逻辑 @After(value = "startAspect()") public void afterAspect() { System.out.println("业务逻辑后代码....."); } //围绕方法前后的逻辑 @Around("startAspect()") public Object aroundAspect(ProceedingJoinPoint point) throws Throwable { Object[] requestParams = point.getArgs(); String name = requestParams[0].toString(); System.out.println("传入参数:" + name); requestParams[0] = "bob"; return point.proceed(requestParams); } } 可以看到,首先需要我们指明要代理的对象及方法,然后根据需要选择不同的注解即可实现代理对象。 传入参数:tom 业务逻辑前代码..... 执行业务逻辑代码..... 业务逻辑后代码..... 二、SpringAOP源码解析 2.1 被代理对象的开始initializeBean 根据上面的使用情况,我们知道只需要声明对应的注解即可,不需要其他额外的配置,然后我们获得的bean对象就已经是被代理的了,那么我们可以推断代理对象的过程一定是发生在bean创建的过程的。 我们回顾一下创建bean的流程 实例化bean 装配属性 初始化bean 只有第三步初始化bean的时候才会有机会进行代理。 找到对应的代码位置: protected Object initializeBean(String beanName, Object bean, @Nullable RootBeanDefinition mbd) { Object wrappedBean = bean; if (mbd == null || !mbd.isSynthetic()) { //前置处理器 wrappedBean = applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName); } //... try { //对象的初始化方法 invokeInitMethods(beanName, wrappedBean, mbd); } if (mbd == null || !mbd.isSynthetic()) { //后置处理器,AOP开始的地方 wrappedBean = applyBeanPostProcessorsAfterInitialization(wrappedBean, beanName); } return wrappedBean; } 2.2 后置处理器applyBeanPostProcessorsAfterInitialization 后置处理器会执行那些实现了后置处理器接口的代码: public Object applyBeanPostProcessorsAfterInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; //获取所有的后置处理器 for (BeanPostProcessor processor : getBeanPostProcessors()) { //实现其要执行的方法 Object current = processor.postProcessAfterInitialization(result, beanName); if (current == null) { return result; } result = current; } return result; } 而AOP的后置处理器就是其中的一个: AbstractAutoProxyCreator 其对应的方法为(以下代码不为同一个类,而是对应的执行顺序): public Object postProcessAfterInitialization(@Nullable Object bean, String beanName) { if (bean != null) { Object cacheKey = getCacheKey(bean.getClass(), beanName); if (this.earlyProxyReferences.remove(cacheKey) != bean) { //执行到下面方法 return wrapIfNecessary(bean, beanName, cacheKey); } } return bean; } protected Object wrapIfNecessary(Object bean, String beanName, Object cacheKey) { // Create proxy if we have advice. Object[] specificInterceptors = getAdvicesAndAdvisorsForBean(bean.getClass(), beanName, null); if (specificInterceptors != DO_NOT_PROXY) { this.advisedBeans.put(cacheKey, Boolean.TRUE); //创建代理对象 Object proxy = createProxy( bean.getClass(), beanName, specificInterceptors, new SingletonTargetSource(bean)); this.proxyTypes.put(cacheKey, proxy.getClass()); return proxy; } this.advisedBeans.put(cacheKey, Boolean.FALSE); return bean; } protected Object createProxy(Class beanClass, @Nullable String beanName, @Nullable Object[] specificInterceptors, TargetSource targetSource) { //获取advisors Advisor[] advisors = buildAdvisors(beanName, specificInterceptors); proxyFactory.addAdvisors(advisors); proxyFactory.setTargetSource(targetSource); customizeProxyFactory(proxyFactory); proxyFactory.setFrozen(this.freezeProxy); if (advisorsPreFiltered()) { proxyFactory.setPreFiltered(true); } // Use original ClassLoader if bean class not locally loaded in overriding class loader ClassLoader classLoader = getProxyClassLoader(); if (classLoader instanceof SmartClassLoader && classLoader != beanClass.getClassLoader()) { classLoader = ((SmartClassLoader) classLoader).getOriginalClassLoader(); } //通过代理工厂创建代理对象 return proxyFactory.getProxy(classLoader); } public Object getProxy(@Nullable ClassLoader classLoader) { //首先获取对应的代理 return createAopProxy().getProxy(classLoader); } //该方法根据要被代理的类选择使用jdk代理还是cglib代理 public AopProxy createAopProxy(AdvisedSupport config) throws AopConfigException { if (!NativeDetector.inNativeImage() && (config.isOptimize() || config.isProxyTargetClass() || hasNoUserSuppliedProxyInterfaces(config))) { Class targetClass = config.getTargetClass(); //如果被代理的类是一个接口则使用jdk代理 if (targetClass.isInterface() || Proxy.isProxyClass(targetClass) || ClassUtils.isLambdaClass(targetClass)) { return new JdkDynamicAopProxy(config); } //否则使用cglib代理 return new ObjenesisCglibAopProxy(config); } else { //根据配置选择强制使用jdk代理 return new JdkDynamicAopProxy(config); } } 我们知道,代理方式有jdk动态代理与cglib动态代理两种方式,而我们一个bean使用那种代理方式则由上述的方法决定。 至此,我们已经确定了使用那种代理方式获取代理对象。 2.3 获取代理对象 从上文中,我们已经确定了选用何种方式构建代理对象。接下来就是通过不同的方式是如何获取代理对象的。 看懂本章需要实现了解jdk动态代理或者cglib动态代理的方式。 2.3.1 JDK代理 首先在获取代理对象时选择 JdkDynamicAopProxy public Object getProxy(@Nullable ClassLoader classLoader) { if (logger.isTraceEnabled()) { logger.trace("Creating JDK dynamic proxy: " + this.advised.getTargetSource()); } //这里通过反射创建代理对象 return Proxy.newProxyInstance(classLoader, this.proxiedInterfaces, this); } 当被代理对象执行被代理的方法时,会进入到此方法。(jdk动态代理的概念) JDK通过反射创建对象,效率上来说相对低一些。 public Object invoke(Object proxy, Method method, Object[] args) throws Throwable { try { // 获取被代理对象的所有切入点 List chain = this.advised.getInterceptorsAndDynamicInterceptionAdvice(method, targetClass); // 如果调用链路为空说明没有需要执行的切入点,直接执行对应的方法即可 if (chain.isEmpty()) { // We can skip creating a MethodInvocation: just invoke the target directly // Note that the final invoker must be an InvokerInterceptor so we know it does // nothing but a reflective operation on the target, and no hot swapping or fancy proxying. Object[] argsToUse = AopProxyUtils.adaptArgumentsIfNecessary(method, args); retVal = AopUtils.invokeJoinpointUsingReflection(target, method, argsToUse); } else { // 如果有切入点的话则按照切入点顺序开始执行 MethodInvocation invocation = new ReflectiveMethodInvocation(proxy, target, method, args, targetClass, chain); // Proceed to the joinpoint through the interceptor chain. retVal = invocation.proceed(); } return retVal; } } invocation.proceed();这个方法就是通过递归的方式执行所有的调用链路。 public Object proceed() throws Throwable { // We start with an index of -1 and increment early. if (this.currentInterceptorIndex == this.interceptorsAndDynamicMethodMatchers.size() - 1) { return invokeJoinpoint(); } Object interceptorOrInterceptionAdvice = this.interceptorsAndDynamicMethodMatchers.get(++this.currentInterceptorIndex); if (interceptorOrInterceptionAdvice instanceof InterceptorAndDynamicMethodMatcher) { InterceptorAndDynamicMethodMatcher dm = (InterceptorAndDynamicMethodMatcher) interceptorOrInterceptionAdvice; Class targetClass = (this.targetClass != null ? this.targetClass : this.method.getDeclaringClass()); if (dm.methodMatcher.matches(this.method, targetClass, this.arguments)) { return dm.interceptor.invoke(this); } else { // 继续执行 return proceed(); } } else { // 如果调用链路还持续的话,下一个方法仍会调用proceed() return ((MethodInterceptor) interceptorOrInterceptionAdvice).invoke(this); } } 2.3.2 cglib代理 public Object getProxy(@Nullable ClassLoader classLoader) { try { //配置CGLIB Enhancer... Enhancer enhancer = createEnhancer(); if (classLoader != null) { enhancer.setClassLoader(classLoader); if (classLoader instanceof SmartClassLoader && ((SmartClassLoader) classLoader).isClassReloadable(proxySuperClass)) { enhancer.setUseCache(false); } } enhancer.setSuperclass(proxySuperClass); enhancer.setInterfaces(AopProxyUtils.completeProxiedInterfaces(this.advised)); enhancer.setNamingPolicy(SpringNamingPolicy.INSTANCE); enhancer.setStrategy(new ClassLoaderAwareGeneratorStrategy(classLoader)); //1.获取回调函数,对于代理类上所有方法的调用,都会调用CallBack,而Callback则需要实现intercept()方法 Callback[] callbacks = getCallbacks(rootClass); Class[] types = new Class[callbacks.length]; for (int x = 0; x < types.length; x++) { types[x] = callbacks[x].getClass(); } // fixedInterceptorMap only populated at this point, after getCallbacks call above enhancer.setCallbackFilter(new ProxyCallbackFilter( this.advised.getConfigurationOnlyCopy(), this.fixedInterceptorMap, this.fixedInterceptorOffset)); enhancer.setCallbackTypes(types); //2.创建代理对象 return createProxyClassAndInstance(enhancer, callbacks); } catch (CodeGenerationException | IllegalArgumentException ex) { throw new AopConfigException("Could not generate CGLIB subclass of " + this.advised.getTargetClass() + ": Common causes of this problem include using a final class or a non-visible class", ex); } catch (Throwable ex) { // TargetSource.getTarget() failed throw new AopConfigException("Unexpected AOP exception", ex); } } 可以看到我们在创建代理对象前会先获取代理对象的所有回调函数: 首先可以看到我们一共有7个回调方法,其中第一个为AOP相关的方法,其他的为spring相关。 在第一个对调对象中持有的 advised 对象中有 advisors 属性,就是对应我们的代理类中四个切片,@Before等等。 然后我们看一下 createProxyClassAndInstance()都做了什么。 //CglibAopProxy类的创建代理对象方法 protected Object createProxyClassAndInstance(Enhancer enhancer, Callback[] callbacks) { enhancer.setInterceptDuringConstruction(false); enhancer.setCallbacks(callbacks); return (this.constructorArgs != null && this.constructorArgTypes != null ? enhancer.create(this.constructorArgTypes, this.constructorArgs) : enhancer.create()); } //ObjenesisCglibAopProxy继承了CglibAopProxy类,并覆写了其方法 protected Object createProxyClassAndInstance(Enhancer enhancer, Callback[] callbacks) { Class proxyClass = enhancer.createClass(); Object proxyInstance = null; //1.尝试使用objenesis创建对象 if (objenesis.isWorthTrying()) { try { proxyInstance = objenesis.newInstance(proxyClass, enhancer.getUseCache()); } catch (Throwable ex) { logger.debug("Unable to instantiate proxy using Objenesis, " + "falling back to regular proxy construction", ex); } } //2.根据commit的提交记录发现,objenesis有可能创建对象失败,如果失败的话则选用放射的方式创建对象 if (proxyInstance == null) { // Regular instantiation via default constructor... try { Constructor ctor = (this.constructorArgs != null ? proxyClass.getDeclaredConstructor(this.constructorArgTypes) : proxyClass.getDeclaredConstructor()); ReflectionUtils.makeAccessible(ctor); proxyInstance = (this.constructorArgs != null ? ctor.newInstance(this.constructorArgs) : ctor.newInstance()); } catch (Throwable ex) { throw new AopConfigException("Unable to instantiate proxy using Objenesis, " + "and regular proxy instantiation via default constructor fails as well", ex); } } // ((Factory) proxyInstance).setCallbacks(callbacks); return proxyInstance; } 2.3.3 cglib 此处有个遇到的问题,当我在debug的时候,发现怎么都进不去 createProxyClassAndInstance(),百思不得其解,然后看到IDEA旁边有一个向下的箭头,代表该方法可能其子类被覆写了。然后在其子类处打断点果然发现是其子类的实现。 此处在2.2中也可看到: 可以看到返回的是其子类的对象,而不是CglibAopProxy本身的对象。 作者:京东科技 韩国凯 来源:京东云开发者社区

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册