首页 文章 精选 留言 我的

精选列表

搜索[全模态模型],共10000篇文章
优秀的个人博客,低调大师

Python全栈工程师(多继承、函数重写)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 补充: 对象 -------------------------> 类实例变量(属性) 类变量实例方法 类方法( @classmethond) 静态方法( @staticmethond)(类内普通函数) 继承/派生 单继承: 一个子类只有一个父类 一个父类可以有多个子类 -------------------------------------------------------------------------------------------- 用于类的函数: issublclass(cls, cls_or_tuple) 判断这个类是否继承自其他类, 如果此cls是class 或tuple中的一个派生子类, 返回True 否则返回False示例: class A: pass class B(A): pass class C(B): pass issublclass(C, B) # Trueissublclass(B, C) # Falseissublclass(C, (int, str)) # Falseissublclass(C, (int, B, str)) # True 封装 enclosure 封装是指隐藏类的实现细节,让使用者不关心这些细节 封装的目的是让使用者通过尽可能少的方法(或属性)操作对象私有属性和私有方法: python类中以双下划线(__)开头, 不以双下划线结尾的标识符为私有成员,私有成员或只能用类的方法进行访问和修改 以__开头的实例变量有私有属性 以__开头的方法有私有方法 示例: class A: def __init__(self): self.__p1 = 100 # 私有属性 def show_A(self): print("self.__p1", self.__p1) self.__m1() # 可以调用自己的方法 def __m1(self): # 私有方法 print("__m1(self)方法被调用") a = A() a.show_A() # 100 # print(a.__p1) # 出错 不能在类外部访问a.__p1私有属性 也不能在子类中访问 # a.__m1() # 出错 不能在类外部访问a.__p1私有方法 也不能在子类中访问 class B(A): pass b = B() print(b.__p1) # 出错,子类不能访问父类的私有成员 b.__m1() # 出错 b._A__p1 = 200 # python的假封装可以用此方法访问 print(b.__p1) # 200 多态polymorphic: 什么是多态 就是多种状态 多态是指在继承/派生关系的类中,调用基类对象的方法, 实际能够调用子类的覆盖方法的现象叫多态 状态: 静态(编译时状态)执行速度快 动态(运行时状态)执行速度慢说明: 多态调用方法与对象相关,不与类相关 Python的全部对象只有“运行时状态(动态)” 没有C++语言里的“编译时状态(静态)” 由于Python是解释执行的 是动态 没有静态 是在运行时编译(解释执行) 示例: # Pytgon中的运行时状态 class Shape: def draw(self): print("Shape的 draw 方法被调用") class Point(Shape): def draw(self): print("画车") class Circle(Shape): def draw(self): print("画圈") # python无法实现静态 除非不出现任何覆盖 def my_draw(s): # 其他静态语言 def my_draw(Circle s) 指定调用者 无法进行改变 s.draw() # 此处显示出"动态" s1 = Circle() s2 = Point() my_draw(s1) # 只有在调用时才能能确定调用哪一个 my_draw(s2) 面向对象不是编程而是一种思想面向对象的语言的特征: 继承 封装 多态 多继承:multiple inheritance 多继承是指一个子类继承自两个或两个以上的基类 语法: class 类名(基类名1, 基类名2, ...) 说明: 1.一个子类同时继承自多个父类,父类中的方法可以同时被继承下来 2.如果两个父类中同时有同名方法,而在子类中又没有覆盖此方法时, 调用结果难以确定 (也可以确定 C3算法)示例: class Car: def run(self, speed): print("汽车", speed, "Km/h 的速度行驶") class Plane: def fly(self, height): print("飞机以海拔", height, "米高度飞行") class PlaneCar(Plane, Car): '''同时继承Plane,Car的方法''' p1 = PlaneCar() p1.fly(10000) p1.run(300) 多继承的问题(缺陷): 标识符冲突的问题 要谨慎使用继承示例: # 多继承名字冲突问题 class A: def m(self): print("A.m被调用") class B: def m(self): print("B.m被调用") class AB(A, B): # 优先调用先出现的父类 有先后顺序 pass ab = AB() ab.m() # A.m被调用 class BA(B, A): pass ba = BA() ba.m() # B.m被调用 多继承的MRO(Method Resolution Order): 类的__mro__属性 __mro__ 是一个元组 里面存放类 此属性用来记录方法查找顺序示例: class A: def go(self): print("A") class B(A): def go(self): print("B") class C(A): def go(self): print("C") class D(B, C): def go(self): print("D") super().go() d = D() d.go() # B # 多继承的super调用关系一定是mro元组内的下一个类 和子父类没关系 # 如果没有方法则报错 调用算法(C3算法) # 正常调用也是mro顺序 函数重写: 在自定义类内添加相应的方法,让自定义类创建的实例 能像内建对象一样进行内建函数操作对象转字符串函数: repr(obj) 返回一个能代表此对象的表达式字符串,通常eval(repr(obj))== obj (这个字符串通常给Python解释执行器运行用的) str(obj) 返回的字符串(这个字符串通常给人阅读用的) 对象转字符串函数的重写方法: repr(obj) 函数的重写方法: def __repr__(self): pass str(obj) 函数的重写方法: def __str__(self): pass 说明: 1.str(obj)函数先查找, obj.str()方法 调用此方法并返回结果 2.如果没有obj.__str__方法时,返回obj.__repr__() 方法的结果并返回 3.如果obj.__repr__方法不存在,则调用obj类的__repr__ 实例方法显示:<__main__.XXXX object at 0x7f4b1c36fa90>示例: class MyNumber: def __init__(self, value): '构造函数,初始化MyNumber' self.data = value def __str__(self): '''转换为人能够识别的字符串''' print("__str__方法被调用") return "自定义数字类型对象:%d" % self.data def __repr__(self): '''转换为eval能够识别的字符串''' return 'MyNumber(%d)' % self.data n1 = MyNumber(100) n2 = MyNumber(200) print("repr(n1):--->", repr(n1)) print("strr(n2):--->", str(n2)) print("strr(n2):--->", n2.__str__()) 其他内建函数的重写方法:__abs__ abs(obj) 函数__len__ len(obj) 函数(必须返回整数)__reversed__ reversed(obj) 函数(必须返回可迭代对象)__round__ round(obj) 函数 示例: # 函数重写 class MyNumber: def __init__(self, v): self.data = v def __repr__(self): return 'MyNumber(%d)' % self.data def __abs__(self): '''__abs__函数重写 求绝对值函数''' # return -self.data v = abs(self.data) return MyNumber(v) # 创建一个新的MyNumber对象 def __len__(self): '''__len__函数重写 求长度函数''' # return len(self.data) i = 0 for x in self.data: i += 1 return i i1 = MyNumber(-10) print(i1) i2 = abs(i1) print(i2) i3 = MyNumber("123d5sa") print(len(i3)) 数据转换函数的重写:__complex__ complex(obj) 函数__int__ int(obj) 函数__float__ float(obj) 函数__bool__ bool(obj) 函数 示例: 数据转换构造函数重写 class MyNumber: def __init__(self, v): self.data = v def __repr__(self): return 'MyNumber(%d)' % self.data def __int__(self): # return 999999 # 可以自定义返回规则 return self.data n1 = MyNumber(100) x = int(n1) print(type(x)) # <class 'int'> print(bool(n1)) # True n2 = MyNumber(0) print(bool(n2)) # True # 默认返回 # True 布尔测试函数重写: 格式: __bool__ 作用: 用于bool(obj)函数取值 用于if语句的真值表达式中 说明: 1.当自定义的类内有__bool__(self) 方法时,此方法的返回值为bool(obj)的返回值 2.当不存在__bool__(self),bool(x) 返回__len__(self)方法的返回值是否为零来测试布尔值 3.当不存在__len__方法时,则直接返回True示例: # bool(x)函数重写 class MyList: '''自定义类型的列表,用来保存数据,内部用列表来储存数据''' def __init__(self, iterable): self.data = [x for x in iterable] def __repr__(self): return " MyList(%s)" % self.data def __len__(self): '''返回长度''' print("__bool__方法被调用") return len(self.data) # def __bool__(self): # print("__bool__方法被调用") # return False # 此处定义所有对象返回False def __bool__(self): print("__bool__方法被调用") for x in self.data: if not x: return False return True # 自定义返回规则(这就是函数重写) myl = MyList((1, 2, -3, 4, -5, 5)) print(myl) print(bool(myl)) if myl: print("myl是真值") else: print("myl是假值") 迭代器(高级): 什么是迭代器: 可以通过next(it)函数取值的对象就是迭代器 迭代器协议: 迭代器是指对象能够使用next函数获取下一项数据, 在没有下一项数据时触发一个StopIteration异常来终止迭代的重写 迭代器协议实现方法: __next__(self) 方法来实现迭代协议 语法形式: class MyIterator: def __next__(self): 迭代器协议 return 数据什么是可迭代对象: 是指用iter(obj) 函数返回迭代对象(实例) 可迭代对象内部需要定义__iter__(self)方法来返回迭代器对象 # 此示例示意让自定义的作为可迭代对象能让 for 语句迭代访问 class MyList: '''创建MyList类''' def __init__(self, iterable=()): '''初始化self iterable:可迭代对象 ''' # 用iterable生成列表 self.data = [x for x in iterable] def __repr__(self): '''返回一个MyList字符串''' return 'MyList(%s)' % self.data def __iter__(self): '''此方法必须返回一个迭代器对象 此方法创建一个迭代器对象并返回 ''' return MyListIterator(self.data) class MyListIterator: '''此类用来创建迭代器,此类型的迭代器可以迭代访问 MyList类型的对象''' def __init__(self, lst): self.data = lst self.cur_index = 0 # 初始化迭代器的起始位置 def __next__(self): '''此方法用于实现迭代器协议''' if self.cur_index >= len(self.data): # 如果索引越界就发终止迭代通知 raise StopIteration value = self.data[self.cur_index] # 要返回的值 self.cur_index += 1 return value myl = MyList([0, -1, 2, -3]) print(myl) # it = iter(myl) # print(next(it)) for x in myl: # 迭代访问自定义类型的可迭代对象 print(x) 练习: 写一个类Bicycle类 ,有 run方法.调用时显示骑行里程km class Bicycle: def run(self, km): print('自行车骑行了', km, '公里') 再写一个类EBicycle(电动自行车类), 在Bicycle类的基础上添加了电池电量 volume 属性, 有两个方法: 1. fill_charge(self, vol) 用来充电, vol为电量 2. run(self, km) 方法每骑行10km消耗电量1度,同时显示当前电量,当电量耗尽时调用 父类的run方法继续骑行 b = EBicycle(5) # 新买的电动有内有5度电 b.run(10) # 电动骑行了10km还剩 4 度电 b.run(100) #电动骑行了40km,还剩0度电,其余60用脚登骑行 b.fill_charge(10) # 又充了10度电 b.run(50) # 骑行了50公里剩5度电 答案: class Bycycle: def run(self, km): '''自行车''' print("自行车骑行了", km, "公里") class EBycyle(Bycycle): def __init__(self, volume=0): '''初始化电动车''' self.volume = volume print("新买的电动车有", volume, "度电") def fill_charge(self, vol): '''冲电''' self.volume += vol print("又冲了", vol, "度电") def run(self, km): self.volume -= (km / 10) # 减去使用的电量 x = abs(self.volume) * 10 # 计算超出的公里 if self.volume < 0: # 判断是否超出电量 self.volume = 0 print("电动车骑行了", km, "千米 还剩", self.volume, "度电 其余", x, "千米用脚蹬") else: print("电动车骑行了", km, "千米 还剩", self.volume, "度电") b = EBycyle(10) b.run(10) b.run(100) b.fill_charge(10) b.run(50) # 新买的电动车有 10 度电 # 电动车骑行了 10 千米 还剩 9.0 度电 # 电动车骑行了 100 千米 还剩 0 度电 其余 10.0 千米用脚蹬 # 又冲了 10 度电 # 电动车骑行了 50 千米 还剩 5.0 度电 b = EBycyle(50) b.run(10) b.run(100) b.fill_charge(10) b.run(50) # 新买的电动车有 50 度电 # 电动车骑行了 10 千米 还剩 49.0 度电 # 电动车骑行了 100 千米 还剩 39.0 度电 # 又冲了 10 度电 # 电动车骑行了 50 千米 还剩 44.0 度电 练习: 1. 修改原有的学生信息管理系统, 将学生对象的,全部属性 都变为私有属性,不让外部直接访问来实现封装 源码: https://pan.baidu.com/s/1szQDS5cfzVHLlZrrJcCs8A 2. 写一个列表类MyList实现存储整数列表,写类的定义如下: class MyList: def __init__(self, iterator): self.data = ... 让此类的对象能用for语句进行迭代访问 L = MyList(range(5)) print(L) L2 = [x ** 2 for x in L] print(L2) # [0, 1, 4, 9, 16] 答案: class MyList: def __init__(self, iterable=()): self.lst = [x for x in iterable] def __repr__(self): return "%s" % self.lst def __iter__(self): return MyIterable(self.lst) class MyIterable: def __init__(self, lst): self.lst = lst self.myindex = 0 def __next__(self): if self.myindex >= len(self.lst): raise StopIteration value = self.lst[self.myindex] self.myindex += 1 return value L = MyList(range(5)) print(L) for x in L: print(x) L2 = [x ** 2 for x in L] print(L2) 3. 写一个类Fibonacci 实现迭代器协议 ,此类的对象可以作为可迭代对象生成相应的斐波那契数 1 1 2 3 5 class Fibonacci: def __init__(self, n) # n代表数据的个数 ... ... 实现如下操作: for x in Fibonacci(10): print(x) # 1 1 3 5 8 .... L = [x for x in Fibonacii(50)] print(L) F = fibonicci(30) print(sum(F)) 答案: 直接继承第二题的类 class Fibonicci(MyList): def __init__(self, n): L = [1, 1] for _ in range(n - 2): L.append(L[-1] + L[-2]) self.lst = L for x in Fibonicci(10): print(x) # 1 1 3 5 8 .... L = [x for x in Fibonicci(50)] print(L) F = Fibonicci(30) print(F) print(sum(F))

优秀的个人博客,低调大师

前端一站式异常捕获方案(全)

一、前端异常监控的重要性 软件异常监控常常直接关联到软件本身的质量,完备的异常监控体系常常能够快速定位到软件运行中发生的问题,并能帮助我们快速定位问题的源头,提升软件质量。 在服务器开发中,我们常常使用日志来记录请求的错误和服务器异常问题,但是在前端开发中,前端工程师按照需求完成页面开发,通过产品体验确认和测试,页面就可以上线了。但不幸的是,产品很快就收到了用户的投诉。用户反映页面点击按钮没反应而且能复现,我们试了一下却一切正常,于是追问用户所用的环境,最后结论是用户使用了一个非常小众的浏览器打开页面,因为该浏览器不支持某个特性,因此页面报错,整个页面停止响应。在这种情况下,用户反馈的投诉花掉了我们很多时间去定位问题,然而这并不是最可怕的,更让我们担忧的是更多的用户遇到这种场景后便会直接抛弃这个有问题的“垃圾产品”。这个问题唯一的解决办法就是在尽量少的用户遇到这样的场景时就把问题即时修复掉,保证尽量多的用户可以正常使用。 首先我们需要在少数用户使用产品出错时知道有用户出错,而且尽量定位到是什么错误。由于用户的运行环境是在浏览器端的,因此可以在前端页面脚本执行出错时将错误信息上传到服务器,然后打开服务器收集的错误信息进行分析来改进产品的质量,下面我们主要讨论下错误的捕获方案。 二、现有的异常监控方案 window.onerror全局异常捕获 目前前端捕获页面异常的方式主要有两种:try...catch和window.onerror。 window.onerror的方法可以在任何执行上下文中执行,如果给window对象增加一个错误处理函数,便既能处理捕获错误又能保持代码的优雅性了。window.onerror一般用于捕捉脚本语法错误和运行时错误,可以获得出错的文件信息,如出错信息、出错文件、行号等,当前页面执行的所有JavaScript脚本出错都会被捕捉到。 window.onerror = function (msg, url, line){ // 可以捕获异步函数中的错误信息并进行处理,提示Script error. console.log(msg); // 获取错误信息 console.log(url); // 获取出错的文件路径 console.log(line); // 获取错误出错的行数 }; setTimeout(function() { console.log(obj); // 可以被捕获到,并在onerror中处理 }, 200); 然而,使用onerror要注意,在不同浏览器中实现函数处理返回的异常对象是不相同的,而且如果报错的JavaScript和HTML不在同一个域名下,错误时window.onerror中的errorMsg全部为script error而不是具体的错误描述信息,此时需要添加JavaScript脚本的跨域设置。 <script src="//www.domain.com/main.js" crossorigin></script> 如果服务器因为一些原因不能设置跨域或设置起来比较麻烦,那就只能在每个引用的文件里添加try...catch进行处理。 try-catch运行时解决方案 一般来说,使用try...catch可以捕捉前端JavaScript的运行时错误,同时拿到出错的信息,例如错误信息描述、堆栈、行号、列号、具体的出错文件信息等。我们也可以在这个阶段将用户浏览器信息等静态内容一起记录下来,快速地定位问题发生的原因。需要注意的是,try...catch无法捕捉到语法错误,只能在单一的作用域内有效捕获错误信息,如果是异步函数里面的内容,就需要把function函数块内容全部加入到try...catch中执行。 try{ // 单一作用域try...catch可以捕获错误信息并进行处理 console.log(obj); }catch(e){ console.log(e); //处理异常,ReferenceError: obj is not defined } try{ // 不同作用域不能捕获到错误信息 setTimeout(function() { console.log(obj); // 直接报错,不经过catch处理 }, 200); }catch(e){ console.log(e); } // 同一个作用域下能捕获到错误信息 setTimeout(function() { try{ // 当前作用域try...catch可以捕获错误信息并进行处理 console.log(obj); }catch(e){ console.log(e); //处理异常,ReferenceError: obj is not defined } }, 200); 但是在上面的这个例子中,try...catch无法获取异步函数setTimeout或其他作用域中的错误信息,这样就只能在每个函数里面添加try...catch了。 虽然使用window.onerror可以获取页面的出错信息、出错文件和行号,但是window. onerror有跨域限制,如果需要获取错误发生的具体描述、堆栈内容、行号、列号和具体的出错文件等详细日志,就必须使用try…catch,但是try…catch又不能在多个作用域中统一处理错误。 幸运的是,我们可以对前端脚本中常用的异步方法入口函数或模块引用的入口方法统一使用try…catch进行一层封装,这样就可以使用try…catch捕获每个引用模块作用域下的主要错误信息了。例如我们就可以对setTimeout函数用如下方式进行封装并捕获错误信息。另外,使用try-catch会带来一定的性能损耗,根据循环测试,平均大概会损失6%~10%的性能,但是为了提升应用的质量和稳定性,这些是可以接受的。 function wrapFunction(fn) { return function() { try { return fn.apply(this, arguments); } catch (e) { console.log(e); _errorProcess(e); return; } }; } // 之后fn函数里面的代码运行出错时则是可以被捕获到的了 fn = wrapFunction(fn); // 或者异步函数里面的回调函数中的错误也可以被捕获到 var _setTimeout = setTimeout; setTimeout = function(fn, time){ return _setTimeout(wrapFunction(fn), time); } // 模块定义函数也可以做重写定义 var _require = require; require = function(id, deps, factory) { if (typeof(factory) !== 'function' || !factory) { return _require(id, deps); } else { return _require(id, deps, wrapFunction(factory)); } }; 这是我们可以对常用的模块入口函数进行重定义,包括setTimeout、setInterval、define、require等,这样模块中的主要作用域中的异常都可以通过try-catch来捕获了。在之前的处理方法中,这种方法是非常有效的,直接可以拿到大多数错误栈中的异常和堆栈信息。 我们可以对不同作用域的setTimeout参数函数的引入方式使用try…catch进行封装,让try…catch能捕获到setTimeout脚本中的错误并使用setTimeoutTry函数来代替。对于异步引入模块定义函数require或define也可以进行类似的封装,这样就可以获取到不同模块里面作用域的错误信息了。因此,这里捕获错误的方式可以根据具体的条件和场景灵活选择,在没有特别限制的情况下,使用window.onerror是比较高效、便捷的。 三、改进的一站式解决方案 ES6 Class的异常捕获方案 尽管window.onerror和try...catch结合可以解决较多的问题,但是React开发时代,这种方式就不能直接使用了,我们知道React的组件都是class,其实也就是构造函数,这里普及下class和构造函数其实是非常类似的,class A除了constructor为class A,其它信息和function A类似,typeof获取的类型也相同。但是我们是没办法把构造函数A直接装入try-catch中运行的,因为需要通过关键字new进行实例化,并创建新的作用域。 此时我们要处理的问题其实是捕获React中属性方法中的错误,应该还记得,JavaScript中函数有个特殊的属性prototype,当函数作为构造函数是,prototype中的属性就成了实例化后的属性方法,而且这一属性对class同样生效。那么我们可以对React中class的prototype这个特殊属性的内容进行处理,对Component中的方法函数进行封装。 /** * 封装React方法的错误处理,改成使用入参的prototype中是否有render生命周期函数来判断 * @param {object} Component 传入组件 * @return {object} 返回包裹后的组件 */ function _defineReact(Component) { var proto = Component.prototype; var key; // 封装本身constructor中的构造方法,React组件编译为ES5后是一个构造函数,ES6下面为class if (_isTrueFunction(Component)) { Component = wrapFunction(Component); } var componnetKeys = Object.getOwnPropertyNames(proto); // 支持ES6类的属性方法错误捕获 for (var i = 0, len = componnetKeys.length; i < len; i++) { key = componnetKeys[i]; proto[key] = wrapFunction(proto[key]) } // 支持ES5下的属性方法错误捕获 for (key in proto) { if (typeof proto[key] === 'function') { proto[key] = wrapFunction(proto[key]); } } return Component; } /** * 判断是否为真实的函数,而不是class * @param {Function} fn [description] * @return {Boolean} [description] */ function _isTrueFunction(fn) { var isTrueFunction = false; try { isTrueFunction = fn.prototype.constructor.arguments === null; } catch (e) { isTrueFunction = false; } for (var key in fn.prototype) { return false; } return isTrueFunction; } 这样通过实例化产生的React组件中的内部方法中的错误就可以被捕获到了。即使代码不通过babel编译为ES5,class里面的异常也可以被捕获到。 class component extends React.Component { componentDidMount(){ var a = {}; console.log(a.b.c); } render() { return <div>hello world</div>; } } export default _defineReact(component); 这里添加defineReact的操作也可以放到构建打包工具中去处理,这样就避免了我们对代码层直接进行修改。 React直接报错不利于定位问题 封装后直接获取堆栈错误 另外不得不说的是react 16里面提供了componentDidCatch方法,可以直接捕获react组件里面的异常来直接上报。这样其实对于react的场景就更简单了。 Promise内的错误捕获 前端代码中,如果你希望浏览直接运行ES6代码,并且使用了Promise,那就不得不重新考虑下Promise的异常捕获了。因为window.onerror并不会去捕获到Promise里面的错误。是的,连script error都没有。就是onerror不会捕获promise里面的错误,应该是早期的浏览器onerror设计没有考虑到Promise直接运行的场景。但借助try-catch封装,我们仍可以做到。 // 如果浏览支持Promise,捕获promise里面then的报错,因为promise里面的错误onerror和try-catch都无法捕获 if (Promise && Promise.prototype.then) { var promiseThen = Promise.prototype.then; Promise.prototype.then = function(resolve, reject) { return promiseThen.call(this, _wrapPromiseFunction(resolve), _wrapPromiseFunction(reject)); } } /** * 输入一个函数,将函数内代码包裹进try-catch执行,then的resolve、reject和普通函数不一样 * * @param {any} fn * @returns 一个新的函数 */ function _wrapPromiseFunction(fn) { // 如果fn是个函数,则直接放到try-catch中运行,否则要将类的方法包裹起来,promise中的fn要返回null,不能返回空函数 if (typeof fn !== 'function') { return null; } return function () { try { return fn.apply(this, arguments); } catch (e) { _errorProcess(e); throw e; } }; } 此时,promise里面resolve和reject就都可以在try-catch的环境运行了,里面的错误也可以被顺利的捕获到。 四、小结 小结一下,其实和原有的方式差别不大,仍然通过try-catch的方式,覆盖到React组件prototype属性中进行异常捕获,极大增加了错误捕获范围,不仅能帮助我们快速定位开发中的问题,也能捕获React线上应用的运行时错误。 原文地址:http://jixianqianduan.com/frontend-weboptimize/2018/02/22/front-end-react-error-capture.html 原文发布时间为:2018年03月01日原文作者:ouven 本文来源:开源中国 如需转载请联系原作者

优秀的个人博客,低调大师

Python全栈工程师(迭代器、字节串)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 Python人工智能从入门到精通 迭代器 Iterator: 用<>括号表示的一定是对象 什么是迭代器? 迭代器是访问可迭代对象的工具 迭代器是指用iter(obj) 函数返回的对象(实例) 迭代器可以用next(it) 函数获取可迭代对象的数据 迭代器函数iter和next iter(iterable) 从可迭代对象中返回一个迭代器,iterable 必须是能提供一个迭代器的对象 next(iterator) 从迭代器iterator中获取下一个记录,如果无法获取下一条记录,则触发StopIteration异常说明: 迭代器只能向前取值,不会后退 用iter函数可以返回一个可迭代对象的迭代器作用: 迭代器对象能用next函数获取下一个元素. 示例: L = [2, 3, 5, 7] it = iter(L) # 用L对象返回能访问L的迭代器, it绑定迭代器 next(it) # 2 next(it) # 3 next(it) # 5 next(it) # 7 next(it) # StopIteration 通知(没有数据) it = iter(range(1, 10, 30)) next(it) # 1 next(it) # 4 next(it) # 7 next(it) # StopIteration 用迭代器访问可迭代对象: L = [2, 3, 5, 7] for x in L: print(x) else: print('循环结束') it = iter(L) # 从L中获取一个迭代器 while True: try: x = next(it) print(x) except StopIteration: print("循环结束") break 生成器 Generator (python 2.5及之后)什么是生成器? 生成器是能够动态提供数据的对象,生成器对象也是可迭代对象(实例) 动态就是现用现生成数据 生成器有两种: 1. 生成器函数 2. 生成器表达式 生成器函数的定义 含有yield语句的函数是生成器函数,此函数被调用将返回一个生成器对象 yield 翻译为(产生或生成) yield 语句 语法: yield 表达式 说明: yield 用于 def 函数中,目的是将此函数作用生成器函数使用 yield 用来生成数据,供迭代器的next(it) 函数使用 yield 单步生成数据 在函数内可以一个或多少 实例: # 此示例示意用生成器函数生成一定范围内的自然数 def myinteger(n): i = 0 # 自然数从0开始 while i < n: yield i i += 1 for x in myinteger(3): print(x) 生成器函数说明: 生成器函数的调用将返回一个生成器对象,生成器对象是一个可迭代对象 在生成器函数调用return 会触发一个StopIteration异常生成器表达式: 语法: (表达式 for 变量 in 可迭代对象 [if 真值表达式 ]) 说明: if 子句可以省略 作用: 用推导式的形式创建一个新的生成器 示例: gen = (x ** 2 for x in range(1, 5)) it = iter(gen) next(it) # 1 next(it) # 4 next(it) # 9 next(it) # 16 next(it) # StopIteration迭代工具函数 迭代工具函数的作用是生成一个个性化的可迭代对象 函数:zip(iter1[, iter2[, ...]]) 返回一个zip对象,此对象用于生成元组,此元组的个数由最小的可迭代对象决定 enumerate(iterable[, start]) 生成带索引的枚举对象,返回迭代类型为索引-值对(index-value对),默认索引从零开始,也可以用start指定 示例: numbers = [10086, 10000, 10010, 9558] names = ['中国移动', '中国电信', '中国联通'] for t in zip(numbers, names): print(t) for x, y in zip(numbers, names): print(y, '的客服电话是:', x) x, y = (10086, '中国移动') # 序列赋值 zip函数的实现示例2: def myzip(iter1, iter2): it1 = iter(iter1) # 拿出一个迭代器 it2 = iter(iter2) while True: a = next(it1) b = next(it2) yield (a, b) for t in myzip(numbers, names): #能实现与zip同样的功能 print(t) enumerate 示例: names = ['中国移动', '中国电信', '中国联通'] for t in enumerate(names): print(t) enumerate 实现方法示意: def myenum(iterable): it = iter(iterable) i = 0 while True: a = next(it) yield (i, a) i += 1 字节串和字节数组 字节串bytes (也叫字节序列) 作用: 存储以字节为单位的数据 字节串是不可变的字节序列 字节: 字节是由8个位(bit)组成的数据单位,是计算机进行数据管理的单位 字节是用 0 ~ 255 范围内的整数表示的 创建空字节串的字面值 B = b'' B = b"" B = b'''''' B = b"""""" 创建非空字节串的字面值 B = b'ABCD' B = b"ABCD" B = b'\x41\x42' 字节串的构造函数 bytes bytes() 生成一个空的字节串 等同于 b'' bytes(整数可迭代对象) # 用可迭代对象初始化一个字节串 bytes(整数n) 生成n个值为0的字节串 bytes(字符串, encoding='utf-8') 用字符串转为编码生成一个字节串 示例: b = bytes() # b = b'' b = bytes(range(65, 69)) # b = b'ABCD' b = bytes(5) # b = b'\x00\x00\x00\x00\x00' b = bytes('abc中文') # b=b'ABC\xe4\xb8\xad\xe6\x96\x87' bytes 的运算: + += * *= < <= > >= == != in / not in 索引和切片 len(x) max(x) min(x) sum(x) any(x) all(x) bytes 和 str 的区别: bytes 存储字节( 通常值在 range(0, 256)) str 存储unicode字符( 通常值在0~65535) bytes 与 str 的转换 编码(encode) str ------------> bytes b = s.encode(encoding='utf-8') 解码(decode) bytes ----------> str s = b.decode(encoding='utf-8') 字节数组 bytearray可变的字节序列 字节数组的构造函数: bytearray bytearray() 创建空的字节数组 bytearray(整数) 用可迭代对象初始化一个字节数组 bytearray(整型可迭代对象) 生成n个值为0的字节数组 bytearray(字符串, encoding='utf-8') 用字符串的转换编码生成一个字节数组 bytearray 的运算: + += * *= < <= > >= == != in / not in 索引和切片 (字节数组支持索引和切片的赋值操作,规则同列表的索引和切片赋值规则) 例: ba = bytearray(b'aBCDEfG') ba[0] = 65 ba[-2] = 70 bytearray的方法: BA.clear() 清空 BA.append(n) 追加一个字节(n为0~255的整数) BA.remove(value) 删除第一个出现的字节,如果没有出现,则触发ValueError错误 BA.reverse() 字节顺序反转 BA.decode(encoding='utf-8') # 解码为字符串 BA.find(sub[, start[,end]]) # 查找 sub 练习: 有一个集合: s = {'唐僧', '悟空', '八戒', '沙僧'} 用 for语句来遍历所有元素如下: for x in s: print(x) else: print('遍历结束') 请将上面的for语句改写为 用while语句和迭代器实现 练习: 写一个生成器函数 myeven(start, stop) 此函数用来生成从 start开始到stop结束(不包含)区间内的一系列偶数 def myeven(start, stop): .... evens = list(myeven(10, 20)) print(evens) # [10, 12, 14, 16, 18] for x in myeven(21, 30): print(x) # 22, 24, 26, 28 L = [x**2 for x in myeven(3, 10)] print(L) # 16 36 64 练习: 已知有一个列表L L = [2, 3, 5, 7] 用生成器表达式从此列表中拿到数,生成 列表中数据的平方 gen = ...... # 此处用生成器表达式实现 L2 = list(gen) # L2 = [4, 9, 25, 49] 练习: 写一个程序,读入任意行的文字,当输入空行时结束输入 打印带有行号的输入结果: 如: 请输入: hello<回车> 请输入: world<回车> 请输入: tarena<回车> 请输入: <回车> # 直接回车结束输入 输出如下: 第1行: hello 第2行: world 第3行: tarena 练习: 写一个程序,从键盘输入一段字符串存入s变量 1. 将此字符串转为字节串用变量b绑定,并打印出b 2. 打印字符串s的长度和字节串b的长度 3. 将b字节串再转换为字符串用变量s2 绑定,判断 s2 和 s是否相同? s = input("please input string:") b = s.encode("utf-8") print(s) print(b) print(len(s)) print(len(b)) s2 = b.decode("utf-8") if s2 == s: print("相等") 练习: 1. 写一个生成器函数primes生成素数, 此生成器函数为 primes(begin, end) 如: [x for x in primes(10, 20)] 将得到列表 [11, 13, 17, 19] 答案: def get_ss(x): if x <= 0: return False for i in range(2, x): if x % i == 0: return False return True def primes(begin, end): if begin <= 2or end <= 2: pass for x in range(begin, end): if get_ss(x): yield x L = [x for x in primes(10, 20)] print(L) 2. 写一个生成器函数,生成斐波那契数列的前n个数 1 1 2 3 5 8 13 def fibonacci(n): ... yield... 1) 输出前20个数: for x in fibonacci(20): print(x) 2) 打印前40个数的和: print(sum(fibonacci(40))) 答案: def fibonacci(n): L = [1, 1] for x in range(n): s = L[x] + L[x + 1] L.append(s) return L print(fibonacci(20)) print(sum(fibonacci(40))) 3. 写 程序打印杨辉三角(只打印6层) 1 1 1 1 2 1 1 3 3 1 1 4 6 4 1 1 5 10 10 5 1 答案: def yh_sj(): L = [1] while True: yield L L.append(0) L = [L[x - 1] + L[x] for x in range(len(L))] def lst(): i = 0 for x in yh_sj(): print(str(x).center(50)) if i == 10: break i += 1 思考: L = [2, 3, 5, 7] L2 = [x ** 2 for x in L] # 列表推导式 it = iter(L2) print(next(it)) # 4 L[1] = 10 print(next(it)) # 9 L = [2, 3, 5, 7] G3 = (x ** 2 for x in L) # 生成器表达式 it = iter(G3) print(next(it)) # 4 L[1] = 10 print(next(it)) # 100 生成器是动态的现用现去 跟着数据变化所变化

优秀的个人博客,低调大师

Python全栈工程师(函数的传参)

ParisGabriel 感谢 大家的支持 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 “\n”Linux 换行符"\r\n" Windows换行符 函数的参数传递: 传参方式:(2种) 位置传参(包含关系 ) 序列传参 关键字传参(包含关系) 字典关键字传参位置传参: 实际参数(实参)的对应关系与形式参数(形参) 的对应关系是安位置来依次对应的 说明: 实参和形参通过位置进行传递和匹配 实参的个数必须与形参的个数相同序列传参: 序列传参是指在函数调用过程中,用 * 将序列拆解 后按照位置进行传递的方式 说明: 序列传参时,序列拆解的位置与形参一一对应 序列的位置信息对应相应的形参的位置关键字传参: 关键字传参是指传参时,按着形参的名称给形参赋值、实参和形参按形参名进行匹配 字典关键字传参: 是指字典,将字典用“**”拆解后再进行关键字传参的方式 说明: 字典的键名必须和形参名一致 字典的键名必须是字符串且标识符 字典额键名要在形参中存在综合传参: 函数的传参方式在能确定形参能唯一匹配到相应实参的情况下可以任意组合 说明: 位置传参(序列传参)一定要在关键字传参(字典关键字传参)的左侧 示例: def fu(a, b, c): print("a=", a) print("b=", b) print("c=", c) fu(100, *[200, 300]) fu(*[100, 200], 300) fu(100, 200, 300) fu(100, b=200, c=300) fu(100, **{"c": 200, "b": 300}) --------------------函数的形参定义--------------------函数的缺省参数: 语法: def 函数名 (形参名1=默认实参1, 形参2=默认实参2) 语句块 说明: 缺省参数必须从右至左依次存在的,如果一个参数有缺省参数, 则右侧的所有参数都必须有缺省参数函数的形参定义: 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 位置形参: 语法: def 函数名(形参1, 形参2.......) 语句块 元组形参: 语法: def 函数名(*元组形参名): 语句块 作用: 收集多余的位置传参 命名关键字形参: 语法: def 函数名(*, 命名关键字形参): 语句块 或 def 函数名(*args, 命名关键字形参): 语句块 (关键字形参 必须用关键字传参) 作用: 强制所有的参数都参数都必须用关键字传参或字典关键字传参双星号字典传参: 语法: def 函数名(**字典形参名): 语句块 作用: 收集多余关键字传参 字典形参名通常命名为:kwargs函数的参数说明: 位置形参、星号元组形参、命名关键字形参、双星号字典形参可以混合使用函数自左到右的顺序为: 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 例如: def fx(a, b, *args, c, **kwargs): pass fx(100, 200, 300, 400, c="c", d="d")函数的不定长参数: 星号元组形参,双星号字典形参 说明: 可以接收任意位置传参和关键字传参 例如: def fn(*args, **kwargs) pass全局变量和局部变量: 局部变量:local variable 1.定义函数内的变量成为局部变量(函数的形参也是局部变量) 2.局部变量只能在函数内部使用 3.局部变量在函数调用时才能够被创建,在函数调用之后被销毁 全局变量:global variable 定义在函数外,模块内的变量称为全局变量 全局变量所有函数都可以直接访问(但函数内不能将其直接赋值) 练习: 1.写一个函数minmax(a, b, c) 有三个参数,这回这三个参数中的最小值和最大值, 要求,形成元组,最小值在前,最大值在后,如: def minmax(a, b, c): ... t = minmax(11, 33, 22) print(t) # (11, 33) # <<< 打印元组 xiao, da = minmax(6, 5, 4) print('最小值:', xiao, '最大值:', da) 答案: def minmax(a, b, c): x = a if x > b: x = b if x > c: x = c z = a if z < b: z = b if z < c: z = c L = [x, z] print(L) minmax(2, 1, 3)方法二: def minmax(a, b, c): L = [min(a, b, c), max(a, b, c)] print(L) minmax(2, 3, 1) 其实方法二 这样也是可以的不过就是有点不厚道了 这不属于二道贩子嘛 2.写一个函数 myadd, 此函数可以计算两个数的和,也可以计算三个数的和 def myadd(......): .... print(myadd(10, 20)) # 30 print(myadd(100, 200, 300)) # 600 答案: def myadd(a, b, c=0): return a + b + c print(myadd(100, 200, 300)) print(myadd(100, 200)) def mysum(*args): return sum(args) 皮一下很开心 mysum = sum 3 . 写一个函数,print_odd, 此函数可以传递一个实参,也可以传递两个实参,当传递一个实参时代表结束值 当传递两个实参时,第一个实参代表起始值,第二个实参代表结束值 打印出以此区间内的全部奇数,不包含结束数: print_odd(10) # 1 3 5 7 9 print_odd(11, 20) # 11 13 15 17 19 答案: def print_odd(a, b=None): if b == None: b = a a = 0 for x in range(a, b): if x % 2 != 0: print(x, end=" ") print_odd(10)# 1 3 5 7 9 print_odd(11, 20)# 11 13 15 17 19 4. 写一个函数, mysum可以传入任意个实参的数字,返回所有实参的和 def mysum(*args): ... print(mysum(1, 2, 3, 4)) # 10 print(mysum(10, 20, 30)) # 60 答案: def mysum(*args): i = 0 for x in args: i += x return i print(mysum(1, 2, 3, 4)) # 10 print(mysum(10, 20, 30)) # 60 6. 创建一个全局变量 L = [] 写一个函数: def input_number(): .... 此函数每次调用将从键盘读入一些数字追加到列表L中 如: L = [] def input_number(): .... input_number() print(L) # [ .... 这些是您从键盘输入的数..] L = [] def input_number(): while True: a = int(input("please input (-1 over):")) if a < 0: break L.append(a) return L L = input_number() print(L) # [ .... 这些是您从键盘输入的数..] 7. 写一个函数isprime(x) 判断x是否为素数。如果是素数,返回True,否则返回False 答案: def isprime(x): if x > 2: for i in range(2, x): if x % i == 0: s = False break else: s = True else: if 1 < x < 3: s = True else: s = False return s x = isprime(4) print(x) 8. 写一个函数prime_m2n(m, n) 返回从m开始,到n结束(不包含n)范围内的素数,返回这些素数的列表并打印 如: L = prime_m2n(5, 10) print(L) [5, 7] 答案: def prime_m2n(m, n): L = [] for x in range(m, n): if isprime(x) == True: L.append(x) return L L = prime_m2n(5, 10) print(L) 9. 写一个函数pimes(n) 返回小于n的全部素数的列表,并打印这些素数 如: L = primes(10) print(L) # [2, 3, 5, 7] 1) 打印100 以内的全部素数 2) 打印200 以内的全部素数的和 答案: def pinmes(n): return prime_m2n(1, n) L = pinmes(10) print(L) # [2, 3, 5, 7] print(pinmes(100)) print(sum(pinmes(200))) 10. 编写函数 fn(n) 此函数返回下列级数的和: fn(n) = 1/(1*2) + 1/(2*3) + .... + 1/(n*(n-1)) 的和 print(fn(100)) 答案: def fn(n): s = 0 for i in range(1, n): s += 1 / (i * (i + 1)) return s print(fn(100)) 一波经验加成buff: (咳咳 C波牛B) 开局 一人 一电脑 ,一键盘999999999999999级你肯会迷茫 晕眩 摸不着头尾 没关系 给你加个经验值BUFF 因为很多专业术语比较抽象 再加上翻译差别 所以说很多人都是知道专业术语该怎么说叫什么 一般容易记住和记忆最久的应该就是用自己的方式去跟现实或者一些列子对比越白话文越好记 什么花里胡哨的术语 知道是什么就行了 (能记还是要记得 说也尽量说 只是在你脑子里是一个对应的实例关系 就好比 变量 在内存中.......跑题了 溜了 溜了) 实参、传参、形参是什么 ? 实参就是调用函数时的参数 传参就是把形参传给实参的过程 形参就是定义(封装)函数时的参数字典关键字传参就是把字典先用(**)拆开分成形参和实参 键代表关键字(形参、不可变) 值代表参数(实参、可变) 一个键对应一个值 一个关键字对应一个参数 列表、元组 都是属于顺序传参 先用(*)拆分后传参 关键字传参必须有关键字(形参)和参数(实参)传参的排序规则: 从左到右 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 变量没什么可说的 就相当于一个公共电话(全局)和私人手机(局部) 所有人都可以用公共电话 你的私人手机你会让所有人用吗?我想不会吧


优秀的个人博客,低调大师

Python全栈工程师(字符串/序列)

ParisGabriel Python 入门基础 字符串:str用来记录文本信息字符串的表示方式:在非注释中凡是用引号括起来的部分都是字符串‘’ 单引号“” 双引号''' ''' 三单引""" """ 三双引有内容代表非空字符串否则是空字符串 区别:单引号内的双引号不算结束符双引号内的单引号不算结束符三引号内的换行会自动转换为换行符三引号内可以包含单引号和双引号 隐式字符串拼接: s = "I'm a I'm a programmer" 'heoll "wored"' 转移符:\' 单引号\" 双引号\\ 单反斜杠\n 换行\r 返回光标至行首\t 水平制表符\v 垂直制表符\f 换页\b 倒退\0 空字符,字符值为0\xXX ,XX为两位16进制表示的自符\uXXXX ,XXXX为4个16进制的Unicode16字符\UXXXXXXXX ,8个16进制表示的Unicode32字符 ASCII编码:man ASCII:查看帮助文档命令 常用ASCII编码:字符 十进制 十六进制 0 48 0x30 A 65 0x41 a 97 0x61 Unicode:统一编码,分为Unicode16、Unicode32 序列的概念:字符串就是序列函数:len(x) 返回字符串的字符个数raw 字符串:让转义符号\无效格式:r‘字符串内容’print(r“\n\\\t”)字符串的运算:+ 用于拼接字符串* 用于生成重复字符串字符串的相乘只能与整数+= *= 与其他符合运算符相同in / not in 运算符:用于判断某个字符串是否在相当于字符串出现过 如果出现过返回true 否则返回false字符串的比较运算:> >= < <= == != 依次按照编码进行比较,直到最短字符串结束为止 索引(下标):Python的字符串是不可以改变字符序列的 index:字符串[整数表达式]Python序列都可以用索引来访问序列中的对象Python的序列正向索引是冲0开始的最后一个索引为len(s)-1Python序列的反响索引是从-1开始的 -1是最后一个 第一个是 -len(s) 切片:slice从一个字符串序列中取出相应的元素重新组成一个字符串系列语法:字符串序列[(开始索引b):(结束索引e):(步长s)]小括号括起的部分代表可省略说明:开始索引是切片开始切下的位置,0代表第一个元素,1代表第二个,-1代表最后一个结束索引是切片的终止索引(但不包括终止点)步长:是切片每次获取当前元素后移动的方向和偏移量没有步长,相当于取值完成后向右移动一个索引的位置默认1当步长代表为正数时取正向切片 步长默认为1 开始位置为0 结束为len(s)步长代表下一次索引的取值增长值当步长为负数时 取反向切片 默认的起始位置是最后一个元素,终止位置是第一个元素的前一个位置 Python3中常用于序列函数:len(x)返回序列长度 max(x)返回序列最大值元素 min(x)返回序列最小止元素 字符串编码转换函数:ord(c)返回一个字符的Unicode值(十进制) chr(i)返回 i这个整数的值所对应的字符 整数转字符串函数:bin(i) 将整数转换为二进制的字符串 oct(i) 将整数转换为八进制的字符串 hex(i) 将整数转换为十六进制的字符串 二进制转换其他进制是非常好转的 如图: 100=4 101=5 10=2 156=0o452 (八进制) 1100=c 1001=9 156=0x9c (十六进制) 字符串的构造函数:str(obj=“”) 将对象转换为字符串 常用的字符串方法:文档参见:对象.方法名(方法传参)"abc".isalpha() # 语法是对的123.isalpha() # 语法是错的方法 说明S.isdigit() 判断字符串中的字符是否全为数字S.isalpha() 判断字符串是否全为英文字母S.islower() 判断字符串所有字符是否全为小写英文字母S.isupper() 判断字符串所有字符是否全为大写英文字母S.isspace() 判断字符串是否全为空白字符S.center(width[,fill]) 将原字符串居中,左右默认填充空格 width:所居中字符串的长度 fill:默认填充空格 S.count(sub[, start[,end]]) 获取一个字符串中子串的个数 sub:所要获取的字符串 start:起始位置 end:结束位置S.find(sub[, start[,end]]) 获取字符串中子串sub的索引,失败返回-1 start:起始位置 end:结束位置 S.strip() 返回去掉左右空白字符的字符串S.lstrip() 返回去掉左侧空白字符的字符串S.rstrip() 返回去掉右侧空白字符的字符串S.upper() 生成将英文转换为大写的字符串S.lower() 生成将英文转换为小写的字符串S.replace(old, new[, count]) 将原字符串的old用new代替,生成一个新的字符串 count:更换的次数S.startswith(prefix[, start[, end]]) 返回S是否是以prefix开头,如果以prefix开头返回True,否则返回False,S.endswith(suffix[, start[, end]]) 返回S是否是以suffix结尾,如果以suffix结尾返回True,否则返回False 以下是不常用的 S.title() 生成每个英文单词的首字母大写字符串S.isnumeric() 判断字符串是否全为数字字符 练习:1.输入一个字符串用s绑定判断输入有几个人空格将原字符串的左右空格空白符去掉打印剩余的字符个数判断输入的是否是数字如果是数字判断这个数是否大于100 答案: print("Answer to question 1:", "\n") s = input("plaese input at will string:") print("you input string blank have ", s.count(" ")) print("string surplus:", len(s.strip())) if s.isdigit() is True: if int(s) > 100: print("input integer:", s, ">100") else: print("input integer:", s, "<100") else: print("you input contain alpha:", s) 2.输入3行文字,让这三行文字在一个方框内居中显示显示如下:+---------------+| hello || 123123 || |+---------------+注:请不要输入中文 答案: print("Answer to question 2:", "\n") a = input("plaese input at will string 1:") b = input("plaese input at will string 2:") c = input("plaese input at will string 3:") top = a if top < b: top = b if top < c: top = c print("+" + "-" * (len(top) * 2 + 10) + "+") print("|" + a.center(len(top) * 2 + 10) + "|") print("|" + b.center(len(top) * 2 + 10) + "|") print("|" + c.center(len(top) * 2 + 10) + "|") print("+" + "-" * (len(top) * 2 + 10) + "+")

优秀的个人博客,低调大师

最全 Docker 介绍与教程,一文全掌握

2013年发布至今, Docker 一直广受瞩目,被认为可能会改变软件行业。 但是,许多人并不清楚 Docker 到底是什么,要解决什么问题,好处又在哪里?本文就来详细解释,帮助大家理解它,还带有简单易懂的实例,教你如何将它用于日常开发。 一、环境配置的难题 软件开发最大的麻烦事之一,就是环境配置。用户计算机的环境都不相同,你怎么知道自家的软件,能在那些机器跑起来? 用户必须保证两件事:操作系统的设置,各种库和组件的安装。只有它们都正确,软件才能运行。举例来说,安装一个 Python 应用,计算机必须有 Python 引擎,还必须有各种依赖,可能还要配置环境变量。 如果某些老旧的模块与当前环境不兼容,那就麻烦了。开发者常常会说:"它在我的机器可以跑了"(It works on my machine),言下之意就是,其他机器很可能跑不了。 环境配置如此麻烦,换一台机器,就要重来一次,旷日费时。很多人想到,能不能从根本上解决问题,软件可以带环境安装?也就是说,安装的时候,把原始环境一模一样地复制过来。 二、虚拟机 虚拟机(virtual machine)就是带环境安装的一种解决方案。它可以在一种操作系统里面运行另一种操作系统,比如在 Windows 系统里面运行 Linux 系统。应用程序对此毫无感知,因为虚拟机看上去跟真实系统一模一样,而对于底层系统来说,虚拟机就是一个普通文件,不需要了就删掉,对其他部分毫无影响。 虽然用户可以通过虚拟机还原软件的原始环境。但是,这个方案有几个缺点。 (1)资源占用多 虚拟机会独占一部分内存和硬盘空间。它运行的时候,其他程序就不能使用这些资源了。哪怕虚拟机里面的应用程序,真正使用的内存只有 1MB,虚拟机依然需要几百 MB 的内存才能运行。 (2)冗余步骤多 虚拟机是完整的操作系统,一些系统级别的操作步骤,往往无法跳过,比如用户登录。 (3)启动慢 启动操作系统需要多久,启动虚拟机就需要多久。可能要等几分钟,应用程序才能真正运行。 三、Linux 容器 由于虚拟机存在这些缺点,Linux 发展出了另一种虚拟化技术:Linux 容器(Linux Containers,缩写为 LXC)。 Linux 容器不是模拟一个完整的操作系统,而是对进程进行隔离。或者说,在正常进程的外面套了一个保护层。对于容器里面的进程来说,它接触到的各种资源都是虚拟的,从而实现与底层系统的隔离。 由于容器是进程级别的,相比虚拟机有很多优势。 (1)启动快 容器里面的应用,直接就是底层系统的一个进程,而不是虚拟机内部的进程。所以,启动容器相当于启动本机的一个进程,而不是启动一个操作系统,速度就快很多。 (2)资源占用少 容器只占用需要的资源,不占用那些没有用到的资源;虚拟机由于是完整的操作系统,不可避免要占用所有资源。另外,多个容器可以共享资源,虚拟机都是独享资源。 (3)体积小 容器只要包含用到的组件即可,而虚拟机是整个操作系统的打包,所以容器文件比虚拟机文件要小很多。 总之,容器有点像轻量级的虚拟机,能够提供虚拟化的环境,但是成本开销小得多。 四、Docker 是什么? Docker 属于 Linux 容器的一种封装,提供简单易用的容器使用接口。它是目前最流行的 Linux 容器解决方案。 Docker 将应用程序与该程序的依赖,打包在一个文件里面。运行这个文件,就会生成一个虚拟容器。程序在这个虚拟容器里运行,就好像在真实的物理机上运行一样。有了 Docker,就不用担心环境问题。 总体来说,Docker 的接口相当简单,用户可以方便地创建和使用容器,把自己的应用放入容器。容器还可以进行版本管理、复制、分享、修改,就像管理普通的代码一样。 五、Docker 的用途 Docker 的主要用途,目前有三大类。 (1)提供一次性的环境。比如,本地测试他人的软件、持续集成的时候提供单元测试和构建的环境。 (2)提供弹性的云服务。因为 Docker 容器可以随开随关,很适合动态扩容和缩容。 (3)组建微服务架构。通过多个容器,一台机器可以跑多个服务,因此在本机就可以模拟出微服务架构。 六、Docker 的安装 Docker 是一个开源的商业产品,有两个版本:社区版(Community Edition,缩写为 CE)和企业版(Enterprise Edition,缩写为 EE)。企业版包含了一些收费服务,个人开发者一般用不到。下面的介绍都针对社区版。 Docker CE 的安装请参考官方文档。 安装完成后,运行下面的命令,验证是否安装成功。 $ docker version$ docker info Docker 需要用户具有 sudo 权限,为了避免每次命令都输入sudo,可以把用户加入 Docker 用户组(官方文档)。 $ sudo usermod -aG docker $USER Docker 是服务器----客户端架构。命令行运行docker命令的时候,需要本机有 Docker 服务。如果这项服务没有启动,可以用下面的命令启动(官方文档)。 $ sudo service docker start$ sudo systemctl start docker 七、image 文件 Docker 把应用程序及其依赖,打包在 image 文件里面。只有通过这个文件,才能生成 Docker 容器。image 文件可以看作是容器的模板。Docker 根据 image 文件生成容器的实例。同一个 image 文件,可以生成多个同时运行的容器实例。 image 是二进制文件。实际开发中,一个 image 文件往往通过继承另一个 image 文件,加上一些个性化设置而生成。举例来说,你可以在 Ubuntu 的 image 基础上,往里面加入 Apache 服务器,形成你的 image。 $ docker image ls$ docker image rm [imageName] image 文件是通用的,一台机器的 image 文件拷贝到另一台机器,照样可以使用。一般来说,为了节省时间,我们应该尽量使用别人制作好的 image 文件,而不是自己制作。即使要定制,也应该基于别人的 image 文件进行加工,而不是从零开始制作。 为了方便共享,image 文件制作完成后,可以上传到网上的仓库。Docker 的官方仓库 Docker Hub 是最重要、最常用的 image 仓库。此外,出售自己制作的 image 文件也是可以的。 八、实例:hello world 下面,我们通过最简单的 image 文件"hello world",感受一下 Docker。 需要说明的是,国内连接 Docker 的官方仓库很慢,还会断线,需要将默认仓库改成国内的镜像网站,具体的修改方法在下一篇文章的第一节。有需要的朋友,可以先看一下。 首先,运行下面的命令,将 image 文件从仓库抓取到本地。 $ docker image pull library/hello-world 上面代码中,docker image pull是抓取 image 文件的命令。library/hello-world是 image 文件在仓库里面的位置,其中library是 image 文件所在的组,hello-world是 image 文件的名字。 由于 Docker 官方提供的 image 文件,都放在library组里面,所以它的是默认组,可以省略。因此,上面的命令可以写成下面这样。 $ docker image pull hello-world 抓取成功以后,就可以在本机看到这个 image 文件了。 $ docker image ls 现在,运行这个 image 文件。 docker container run命令会从 image 文件,生成一个正在运行的容器实例。 注意,docker container run命令具有自动抓取 image 文件的功能。如果发现本地没有指定的 image 文件,就会从仓库自动抓取。因此,前面的docker image pull命令并不是必需的步骤。 如果运行成功,你会在屏幕上读到下面的输出。 $ docker container run hello-worldHello from Docker!This message shows that your installation appears to be working correctly... 输出这段提示以后,hello world就会停止运行,容器自动终止。 有些容器不会自动终止,因为提供的是服务。比如,安装运行 Ubuntu 的 image,就可以在命令行体验 Ubuntu 系统。 $ docker container run -it ubuntu bash 对于那些不会自动终止的容器,必须使用docker container kill 命令手动终止。 $ docker container kill [containID] 九、容器文件 image 文件生成的容器实例,本身也是一个文件,称为容器文件。也就是说,一旦容器生成,就会同时存在两个文件: image 文件和容器文件。而且关闭容器并不会删除容器文件,只是容器停止运行而已。 $ docker container ls$ docker container ls --all 上面命令的输出结果之中,包括容器的 ID。很多地方都需要提供这个 ID,比如上一节终止容器运行的docker container kill命令。 终止运行的容器文件,依然会占据硬盘空间,可以使用docker container rm命令删除。 $ docker container rm [containerID] 运行上面的命令之后,再使用docker container ls --all命令,就会发现被删除的容器文件已经消失了。 十、Dockerfile 文件 学会使用 image 文件以后,接下来的问题就是,如何可以生成 image 文件?如果你要推广自己的软件,势必要自己制作 image 文件。 这就需要用到 Dockerfile 文件。它是一个文本文件,用来配置 image。Docker 根据 该文件生成二进制的 image 文件。 下面通过一个实例,演示如何编写 Dockerfile 文件。 十一、实例:制作自己的 Docker 容器 下面我以 koa-demos 项目为例,介绍怎么写 Dockerfile 文件,实现让用户在 Docker 容器里面运行 Koa 框架。 作为准备工作,请先下载源码。 $ git clone https://github.com/ruanyf/koa-demos.git$ cd koa-demos 11.1 编写 Dockerfile 文件 首先,在项目的根目录下,新建一个文本文件.dockerignore,写入下面的内容。 .gitnode_modulesnpm-debug.log 上面代码表示,这三个路径要排除,不要打包进入 image 文件。如果你没有路径要排除,这个文件可以不新建。 然后,在项目的根目录下,新建一个文本文件 Dockerfile,写入下面的内容。 FROM node:8.4COPY . /appWORKDIR /appRUN npm install --registry=https://registry.npm.taobao.orgEXPOSE 3000 上面代码一共五行,含义如下。 FROM node:8.4:该 image 文件继承官方的 node image,冒号表示标签,这里标签是8.4,即8.4版本的 node。 COPY . /app:将当前目录下的所有文件(除了.dockerignore排除的路径),都拷贝进入 image 文件的/app目录。 WORKDIR /app:指定接下来的工作路径为/app。 RUN npm install:在/app目录下,运行npm install命令安装依赖。注意,安装后所有的依赖,都将打包进入 image 文件。 EXPOSE 3000:将容器 3000 端口暴露出来, 允许外部连接这个端口。 11.2 创建 image 文件 有了 Dockerfile 文件以后,就可以使用docker image build命令创建 image 文件了。 $ docker image build -t koa-demo .$ docker image build -t koa-demo:0.0.1 . 上面代码中,-t参数用来指定 image 文件的名字,后面还可以用冒号指定标签。如果不指定,默认的标签就是latest。最后的那个点表示 Dockerfile 文件所在的路径,上例是当前路径,所以是一个点。 如果运行成功,就可以看到新生成的 image 文件koa-demo了。 $ docker image ls 11.3 生成容器 docker container run命令会从 image 文件生成容器。 $ docker container run -p 8000:3000 -it koa-demo /bin/bash$ docker container run -p 8000:3000 -it koa-demo:0.0.1 /bin/bash 上面命令的各个参数含义如下: -p参数:容器的 3000 端口映射到本机的 8000 端口。 -it参数:容器的 Shell 映射到当前的 Shell,然后你在本机窗口输入的命令,就会传入容器。 koa-demo:0.0.1:image 文件的名字(如果有标签,还需要提供标签,默认是 latest 标签)。 /bin/bash:容器启动以后,内部第一个执行的命令。这里是启动 Bash,保证用户可以使用 Shell。 如果一切正常,运行上面的命令以后,就会返回一个命令行提示符。 root@66d80f4aaf1e:/app 这表示你已经在容器里面了,返回的提示符就是容器内部的 Shell 提示符。执行下面的命令。 root@66d80f4aaf1e:/app 这时,Koa 框架已经运行起来了。打开本机的浏览器,访问 http://127.0.0.1:8000,网页显示"Not Found",这是因为这个 demo 没有写路由。 这个例子中,Node 进程运行在 Docker 容器的虚拟环境里面,进程接触到的文件系统和网络接口都是虚拟的,与本机的文件系统和网络接口是隔离的,因此需要定义容器与物理机的端口映射(map)。 现在,在容器的命令行,按下 Ctrl + c 停止 Node 进程,然后按下 Ctrl + d (或者输入 exit)退出容器。此外,也可以用docker container kill终止容器运行。 $ docker container ls$ docker container kill [containerID] 容器停止运行之后,并不会消失,用下面的命令删除容器文件。 $ docker container ls --all$ docker container rm [containerID] 也可以使用docker container run命令的--rm参数,在容器终止运行后自动删除容器文件。 $ docker container run --rm -p 8000:3000 -it koa-demo /bin/bash 10.4 CMD 命令 上一节的例子里面,容器启动以后,需要手动输入命令node demos/01.js。我们可以把这个命令写在 Dockerfile 里面,这样容器启动以后,这个命令就已经执行了,不用再手动输入了。 FROM node:8.4COPY . /appWORKDIR /appRUN npm install --registry=https://registry.npm.taobao.orgEXPOSE 3000CMD node demos/01.js 上面的 Dockerfile 里面,多了最后一行CMD node demos/01.js,它表示容器启动后自动执行node demos/01.js。 你可能会问,RUN命令与CMD命令的区别在哪里?简单说,RUN命令在 image 文件的构建阶段执行,执行结果都会打包进入 image 文件;CMD命令则是在容器启动后执行。另外,一个 Dockerfile 可以包含多个RUN命令,但是只能有一个CMD命令。 注意,指定了CMD命令以后,docker container run命令就不能附加命令了(比如前面的/bin/bash),否则它会覆盖CMD命令。现在,启动容器可以使用下面的命令。 $ docker container run --rm -p 8000:3000 -it koa-demo:0.0.1 10.5 发布 image 文件 容器运行成功后,就确认了 image 文件的有效性。这时,我们就可以考虑把 image 文件分享到网上,让其他人使用。 首先,去 hub.docker.com 或 cloud.docker.com 注册一个账户。然后,用下面的命令登录。 接着,为本地的 image 标注用户名和版本。 $ docker image tag [imageName] [username]/[repository]:[tag]$ docker image tag koa-demos:0.0.1 ruanyf/koa-demos:0.0.1 也可以不标注用户名,重新构建一下 image 文件。 $ docker image build -t [username]/[repository]:[tag] . 最后,发布 image 文件。 $ docker image push [username]/[repository]:[tag] 发布成功以后,登录 hub.docker.com,就可以看到已经发布的 image 文件。 十二、其他有用的命令 docker 的主要用法就是上面这些,此外还有几个命令,也非常有用。 (1)docker container start 前面的docker container run命令是新建容器,每运行一次,就会新建一个容器。同样的命令运行两次,就会生成两个一模一样的容器文件。如果希望重复使用容器,就要使用docker container start命令,它用来启动已经生成、已经停止运行的容器文件。 $ docker container start [containerID] (2)docker container stop 前面的docker container kill命令终止容器运行,相当于向容器里面的主进程发出 SIGKILL 信号。而docker container stop命令也是用来终止容器运行,相当于向容器里面的主进程发出 SIGTERM 信号,然后过一段时间再发出 SIGKILL 信号。 $ bash container stop [containerID] 这两个信号的差别是,应用程序收到 SIGTERM 信号以后,可以自行进行收尾清理工作,但也可以不理会这个信号。如果收到 SIGKILL 信号,就会强行立即终止,那些正在进行中的操作会全部丢失。 (3)docker container logs docker container logs命令用来查看 docker 容器的输出,即容器里面 Shell 的标准输出。如果docker run命令运行容器的时候,没有使用-it参数,就要用这个命令查看输出。 $ docker container logs [containerID] (4)docker container exec docker container exec命令用于进入一个正在运行的 docker 容器。如果docker run命令运行容器的时候,没有使用-it参数,就要用这个命令进入容器。一旦进入了容器,就可以在容器的 Shell 执行命令了。 $ docker container exec -it [containerID] /bin/bash (5)docker container cp docker container cp命令用于从正在运行的 Docker 容器里面,将文件拷贝到本机。下面是拷贝到当前目录的写法。 $ docker container cp [containID]:[/path/to/file] . 非常感谢你一直读到了这里,这个系列还有下一篇,介绍如何使用 Docker 搭建真正的网站,欢迎继续阅读。 欢迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 2013年发布至今, Docker 一直广受瞩目,被认为可能会改变软件行业。 但是,许多人并不清楚 Docker 到底是什么,要解决什么问题,好处又在哪里?本文就来详细解释,帮助大家理解它,还带有简单易懂的实例,教你如何将它用于日常开发。 一、环境配置的难题 软件开发最大的麻烦事之一,就是环境配置。用户计算机的环境都不相同,你怎么知道自家的软件,能在那些机器跑起来? 用户必须保证两件事:操作系统的设置,各种库和组件的安装。只有它们都正确,软件才能运行。举例来说,安装一个 Python 应用,计算机必须有 Python 引擎,还必须有各种依赖,可能还要配置环境变量。 如果某些老旧的模块与当前环境不兼容,那就麻烦了。开发者常常会说:"它在我的机器可以跑了"(It works on my machine),言下之意就是,其他机器很可能跑不了。 环境配置如此麻烦,换一台机器,就要重来一次,旷日费时。很多人想到,能不能从根本上解决问题,软件可以带环境安装?也就是说,安装的时候,把原始环境一模一样地复制过来。 二、虚拟机 虚拟机(virtual machine)就是带环境安装的一种解决方案。它可以在一种操作系统里面运行另一种操作系统,比如在 Windows 系统里面运行 Linux 系统。应用程序对此毫无感知,因为虚拟机看上去跟真实系统一模一样,而对于底层系统来说,虚拟机就是一个普通文件,不需要了就删掉,对其他部分毫无影响。 虽然用户可以通过虚拟机还原软件的原始环境。但是,这个方案有几个缺点。 (1)资源占用多 虚拟机会独占一部分内存和硬盘空间。它运行的时候,其他程序就不能使用这些资源了。哪怕虚拟机里面的应用程序,真正使用的内存只有 1MB,虚拟机依然需要几百 MB 的内存才能运行。 (2)冗余步骤多 虚拟机是完整的操作系统,一些系统级别的操作步骤,往往无法跳过,比如用户登录。 (3)启动慢 启动操作系统需要多久,启动虚拟机就需要多久。可能要等几分钟,应用程序才能真正运行。 三、Linux 容器 由于虚拟机存在这些缺点,Linux 发展出了另一种虚拟化技术:Linux 容器(Linux Containers,缩写为 LXC)。 Linux 容器不是模拟一个完整的操作系统,而是对进程进行隔离。或者说,在正常进程的外面套了一个保护层。对于容器里面的进程来说,它接触到的各种资源都是虚拟的,从而实现与底层系统的隔离。 由于容器是进程级别的,相比虚拟机有很多优势。 (1)启动快 容器里面的应用,直接就是底层系统的一个进程,而不是虚拟机内部的进程。所以,启动容器相当于启动本机的一个进程,而不是启动一个操作系统,速度就快很多。 (2)资源占用少 容器只占用需要的资源,不占用那些没有用到的资源;虚拟机由于是完整的操作系统,不可避免要占用所有资源。另外,多个容器可以共享资源,虚拟机都是独享资源。 (3)体积小 容器只要包含用到的组件即可,而虚拟机是整个操作系统的打包,所以容器文件比虚拟机文件要小很多。 总之,容器有点像轻量级的虚拟机,能够提供虚拟化的环境,但是成本开销小得多。 四、Docker 是什么? Docker 属于 Linux 容器的一种封装,提供简单易用的容器使用接口。它是目前最流行的 Linux 容器解决方案。 Docker 将应用程序与该程序的依赖,打包在一个文件里面。运行这个文件,就会生成一个虚拟容器。程序在这个虚拟容器里运行,就好像在真实的物理机上运行一样。有了 Docker,就不用担心环境问题。 总体来说,Docker 的接口相当简单,用户可以方便地创建和使用容器,把自己的应用放入容器。容器还可以进行版本管理、复制、分享、修改,就像管理普通的代码一样。 五、Docker 的用途 Docker 的主要用途,目前有三大类。 (1)提供一次性的环境。比如,本地测试他人的软件、持续集成的时候提供单元测试和构建的环境。 (2)提供弹性的云服务。因为 Docker 容器可以随开随关,很适合动态扩容和缩容。 (3)组建微服务架构。通过多个容器,一台机器可以跑多个服务,因此在本机就可以模拟出微服务架构。 六、Docker 的安装 Docker 是一个开源的商业产品,有两个版本:社区版(Community Edition,缩写为 CE)和企业版(Enterprise Edition,缩写为 EE)。企业版包含了一些收费服务,个人开发者一般用不到。下面的介绍都针对社区版。 Docker CE 的安装请参考官方文档。 安装完成后,运行下面的命令,验证是否安装成功。 $ docker version$ docker info Docker 需要用户具有 sudo 权限,为了避免每次命令都输入sudo,可以把用户加入 Docker 用户组(官方文档)。 $ sudo usermod -aG docker $USER Docker 是服务器----客户端架构。命令行运行docker命令的时候,需要本机有 Docker 服务。如果这项服务没有启动,可以用下面的命令启动(官方文档)。 $ sudo service docker start$ sudo systemctl start docker 七、image 文件 Docker 把应用程序及其依赖,打包在 image 文件里面。只有通过这个文件,才能生成 Docker 容器。image 文件可以看作是容器的模板。Docker 根据 image 文件生成容器的实例。同一个 image 文件,可以生成多个同时运行的容器实例。 image 是二进制文件。实际开发中,一个 image 文件往往通过继承另一个 image 文件,加上一些个性化设置而生成。举例来说,你可以在 Ubuntu 的 image 基础上,往里面加入 Apache 服务器,形成你的 image。 $ docker image ls$ docker image rm [imageName] image 文件是通用的,一台机器的 image 文件拷贝到另一台机器,照样可以使用。一般来说,为了节省时间,我们应该尽量使用别人制作好的 image 文件,而不是自己制作。即使要定制,也应该基于别人的 image 文件进行加工,而不是从零开始制作。 为了方便共享,image 文件制作完成后,可以上传到网上的仓库。Docker 的官方仓库 Docker Hub 是最重要、最常用的 image 仓库。此外,出售自己制作的 image 文件也是可以的。 八、实例:hello world 下面,我们通过最简单的 image 文件"hello world",感受一下 Docker。 需要说明的是,国内连接 Docker 的官方仓库很慢,还会断线,需要将默认仓库改成国内的镜像网站,具体的修改方法在下一篇文章的第一节。有需要的朋友,可以先看一下。 首先,运行下面的命令,将 image 文件从仓库抓取到本地。 $ docker image pull library/hello-world 上面代码中,docker image pull是抓取 image 文件的命令。library/hello-world是 image 文件在仓库里面的位置,其中library是 image 文件所在的组,hello-world是 image 文件的名字。 由于 Docker 官方提供的 image 文件,都放在library组里面,所以它的是默认组,可以省略。因此,上面的命令可以写成下面这样。 $ docker image pull hello-world 抓取成功以后,就可以在本机看到这个 image 文件了。 $ docker image ls 现在,运行这个 image 文件。 docker container run命令会从 image 文件,生成一个正在运行的容器实例。 注意,docker container run命令具有自动抓取 image 文件的功能。如果发现本地没有指定的 image 文件,就会从仓库自动抓取。因此,前面的docker image pull命令并不是必需的步骤。 如果运行成功,你会在屏幕上读到下面的输出。 $ docker container run hello-worldHello from Docker!This message shows that your installation appears to be working correctly... 输出这段提示以后,hello world就会停止运行,容器自动终止。 有些容器不会自动终止,因为提供的是服务。比如,安装运行 Ubuntu 的 image,就可以在命令行体验 Ubuntu 系统。 $ docker container run -it ubuntu bash 对于那些不会自动终止的容器,必须使用docker container kill 命令手动终止。 $ docker container kill [containID] 九、容器文件 image 文件生成的容器实例,本身也是一个文件,称为容器文件。也就是说,一旦容器生成,就会同时存在两个文件: image 文件和容器文件。而且关闭容器并不会删除容器文件,只是容器停止运行而已。 $ docker container ls$ docker container ls --all 上面命令的输出结果之中,包括容器的 ID。很多地方都需要提供这个 ID,比如上一节终止容器运行的docker container kill命令。 终止运行的容器文件,依然会占据硬盘空间,可以使用docker container rm命令删除。 $ docker container rm [containerID] 运行上面的命令之后,再使用docker container ls --all命令,就会发现被删除的容器文件已经消失了。 十、Dockerfile 文件 学会使用 image 文件以后,接下来的问题就是,如何可以生成 image 文件?如果你要推广自己的软件,势必要自己制作 image 文件。 这就需要用到 Dockerfile 文件。它是一个文本文件,用来配置 image。Docker 根据 该文件生成二进制的 image 文件。 下面通过一个实例,演示如何编写 Dockerfile 文件。 十一、实例:制作自己的 Docker 容器 下面我以 koa-demos 项目为例,介绍怎么写 Dockerfile 文件,实现让用户在 Docker 容器里面运行 Koa 框架。 作为准备工作,请先下载源码。 $ git clone https://github.com/ruanyf/koa-demos.git$ cd koa-demos 11.1 编写 Dockerfile 文件 首先,在项目的根目录下,新建一个文本文件.dockerignore,写入下面的内容。 .gitnode_modulesnpm-debug.log 上面代码表示,这三个路径要排除,不要打包进入 image 文件。如果你没有路径要排除,这个文件可以不新建。 然后,在项目的根目录下,新建一个文本文件 Dockerfile,写入下面的内容。 FROM node:8.4COPY . /appWORKDIR /appRUN npm install --registry=https://registry.npm.taobao.orgEXPOSE 3000 上面代码一共五行,含义如下。 FROM node:8.4:该 image 文件继承官方的 node image,冒号表示标签,这里标签是8.4,即8.4版本的 node。 COPY . /app:将当前目录下的所有文件(除了.dockerignore排除的路径),都拷贝进入 image 文件的/app目录。 WORKDIR /app:指定接下来的工作路径为/app。 RUN npm install:在/app目录下,运行npm install命令安装依赖。注意,安装后所有的依赖,都将打包进入 image 文件。 EXPOSE 3000:将容器 3000 端口暴露出来, 允许外部连接这个端口。 11.2 创建 image 文件 有了 Dockerfile 文件以后,就可以使用docker image build命令创建 image 文件了。 $ docker image build -t koa-demo .$ docker image build -t koa-demo:0.0.1 . 上面代码中,-t参数用来指定 image 文件的名字,后面还可以用冒号指定标签。如果不指定,默认的标签就是latest。最后的那个点表示 Dockerfile 文件所在的路径,上例是当前路径,所以是一个点。 如果运行成功,就可以看到新生成的 image 文件koa-demo了。 $ docker image ls 11.3 生成容器 docker container run命令会从 image 文件生成容器。 $ docker container run -p 8000:3000 -it koa-demo /bin/bash$ docker container run -p 8000:3000 -it koa-demo:0.0.1 /bin/bash 上面命令的各个参数含义如下: -p参数:容器的 3000 端口映射到本机的 8000 端口。 -it参数:容器的 Shell 映射到当前的 Shell,然后你在本机窗口输入的命令,就会传入容器。 koa-demo:0.0.1:image 文件的名字(如果有标签,还需要提供标签,默认是 latest 标签)。 /bin/bash:容器启动以后,内部第一个执行的命令。这里是启动 Bash,保证用户可以使用 Shell。 如果一切正常,运行上面的命令以后,就会返回一个命令行提示符。 root@66d80f4aaf1e:/app 这表示你已经在容器里面了,返回的提示符就是容器内部的 Shell 提示符。执行下面的命令。 root@66d80f4aaf1e:/app 这时,Koa 框架已经运行起来了。打开本机的浏览器,访问 http://127.0.0.1:8000,网页显示"Not Found",这是因为这个 demo 没有写路由。 这个例子中,Node 进程运行在 Docker 容器的虚拟环境里面,进程接触到的文件系统和网络接口都是虚拟的,与本机的文件系统和网络接口是隔离的,因此需要定义容器与物理机的端口映射(map)。 现在,在容器的命令行,按下 Ctrl + c 停止 Node 进程,然后按下 Ctrl + d (或者输入 exit)退出容器。此外,也可以用docker container kill终止容器运行。 $ docker container ls$ docker container kill [containerID] 容器停止运行之后,并不会消失,用下面的命令删除容器文件。 $ docker container ls --all$ docker container rm [containerID] 也可以使用docker container run命令的--rm参数,在容器终止运行后自动删除容器文件。 $ docker container run --rm -p 8000:3000 -it koa-demo /bin/bash 10.4 CMD 命令 上一节的例子里面,容器启动以后,需要手动输入命令node demos/01.js。我们可以把这个命令写在 Dockerfile 里面,这样容器启动以后,这个命令就已经执行了,不用再手动输入了。 FROM node:8.4COPY . /appWORKDIR /appRUN npm install --registry=https://registry.npm.taobao.orgEXPOSE 3000CMD node demos/01.js 上面的 Dockerfile 里面,多了最后一行CMD node demos/01.js,它表示容器启动后自动执行node demos/01.js。 你可能会问,RUN命令与CMD命令的区别在哪里?简单说,RUN命令在 image 文件的构建阶段执行,执行结果都会打包进入 image 文件;CMD命令则是在容器启动后执行。另外,一个 Dockerfile 可以包含多个RUN命令,但是只能有一个CMD命令。 注意,指定了CMD命令以后,docker container run命令就不能附加命令了(比如前面的/bin/bash),否则它会覆盖CMD命令。现在,启动容器可以使用下面的命令。 $ docker container run --rm -p 8000:3000 -it koa-demo:0.0.1 10.5 发布 image 文件 容器运行成功后,就确认了 image 文件的有效性。这时,我们就可以考虑把 image 文件分享到网上,让其他人使用。 首先,去 hub.docker.com 或 cloud.docker.com 注册一个账户。然后,用下面的命令登录。 接着,为本地的 image 标注用户名和版本。 $ docker image tag [imageName] [username]/[repository]:[tag]$ docker image tag koa-demos:0.0.1 ruanyf/koa-demos:0.0.1 也可以不标注用户名,重新构建一下 image 文件。 $ docker image build -t [username]/[repository]:[tag] . 最后,发布 image 文件。 $ docker image push [username]/[repository]:[tag] 发布成功以后,登录 hub.docker.com,就可以看到已经发布的 image 文件。 十二、其他有用的命令 docker 的主要用法就是上面这些,此外还有几个命令,也非常有用。 (1)docker container start 前面的docker container run命令是新建容器,每运行一次,就会新建一个容器。同样的命令运行两次,就会生成两个一模一样的容器文件。如果希望重复使用容器,就要使用docker container start命令,它用来启动已经生成、已经停止运行的容器文件。 $ docker container start [containerID] (2)docker container stop 前面的docker container kill命令终止容器运行,相当于向容器里面的主进程发出 SIGKILL 信号。而docker container stop命令也是用来终止容器运行,相当于向容器里面的主进程发出 SIGTERM 信号,然后过一段时间再发出 SIGKILL 信号。 $ bash container stop [containerID] 这两个信号的差别是,应用程序收到 SIGTERM 信号以后,可以自行进行收尾清理工作,但也可以不理会这个信号。如果收到 SIGKILL 信号,就会强行立即终止,那些正在进行中的操作会全部丢失。 (3)docker container logs docker container logs命令用来查看 docker 容器的输出,即容器里面 Shell 的标准输出。如果docker run命令运行容器的时候,没有使用-it参数,就要用这个命令查看输出。 $ docker container logs [containerID] (4)docker container exec docker container exec命令用于进入一个正在运行的 docker 容器。如果docker run命令运行容器的时候,没有使用-it参数,就要用这个命令进入容器。一旦进入了容器,就可以在容器的 Shell 执行命令了。 $ docker container exec -it [containerID] /bin/bash (5)docker container cp docker container cp命令用于从正在运行的 Docker 容器里面,将文件拷贝到本机。下面是拷贝到当前目录的写法。 $ docker container cp [containID]:[/path/to/file] . 非常感谢你一直读到了这里,这个系列还有下一篇,介绍如何使用 Docker 搭建真正的网站,欢迎继续阅读。 欢迎工作一到五年的Java程序员朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Net和Java基于zipkin的全链路追踪

在各大厂分布式链路跟踪系统架构对比中已经介绍了几大框架的对比,如果想用免费的可以用zipkin和pinpoint还有一个忘了介绍:SkyWalking,具体介绍可参考:https://github.com/apache/incubator-skywalking/blob/master/README_ZH.md 由于追踪的要求是Net平台和Java平台都要支持,对于java平台各组件都是天生的支持的,但对于net的支持找了些开源组件,发现Pinpoint和SkyWalking给出的Demo都是基于NetCore(SkyWalking可以在github上搜skywalking-netcore,Pinpoint没有好的推荐),版本要求比较高,但不可能更改现有平台的FW框架,Zipkin有开源项目 Medidata.zipkinTracerModule 、zipkin.net、zipkin-csharp,网上依次推荐是从前到后,经过测试发现Medidata.zipkinTracerModule、zipkin.net也是用于Net Core的,在NuGet上安装报错。最后测试zipkin-csharp(https://github.com/openzipkin-attic/zipkin-csharp)可以成功,在NuGet中搜索Zipkin.Core,现在版本也只有一个,如下: 然后查看给出的demo中代码:zipkin-csharp/examples/ZipkinExample/Program.cs using System; using System.Net; using System.Threading; using Zipkin; using Zipkin.Tracer.Kafka; namespace ZipkinExample { class Program { static void Main(string[] args) { var random = new Random(); // make sure Zipkin with Scribe client is working //var collector = new HttpCollector(new Uri("http://localhost:9411/")); var collector = new KafkaCollector(KafkaSettings.Default); var traceId = new TraceHeader(traceId: (ulong)random.Next(), spanId: (ulong)random.Next()); var span = new Span(traceId, new IPEndPoint(IPAddress.Loopback, 9000), "test-service"); span.Record(Annotations.ClientSend(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ServerReceive(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ServerSend(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ClientReceive(DateTime.UtcNow)); collector.CollectAsync(span).Wait(); } } } 可以看出这里的traceId和spanId都是随机生成的,在这里推荐自己生成ID,注意是ulong型,这里毫秒数只格式化两位(数据库的位数20位,会超),也可以用更保险的其它方法。 /// <summary> /// 获得随机数 /// </summary> /// <returns></returns> private static ulong getRandom() { var random = new Random(); return ulong.Parse(DateTime.Now.ToString("yyyyMMddHHmmssff") + random.Next(100, 999)); } } collector这里使用Http来接收,注释kafka的,放开http的。去掉collector.CollectAsync(span).Wait(); 中的Wait。 Zipkin的几个基本概念Span:基本工作单元,一次链路调用(可以是RPC,DB等没有特定的限制)创建一个span,通过一个64位ID标识它, span通过还有其他的数据,例如描述信息,时间戳,key-value对的(Annotation)tag信息,parent-id等,其中parent-id 可以表示span调用链路来源,通俗的理解span就是一次请求信息Trace:类似于树结构的Span集合,表示一条调用链路,存在唯一标识,即TraceIdAnnotation:注解,用来记录请求特定事件相关信息(例如时间),通常包含四个注解信息cs - Client Start,表示客户端发起请求sr - Server Receive,表示服务端收到请求ss - Server Send,表示服务端完成处理,并将结果发送给客户端cr - Client Received,表示客户端获取到服务端返回信息BinaryAnnotation:提供一些额外信息,一般以key-value对出现 启动服务端测试 下载 https://github.com/openzipkin/zipkin/releases 最近的稳定版 release-2.7.1的jar包,这里采用mysql的型式保存记录,因此需要创建数据库zipkin,创建表: SET FOREIGN_KEY_CHECKS=0; -- ---------------------------- -- Table structure for `zipkin_annotations` -- ---------------------------- DROP TABLE IF EXISTS `zipkin_annotations`; CREATE TABLE `zipkin_annotations` ( `trace_id_high` bigint(20) NOT NULL DEFAULT '0' COMMENT 'If non zero, this means the trace uses 128 bit traceIds instead of 64 bit', `trace_id` bigint(20) NOT NULL COMMENT 'coincides with zipkin_spans.trace_id', `span_id` bigint(20) NOT NULL COMMENT 'coincides with zipkin_spans.id', `a_key` varchar(255) NOT NULL COMMENT 'BinaryAnnotation.key or Annotation.value if type == -1', `a_value` blob COMMENT 'BinaryAnnotation.value(), which must be smaller than 64KB', `a_type` int(11) NOT NULL COMMENT 'BinaryAnnotation.type() or -1 if Annotation', `a_timestamp` bigint(20) DEFAULT NULL COMMENT 'Used to implement TTL; Annotation.timestamp or zipkin_spans.timestamp', `endpoint_ipv4` int(11) DEFAULT NULL COMMENT 'Null when Binary/Annotation.endpoint is null', `endpoint_ipv6` binary(16) DEFAULT NULL COMMENT 'Null when Binary/Annotation.endpoint is null, or no IPv6 address', `endpoint_port` smallint(6) DEFAULT NULL COMMENT 'Null when Binary/Annotation.endpoint is null', `endpoint_service_name` varchar(255) DEFAULT NULL COMMENT 'Null when Binary/Annotation.endpoint is null', UNIQUE KEY `trace_id_high` (`trace_id_high`,`trace_id`,`span_id`,`a_key`,`a_timestamp`) COMMENT 'Ignore insert on duplicate', UNIQUE KEY `trace_id_high_4` (`trace_id_high`,`trace_id`,`span_id`,`a_key`,`a_timestamp`) COMMENT 'Ignore insert on duplicate', KEY `trace_id_high_2` (`trace_id_high`,`trace_id`,`span_id`) COMMENT 'for joining with zipkin_spans', KEY `trace_id_high_3` (`trace_id_high`,`trace_id`) COMMENT 'for getTraces/ByIds', KEY `endpoint_service_name` (`endpoint_service_name`) COMMENT 'for getTraces and getServiceNames', KEY `a_type` (`a_type`) COMMENT 'for getTraces', KEY `a_key` (`a_key`) COMMENT 'for getTraces', KEY `trace_id` (`trace_id`,`span_id`,`a_key`) COMMENT 'for dependencies job', KEY `trace_id_high_5` (`trace_id_high`,`trace_id`,`span_id`) COMMENT 'for joining with zipkin_spans', KEY `trace_id_high_6` (`trace_id_high`,`trace_id`) COMMENT 'for getTraces/ByIds', KEY `endpoint_service_name_2` (`endpoint_service_name`) COMMENT 'for getTraces and getServiceNames', KEY `a_type_2` (`a_type`) COMMENT 'for getTraces', KEY `a_key_2` (`a_key`) COMMENT 'for getTraces', KEY `trace_id_2` (`trace_id`,`span_id`,`a_key`) COMMENT 'for dependencies job' ) ENGINE=InnoDB DEFAULT CHARSET=utf8 ROW_FORMAT=COMPRESSED; -- ---------------------------- -- Records of zipkin_annotations -- ---------------------------- -- ---------------------------- -- Table structure for `zipkin_dependencies` -- ---------------------------- DROP TABLE IF EXISTS `zipkin_dependencies`; CREATE TABLE `zipkin_dependencies` ( `day` date NOT NULL, `parent` varchar(255) NOT NULL, `child` varchar(255) NOT NULL, `call_count` bigint(20) DEFAULT NULL, `error_count` bigint(20) DEFAULT NULL, UNIQUE KEY `day` (`day`,`parent`,`child`), UNIQUE KEY `day_2` (`day`,`parent`,`child`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 ROW_FORMAT=COMPRESSED; -- ---------------------------- -- Records of zipkin_dependencies -- ---------------------------- -- ---------------------------- -- Table structure for `zipkin_spans` -- ---------------------------- DROP TABLE IF EXISTS `zipkin_spans`; CREATE TABLE `zipkin_spans` ( `trace_id_high` bigint(20) NOT NULL DEFAULT '0' COMMENT 'If non zero, this means the trace uses 128 bit traceIds instead of 64 bit', `trace_id` bigint(20) NOT NULL, `id` bigint(20) NOT NULL, `name` varchar(255) NOT NULL, `parent_id` bigint(20) DEFAULT NULL, `debug` bit(1) DEFAULT NULL, `start_ts` bigint(20) DEFAULT NULL COMMENT 'Span.timestamp(): epoch micros used for endTs query and to implement TTL', `duration` bigint(20) DEFAULT NULL COMMENT 'Span.duration(): micros used for minDuration and maxDuration query', UNIQUE KEY `trace_id_high` (`trace_id_high`,`trace_id`,`id`) COMMENT 'ignore insert on duplicate', UNIQUE KEY `trace_id_high_4` (`trace_id_high`,`trace_id`,`id`) COMMENT 'ignore insert on duplicate', KEY `trace_id_high_2` (`trace_id_high`,`trace_id`,`id`) COMMENT 'for joining with zipkin_annotations', KEY `trace_id_high_3` (`trace_id_high`,`trace_id`) COMMENT 'for getTracesByIds', KEY `name` (`name`) COMMENT 'for getTraces and getSpanNames', KEY `start_ts` (`start_ts`) COMMENT 'for getTraces ordering and range', KEY `trace_id_high_5` (`trace_id_high`,`trace_id`,`id`) COMMENT 'for joining with zipkin_annotations', KEY `trace_id_high_6` (`trace_id_high`,`trace_id`) COMMENT 'for getTracesByIds', KEY `name_2` (`name`) COMMENT 'for getTraces and getSpanNames', KEY `start_ts_2` (`start_ts`) COMMENT 'for getTraces ordering and range' ) ENGINE=InnoDB DEFAULT CHARSET=utf8 ROW_FORMAT=COMPRESSED; -- ---------------------------- -- Records of zipkin_spans -- ---------------------------- 启动 进入程序的当前目录启动,注意参数内容,如果想要保存到elasticsearch,需要按官方文档更改。 java -jar zipkin-server-2.7.1.jar --STORAGE_TYPE=mysql --MYSQL_DB=zipkin --MYSQL_USER=root --MYSQL_PASS=123456 --MYSQL_HOST=localhost --MYSQL_TCP_PORT=3306 启动后看到如下内容表明成功。 启动成功后浏览器访问http://localhost:9411/ 至此服务端和展示页面已经启动,不过功能还是很简单的,具体的使用可另行查询资料。 这里用来测试的服务采用网友提供的 源码:mircoservice分布式跟踪系统(zipkin+springboot)https://github.com/dreamerkr/mircoservice,文章可参考:微服务之分布式跟踪系统(springboot+zipkin)https://blog.csdn.net/qq_21387171/article/details/53787019 用默认配置分别运行4个客户端服务后运行效果: (1)分别启动每个服务,然后访问服务1,浏览器访问(http://localhost:8081/service1/test) (2)输入zipkin地址,每次trace的列表 点击其中的trace,可以看trace的树形结构,包括每个服务所消耗的时间: 点击每个span可以获取延迟信息: 同时可以查看服务之间的依赖关系: 测试Net平台程序 将demo代码改为: static void Main(string[] args) { var random = new Random(); // make sure Zipkin with Scribe client is working var collector = new HttpCollector(new Uri("http://localhost:9411/")); //var collector = new KafkaCollector(KafkaSettings.Default); var traceId = new TraceHeader(traceId: (ulong)random.Next(), spanId: (ulong)random.Next()); var span = new Span(traceId, new IPEndPoint(IPAddress.Loopback, 9000), "zipkinweb"); span.Record(Annotations.ClientSend(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ServerReceive(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ServerSend(DateTime.UtcNow)); Thread.Sleep(100); span.Record(Annotations.ClientReceive(DateTime.UtcNow)); collector.CollectAsync(span); } 然后运行一次再查看,会多出一条信息 点进去会看到请求的详细信息和备注信息: 右上角查看json 验证了NET平台下是可以成功调用的,而且可以看到zipkin服务前端展示是通过api请求的,前后台分开的,因此我们可以以此来做二次开发,我们知道了数据结构或者通过自己请求数据库内容做更复杂的业务前端。 这里强调一点的是net最好用framework4.5以上的版本,由net的demo来看其实封装性不高,所以灵活性能很高,需要自己进一步封装才能达到代码的侵入性更少,性能更高。后面考虑到性能和数据量可改用kafka接收和ES保存数据。

优秀的个人博客,低调大师

超全!基于Java的机器学习项目、环境、库...

你是一名希望开始或者正在学习机器学习的Java程序员吗? 利用机器学习编写程序是最佳的学习方式。你可以从头开始编写算法,但是利用现有的开源库,你可以取得更大的进步。 本文介绍了主要的平台和开放源码的机器学习库。你可以使用这些机器学习库。 环境 本节描述了用于机器学习的Java环境或工作域。它们提供了用于执行机器学习任务的图形用户界面,还提供了用于开发自己应用程序的Java API。 WEKA 怀卡托环境知识分析(Weka)( https:// www.cs.waikato.ac.nz/ml/weka/)是一个由新西兰怀卡托大学开发的机器学习平台。提供Java的图形用户接口,命令行接口和Java API接口。它可能是最流行的Java机器学习库,也是开始或练习机器学习的好地方。 KNIME 康斯坦茨信息挖掘(KNIME)(https://www.kn

优秀的个人博客,低调大师

【Docker】容器、虚拟机与Docker概念全解析

作为程序员或者技术人员,大家肯定听说过Docker的鼎鼎大名——这款工具能够帮助我们高效打包、发布及运行承载着应用程序的“容器”系统。其发展如火如荼——从开发者到运维人员,每个人都在关注着这位技术新贵。即使是像谷歌、VMware与Amazon这样的技术巨擘也在构建相关服务为其提供支持。 无论大家是否有意立即使用Docker,我们都应当对其基础概念加以了解,并明确区分容器与虚拟机之间的差异所在。目前网络上已经存在大量对二者关联与区别的阐述性文章,不过在今天的综述中,我们将立足于新手对其加以剖析。 下面首先聊聊虚拟机与容器究竟是什么? 容器与虚拟机究竟是什么? 容器与虚拟机拥有着类似的使命:对应用程序及其关联性进行隔离,从而构建起一套能够随处运行的自容纳单元。 此外,容器与虚拟机还摆脱了对物理硬件的需求,允许我们更为高效地使用计算资源,从而提升能源效率与成本效益。 容器与虚拟机之间的核心差异在于其架构方法。下面一起进行深入了解。 虚拟机 虚拟机在本质上就是在模拟一台真实的计算机设备,同时遵循同样的程序执行方式。虚拟机能够利用“虚拟机管理程序”运行在物理设备之上。反过来,虚拟机管理程序则可运行在主机设备或者“裸机”之上。 下面用更直白的表达来说明: 虚拟机管理程序可表现为软件、固件或者硬件,并作为虚拟机的运行基础。虚拟机管理程序本身运行在物理计算机之上,我们也将这种底层硬件称为“主机设备”。主机设备为虚拟机提供资源,包括内存与CPU。这些资源由不同虚拟机共享,并根据需要进行随意分配。因此如果一套虚拟机运行有需求大量资源的高强度应用程序,那么我们可以在同一主机设备上为其分配远高于其它虚拟机的资源配额。 运行在主机设备上的虚拟机(当然,需要配合虚拟机管理程序)通常被称为一套“客户机”。这套客户机容纳有应用程序及其运行所必需的各类组件(例如系统二进制文件及库)。它同时还包含有完整的虚拟硬件堆栈,其中包括虚拟网络适配器、存储以及CPU——这意味着它也拥有自己的完整访客操作系统。着眼于内部,这套客户机自成体系并拥有专用资源。而从外部来看,这套虚拟机使用的则是由主机设备提供的共享资源。 如上所述,客户机可以运行主机虚拟机管理程序或者裸机虚拟机管理程序。二者之间存在着多种重要区别。 首先,主机虚拟机管理程序运行在主机设备的操作系统之上。举例来说,一台运行有OS X的计算机可以在操作系统之上安装虚拟机(例如VirtualBox或者VMware Workstation 8)。该虚拟机并不会直接访问硬件,因此其需要经由主机操作系统(也就是Mac OS X)实现资源获取。 主机虚拟机管理程序的优势在于,其基本摆脱了对底层硬件的要求。该主机操作系统负责提供硬件驱动程序,而非由虚拟机管理程序自身提供,因此我们认为其具备更理想的“硬件兼容性”。在另一方面,这种介于硬件与虚拟机管理程序之间的额外层会带来更多资源消耗,进而降低虚拟机性能表现。 裸机虚拟机管理程序则将虚拟机直接安装并运行在主机设备硬件之上以改善性能表现。由于其直接接入底层硬件,因此我们不再需要主机操作系统作为辅助。在这种情况下,我们可以直接在硬件上安装虚拟机管理程序并将其作为操作系统。与主机虚拟机管理程序不同,裸机虚拟机管理程序拥有自己的设备驱动程序及接口,从而直接支持各类I/O、处理或者操作系统特定任务相关组件。这种方式能够带来更理想的性能水平、可扩展性以及稳定性。但代价是其硬件兼容性比较有限,因为虚拟机管理程序只能包含一部分设备驱动程序。 说到这里,大家可能提出疑问:为什么我们非得在虚拟机与主机设备之间添加“虚拟机管理程序”呢? 这个嘛,因为虚拟机本身拥有一套虚拟操作系统,而虚拟机管理程序则负责为虚拟机提供平台以管理并运行这套访客操作系统。如此一来,主机计算机就能够为运行于其上的各虚拟机分配共享资源了。 虚拟机原理示意图 如大家所见,虚拟机会将虚拟硬件、内核(即操作系统)以及用户空间打包在新虚拟机当中。 容器 与提供硬件虚拟化机制的虚拟机不同,容器通过对“用户空间”的抽象化处理提供操作系统层级的虚拟化机制。通过对容器进行分解,大家将可以非常清晰地理解其中含义。 出于各种考量与需求,容器在外观上与虚拟机非常相似。举例来说,二者皆拥有专有处理空间、能够作为root执行命令、提供专有网络接口与IP地址、允许定制化路由及iptable规则,且可启动文件系统等等。 容器与虚拟机间的最大区别在于,各容器系统共享主机系统的内核。 容器原理示意图 以上示意图显示了容器如何对用户空间进行打包,而不像虚拟机那样同样对内核或者虚拟硬件进行打包。每套容器都拥有自己的隔离化用户空间,从而使得多套容器能够运行在同一主机系统之上。我们可以看到全部操作系统层级的架构都可实现跨容器共享。惟一需要独立构建的就是二进制文件与库。正因为如此,容器才拥有极为出色的轻量化特性。 Docker的功能定位 Docker为基于Linux容器的开源项目,其利用Linux内核中的各项功能——例如命名空间与控制组——以在操作系统之上创建容器。 容器概念并不是什么新鲜事物; 谷歌公司多年来一直在使用自己开发的容器技术。其它Linux容器技术方案还包括Solaris Zones、BSD jails以及LXC,且其都已经拥有多年的发展历史。 那么为什么Docker的出现会快速吸引到技术业界的注意? 易用性: Docker能够为潜在受众带来出色的易用性——开发者、系统管理员以及架构师等等——从而帮助其充分利用容器技术优势以快速构建并测试可移植应用程序。每个人都可以在自己的笔记本上打包应用程序,并将其直接运行在任何公有云、私有云甚至是裸机之上。其座右铭是:一次构建,随处运行。 速度: Docker容器具备轻量化与高速特性。由于容器本身属于运行在内核之上的沙箱环境,因为其对资源的需求量极低。大家可以在数秒钟内完成容器的创建与运行,而虚拟机则由于需要引导完整的虚拟操作系统而耗费更多时间。 Docker Hub: Docker用户还能够享受由Docker Hub带来的丰富生态系统支持,我们可以将其理解成“Docker镜像的应用商店”。Docker Hub提供成千上万由社区开发的公共镜像,且可立即加以使用。我们可以轻松根据需要搜索到合适的镜像,将其提取并稍加修改即加以使用。 模块性与可扩展性: Docker允许我们轻松将应用程序的功能拆分成多个独立容器。举例来说,我们可以将自己的Postgres数据库运行在一套容器当中,并将Redis服务器运行在另一容器内,而Node.js也拥有自己的容器系统。在Docker的帮助上,大家能够轻松将这些容器对接起来以创建完整的应用程序,这就让未来的规模伸缩或者组件更新得以通过相互独立的方式完成。 最后但同样重要的是,Docker鲸鱼实在是太惹人喜爱了~ Docker基本概念 现在我们对Docker有了宏观印象,下面具体对其组件进行解读: Docker Engine Docker Engine属于Docker的运行层。这是一套轻量化运行时及工具组合,负责管理容器、镜像、构建 等等。它以原生方式运行在Linux系统之上,并由以下元素构成: Docker Daemon,运行在主机计算机之上。 Docker Client,负责与Docker Daemon通信以执行命令。 REST API,用于同Docker Daemon远程交互。 Docker Client Docker Client正是我们作为最终用户的通信对象。我们可以将其视为Docker的UI。 我们进行的一切操作都将直接接入Docker Client,再由其将指令传递至Docker Daemon。 Docker Daemon Docker Daemon直接将执行命令发送至Docker Client——例如构建、运行以及分发等等。Docker Daemon运行在主机设备之上,但作为用户,我们永远不会直接与该Daemon进行通信。Docker Client也可以运行在主机设备上,但并非必需。它亦能够运行在另一台设备上,并与运行在目标主机上的Docker Daemon进行远程通信。 Dockerfile Dockerfile是我们编写指令以构建Docker镜像的载体。这些指令包括: RUN apt-get y install some-package:安装某软件包 EXPOSE 8000: 开放端口 ENV ANT_HOME /usr/local/apache-ant:传递环境变量 类似的指令还有很多。一旦设置了Dockerfile,大家就可以利用docker build命令来构建镜像了。下面来看Dockerfile示例: # Start with ubuntu 14.04 FROM ubuntu:14.04MAINTAINER preethi kasireddy iam.preethi.k@gmail.com# For SSH access and port redirection ENV ROOTPASSWORD sample# Turn off prompts during installations ENV DEBIAN_FRONTEND noninteractive RUN echo "debconf shared/accepted-oracle-license-v1-1 select true" | debconf-set-selections RUN echo "debconf shared/accepted-oracle-license-v1-1 seen true" | debconf-set-selections# Update packages RUN apt-get -y update# Install system tools / libraries RUN apt-get -y install python3-software-properties \ software-properties-common \ bzip2 \ ssh \ net-tools \ vim \ curl \ expect \ git \ nano \ wget \ build-essential \ dialog \ make \ build-essential \ checkinstall \ bridge-utils \ virt-viewer \ python-pip \ python-setuptools \ python-dev # Install Node, npm RUN curl -sL https://deb.nodesource.com/setup_4.x | sudo -E bash - RUN apt-get install -y nodejs # Add oracle-jdk7 to repositories RUN add-apt-repository ppa:webupd8team/java # Make sure the package repository is up to date RUN echo "deb http://archive.ubuntu.com/ubuntu precise main universe" > /etc/apt/sources.list # Update apt RUN apt-get -y update # Install oracle-jdk7 RUN apt-get -y install oracle-java7-installer # Export JAVA_HOME variable ENV JAVA_HOME /usr/lib/jvm/java-7-oracle # Run sshd RUN apt-get install -y openssh-server RUN mkdir /var/run/sshd RUN echo "root:$ROOTPASSWORD" | chpasswd RUN sed -i 's/PermitRootLogin without-password/PermitRootLogin yes/' /etc/ssh/sshd_config # SSH login fix. Otherwise user is kicked off after login RUN sed 's@session\s*required\s*pam_loginuid.so@session optional pam_loginuid.so@g' -i /etc/pam.d/sshd # Expose Node.js app port EXPOSE 8000 # Create tap-to-android app directory RUN mkdir -p /usr/src/my-app WORKDIR /usr/src/my-app # Install app dependencies COPY . /usr/src/my-app RUN npm install # Add entrypoint ADD entrypoint.sh /entrypoint.sh RUN chmod +x /entrypoint.sh ENTRYPOINT ["/entrypoint.sh"] CMD ["npm", "start"] 示例Dockerfile Docker镜像 镜像属于只读模板,大家可以借此配合Dockerfile中的编写指令集进行容器构建。镜像定义了打包的应用程序以及其相关依赖。这些依赖就好像是其启动时需要运行的进程。 Docker镜像利用Dockerfile实现构建。Dockerfile中的每条指令都会在镜像中添加一个新的“层”,这些层则表现为镜像文件系统中的一个分区——我们可以对其进行添加或者替换。层概念正是Docker轻量化的基础。Docker利用一套Union File System建立起这套强大的结构: Union File System Docker利用Union File System以构建镜像。大家可以将Union File System视为一套可堆叠文件系统,这意味着各文件系统中的文件与目录(在Docker中被称为分支)可以透明方式覆盖并构成单一文件系统。 覆盖分支内的各目录内容拥有同样的路径,并将被视为单一合并目录,这就避免了需要为每个层分别创建副本的麻烦。相反,这些目录可调用特定指针以指向同样的资源; 当特定层需要进行修改时,其会分别创建修改前与修改后的本地副本。通过这种方式,文件系统表现出可写入特性,但其实际上并未接受任何写入操作。(换言之,这是一套‘写入即复制’系统。) 分层系统拥有两大核心优势: 无重复数据: 分层机制使得我们在使用镜像创建并运行新容器时无需复制完整的文件集,从而保证Docker容器实例拥有良好的运行速度与低廉的资源成本。 层隔离: 变更操作速度很快——当我们对镜像进行变更时,Docker只需要对进行了变更的层进行广播。 Volumes Volumes属于容器中的“数据”部分,会在容器创建时进行初始化。Volumes机制允许我们持久保留并共享容器数据。数据卷 独立于默认Union File System之外,且作为普通目录及文件存在于主机文件系统当中。因此即使是在对容器进行销毁、更新或者重构时,数据卷仍然不受影响。当我们需要对某一数据卷进行更新时,直接加以变更即可。(作为另一项优势,数据卷还能够在不同容器之间进行共享与复用。) Docker容器 如上所述,Docker容器将一款应用程序的软件打包在单一环境当中,同时包含全部运行必需的要素。其中包括操作系统、应用程序代码、运行时、系统工具、系统库等等。Docker容器由Docker镜像构建而成。由于镜像存在只读属性,因此Docker会在镜像在只读文件系统之上添加一套读取-写入文件系统以实现容器创建。 另外,在创建容器时,Docker还会创建一套网络接口以帮助容器同本地主机通信、对接可用IP地址并执行用户在定义镜像时所执行的进程以运行应用程序。 在成功创建了一套容器之后,我们随后可以将其运行在任何环境当中,而不必再做任何变更。 “容器”揭秘 打开容器,我们会发现其中包含大量活动组件。容器的实现机制一直令我感到惊讶而好奇,特别是考虑到容器不存在任何抽象的基础设施边界。在阅读了大量材料之后,我将结合自己的理解为大家进行讲解:) “容器”这一术语其实只是个抽象概念,用于表述多种不同的相关特性,而其与原词“container”的另一含义“集装箱”有着千丝万缕的联系。下面就来一起了解: 命名空间 命名空间为容器提供对应的底层Linux系统视图,即限制容器的查看与访问范畴。当我们运行一套容器时,Docker会创建多个命名空间供特定容器使用。 Docker会在内核中使用多种不同类型的命名空间,例如: NET: 为容器提供独特的系统网络堆栈视图(例如自有网络设备、IP地址、IP路由表、/proc/net目录、端口编号等等)。 PID: PID代表进程ID。如果大家曾经在命令行中运行过ps aux以检查当前系统正在运行的进程,就会发现其中一栏名为“PID”。PID命名空间为容器提供其能够查看与交互的进程范围,其中包括独立的init(PID 1),其属于“所有进程的元祖”。 MNT: 为容器提供独特的系统“mounts”视图。这样不同mount命名空间内的进程就将拥有彼此不同的文件系统结构。 UTS: UTS代表UNIX分时系统。它允许某一进程识别系统身份(例如主机名称或者域名等)。UTS允许容器拥有不同于其它容器以及主机系统的主机名称与NIS域名。 IPC: IPC代表进程间通信。IPC命名空间负责对运行在每套容器内的进程进行IPC资源隔离。 USER: 此命名空间用于对每套容器内的用户进行隔离。其允许各容器拥有不同的uid(即用户ID)与gid(组ID)视图区间,并将其与主机系统进行比对。这样一来,某一进程的uid与gid在用户命名空间之内与之外即有所不同,这也使得该进程能够在不影响容器内root权限的情况下,撤销同一用户在容器外的权限。 Docker将这些命名空间结合起来以隔离并创建容器。下面要讲的则是控制组。 控制组 控制组(也被称为cgroups)属于Linux内核中的一项功能,用于对一组进程的资源使用量(包括CPU、内存、磁盘I/O以及网络等)进行隔离、排序与计数。这意味着cgroup能够确保Docker容器只使用其必需的资源——并在必要情况下设置其所能使用的资源上限。另外,cgroups还能够确保单一容器不至于占用太多资源并导致整体系统陷入瘫痪。 最后要说明的是Union文件系统: 隔离化Union File System 我们在之前的Docker镜像章节中已经解释过了:) 这就是关于Docker容器的全部内容了(当然,实现细节才是最麻烦的环节——例如如何管理不同组件间的交互)。 Docker的未来:Docker与虚拟机将并生共存 尽管Docker已经开始逐步成为主流,但我认为它不太可能对虚拟机造成真正的威胁。容器将继续发展壮大,但虚拟机也仍然拥有适合自己的生存空间。 举例来说,如果我们需要在多台服务器上运行多款应用程序,那么最理想的办法就是使用虚拟机。在另一方面,如果我们需要运行同一应用程序的多套副本,那么Docker则拥有更多具体优势。 另外,尽管容器允许我们将应用程序拆分成多个功能组件,但这种分散化趋势意味着我们需要管理更多功能部件,即带来更为复杂的控制与协调任务。 安全同时也是Docker容器需要解决的一大难题——由于各容器共享同一套内核,因此不同容器之间的屏障非常薄弱。与只需要调用主机虚拟机管理程序的虚拟机方案不同,Docker容器需要向主机内核发出系统调用,而这会带来更庞大的攻击面。出于安全性的考量,很多开发人员可能更倾向于选择虚拟机——其由抽象化硬件进行隔离,从而显著提升了彼此交互的难度。 当然,安全性与管理等难题必将随着容器在生产环境下的进一步普及而得到解决。就目前来讲,关于容器与虚拟机孰优孰劣的议题已经成为开发人员与运维人员间的日常争论素材。 结束语 希望通过此文能让大家掌握Docker、虚拟机的基本概念和区别。容器时代即将到来! 本文转自Linux就该这么学博客园博客,原文链接:http://www.cnblogs.com/linuxprobe/p/5438443.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

基于阿里的Node全栈之路(一)部署Docker

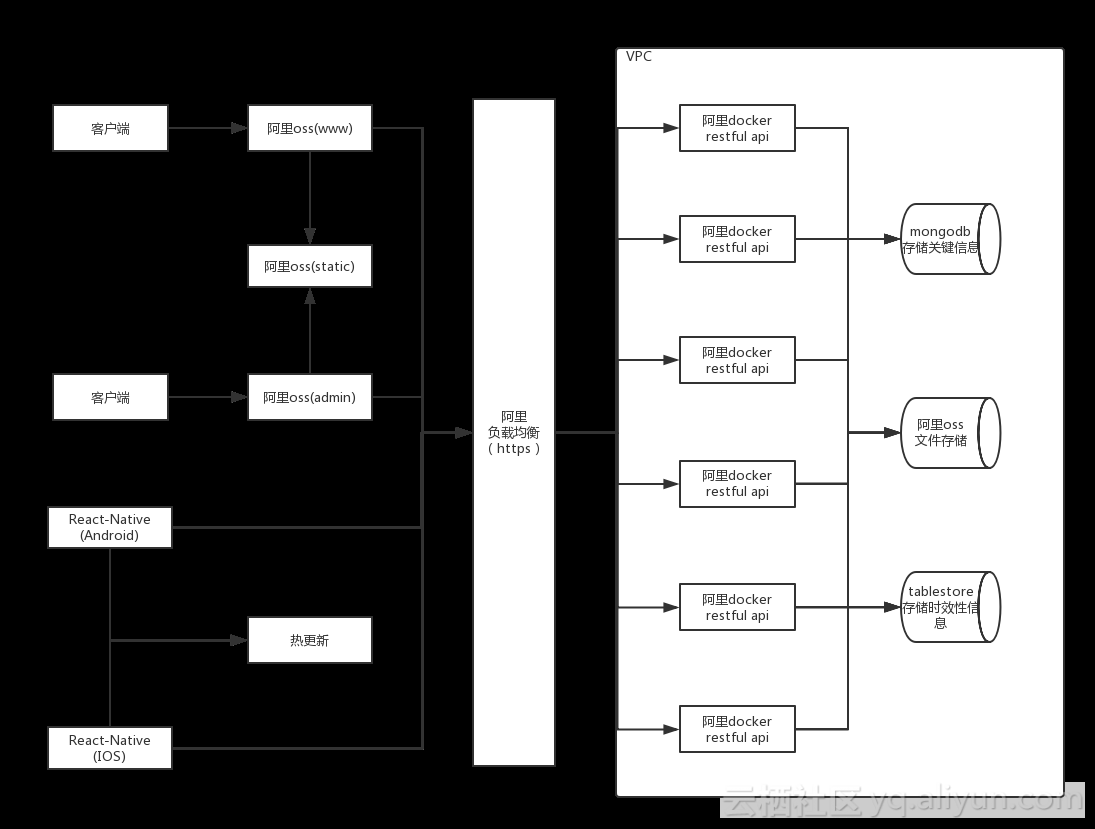
在经历多次项目技术改革,现在的技术架构基本稳定下来了。一个人的开发不容易啊,想在这里分享下自己的一些想法和走过的一些坑,希望能够帮助到大家。下面放下我现在的技术架构。 Docker是个好东西,虽然阿里出了函数计算,但在使用的时候,发现还是缺乏些火候,而且现在的函数计算还是比较适合高CPU型api,鄙见鄙见~ 阿里docker的流程: 创建code仓库 创建docker镜像 创建docker容器服务 创建docker的时候,阿里会自动部署负载均衡(https的放在下个文章更新) 一般,我的项目结构是这样的: -project -api // 项目的api -app // React-Native,移动端 -www // 项目主页 -admin // 项目后端管理系统 -h5 // 宣传H5 -Dockerfile // 部署api使用 贴上我的api的通用dockerfile FROM node:7 MAINTAINER Mumudeveloper #hardcode RUN cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime RUN yarn global add forever # Create www directory RUN mkdir -p /api COPY ./api /api # Install www dependencies WORKDIR /api RUN yarn install EXPOSE 7001 # Define default command. ENTRYPOINT forever start -l forever.log -a index.js && tail -f ~/.forever/forever.log 好!重点来了,敲黑板!大家注意到我这一行没有,嗯,这是我跑docker的时候遇到的第一个坑啦! RUN cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime 去年,做了一个中间商平台,订单是按照时间来定价格了,一个时间一个价格,因为市场是波动的,当时我怀抱着一种很开心很高兴觉得自己很流逼的心情,把项目部署在docker上。部署完后,高高兴兴的睡觉了,因为明天还要上班呢!突然凌晨1点,合作方打电话过来,很急很急的样子,一接电话,我的心都凉了,晚上提交的几千订单,时间错误!!! 急急忙忙的起身,查bug,现在想来都心塞塞...orz... 最后原因找到了,原来是阿里部署的docker是基于原版镜像的,时间是以美国还是伦敦为标准了(具体忘记了),当时我的临时方案是远程登录上了docker服务器,因为只是部署了三台服务器,所以就一台台的改... 第二天一早就提了个工单,希望能得到处理,发现暂时还实现不了,而且优先级也不高。但我觉得吧,阿里的同学应该把这个时间问题写文档,提醒给使用阿里docker的童鞋。不过如果是公司运营的话,一般都有测试,所以上线发生这种问题估计是很少的。 后来对那些订单的处理方案是让合作方和他们对接的平台商量,手工处理前后两天的订单,处理了三天,内心无比愧疚~ 嗯,大家如果是做国内业务,还是最好在dockerfile上加上这句话好了。

优秀的个人博客,低调大师

窄带物联网全覆盖让无锡距未来更近

未来的城市应该是什么样?不同的人也许会给出不同的答案,但永远脱离不了安全、便捷、低耗与高效。目前,无锡已是全国首个实现NB-IoT窄带物联网全域覆盖的地级市,在鸿山物联网小镇建成了全国首个NB-IoT商用网络,各项示范应用项目建设全面铺开。依靠强大的物联网技术支持,加速实现“万物互联”的无锡或将成为距未来最近的城市。 在鸿山物联网小镇吴博园的停车场内,记者看到每个停车位中间都填埋了一个高度约10厘米的“小黑盒”——地磁车辆检测仪。这个小东西无需排线,只要填埋在停车位上,就可以与停车场的整个监控系统相连,实时反馈停车情况。同时,车主可以通过智能操控系统或者与其相连的客户端、微信公众号等平台了解车位停放情况,预设停车位置和时间。无锡电信相关负责人表示,地磁车辆检测仪成本低、寿命长,未来可以广泛应用于地下停车场、大型停车场。 中华赏石园内的电梯也用上了物联网技术。这些电梯配备的物联网传感器能够实时感知电梯运行状态,在事故发生时利用内置的语音装置让被困人员得以与外界交流。此外,电梯中平时用以播放短视频的显示屏中还自带蓄电池,一旦电梯断电便可以依靠蓄电池中的电量进行照明,缓解被困人员的紧张感,提高救援效率。如果说智能停车注重便捷,那智能电梯关注的就是安全。从传感器到语音装置、蓄电池,物联网技术参与了从前期预防到应急救援的全过程。 电动汽车充电桩已经不是稀罕事,面向更多城市居民需求的智能电动车充电桩你可曾用过?在国脉大厦地下停车场,记者体验了一回电动车智能充电。只要在微信公众号上进行几步简单的操作,就能为电动车进行充电,同时用手机实时监控充电状况。除了便利的使用,智能充电桩也可以有效确保电动车充电期间的安全。据介绍,当电动车电流骤然上升或温度突然升高时,充电桩会立刻断电并通知用户和管理员,及时避免因充电不当、时间过长等原因带来的安全问题。 在中国电信无锡物联网实验室,工作人员还展示了更多“脑洞大开”的物联网应用。有可以定位追踪与发出位移警报的智能井盖,支持指纹、密码、钥匙与手机开锁的智能门锁与保险箱,还有手机扫一扫就能轻松使用的物联网共享洗衣机。工作人员还告诉记者,在未来技术改进与芯片进一步微型化的情况下,他们还有可能推出具有定位功能的智能纽扣,为儿童与失智老人的看护与寻找提供便捷高效的途径。 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册