首页 文章 精选 留言 我的

精选列表

搜索[指标分析],共10000篇文章
优秀的个人博客,低调大师

GayHub用户及仓库分析爬虫

爬虫介绍 Github 是一个很棒的社区,这里可以找到很多优秀的项目,很多实用的库类,简直是 coder 的天堂,同时也是全球最大的同性交友社区? 爬取的数据主要分为两大类, User 类 和 Repo 类 ,也就是针对用户情况和仓库信息 User 类 先来看看 Github 全站 followers 人数 top10 都是哪些大犇 Linus 大神以压倒性的优势夺得第一名,说实在不知道 Linus 的真不好意思说自己是写代码的,这是信仰。然而大神还是很傲娇的,毕竟没有 following anybody,可能是强到了没朋友了吧,毕竟 talk is cheap, show me the code。JakeWharton 以 34000+ 位于第二,以前也看过一点 Android 的东西,不知道说什么,膜拜吧。 中国区还是有两名种子选手

优秀的个人博客,低调大师

市场分享竞品分析-Android

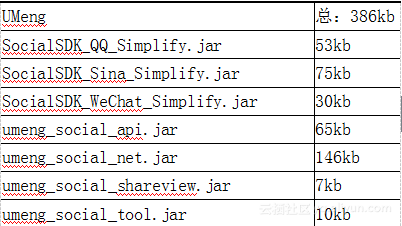
一.SDK大小对比环境说明:1.只集成社交平台 新浪微博,微信好友,QQ;2.均不包含各自的UI库,使用最简单最基础的接口实现分享;3.均新建android工程项目中集成;4.集成方式的对比;对比集成微信好友、QQ好友、微信好友的大小,基础jar包其实是比较大的,后续增加想加的平台几乎就增加几十K左右;UMeng Jar包的大小,编译后apk增加0.15M 从上下两个表格可以看出,Umeng的大小相对于下面的ShareSDK的比较小,但是整体来说都会增加太多;MobShareJar包的大小,编译后apk增加 0.27M 二、集成复杂度1、工具采用studio集成2、集成方式首先是官网注册,这个ShareSDK有流程说明,ShareSDK好些; 重点比较两种SDK的新的集成方式a)集成jar包:ShareSDK更有优势Umeng需要集成jar包,与老的集成方式一样,资源也一样; ShareSDK不需要集成jar包,只需要在gradle文件中配置需要的平台即可 b) 配置SDK及配置第三方:key ShareSDK更有优势Umeng这里可以使用生成工具来生成 (1)生成后需要配置到application中,这里可以配置第三方平台的key; (2)AndroidManifest配置代码生成,生成后可以直接复制配置到清单文件中; ShareSDK集成,只需要在gradle中配置如下即可;(1)配置MobSDK的调用,并且配置平台及keymaven { url "http://mvn.mob.com/android" }dependencies { ... classpath 'com.mob.sdk:MobSDK:+' } (2)ShareSDK不需要在manifest中进行配置 c)分享代码生成调用,友盟更有优势友盟同样可以代码生成器生成来调用,输入内容友盟会自动生成方法,调用即可; ShareSDK,方法调用,如下图所示,也是套用,只需要换个分享对象,和相应方法即可; 集成方式总结:从集成方式,友盟在代码调用和配置都可以使用生成器,但是ShareSDK不需要多余的配置,在集成方式上ShareSDK更有优势 三、其他比较集成文档:集成文档方面,友盟追求过于智能,但是讲解不够详细,ShareSDK的文档比较清晰,还分出了不同的第三方常用平台的说明;ShareSDK更有优势技术论坛:这方面ShareSDK有自己的论坛,并且有常见问题帖子。还有成百上千的用户的问题,如果遇到问题可以先看看有没有人问过,定位问题迅速;客服技术:ShareSDK提供全天的技术支持,不会的问题可以直接通过技术来解决,听说可以聊天聊地聊感情,这个方面友盟确实做的不够好;更新频率:ShareSDK基本是每个月更新一次,SDK更新及时、快,第三方有什么改动,ShareSDK都能及时发出公告并及时更新版本; 从最近半年的更新频率来看,友盟更新的是慢了些; 四、总结对比 Umeng做的主要模块不是分享,从上面的对比项上来看,确实ShareSDK更具优势,特别是技术论坛和技术支持的回复上,这些是独有的优势,有不明白的地方可以直接QQ联系技术支持来解决;当然上述是我的个人见解,欢迎留言来提出对比项,后续我们一起来补充对比说明;

优秀的个人博客,低调大师

深入分析Java的enum

一、定义(语法) enum全称为enumeration,中文意为枚举,枚举简单的说就是一种数据类型,只不过是这种数据类型只包含自定义的特定数据,它是一组有共同特性的数据的集合。 创建枚举类型是需要用到enum关键字,如: public enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } enum的语法看似与class不同,但它实际上就是一个类,经过编译器编译之后得到一个.class文件。 创建的枚举类型默认是java.lang.enum<枚举类型名>(抽象类)的子类。 每个枚举项的类型都为public static final 。 因为Java的单继承机制,emum不能再用extends继承其他的类。 我们可以使用javap命令进行反编译验证。 既然enum是一个类,那么它就可以像一般的类一样拥有自己的属性与方法。但Java要求必须先定义enum实例。 否则会编译错误。 public enum Color { RED("红色", 1), GREEN("绿色", 2), BLANK("白色", 3), YELLO("黄色", 4); // 成员变量 private String name; private int index; // 构造方法 private Color(String name, int index) { this.name = name; this.index = index; } // 普通方法 public static String getName(int index) { for (Color c : Color.values()) { if (c.getIndex() == index) { return c.name; } } return null; } // get set 方法 public String getName() { return name; } public void setName(String name) { this.name = name; } public int getIndex() { return index; } public void setIndex(int index) { this.index = index; } } 枚举实例的创建过程:枚举类型符合通用模式 Class Enum<E extends Enum<E>>,而 E 表示枚举类型的名称。枚举类型的每一个值都将映射到 protected Enum(String name, int ordinal) 构造函数中,在这里,每个值的名称都被转换成一个字符串,并且序数设置表示了此设置被创建的顺序。 public enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } 相当于调用了六次Enum<Color>构造方法 Enum<Color>("RED", 0); Enum<Color>("GREEN", 1); Enum<Color>("BLUE", 2); Enum<Color>("BLACK", 3); Enum<Color>("PINK",4); Enum<Color>("WHITE", 5); 枚举类型的常用方法: int compareTo(E o) 比较此枚举与指定对象的顺序。 Class<E> getDeclaringClass() 返回与此枚举常量的枚举类型相对应的 Class 对象。 String name() 返回此枚举常量的名称,在其枚举声明中对其进行声明。 int ordinal() 返回枚举常量的序数(它在枚举声明中的位置,其中初始常量序数为零 String toString() 返回枚举常量的名称,它包含在声明中。 static <T extends Enum<T>> T valueOf(Class<T> enumType, String name) 返回带指定名称的指定枚举类型的枚举常量。 二、常用用法 用法一:常量 在JDK1.5 之前,我们定义常量都是: public static fianl.... 。现在好了,有了枚举,可以把相关的常量分组到一个枚举类型里,而且枚举提供了比常量更多的方法。 用法二:switch JDK1.6之前的switch语句只支持int,char,enum类型,使用枚举,能让我们的代码可读性更强。 enum Color{ RED, GREEN, BLUE, BLACK, PINK, WHITE; } public class TestEnum { public void changeColor(){ Color color = Color.RED; System.out.println("原色:" + color); switch(color){ case RED: color = Color.GREEN; System.out.println("变色:" + color); break; case GREEN: color = Color.BLUE; System.out.println("变色:" + color); break; case BLUE: color = Color.BLACK; System.out.println("变色:" + color); break; case BLACK: color = Color.PINK; System.out.println("变色:" + color); break; case PINK: color = Color.WHITE; System.out.println("变色:" + color); break; case WHITE: color = Color.RED; System.out.println("变色:" + color); break; } } public static void main(String[] args){ TestEnum testEnum = new TestEnum(); testEnum.changeColor(); } } 用法三:实现接口 public interface Behaviour { void print(); String getInfo(); } public enum Color implements Behaviour { RED("红色", 1), GREEN("绿色", 2), BLANK("白色", 3), YELLO("黄色", 4); // 成员变量 private String name; private int index; // 构造方法 private Color(String name, int index) { this.name = name; this.index = index; } // 接口方法 @Override public String getInfo() { return this.name; } // 接口方法 @Override public void print() { System.out.println(this.index + ":" + this.name); } } 用法四:枚举集合的应用 java.util.EnumSet和java.util.EnumMap是两个枚举集合。EnumSet保证集合中的元素不重复;EnumMap中的 key是enum类型,而value则可以是任意类型。关于这个两个集合的使用就不在这里赘述,可以参考JDK文档 public class Test { public static void main(String[] args) { // EnumSet的使用 EnumSet<EnumTest> weekSet = EnumSet.allOf(EnumTest.class); for (EnumTest day : weekSet) { System.out.println(day); } // EnumMap的使用 EnumMap<EnumTest, String> weekMap = new EnumMap(EnumTest.class); weekMap.put(EnumTest.MON, "星期一"); weekMap.put(EnumTest.TUE, "星期二"); // ... ... for (Iterator<Entry<EnumTest, String>> iter = weekMap.entrySet().iterator(); iter.hasNext();) { Entry<EnumTest, String> entry = iter.next(); System.out.println(entry.getKey().name() + ":" + entry.getValue()); } } } 三、综合实例 最简单的使用 最简单的枚举类 public enum Weekday { SUN,MON,TUS,WED,THU,FRI,SAT } 如何使用它呢? 先来看看它有哪些方法: 这是Weekday可以调用的方法和参数。发现它有两个方法:values()和valueOf()。还有我们刚刚定义的七个变量 这些事枚举变量的方法。我们接下来会演示几个比较重要的 这段代码,我们演示了几个常用的方法和功能: Weekday.valueOf() 方法: 它的作用是传来一个字符串,然后将它转变为对应的枚举变量。前提是你传的字符串和定义枚举变量的字符串一样,区分大小写。如果你传了一个不存在的字符串,那么会抛出异常。 Weekday.values()方法。 这个方法会返回包括所有枚举变量的数组。在该例中,返回的就是包含了七个星期的Weekday[]。可以方便的用来做循环。 枚举变量的toString()方法。 该方法直接返回枚举定义枚举变量的字符串,比如MON就返回【”MON”】。 枚举变量的.ordinal()方法。 默认情况下,枚举类会给所有的枚举变量一个默认的次序,该次序从0开始,类似于数组的下标。而.ordinal()方法就是获取这个次序(或者说下标) 枚举变量的compareTo()方法。 该方法用来比较两个枚举变量的”大小”,实际上比较的是两个枚举变量的次序,返回两个次序相减后的结果,如果为负数,就证明变量1”小于”变量2 (变量1.compareTo(变量2),返回【变量1.ordinal() - 变量2.ordinal()】) 这是compareTo的源码,会先判断是不是同一个枚举类的变量,然后再返回差值。 枚举类的name()方法。 它和toString()方法的返回值一样,事实上,这两个方法本来就是一样的: 这两个方法的默认实现是一样的,唯一的区别是,你可以重写toString方法。name变量就是枚举变量的字符串形式。 还有一些其他的方法我就暂时不介绍了,感兴趣的话可以自己去看看文档或者源码,都挺简单的。 要点: 使用的是enum关键字而不是class。 多个枚举变量直接用逗号隔开。 枚举变量最好大写,多个单词之间使用”_”隔开(比如:INT_SUM)。 定义完所有的变量后,以分号结束,如果只有枚举变量,而没有自定义变量,分号可以省略(例如上面的代码就忽略了分号)。 在其他类中使用enum变量的时候,只需要【类名.变量名】就可以了,和使用静态变量一样。 但是这种简单的使用显然不能体现出枚举的强大,我们来学习一下复杂的使用: 枚举的高级使用方法 就像我们前面的案例一样,你需要让每一个星期几对应到一个整数,比如星期天对应0。上面讲到了,枚举类在定义的时候会自动为每个变量添加一个顺序,从0开始。 假如你希望0代表星期天,1代表周一。。。并且你在定义枚举类的时候,顺序也是这个顺序,那你可以不用定义新的变量,就像这样: public enum Weekday { SUN,MON,TUS,WED,THU,FRI,SAT } 这个时候,星期天对应的ordinal值就是0,周一对应的就是1,满足你的要求。但是,如果你这么写,那就有问题了: public enum Weekday { MON,TUS,WED,THU,FRI,SAT,SUN } 我吧SUN放到了最后,但是我还是希0代表SUN,1代表MON怎么办呢?默认的ordinal是指望不上了,因为它只会傻傻的给第一个变量0,给第二个1。。。 所以,我们需要自己定义变量! 看代码: 我们对上面的代码做了一些改变: 首先,我们在每个枚举变量的后面加上了一个括号,里面是我们希望它代表的数字。 然后,我们定义了一个int变量,然后通过构造函数初始化这个变量。 你应该也清楚了,括号里的数字,其实就是我们定义的那个int变量。这句叫做自定义变量。 请注意:这里有三点需要注意: 一定要把枚举变量的定义放在第一行,并且以分号结尾。 构造函数必须私有化。事实上,private是多余的,你完全没有必要写,因为它默认并强制是private,如果你要写,也只能写private,写public是不能通过编译的。 自定义变量与默认的ordinal属性并不冲突,ordinal还是按照它的规则给每个枚举变量按顺序赋值。 好了,你很聪明,你已经掌握了上面的知识,你想,既然能自定义一个变量,能不能自定义两个呢? 当然可以: 你可以定义任何你想要的变量。学完了这些,大概枚举类你也应该掌握了,但是,还有没有其他用法呢? 枚举类中的抽象类 如果我在枚举类中定义一个抽象方法会怎么样? 你要知道,枚举类不能继承其他类,也不能被其他类继承。至于为什么,我们后面会说到。 你应该知道,有抽象方法的类必然是抽象类,抽象类就需要子类继承它然后实现它的抽象方法,但是呢,枚举类不能被继承。。你是不是有点乱? 我们先来看代码: 你好像懂了点什么。但是你好像又不太懂。为什么一个变量的后边可以带一个代码块并且实现抽象方法呢? 别着急,带着这个疑问,我们来看一下枚举类的实现原理。 枚举类的实现原理 从最简单的看起: 还是这段熟悉的代码,我们编译一下它,再反编译一下看看它到底是什么样子的: 你是不是觉得很熟悉?反编译出来的代码和我们用静态变量自己写的类出奇的相似! 而且,你看到了熟悉的values()方法和valueOf()方法。 仔细看,这个类继承了java.lang.Enum类!所以说,枚举类不能再继承其他类了,因为默认已经继承了Enum类。 并且,这个类是final的!所以它不能被继承! 回到我们刚才的那个疑问: 为什么会有这么神奇的代码?现在你差不多懂了。因为RED本身就是一个TrafficLamp对象的引用。实际上,在初始化这个枚举类的时候,你可以理解为执行的是 TrafficLamp RED = new TrafficLamp(30) ,但是因为TrafficLamp里面有抽象方法,还记得匿名内部类么? 我们可以这样来创建一个TrafficLamp引用: 而在枚举类中,我们只需要像上面那样写【RED(30){}】就可以了,因为java会自动的去帮我们完成这一系列操作 枚举类的其他用法 switch语句 虽然枚举类不能继承其他类,但是还是可以实现接口的 接口定义 实现接口 使用接口组织枚举 使用枚举创建单例模式 使用枚举创建的单例模式: public enum EasySingleton{ INSTANCE; } 代码就这么简单,你可以使用EasySingleton.INSTANCE调用它,比起你在单例中调用getInstance()方法容易多了。 我们来看看正常情况下是怎样创建单例模式的: 用双检索实现单例: 下面的代码是用双检索实现单例模式的例子,在这里getInstance()方法检查了两次来判断INSTANCE是否为null,这就是为什么叫双检索的原因,记住双检索在java5之前是有问题的,但是java5在内存模型中有了volatile变量之后就没问题了。 public class DoubleCheckedLockingSingleton{ private volatile DoubleCheckedLockingSingleton INSTANCE; private DoubleCheckedLockingSingleton(){} public DoubleCheckedLockingSingleton getInstance(){ if(INSTANCE == null){ synchronized(DoubleCheckedLockingSingleton.class){ //double checking Singleton instance if(INSTANCE == null){ INSTANCE = new DoubleCheckedLockingSingleton(); } } } return INSTANCE; } } 你可以访问DoubleCheckedLockingSingleTon.getInstance()来获得实例对象。 用静态工厂方法实现单例: public class Singleton{ private static final Singleton INSTANCE = new Singleton(); private Singleton(){} public static Singleton getSingleton(){ return INSTANCE; } } 你可以调用Singleton.getInstance()方法来获得实例对象。 上面的两种方式就是懒汉式和恶汉式单利的创建,但是无论哪一种,都不如枚举来的方便。而且传统的单例模式的另外一个问题是一旦你实现了serializable接口,他们就不再是单例的了。但是枚举类的父类【Enum类】实现了Serializable接口,也就是说,所有的枚举类都是可以实现序列化的,这也是一个优点。 总结 可以创建一个enum类,把它看做一个普通的类。除了它不能继承其他类了。(java是单继承,它已经继承了Enum),可以添加其他方法,覆盖它本身的方法 switch()参数可以使用enum values()方法是编译器插入到enum定义中的static方法,所以,当你将enum实例向上转型为父类Enum是,values()就不可访问了。解决办法:在Class中有一个getEnumConstants()方法,所以即便Enum接口中没有values()方法,我们仍然可以通过Class对象取得所有的enum实例 无法从enum继承子类,如果需要扩展enum中的元素,在一个接口的内部,创建实现该接口的枚举,以此将元素进行分组。达到将枚举元素进行分组。 enum允许程序员为eunm实例编写方法。所以可以为每个enum实例赋予各自不同的行为。 【java.util.EnumSet和java.util.EnumMap】


优秀的个人博客,低调大师

jdk分析工具:jps和jstack

jps 用来查看基于HotSpotJVM里面所有进程的具体状态,包括进程ID,进程启动的路径等等。与unix上的ps类似,用来显示本地有权限的java进程,可以查看本地运行着几个java程序,并显示他们的进程号。使用jps时,不需要传递进程号做为参数。 Jps也可以显示远程系统上的JAVA进程,这需要远程服务上开启了jstat服务,以及RMI注及服务,不过常用都是对本对的JAVA进程的查看。 命令格式 jps[options][hostid] 常用参数说明 -m输出传递给main方法的参数,如果是内嵌的JVM则输出为null。 -l输出应用程序主类的完整包名,或者是应用程序JAR文件的完整路径。 -v输出传给JVM的参数。 使用示例 blue@blue-pc:~$ jps 8710 Jps 5661 Bootstrap 2491 2967 blue@blue-pc:~$ jps -ml 5661 org.apache.catalina.startup.Bootstrap start 2491 8724 sun.tools.jps.Jps -ml 2967 blue@blue-pc:~$ jps -mlv 5661 org.apache.catalina.startup.Bootstrap start -Djava.util.logging.config.file=/home/blue/apache-tomcat-7.0.39/conf/logging.properties -Djava.util.logging.manager=org.apache.juli.ClassLoaderLogManager -Djava.endorsed.dirs=/home/blue/apache-tomcat-7.0.39/endorsed -Dcatalina.base=/home/blue/apache-tomcat-7.0.39 -Dcatalina.home=/home/blue/apache-tomcat-7.0.39 -Djava.io.tmpdir=/home/blue/apache-tomcat-7.0.39/temp 2491 -Dosgi.requiredJavaVersion=1.5 -XX:MaxPermSize=256m -Xms40m -Xmx384m 8738 sun.tools.jps.Jps -mlv -Dapplication.home=/usr/local/jdk1.6.0_35 -Xms8m 2967 -Dosgi.requiredJavaVersion=1.5 -XX:MaxPermSize=256m -Xms40m -Xmx512m 前面的数字是jvm的进程id,后面是jvm的类启动信息。 jstack 如果java程序崩溃生成core文件,jstack工具可以用来获得core文件的java stack和native stack的信息,从而可以轻松地知道java程序是如何崩溃和在程序何处发生问题。另外,jstack工具还可以附属到正在运行的java程序中,看到当时运行的java程序的java stack和native stack的信息,如果现在运行的java程序呈现hung的状态,jstack是非常有用的。 命令格式 $jstack[option]pid $jstack[option]executablecore $jstack[option][server-id@]remote-hostname-or-IP 常用参数说明 OPTIONS -Fjstack [-l] pid无法响应时,强制打印堆栈 -ll长列表.打印关于锁的附加信息,例如属于java.util.concurrent的ownablesynchronizers列表. -m 混合模式输出(包括java和本地c/c++片段)堆栈。 pid: java应用程序的进程号,一般可以通过jps来获得; executable:产生coredump的java可执行程序; core:打印出的core文件; remote-hostname-or-ip:远程debug服务器的名称或IP; server-id: 唯一id,假如一台主机上多个远程debug服务; 使用示例 blue@blue-pc:~$ jps -ml 5661 org.apache.catalina.startup.Bootstrap blue@blue-pc:~$ jstack 5661 2013-04-16 21:09:27 Full thread dump Java HotSpot(TM) Server VM (20.10-b01 mixed mode): "Attach Listener" daemon prio=10 tid=0x70e95400 nid=0x2265 waiting on condition [0x00000000] java.lang.Thread.State: RUNNABLE "http-bio-8080-exec-20" daemon prio=10 tid=0x08a35800 nid=0x1d42 waiting on condition [0x70997000] java.lang.Thread.State: WAITING (parking) at sun.misc.Unsafe.park(Native Method) - parking to wait for <0x766a27b8> (a java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject) at java.util.concurrent.locks.LockSupport.park(LockSupport.java:156) at java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject.await(AbstractQueuedSynchronizer.java:1987) at java.util.concurrent.LinkedBlockingQueue.take(LinkedBlockingQueue.java:399) at org.apache.tomcat.util.threads.TaskQueue.take(TaskQueue.java:104) at org.apache.tomcat.util.threads.TaskQueue.take(TaskQueue.java:32) at java.util.concurrent.ThreadPoolExecutor.getTask(ThreadPoolExecutor.java:947) at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:907) at java.lang.Thread.run(Thread.java:662) ........ 一般情况下,通过jstack输出的线程信息主要包括:jvm自身线程、用户线程等。其中jvm线程会在jvm启动时就会存在。对于用户线程则是在用户访问时才会生成。 分类: java 本文转自快乐就好博客园博客,原文链接:http://www.cnblogs.com/happyday56/p/6006868.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

c++中sizeof的分析

sizeof是何方神圣sizeof乃C/C++中的一个操作符(operator)是也,简单的说其作用就是返回一个对象或者类型所占的内存字节数。 MSDN上的解释为: The sizeof keyword gives the amount of storage, in bytes, associated with a variable or a type (including aggregate types). This keyword returns a value of type size_t. 其返回值类型为size_t,在头文件stddef.h中定义。这是一个依赖于编译系统的值,一般定义为 typedef unsigned int size_t; 世上编译器林林总总,但作为一个规范,它们都会保证char、signed char和unsigned char的sizeof值为1,毕竟char是我们编程能用的最小数据类型。 2. 语法: sizeof有三种语法形式,如下: 1) sizeof( object ); // sizeof( 对象 ); 2) sizeof( type_name ); // sizeof( 类型 ); 3) sizeof object; // sizeof 对象; 所以, int i; sizeof( i ); // ok sizeof i; // ok sizeof( int ); // ok sizeof int; // error 既然写法3可以用写法1代替,为求形式统一以及减少我们大脑的负担,第3种写法,忘掉它吧!实际上,sizeof计算对象的大小也是转换成对对象类型的计算,也就是说,同种类型的不同对象其sizeof值都是一致的。这里,对象可以进一步延伸至表达式,即sizeof可以对一个表达式求值,编译器根据表达式的最终结果类型来确定大小,一般不会对表达式进行计算。如: sizeof( 2 ); // 2的类型为int,所以等价于 sizeof( int ); sizeof( 2 + 3.14 ); // 3.14的类型为double,2也会被提升成double类型,所以等价于 sizeof( double ); sizeof也可以对一个函数调用求值,其结果是函数返回类型的大小,函数并不会被调用,我们来看一个完整的例子: char foo() { printf("foo() has been called.\n"); return 'a'; } int main() { size_t sz = sizeof( foo() ); // foo() 的返回值类型为char,所以sz = sizeof(char ),foo()并不会被调用 printf("sizeof( foo() ) = %d\n", sz); } C99标准规定,函数、不能确定类型的表达式以及位域(bit-field)成员不能被计算sizeof值,即下面这些写法都是错误的: sizeof( foo );// error void foo2() { } sizeof( foo2() );// error struct S { unsigned int f1 : 1; unsigned int f2 : 5; unsigned int f3 : 12; }; sizeof( S.f1 );// error 3. sizeof的常量性 sizeof的计算发生在编译时刻,所以它可以被当作常量表达式使用,如: char ary[ sizeof( int ) * 10 ]; // ok 最新的C99标准规定sizeof也可以在运行时刻进行计算,如下面的程序在Dev-C++中可以正确执行: int n; n = 10; // n动态赋值 char ary[n]; // C99也支持数组的动态定义 printf("%d\n", sizeof(ary)); // ok. 输出10 但在没有完全实现C99标准的编译器中就行不通了,上面的代码在VC6中就通不过编译。所以我们最好还是认为sizeof是在编译期执行的,这样不会带来错误,让程序的可移植性强些。 4. 基本数据类型的sizeof 这里的基本数据类型指short、int、long、float、double这样的简单内置数据类型,由于它们都是和系统相关的,所以在不同的系统下取值可能不同,这务必引起我们的注意,尽量不要在这方面给自己程序的移植造成麻烦。 一般的,在32位编译环境中,sizeof(int)的取值为4。 5. 指针变量的sizeof 学过数据结构的你应该知道指针是一个很重要的概念,它记录了另一个对象的地址。既然是来存放地址的,那么它当然等于计算机内部地址总线的宽度。所以在32位计算机中,一个指针变量的返回值必定是4(注意结果是以字节为单位),可以预计,在将来的64位系统中指针变量的sizeof结果为8。 char* pc = "abc"; int* pi; string* ps; char** ppc = &pc; void (*pf)();// 函数指针 sizeof( pc ); // 结果为4 sizeof( pi ); // 结果为4 sizeof( ps ); // 结果为4 sizeof( ppc ); // 结果为4 sizeof( pf );// 结果为4 指针变量的sizeof值与指针所指的对象没有任何关系,正是由于所有的指针变量所占内存大小相等,所以MFC消息处理函数使用两个参数WPARAM、LPARAM就能传递各种复杂的消息结构(使用指向结构体的指针)。 6. 数组的sizeof 数组的sizeof值等于数组所占用的内存字节数,如: char a1[] = "abc"; int a2[3]; sizeof( a1 ); // 结果为4,字符 末尾还存在一个NULL终止符 sizeof( a2 ); // 结果为3*4=12(依赖于int) 一些朋友刚开始时把sizeof当作了求数组元素的个数,现在,你应该知道这是不对的,那么应该怎么求数组元素的个数呢Easy,通常有下面两种写法: int c1 = sizeof( a1 ) / sizeof( char ); // 总长度/单个元素的长度 int c2 = sizeof( a1 ) / sizeof( a1[0] ); // 总长度/第一个元素的长度 写到这里,提一问,下面的c3,c4值应该是多少呢 void foo3(char a3[3]) { int c3 = sizeof( a3 ); // c3 == } void foo4(char a4[]) { int c4 = sizeof( a4 ); // c4 == } 也许当你试图回答c4的值时已经意识到c3答错了,是的,c3!=3。这里函数参数a3已不再是数组类型,而是蜕变成指针,相当于char* a3,为什么仔细想想就不难明白,我们调用函数foo1时,程序会在栈上分配一个大小为3的数组吗不会!数组是“传址”的,调用者只需将实参的地址传递过去,所以a3自然为指针类型(char*),c3的值也就为4。 7. 结构体的sizeof 这是初学者问得最多的一个问题,所以这里有必要多费点笔墨。让我们先看一个结构体: struct S1 { char c; int i; }; 问sizeof(s1)等于多少聪明的你开始思考了,char占1个字节,int占4个字节,那么加起来就应该是5。是这样吗你在你机器上试过了吗也许你是对的,但很可能你是错的!VC6中按默认设置得到的结果为8。 Why为什么受伤的总是我 请不要沮丧,我们来好好琢磨一下sizeof的定义——sizeof的结果等于对象或者类型所占的内存字节数,好吧,那就让我们来看看S1的内存分配情况: S1 s1 = { 'a', 0xFFFFFFFF }; 定义上面的变量后,加上断点,运行程序,观察s1所在的内存,你发现了什么 以我的VC6.0为例,s1的地址为0x0012FF78,其数据内容如下: 0012FF78: 61 CC CC CC FF FF FF FF 发现了什么怎么中间夹杂了3个字节的CC看看MSDN上的说明: When applied to a structure type or variable, sizeof returns the actual size, which may include padding bytes inserted for alignment. 原来如此,这就是传说中的字节对齐啊!一个重要的话题出现了。 为什么需要字节对齐计算机组成原理教导我们这样有助于加快计算机的取数速度,否则就得多花指令周期了。为此,编译器默认会对结构体进行处理(实际上其它地方的数据变量也是如此),让宽度为2的基本数据类型(short等)都位于能被2整除的地址上,让宽度为4的基本数据类型(int等)都位于能被4整除的地址上,以此类推。这样,两个数中间就可能需要加入填充字节,所以整个结构体的sizeof值就增长了。 让我们交换一下S1中char与int的位置: struct S2 { int i; char c; }; 看看sizeof(S2)的结果为多少,怎么还是8再看看内存,原来成员c后面仍然有3个填充字节,这又是为什么啊别着急,下面总结规律。 字节对齐的细节和编译器实现相关,但一般而言,满足三个准则: 1) 结构体变量的首地址能够被其最宽基本类型成员的大小所整除; 2) 结构体每个成员相对于结构体首地址的偏移量(offset)都是成员大小的整数倍,如有需要编译器会在成员之间加上填充字节(internal adding); 3) 结构体的总大小为结构体最宽基本类型成员大小的整数倍,如有需要编译器会在最末一个成员之后加上填充字节(trailing padding)。 对于上面的准则,有几点需要说明: 1) 前面不是说结构体成员的地址是其大小的整数倍,怎么又说到偏移量了呢因为有了第1点存在,所以我们就可以只考虑成员的偏移量,这样思考起来简单。想想为什么。 结构体某个成员相对于结构体首地址的偏移量可以通过宏offsetof()来获得,这个宏也在stddef.h中定义,如下: #define offsetof(s,m) (size_t)&(((s *)0)->m) 例如,想要获得S2中c的偏移量,方法为 size_t pos = offsetof(S2, c);// pos等于4 2) 基本类型是指前面提到的像char、short、int、float、double这样的内置数据类型,这里所说的“数据宽度”就是指其sizeof的大小。由于结构体的成员可以是复合类型,比如另外一个结构体,所以在寻找最宽基本类型成员时,应当包括复合类型成员的子成员,而不是把复合成员看成是一个整体。但在确定复合类型成员的偏移位置时则是将复合类型作为整体看待。 这里叙述起来有点拗口,思考起来也有点挠头,还是让我们看看例子吧(具体数值仍以VC6为例,以后不再说明): struct S3 { char c1; S1 s; char c2; }; S1的最宽简单成员的类型为int,S3在考虑最宽简单类型成员时是将S1“打散”看的,所以S3的最宽简单类型为int,这样,通过S3定义的变量,其存储空间首地址需要被4整除,整个sizeof(S3)的值也应该被4整除。 c1的偏移量为0,s的偏移量呢这时s是一个整体,它作为结构体变量也满足前面三个准则,所以其大小为8,偏移量为4,c1与s之间便需要3个填充字节,而c2与s之间就不需要了,所以c2的偏移量为12,算上c2的大小为13,13是不能被4整除的,这样末尾还得补上3个填充字节。最后得到sizeof(S3)的值为16。 通过上面的叙述,我们可以得到一个公式: 结构体的大小等于最后一个成员的偏移量加上其大小再加上末尾的填充字节数目,即: sizeof( struct ) = offsetof( last item ) + sizeof( last item ) + sizeof( trailing padding ) 到这里,朋友们应该对结构体的sizeof有了一个全新的认识,但不要高兴得太早,有一个影响sizeof的重要参量还未被提及,那便是编译器的pack指令。它是用来调整结构体对齐方式的,不同编译器名称和用法略有不同,VC6中通过#pragma pack实现,也可以直接修改/Zp编译开关。#pragma pack的基本用法为:#pragma pack( n ),n为字节对齐数,其取值为1、2、4、8、16,默认是8,如果这个值比结构体成员的sizeof值小,那么 该成员的偏移量应该以此值为准,即是说,结构体成员的偏移量应该取二者的最小值, 公式如下: offsetof( item ) = min( n, sizeof( item ) ) 再看示例: #pragma pack(push) // 将当前pack设置压栈保存 #pragma pack(2) // 必须在结构体定义之前使用 struct S1 { char c; int i; }; struct S3 { char c1; S1 s; char c2; }; #pragma pack(pop) // 恢复先前的pack设置 计算sizeof(S1)时,min(2, sizeof(i))的值为2,所以i的偏移量为2,加上sizeof(i)等于6,能够被2整除,所以整个S1的大小为6。 同样,对于sizeof(S3),s的偏移量为2,c2的偏移量为8,加上sizeof(c2)等于9,不能被2整除,添加一个填充字节,所以sizeof(S3)等于10。 现在,朋友们可以轻松的出一口气了,:) 还有一点要注意,“空结构体”(不含数据成员)的大小不为0,而是1。试想一个“不占空间”的变量如何被取地址、两个不同的“空结构体”变量又如何得以区分呢于是,“空结构体”变量也得被存储,这样编译器也就只能为其分配一个字节的空间用于占位了。如下: struct S5 { }; sizeof( S5 ); // 结果为1 8. 含位域结构体的sizeof 前面已经说过,位域成员不能单独被取sizeof值,我们这里要讨论的是含有位域的结构体的sizeof,只是考虑到其特殊性而将其专门列了出来。 C99规定int、unsigned int和bool可以作为位域类型,但编译器几乎都对此作了扩展,允许其它类型类型的存在。使用位域的主要目的是压缩存储,其大致规则为: 1) 如果相邻位域字段的类型相同,且其位宽之和小于类型的sizeof大小,则后面的字段将紧邻前一个字段存储,直到不能容纳为止; 2) 如果相邻位域字段的类型相同,但其位宽之和大于类型的sizeof大小,则后面的字段将从新的存储单元开始,其偏移量为其类型大小的整数倍; 3) 如果相邻的位域字段的类型不同,则各编译器的具体实现有差异,VC6采取不压缩方式,Dev-C++采取压缩方式; 4) 如果位域字段之间穿插着非位域字段,则不进行压缩; 5) 整个结构体的总大小为最宽基本类型成员大小的整数倍。 还是让我们来看看例子。 示例1: struct BF1 { char f1 : 3; char f2 : 4; char f3 : 5; }; 其内存布局为: |_f1__|__f2__|_|____f3___|____| |_|_|_|_|_|_|_|_|_|_|_|_|_|_|_|_| 0 3 7 8 1316 位域类型为char,第1个字节仅能容纳下f1和f2,所以f2被压缩到第1个字节中,而f3只 能从下一个字节开始。因此sizeof(BF1)的结果为2。 示例2: struct BF2 { char f1 : 3; short f2 : 4; char f3 : 5; }; 由于相邻位域类型不同,在VC6中其sizeof为6,在Dev-C++中为2。 示例3: struct BF3 { char f1 : 3; char f2; char f3 : 5; }; 非位域字段穿插在其中,不会产生压缩,在VC6和Dev-C++中得到的大小均为3。 9. 联合体的sizeof 结构体在内存组织上是顺序式的,联合体则是重叠式,各成员共享一段内存,所以整个联合体的sizeof也就是每个成员sizeof的最大值。结构体的成员也可以是复合类型,这里,复合类型成员是被作为整体考虑的。 所以,下面例子中,U的sizeof值等于sizeof(s)。 union U { int i; char c; S1 s; }; ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/archive/2012/03/19/2405455.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册