首页 文章 精选 留言 我的

精选列表

搜索[开源机器人],共10000篇文章
优秀的个人博客,低调大师

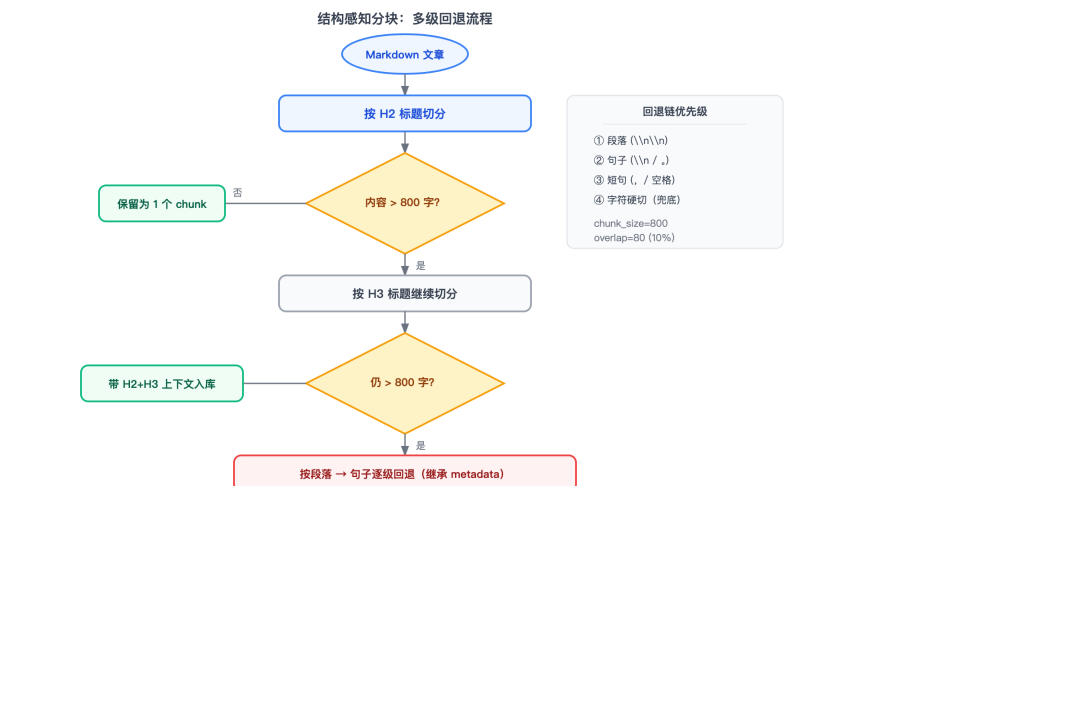
我的 AI 知识库开源!RAG命中率从60%到78% 经验分享

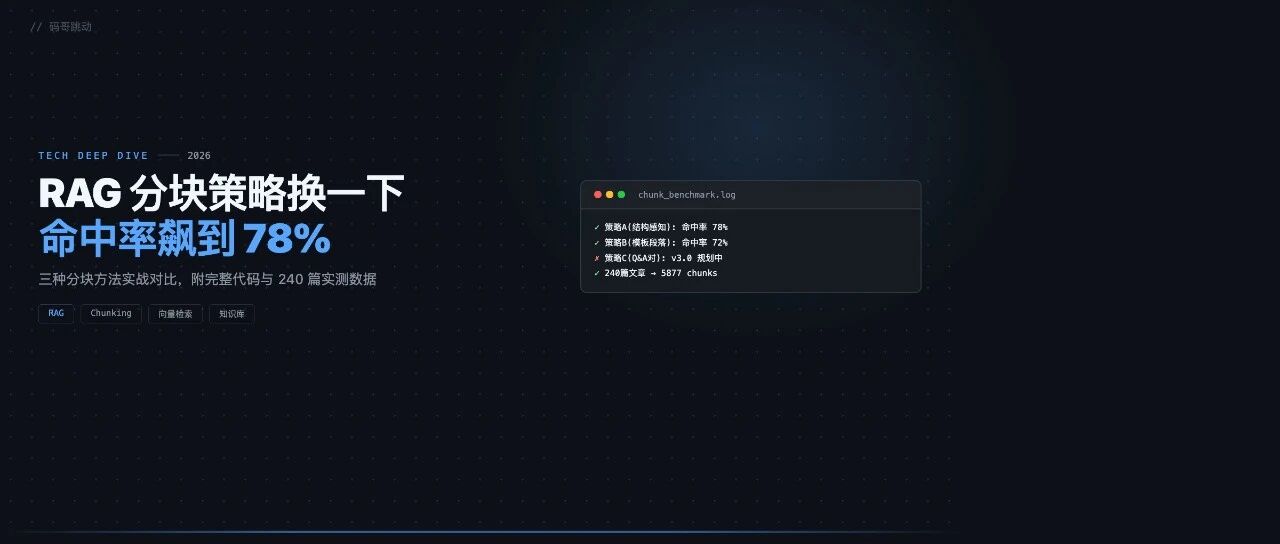
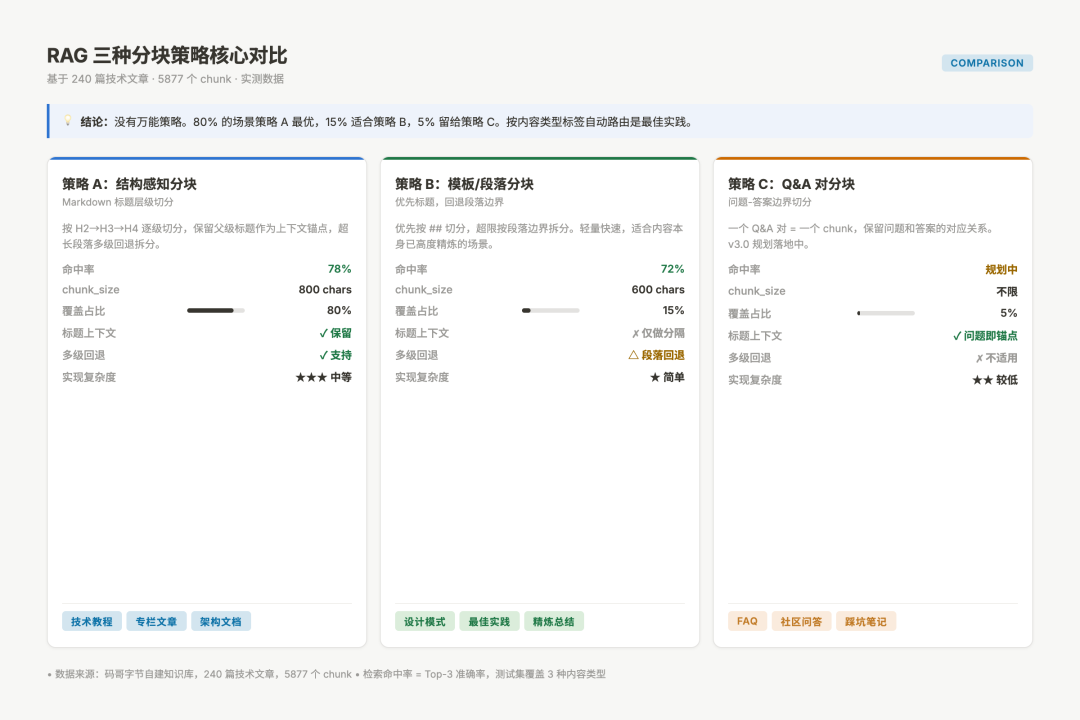
我花了1个月搭了一套[自建 RAG 知识库,240 篇技术文章灌进去](https://mp.weixin.qq.com/s?__biz=MzkzMDI1NjcyOQ==&mid=2247507550&idx=1&sn=b63ebdd3ae6db3e2c3750cbcfbb05de7&scene=21#wechat_redirect),向量库跑起来一切正常。 然后我用"Redis Cluster 怎么扩容"搜了一下。 返回的结果前三篇分别是:《Redis 为什么快》、《Go 语言的并发模型》、《我们团队的代码规范》。每一篇回答了我的问题。 问题不在 embedding 模型,不在向量数据库。问题出在一个大多数教程一笔带过、很多工程师压根没认真对待的环节——**分块策略**。 同样的向量数据库、同样的 embedding 模型,分块策略不同,检索命中率能差 20% 以上。这不是夸大,是我实打实测出来的。 ![三种分块策略核心差异速览](https://developer.qcloudimg.com/http-save/yehe-2253892/a57b140448afdc7e2d5c2bf8e3dfb627.png) 三种分块策略核心差异速览 ## **先给答案:三种策略怎么选** 不想看完整分析的话,这张表够用了: |你的内容类型|推荐策略|预期命中率|一句话理由| | --- | --- | --- | --- | |技术教程、专栏、架构文档|策略 A:结构感知分块|~78%|保留标题层级,chunk 自带上下文| |设计模式、最佳实践、精炼总结|策略 B:模板/段落分块|~72%|轻量快速,适合内容本身已结构化| |FAQ、社区问答、踩坑笔记|策略 C:Q&A 对分块|规划中|保证问题和答案不被拆散| 如果你用的还是固定 500 字符硬切,命中率大概率在 60% 左右徘徊——这跟没做 RAG 区别不大。 上面这张表看起来简洁,但背后有一个很多人不知道的事实:**策略 A 和策略 B 本质上是在「内容入库时」就已经决定了检索质量的上下限**。chunk 边界一旦写入索引,之后所有下游操作——换 embedding 模型、加 reranker、调检索参数——都只能在这组已切好的候选上重新排序。如果你的 chunk 本身就是残缺的(一句话被腰斩、代码块被截断、Q&A 被拆散),后面做再多优化也是白搭。 换句话说:**分块定义了「检索对象是什么」,embedding 只决定「怎么找到它」**。想通这一层,你就知道为什么分块策略值得花时间细调。 如果你对自己的内容类型拿不准,直接看后面的详细对比。如果内容结构比较复杂——比如既有一堆 Markdown 教程又有一批 FAQ 问答——可以考虑进阶方案:**Small-to-Big(父子文档)**。用小块做精准召回(chunk_size=300-500),召回后自动扩展到父级大块喂给 LLM。社区 benchmark 显示这套方案的 recall 能达到 0.86,是目前生产环境实测的最优策略之一。 ## **为什么分块策略被低估了** 大部分 RAG 教程的流程是:装向量库 → 选 embedding 模型 → 调检索参数 → 上线。分块这一步,教程里通常就一行 `chunk_size=500`,随手一设就过了。 但实际上,**分块决定了 embedding 向量的信息密度**。 一个 chunk 太大(比如 2000 字符),包含多个不相关的技术概念,embedding 向量就会变成一个"平均脸"——什么都像,什么都检索不准。一个 chunk 太小(比如 200 字符),信息被切碎,检索时会召回一堆零散片段,LLM 得自己拼图。 说白了,分块策略在 RAG 系统里的地位相当于数据库的索引设计。索引没建对,换什么存储引擎都是白搭。 换一个角度想:你写技术文章的时候会先搭标题结构,读者阅读时会根据标题找自己关心的章节。那为什么给向量库灌内容的时候,要把标题结构扔掉、当成一坨平文本切? 这就是结构感知分块的核心思路。 还有一个反直觉的数据点:Adobe 在 2025 年做了一个大规模实验,在他们内部数千工程师使用的技术支持系统上对比了多种分块策略。结果让很多人意外——**400-token 的固定分块(加 20% overlap)在某些场景下反而击败了语义分块和分层分块**,准确率提升了 20%。这说明一个道理:分块策略没有银弹,内容类型决定一切。如果文档本身格式规整、段落清晰,简单的段落切分可能比复杂的语义分块更有效。 ## **策略 A:结构感知分块(我的主力策略)** **原理**:按 Markdown 的标题层级(H2 → H3 → H4)逐级切分,保证每个 chunk 是一个完整的"小节",而不是一段被腰斩的文字。 关键点有两条: 1. **保留父级标题作为上下文前缀**。比如一篇讲 Redis Cluster 的文章,H3 小节"3.4.1 Redis Cluster 是什么"下面的内容在切分时,chunk 的 metadata 会带上 `Redis Cluster 集群 > 3.4.1 Redis Cluster 是什么`。检索时不仅能匹配内容本身,还能利用标题路径做语义锚定。 1. **max_size 不是一刀切,而是"软上限"**。我的设置是 800 字符——大部分 H3 小节本身就在 500-800 字之间,少数超长的会自动在 H4 级别进一步拆分,但绝对不会在一段代码或一个完整概念中间断开。 来看一下实现代码: ``` from langchain.text_splitter import MarkdownHeaderTextSplitter headers_to_split_on = [ ("##", "h2"), ("###", "h3"), ("####", "h4"), ] splitter = MarkdownHeaderTextSplitter( headers_to_split_on=headers_to_split_on, strip_headers=False, # 保留标题文本在 chunk 中 ) # 实际使用:读取 markdown 文件后切分 with open("redis-cluster-deep-dive.md", "r") as f: markdown_content = f.read() chunks = splitter.split_text(markdown_content) for chunk in chunks: # metadata 中保留了完整的标题路径 # 例如:{'h2': 'Redis Cluster 集群', 'h3': '3.4.1 Redis Cluster 是什么'} print(f"标题路径: {chunk.metadata}") print(f"内容长度: {len(chunk.page_content)} 字符") print(f"内容预览: {chunk.page_content[:100]}...") print("---") ``` 但这只是第一步。MarkdownHeaderTextSplitter 按标题切完后,如果某个 H3 下的内容有 3000 多字怎么办?单个 chunk 直接塞进向量库,embedding 质量会严重下降。所以需要加一层多级回退: ``` from langchain.text_splitter import RecursiveCharacterTextSplitter # 多级回退拆分器:优先按 \n\n(段落)切,不行再按 \n(句子),最后按字符 fallback_splitter = RecursiveCharacterTextSplitter( chunk_size=800, chunk_overlap=80, separators=["\n\n", "\n", "。", ".", " ", ""], length_function=len, ) # 对每个 header split 的结果再做尺寸检查 final_chunks = [] for chunk in header_chunks: if len(chunk.page_content) list[dict]: """按 Q&A 模式切分文本""" # 匹配 Q: 或 问: 开头的段落 pattern = r'(?:Q[::]|问[::]|#### Q\d+)(.*?)(?=Q[::]|问[::]|#### Q\d+|$)' matches = re.findall(pattern, text, re.DOTALL) qa_pairs = [] for match in matches: parts = re.split(r'(?:A[::]|答[::])', match, maxsplit=1) if len(parts) == 2: qa_pairs.append({ "question": parts[0].strip(), "answer": parts[1].strip(), }) return qa_pairs ``` 这个策略在 v3.0 里才规划落地,目前只覆盖了我知识库中约 5% 的内容(那批 FAQ 类文章)。但效果已经能看出来——Q&A 类内容的检索命中率提升非常明显,因为问题本身就是一个天然的检索 query,chunk 里同时包含问题和答案,embedding 向量能更好地捕捉这种"提问-回答"语义模式。 **适用内容**:FAQ 页面、社区问答、踩坑笔记——所有以"问题-回答"形式组织的内容。 ## **我的迭代过程:三个版本的教训** 说实话,我在分块策略上踩的坑,比在 embedding 模型选型上踩的还多。 **v1.0:固定 500 字符硬切** 这是绝大多数教程推荐的"最佳实践"——设个 `chunk_size=500`,overlap 给个 50,跑起来就行。 结果惨不忍睹。一段讲 Go 并发模型的中文段落,500 字符可能刚好卡在"goroutine 的调度基于 GMP 模型,G 代表"——后面就没了。G 代表什么?读者想知道,向量库也不知道。 更致命的是代码块被拦腰截断。一个完整的设计模式示例,前半段是问题描述,后半段是实现代码,被切到两个 chunk 里之后,两个 chunk 都变成了语义残片。 命中率 60% 出头——跟随机抽差不多。 **v2.0:按 H2 标题切** 意识到问题之后,我改成了按 H2 标题切分——每个大章节一个 chunk。 效果好了一些,但马上遇到新问题:有些 H2 下面的内容多达 3000+ 字。比如我有一篇讲 Redis 持久化的文章,H2"RDB 快照原理"下面光代码注释就有 1500 字。这么大一个 chunk 塞进向量库,embedding 向量的语义焦点完全散了。 **v3.0:结构感知 + 多级回退** v3.0 就是现在这套方案——H2 → H3 → H4 → 段落 → 句子,逐级回退。每个 chunk 自带标题上下文,尺寸控制在 800 字符左右。 这套方案上线后,命中率稳定在 75%+,少数优化过的专题能达到 80% 以上。 ![结构感知分块的多级回退流程](https://developer.qcloudimg.com/http-save/yehe-2253892/5235208126f972a47cde762ad84d2806.png) 结构感知分块的多级回退流程 ## **四个核心原则(比参数更重要)** 扒完三种策略,我得出的结论是:**参数(chunk_size、overlap)只是表象,核心原则决定了你的分块策略能不能用**。 **原则一:保持语义完整性** 宁可 chunk 稍大,不要打断一个完整的技术概念。切在段落中间、切在代码块中间、切在"首先……其次……"的并列结构中间——这些都是致命伤。一段被腰斩的技术解释,embedding 质量远不如稍长但完整的段落。 **原则二:保留上下文锚点** 每个 chunk 要知道自己属于哪篇文章、哪个章节。这不是为了好看——当 LLM 同时拿到 5 个相关 chunk 时需要回答"这 5 段来自 3 篇不同的文章,它们之间是什么关系"时,上下文锚点是 LLM 拼接信息的唯一线索。 **原则三:内容类型决定分块策略** 不要一刀切。技术教程和 FAQ 问答天然需要不同的分块方式。我现在的做法是:在内容入库时就打上类型标签,分块器根据标签自动选择策略。 **原则四:max_size 不是越短越好,也不是越长越好** 太短丢失上下文(500 字以下的 chunk,embedding 质量下降明显),太长检索精度下降(超过 1200 字的 chunk,容易出现"什么都沾边但什么都不准"的问题)。800 字符是我反复实验后找到的甜点——当然,这个数字对英文内容可能不同,英文的分块甜点通常在 256-512 tokens 之间。 ## **综合评分** |评估维度|策略 A:结构感知|策略 B:模板段落|策略 C:Q&A 对| | --- | --- | --- | --- | |检索命中率|★★★★★ (78%)|★★★★ (72%)|规划中| |实现复杂度|★★★ (需解析标题树)|★ (仅需配置拆分器)|★★| |内容格式要求|必须有 Markdown 标题|有段落结构即可|必须有 Q&A 格式| |长文处理能力|★★★★★ (多级回退)|★★★ (超大段落会退化)|★★ (不适用长文)| |LLM 回答质量|★★★★★ (自带上下文)|★★★ (上下文依赖检索)|★★★★ (Q&A 语义完整)| |适用范围|80% 的常见内容|15%(精炼内容)|5%(FAQ/问答)| 我的实际数据:240 篇文章产生了 5877 个 chunk,平均每篇约 24 个 chunk。策略 A 覆盖了其中 80% 的内容,策略 B 覆盖 15%,策略 C 只占了 5%(还在扩展中)。 有两点值得单独拉出来说—— **第一,语义分块为什么不在我的策略列表里?** 语义分块(按相邻句子 embedding 相似度的骤降点切分)听起来很高级,但社区真实 benchmark 给出了一个扎心的数据:它在某些测试集上以 **50 倍的计算成本**,只换来了和递归切分几乎持平的 recall(0.72 vs 0.74)。花 50 倍成本换不到 2 个点的提升,这性价比不适合大多数生产环境。除非你的文档是纯自然语言长文(法律合同、科研论文),语义分块才有明显优势——因为这类文档没有标题结构可依赖。 **第二,overlap 可能被高估了。** 几乎所有教程都在推荐设 10-20% 的 overlap,但我最近读到了一篇 2025 年的系统分析论文(arXiv:2601.14123),结论是:overlap 在 Natural Questions 这类数据集上**没有显著收益**,反而让索引体积膨胀了约 25%。我的经验是 10% 的 overlap 有个保底作用——防止关键句恰好落在边界上被截断——但不要无脑往上加。overlap 不是越大越好。 ## **常见问题** **Q:chunk_overlap 设多少合适?** 先说一个反常识的结论:有学术分析(arXiv 2025)表明 10-20% 的 overlap 在某些 benchmark 上**没有显著收益**,反而让索引体积膨胀了 25%。我的折中做法是 chunk_size 的 10%——chunk_size=800 时 overlap 设 80。这更多是一个"保底"策略,防止关键句恰好落在边界上被截断,但不用无脑往上加。如果你的文档本身就是按标题/段落组织的,overlap 甚至可以降到 5%。 **Q:什么叫 Context Cliff?它和分块策略有什么关系?** Context Cliff 是一个 2025 年被反复验证的现象:LLM 在上下文超过约 2500-3000 tokens 后,对中间位置信息的提取能力会**显著下降**。这和分块策略直接相关——如果你为了"多给上下文"把 chunk 设得过大(>1500 tokens),或者一次召回太多 chunk 全塞给 LLM,反而会触发这个退化效应。正确的思路是:**小块精准召回 + 只把最相关的 3-5 个 chunk 喂给 LLM**。这也是为什么 Small-to-Big(父子文档)方案值得关注——它在检索阶段用小 chunk 保证精度,生成阶段才扩展到大 chunk,避开了 Context Cliff 的风险。 **Q:中文和英文的分块策略有区别吗?** 有。中文字符本身的信息密度比英文 token 低——一个中文字符通常对应 1.5-2 个 token,一个英文单词也是 1-2 个 token。所以中文的 chunk_size 可以设大一些(我用的 800 字符),英文通常在 256-512 tokens 之间。另外,中文分词对句子边界识别更敏感,分块器中的 `separators` 建议加入中文标点(`。`、`!`、`?`)。 **Q:我的文章很短,每篇只有几百字,还需要分块吗?** 如果单篇文章本身不超过 chunk_size 上限,可以整篇作为一个 chunk 入库,不需要额外拆分。但建议在 metadata 中保留文章标题,方便后续检索时做来源标注。 **Q:三种策略能混用吗?** 能,而且推荐混用。我的做法是在内容入库时,先判断文章类型标签,然后路由到对应的分块策略。比如一篇 Markdown 技术教程走策略 A,一篇设计模式清单走策略 B,一篇 FAQ 走策略 C。不要试图用一套参数覆盖所有内容——这是最常见的错误。 **Q:怎么客观评估分块策略的效果?** 我用的方法是用一组标准测试问题(覆盖不同内容类型),对每种策略分别评估 Top-3 检索命中率。注意要用真实用户会问的问题,而不是你自己写的问题——后者往往和你的 chunk 语义分布高度匹配,测出来的命中率不准。 > **“💬 你现在用的什么分块策略**? - A. 固定 size 硬切,设个 chunk_size 就完了 - B. 按标题/章节切分,保留结构信息 - C. 上了 LangChain/LlamaIndex 的默认配置,没细调 - D. 还没在生产环境真正用过 RAG 评论区说说,码哥猜选 A 和 C 的最多 😂 ## **我的建议** 分块策略是 RAG 系统里最容易被低估、同时也是性价比最高的优化点。换 embedding 模型可能需要重新入库、重新调参,改向量数据库可能需要数据迁移,但优化分块策略只需要改几行 Python 代码——效果立竿见影。 如果你现在用的是固定字符硬切,建议优先迁移到策略 A(结构感知分块)。如果你的内容本身没有 Markdown 标题结构,策略 B(段落切分)是更好的起点。如果你是做 FAQ/客服知识库的,策略 C 的 Q&A 对思路值得一试。 说到底,分块策略的本质是**让每一段文字在脱离原文后仍然能被理解**。技术文章的标题结构是为人类阅读设计的,而分块策略的职责就是把这套结构翻译成向量库能理解的语言。 这篇文章里提到的方法和代码,我自己在生产环境的知识库上跑了几个月。实际效果比我预想的要好——在不需要换 embedding 模型、不需要加 reranker 的情况下,只靠优化分块策略就把命中率从 60% 提到了 78%。如果你的知识库还在为检索精度头疼,不妨先检查一下分块策略——大概率问题就出在这。 写完这篇,码哥自己又过了一遍自己的分块逻辑,发现还有几篇老文章的 chunk 是用 v1.0 策略切的——该重跑了。 下一篇打算拆 embedding 模型选型,bge-large、text2vec、m3e 这些到底哪个更适合中文技术内容,实测数据说话。 感兴趣的关注一下,不然算法不一定推给你。如果不星标,算法就不会主动推给你——错过几篇没关系,但有些内容正好是你当时需要的,那就不划算了。

优秀的个人博客,低调大师

roncoo-education v26.0.0 发布,微服务分布式在线教育开源系统

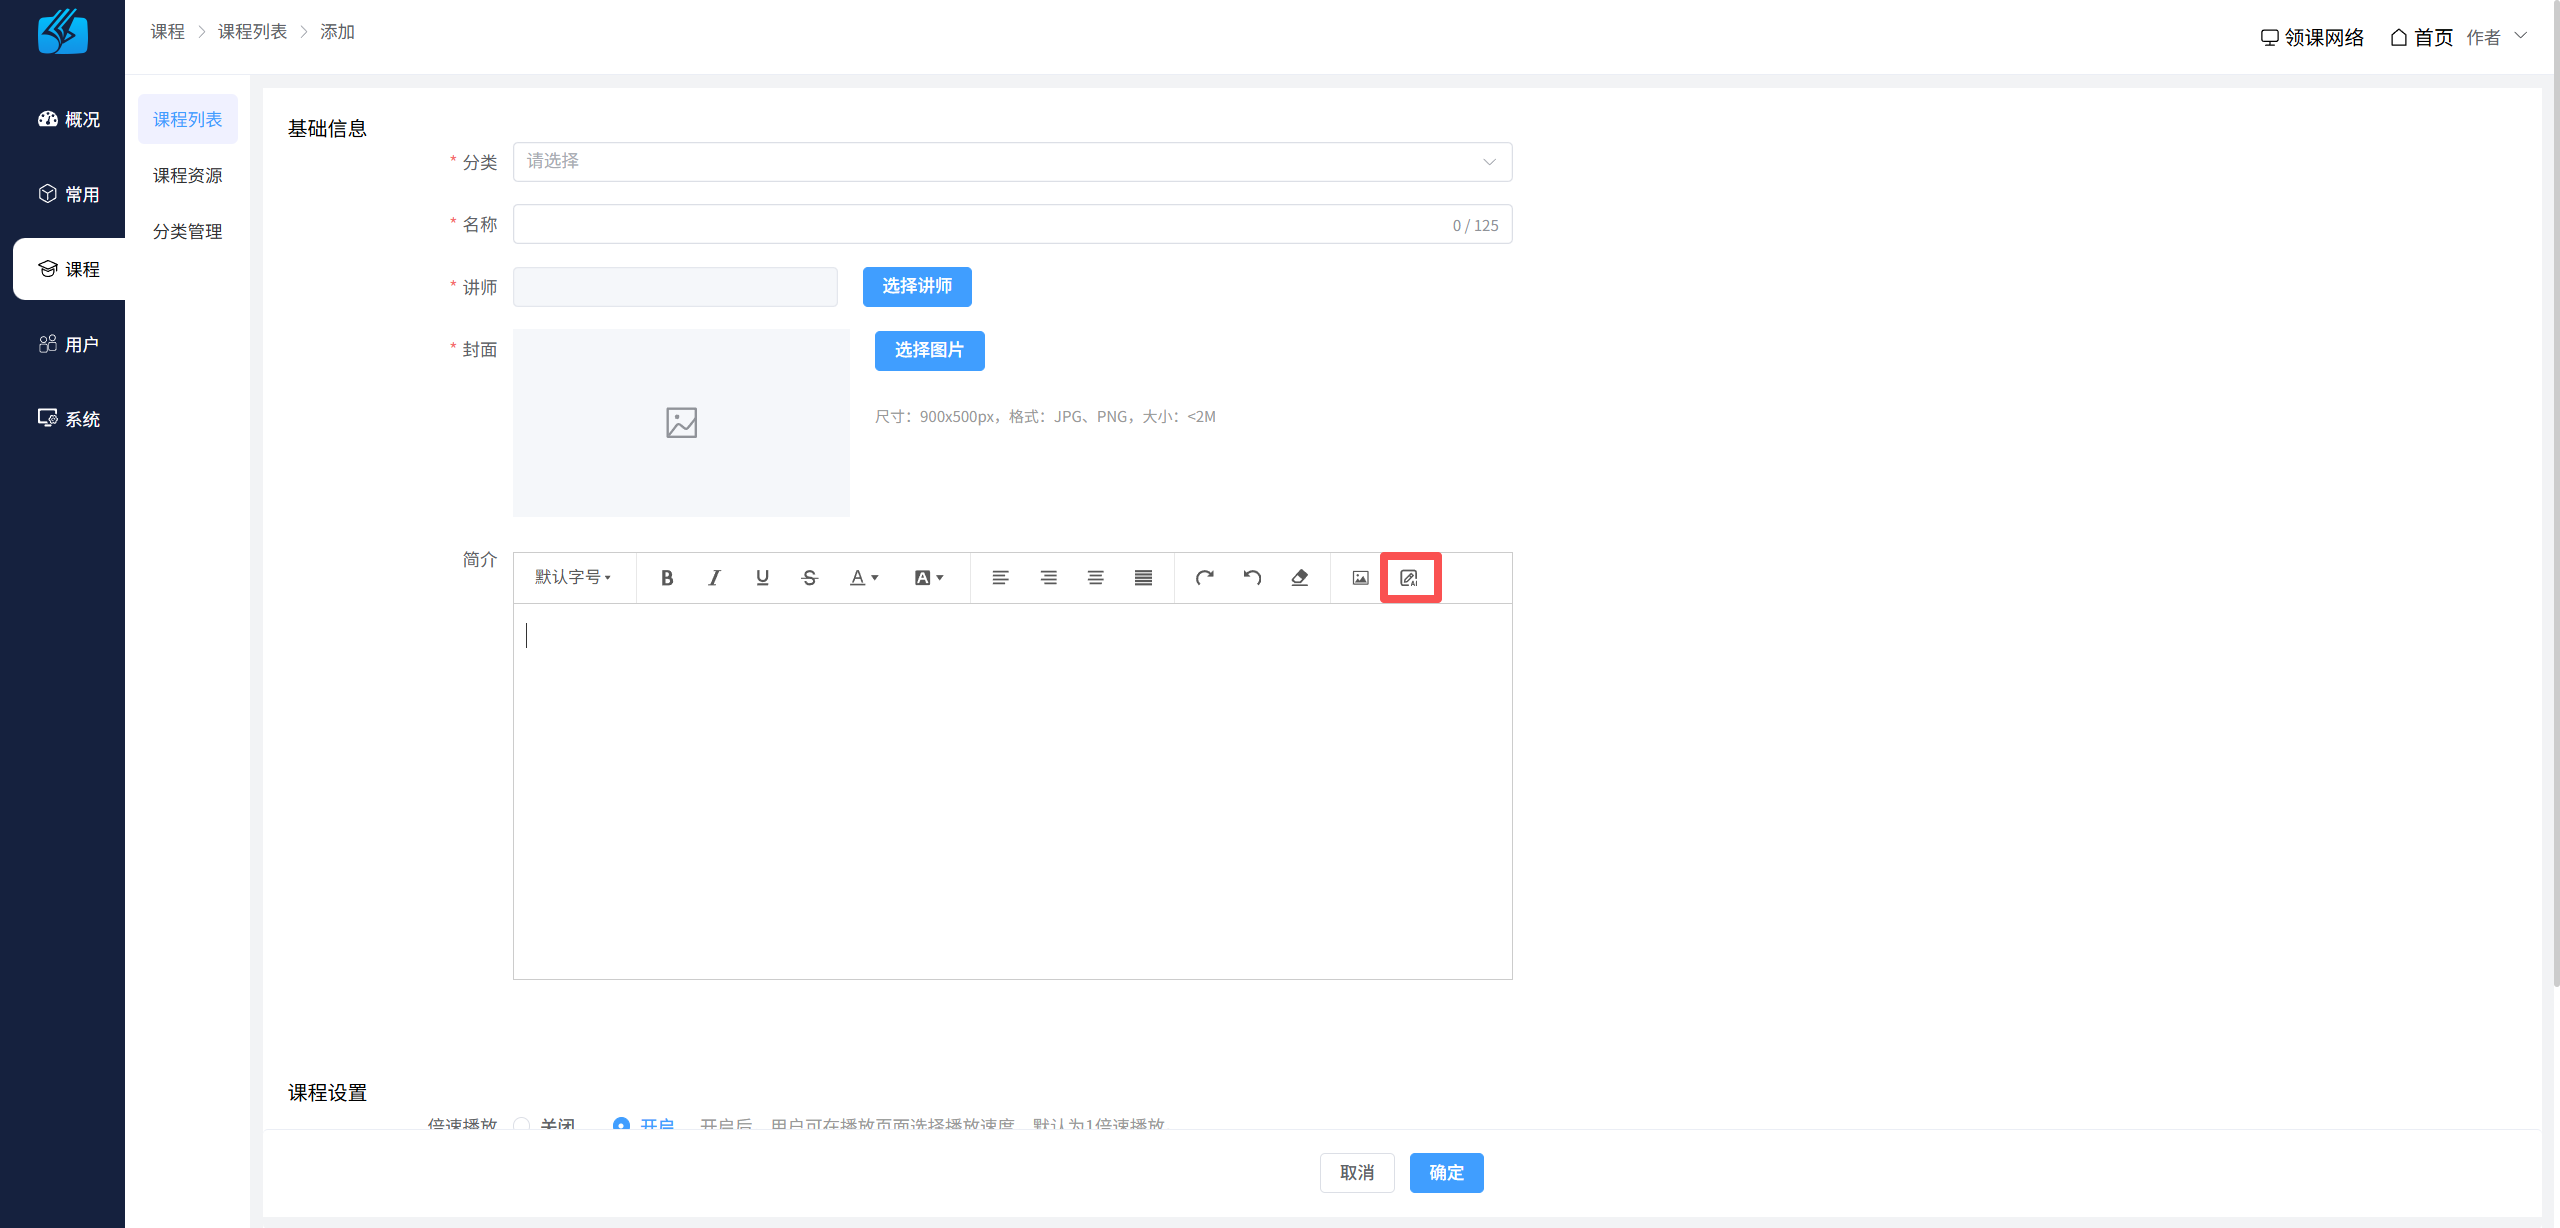
领课教育系统(roncoo-education)是基于领课网络多年的在线教育平台开发和运营经验打造出来的产品,致力于打造一个各行业都适用的分布式在线教育系统。系统采用前后端分离模式,前台采用 vue.js 为核心框架,后台采用 Spring Cloud 为核心框架。系统目前主要功能有课程点播功能,支持多家视频云的接入,课程附件管理功能,支持多家存储云的接入,可以帮助个人或者企业快速搭建一个轻量级的在线教育平台。 前端技术体系:Vue3 + Vite8 + Vue-Router + Element-Plus + Pinia + Axios 后端技术体系:Spring Cloud Alibaba2025 + MySQL8.0 + Nacos + Seata + Mybatis + Druid 当前版本更新内容如下: 1. 集成AI写作功能,方便课程创建时,自动生成课程简介 2. Swagger2升级到Swagger3,切换使用springdoc 3. Spring Boot版本由3.2.4升级到3.5.0,要求jdk>=17 4. Spring Cloud版升由2023.0.1级到2025.0.0 5. xxl-job版本由3.1.1升级到3.4.0 6. nacos版本由2.3.2升级到3.0.3 7. seata版本由2.0.0升级到2.5.0

优秀的个人博客,低调大师

🔥为看板插件增加 client-v2 支持:开源无代码 / 低代码平台 NocoBase

原文链接:https://www.nocobase.com/cn/blog/weekly-updates-20260521 汇总一周产品更新日志,最新发布可以前往我们的博客查看。 NocoBase 目前更新包括的版本更新包括三个分支:main ,next和 develop。 version.png main :截止目前最稳定的版本,推荐安装此版本。 next:包含即将发布的新功能,经过初步测试的版本,可能存在部分已知或未知问题。主要面向测试用户,用于收集反馈和进一步优化功能。适合愿意提前体验新功能并提供反馈的测试用户。 develop:开发中的版本,包含最新的功能代码,可能尚未完成或存在较多不稳定因素,主要用于内部开发和快速迭代。适合对产品功能前沿发展感兴趣的技术用户,但可能存在较多问题或不完整功能,不建议在生产环境中使用。 main main.png v2.0.55 发布日期:2026-05-18 * 优化 [AI 员工] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 (#9497) by @cgyrock [AI: 知识库] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 by @cgyrock * 修复 [client] 修复无法在操作按钮事件流中解析当前弹窗记录变量的问题。 (#9495) by @gchust 修复表单提交时子表单里的 js field 值没有被正确设置的问题。 (#9496) by @gchust [文件管理器] 修复文件管理器 tx-cos 上传后缺少文件大小元数据的问题。 (#9499) by @mytharcher [数据源:主数据库] 修复同步字段后,字段选项会写入 schema 的问题 (#9505) by @2013xile [WEB 客户端] 删除菜单时移除内部区块数据。 (#9459) by @gchust [AI 员工] 修复 AI 员工读取 OSS 存储文件报错问题 (#9493) by @cgyrock [操作:导入记录] 修复导入日期类字段后展示错误的时间的问题 (#9463) by @mytharcher [操作:导出记录 Pro] 修复导出附件 URL 字段提供的附件时的报错 by @mytharcher [操作:导入记录 Pro] 修复专业版 xlsx 导入的时区处理问题 by @mytharcher v2.0.53 发布日期:2026-05-14 * 优化 [flow-engine] 关闭事件流配置页面时如果存在未保存的数据则显示未保存的提示信息。 (#9449) by @gchust * 修复 [client] 修复表格中关联字段显示快捷编辑允许打开编辑弹窗的问题 (#9469) by @katherinehhh 修复子表格中关系字段设置为仅展示后刷新不显示或不可点击的问题。 (#9453) by @jiannx 修复 v2 数据区块多选字段显示选项值而非选项标签的问题 (#9472) by @katherinehhh [区块:分步表单] 修复 v1 分步表单区块设置全高后页面出现滚动条的问题 (#9468) by @katherinehhh next next.png v2.1.0-beta.35 发布日期:2026-05-20 * 优化 [client] v1 和 v2 应用共用条件判断能力 (#9522) by @zhangzhonghe [本地化] 优化 Lina 本地化翻译任务,支持翻译范围、参考语言配置和快捷编辑 (#9521) by @2013xile [工作流:审批] 相关审批现在以时间线卡片展示 by @zhangzhonghe * 修复 [undefined] 对齐 Nginx 配置路径 (#9528) by @chenos [cli-v1] 修复 create-nocobase-app 项目的开发启动问题,复用已发布应用壳并支持本地插件开发。 (#9471) by @Molunerfinn [client] 修复菜单徽章值为 0 时仍显示小红点的问题 (#9491) by @zhangzhonghe 修复筛选表单无法使用当前表单变量的问题 (#9474) by @zhangzhonghe [用户认证] 修复 WebSocket 鉴权 token 关联到未加载或缺失的 authType 时,服务进程崩溃的问题。 (#9514) by @Molunerfinn [日历] 修复日历展开更多日程时显示不全的问题 (#9492) by @zhangzhonghe 修复日历更多事项面板中事项 hover 时未显示手型光标的问题 (#9519) by @jiannx [授权设置] 解决依赖软链接问题 (#9518) by @chenos v2.1.0-beta.34 发布日期:2026-05-19 * 新特性 [区块:看板] 为看板插件增加 client-v2 支持 (#9475) by @jiannx * 优化 [cli] 将 NocoBase CLI 的安装与管理交互流程迁移到 Inquirer,改进提示体验,并修复相关的安装、技能管理和 Docker 运行时问题。 (#9452) by @chenos [AI 员工] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 (#9497) by @cgyrock [通知管理] 调整队列策略以优化发送性能 (#9407) by @mytharcher [工作流:自定义操作事件] 将 block-workbench 和 workflow-custom-action-trigger 插件迁移到 client v2,并同步其操作面板模型与二维码扫描流程。 (#9494) by @jiannx [用户认证] 实现 client-v2 中的认证设置页,并提供可复用的表格、变量输入与表单基础组件。 (#9457) by @Molunerfinn [AI: 知识库] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 by @cgyrock [认证:SAML 2.0] 为 CAS 和 SAML 认证插件补齐 client-v2 入口,使其能在 v2 登录页和认证器后台设置中正常使用。 by @Molunerfinn * 修复 [client-v2] 修复看板插件 v2 路由因客户端未提供 dnd-kit 依赖而加载失败的问题。 (#9516) by @jiannx v2 公共 Table 组件默认展示分页数量选择器,行为对齐 v1。 (#9512) by @Molunerfinn [client] 修复表单提交时子表单里的 js field 值没有被正确设置的问题。 (#9496) by @gchust 修复无法在操作按钮事件流中解析当前弹窗记录变量的问题。 (#9495) by @gchust [flow-engine] 修复控制台不正确的错误日志信息。 (#9502) by @gchust [AI 员工] 修复工作流 AI 员工节点指定的操作人角色权限不生效问题 (#9513) by @cgyrock 修复 AI 员工读取 OSS 存储文件报错问题 (#9493) by @cgyrock [API 文档] 修复 Collection API 文档中的查询参数相互影响问题 (#9442) by @jiannx [数据源:主数据库] 修复同步字段后,字段选项会写入 schema 的问题 (#9505) by @2013xile [工作流:JavaScript 节点] 修复生产构建中工作流 JavaScript 节点 QuickJS 运行时包加载失败的问题。 (#9503) by @mytharcher [WEB 客户端] 删除菜单时移除内部区块数据。 (#9459) by @gchust [操作:导入记录] 修复导入日期类字段后展示错误的时间的问题 (#9463) by @mytharcher [操作:导入记录 Pro] 修复专业版 xlsx 导入的时区处理问题 by @mytharcher [认证:SAML 2.0] 修复 SAML 自动重定向拦截器在每次页面跳转时重复请求导致应用闪屏、抽屉被重复打开的问题。 by @Molunerfinn [操作:导出记录 Pro] 修复导出附件 URL 字段提供的附件时的报错 by @mytharcher v2.1.0-beta.33 发布日期:2026-05-15 * 新特性 [Markdown] Markdown 区块支持 client v2 (#9487) by @jiannx [区块:列表] 列表区块支持 client-v2 (#9486) by @jiannx [日历] 日历插件新增 client v2 支持。 (#9464) by @jiannx [区块:树] 为树筛选区块新增 client-v2 支持。 (#9466) by @jiannx * 优化 [flow-engine] 关闭事件流配置页面时如果存在未保存的数据则显示未保存的提示信息。 (#9449) by @gchust [数据源管理] 优化数据建模接口,支持用 AI 创建评论表,配置外部数据源的关系字段,配置字段验证规则 (#9480) by @2013xile [区块:网格卡片] 更新网格卡片插件支持 client v2 (#9484) by @jiannx [区块:iframe] 新增 iframe 区块的 v2 支持。 (#9485) by @jiannx [AI 员工] AI 员工并行会话交互与性能优化 (#9462) by @cgyrock * 修复 [client] 为表单提交动作补充“提交成功后”设置项。 (#9414) by @jiannx 修复表格中关联字段显示快捷编辑允许打开编辑弹窗的问题 (#9469) by @katherinehhh 修复子表格中关系字段设置为仅展示后刷新不显示或不可点击的问题。 (#9453) by @jiannx 修复旧默认值配置无法被移除的问题。 (#9470) by @gchust 修复 v2 数据区块多选字段显示选项值而非选项标签的问题 (#9472) by @katherinehhh [client-v2] 修复表格中关系字段标题字段选项列表为空的问题 (#9490) by @katherinehhh v2 布局中过滤 v1 菜单后保留空分组 (#9478) by @zhangzhonghe [flow-engine] 修复子模型菜单中关系字段子菜单状态不稳定的问题 (#9417) by @jiannx [文件管理器] 修复文件管理器 tx-cos 上传后缺少文件大小元数据的问题。 (#9499) by @mytharcher [AI 员工] 修复 AI 插件启动失败问题 (#9483) by @cgyrock [区块:分步表单] 修复 v1 分步表单区块设置全高后页面出现滚动条的问题 (#9468) by @katherinehhh [工作流:Webhook 触发器] 修复由于验证规则导致创建响应节点失败的问题 by @mytharcher [数据表字段:手写签名] 移动端签名框显示异常 by @chenzhizdt develop develop.png v2.1.0-alpha.39 发布日期:2026-05-20 * 新特性 [区块:看板] 为看板插件增加 client-v2 支持 (#9475) by @jiannx * 优化 [client] v1 和 v2 应用共用条件判断能力 (#9522) by @zhangzhonghe [本地化] 优化 Lina 本地化翻译任务,支持翻译范围、参考语言配置和快捷编辑 (#9521) by @2013xile [AI 员工] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 (#9497) by @cgyrock [通知管理] 调整队列策略以优化发送性能 (#9407) by @mytharcher [工作流:自定义操作事件] 将 block-workbench 和 workflow-custom-action-trigger 插件迁移到 client v2,并同步其操作面板模型与二维码扫描流程。 (#9494) by @jiannx [用户认证] 实现 client-v2 中的认证设置页,并提供可复用的表格、变量输入与表单基础组件。 (#9457) by @Molunerfinn [AI: 知识库] 新增向量库写入校验:检测到同名数据表时弹出提示,避免误操作覆盖 by @cgyrock [认证:SAML 2.0] 为 CAS 和 SAML 认证插件补齐 client-v2 入口,使其能在 v2 登录页和认证器后台设置中正常使用。 by @Molunerfinn [工作流:审批] 相关审批现在以时间线卡片展示 by @zhangzhonghe * 修复 [undefined] 对齐 Nginx 配置路径 (#9528) by @chenos [cli-v1] 修复 create-nocobase-app 项目的开发启动问题,复用已发布应用壳并支持本地插件开发。 (#9471) by @Molunerfinn [client] 修复筛选表单无法使用当前表单变量的问题 (#9474) by @zhangzhonghe 修复菜单徽章值为 0 时仍显示小红点的问题 (#9491) by @zhangzhonghe [client-v2] v2 公共 Table 组件默认展示分页数量选择器,行为对齐 v1。 (#9512) by @Molunerfinn 修复看板插件 v2 路由因客户端未提供 dnd-kit 依赖而加载失败的问题。 (#9516) by @jiannx [日历] 修复日历更多事项面板中事项 hover 时未显示手型光标的问题 (#9519) by @jiannx 修复日历展开更多日程时显示不全的问题 (#9492) by @zhangzhonghe [授权设置] 解决依赖软链接问题 (#9518) by @chenos [AI 员工] 修复工作流 AI 员工节点指定的操作人角色权限不生效问题 (#9513) by @cgyrock 修复 AI 员工读取 OSS 存储文件报错问题 (#9493) by @cgyrock [用户认证] 修复 WebSocket 鉴权 token 关联到未加载或缺失的 authType 时,服务进程崩溃的问题。 (#9514) by @Molunerfinn [API 文档] 修复 Collection API 文档中的查询参数相互影响问题 (#9442) by @jiannx [数据源:主数据库] 修复同步字段后,字段选项会写入 schema 的问题 (#9505) by @2013xile [认证:SAML 2.0] 修复 SAML 自动重定向拦截器在每次页面跳转时重复请求导致应用闪屏、抽屉被重复打开的问题。 by @Molunerfinn v2.1.0-alpha.38 发布日期:2026-05-18 * 修复 [client] 修复无法在操作按钮事件流中解析当前弹窗记录变量的问题。 (#9495) by @gchust 修复表单提交时子表单里的 js field 值没有被正确设置的问题。 (#9496) by @gchust [flow-engine] 修复控制台不正确的错误日志信息。 (#9502) by @gchust [工作流:JavaScript 节点] 修复生产构建中工作流 JavaScript 节点 QuickJS 运行时包加载失败的问题。 (#9503) by @mytharcher [操作:导入记录] 修复导入日期类字段后展示错误的时间的问题 (#9463) by @mytharcher [操作:导入记录 Pro] 修复专业版 xlsx 导入的时区处理问题 by @mytharcher [操作:导出记录 Pro] 修复导出附件 URL 字段提供的附件时的报错 by @mytharcher v2.1.0-alpha.37 发布日期:2026-05-17 * 修复 [WEB 客户端] 删除菜单时移除内部区块数据。 (#9459) by @gchust v2.1.0-alpha.36 发布日期:2026-05-16 * 新特性 [Markdown] Markdown 区块支持 client v2 (#9487) by @jiannx [区块:列表] 列表区块支持 client-v2 (#9486) by @jiannx * 优化 [flow-engine] 关闭事件流配置页面时如果存在未保存的数据则显示未保存的提示信息。 (#9449) by @gchust [cli] 将 NocoBase CLI 的安装与管理交互流程迁移到 Inquirer,改进提示体验,并修复相关的安装、技能管理和 Docker 运行时问题。 (#9452) by @chenos [数据源管理] 优化数据建模接口,支持用 AI 创建评论表,配置外部数据源的关系字段,配置字段验证规则 (#9480) by @2013xile [区块:网格卡片] 更新网格卡片插件支持 client v2 (#9484) by @jiannx [区块:iframe] 新增 iframe 区块的 v2 支持。 (#9485) by @jiannx * 修复 [client] 修复子表格中关系字段设置为仅展示后刷新不显示或不可点击的问题。 (#9453) by @jiannx 为表单提交动作补充“提交成功后”设置项。 (#9414) by @jiannx [client-v2] 修复表格中关系字段标题字段选项列表为空的问题 (#9490) by @katherinehhh [flow-engine] 修复子模型菜单中关系字段子菜单状态不稳定的问题 (#9417) by @jiannx [文件管理器] 修复文件管理器 tx-cos 上传后缺少文件大小元数据的问题。 (#9499) by @mytharcher [数据表字段:手写签名] 移动端签名框显示异常 by @chenzhizdt v2.1.0-alpha.35 发布日期:2026-05-14 * 新特性 [undefined] 新增 AI 员工:本地化工程师 Lina, 辅助完成本地化翻译 (#9434) by @2013xile 参考文档:本地化管理 Lina:本地化工程师 使用 Lina 和本地 HY-MT1.5-1.8B 翻译本地化词条 [日历] 日历插件新增 client v2 支持。 (#9464) by @jiannx [区块:树] 为树筛选区块新增 client-v2 支持。 (#9466) by @jiannx [文件存储:S3 (Pro)] 支持在 v2 文件管理器中通过 S3 Pro 存储上传文件。 by @Molunerfinn * 优化 [build] 补充了 deleteServerFiles 的回归测试,确保在 Windows 和 POSIX 路径场景下不会误删 client 和 client-v2 构建产物。 (#9318) by @Molunerfinn [client] 一对多关系表格区块的关联操作中,弹窗选择区块应排除已关联数据 (#9448) by @katherinehhh [AI 员工] AI 员工并行会话交互与性能优化 (#9462) by @cgyrock [文件管理器] 第三方存储插件现在可以在 v2 的文件管理器设置页注册自定义的存储类型表单。 (#9439) by @Molunerfinn [AI: 知识库] 支持在创建知识库时指定其唯一键 by @cgyrock * 修复 [client] 修复表格中关联字段显示快捷编辑允许打开编辑弹窗的问题 (#9469) by @katherinehhh 修复 v2 数据区块多选字段显示选项值而非选项标签的问题 (#9472) by @katherinehhh 修复筛选表单有默认值时表格初始化重复请求的问题 (#9423) by @zhangzhonghe 修复旧默认值配置无法被移除的问题。 (#9470) by @gchust 修复字段赋值里关系字段选择字段无法选择常量字段的问题。 (#9088) by @gchust 修复系统设置提交后页面显示为空的问题 (#9458) by @zhangzhonghe 修复表格区块事件流行数据取消选择时设置目标区块数据范围不正确的问题。 (#9443) by @gchust 修复 v2 表格中关系字段修改标题字段时报错的问题 (#9451) by @katherinehhh 修复 V2 联动规则支持字段设置可选项 (#9399) by @jiannx [client-v2] v2 布局中过滤 v1 菜单后保留空分组 (#9478) by @zhangzhonghe 修复启用插件弹窗后方页面变空白的问题 (#9455) by @zhangzhonghe 修复 v1 后台页面在生产构建下引用 v2 插件模块时崩溃的问题。 (#9460) by @Molunerfinn [cli-v1] 修复通过 create-nocobase-app 创建的应用在开发启动时因 app-dev 客户端路径解析错误导致构建失败的问题。 (#9465) by @Molunerfinn [server] fix(file-manager): 对本地/公开存储中有风险内容的文件强制下载 (#9437) by @mytharcher [AI 员工] 修复 AI 插件启动失败问题 (#9483) by @cgyrock 修复 Ollama 试运行无需 Key 却要求输入的问题 (#9450) by @cgyrock [区块:分步表单] 修复 v1 分步表单区块设置全高后页面出现滚动条的问题 (#9468) by @katherinehhh [部门] 修复 Users & Permissions 设置中添加用户和添加部门按钮翻译相互影响的问题 (#9456) by @katherinehhh [工作流] 修复:补回 FlowModel 工作流绑定弹窗中操作类事件与自定义操作事件的提示文案 (#9447) by @mytharcher [Markdown] 修复 v2 Markdown 区块报错的问题 (#9440) by @zhangzhonghe [工作流:Webhook 触发器] 修复由于验证规则导致创建响应节点失败的问题 by @mytharcher [工作流:审批] 修复移动端审批表单布局显示不正确的问题 by @zhangzhonghe 修复审批转签时审批记录索引重复的问题。 by @mytharcher [备份管理器] 修复备份时因为文件无法找到而失败报错的问题。 by @gchust

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册