首页 文章 精选 留言 我的

精选列表

搜索[文智公众趋势分析],共10000篇文章
优秀的个人博客,低调大师

一文看懂NAT 网关创建DNAT条目

云栖号快速入门:【点击查看更多云产品快速入门】不知道怎么入门?这里分分钟解决新手入门等基础问题,可快速完成产品配置操作! NAT网关支持DNAT功能,将NAT网关上的公网IP映射给ECS实例使用,使ECS实例能够提供互联网服务。DNAT支持端口映射和IP映射。 背景信息 如果您的ECS实例已经绑定了EIP,则不支持为该ECS实例添加DNAT条目。如需为该ECS实例添加DNAT条目,请先将ECS实例与EIP解绑。解绑后,再为该ECS实例添加DNAT条目。详细信息,请参见解绑EIP和创建DNAT条目。 操作步骤 1.登录NAT网关管理控制台。2.在顶部菜单栏处,选择NAT网关的地域。3.在NAT网关页面,找到目标NAT网关实例,单击操作列下的设置DNAT。4.在DNAT列表页签下,单击创建DNAT条目。5.在创建DNAT条目对话框,根据以下信息配置DNAT条目,然后单击确定。 本文来自 阿里云文档中心 NAT 网关创建 DNAT条目 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK

优秀的个人博客,低调大师

一文学会Redis,就是这么简单

直播:近二十载从业老兵谈金融科技赋能的探索与实践 Redis是一个开源的使用ANSI C语言编写、支持网络、可基于内存亦可持久化的日志型、Key-Value数据库,并提供多种语言的API。从2010年3月15日起,Redis的开发工作由VMware主持。从2013年5月开始,Redis的开发由Pivotal赞助。 Redis特性 Redis支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。 Redis不仅仅支持简单的key-value类型的数据,同时还把value分为list,set,zset,hash等数据结构存储。 因为Redis交换数据快,所以在服务器中常用来存储一些需要频繁调取的数据,提高效率。 Redis数据模型 Redis支持五种数据类型:string(字符串),hash(哈希),list(列表),set(集合)及zset(sorted set:有序集合)。 String ------> 字符串 Hash ------> 哈希 List ------> 列表 set ------> 集合 Zset ------> 有序集合 Redis基本使用 连接redis:redis-cli 退出:exit 操作服务端:service redis start/stop/restart 切换数据库:select n Redis五大数据类型使用 1.全局key操作 对5 个数据类型都使用的命令 查看所有的key:keys* 删除键值对:delkey 改名:renamekeynew_key 设置过期时间:expirekeyseconds 2.String类型 strings是redis最基本的数据类型,一个key对应一个value 设置数据:setkeyvalue 查看数据:getkey 追加数据:appendkeyvalue 删除数据:delkey; 3.List类型 添加数据:rpushkeyvalue[value…] lpushkeyvalue[value…]头部添加数据 查看数据:lrangekeystartstop lindexkeyindex查看某个数据 修改数据:lsetkeyindexvalue 删除数据:rpopkey lpopkey头部删除数据 4.Hash类型 添加数据:hsetkeyfieldvalue 查看域值:hgetkeyfield hgetallkey查看所有的field和value 查看所有的value:hvalskey 查看所有的field:hkeyskey 5.Set类型 添加数据:saddkeymember[member…] 查看数据:smemberskey 随机删除:spopkey 指定删除:sremkeymember[member…] 6.Sorted Set类型 添加数据:zaddkeyscoremember[score2member2…] 查看数据:zrangekeystartstop zrangebyscorekeyminmax通过scores值查看 删除数据:zremkeymember[member…] 通过索引删除多个数据:zremrangebyrankkeyminmax zremrangebyscorekeyminmax--通过scores值删除 flushall 删除所有数据

优秀的个人博客,低调大师

一文带你了解JavaScript函数式编程

摘要: 函数式编程入门。 作者:浪里行舟 Fundebug经授权转载,版权归原作者所有。 前言 函数式编程在前端已经成为了一个非常热门的话题。在最近几年里,我们看到非常多的应用程序代码库里大量使用着函数式编程思想。 本文将略去那些晦涩难懂的概念介绍,重点展示在 JavaScript 中到底什么是函数式的代码、声明式与命令式代码的区别、以及常见的函数式模型都有哪些?想阅读更多优质文章请猛戳GitHub博客。 一、什么是函数式编程 函数式编程是一种编程范式,主要是利用函数把运算过程封装起来,通过组合各种函数来计算结果。函数式编程意味着你可以在更短的时间内编写具有更少错误的代码。举个简单的例子,假设我们要把字符串 functional programming is great 变成每个单词首字母大写,我们可以这样实现: var string = 'functional programming is great'; var result = string .split(' ') .map(v => v.slice(0, 1).toUpperCase() + v.slice(1)) .join(' '); 上面的例子先用 split 把字符串转换数组,然后再通过 map 把各元素的首字母转换成大写,最后通过 join 把数组转换成字符串。 整个过程就是 join(map(split(str))),体现了函数式编程的核心思想: 通过函数对数据进行转换。 由此我们可以得到,函数式编程有两个基本特点: 通过函数来对数据进行转换 通过串联多个函数来求结果 二、对比声明式与命令式 命令式:我们通过编写一条又一条指令去让计算机执行一些动作,这其中一般都会涉及到很多繁杂的细节。命令式代码中频繁使用语句,来完成某个行为。比如 for、if、switch、throw 等这些语句。 声明式:我们通过写表达式的方式来声明我们想干什么,而不是通过一步一步的指示。表达式通常是某些函数调用的复合、一些值和操作符,用来计算出结果值。 //命令式 var CEOs = []; for(var i = 0; i < companies.length; i++){ CEOs.push(companies[i].CEO) } //声明式 var CEOs = companies.map(c => c.CEO); 从上面的例子中,我们可以看到声明式的写法是一个表达式,无需关心如何进行计数器迭代,返回的数组如何收集,它指明的是做什么,而不是怎么做。函数式编程的一个明显的好处就是这种声明式的代码,对于无副作用的纯函数,我们完全可以不考虑函数内部是如何实现的,专注于编写业务代码。 三、常见特性 无副作用 指调用函数时不会修改外部状态,即一个函数调用 n 次后依然返回同样的结果。 var a = 1; // 含有副作用,它修改了外部变量 a // 多次调用结果不一样 function test1() { a++ return a; } // 无副作用,没有修改外部状态 // 多次调用结果一样 function test2(a) { return a + 1; } 透明引用 指一个函数只会用到传递给它的变量以及自己内部创建的变量,不会使用到其他变量。 var a = 1; var b = 2; // 函数内部使用的变量并不属于它的作用域 function test1() { return a + b; } // 函数内部使用的变量是显式传递进去的 function test2(a, b) { return a + b; } 不可变变量 指的是一个变量一旦创建后,就不能再进行修改,任何修改都会生成一个新的变量。使用不可变变量最大的好处是线程安全。多个线程可以同时访问同一个不可变变量,让并行变得更容易实现。 由于 JavaScript 原生不支持不可变变量,需要通过第三方库来实现。 (如 Immutable.js,Mori 等等) var obj = Immutable({ a: 1 }); var obj2 = obj.set('a', 2); console.log(obj); // Immutable({ a: 1 }) console.log(obj2); // Immutable({ a: 2 }) 函数是一等公民 我们常说函数是JavaScript的"第一等公民",指的是函数与其他数据类型一样,处于平等地位,可以赋值给其他变量,也可以作为参数,传入另一个函数,或者作为别的函数的返回值。下文将要介绍的闭包、高阶函数、函数柯里化和函数组合都是围绕这一特性的应用 四、常见的函数式编程模型 1. 闭包(Closure) 如果一个函数引用了自由变量,那么该函数就是一个闭包。何谓自由变量?自由变量是指不属于该函数作用域的变量(所有全局变量都是自由变量,严格来说引用了全局变量的函数都是闭包,但这种闭包并没有什么用,通常情况下我们说的闭包是指函数内部的函数)。 闭包的形成条件: 存在内、外两层函数 内层函数对外层函数的局部变量进行了引用 闭包的用途: 可以定义一些作用域局限的持久化变量,这些变量可以用来做缓存或者计算的中间量等。 // 简单的缓存工具 // 匿名函数创造了一个闭包 const cache = (function() { const store = {}; return { get(key) { return store[key]; }, set(key, val) { store[key] = val; } } }()); console.log(cache) //{get: ƒ, set: ƒ} cache.set('a', 1); cache.get('a'); // 1 上面例子是一个简单的缓存工具的实现,匿名函数创造了一个闭包,使得 store 对象 ,一直可以被引用,不会被回收。 闭包的弊端:持久化变量不会被正常释放,持续占用内存空间,很容易造成内存浪费,所以一般需要一些额外手动的清理机制。 2. 高阶函数 函数式编程倾向于复用一组通用的函数功能来处理数据,它通过使用高阶函数来实现。高阶函数指的是一个函数以函数为参数,或以函数为返回值,或者既以函数为参数又以函数为返回值。 高阶函数经常用于: 抽象或隔离行为、作用,异步控制流程作为回调函数,promises,monads等 创建可以泛用于各种数据类型的功能 部分应用于函数参数(偏函数应用)或创建一个柯里化的函数,用于复用或函数复合。 接受一个函数列表并返回一些由这个列表中的函数组成的复合函数。 JavaScript 语言是原生支持高阶函数的, 例如Array.prototype.map,Array.prototype.filter 和 Array.prototype.reduce 是JavaScript中内置的一些高阶函数,使用高阶函数会让我们的代码更清晰简洁。 map map() 方法创建一个新数组,其结果是该数组中的每个元素都调用一个提供的函数后返回的结果。map 不会改变原数组。 假设我们有一个包含名称和种类属性的对象数组,我们想要这个数组中所有名称属性放在一个新数组中,如何实现呢? // 不使用高阶函数 var animals = [ { name: "Fluffykins", species: "rabbit" }, { name: "Caro", species: "dog" }, { name: "Hamilton", species: "dog" }, { name: "Harold", species: "fish" }, { name: "Ursula", species: "cat" }, { name: "Jimmy", species: "fish" } ]; var names = []; for (let i = 0; i < animals.length; i++) { names.push(animals[i].name); } console.log(names); //["Fluffykins", "Caro", "Hamilton", "Harold", "Ursula", "Jimmy"] // 使用高阶函数 var animals = [ { name: "Fluffykins", species: "rabbit" }, { name: "Caro", species: "dog" }, { name: "Hamilton", species: "dog" }, { name: "Harold", species: "fish" }, { name: "Ursula", species: "cat" }, { name: "Jimmy", species: "fish" } ]; var names = animals.map(x=>x.name); console.log(names); //["Fluffykins", "Caro", "Hamilton", "Harold", "Ursula", "Jimmy"] filter filter() 方法会创建一个新数组,其中包含所有通过回调函数测试的元素。filter 为数组中的每个元素调用一次 callback 函数, callback 函数返回 true 表示该元素通过测试,保留该元素,false 则不保留。filter 不会改变原数组,它返回过滤后的新数组。 假设我们有一个包含名称和种类属性的对象数组。 我们想要创建一个只包含狗(species: "dog")的数组。如何实现呢? // 不使用高阶函数 var animals = [ { name: "Fluffykins", species: "rabbit" }, { name: "Caro", species: "dog" }, { name: "Hamilton", species: "dog" }, { name: "Harold", species: "fish" }, { name: "Ursula", species: "cat" }, { name: "Jimmy", species: "fish" } ]; var dogs = []; for (var i = 0; i < animals.length; i++) { if (animals[i].species === "dog") dogs.push(animals[i]); } console.log(dogs); // 使用高阶函数 var animals = [ { name: "Fluffykins", species: "rabbit" }, { name: "Caro", species: "dog" }, { name: "Hamilton", species: "dog" }, { name: "Harold", species: "fish" }, { name: "Ursula", species: "cat" }, { name: "Jimmy", species: "fish" } ]; var dogs = animals.filter(x => x.species === "dog"); console.log(dogs); // {name: "Caro", species: "dog"} // { name: "Hamilton", species: "dog" } reduce reduce 方法对调用数组的每个元素执行回调函数,最后生成一个单一的值并返回。 reduce 方法接受两个参数:1)reducer 函数(回调),2)一个可选的 initialValue。 假设我们要对一个数组的求和: // 不使用高阶函数 const arr = [5, 7, 1, 8, 4]; let sum = 0; for (let i = 0; i < arr.length; i++) { sum = sum + arr[i]; } console.log(sum);//25 // 使用高阶函数 const arr = [5, 7, 1, 8, 4]; const sum = arr.reduce((accumulator, currentValue) => accumulator + currentValue,0); console.log(sum)//25 我们可以通过下图,形象生动展示三者的区别: 3. 函数柯里化 柯里化又称部分求值,柯里化函数会接收一些参数,然后不会立即求值,而是继续返回一个新函数,将传入的参数通过闭包的形式保存,等到被真正求值的时候,再一次性把所有传入的参数进行求值。 // 普通函数 function add(x,y){ return x + y; } add(1,2); // 3 // 函数柯里化 var add = function(x) { return function(y) { return x + y; }; }; var increment = add(1); increment(2);// 3 这里我们定义了一个 add 函数,它接受一个参数并返回一个新的函数。调用 add 之后,返回的函数就通过闭包的方式记住了 add 的第一个参数。那么,我们如何来实现一个简易的柯里化函数呢? function curryIt(fn) { // 参数fn函数的参数个数 var n = fn.length; var args = []; return function(arg) { args.push(arg); if (args.length < n) { return arguments.callee; // 返回这个函数的引用 } else { return fn.apply(this, args); } }; } function add(a, b, c) { return [a, b, c]; } var c = curryIt(add); var c1 = c(1); var c2 = c1(2); var c3 = c2(3); console.log(c3); //[1, 2, 3] 由此我们可以看出,柯里化是一种“预加载”函数的方法,通过传递较少的参数,得到一个已经记住了这些参数的新函数,某种意义上讲,这是一种对参数的“缓存”,是一种非常高效的编写函数的方法! 4. 函数组合 (Composition) 前面提到过,函数式编程的一个特点是通过串联函数来求值。然而,随着串联函数数量的增多,代码的可读性就会不断下降。函数组合就是用来解决这个问题的方法。 假设有一个 compose 函数,它可以接受多个函数作为参数,然后返回一个新的函数。当我们为这个新函数传递参数时,该参数就会「流」过其中的函数,最后返回结果。 //两个函数的组合 var compose = function(f, g) { return function(x) { return f(g(x)); }; }; //或者 var compose = (f, g) => (x => f(g(x))); var add1 = x => x + 1; var mul5 = x => x * 5; compose(mul5, add1)(2);// =>15 给大家推荐一个好用的BUG监控工具Fundebug,欢迎免费试用! 参考文章 MDN文档 What is Functional Programming? So You Want to be a Functional Programmer 理解 JavaScript 中的高阶函数 我所了解的函数式编程 JS函数式编程指南 JavaScript函数式编程(一) 我眼中的 JavaScript 函数式编程 JavaScript深入浅出第2课:函数是一等公民是什么意思呢? 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java线上应用实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了20亿+错误事件,付费客户有阳光保险、核桃编程、荔枝FM、掌门1对1、微脉、青团社等众多品牌企业。欢迎大家免费试用!

优秀的个人博客,低调大师

一文了解 Apache Flink 核心技术

作者:伍翀 Apache Flink 介绍 Apache Flink (以下简称Flink)是近年来越来越流行的一款开源大数据计算引擎,它同时支持了批处理和流处理,也能用来做一些基于事件的应用。使用官网的语句来介绍 Flink 就是 "Stateful Computations Over Streams"。 首先 Flink 是一个纯流式的计算引擎,它的基本数据模型是数据流。流可以是无边界的无限流,即一般意义上的流处理。也可以是有边界的有限流,这样就是批处理。因此 Flink 用一套架构同时支持了流处理和批处理。其次,Flink 的一个优势是支持有状态的计算。如果处理一个事件(或一条数据)的结果只跟事件本身的内容有关,称为无状态处理;反之结果还和之前处理过的事件有关,称为有状态处理。稍微复杂一点的数据处理,比如说基本的聚合,数据流之间的

优秀的个人博客,低调大师

一文搞懂域名解析相关问题

本文希望通过一篇文章解决所有域名解析中相关的问题 Linux下域名解析流程 DNS域名解析的时候先根据 /etc/nsswitch.conf 配置的顺序进行dns解析(name service switch),一般是这样配置:hosts: files dns 【files代表 /etc/hosts ; dns 代表 /etc/resolv.conf】(ping是这个流程,但是nslookup和dig不是) 如果本地有DNS Client Cache,先走Cache查询,所以有时候看不到DNS网络包。Linux下nscd可以做这个cache,Windows下有 ipconfig /displaydns ipconfig /flushdns 如果 /etc/resolv.conf 中配置了多个nameserver,默认使用第一个,只有第一个失

优秀的个人博客,低调大师

一文带你看透kubernetes 容器编排系统

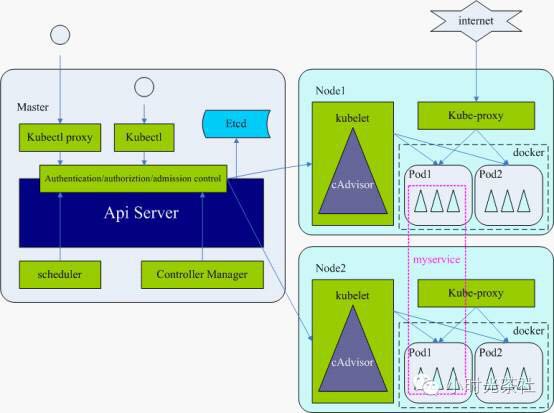
本文由云+社区发表 作者:turboxu Kubernetes作为容器编排生态圈中重要一员,是Google大规模容器管理系统borg的开源版本实现,吸收借鉴了google过去十年间在生产环境上所学到的经验与教训。 Kubernetes提供应用部署、维护、 扩展机制等功能,利用Kubernetes能方便地管理跨机器运行容器化的应用。当前Kubernetes支持GCE、vShpere、CoreOS、OpenShift、Azure等平台,除此之外,也可以直接运行在物理机上.kubernetes是一个开放的容器调度管理平台,不限定任何一种言语,支持java/C++/go/python等各类应用程序 。 kubernetes是一个完备的分布式系统支持平台,支持多层安全防护、准入机制、多租户应用支撑、透明的服务注册、服务发现、内建负载均衡、强大的故障发现和自我修复机制、服务滚动升级和在线扩容、可扩展的资源自动调度机制、多粒度的资源配额管理能力,完善的管理工具,包括开发、测试、部署、运维监控,一站式的完备的分布式系统开发和支撑平台。 一. 系统架构 kubernetes系统按节点功能由master和node组成。 Master Master作为控制节点,调度管理整个系统,包含以下组件: API Server作为kubernetes系统的入口,封装了核心对象的增删改查操作,以RESTful接口方式提供给外部客户和内部组件调用。它维护的REST对象将持久化到etcd。 Scheduler:负责集群的资源调度,为新建的pod分配机器。这部分工作分出来变成一个组件,意味着可以很方便地替换成其他的调度器。 Controller Manager:负责执行各种控制器,目前有两类: Endpoint Controller:定期关联service和pod(关联信息由endpoint对象维护),保证service到pod的映射总是最新的。 Replication Controller:定期关联replicationController和pod,保证replicationController定义的复制数量与实际运行pod的数量总是一致的。 Node Node是运行节点,运行业务容器,包含以下组件: Kubelet:责管控docker容器,如启动/停止、监控运行状态等。它会定期从etcd获取分配到本机的pod,并根据pod信息启动或停止相应的容器。同时,它也会接收apiserver的HTTP请求,汇报pod的运行状态。 Kube Proxy:负责为pod提供代理。它会定期从etcd获取所有的service,并根据service信息创建代理。当某个客户pod要访问其他pod时,访问请求会经过本机proxy做转发。 借用一张网图,表达功能组件之间关系: 二.基本概念 Node node是kubernetes集群中相对于master而言的工作主机,在较早版本中也被称为minion。Node可以是一台物理主机,也可以是一台虚拟机(VM)。在每个node上运行用于启动和管理pod的服务——kubelet,并能够被master管理。在node上运行的服务进程包括kubelet、kube-proxy和docker daemon。 Node的信息如下: node地址:主机的IP地址或者nodeid。 node的运行状态: pending,running,terminated。 node condition: 描述running状态node的运行条件,目前只有一种条件Ready,表示node处于健康状态,可以接收master发来的创建pod的指令。 node系统容量:描述node可用的系统资源,包括CPU、内存、最大可调度pod数量等。 Pod pod 是 kubernetes 的最基本操作单元,包括一个或多个紧密相关的容器,一个 pod 可以被一个容器化的环境看作应用层的“逻辑宿主机”( Logical host )。一个 pod 中的多个容器应用通常是紧耦合的。Pod 在 node 上被创建、启动或者销毁。 为什么 kubernetes 使用 pod 在容器之上再封装一层呢?一个很重要的原因是,docker 容器之间通信受到 docker 网络机制的限制。在 docker 的,世界中,一个容器需要通过 link 方式才能访问另一个容器提供的服务(端口)。大量容器之间的 link 将是一个非常繁重的工作。通过 pod 的概念将多个容器组合在一个虚拟的“主机”内,可以实现容器之间仅需通过 localhost 就能相互通信了。 一个pod中的应用容器共享一组资源,如: pid命名空间:pod中的不同应用程序可以看到其他的进程PID 网络命名空间:pod中的多个容器能够访问同一个IP和端口范围 IPC命名空间:pod中的多个容器能够使用systemV ipc 或POSIX消息队列进行通信。 UTS命名空间:pod中的多个容器共享一个主机名。 Volumes(共享存储卷):pod中的各个容器可以访问在pod级别定义的volumes。 Label label是kubernetes系统中的一个核心概念。Label以key/value键值对的形式附加到各种对象上,如pod、service、RC、Node等。Label定义了这些对象的可识别属性,用来对它们进行管理和选择。Label可以在创建对象时附加到对象上,也可以在对象创建后通过API进行管理。 在为对象定义好label后,其他对象就可以使用label selector来定义其他作用的对象了。 label selector的定义由多个逗号分隔的条件组成: “label”: { “key1”: ”value1”, “key2”: ”value2” } Resource controller(RC) Resource controller(RC)是kubernetes系统中的核心概念,用于定义pod副本的数量。在master的Controller manager进程通过RC的定义来完成pod的创建、监控、启停等操作。 根据replication controller的定义,kubernetes能够确保在任意时刻都能运行用户指定的pod“副本”(replica)数量。如果有过多的的pod副本在运行,系统会停掉一些pod;如果运行的pod副本数量太少,系统就会再启动一些pod,总之,通过RC的定义,kubernetes总是保证集群中运行着用户期望副本数量。 Service(服务) 在kubernetes的世界里,虽然每个pod都会被分配一个单独的IP地址,但这个IP地址会随着pod的销毁而消失。这就引出一个问题:如果有一组pod组成一个集群来提供服务,那么如何来访问它们呢? kubernetes的service就是用来解决这个问题的核心概念。一个service可以看作一组提供相同服务的pod的对外访问接口。Service作用于哪些pod是通过label selector 来定义的。 pod的IP地址是docker daemon根据docker0网桥的IP地址段进行分配的,但service的Cluster IP地址是kubernetes系统中的虚拟IP地址,由系统动态分配。 Service的ClusterIP地址相对于pod的IP地址来说相对稳定,service被创建时即被分配IP地址,在销毁该service之前,这个IP地址都不会再变化。 由于service对象在Cluster IP Range池中分配到的IP只能在内部访问,所以其他pod都可以无障碍地访问到它。但如果这个service作为前端服务,准备为集群外的客户端提供服务,我们就需要给这个服务提供公共IP了。 kubernetes支持两种对外提供服务的service的type定义:nodeport和loadbalancer。 Volume(存储卷) volume是pod中能够被多个容器访问的共享目录。Kubernetes的volume概念与docker的volume比较类似,但并不完全相同。Kubernetes中的volume与pod生命周期相同,但与容器的生命周期不相关。当容器终止或重启时,volume中的数据也不会丢失。另外,kubernetes支持多种类型的volume,并且一个pod可以同时使用任意多个volume。 (1)EmptyDir:一个EmptyDir volume是在pod分配到Node时创建的。从它的名称就可以看出,它的初始内容为空。在同一个pod中所有容器可以读和写EmptyDir中的相同文件。当pod从node上移除时,EmptyDir中的数据也会永久删除。 (2)hostPath:在pod上挂载宿主机上的文件或目录。通常用于: 容器应用程序生成的日志文件需要永久保存,可以使用宿主机的高速文件系统进行存储; 需要访问宿主机上的docker引擎内部数据结构的容器应用,可以通过定义hostPath为宿主机/var/lib/docker目录,使容器内部应用可以直接访问docker的文件系统。 (3)gcePersistentDick:使用这种类型的volume表示使用谷歌计算引擎(Google Compute Engine, GCE)上永久磁盘(persistent disk,PD)上的文件。与EmptyDir不同,PD上的内容会永久保存,当pod被删除时,PD只是被卸载(unmount),但不会被删除。需要注意的是,你需要先创建一个永久磁盘(PD)才能使用gcePersistentDisk。 (4)awsElasticBlockStore:与GCE类似,该类型的volume使用Amazon提供的Amazon Web Service(AWS)的EBS Volume,并可以挂载到pod中去。需要注意的是,需要先创建一个EBS Volume才能使用awsElasticBlockStore。 (5)nfs:使用NFS(网络文件系统)提供的共享目录挂载到Pod中。在系统中需要一个支行中的NFS系统。 (6)iscsi:使用iSCSI存储设备上的目录挂载到pod中。 (7)glusterfs:使用开源BlusterFS网络文件系统的目录挂载到pod中。 (8)rbd:使用Linux块设备共享存储(Rados Block Device)挂载到pod中。 (9)gitRepo:通过挂载一个空目录,并从GIT库clone一个git repository以供pod使用。 (10)secret:一个secret volume用于为pod提供加密的信息,你可以将定义在kubernetes中的secret直接挂载为文件让pod访问。Secret volume是通过tmfs(内存文件系统)实现的,所以这种类型的volume总是不会持久化的。 (11)persistentVolumeClaim:从PV(persistentVolume)中申请所需的空间,PV通常是种网络存储,如GCEPersistentDisk、AWSElasticBlockStore、NFS、iSCSI等。 Namespace(命名空间) namespace(命名空间)是kubernetes系统中另一个非常重要的概念,通过将系统内部的对象“分配”到不同的namespace中,形成逻辑上分组的不同项目、小组或用户组,便于不同的分组在共享使用整个集群的资源的同时还能分别管理。 kubernetes集群在启动后,会创建一个名为“default”的namespace。接下来,如果不特别指明namespace,则用户创建的pod、RC、Service都将被系统创建到名为“default”的namespace中。 使用namespace来组织kubernetes的各种对象,可以实现对用户的分组,即“多租户”管理。对不同的租房还可以进行单独的资源配额设备和管理,使得整个集群配置非常灵活、方便。 Annotation(注解) annotation与label类似,也使用key/value键值对的形式进行定义。Label具有严格的全名规则,它定义的是kubernetes对象的元数据(metadata),并且用于label selector。Annotation则是用户任意定义的“附加”信息,以便于外部工具进行查找。 用annotation来记录的信息包括: build信息、release信息、docker镜像信息等,如时间戳、release id号、PR号、镜像hash值、docker Controller地址等。 典型流程 以创建一个Pod为例,kubernetes典型的流程如下图所示: 三.组件 Replication Controller 为了区分Controller Manager中的Replication Controller(副本控制器)和资源对象Replication Controller,我们将资源对象简写为RC,而Replication Controller特指“副本控制器”。 Replication Controller的核心作用是确保在任何时间集群中一个RC所关联的pod都保持一定数量的pod副本处于正常运行状态。如果该类pod的pod副本数量太多,则Replication Controller会销毁一些pod副本;反之Replication Controller会添加pod副本,直到该类pod的pod副本数量达到预设的副本数量。最好不要超过RC直接创建pod,因为Replication Controller会通过RC管理pod副本,实现自动创建、补足、替换、删除pod副本,这样就能提高系统的容灾能力,减少由于节点崩溃等意外状况造成的损失。即使应用程序只用到一个pod副本,也强烈建设使用RC来定义pod。 Replication Controller管理的对象是pod,因此其操作与pod的状态及重启策略息息相关。 副本控制器的常用使用模式: (1)重新调度:不管想运行1个副本还是1000副本,副本控制器能够确保指定pod数量的副本存在于集群中,如果节点故障或副本被终止运行等意外情况,将会重新调度直到达到预期的副本正常运行。 (2)弹性伸缩:手动或通过自动扩容代理修改副本控制器的spec.replicas属性值,非常容易实现扩大或缩小副本的数量。 (3)滚动更新:副本控制器被设计成通过逐个替换pod的方式来辅助服务的滚动更新。推荐的方式是创建一个新的只有一个副本的RC,若新的RC副本数量加1,则旧的RC的副本数量减1,直到这个旧的RC副本数量为零,然后删除该旧的RC。 在滚动更新的讨论中,我们发现一个应用在滚动更新时,可能存在多个版本的release。事实上,在生产环境中一个已经发布的应用程序存在多个release版本是很正常的现象。通过RC的标签选择器,我们能很方便地实现对一个应用的多版本release的跟踪。 node controller Node Controller负责发现、管理和监控集群中的各个node节点。Kubelet在启动时通过API Server注册节点信息,并定时向API Server发送节点信息。API Server接收到这些信息后,将这些信息写入etcd。存入etcd的节点信息包括节点健康状况、节点资源、节点名称、节点地址信息、操作系统版本、docker版本、kubelet版本等。节点健康状况包含“就绪(true)”、“未就绪(false)”和“未知(unknown)”三种。 (1)Controller Manager 在启动时如果设置了—cluster-cidr参数,那么为每个没有设置spec.podCIDR的node生成一个CIDR地址,并用该CIDR设置节点的spec.PodCIDR属性,这样的目的是防止不同节点的CIDR地址发生冲突。 (2)逐个读取节点的信息,多次尝试修改nodeStatusMap中的节点状态信息,将该节点信息和node controller的nodeStatusMap中保存的节点信息比较。如果判断中没有收到kubelet发送的节点信息、第一次收到节点kubelet发送的节点信息,或在该处理过程中节点状态变成非“健康”状态,则在nodeStatusMap中保存该节点的状态信息,并用node controller所在节点的系统时间作为探测时间和节点状态变化时间。 如果判断出在某一段时间内没有收到节点的状态信息,则设置节点状态为“未知(unknown)”,并且通过api server保存节点状态。 (3)逐个读取节点信息,如果节点状态变为非“就绪”状态,则将节点加入待删除队列,否则将节点从该队列中删除。如果节点状态为非“就绪”状态,且系统指定了Cloud Provider,则node controller调用Cloud Provider查看节点,若发现并节点故障,则删除etcd中的节点信息,并删除和该节点相关的pod等资源的信息。 ResourceQuota controller 作为容器集群的管理平台, kubernetes也提供了资源配额管理这一高级功能,资源配额管理确保指定的对象在任何时候都不会超量占用系统资源,避免了由于某些业务进程的设计或实现的缺陷导致整个系统运行紊乱甚至意外宕机,对整个集群的平稳运行和稳定性有非常重要的作用。 目前kubernetes支持三个层次的资源配额管理: (1)容器级别,可以对CPU和内存的资源配额管理。 (2)pod级别,可以对pod内所有容器的可用资源进行限制。 (3)namespace级别,为namespace(可以用于多租户)级别的资源限制,包括:pod数量、replication Controller数量、service数量、ResourceQuota数量、secret数量、可持有的PV(persistent volume)数量。 kubernetes的配额管理是通过准入机制(admission control)来实现的,与配额相关的两种准入控制器是LimitRanger和ResoureQuota,其中LimitRanger作用于pod和container上,ResourceQuota则作用于namespace上。此外,如果定义了资源配额,则scheduler在pod调度过程中也会考虑这一因素,确保pod调度不会超出配额限制。 典型的资源控制流程如下图所示: namaspace controller 用户通过API Server可以创建新的namespace并保存在etcd中,namespace controller定时通过api server读取这些namespace信息。如果namespace被API标识为优雅删除(设置删除期限,deletionTimestamp属性被设置),则将该namespace的状态设置为“terminating”并保存到etcd中。同时namespace controller删除该namespace下的serviceAccount、RC、Pod、Secret、PersistentVolume、ListRange、SesourceQuota和event等资源对象。 当namespace的状态被设置为“terminating”后,由Adminssion Controller的NamespaceLifecycle插件来阻止为该namespace创建新的资源。同时,在namespace controller删除完该namespace中的所有资源对象后,Namespace Controller对该namespace执行finalize操作,删除namespace的spec.finalizers域中的信息。 如果Namespace Controller观察到namespace设置了删除期限(即DeletionTimestamp属性被设置),同时namespacer 的spec.finalizers域值是空的,那么namespace controller将通过API Server删除该namespace资源。 kubernetes安全控制 ServiceAccount Controller和token Controller是与安全相关的两个控制器。ServiceAccount Controller在Controller Manager启动时被创建。它监听Service Account的删除事件和Namespace的创建、修改事件。如果在该Service Account的namespace中没有default Service Account,那么ServiceAccount Controller为该Service Account的namespace创建一个default ServiceAccount。 在API Server的启动中添加“—admission_control=ServiceAccount”后,API Server在启动时会自己创建一个key和crt(/var/run/kubernetes/apiserver.crt和apiserver.key),然后在启动./kube-controller-manager时添加参数service_account_privatge_key_file=/var/run/kubernetes/apiserver.key,这样启动kubernetes master后,就会发现在创建Service Account时系统会自动为其创建一个secret。 如果Controller Manager在启动时指定参数为service-account-private-key-file,而且该参数所指定的文件包含一个PEM-encoded的编码的RSA算法的私钥,那么,Controler Manager会创建token controller对象。 Token controller token controller对象监听Service Account的创建、修改和删除事件,并根据事件的不同做不同的处理。如果监听到的事件是创建和修改Service Account事件,则读取该Service Account的信息;如果该Service Account没有Service Account Secret(即用于访问Api server的secret),则用前面提及的私钥为该Service Account创建一个JWT Token,将该Token和ROOT CA(如果启动时参数指定了该 ROOT CA)放入新建的secret中,将该新建的secret放入该Service Account中,同时修改etcd中Service Account的内容。如果监听到的事件是删除Service Account事件,则删除与该Service Account相关的secret。 token controller对象同时监听secret的创建、修改和删除事件,并根据事件的不同做不同的处理。如果监听到的事件是创建和修改secret事件,那么读取该secret中annotation所指定的Service Account信息,并根据需要为该secret创建一个和其Service Account相关的token;如果监听到的事件是删除secret事件,则删除secret和相关的Service Account的引用关系。 service controller&endpoint controller Kubernetes service是一个定义pod集合的抽象,或者被访问都看作一个访问策略,有时也被称为微服务。 kubernetes中的service是种资源对象,各所有其他资源对象一样,可以通过API Server的POST接口创建一个新的实例。在下面的例子代码中创建了一个名为“MyServer”的Service,它包含一个标签选择器,通过该标签选择器选择所有包含标签为“app=MyApp”的pod作为该service的pod集合。Pod集合中的每个pod的80端口被映射到节点本地的9376端口,同时kubernetes指派一个集群IP(即虚拟IP)给该service。 { “kind”: ”service”, “apiVersion”: ”v1”, “metadata”: { “name”: ”MyService” }, “spec”: { “selector”: { “app”: ”MyApp” }, “ports”: [ { “protocol”: ”TCP”, “port”: 80, “targetPort”: 9376 } ] }, } 四.功能特性 Service 集群访问流程(服务发现) 在kubernetes集群中的每个node上都运行着一个叫“kube-proxy”的进程,该进程会观察master节点添加和删除“service”和“endpoint”的行为,如图中第1步所示。 kube-proxy为每个service在本地主机上开一个端口(随机选择)。任何访问该端口的连接都被代理到相应的一个后端pod上。Kube-proxy根据round robin算法及service的session粘连(SessionAffinity)决定哪个后台pod被选中,如第2步所示。 最后,如第3步所示,kube-proxy在本机的iptables中安装相应的规则,这些规则使得iptables将捕获的流量重定向到前面提及的随机端口。通过该端口流量再被kube-proxy转到相应的后端pod上。 在创建了服务后,服务endpoint模型会创建后端pod的IP和端口列表(包含中endpoint对象中),kube-proxy就是从这个endpoint列表中选择服务后端的。集群内的节点通过虚拟IP和端口能够访问service后台的pod。 在默认情况下,kubernetes会为server指定一个集群IP(或虚拟IP、cluster IP),但在某些情况下,希望能够自己指定该集群IP。为了给service指定集群IP,用户只需要在定义service时,在service的spec.clusterIP域中设置所需要的IP地址即可。 Scheduler(调度) scheduler在整个kubernetes系统中承担了“承上启下”的重要功能,“承上”是指它负责接收Controller Manager创建的新pod,为其安排一个落脚的“家”——目标node;“启下”是指安置工作完成后,目标node上的kubelet服务进程接管后继工作,负责pod生命周期中的“下半生”。 具体来说,scheduler的作用是将待调度的pod(API新创建的Pod、Controller Manager为补足副本而创建的pod等)按照特定的调度算法和调度策略绑定(binding)到集群中的某个合适的node上,并将绑定信息写入etcd中。在整个调度过程中涉及三个对象,分别是:待调度的pod列表、可用node列表、以及调度算法和策略。简单地说,就是通过调度算法调度,为待调度pod列表中的每个pod从node列表中选择一个最适合的node。 随后,目标node上的kublet通过API Server监听到scheduler产生的pod绑定事件,然后获对应的取pod,下载image镜像,并启动容器。 Scheduler(调度策略) scheduler当前提供的默认调度流程分为两步: (1)预选调度过程,即遍历所有目标node,筛选出符合要求的候选节点。为此kubernetes内置了多种预先策略(xxx predicates)供用户选择。 (2)确定最优节点,在第一步的基础上,采用优先策略(xxx priority)计算出每个候选节点的积分,积分最高都胜出。 scheduler的调度流程是通过插件方式加载的“调度算法提供者(AlgorithmProvider)”具体实现的。一个AlgorithmProvider其实就是包括了一组预选策略与一组优选策略的结构体,注册AlgorithmProvider的函数如下: func RegisterAlgorithmProvider(name string, predicateKeys, priorityKeys util.StringSet) 它包含3个参数,name string 参数为算法名; predicateKeys参数为算法集合用到的预选策略集合 priorityKeys 参数为算法用到的优选策略集合 scheduler 中可用的预选策略包含7个,每个节点只有通过PodFitsPorts、PodFitsResources、NoDiskConflict、PodSelectorMatches、PodFitsHost 5个默认预先策略后,才能初步被选中,进入下一个流程。 每个节点通过优选策略时都会算出一个得分,计算各项得分,最终选出得分值最大的节点作为优选的结果(也是调度算法的结果)。LeastRequestedPriority,选择资源消耗最小节点: (1)计算出所有备选节点上运行的pod和备选pod的CPU占用量totalMilliCPU (2)计算出所有备选节点上运行的pod和备选pod的内存占用量totalMomory (3)计算每个节点的得分,计算规则大致如下: score=int(((nodeCpuCapacity-totalMilliCPU)*10)/nodeCpuCapacity+((nodeMemoryCapacity-totalMemory)*10/nodeMemoryCapacity)/2) CalculateNodeLabelPriority,根据CheckNodeLabelPresence策略打分 BalancedResourceAllocation,选择资源使用最均衡节点 (1)计算出所有备选节点上运行的pod和备选pod的CPU占用量totalMilliCPU (2)计算出所有备选节点上运行的pod和备选pod的内存占用量totalMomory (3)计算每个节点的得分,计算规则大致如下: score=int(10-math.abs(totalMilliCPU/nodeCpuCapacity-totalMemory/nodeMemoryCapacity) * 10) 节点管理 节点管理包含节点的注册、状态上报、Pod管理、容器健康检查、资源监控等部分。 节点注册 在kubernetes集群中,在每个node节点上都会启动一个kubelet服务进程。该进程用于处理master节点下发到本节点的任务,管理pod及pod中的容器。每个kubelet进程会在API Server上注册节点自身信息,定期向master节点汇报节点资源使用情况,并通过cAdvisor监控容器和节点资源。 节点通过设置kubelet的启动参数“—register-node”,来决定是否向API Server注册自己。如果该参数为true,那么kubelet将试着通过API Server注册自己。作为自注册,kubelet启动还包含下列参数: --api-servers,告诉kubelet API Server的位置; --kubeconfig,告诉kubelet在哪儿可以找到用于访问API Server的证书; --cloud-provider,告诉kubelet如何从云服务商(IAAS)那里读取到和自己相关的元数据。 状态上报 kubelet在启动时通过API Server注册节点,并定时向API Server发送节点新消息,API Server在接收到这些信息后,将这些信息写入etcd。通过kubelet的启动参数“—node-status-update-frequency”设置kubelet每隔多少时间向API Server报告节点状态,默认为10秒。 Pod管理 kubelet通过以下几种方式获取自身node上所要运行的pod清单: (1)文件:kubelet启动参数“--config”指定的配置文件目录下的文件。通过—file-check-frequency设置检查该文件目录的时间间隔,默认为20秒。 (2)HTTP端点(URL):通过“—manifest-url”参数设置。通过—http-check-frequency设置检查该HTTP端点的数据时间间隔,默认为20秒。 (3)API Server:kubelet通过API Server监听etcd目录,同步pod清单。 所有以非API Server方式创建的pod都叫作static pod。Kubelet将static pod的状态汇报给API Server,API Server为static pod创建一个mirror pod和其相匹配。Mirror pod的状态将真实反映static pod的状态。当static pod被删除时,与之相对应的mirror pod也会被删除。Kubelet通过API Server client使用watch+list的方式监听“/registry/node/<当前node名称>”和“/registry/pods”目录,将获取的信息同步到本地缓存中。 kubelet监听etcd,所有针对pod的操作将会被kubelet监听到。如果发现有新的绑定到本节点的pod,则按照pod清单的要求创建该pod。如果发现本地的pod被修改,则kubelet会做出相应的修改,如删除pod中的某个容器时,则通过docker client删除该容器。如果发现删除本节点的pod,则删除相应的pod,并通过docker client删除pod中的容器。 kubelet读取监听到的信息,如果是创建和修改pod任务,则做如下处理: (1)为该pod创建一个数据目录。 (2)从API Server读取该pod清单。 (3)为该pod挂载外部卷(Extenal Volume)。 (4)下载pod用到的secret。 (5)检查已经运行在节点中的pod,如果该 pod没有容器或pause容器没有启动,则先停止pod里所有容器进程。如果在pod中有需要删除的容器,则删除这些容器。 (6)用“kubernetes/pause”镜像为每个pod创建一个容器,该pause容器用于接管pod中所有其他容器的网络。 (7)为pod中的每个容器做如下处理: 为容器计算一个hash值,然后用容器的名字去docker查询对应容器的hash值。若查到容器,且两者hash值不同,则停止docker中容器进程,并停止与之关联的pause容器进程;若两者相同不做任何处理。 如果容器被中止了,且容器没有指定的restartPolicy(重启策略),则不做任何处理。 调用docker client下载容器镜像,调用docker client运行容器。 容器健康检查 pod通过两类探针来检查容器的健康状态。一个是LivenessProbe探针,用于判断容器是否健康,告诉kubelet一个容器什么时候处于不健康的状态。如果LivenessProbe探针探测到容器不健康,则kubelet将删除容器,并根据容器的重启策略做相应的处理。如果一个容器不包含LivenessProbe探针,那么kubelet认为该容器的LivenessProbe探针返回的值永远是“success”.另一类是ReadinessProbe探针,用于判断容器是否启动完成,且准备接收请求。如果ReadinessProbe探针检测到失败,则pod的状态将被修改。Endpoint controller将从service的endpoint中删除包含该容器所在pod的IP地址的endpoint条目。 参考 《kubernetes权威指南》 此文已由作者授权腾讯云+社区在各渠道发布 获取更多新鲜技术干货,可以关注我们腾讯云技术社区-云加社区官方号及知乎机构号

优秀的个人博客,低调大师

一文读懂 Java 反射机制那些事

前不久学习了反射机制,来总结下。在此之前,回顾下java程序的编译运行过程,分为三个阶段:源码(.java文件)进过编译生成字节码文件(.class文件),然后jvm加载字节码文件执行程序(runtime)。 前两个步骤(编译阶段)是在硬盘上完成的,后一个步骤(运行阶段)是在内存中完成的,而中间这个衔接就是:jvm通过类加载器----ClassLoader把硬盘中的class文件加载到内存中生成一个Class类的对象,这样就可以使用这个类中的成员变量和方法。一个类默认只会被加载一次,所以这个类对应的Class对象有且仅有一个。 什么是java反射机制? 1983年Smith首次提出反射这个概念,主要指程序可以访问、检测和修改他本身状态或行为的一种能力。 java反射机制是在运行状态中中对类进行解剖并操作类中的构造方法,成员方法,成员属性(主要用于框架中),这种动态获取信息以及动态调用对象的方法的功能称为java语言的反射机制。 Class对象和反射机制的联系。 了解了反射机制的概念,那么可见要想利用java反射机制做一些事,那么就要利用Class对象,所以说Class对象是反射的前提。 那么,怎么获取Class对象? java中有三种方式获取Class对象: ●类名.class ●对象名.gerClass ●Class.forName("全限定名(包名 + 类名)"); 补充:Class对象分两种 1.普通Class对象:基于 引用类型 2.预定义(在jvm中的)Class对象:基于 基本类型 和 void 反射机制的几种作用: ●在运行时判断任意一个对象所属的类 ●在运行时构造任意一个类的对象 ●在运行时判断任意一个类所具有的成员变量和方法 ●在运行时调用任意一个对象的方法 先准备一个类: package com.test.demo; public class Student { public String name; private int age; public Student() { } private Student(String name, int age) { this.name = name; this.age = age; } public void show(String msg){ System.out.println("show方法 = " + msg); } private void speak(String msg,int number){ System.out.println("speak方法 = " + msg +":"+ number ); } @Override public String toString() { return "Student{" + "name='" + name + '\'' + ", age=" + age +'}'; } } 反射的使用1:构造器(Constructor)的反射 再次之前,我们可以通过公共的空参构造new一个Student,但是无法new私有的满参构造。 Student student = new Student(); 现在来反射构造构造器(反射的形式创建实例) public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException, InvocationTargetException, InstantiationException { //获取Class对象 Class<?> clazz = Student.class; /* 根据参数类型获取相应的构造器 参数类型是形参类型 */ Constructor<?> constructor = clazz.getConstructor(); /* 创建实例 参数类型是实参类型(形参一一对应) */ Object obj = constructor.newInstance(); System.out.println("obj = " + obj); } 这样获取到的Student对象和new出来的空参构造器new出来的对象效果一样的(实际业务开发并没有意义)。 前者通过new创建出来对象的方式相比用反射创建的对象更被动,前者 是被new出来的,而用反射,是自己创建自己(对象),构造方法反客为主。 还有一种方式,就是直接通过Class对象创建构造器: public static void main(String[] args) throws IllegalAccessException, InstantiationException { //获取Class对象 Class<?> clazz = Student.class; /* 默认调用空参构造创建一个实例 jdk9中已过时 */ Object obj = clazz.newInstance(); System.out.println("obj = " + obj); } 在Student类中 ,还有一个私有的构造器,正常方式下是不能通过私有构造器创建对象的。,但是反射可以做到: public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException, InvocationTargetException, InstantiationException { //获取Class对象 Class<?> clazz = Student.class; /* 获取构造 因为权限是私有,但getConstructor()只能获取public修饰的方法 getDeclaredConstructor():获取声明的方法。只要声明的就可以 */ Constructor<?> constructor = clazz.getDeclaredConstructor(String.class, int.class); System.out.println("满参私有构造 :" + constructor); /* 私有构造,newInstance会产生非法访问异常:java.lang.IllegalAccessException 所以要改变权限setAccessible() -->暴力反射 */ constructor.setAccessible(true); Object obj = constructor.newInstance("小明",20); System.out.println("obj = " + obj); } 以上就是利用反射来创建一个对象(反射构造器)。 反射的使用2:方法(Method)的反射 接下来看看Student对象内两个方法的反射 我们之前(外部)使用方法,都是都是通过对象调用(非私有)方法,如果是静态方法就是类直接调用。 那么,使用反射调用(非私有)方法,该怎么做? public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException, InvocationTargetException { //获取Class对象 Student student = new Student(); Class<? extends Student> clazz = student.getClass(); /* getMethod():获取Class对象里的方法 参数一:方法名 参数二:参数列表类型 */ Method show = clazz.getMethod("show", String.class); /* 调用show方法需要对象和参数 invoke()方法:调用的意思 参数一:调用此方法的对象 参数二:调用此方法需要传入的实参 */ show.invoke(student, "hello public show"); } 反射可以理解为语言语法上的倒装句: 我们平时写代码都是我(对象)去调用方法,这里就是: new Student().show("对象调用方法"); 而在 show.invoke(student, "hello public show"); 中, show方法考虑的是谁来调用我,然后Student对象说,我来调用你(student作为参数)。 扩展:如果公共的show方法加上static关键字,会影响方法调用吗? 提示:静态与对象无关. 答:加上static关键字,普通代码即使不new对象也可以调用,这个大家都知道,那么,在show.invoke(student, "hello public show"); 中参数1 写 null 也是不影响的,因为,show方法来自于 Student的Class对象。 接下来看看私有方法的反射如何实现? ps: 反射通道的API都很有规律,可读性很强 public static void main(String[] args) throws NoSuchMethodException, IllegalAccessException, InvocationTargetException { //获取Class对象 Student student = new Student(); Class<? extends Student> clazz = student.getClass(); /* getDeclaredMethod():获取Class对象里的声明过的方法(包括) 参数一:方法名 参数二:参数列表类型 */ Method speak = clazz.getDeclaredMethod("speak", String.class, int.class); //私有方法,暴力反射 speak.setAccessible(true); /* 调用show方法需要对象和参数 invoke()方法:调用的意思 参数一:调用此方法的对象 参数二:调用此方法需要传入的实参 */ speak.invoke(student, "hello private speak",2018); } 反射的使用3:属性(Field)的反射 在Student实体中有一个共有属性一个私有属性,我们可以通过对象来设置共有属性的值,那么通过反射如何实现所有属性的赋值? 先来看看共有属性name的赋值 public static void main(String[] args) throws ClassNotFoundException, NoSuchFieldException, IllegalAccessException, InstantiationException { //获取Class对象,参数全限定名 Class<?> clazz = Class.forName("com.test.demo.Student"); /* getField():通过属性名获取属性 */ Field name = clazz.getField("name"); //获取对象 Object obj = clazz.newInstance(); /* 设置一个值 参数一:哪个对象的属性值 参数二:参数 */ name.set(obj,"张三"); System.out.println(obj); } 根据前面说的API,反射属性不难理解。 私有属性的反射也不难实现 public static void main(String[] args) throws ClassNotFoundException, NoSuchFieldException, IllegalAccessException, InstantiationException { //获取Class对象,参数全限定名 Class<?> clazz = Class.forName("com.test.demo.Student"); /* getDeclaredField():通过属性名获取(所有权限)属性 */ Field age = clazz.getDeclaredField("age"); //暴力反射 age.setAccessible(true); //创建对象 Object obj = clazz.newInstance(); /* 设置一个值 参数一:哪个对象的属性值 参数二:参数 */ age.set(obj,20); System.out.println(obj); } 总结: 使用java的反射机制,一般需要遵循三步: ●获得你想操作类的Class对象 ●通过第一步获得的Class对象去取得操作类的方法或是属性名 ●操作第二步取得的方法或是属性 那么反射到底有什么用? 反射最主要还是运用在框架中,了解反射才更好的了解一些框架的原理。 原文发布时间为:2018-11-21 本文作者:四夕又欠 本文来自云栖社区合作伙伴“Web项目聚集地”,了解相关信息可以关注“Web项目聚集地”。

优秀的个人博客,低调大师

一文看懂 Redis5 搭建集群

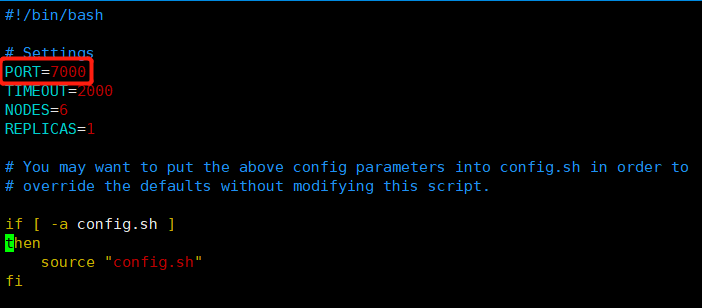
1、简要说明 2018年十月 Redis 发布了稳定版本的 5.0 版本,推出了各种新特性,其中一点是放弃 Ruby的集群方式,改为 使用 C语言编写的 redis-cli的方式,是集群的构建方式复杂度大大降低。关于集群的更新可以在 Redis5 的版本说明中看到,如下: The cluster manager was ported from Ruby (redis-trib.rb) to C code inside redis-cli. check `redis-cli --cluster help ` for more info. 可以查看Redis官网查看集群搭建方式,连接如下 https://redis.io/topics/cluster-tutorial 以下步骤是在一台 Linux 服务器上搭建有6个节点的 Redis集群。 2、创建集群步骤 1、创建目录 新建目录:/root/software/redis 2、下载源码并解压编译 ​wget http://download.redis.io/releases/redis-5.0.0.tar.gz tar xzf redis-5.0.0.tar.gz cd redis-5.0.0 make 3、创建6个Redis配置文件 6个配置文件不能在同一个目录,此处我们定义如下: /root/software/redis/redis-cluster-conf/7001/redis.conf /root/software/redis/redis-cluster-conf/7002/redis.conf /root/software/redis/redis-cluster-conf/7003/redis.conf /root/software/redis/redis-cluster-conf/7004/redis.conf /root/software/redis/redis-cluster-conf/7005/redis.conf /root/software/redis/redis-cluster-conf/7006/redis.conf 配置文件的内容为: port 7001 #端口 cluster-enabled yes #启用集群模式 cluster-config-file nodes.conf cluster-node-timeout 5000 #超时时间 appendonly yes daemonize yes #后台运行 protected-mode no #非保护模式 pidfile /var/run/redis_7001.pid 其中 port 和 pidfile 需要随着 文件夹的不同调增。 4、启动节点 /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7001/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7002/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7003/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7004/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7005/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7006/redis.conf 5、启动集群 /root/software/redis/redis-5.0.0/src/redis-cli --cluster create 192.168.2.40:7001 192.168.2.40:7002 192.168.2.40:7003 192.168.2.40:7004 192.168.2.40:7005 192.168.2.40:7006 --cluster-replicas 1 启动后,可看到成功信息,如下: >>> Performing hash slots allocation on 6 nodes... Master[0] -> Slots 0 - 5460 Master[1] -> Slots 5461 - 10922 Master[2] -> Slots 10923 - 16383 Adding replica 192.168.2.40:7004 to 192.168.2.40:7001 Adding replica 192.168.2.40:7005 to 192.168.2.40:7002 Adding replica 192.168.2.40:7006 to 192.168.2.40:7003 >>> Trying to optimize slaves allocation for anti-affinity [WARNING] Some slaves are in the same host as their master M: 191c645200a8b4d267f71e3354c8248dbb533dde 192.168.2.40:7001 slots:[0-5460] (5461 slots) master M: 400a08d4e5a534c1b609988105d3e045395fbd12 192.168.2.40:7002 slots:[5461-10922] (5462 slots) master M: 684f6aa0fbccda295ce6818a8c01ee7255a7b002 192.168.2.40:7003 slots:[10923-16383] (5461 slots) master S: f2701549ae98315b432d73b49d139ee77d5685b4 192.168.2.40:7004 replicates 684f6aa0fbccda295ce6818a8c01ee7255a7b002 S: 9fdc1e375436767ab815cbddd3df674f3bc2ca99 192.168.2.40:7005 replicates 191c645200a8b4d267f71e3354c8248dbb533dde S: e7742888ed85b37cff4a98e861e99bb16e8bae2c 192.168.2.40:7006 replicates 400a08d4e5a534c1b609988105d3e045395fbd12 Can I set the above configuration? (type 'yes' to accept): yes >>> Nodes configuration updated >>> Assign a different config epoch to each node >>> Sending CLUSTER MEET messages to join the cluster Waiting for the cluster to join .... >>> Performing Cluster Check (using node 192.168.2.40:7001) M: 191c645200a8b4d267f71e3354c8248dbb533dde 192.168.2.40:7001 slots:[0-5460] (5461 slots) master 1 additional replica(s) M: 684f6aa0fbccda295ce6818a8c01ee7255a7b002 192.168.2.40:7003 slots:[10923-16383] (5461 slots) master 1 additional replica(s) S: 9fdc1e375436767ab815cbddd3df674f3bc2ca99 192.168.2.40:7005 slots: (0 slots) slave replicates 191c645200a8b4d267f71e3354c8248dbb533dde S: e7742888ed85b37cff4a98e861e99bb16e8bae2c 192.168.2.40:7006 slots: (0 slots) slave replicates 400a08d4e5a534c1b609988105d3e045395fbd12 M: 400a08d4e5a534c1b609988105d3e045395fbd12 192.168.2.40:7002 slots:[5461-10922] (5462 slots) master 1 additional replica(s) S: f2701549ae98315b432d73b49d139ee77d5685b4 192.168.2.40:7004 slots: (0 slots) slave replicates 684f6aa0fbccda295ce6818a8c01ee7255a7b002 [OK] All nodes agree about slots configuration. >>> Check for open slots... >>> Check slots coverage... [OK] All 16384 slots covered. 至此,Reids5 集群搭建完成。 3、集群其他操作 1、关闭集群 redis5 提供了关闭集群的工具,在如下目录: /root/software/redis/redis-5.0.0/utils/create-cluster 打开此文件修改端口为我们自己的,如下所示: 端口PROT设置为7000,NODES为6,工具会自动累加1 生成 7001-7006 六个节点 用于操作。 修改后,执行如下命令关闭集群: /root/software/redis/redis-5.0.0/utils/create-cluster/create-cluster stop 2、重新启动集群 /root/software/redis/redis-5.0.0/utils/create-cluster/create-cluster start 3、使用脚本文件启动集群 #!/bin/sh /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7001/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7002/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7003/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7004/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7005/redis.conf /root/software/redis/redis-5.0.0/src/redis-server /root/software/redis/redis-cluster-conf/7006/redis.conf /root/software/redis/redis-5.0.0/src/redis-cli --cluster create 192.168.2.40:7001 192.168.2.40:7002 192.168.2.40:7003 192.168.2.40:7004 192.168.2.40:7005 192.168.2.40:7006 --cluster-replicas 1 以下是 Redis3 集群的操作步骤: https://www.cnblogs.com/xuliangxing/p/7146868.html https://www.cnblogs.com/yuanermen/p/5717885.html

优秀的个人博客,低调大师

Android开发精选博文推荐(12.3-12.9)

silverlight C#委托与事件 我们都知道,C#中有“接口”这个概念,所谓的“接口”就是定义一套标准,然后由实现类来具体实现其中的方法,所以说“接口,是一组类的抽象”。同样道理,我们可以将“委托”理解为“方法的抽象”,也就是说定义一个方法的模板,至于这个方法具体是怎么样的,就由方法自己去实现。http://www.apkbus.com/blog-109557-45420.htmlandroid 混淆文件proguard.cfg详解 proguard是一个java代码混淆的工具,通过proguard,别人即使反编译你的apk包,也只会看到一些让人很难看懂的代码,从而达到保护代码的作用。http://www.apkbus.com/blog-56077-45418.htmlAndroid中TextView中加图片,超链接 对一个TextView中添加图片或者本身文字颜色或者背景色变化的demo:http://www.apkbus.com/blog-134192-45409.htmlandroid opengl es 绘制位图字体 Android中绘制字体,用到了canvas,下面代码里面为我写的实例,几乎每行代码都有注释。http://www.apkbus.com/blog-55942-45401.htmlandroid 程序锁 某些人有时候会有这样一种需求,小A下载了个软件,只是软件中的美女过于诱惑与暴露,所以他不想让别人知道这是个什么软件,起码不想让别人打开浏览。而这款软件又没有锁,任何人都可以打开,肿么办呢?如果打开它的时候需要输入密码,那该多好阿!于是,程序锁这种应用就产生了http://www.apkbus.com/blog-66575-45396.htmlandroid静音拍照 之前写过一些android手机root之后的安全问题的(文章列表见末尾),其实我是想到哪就写到了,今天整理硬盘,发现一年之前写过一段代码,所以今天我们就一起来讨论一下。http://www.apkbus.com/blog-66575-45394.htmlSQLite数据库的创建增删改查等问题 很多朋友刚接触安卓,对安卓里SQLite数据库还不是很了解,下面是我做的一个小程序,程序里能实现数据库的创建、增加、修改、删除、查询等,程序非常简单,希望能对初学者有帮助。http://www.apkbus.com/blog-127136-45390.htmlandroid ViewFlipper的使用 屏幕切换指的是在同一个Activity内屏幕见的切换,最长见的情况就是在一个FrameLayout内有多个页面,比如一个系统设置页面;一个个性化设置页面。http://www.apkbus.com/blog-85308-45385.html简单易懂的Android ROM定制与修改教程 每个人对手机都有不同的要求,这里我想谈谈我的修改ROM的方法,其中大部分是总结于论坛中其他帖子,有一小部分是自己总结的经验。玩Android手机可为个层次:http://www.apkbus.com/blog-83782-45383.html利用pull解析器读写XML文件 对XML解析有SAX和DOM等多种方式,Android中极力推荐xmlpull方式解析xml。xmlpull不仅可用在Android上同样也适用于javase,但在javase环境中需自己获取xmlpull所依赖的类库,kxml2-2.3.0.jar,xmlpull_1_1_3_4c.jar。http://www.apkbus.com/blog-83703-45382.htmlActivity的跳转与传值 Activity跳转与传值,主要是通过Intent类,Intent的作用是激活组件和附带数据。http://www.apkbus.com/blog-83703-45380.html数据存取之SQLite SQLite是一款轻型的数据库,是遵守ACID的关联式数据库管理系统,它的设计目标是嵌入 式的,而且目前已经在很多嵌入式产品中使用了它,它占用资源非常的低,在嵌入式设备中,可能只需要几百K的内存就够了。http://www.apkbus.com/blog-17085-45379.htmlLibgdx camera 介绍 Camera 是libgdx中很重要的一个类。api中有关介绍如下:http://www.apkbus.com/blog-20705-45377.html基于Android Fragment功能的例子 通过最近空闲时候对Fragment的学习,尝试着写了一个小Demo,将在开发的时候能常用到的Fragment知识放在一起,写过了这个Demo对Android Fragment的了解更加深入了,以后做起有关的项目也会顺手很多,下面先贴上几张实现之后的图片http://www.apkbus.com/blog-83782-45375.htmlAndroid 查看内存 方式一,Running services 通过手机上Running services的Activity查看,可以通过Setting->Applications->Running services进。http://www.apkbus.com/blog-83591-45357.htmlandroid 文件读写 从resource中的raw文件夹中获取文件并读取数据(资源文件只能读不能写)http://www.apkbus.com/blog-17085-45351.htmlsql where 1=1和 0=1 的作用 举个例子,如果您做查询页面,并且,可查询的选项有多个,同时,还让用户自行选择并输入查询关键词,那么,按平时的查询语句的动态构造,代码大体如下:http://www.apkbus.com/blog-120032-45350.htmlANDROID 产生弹出菜单方法 先对某一个控件注册,使得他能够产生菜单registerForContextMenu(this.gallery); //注册一个gallery空间的的菜单http://www.apkbus.com/blog-83591-45343.htmlAndroid 菜单(OptionMenu)大全 建立你自己的菜单 菜单是用户界面中最常见的元素之一,使用非常频繁,在Android中,菜单被分为如下三种,选项菜单(OptionsMenu)、上下文菜单(ContextMenu)和子菜单(SubMenu),今天这讲是OptionsMenuhttp://www.apkbus.com/blog-130933-45337.htmlandroid文件存储的4种方式 Context.MODE_PRIVATE:为默认操作模式,代表该文件是私有数据,只能被应用本身访问,在该模式下,写入的内容会覆盖原文件的内容,如果想把新写入的内容追加到原文件中。http://www.apkbus.com/blog-56077-45333.htmlSimpleCursorAdapter 在许多时候需要将数据库表中的数据显示在ListView、Gallery等组件中。虽然可以直接使用Adapter对象处理,但工作量很大。为此,Android SDK提供了一个专用于数据绑定的Adapter类:SimpleCursorAdapter。http://www.apkbus.com/blog-17085-45328.htmlGallery和GridView浅析 Gallery(画廊)是一个锁定中心条目并且拥有水平滚动列表的视图,一般用来浏览图片,并且可以响应事件显示信息。Gallery还可以和ImageSwitcher组件结合使用来实现一个通过缩略图来浏览图片的效果。http://www.apkbus.com/blog-17085-45327.html一个简易的音乐播放器 因为第一次发表博客,很多地方还不会,以后会好好改进的,希望能和大家交流学习,android还在学习当中,以后有好东西会第一时间和大家分享的。。。http://www.apkbus.com/blog-138234-45326.htmlandroid service 实现Binder类 如果你的service仅被自己的应用使用并且不需跨进程工作,那么你可以实现你自己的Binder类使得你的客户端能直接使用service的公开接口方法.http://www.apkbus.com/blog-85308-45324.htmlAndroid Service的用法 Service就是一个应用程序组件,用来执行一些长时间的操作,然而不与用户交互或者为其他应用程序提供一些功能。每一个Service类都必须定义在AndroidManifest.xml中,以<service>tag开头。http://www.apkbus.com/blog-85308-45321.html采用MQTT协议实现android消息推送 MQ 遥测传输 (MQTT) 是轻量级基于代理的发布/订阅的消息传输协议,设计思想是开放、简单、轻量、易于实现。这些特点使它适用于受限环境。http://www.apkbus.com/blog-85308-45319.htmlAndroid游戏框架Libgdx使用入门(转) Libgdx是一款支持2D与3D游戏开发的游戏类库,兼容大多数微机平台(标准JavaSE实现,能运行在Mac、Linux、Windows等系统)与Android平台(Android1.5以上即可使用,Android2.1以上可满功率发挥)http://www.apkbus.com/blog-20705-45318.htmlSurface、SurfaceView、SurfaceHolder及SurfaceHolder.Callback之间的关系 Surface就是“表面”的意思。在SDK的文档中,对Surface的描述是这样的:“Handle onto a raw buffer that is being managed by the screen compositor”,翻译成中文就是“由屏幕显示内容合成器(screen compositor)所管理的原生缓冲器的句柄”,这句话包括下面两个意思http://www.apkbus.com/blog-130933-45313.htmlAndroid支持HTML标签 目前android不支持全部的html的标签,目前只支持与文本显示和段落等标签,对于图片和其他的多媒体,还有一些自定义标签不能识别。http://www.apkbus.com/blog-144026-45311.htmlAsyncTask的用法 在开发Android应用时必须遵守单线程模型的原则: Android UI操作并不是线程安全的并且这些操作必须在UI线程中执行。在单线程模型中始终要记住两条法则:http://www.apkbus.com/blog-124243-45310.htmlAndroid开发中多线程及异步处理 由于内核并没有对多线程进程的支持,因此,内核中只有单线程进程的概念, 而多线程进程是通过一个和应用程序连接的函数库实现的。由于内核没有轻量 级进程(线程)的概念,因此它不能独立的对之进行调度,而是由一个线程运 行库来组织线程的调度,其主要工作在于在各个线程的栈之间调度。http://www.apkbus.com/blog-124243-45309.htmlAndroid Socket编程 Socket Programming on AndroidSocket 编程基础知识:主要分服务器端编程和客户端编程。http://www.apkbus.com/blog-76214-45306.htmlViewPager在ScrollView中无法正常滑动的问题 ——问题解决 ScrollView中嵌入ViewPager,ViewPager的滑动出现问题在网上找到两种方法,都是自定义scrollview,主要作用于多重嵌套,复杂布局,我最近正在做的大家可以试试。http://www.apkbus.com/blog-24118-45304.htmlandroid 监听电话状态 以上代码是对电话进行状态改变的监听。这里需要理解监听器的机制。 Android的事件处理机制有两种:监听和回调。http://www.apkbus.com/blog-105036-45262.htmlandroid_handle消息机制 默认情况下,Handler接受的是当前线程下的消息循环实例(使用Handler(Looper looper)、Handler(Looper looper, Handler.Callback callback)可以指定线程),同时一个消息队列可以被当前线程中的多个对象进行分发、处理(在UI线程中,系统已经有一个Activity来处理了,你可以再起若干个Handler来处理)。http://www.apkbus.com/blog-98964-45259.html中国国家气象局天气预报信息接口 想在自己的android应用中获得当天的天气情况,这该怎么做呢?不用担心。中国国家气象局提供了获取所在城市天气预报信息接口。通过这个接口,我们就可以获取天气信息了。http://www.apkbus.com/blog-56077-45150.htmlAndroid 国际化 多语言适配 nternationalization (国际化)简称 i18n,因为在i和n之间还有18个字符,localization(本地化 ),简称L10n。一般用 语言_地区的形式表示一种语言,如zh_CN, zh_TW.http://www.apkbus.com/blog-24118-45137.htmllibgdx 三维旋转立方体(原创)http://www.apkbus.com/blog-20705-45381.html 本文转自qianqianlianmeng博客园博客,原文链接:http://www.cnblogs.com/aimeng/archive/2012/12/10/2811601.html ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册