首页 文章 精选 留言 我的

精选列表

搜索[文智公众趋势分析],共10000篇文章
优秀的个人博客,低调大师

文盘Rust -- struct 中的生命周期

最近在用rust 写一个redis的数据校验工具。redis-rs中具备 redis::ConnectionLike trait,借助它可以较好的来抽象校验过程。在开发中,不免要定义struct 中的某些元素为 trait object,从而带来一些rust语言中的生命周期问题。 本文不具体讨论 redis的数据校验过程,通过一个简单的例子来聊聊 struct 中 trait object 元素的生命周期问题。 首先来定义一个 base trait,该 trait 中只包含一个函数,返回String类型。 pub trait Base { fn say(&self) -> String; } 接下来,定义两个实现了 Base trait 的 struct AFromBase 和 BFromBase pub struct AFromBase { content: String, } impl Base for AFromBase { fn say(&self) -> String { self.content.clone() } } pub struct BFromBase { text: String, } impl Base for BFromBase { fn say(&self) -> String { self.text.clone() } } 接下来,定义一个struct 包含两个 Base trait 的 trait object ,然后实现一个函数是 say 函数输出的字符串的拼接结果. 按照其他没有生命周期语言的编写习惯,直觉上这么写 pub struct AddTowBase { a: &mut dyn Base, b: &mut dyn Base, } impl AddTowBase { fn add(&self) -> String { let result = self.a.say() + &self.b.say(); result } } 最后,搞个main函数验证一下。 完整代码如下 pub trait Base { fn say(&self) -> String; } pub struct AFromBase { content: String, } impl Base for AFromBase { fn say(&self) -> String { self.content.clone() } } pub struct BFromBase { text: String, } impl Base for BFromBase { fn say(&self) -> String { self.text.clone() } } pub struct AddTowBase { a: &mut dyn Base, b: &mut dyn Base, } impl<'a> AddTowBase<'a> { fn add(&self) -> String { let result = self.a.say() + &self.b.say(); result } } fn main() { let mut a = AFromBase { content: "baseA".to_string(), }; let mut b = BFromBase { text: "baseB".to_string(), }; let addtow = AddTowBase { a: &mut a, b: &mut b, }; let r = addtow.add(); println!("{}", r); } 很遗憾,以上代码是不能编译通过的,编译时报如下错误 error[E0106]: missing lifetime specifier --> examples/lifetimeinstruct.rs:26:8 | 26 | a: &mut dyn Base, | ^ expected named lifetime parameter | help: consider introducing a named lifetime parameter | 25 ~ pub struct AddTowBase<'a> { 26 ~ a: &'a mut dyn Base, | error[E0106]: missing lifetime specifier --> examples/lifetimeinstruct.rs:27:8 | 27 | b: &mut dyn Base, | ^ expected named lifetime parameter | help: consider introducing a named lifetime parameter | 25 ~ pub struct AddTowBase<'a> { 26 | a: &mut dyn Base, 27 ~ b: &'a mut dyn Base, | For more information about this error, try `rustc --explain E0106`. error: could not compile `wenpan-rust` due to 2 previous errors 编译器给出的提示很明确,要在 trait object 上添加生命周期参数,确保 struct 和他的 trait object 元素在同一生命周期,避免悬垂指针。 我们按照编译器的提示修改代码 pub struct AddTowBase<'a> { a: &'a mut dyn Base, b: &'a mut dyn Base, } impl<'a> AddTowBase<'a> { fn add(self) -> String { let result = self.a.say() + &self.b.say(); result } } 代码顺利通过编译。 rust 的生命周期保证了内存的安全性,同时也增加了开发者的心智负担。是在上线之前多费心思写代码,还是在上线以后忙忙活活查问题,这是个 trade off 问题。俗话讲:"背着抱着,一样沉".我本人还是倾向于把问题控制在上线之前,少折腾用户。 本期咱们先聊到这儿,下期见

优秀的个人博客,低调大师

【详细教程】一文参透MongoDB聚合查询

MongoDB聚合查询 什么是聚合查询 聚合操作主要用于处理数据并返回计算结果。聚合操作将来自多个文档的值组合在一起,按条件分组后,再进行一系列操作(如求和、平均值、最大值、最小值)以返回单个结果。 MongoDB的聚合查询 ​ 聚合是MongoDB的高级查询语言,它允许我们通过转化合并由多个文档的数据来生成新的在单个文档里不存在的文档信息。MongoDB中聚合(aggregate)主要用于处理数据(例如分组统计平均值、求和、最大值等),并返回计算后的数据结果,有点类似sql语句中的 count(*)、group by。 ​ 在MongoDB中,有两种方式计算聚合:Pipeline 和 MapReduce。Pipeline查询速度快于MapReduce,但是MapReduce的强大之处在于能够在多台Server上并行执行复杂的聚合逻辑。MongoDB不允许Pipeline的单个聚合操作占用过多的系统内存。 聚合管道方法 MongoDB 的聚合框架就是将文档输入处理管道,在管道内完成对文档的操作,最终将文档转换为聚合结果,MongoDB的聚合管道将MongoDB文档在一个管道处理完毕后将结果传递给下一个管道处理,管道操作是可以重复的。 ​ 最基本的管道阶段提供过滤器,其操作类似查询和文档转换,可以修改输出文档的形式。其他管道操作提供了按特定字段对文档进行分组和排序的工具,以及用于聚合数组内容(包括文档数组)的工具。 ​ 此外,在管道阶段还可以使用运算符来执行诸如计算平均值或连接字符串之类的任务。聚合管道可以在分片集合上运行。 聚合流程 db.collection.aggregate()是基于数据处理的聚合管道,每个文档通过一个由多个阶段(stage)组成的管道,可以对每个阶段的管道进行分组、过滤等功能,然后经过一系列的处理,输出相应的结果。 聚合管道方法的流程参见下图 上图的聚合操作相当于 MySQL 中的以下语句: select cust_id as _id, sum(amount) as total from orders where status like "%A%" group by cust_id; 详细流程 db.collection.aggregate() 可以用多个构件创建一个管道,对于一连串的文档进行处理。这些构件包括:筛选操作的match、映射操作的project、分组操作的group、排序操作的sort、限制操作的limit、和跳过操作的skip。 db.collection.aggregate()使用了MongoDB内置的原生操作,聚合效率非常高,支持类似于SQL Group By操作的功能,而不再需要用户编写自定义的JavaScript例程。 每个阶段管道限制为100MB的内存。如果一个节点管道超过这个极限,MongoDB将产生一个错误。为了能够在处理大型数据集,可以设置allowDiskUse为true来在聚合管道节点把数据写入临时文件。这样就可以解决100MB的内存的限制。 db.collection.aggregate()可以作用在分片集合,但结果不能输在分片集合,MapReduce可以 作用在分片集合,结果也可以输在分片集合。 db.collection.aggregate()方法可以返回一个指针(cursor),数据放在内存中,直接操作。跟Mongo shell 一样指针操作。 db.collection.aggregate()输出的结果只能保存在一个文档中,BSON Document大小限制为16M。可以通过返回指针解决,版本2.6中:DB.collect.aggregate()方法返回一个指针,可以返回任何结果集的大小。 聚合语法 db.collection.aggregate(pipeline, options) 参数说明 参数 类型 描述 pipeline array 一系列数据聚合操作或阶段。详见聚合管道操作符 在版本2.6中更改:该方法仍然可以将流水线阶段作为单独的参数接受,而不是作为数组中的元素;但是,如果不将管道指定为数组,则不能指定options参数 options document 可选。 aggregate()传递给聚合命令的其他选项。 2.6版中的新增功能:仅当将管道指定为数组时才可用。 注意事项 ​ 使用db.collection.aggregate()直接查询会提示错误,但是传一个空数组如db.collection.aggregate([])则不会报错,且会和find一样返回所有文档。 常用聚合管道 与mysql聚合类比 为了便于理解,先将常见的mongo的聚合操作和mysql的查询做下类比 SQL 操作/函数 mongodb聚合操作 where $match group by $group having $match select $project order by $sort limit $limit sum() $sum count() $sum join $lookup $count 返回包含输入到stage的文档的计数,理解为返回与表或视图的find()查询匹配的文档的计数。db.collection.count()方法不执行find()操作,而是计数并返回与查询匹配的结果数。 语法 { $count: <string> } $count阶段相当于下面$group+$project的序列: db.collection.aggregate([ { "$group": { "_id": null, "count": {// 这里count自定义,相当于mysql的select count(*) as tables "$sum": 1 } } }, { "$project": {// 返回不显示_id字段 "_id": 0 } } ]) 示例 查询人数是100000以上的城市的数量 $match:阶段排除pop小于等于100000的文档,将大于100000的文档传到下个阶段 $count:阶段返回聚合管道中剩余文档的计数,并将该值分配给名为count的字段。 db.zips.aggregate([ { "$match": { "pop": { "$gt": 100000 } } }, { "$count": "count" } ]) $group 按指定的表达式对文档进行分组,并将每个不同分组的文档输出到下一个阶段。输出文档包含一个_id字段,该字段按键包含不同的组。 ​ 输出文档还可以包含计算字段,该字段保存由$group的_id字段分组的一些accumulator表达式的值。 $group不会输出具体的文档而只是统计信息。 语法 { $group: { _id: <expression>, <field1>: { <accumulator1> : <expression1> }, ... } } _id字段是必填的;但是,可以指定_id值为null来为整个输入文档计算累计值。 剩余的计算字段是可选的,并使用<accumulator>运算符进行计算。 _id和<accumulator>表达式可以接受任何有效的表达式。 accumulator操作符 名称 描述 类比sql $avg 计算均值 avg $first 返回每组第一个文档,如果有排序,按照排序,如果没有按照默认的存储的顺序返回第一个文档。 limit 0,1 $last 返回每组最后一个文档,如果有排序,按照排序,如果没有按照默认的存储的顺序返回最后一个文档。 - $max 根据分组,获取集合中所有文档对应值的最大值。 max $min 根据分组,获取集合中所有文档对应值的最小值。 min $push 将指定的表达式的值添加到一个数组中。 - $addToSet 将表达式的值添加到一个集合中(无重复值,无序)。 - $sum 计算总和 sum $stdDevPop 返回输入值的总体标准偏差(population standard deviation) - $stdDevSamp 返回输入值的样本标准偏差(the sample standard deviation) - $group阶段的内存限制为100M,默认情况下,如果stage超过此限制,$group将产生错误,但是,要允许处理大型数据集,请将allowDiskUse选项设置为true以启用$group操作以写入临时文件。 注意: "$addToSet":expr,如果当前数组中不包含expr,那就将它添加到数组中。 "$push":expr,不管expr是什么值,都将它添加到数组中,返回包含所有值的数组。 示例 按照state分组,并计算每一个state分组的总人数,平均人数以及每个分组的数量 db.zips.aggregate([ { "$group": { "_id": "$state", "totalPop": { "$sum": "$pop" }, "avglPop": { "$avg": "$pop" }, "count": { "$sum": 1 } } } ]) 查找不重复的所有的state的值 db.zips.aggregate([ { "$group": { "_id": "$state" } } ]) 按照city分组,并且分组内的state字段列表加入到stateItem并显示 db.zips.aggregate([ { "$group": { "_id": "$city", "stateItem": { "$push": "$state" } } } ]) 下面聚合操作使用系统变量$$ROOT按item对文档进行分组,生成的文档不得超过BSON文档大小限制 db.zips.aggregate([ { "$group": { "_id": "$city", "item": { "$push": "$$ROOT" } } } ]).pretty(); $match 过滤文档,仅将符合指定条件的文档传递到下一个管道阶段。 $match接受一个指定查询条件的文档,查询语法与读操作查询语法相同。 语法 { $match: { <query> } } 管道优化 ​ $match用于对文档进行筛选,之后可以在得到的文档子集上做聚合,$match可以使用除了地理空间之外的所有常规查询操作符,在实际应用中尽可能将$match放在管道的前面位置。这样有两个好处: 一是可以快速将不需要的文档过滤掉,以减少管道的工作量; 二是如果再投射和分组之前执行$match,查询可以使用索引。 使用限制 不能在$match查询中使用$作为聚合管道的一部分。 要在$match阶段使用$text,$match阶段必须是管道的第一阶段。 视图不支持文本搜索。 示例 使用 $match做简单的匹配查询,查询缩写是NY的城市数据 db.zips.aggregate([ { "$match": { "state": "NY" } } ]).pretty(); 使用$match管道选择要处理的文档,然后将结果输出到$group管道以计算文档的计数 db.zips.aggregate([ { "$match": { "state": "NY" } }, { "$group": { "_id": null, "sum": { "$sum": "$pop" }, "avg": { "$avg": "$pop" }, "count": { "$sum": 1 } } } ]).pretty(); $unwind 从输入文档解构数组字段以输出每个元素的文档,简单说就是 可以将数组拆分为单独的文档。 语法 要指定字段路径,在字段名称前加上$符并用引号括起来。 { $unwind: <field path> } v3.2+支持如下语法 { $unwind: { path: <field path>, #可选,一个新字段的名称用于存放元素的数组索引。该名称不能以$开头。 includeArrayIndex: <string>, #可选,default :false,若为true,如果路径为空,缺少或为空数组,则$unwind输出文档 preserveNullAndEmptyArrays: <boolean> } } ​ 如果为输入文档中不存在的字段指定路径,或者该字段为空数组,则$unwind默认会忽略输入文档,并且不会输出该输入文档的文档。 版本3.2中的新功能:要输出数组字段丢失的文档,null或空数组,请使用选项preserveNullAndEmptyArrays。 示例 以下聚合使用$unwind为loc数组中的每个元素输出一个文档: db.zips.aggregate([ { "$match": { "_id": "01002" } }, { "$unwind": "$loc" } ]).pretty(); $project $project可以从文档中选择想要的字段,和不想要的字段(指定的字段可以是来自输入文档或新计算字段的现有字段),也可以通过管道表达式进行一些复杂的操作,例如数学操作,日期操作,字符串操作,逻辑操作。 语法 $project 管道符的作用是选择字段(指定字段,添加字段,不显示字段,_id:0,排除字段等),重命名字段,派生字段。 { $project: { <specification(s)> } } specifications有以下形式: <field>: <1 or true> 是否包含该字段,field:1/0,表示选择/不选择 field _id: <0 or false> 是否指定_id字段 <field>: <expression> 添加新字段或重置现有字段的值。 在版本3.6中更改:MongoDB 3.6添加变量REMOVE。如果表达式的计算结果为$$REMOVE,则该字段将排除在输出中。 <field>:<0 or false> v3.4新增功能,指定排除字段 默认情况下,_id字段包含在输出文档中。要在输出文档中包含输入文档中的任何其他字段,必须明确指定$project中的包含。 如果指定包含文档中不存在的字段,$project将忽略该字段包含,并且不会将该字段添加到文档中。 默认情况下,_id字段包含在输出文档中。要从输出文档中排除_id字段,必须明确指定$project中的_id字段为0。 v3.4版新增功能-如果指定排除一个或多个字段,则所有其他字段将在输出文档中返回。 如果指定排除_id以外的字段,则不能使用任何其他$project规范表单:即,如果排除字段,则不能指定包含字段,重置现有字段的值或添加新字段。此限制不适用于使用REMOVE变量条件排除字段。 v3.6版本中的新功能- 从MongoDB 3.6开始,可以在聚合表达式中使用变量REMOVE来有条件地禁止一个字段。 要添加新字段或重置现有字段的值,请指定字段名称并将其值设置为某个表达式。 要将字段值直接设置为数字或布尔文本,而不是将字段设置为解析为文字的表达式,请使用$literal操作符。否则,$project会将数字或布尔文字视为包含或排除该字段的标志。 通过指定新字段并将其值设置为现有字段的字段路径,可以有效地重命名字段。 从MongoDB 3.2开始,$project阶段支持使用方括号[]直接创建新的数组字段。如果数组规范包含文档中不存在的字段,则该操作会将空值替换为该字段的值。 在版本3.4中更改-如果$project 是一个空文档,MongoDB 3.4和更高版本会产生一个错误。 投影或添加/重置嵌入文档中的字段时,可以使用点符号 示例 以下$project阶段的输出文档中只包含_id,city和state字段 db.zips.aggregate([ { "$project": { "_id": 1, "city": 1, "state": 1 } } ]).pretty(); _id字段默认包含在内。要从$ project阶段的输出文档中排除_id字段,请在project文档中将_id字段设置为0来指定排除_id字段。 db.zips.aggregate([ { "$project": { "_id": 0, "city": 1, "state": 1 } } ]).pretty(); 以下$ project阶段从输出中排除loc字段 db.zips.aggregate([ { "$project": { "loc": 0 } } ]).pretty(); 可以在聚合表达式中使用变量REMOVE来有条件地禁止一个字段, db.zips.aggregate([ { "$project": { "_id": 1, "city": 1, "state": 1, "pop": 1, "loc": { "$cond": { "if": { "$gt": [ "$pop", 1000 ] }, "then": "$$REMOVE", "else": "$loc" } } } } ]).pretty(); 我们还可以改变数据,将人数大于1000的城市坐标重置为0 db.zips.aggregate([ { "$project": { "_id": 1, "city": 1, "state": 1, "pop": 1, "loc": { "$cond": { "if": { "$gt": [ "$pop", 1000 ] }, "then": [ 0, 0 ], "else": "$loc" } } } } ]).pretty(); 新增字段列 db.zips.aggregate([ { "$project": { "_id": 1, "city": 1, "state": 1, "pop": 1, "desc": { "$cond": { "if": { "$gt": [ "$pop", 1000 ] }, "then": "人数过多", "else": "人数过少" } }, "loc": { "$cond": { "if": { "$gt": [ "$pop", 1000 ] }, "then": [ 0, 0 ], "else": "$loc" } } } } ]).pretty(); $limit 限制传递到管道中下一阶段的文档数 语法 { $limit: <positive integer> } 示例,此操作仅返回管道传递给它的前5个文档。 $limit对其传递的文档内容没有影响。 db.zips.aggregate({ "$limit": 5 }); 注意 ​ 当$sort在管道中的$limit之前立即出现时,$sort操作只会在过程中维持前n个结果,其中n是指定的限制,而MongoDB只需要将n个项存储在内存中。当allowDiskUse为true并且n个项目超过聚合内存限制时,此优化仍然适用。 $skip 跳过进入stage的指定数量的文档,并将其余文档传递到管道中的下一个阶段 语法 { $skip: <positive integer> } 示例,此操作将跳过管道传递给它的前5个文档, $skip对沿着管道传递的文档的内容没有影响。 db.zips.aggregate({ "$skip": 5 }); $sort 对所有输入文档进行排序,并按排序顺序将它们返回到管道。 语法 { $sort: { <field1>: <sort order>, <field2>: <sort order> ... } } $sort指定要排序的字段和相应的排序顺序的文档。 <sort order>可以具有以下值之一: 1指定升序。 -1指定降序。 {$meta:“textScore”}按照降序排列计算出的textScore元数据。 示例 要对字段进行排序,请将排序顺序设置为1或-1,以分别指定升序或降序排序,如下例所示: db.zips.aggregate([ { "$sort": { "pop": -1, "city": 1 } } ]) $sortByCount 根据指定表达式的值对传入文档分组,然后计算每个不同组中文档的数量。每个输出文档都包含两个字段:包含不同分组值的_id字段和包含属于该分组或类别的文档数的计数字段,文件按降序排列。 语法 { $sortByCount: <expression> } 使用示例 下面举了一些常用的mongo聚合例子和mysql对比,假设有一条如下的数据库记录(表名:zips)作为例子: 统计所有数据 SQL的语法格式如下 select count(1) from zips; mongoDB的语法格式 db.zips.aggregate([ { "$group": { "_id": null, "count": { "$sum": 1 } } } ]) 对所有城市人数求合 SQL的语法格式如下 select sum(pop) AS tota from zips; mongoDB的语法格式 db.zips.aggregate([ { "$group": { "_id": null, "total": { "$sum": "$pop" } } } ]) 对城市缩写相同的城市人数求合 SQL的语法格式如下 select state,sum(pop) AS tota from zips group by state; mongoDB的语法格式 db.zips.aggregate([ { "$group": { "_id": "$state", "total": { "$sum": "$pop" } } } ]) state重复的城市个数 SQL的语法格式如下 select state,count(1) AS total from zips group by state; mongoDB的语法格式 db.zips.aggregate([ { "$group": { "_id": "$state", "total": { "$sum": 1 } } } ]) state重复个数大于100的城市 SQL的语法格式如下 select state,count(1) AS total from zips group by state having count(1)>100; mongoDB的语法格式 db.zips.aggregate([ { "$group": { "_id": "$state", "total": { "$sum": 1 } } }, { "$match": { "total": { "$gt": 100 } } } ]) 本文由育博学谷狂野架构师发布 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力 转载请注明出处!

优秀的个人博客,低调大师

每日一博 | 一文详解 Kafka API

摘要:Kafka的API有Producer API,Consumer API还有自定义Interceptor (自定义拦截器),以及处理的流使用的Streams API和构建连接器的Kafka Connect API。 本文分享自华为云社区《【Kafka笔记】Kafka API详细解析 Java版本(Producer API,Consumer API,拦截器等)》,作者: Copy工程师。 简介 Kafka的API有Producer API,Consumer API还有自定义Interceptor (自定义拦截器),以及处理的流使用的Streams API和构建连接器的Kafka Connect API。 Producer API Kafka的Producer发送消息采用的是异步发送的方式。在消息发送过程中,涉及两个线程:main线程和Sender线程,以及一个线程共享变量RecordAccumulator。main线程将消息发送给RecordAccmulator,Sender线程不断地从RecordAccumulator中拉取消息发送给Kafka broker。 这里的ACk机制,不是生产者得到ACK返回信息才开始发送,ACK保证的是生产者不丢失数据。例如: 而是只要有消息数据,就向broker发送。 消息发送流程 生产者使用send方法,经过拦截器之后在经过序列化器,然后在走分区器。然后通过分批次把数据发送到PecordAccumulator,main线程到此过程就结束了,然后在回去执行send。 Sender线程不断的获取RecordAccumulator的数据发送到topic。 消息发送流程是异步发送的,并且顺序是一定的拦截器-》序列化器-》分区器 异步发送API 需要用到的类: KafkaProducer: 需要创建一个生产者对象,用来发送数据 ProducerConfig:获取所需要的一系列配置参数 ProducerRecord:每条数据都要封装成一个ProducerRecord对象 实例: public class KafkaProducerDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXXXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 0; i < 10 ; i++) { producer.send(new ProducerRecord<>("my-topic","ImKey-"+i,"ImValue-"+i)); } // 关闭资源 producer.close(); } } 配置参数说明: send():方法是异步的,添加消息到缓冲区等待发送,并立即返回。生产者将单个的消息批量在一起发送来提高效率。 ack:是判断请求是否完整的条件(就会判断是不是成功发送了,也就是上次说的ACK机制),指定all将会阻塞消息,性能低但是最可靠。 retries:如果请求失败,生产者会自动重试,我们指定是1次,但是启动重试就有可能出现重复数据。 batch.size:指定缓存的大小,生产者缓存每个分区未发送的消息。值越大的话将会产生更大的批量,并需要更大的内存(因为每个活跃的分区都有一个缓存区)。 linger.ms:指示生产者发送请求之前等待一段时间,设置等待时间是希望更多地消息填补到未满的批中。默认缓冲可以立即发送,即便缓冲空间还没有满,但是如果想减少请求的数量可以设置linger.ms大于0。需要注意的是在高负载下,相近的时间一般也会组成批,即使等于0。 buffer.memory:控制生产者可用的缓存总量,如果消息发送速度比其传输到服务器的快,将会耗尽这个缓存空间。当缓存空间耗尽,其他发送调用将被阻塞,阻塞时间的阈值通过max.block.ms设定,之后将会抛出一个TimeoutException key.serializer和value.serializer将用户提供的key和value对象ProducerRecord转换成字节,你可以使用附带的ByteArraySerializaer或StringSerializer处理简单的string或byte类型。 运行日志: [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.clients.producer.ProducerConfig[main] - ProducerConfig values: acks = all batch.size = 16384 bootstrap.servers = [XXXXXX:9093] buffer.memory = 33554432 client.id = compression.type = none connections.max.idle.ms = 540000 enable.idempotence = false interceptor.classes = null key.serializer = class org.apache.kafka.common.serialization.StringSerializer linger.ms = 1 max.block.ms = 60000 max.in.flight.requests.per.connection = 5 max.request.size = 1048576 metadata.max.age.ms = 300000 metric.reporters = [] metrics.num.samples = 2 metrics.recording.level = INFO metrics.sample.window.ms = 30000 partitioner.class = class org.apache.kafka.clients.producer.internals.DefaultPartitioner receive.buffer.bytes = 32768 reconnect.backoff.max.ms = 1000 reconnect.backoff.ms = 50 request.timeout.ms = 30000 retries = 1 retry.backoff.ms = 100 sasl.jaas.config = null sasl.kerberos.kinit.cmd = /usr/bin/kinit sasl.kerberos.min.time.before.relogin = 60000 sasl.kerberos.service.name = null sasl.kerberos.ticket.renew.jitter = 0.05 sasl.kerberos.ticket.renew.window.factor = 0.8 sasl.mechanism = GSSAPI security.protocol = PLAINTEXT send.buffer.bytes = 131072 ssl.cipher.suites = null ssl.enabled.protocols = [TLSv1.2, TLSv1.1, TLSv1] ssl.endpoint.identification.algorithm = null ssl.key.password = null ssl.keymanager.algorithm = SunX509 ssl.keystore.location = null ssl.keystore.password = null ssl.keystore.type = JKS ssl.protocol = TLS ssl.provider = null ssl.secure.random.implementation = null ssl.trustmanager.algorithm = PKIX ssl.truststore.location = null ssl.truststore.password = null ssl.truststore.type = JKS transaction.timeout.ms = 60000 transactional.id = null value.serializer = class org.apache.kafka.common.serialization.StringSerializer [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.common.utils.AppInfoParser[main] - Kafka version : 0.11.0.3 [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.common.utils.AppInfoParser[main] - Kafka commitId : 26ddb9e3197be39a [Godway] WARN 2019-11-14 14:46 - org.apache.kafka.clients.NetworkClient[kafka-producer-network-thread | producer-1] - Error while fetching metadata with correlation id 1 : {my-topic=LEADER_NOT_AVAILABLE} [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.clients.producer.KafkaProducer[main] - Closing the Kafka producer with timeoutMillis = 9223372036854775807 ms. Process finished with exit code 0 有一条警告{my-topic=LEADER_NOT_AVAILABLE} 提示该topic不存在,但是没有关系kafka会自动给你创建一个topic,不过创建的topic是有一个分区和一个副本: 查看一下该topic的消息: 消息已经在topic里了 上面的实例是没有回调函数的,send方法是有回调函数的: public class KafkaProducerCallbackDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 10; i < 20 ; i++) { producer.send(new ProducerRecord<String, String>("my-topic", "ImKey-" + i, "ImValue-" + i), new Callback() { @Override public void onCompletion(RecordMetadata recordMetadata, Exception e) { if (e == null){ System.out.println("消息发送成功!"+recordMetadata.offset()); }else { System.err.println("消息发送失败!"); } } }); } producer.close(); } } 回调函数会在producer收到ack时调用,为异步调用,该方法有两个参数,分别是RecordMetadata和Exception,如果Exception为null,说明消息发送成功,如果Exception不为null说明消息发送失败。 注意:消息发送失败会自动重试,不需要我们在回调函数中手动重试,使用回调也是无阻塞的。而且callback一般在生产者的IO线程中执行,所以是非常快的,否则将延迟其他的线程消息发送。如果需要执行阻塞或者计算的回调(耗时比较长),建议在callbanck主体中使用自己的Executor来并行处理! 同步发送API 同步发送的意思就是,一条消息发送之后,会阻塞当前的线程,直到返回ack(此ack和异步的ack机制不是一个ack)。 此ack是Future阻塞main线程,当发送完成就返回一个ack去通知main线程已经发送完毕,继续往下走了 public Future<RecordMetadata> send(ProducerRecord<K,V> record,Callback callback) send是异步的,并且一旦消息被保存在等待发送的消息缓存中,此方法就立即返回。这样并行发送多条消息而不阻塞去等待每一条消息的响应。 发送的结果是一个RecordMetadata,它指定了消息发送的分区,分配的offset和消息的时间戳。如果topic使用的是CreateTime,则使用用户提供的时间戳或发送的时间(如果用户没有指定指定消息的时间戳)如果topic使用的是LogAppendTime,则追加消息时,时间戳是broker的本地时间。 由于send调用是异步的,它将为分配消息的此消息的RecordMetadata返回一个Future。如果future调用get(),则将阻塞,直到相关请求完成并返回该消息的metadata,或抛出发送异常。 Throws: InterruptException - 如果线程在阻塞中断。 SerializationException - 如果key或value不是给定有效配置的serializers。 TimeoutException - 如果获取元数据或消息分配内存话费的时间超过max.block.ms。 KafkaException - Kafka有关的错误(不属于公共API的异常)。 public class KafkaProducerDemo { public static void main(String[] args) throws ExecutionException, InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 20; i < 30 ; i++) { RecordMetadata metadata = producer.send(new ProducerRecord<>("my-topic", "ImKey-" + i, "ImValue-" + i)).get(); System.out.println(metadata.offset()); } producer.close(); } } API生产者自定义分区策略 生产者在向topic发送消息的时候的分区规则: public ProducerRecord(String topic, Integer partition, Long timestamp, K key, V value, Iterable<Header> headers) public ProducerRecord(String topic, Integer partition, Long timestamp, K key, V value) public ProducerRecord(String topic, Integer partition, K key, V value, Iterable<Header> headers) public ProducerRecord(String topic, Integer partition, K key, V value) public ProducerRecord(String topic, K key, V value) public ProducerRecord(String topic, V value) 根据send方法的参数的构造方法就可以看出来, 指定分区就发送到指定分区 没有指定分区,有key值,就按照key值的Hash值分配分区 没有指定分区,也没有指定key值,轮询分区分配(只分配一次,以后都按照第一次的分区顺序) 自定义分区器 自定义分区器需要实现org.apache.kafka.clients.producer.Partitioner接口。并且实现三个方法 public class KafkaMyPartitions implements Partitioner { @Override public int partition(String s, Object o, byte[] bytes, Object o1, byte[] bytes1, Cluster cluster) { return 0; } @Override public void close() { } @Override public void configure(Map<String, ?> map) { } } 自定义分区实例: KafkaMyPartitions: public class KafkaMyPartitions implements Partitioner { @Override public int partition(String s, Object o, byte[] bytes, Object o1, byte[] bytes1, Cluster cluster) { // 这里写自己的分区策略 // 我这里指定为1 return 1; } @Override public void close() { } @Override public void configure(Map<String, ?> map) { } } KafkaProducerCallbackDemo: public class KafkaProducerCallbackDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 指定自定义分区 props.put("partitioner.class","com.firehome.newkafka.KafkaMyPartitions"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 20; i < 25 ; i++) { producer.send(new ProducerRecord<String, String>("th-topic", "ImKey-" + i, "ImValue-" + i), new Callback() { @Override public void onCompletion(RecordMetadata recordMetadata, Exception e) { if (e == null){ System.out.printf("消息发送成功!topic=%s,partition=%s,offset=%d \n",recordMetadata.topic(),recordMetadata.partition(),recordMetadata.offset()); }else { System.err.println("消息发送失败!"); } } }); } producer.close(); } } 返回日志: 消息发送成功!topic=th-topic,partition=1,offset=27 消息发送成功!topic=th-topic,partition=1,offset=28 消息发送成功!topic=th-topic,partition=1,offset=29 消息发送成功!topic=th-topic,partition=1,offset=30 消息发送成功!topic=th-topic,partition=1,offset=31 可以看到直接发送到了分区1上了。 多线程发送消息 Producer API是线程安全的,直接就可以使用多线程发送消息,实例: public class KafkaProducerThread implements Runnable { private KafkaProducer<String,String> kafkaProducer; public KafkaProducerThread(){ } public KafkaProducerThread(KafkaProducer kafkaProducer){ this.kafkaProducer = kafkaProducer; } @Override public void run() { for (int i = 0; i < 20 ; i++) { String key = "ImKey-" + i+"-"+Thread.currentThread().getName(); String value = "ImValue-" + i+"-"+Thread.currentThread().getName(); kafkaProducer.send(new ProducerRecord<>("th-topic", key, value)); System.out.printf("Thread-name = %s, key = %s, value = %s",Thread.currentThread().getName(),key,value); } } public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); KafkaProducerThread producerThread1 = new KafkaProducerThread(producer); //KafkaProducerThread producerThread2 = new KafkaProducerThread(producer); Thread one = new Thread(producerThread1, "one"); Thread two = new Thread(producerThread1, "two"); System.out.println("线程开始"); one.start(); two.start(); } } 这里只是一个简单的实例。 Consumer API kafka客户端通过TCP长连接从集群中消费消息,并透明地处理kafka集群中出现故障服务器,透明地调节适应集群中变化的数据分区。也和服务器交互,平衡均衡消费者。 偏移量和消费者的位置 kafka为分区中的每条消息保存一个偏移量(offset),这个偏移量是该分区中一条消息的唯一标示符。也表示消费者在分区的位置。例如,一个位置是5的消费者(说明已经消费了0到4的消息),下一个接收消息的偏移量为5的消息。实际上有两个与消费者相关的“位置”概念: 消费者的位置给出了下一条记录的偏移量。它比消费者在该分区中看到的最大偏移量要大一个。 它在每次消费者在调用poll(long)中接收消息时自动增长。 “已提交”的位置是已安全保存的最后偏移量,如果进程失败或重新启动时,消费者将恢复到这个偏移量。消费者可以选择定期自动提交偏移量,也可以选择通过调用commit API来手动的控制(如:commitSync 和 commitAsync)。 这个区别是消费者来控制一条消息什么时候才被认为是已被消费的,控制权在消费者。 消费者组和主题订阅 Kafka的消费者组概念,通过进程池瓜分消息并处理消息。这些进程可以在同一台机器运行,也可分布到多台机器上,以增加可扩展性和容错性,相同group.id的消费者将视为同一个消费者组。 分组中的每个消费者都通过subscribe API动态的订阅一个topic列表。kafka将已订阅topic的消息发送到每个消费者组中。并通过平衡分区在消费者分组中所有成员之间来达到平均。因此每个分区恰好地分配1个消费者(一个消费者组中)。所有如果一个topic有4个分区,并且一个消费者分组有只有2个消费者。那么每个消费者将消费2个分区。 消费者组的成员是动态维护的:如果一个消费者故障。分配给它的分区将重新分配给同一个分组中其他的消费者。同样的,如果一个新的消费者加入到分组,将从现有消费者中移一个给它。这被称为重新平衡分组。当新分区添加到订阅的topic时,或者当创建与订阅的正则表达式匹配的新topic时,也将重新平衡。将通过定时刷新自动发现新的分区,并将其分配给分组的成员。 从概念上讲,你可以将消费者分组看作是由多个进程组成的单一逻辑订阅者。作为一个多订阅系统,Kafka支持对于给定topic任何数量的消费者组,而不重复。 这是在消息系统中常见的功能的略微概括。所有进程都将是单个消费者分组的一部分(类似传统消息传递系统中的队列的语义),因此消息传递就像队列一样,在组中平衡。与传统的消息系统不同的是,虽然,你可以有多个这样的组。但每个进程都有自己的消费者组(类似于传统消息系统中pub-sub的语义),因此每个进程都会订阅到该主题的所有消息。 此外,当分组重新分配自动发生时,可以通过ConsumerRebalanceListener通知消费者,这允许他们完成必要的应用程序级逻辑,例如状态清除,手动偏移提交等 它也允许消费者通过使用assign(Collection)手动分配指定分区,如果使用手动指定分配分区,那么动态分区分配和协调消费者组将失效。 发现消费者故障 订阅一组topic,当调用poll(long)时,消费者将自动加入到消费者组中。只要持续调用poll,消费者将一直保持可用,并继续从分配的分区中接收数据。此外,消费者向服务器定时发送心跳。如果消费者崩溃或无法再session.timeout.ms配置的时间内发送心跳,则消费者就被视为死亡,并且其分区将被重新分配。 还有一种可能,消费者可能遇到活锁的情况,它持续的发送心跳,但是没有处理。为了预防消费者在这总情况下一直拥有分区,我们使用max.poll.interval.ms活跃监测机制。在此基础上,如果你调用的poll的频率大于最大间隔,则客户端将主动地离开组,以便其他消费者接管该分区。发生这种情况时,你会看到offset提交失败( 调用commitSync()引发的CommitFailedException )。这是一种安全机制,保障只有活动成员能够提交offset。所以要留在组中,你必须持续调用poll。 消费者提供两种配置设置来控制poll循环: max.poll.interval.ms: 增大poll的间隔,可以为消费者提供更多的时间去处理返回的消息(调用poll(long)返回的消息,通常返回的消息都是一批),缺点是此值越大将会延迟组重新平衡。 max.poll.records:此设置限制每次调用poll返回的消息数,这样可以更容易的预测每次poll间隔要处理的最大值。通过调整此值,可以减少poll间隔,减少重新平衡分组的 对于消息处理时间不可预测地情况,这些选项是不够的。 处理这种情况的推荐方法是将消息处理移到另一个线程中,让消费者继续调用poll。 但是必须注意确保已提交的offset不超过实际位置。另外,你必须禁用自动提交,并只有在线程完成处理后才为记录手动提交偏移量。 还要注意, 你需要pause暂停分区,不会从poll接收到新消息,让线程处理完之前返回的消息(如果你的处理能力比拉取消息的慢,那创建新线程将导致机器内存溢出)。 实例: 自动提交偏移量 public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","xxxxxxxxxx:9093"); props.put("group.id","test-6");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","true");//自动提交offset props.put("auto.commit.interval.ms","1000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props); // 可以写多个topic consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } System.out.println("处理了一批数据!"); } } 配置说明: bootstrap.servers: 集群是通过配置bootstrap.servers指定一个或多个broker。不用指定全部的broker,它将自动发现集群中的其余的borker(最好指定多个,万一有服务器故障) enable.auto.commit: 自动提交偏移量,如果设置了自动提交偏移量,下面这个设置就必须要用到了。 auto.commit.interval.ms:自动提交时间间隔,和自动提交偏移量配合使用 max.poll.records:控制从 broker拉取的消息条数 poll(long time): 当消费者获取不到消息时,就会使用这个参数,为了减轻无效的循环请求消息,消费者会每隔long time的时间请求一次消息,单位是毫秒。 session.timeout.ms: broker通过心跳机器自动检测消费者组中失败的进程,消费者会自动ping集群,告诉进群它还活着。只要消费者能够做到这一点,它就被认为是活着的,并保留分配给它分区的权利,如果它停止心跳的时间超过session.timeout.ms,那么就会认为是故障的,它的分区将被分配到别的进程。 auto.offset.reset:这个属性很重要,一会详细讲解 这里说明一下auto.commit.interval.ms以及何时提交消费者偏移量,经过测试: 设置props.put("auto.commit.interval.ms","60000"); 自动提交时间为一分钟,也就是你在这一分钟内拉取任何数量的消息都不会被提交消费的当前偏移量,如果你此时关闭消费者(一分钟内),下次消费还是从和第一次的消费数据一样,即使你在一分钟内消费完所有的消息,只要你在一分钟内关闭程序,导致提交不了offset,就可以一直重复消费数据。 设置props.put("auto.commit.interval.ms","3000"); 但是在消费过程中设置sleep。 public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","xxxxxxxxxxxx:9093"); props.put("group.id","test-6");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","true");//自动提交offset props.put("auto.commit.interval.ms","100000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); // KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props); // 可以写多个topic consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } try { Thread.sleep(5000L); System.out.println("等待了5秒了!!!!!!!!!!!!开始等待15秒了"); Thread.sleep(5000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("处理了一批数据!"); } } 这里如果你消费了第一批数据,在执行第二次poll的时候,关闭程序也不会提交偏移量,只有在执行第二次poll的时候才会把上一次的最后一个offset提交上去。 auto.offset.reset讲解: auto.offset.reset的值有三种:earliest,latest,none,代表者不同的意思 earliest: 当各分区下有已经提交的offset时,从提交的offset开始消费;无提交的offset时,从头开始消费,最常用的值 latest: 当各分区下有已提交的offset时,从提交的offset开始消费;无提交的offset时,消费新产生的该分区下的数据 none: topic各分区都存在已提交的offset时,从offset后开始消费,只要有一个分区不存在已提交的offset,则抛出异常 !!注意:当使用了latest,并且分区没有已提交的offset时,消费新产生的该分区下的数据,其实是把offset的值直接设置到最后一个消息的位置。例如,有个30条数据的demo的topic,各分区无提交offset,使用了latest,再看offset就会发现已经在30的位置了,所以才只能消费新产生的数据!!!! 手动提交偏移量 不需要定时提交偏移量,可以自己控制offset,当消息已经被我们消费过后,再去手动提交他们的偏移量。这个很适合我们的一些处理逻辑。 手动提交offset的方法有两种:分别是commitSync(同步提交) 和commitAsync(异步提交)。两者的相同点,都会将本次poll的一批数据最高的偏移量提交;不同点是commitSync会失败重试,一直到提交成功(如果有不可恢复的原因导致,也会提交失败),才去拉取新数据。而commitAsync则没有重试机制(提交了就去拉取新数据,不管这次的提交有没有成功),故有可能提交失败。 实例: public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXC:9093"); props.put("group.id","test-11");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000"); // 自动提交时间间隔 props.put("max.poll.records","20"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); consumer.subscribe(Arrays.asList("my-topic")); int i= 0; while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); i++; } if (i == 20){ System.out.println("i_num:"+i); // 同步提交 consumer.commitSync(); // 异步提交 // consumer.commitAsync(); }else { System.out.println("不足二十个,不提交"+i); } i=0; } } 这些都是全部提交偏移量,如果我们想更细致的控制偏移量提交,可以自定义提交偏移量: public static void main(String[] args) throws InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXXXXXX:9093"); props.put("group.id","test-18");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (TopicPartition partition : records.partitions()) { List<ConsumerRecord<String, String>> partitionRecords = records.records(partition); for (ConsumerRecord<String, String> record : partitionRecords) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset(); consumer.commitAsync(Collections.singletonMap(partition, new OffsetAndMetadata(lastOffset + 1)), new OffsetCommitCallback() { @Override public void onComplete(Map<TopicPartition, OffsetAndMetadata> map, Exception e) { for (Map.Entry<TopicPartition,OffsetAndMetadata> entry : map.entrySet()){ System.out.println("提交的分区:"+entry.getKey().partition()+",提交的偏移量:"+entry.getValue().offset()); } } }); } } } 订阅指定的分区 通过消费者Kafka会通过分区分配分给消费者一个分区,但是我们也可以指定分区消费消息,要使用指定分区,只需要调用assign(Collection)消费指定的分区即可: public static void main(String[] args) throws InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXXXXX:9093"); props.put("group.id","test-19");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); // 你可以指定多个不同topic的分区或者相同topic的分区 我这里只指定一个分区 TopicPartition topicPartition = new TopicPartition("my-topic", 0); // 调用指定分区用assign,消费topic使用subscribe consumer.assign(Arrays.asList(topicPartition)); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (TopicPartition partition : records.partitions()) { List<ConsumerRecord<String, String>> partitionRecords = records.records(partition); for (ConsumerRecord<String, String> record : partitionRecords) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset(); consumer.commitAsync(Collections.singletonMap(partition, new OffsetAndMetadata(lastOffset + 1)), new OffsetCommitCallback() { @Override public void onComplete(Map<TopicPartition, OffsetAndMetadata> map, Exception e) { for (Map.Entry<TopicPartition,OffsetAndMetadata> entry : map.entrySet()){ System.out.println("提交的分区:"+entry.getKey().partition()+",提交的偏移量:"+entry.getValue().offset()); } } }); } } } 一旦手动分配分区,你可以在循环中调用poll。消费者分区任然需要提交offset,只是现在分区的设置只能通过调用assign 修改,因为手动分配不会进行分组协调,因此消费者故障或者消费者的数量变动都不会引起分区重新平衡。每一个消费者是独立工作的(即使和其他的消费者共享GroupId)。为了避免offset提交冲突,通常你需要确认每一个consumer实例的groupId都是唯一的。 注意: 手动分配分区(assgin)和动态分区分配的订阅topic模式(subcribe)不能混合使用。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文搞懂 Kubernetes 网络通信原理

接下来,我将用一个系列的文章对 Kubernetes 中的核心技术进行一一的探秘,话不多说,一起进入今天的内容吧。 名词解释 1、网络的命名空间:Linux 在网络栈中引入网络命名空间,将独立的网络协议栈隔离到不同的命名空间中,彼此间无法通信;Docker 利用这一特性,实现不容器间的网络隔离。 2、Veth 设备对:也叫虚拟网络接口对。Veth设备对的引入是为了实现在不同网络命名空间的通信。 3、Iptables/Netfilter:Netfilter 负责在内核中执行各种挂接的规则(过滤、修改、丢弃等),运行在内核 模式中;Iptables模式是在用户模式下运行的进程,负责协助维护内核中 Netfilter 的各种规则表;通过二者的配合来实现整个 Linux 网络协议栈中灵活的数据包处理机制。 4、网桥:网桥是一个二层网络设备,通过网桥可以将 linux 支持的不同的端口连接起来,并实现类似交换机那样的多对多的通信。 5、路由:Linux 系统包含一个完整的路由功能,当IP层在处理数据发送或转发的时候,会使用路由表来决定发往哪里。 令人头大的网络模型 Kubernetes对集群内部的网络进行了重新抽象,以实现整个集群网络扁平化。我们可以理解网络模型时,可以完全抽离物理节点去理解,我们用图说话,先有基本印象。 其中,重点讲解以下几个关键抽象概念。 一个 Service Service 是 Kubernetes 为屏蔽这些后端实例(Pod)的动态变化和对多实例的负载均衡而引入的资源对象。Service 通常与 deployment 绑定,定义了服务的访问入口地址,应用(Pod)可以通过这个入口地址访问其背后的一组由 Pod 副本组成的集群实例。Service 与其后端 Pod 副本集群之间则是通过 Label Selector 来实现映射。 Service的类型(Type)决定了 Service 如何对外提供服务,根据类型不同,服务可以只在Kubernetes cluster中可见,也可以暴露到集群外部。Service有三种类型,ClusterIP,NodePort 和 LoadBalancer。具体的使用场景会在下文中进行阐述。 在测试环境查看: $ kubectl get svc --selector app=nginxNAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGEnginx ClusterIP 172.19.0.166 <none> 80/TCP 1m$ kubectl describe svc nginxName: nginxNamespace: defaultLabels: app=nginxAnnotations: <none>Selector: app=nginxType: ClusterIPIP: 172.19.0.166Port: <unset> 80/TCPTargetPort: 80/TCPEndpoints: 172.16.2.125:80,172.16.2.229:80Session Affinity: NoneEvents: <none> 上述信息中该 svc 后端代理了2个Pod实例:172.16.2.125:80,172.16.2.229:80 二个 IP Kubernetes 为描述其网络模型的 IP 对象,抽象出 Cluster IP和Pod IP的概念。 Pod IP 是 Kubernetes 集群中每个 Pod 的 IP 地址。它是 Docker Engine 根据 docker0网桥的IP地址段进行分配的,是一个虚拟的二层网络。Kubernetes 中 Pod 间能够彼此直接通讯,Pod 里的容器访问另外一个Pod里的容器,是通过Pod IP所在进行通信。 Cluster IP仅作用于 Service,其没有实体对象所对应,因此 Cluster IP 无法被ping通。它的作用是为 Service 后端的实例提供统一的访问入口。当访问 Cluster IP 时,请求将被转发到后端的实例上,默认是轮询方式。Cluster IP 和 Service一样由 kube-proxy 组件维护,其实现方式主要有两种,iptables 和 IPVS。在 1.8 版本后 kubeproxy 开始支持IPVS 方式。在上例中,SVC的信息中包含了Cluster IP。 这里未列出 node ip 概念,由于其本身是物理机的网卡IP。因此可理解为nodeip就是物理机IP。 三个 Port 在 Kubernetes 中,涉及容器,Pod,Service,集群各等多个层级的对象间的通信,为在网络模型中区分各层级的通信端口,这里对Port进行了抽象。 Port 该Port非一般意义上的TCP/IP中的Port概念,它是特指Kubernetes中Service的port,是Service间的访问端口,例如Mysql的Service默认3306端口。它仅对进群内容器提供访问权限,而无法从集群外部通过该端口访问服务。 nodePort nodePort为外部机器提供了访问集群内服务的方式。比如一个Web应用需要被其他用户访问,那么需要配置type=NodePort,而且配置nodePort=30001,那么其他机器就可以通过浏览器访问scheme://node:30001访问到该服务,例如http://node:30001。 targetPort targetPort是容器的端口(最根本的端口入口),与制作容器时暴露的端口一致(DockerFile中EXPOSE),例如 http://docker.io 官方的 nginx 暴露的是80端口。 举一个例子来看如何配置 Service 的 port: kind: ServiceapiVersion: v1metadata: name: mallh5-service namespace: abcdockerspec: selector: app: mallh5web type: NodePort ports: - protocol: TCP port: 3017 targetPort: 5003 nodePort: 31122 这里举出了一个service的yaml,其部署在abcdocker的namespace中。这里配置了nodePort,因此其类型Type就是NodePort,注意大小写。若没有配置nodePort,那这里需要填写ClusterIP,即表示只支持集群内部服务访问。 集群内部通信 单节点通信 集群单节点内的通信,主要包括两种情况,同一个 pod 内的多容器间通信以及同一节点不同 pod 间的通信。由于不涉及跨节点访问,因此流量不会经过物理网卡进行转发。 通过查看路由表,也能窥见一二: root@node-1:/opt/bin# route -nKernel IP routing tableDestination Gateway Genmask Flags Metric Ref Use Iface0.0.0.0 172.23.100.1 0.0.0.0 UG 0 0 0 eth010.1.0.0 0.0.0.0 255.255.0.0 U 0 0 0 flannel.1 #flannel 网络内跨节点的通信会交给 flannel.1 处理10.1.1.0 0.0.0.0 255.255.255.0 U 0 0 0 docker0 #flannel 网络内节点内的通信会走 docker0 1 Pod 内通信 如下图所示: 这种情况下,同一个pod内共享网络命名空间,容器之间通过访问 127.0.0.1:(端口)即可。图中的 veth* 即指veth对的一端(另一端未标注,但实际上是成对出现),该veth对是由 Docker Daemon 挂载在 docker0 网桥上,另一端添加到容器所属的网络命名空间,图上显示是容器中的eth0。 图中演示了 bridge 模式下的容器间通信。docker1 向 docker2 发送请求,docker1,docker2 均与 docker0 建立了 veth 对进行通讯。 当请求经过 docker0 时,由于容器和 docker0 同属于一个子网,因此请求经过 docker2与docker0的veth*对,转发到docker2,该过程并未跨节点,因此不经过eth0。 2 Pod 间通信 同节点 pod 间通信 由于 Pod 内共享网络命名空间(由 pause 容器创建),所以本质上也是同节点容器间的通信。同时,同一 Node 中 Pod 的默认路由都是 docker0 的地址,由于它们关联在同一个 docker0 网桥上,地址网段相同,所有它们之间应当是能直接通信的。来看看实际上这一过程如何实现。如上图,Pod1 中容器 1和容器 2 共享网络命名空间,因此对pod 外的请求通过 pod1 和 Docker0 网桥的 veth对(图中挂在eth0和ethx上)实现。 访问另一个pod内的容器,其请求的地址是PodIP而非容器的ip,实际上也是同一个子网间通信,直接经过veth对转发即可。 跨节点通信 CNI:容器网络接口 CNI 是一种标准,它旨在为容器平台提供网络的标准化。不同的容器平台(比如目前的 kubernetes、mesos 和 rkt)能够通过相同的接口调用不同的网络组件。 目前kubernetes支持的CNI组件种类很多,例如:bridge calico calico-ipam dhcp flannel host-local ipvlan loopback macvlan portmap ptp sample tuning vlan。在docker中,主流的跨主机通信方案主要有一下几种: 1)基于隧道的overlay网络:按隧道类型来说,不同的公司或者组织有不同的实现方案。docker原生的overlay网络就是基于vxlan隧道实现的。ovn则需要通过geneve或者stt隧道来实现的。flannel最新版本也开始默认基于vxlan实现overlay网络。 2)基于包封装的overlay网络:基于UDP封装等数据包包装方式,在docker集群上实现跨主机网络。典型实现方案有weave、flannel的早期版本。 3)基于三层实现SDN网络:基于三层协议和路由,直接在三层上实现跨主机网络,并且通过iptables实现网络的安全隔离。典型的方案为Project Calico。同时对不支持三层路由的环境,Project Calico还提供了基于IPIP封装的跨主机网络实现 通信方式 集群内跨节点通信涉及到不同的子网间通信,仅靠docker0无法实现,这里需要借助CNI网络插件来实现。图中展示了使用flannel实现跨节点通信的方式。 简单说来,flannel的用户态进程flanneld会为每个node节点创建一个flannel.1的网桥,根据etcd或apiserver的全局统一的集群信息为每个node分配全局唯一的网段,避免地址冲突。同时会为docker0和flannel.1创建veth对,docker0将报文丢给flannel.1,。 Flanneld维护了一份全局node的网络表,通过flannel.1接收到请求后,根据node表,将请求二次封装为UDP包,扔给eth0,由eth0出口进入物理网路发送给目的node。 在另一端以相反的流程。Flanneld解包并发往docker0,进而发往目的Pod中的容器。 外部访问集群 从集群外访问集群有多种方式,比如loadbalancer,Ingress,nodeport,nodeport和loadbalancer是service的两个基本类型,是将service直接对外暴露的方式,ingress则是提供了七层负载均衡,其基本原理将外部流量转发到内部的service,再转发到后端endpoints,在平时的使用中,我们可以依据具体的业务需求选用不同的方式。这里主要介绍nodeport和ingress方式。 Nodeport 通过将 Service 的类型设置为 NodePort,就可以在 Cluster 中的主机上通过一个指定端口暴露服务。注意通过 Cluster 中每台主机上的该指定端口都可以访问到该服务,发送到该主机端口的请求会被 Kubernetes 路由到提供服务的 Pod 上。采用这种服务类型,可以在 Kubernetes cluster 网络外通过主机 IP:端口的方式访问到服务。 这里给出一个 influxdb 的例子,我们也可以针对这个模板去修改成其他的类型: kind: ServiceapiVersion: v1metadata: name: influxdbspec: type: NodePort ports: - port: 8086 nodePort: 31112 selector: name: influxdb Ingress Ingress 是推荐在生产环境使用的方式,它起到了七层负载均衡器和 Http 方向代理的作用,可以根据不同的 url 把入口流量分发到不同的后端Service。外部客户端只看到 http://foo.bar.com 这个服务器,屏蔽了内部多个 Service 的实现方式。采用这种方式,简化了客户端的访问,并增加了后端实现和部署的灵活性,可以在不影响客户端的情况下对后端的服务部署进行调整。 其部署的 yaml 可以参考如下模板: apiVersion: extensions/v1beta1kind: Ingressmetadata: name: test annotations: ingress.kubernetes.io/rewrite-target: /spec: rules: - host: test.name.com http: paths: - path: /test backend: serviceName: service-1 servicePort: 8118 - path: /name backend: serviceName: service-2 servicePort: 8228 这里我们定义了一个ingress模板,定义通过 http://test.name.com 来访问服务,在虚拟主机http://test.name.com下面定义了两个Path,其中/test被分发到后端服务s1,/name被分发到后端服务s2。 集群中可以定义多个ingress,来完成不同服务的转发,这里需要一个ingress controller来管理集群中的Ingress规则。Ingress Contronler 通过与 Kubernetes API 交互,动态的去感知集群中 Ingress 规则变化,然后读取它,按照自定义的规则,规则就是写明了哪个域名对应哪个service,生成一段 Nginx 配置,再写到 Nginx-ingress-control的 Pod 里,这个 Ingress Contronler 的 pod 里面运行着一个nginx服务,控制器会把生成的nginx配置写入 /etc/nginx.conf 文件中,然后 reload使用配置生效。 Kubernetes 提供的 Ingress Controller 模板如下: apiVersion: extensions/v1beta1kind: Ingressmetadata: name: test annotations: ingress.kubernetes.io/rewrite-target: /spec: rules: - host: foo.bar.com http: paths: - path: /foo backend: serviceName: s1 servicePort: 80 - path: /bar backend: serviceName: s2 servicePort: 80 总结及展望 本文针对 Kubernetes 的网络模型,从一个 service,二个IP,三个 port 出发进行图解。详解 Kubernetes 集群内及集群外部访问方式。

优秀的个人博客,低调大师

每日一博 | 一文带你熟知 ForkJoin

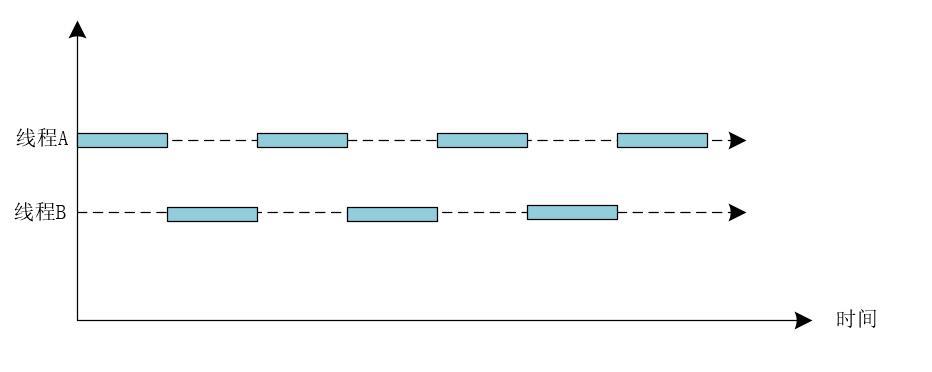
摘要:ForkJoin将复杂的计算当做一个任务,而分解的多个计算则是当做一个个子任务来并行执行。 本文分享自华为云社区《【高并发】什么是ForkJoin?看这一篇就够了!》,作者:冰 河。 在JDK中,提供了这样一种功能:它能够将复杂的逻辑拆分成一个个简单的逻辑来并行执行,待每个并行执行的逻辑执行完成后,再将各个结果进行汇总,得出最终的结果数据。有点像Hadoop中的MapReduce。 ForkJoin是由JDK1.7之后提供的多线程并发处理框架。ForkJoin框架的基本思想是分而治之。什么是分而治之?分而治之就是将一个复杂的计算,按照设定的阈值分解成多个计算,然后将各个计算结果进行汇总。相应的,ForkJoin将复杂的计算当做一个任务,而分解的多个计算则是当做一个个子任务来并行执行。 Java并发编程的发展 对于Java语言来说,生来就支持多线程并发编程,在并发编程领域也是在不断发展的。Java在其发展过程中对并发编程的支持越来越完善也正好印证了这一点。 Java 1 支持thread,synchronized。 Java 5 引入了 thread pools, blocking queues, concurrent collections,locks, condition queues。 Java 7 加入了fork-join库。 Java 8 加入了 parallel streams。 并发与并行 并发和并行在本质上还是有所区别的。 并发 并发指的是在同一时刻,只有一个线程能够获取到CPU执行任务,而多个线程被快速的轮换执行,这就使得在宏观上具有多个线程同时执行的效果,并发不是真正的同时执行,并发可以使用下图表示。 并行 并行指的是无论何时,多个线程都是在多个CPU核心上同时执行的,是真正的同时执行。 分治法 基本思想 把一个规模大的问题划分为规模较小的子问题,然后分而治之,最后合并子问题的解得到原问题的解。 步骤 ①分割原问题; ②求解子问题; ③合并子问题的解为原问题的解。 我们可以使用如下伪代码来表示这个步骤。 if(任务很小){ 直接计算得到结果 }else{ 分拆成N个子任务 调用子任务的fork()进行计算 调用子任务的join()合并计算结果 } 在分治法中,子问题一般是相互独立的,因此,经常通过递归调用算法来求解子问题。 典型应用 二分搜索 大整数乘法 Strassen矩阵乘法 棋盘覆盖 合并排序 快速排序 线性时间选择 汉诺塔 ForkJoin并行处理框架 ForkJoin框架概述 Java 1.7 引入了一种新的并发框架—— Fork/Join Framework,主要用于实现“分而治之”的算法,特别是分治之后递归调用的函数。 ForkJoin框架的本质是一个用于并行执行任务的框架, 能够把一个大任务分割成若干个小任务,最终汇总每个小任务结果后得到大任务的计算结果。在Java中,ForkJoin框架与ThreadPool共存,并不是要替换ThreadPool 其实,在Java 8中引入的并行流计算,内部就是采用的ForkJoinPool来实现的。例如,下面使用并行流实现打印数组元组的程序。 public class SumArray { public static void main(String[] args){ List<Integer> numberList = Arrays.asList(1,2,3,4,5,6,7,8,9); numberList.parallelStream().forEach(System.out::println); } } 这段代码的背后就使用到了ForkJoinPool。 说到这里,可能有读者会问:可以使用线程池的ThreadPoolExecutor来实现啊?为什么要使用ForkJoinPool啊?ForkJoinPool是个什么鬼啊?!接下来,我们就来回答这个问题。 ForkJoin框架原理 ForkJoin框架是从jdk1.7中引入的新特性,它同ThreadPoolExecutor一样,也实现了Executor和ExecutorService接口。它使用了一个无限队列来保存需要执行的任务,而线程的数量则是通过构造函数传入,如果没有向构造函数中传入指定的线程数量,那么当前计算机可用的CPU数量会被设置为线程数量作为默认值。 ForkJoinPool主要使用**分治法(Divide-and-Conquer Algorithm)**来解决问题。典型的应用比如快速排序算法。这里的要点在于,ForkJoinPool能够使用相对较少的线程来处理大量的任务。 比如要对1000万个数据进行排序,那么会将这个任务分割成两个500万的排序任务和一个针对这两组500万数据的合并任务。以此类推,对于500万的数据也会做出同样的分割处理,到最后会设置一个阈值来规定当数据规模到多少时,停止这样的分割处理。 比如,当元素的数量小于10时,会停止分割,转而使用插入排序对它们进行排序。那么到最后,所有的任务加起来会有大概200万+个。问题的关键在于,对于一个任务而言,只有当它所有的子任务完成之后,它才能够被执行。 所以当使用ThreadPoolExecutor时,使用分治法会存在问题,因为ThreadPoolExecutor中的线程无法向任务队列中再添加一个任务并在等待该任务完成之后再继续执行。而使用ForkJoinPool就能够解决这个问题,它就能够让其中的线程创建新的任务,并挂起当前的任务,此时线程就能够从队列中选择子任务执行。 那么使用ThreadPoolExecutor或者ForkJoinPool,性能上会有什么差异呢? 首先,使用ForkJoinPool能够使用数量有限的线程来完成非常多的具有父子关系的任务,比如使用4个线程来完成超过200万个任务。但是,使用ThreadPoolExecutor时,是不可能完成的,因为ThreadPoolExecutor中的Thread无法选择优先执行子任务,需要完成200万个具有父子关系的任务时,也需要200万个线程,很显然这是不可行的,也是很不合理的!! 工作窃取算法 假如我们需要做一个比较大的任务,我们可以把这个任务分割为若干互不依赖的子任务,为了减少线程间的竞争,于是把这些子任务分别放到不同的队列里,并为每个队列创建一个单独的线程来执行队列里的任务,线程和队列一一对应,比如A线程负责处理A队列里的任务。但是有的线程会先把自己队列里的任务干完,而其他线程对应的队列里还有任务等待处理。干完活的线程与其等着,不如去帮其他线程干活,于是它就去其他线程的队列里窃取一个任务来执行。而在这时它们会访问同一个队列,所以为了减少窃取任务线程和被窃取任务线程之间的竞争,通常会使用双端队列,被窃取任务线程永远从双端队列的头部拿任务执行,而窃取任务的线程永远从双端队列的尾部拿任务执行。 工作窃取算法的优点: 充分利用线程进行并行计算,并减少了线程间的竞争。 工作窃取算法的缺点: 在某些情况下还是存在竞争,比如双端队列里只有一个任务时。并且该算法会消耗更多的系统资源,比如创建多个线程和多个双端队列。 Fork/Join框架局限性: 对于Fork/Join框架而言,当一个任务正在等待它使用Join操作创建的子任务结束时,执行这个任务的工作线程查找其他未被执行的任务,并开始执行这些未被执行的任务,通过这种方式,线程充分利用它们的运行时间来提高应用程序的性能。为了实现这个目标,Fork/Join框架执行的任务有一些局限性。 (1)任务只能使用Fork和Join操作来进行同步机制,如果使用了其他同步机制,则在同步操作时,工作线程就不能执行其他任务了。比如,在Fork/Join框架中,使任务进行了睡眠,那么,在睡眠期间内,正在执行这个任务的工作线程将不会执行其他任务了。 (2)在Fork/Join框架中,所拆分的任务不应该去执行IO操作,比如:读写数据文件。 (3)任务不能抛出检查异常,必须通过必要的代码来出来这些异常。 ForkJoin框架的实现 ForkJoin框架中一些重要的类如下所示。 ForkJoinPool 框架中涉及的主要类如下所示。 1.ForkJoinPool类 实现了ForkJoin框架中的线程池,由类图可以看出,ForkJoinPool类实现了线程池的Executor接口。 我们也可以从下图中看出ForkJoinPool的类图关系。 其中,可以使用Executors.newWorkStealPool()方法创建ForkJoinPool。 ForkJoinPool中提供了如下提交任务的方法。 public void execute(ForkJoinTask<?> task) public void execute(Runnable task) public <T> T invoke(ForkJoinTask<T> task) public <T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks) public <T> ForkJoinTask<T> submit(ForkJoinTask<T> task) public <T> ForkJoinTask<T> submit(Callable<T> task) public <T> ForkJoinTask<T> submit(Runnable task, T result) public ForkJoinTask<?> submit(Runnable task) 2.ForkJoinWorkerThread类 实现ForkJoin框架中的线程。 3.ForkJoinTask<V>类 ForkJoinTask封装了数据及其相应的计算,并且支持细粒度的数据并行。ForkJoinTask比线程要轻量,ForkJoinPool中少量工作线程能够运行大量的ForkJoinTask。 ForkJoinTask类中主要包括两个方法fork()和join(),分别实现任务的分拆与合并。 fork()方法类似于Thread.start(),但是它并不立即执行任务,而是将任务放入工作队列中。跟Thread.join()方法不同,ForkJoinTask的join()方法并不简单的阻塞线程,而是利用工作线程运行其他任务,当一个工作线程中调用join(),它将处理其他任务,直到注意到目标子任务已经完成。 我们可以使用下图来表示这个过程。 ForkJoinTask有3个子类: RecursiveAction:无返回值的任务。 RecursiveTask:有返回值的任务。 CountedCompleter:完成任务后将触发其他任务。 4.RecursiveTask<V> 类 有返回结果的ForkJoinTask实现Callable。 5.RecursiveAction类 无返回结果的ForkJoinTask实现Runnable。 6.CountedCompleter<T> 类 在任务完成执行后会触发执行一个自定义的钩子函数。 ForkJoin示例程序 package io.binghe.concurrency.example.aqs; import lombok.extern.slf4j.Slf4j; import java.util.concurrent.ForkJoinPool; import java.util.concurrent.Future; import java.util.concurrent.RecursiveTask; @Slf4j public class ForkJoinTaskExample extends RecursiveTask<Integer> { public static final int threshold = 2; private int start; private int end; public ForkJoinTaskExample(int start, int end) { this.start = start; this.end = end; } @Override protected Integer compute() { int sum = 0; //如果任务足够小就计算任务 boolean canCompute = (end - start) <= threshold; if (canCompute) { for (int i = start; i <= end; i++) { sum += i; } } else { // 如果任务大于阈值,就分裂成两个子任务计算 int middle = (start + end) / 2; ForkJoinTaskExample leftTask = new ForkJoinTaskExample(start, middle); ForkJoinTaskExample rightTask = new ForkJoinTaskExample(middle + 1, end); // 执行子任务 leftTask.fork(); rightTask.fork(); // 等待任务执行结束合并其结果 int leftResult = leftTask.join(); int rightResult = rightTask.join(); // 合并子任务 sum = leftResult + rightResult; } return sum; } public static void main(String[] args) { ForkJoinPool forkjoinPool = new ForkJoinPool(); //生成一个计算任务,计算1+2+3+4 ForkJoinTaskExample task = new ForkJoinTaskExample(1, 100); //执行一个任务 Future<Integer> result = forkjoinPool.submit(task); try { log.info("result:{}", result.get()); } catch (Exception e) { log.error("exception", e); } } } 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

分享 | 一文了解 PG PITR 即时恢复

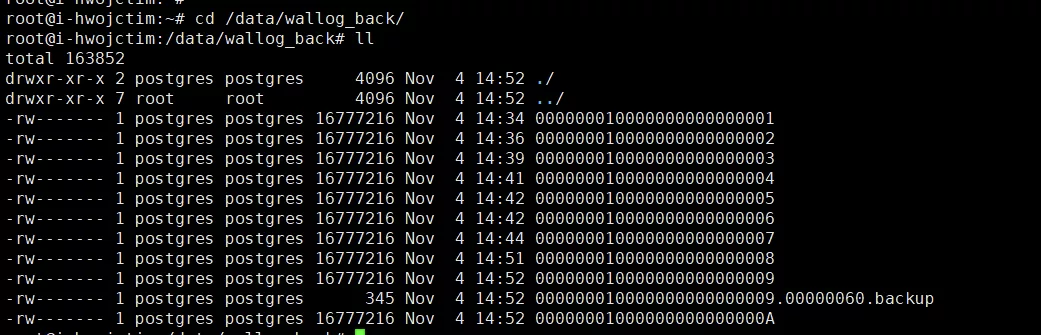
作者:颜博 青云科技数据库研发工程师 目前从事 PostgreSQL 产品开发工作,热衷于 PostgreSQL 数据库的学习和研究 在数据库系统中,数据是一切的基础,数据的安全更是重中之重。但可能因为各种原因导致数据丢失或损坏,因此数据的备份和恢复便显得尤为重要。 PostgreSQL 是一个强大的开源对象关系数据库系统,经过 30 多年的积极开发,在可靠性、功能稳健性和性能方面赢得了良好的声誉。Point-In-Time Recovery(简称 PITR) 是 PostgreSQL 的基于时间点的数据恢复技术,在开启 WAL 日志归档及基础备份后,可以即时恢复用户误操作丢失的数据,为您的数据库加上一重"保险"。 本文将演示 PostgreSQL 如何配置 PITR 数据备份,以及当数据被误删除后如何进行数据即时恢复。 |环境准备 准备数据库 准备 PostgreSQL 11 版数据库环境。 # echo "$PGHOME" 查看 PGHOME=/usr/lib/postgresql/11 # echo "$PGDATA" 查看,PostgreSQL 的数据目录 PGDATA=/data/pgsql/main # pg 命令行执行 show config_file; 命令查看,PostgreSQL 的配置文件位置 PGCONFIG_FILE=/etc/postgresql/11/main/postgresql.conf # PostgreSQL 的启动日志位置,当启动失败时,可以通过日志快速查看报错内容 PG_LOG=/data/pglog/start.log |PITR 数据备份 当用户误删除数据之后,可以通过 PITR 恢复指定的时间戳的数据。下面介绍开启备份及恢复数据的详细步骤。 开启 WAL 日志归档 通过修改配置文件,开启 WAL 日志归档功能。 # 创建保存wal日志归档的目录,并修改目录拥有者 $ mkdir -p /data/wallog_back $ chown -R postgres:postgres /data/wallog_back # 修改 PostgreSQL 数据库配置文件 postgresql.conf $ vim /etc/postgresql/11/main/postgresql.conf # 修改如下配置项: wal_level = archive archive_mode = on archive_command = 'test ! -f /data/wallog_back/%f && cp %p /data/wallog_back/%f' # 配置归档命令,拷贝 wal 文件到指定目录,%p 为实际的 wal 文件目录,%f 为 wal 文件名称 # 保存后重启数据库 root:~# su postgres # stop postgresql server postgres:~$ /usr/lib/postgresql/11/bin/pg_ctl stop # start postgresql server postgres:~$ /usr/lib/postgresql/11/bin/pg_ctl -D /data/pgsql/main/ start -o '-c config_file=/etc/postgresql/11/main/postgresql.conf' -l /data/pglog/start.log 成功保存配置修改,即打开了 WAL 日志归档功能。 准备数据 # 创建测试表 CREATE TABLE test_table( ID INT NOT NULL, NAME TEXT NOT NULL, AGE INT NOT NULL ); # 插入测试数据。通过以下命令,快速插入 200001 条测试数据 insert into test_table(id, name, age) values( generate_series(0,200000), substr(md5(random()::text), 0, 25), generate_series(0,200000) ); 执行基础备份 PostgreSQL 查看当前时间,指定备份时的 lable。 postgres=# select now(); now ------------------------------- 2021-11-04 14:50:42.482253+08 (1 row) 开始备份 # PostgreSQL 命令行执行 postgres=# select pg_start_backup('backup_2021-11-04 14:50:42'); pg_start_backup ----------------- 0/9000060 (1 row) # 切换到 linux 命令行执行 cd /data $ sudo tar -cvzf pgsql.tar pgsql postgres=# select pg_stop_backup(); NOTICE: pg_stop_backup complete, all required WAL segments have been archived pg_stop_backup ---------------- 0/9000168 (1 row) 执行一次 WAL 切换,使得 WAL 日志归档 postgres=# select pg_switch_wal(); pg_switch_wal --------------- 0/A000078 (1 row) 查看归档状态,如果 archived_count 为 0 代表异常,需要查看配置文件是否修改成功或尝试重启 PostgreSQL 服务 postgres=# select * from pg_stat_archiver; 注意: 备份完成后,/data/wallog_back/ 目录下应该有相应的归档文件。 select * from pg_stat_archiver;命令执行完成后,如果 archived_count 为 0,代表归档设置开启失败,请重新检查配置文件或重启服务。 |PITR 数据恢复 模拟误删数据 # 删除 test_table 表中 id 大于 10000 的数据,模拟误删除数据的操作 postgres=# delete from test_table where id>10000; DELETE 190000 # 查询出当前时间,根据此时间确定大概的恢复时间点 postgres=# select now(); now ------------------------------- 2021-11-04 14:56:17.452967+08 (1 row) 即时恢复数据 # 停止数据库运行 $ /usr/lib/postgresql/11/bin/pg_ctl stop # 重命名 pgsql 目录 cd /data mv pgsql pgsql_back # 恢复备份包到 data 目录 sudo tar -zxvf pgsql.tar # 配置 data 目录下的recovery.done文件,如果没有则创建。 restore_command='cp /data/wallog_back/%f %p' # wal归档的目录 recovery_target_time='2021-11-04 14:56:17.452967' # 恢复到此时刻,根据之前的 select now()判断恢复时刻。 recovery_target_timeline='latest' 重新启动数据库 $ /usr/lib/postgresql/11/bin/pg_ctl -D /data/pgsql/main/ start -o '-c config_file=/etc/postgresql/11/main/postgresql.conf' -l /data/pglog/start.log |数据恢复验证 postgres=# select * from test_table; postgres=# select count(*) from test_table; count -------- 200001 (1 row) 如图所示,数据恢复到了 200001 条。 |总结 PITR 在配置一定条件后,可以进行数据的恢复,在误删除数据后,可以帮助我们找回数据。 |参考 https://www.postgresql.org/ https://blog.csdn.net/arcticJian/article/details/102746287 https://my.oschina.net/Kenyon/blog/58112

优秀的个人博客,低调大师

一文搞懂如何实现 Go 超时控制

为什么需要超时控制? 请求时间过长,用户侧可能已经离开本页面了,服务端还在消耗资源处理,得到的结果没有意义 过长时间的服务端处理会占用过多资源,导致并发能力下降,甚至出现不可用事故 Go 超时控制必要性 Go 正常都是用来写后端服务的,一般一个请求是由多个串行或并行的子任务来完成的,每个子任务可能是另外的内部请求,那么当这个请求超时的时候,我们就需要快速返回,释放占用的资源,比如goroutine,文件描述符等。 服务端常见的超时控制 进程内的逻辑处理 读写客户端请求,比如HTTP或者RPC请求 调用其它服务端请求,包括调用RPC或者访问DB等 没有超时控制会怎样? 为了简化本文,我们以一个请求函数 hardWork 为例,用来做啥的不重要,顾名思义,可能处理起来比较慢。 funchardWork(jobinterface{})error{ time.Sleep(time.Minute) returnnil}funcrequestWork(ctxcontext.Context,jobinterface{})error{returnhardWork(job) }复制代码 这时客户端看到的就一直是大家熟悉的画面 绝大部分用户都不会看一分钟菊花,早早弃你而去,空留了整个调用链路上一堆资源的占用,本文不究其它细节,只聚焦超时实现。 下面我们看看该怎么来实现超时,其中会有哪些坑。 第一版实现 大家可以先不往下看,自己试着想想该怎么实现这个函数的超时,第一次尝试: funcrequestWork(ctxcontext.Context,jobinterface{})error{ ctx,cancel:=context.WithTimeout(ctx,time.Second*2) defercancel() done:=make(chanerror) gofunc(){ done<-hardWork(job) }() select{ caseerr:=<-done: returnerr case<-ctx.Done(): returnctx.Err() } }复制代码 我们写个 main 函数测试一下 funcmain(){ consttotal=1000varwgsync.WaitGroup wg.Add(total) now:=time.Now() fori:=0;i<total;i++{ gofunc(){ deferwg.Done() requestWork(context.Background(),"any") }() } wg.Wait() fmt.Println("elapsed:",time.Since(now)) }复制代码 跑一下试试效果 ➜goruntimeout.go elapsed:2.005725931s复制代码 超时已经生效。但这样就搞定了吗? goroutine 泄露 让我们在main函数末尾加一行代码看看执行完有多少goroutine time.Sleep(time.Minute*2) fmt.Println("numberofgoroutines:",runtime.NumGoroutine())复制代码 sleep 2分钟是为了等待所有任务结束,然后我们打印一下当前goroutine数量。让我们执行一下看看结果 ➜goruntimeout.go elapsed:2.005725931s numberofgoroutines:1001复制代码 goroutine泄露了,让我们看看为啥会这样呢?首先,requestWork 函数在2秒钟超时后就退出了,一旦 requestWork 函数退出,那么 done channel 就没有goroutine接收了,等到执行 done <- hardWork(job) 这行代码的时候就会一直卡着写不进去,导致每个超时的请求都会一直占用掉一个goroutine,这是一个很大的bug,等到资源耗尽的时候整个服务就失去响应了。 那么怎么fix呢?其实也很简单,只要 make chan 的时候把 buffer size 设为1,如下: done:=make(chanerror,1)复制代码 这样就可以让 done <- hardWork(job) 不管在是否超时都能写入而不卡住goroutine。此时可能有人会问如果这时写入一个已经没goroutine接收的channel会不会有问题,在Go里面channel不像我们常见的文件描述符一样,不是必须关闭的,只是个对象而已,close(channel) 只是用来告诉接收者没有东西要写了,没有其它用途。 改完这一行代码我们再测试一遍: ➜goruntimeout.go elapsed:2.005655146s numberofgoroutines:1复制代码 goroutine泄露问题解决了! panic 无法捕获 让我们把 hardWork 函数实现改成 panic("oops")复制代码 修改 main 函数加上捕获异常的代码如下: gofunc(){deferfunc(){ifp:=recover();p!=nil{ fmt.Println("oops,panic") } }()deferwg.Done() requestWork(context.Background(),"any") }()复制代码 此时执行一下就会发现panic是无法被捕获的,原因是因为在 requestWork 内部起的goroutine里产生的panic其它goroutine无法捕获。 解决方法是在 requestWork 里加上 panicChan 来处理,同样,需要 panicChan 的 buffer size 为1,如下: funcrequestWork(ctxcontext.Context,jobinterface{})error{ ctx,cancel:=context.WithTimeout(ctx,time.Second*2) defercancel() done:=make(chanerror,1) panicChan:=make(chaninterface{},1) gofunc(){ deferfunc(){ ifp:=recover();p!=nil{ panicChan<-p } }() done<-hardWork(job) }() select{ caseerr:=<-done: returnerr casep:=<-panicChan: panic(p) case<-ctx.Done(): returnctx.Err() } }复制代码 改完就可以在 requestWork 的调用方处理 panic 了。 超时时长一定对吗? 上面的 requestWork 实现忽略了传入的 ctx 参数,如果 ctx 已有超时设置,我们一定要关注此传入的超时是不是小于这里给的2秒,如果小于,就需要用传入的超时,go-zero/core/contextx 已经提供了方法帮我们一行代码搞定,只需修改如下: ctx,cancel:=contextx.ShrinkDeadline(ctx,time.Second*2)复制代码 Data race 这里 requestWork 只是返回了一个 error 参数,如果需要返回多个参数,那么我们就需要注意 data race,此时可以通过锁来解决,具体实现参考 go-zero/zrpc/internal/serverinterceptors/timeoutinterceptor.go,这里不做赘述。 完整示例 packagemainimport( "context""fmt""runtime""sync""time""github.com/tal-tech/go-zero/core/contextx")funchardWork(jobinterface{})error{ time.Sleep(time.Second*10) returnnil}funcrequestWork(ctxcontext.Context,jobinterface{})error{ ctx,cancel:=contextx.ShrinkDeadline(ctx,time.Second*2) defercancel() done:=make(chanerror,1) panicChan:=make(chaninterface{},1) gofunc(){ deferfunc(){ ifp:=recover();p!=nil{ panicChan<-p } }() done<-hardWork(job) }() select{ caseerr:=<-done: returnerr casep:=<-panicChan: panic(p) case<-ctx.Done(): returnctx.Err() } }funcmain(){ consttotal=10varwgsync.WaitGroup wg.Add(total) now:=time.Now() fori:=0;i<total;i++{ gofunc(){ deferfunc(){ ifp:=recover();p!=nil{ fmt.Println("oops,panic") } }() deferwg.Done() requestWork(context.Background(),"any") }() } wg.Wait() fmt.Println("elapsed:",time.Since(now)) time.Sleep(time.Second*20) fmt.Println("numberofgoroutines:",runtime.NumGoroutine()) }复制代码

优秀的个人博客,低调大师

一文读懂云上DevOps能力体系

简介: 阿里云ECS自动化运维套件架构师,深度拆解云上运维能力体系建设:自动化运维等级金字塔、自动化运维的进阶模式、DevOps的基础核心、云上标准化部署三大能力…… 序言 云计算行业已经有十多年的发展了,话题早已从“要不要上云”转向“如何用好云”。“要不要”其实是一个决策性的话题,直到决策出来一个结果了,话题就算结束了。而“如何用好云”却是一个持续性的话题。 一般来说,在规划阶段开始,企业就会开始思考“如何用好云”,这个话题会伴随用云的整个过程。如果简单地从工作类型划分,除了业务代码的研发(Dev),其他的部分都可以称为运维(Ops),包含资源创建(环境部署)、应用部署、资源管理、资源监控、报警、故障排查等工作。 笔者从事云计算工作超过五年时间,参与开发过多款云产品,可以说既是云计算产品的消费者,也是云计算产品的生产者。在这里,笔者谈一谈对云上DevOps能力体系的多年思考和总结,希望对准备上云或是已经上云的运维人员有所帮助。 1 自动化运维等级金字塔 从运维自动化等级和程度来看,DevOps其实是一种非常高级的自动化,不仅自动化程度比较高,而且对于自动化的完成方式有着非常严格的定义。关于运维自动化与DevOps的关系,其实可以非常好地参考汽车自动驾驶技术分级标准,笔者做了个对比图,如图1。 图1:自动化运维等级金字塔 如图1,自动化运维可分为5个等级,分别是手动运维、半手工/半自动化运维、高度自动化、标准化运维和AIOps,分别对应自动化驾驶的6个Level,其中运维自动化L2对应了自动驾驶的Level 1和2。为了方便说明和对比这5个自动化运维等级,请参考如下的表格。 表1:自动化驾驶等级与自动化运维等级对比参考 Level 1:手动运维。一些技术能力一般的企业,在上云初期运维工作主要是纯手动,只能依赖云服务商提供的控制台进行操作。 Level 2:半手工/半自动化运维,运维自动化工作比例还不超过30%。运维人员可以通过命令行(CLI)完成部分运维工作。 Level 3:高度自动化,运维自动化程度可达到50%。企业运维人员会使用云平台的SDK调用API进行日常运维工作,同时自行开发运维系统,但运维系统通常无定制化和平台能力,和内部系统紧耦合。 Level 4:标准化自动化,运维自动化程度超过90%。企业的运维系统已具备平台化、模版化和代码化的能力,可根据自身的运维需求定制化开发系统。与此同时,运维人员已具备使用具备模板化的产品来实现运维工作的标准化和自动化。 Level 5:AIOps,即智能运维,运维自动化程度达100%。不再需要值班人员,生产力完全解放。这是当前很多大型互联网企业的运维目标,也是头部企业重点投入的方向。 2 DevOps 是自动化运维的进阶模式 2.1 模板化是最DevOps的自动化方式 这里,笔者想着重谈一下Level 3-高度自动化运维与Level 4-标准化自动化运维的区别。大多数自研的运维系统是在Level3 类型,例如在内部运维系统上开发了一个功能,可以立即创建10台云服务器,下次需要创建其他资源时,如创建3个消息队列,还是需要额外再开发创建消息队列功能。所以,Level 3-高度自动化运维可以理解为是一个聚焦具体场景的单一“系统”。 而Level 4-标准化自动化运维更具备普遍性,完成了更高一级的抽象。当前,大多数的云平台都提供了自动化部署相关产品,如AWS CloudFormation、阿里云的资源编排工具ROS等,所以Level 4标准化自动化运维系统其实是一个平台型的产品。 使用Level 4阶段的产品创建资源只需要创建一个模板,当需要创建新资源时,只需要套用模板即可,无需额外开发。多提一句,这里说的模板通常是YAML或是JSON文件,最近业界又开始将这类YAML和JSON代码化,面对资源的代码方式,思路和模板还是一致的,对于DevOps先锋者建议可以关注下AWS CDK和Pulumi类的产品。 实现模板化后,即可以将模板的管理方式和代码一致,使用Git等版本控制软件管理起来,使得模板的修改和发布过程可以享受类似代码一样的福利——评审、构建和持续发布,这就是最DevOps的自动化方式。 2.2 模板化或代码化是AIOps基础 AIOps(智能运维)可能是我们所有人的目标,不过理想和现实的差距还是存在的。现阶段的AIOps 只在少数的特定场景下才有,比如弹性扩容场景下,可以对历史扩容数据进行学习后进行预扩容,或用AI的方式来检测某个指标是否异常等,所以AIOps还远没有达到完全自动化的程度。建议在特定场景里可进行AIOps的调研,在方向上对AIOps保持关注即可。 即便如此,笔者还是愿意表达自己的观点,模板化或代码化自动化运维(即Level 4),应该会是AIOps的基础,因为只有所有运维工作都可以被自动化、所有自动化工作都非常规范和标准时,AI才有机会进行学习,AIOps 才可能成为现实。 3 DevOps基础核心:CI/CD,基础设施即代码 通常,云上自动化运维系统的第一步是环境部署,这是基础同时非常重要的一步。一旦部署完成,后续想要再去修改代价会非常大。尤其是上线以后,会是一个环境迁移的工程量了,所以环境部署是最先需要开始设计的。 图2 :CI/CD流水线的系统运行环境 3.1 CI/CD 流水线的系统运行环境 以实际项目中运用DevOps模式的例子——CI/CD流水线应用“基础设施即代码”的实践为例,看一下自动化部署的整个流程。 图3:CI/CD流水线 通常流水线的源头是从Git开始的,所以也有人将这种模式称之为GitOps,显然这里的Git也可以替换成其他的版本控制系统,如SVN等,因为思路是一样的,所以本文依旧称之为DevOps。 相信大家对CI/CD流水线都很熟悉了,如图3,这里的流水线不仅包括了业务代码Repo,还包括了DevOps Repo,那么DevOps Repo应该用来存什么内容的呢?这里重点强调的是系统所依赖的运行环境的配置,这里的运行环境通常也叫“基础设施”,即包括了云服务器、网络、数据库、负载均衡和中间件等业务应用所依赖的系统环境,目录可参考图4。 图4:系统环境目录 在图4中,environment.yml是一个环境所需要的完整模板,modules里是各个资源模块,分别是云服务器、数据库、负载均衡和VPC网络,这里只包含了最最基本的云资源,对于有经验的DevOps工程师还可以增加更多的资源,如消息队列、kafka等中间件,NoSQL类型的数据库以及监控和报警规则。 环境的配置信息可以存储在流水线上,这样在部署时可以先部署环境、后部署业务。那部署环境时,可以根据实际情况选择创建一个新环境或是更新环境。一个环境配置通常包含以下信息: 环境类型:如日常测试环境、预发环境和生产环境。 环境地域:如杭州、北京和上海等。 环境其他参数:如账号、AccessKey/Token和角色等。 资源相关配置:如服务器数量、域名等。 3.2 云上标准化部署三大能力 云上环境与传统数据中心的环境最大的区别是,云上的一切服务是以API为核心,资源的创建、修改和删除等所有操作都可以通过API来完成,因此云上部署是天然的规范化,从而提高了云上的部署效率,即实现了高效而统一的标准化部署。其中,典型的需重复部署的场景有以下四类: 环境部署,如日常测试环境、预发环境和生产环境,只需要构建一个部署,即可以通过新增stage的方式达到重复部署。通常由日常环境开始,然后重复到预发和生产环境。 多地域部署,如先部署在杭州、后需部署到北京和上海等其他地域,可以快速地重复部署。一般只需要在流水线上新增一个新地域stage,添加配置参数即可实现一键部署。 集群部署,如先部署了几个集群,再重复部署多个集群,同样也可以快速地重复部署。可以通过在流水线上新增一个新集群stage,添加配置参数即可实现一键部署。 容灾环境部署,如先部署了一个主要的生产环境,后需要部署一个容灾环境时,采取集群部署的同样方式来实现。 通常,云上高效而标准化部署具备三大能力——消除环境差异、环境的快速复制能力和环境的重建能力。 • 消除环境差异,实现环境一致性。环境的微小差异即可带来业务上非常大的差异,而且排查起来非常困难,比起代码的Debug要费时费力许多,毕竟大部分的代码逻辑可以在本地复现和Debug,但是环境造成的差异则非常繁琐,需要进行非常细致的排查才能找到问题的症结所在。而云上标准化部署能够消除环境差异,实现环境的一致性,大大地简化了运维工作。 • 一键部署,快速复制能力。从日常环境到生产环境,从A地域到B地域,从单集群到多个集群,无一不需要高效的复制能力,而环境的复制能力是其中的第一步,且是最为关键的一步。标准化部署能将原来的数天工作量缩短为几个小时,甚至一键部署的能力,可以说极大地提升了运维效率。 • 重建的能力。很多环境问题是问题历史悠久造成的,各种不规范、不标准的操作日积月累最终导致环境混乱。因此,对于日常测试环境来说,定期地推倒重建是非常有必要的,理由类似自动化测试,越干净的环境越能验证、复现和Debug业务问题。因此,当一个测试环境有问题时,应该可以做到随时释放并能够一键重建。 所以,如果在项目规划阶段就考虑到自动化部署能力,那么后续的部署无疑会平滑许多。然而,对于已经存在的项目是否也可以使用这个模式呢?答案是肯定的,这要求对应的服务有能力将已有的云资源转化成部署模板的能力,然后再根据修改这个模板以便可以重复使用。 4 完整DevOps体系应具备哪些能力? 如果说,100% 自动化是DevOps理想中的形态,那么任何环节的缺失都可能成为实践DevOps的障碍。通常,按照运维工作的流程来看,DevOps 往往会包括八个环节:计划、编码、构建、测试、发布、运维、监控,然后重新回到计划,开始新一轮迭代。 图5:DevOps流程图 值得重点强调的是,利用上述部署模板的方式,也是可以包括监控、报警等设置。因为一切皆是云产品、一切云产品都提供API缘故,因此才成就了部署模板是可以做到统一集中的。 笔者所在的阿里云,DevOps体系不仅环境部署实现了模板化,连运维编排也可以模板化的,即自动化运维(阿里云提供运维编排工具OOS),业界也把这种模式叫做Ops as Code、Automation as Code或是Runbook as Code了。因为产品的设计原则和思想和部署模板一致,所以不再赘述其详细步骤。 作为云计算产品的生产者,笔者同时也从一个云资源的全生命周期梳理了一个DevOps的闭环,如图5。这张图笔者在今年2020云栖大会的分享中也做了阐述,熟悉北京的朋友喜欢用“四环图”来称呼它。 图6:云资源生命周期四环图 一环:最核心的云资源,有服务器类资源,虚拟机服务器和裸金属,也可以包括容器实例。 二环:云服务器的生命周期的六个阶段:创建、镜像、补丁升级、诊断修复、监控和运维和实例配置。 三环:云服务器全生命周期的六个阶段,可以利用不同的工具可以提升效率。如实例的监控和运维,除了有云厂商提供的监控产品外,还有很多第三方的监控产品。运维方面,建议使用自动化运维类产品,如运维编排OOS,可以把最常用的运维任务模板化,从而提供运维的规范性,减少因为人肉执行的失误,避免让运维背锅。 最近,我们已经将三环的这一整套“ECS自动化运维套件”正式对外发布,帮助企业实现从IT架构的规划、迁移、部署、弹性扩缩容,到日常管理全生命周期的自动化运维。利用这套工具,每一家云上的企业都可以低成本构建属于自己的自动化运维体系。 四环:除了使用云平台工具之外,还可以利用第三方的工具,如Terraform、Ansible等。另外,很多工具都不约而同地选择了模版的方式, 如YAML、JSON、Hashicorp自定义的HCL等。基于模板,可以构建一个生态,方便外部的参与者共同贡献内容,不仅丰富了DevOps的世界,最终达到了更高的DevOps效率。 图6不仅包含了阿里云的DevOps工具,也包括了业界较为流行的运维工具,它们的设计思想都是类似的,因此在工具的采用上可以根据实际需要分别采用。一般来说,如果使用的是单一云平台的云资源时,使用云平台一方的产品有着最一致的体验,集成度也最高,成本也是相对最少的。 这里,笔者还想简单提一下容器DevOps和云服务器DevOps的区别。当前,K8S已经是容器编排(管控)领域的事实标准了,几乎所有的云服务商也都实现了各类托管K8S产品,甚至局部的Serverless K8S。 很多云服务器的使用者对于K8S是心向往之,却又因为各种原因需要继续使用云服务器。笔者曾经这样评价过K8S,“K8S本身并不是什么技术上的重大创新,更多的是把DevOps里面的很多最佳实践产品化了”——这一说法也得到了部分容器专家的认同。 5 DevOps落地的阻碍:如何和财务流程实现平衡 事实上,DevOps并不是一个新鲜的概念,但是真正做到DevOps的企业少之又少,背后的原因是多种多样的。以笔者多年的经验看来,其中最大的两个因素:一个是财务,二是运维开发人员的习惯。 财务人员是典型的计划式模式,需先预估、再采购,这里最大的挑战在于没人能够精准地预测明天的事情,所以最终的结果要么是预估多了,要么就是预估少了,预估多了下一次的预估必定要收紧,预估少了再放松,然后循环重复这个过程。 财务上的限制对于DevOps的发展有时是致命的,这种“计划式”的模式直接影响到了云上资源的创建和释放模式,财务上喜欢“包年包月”,因为看起来比较划算,而DevOps运维开发人员则偏向于“按需分配,弹性伸缩”。 所以,笔者最后想呼吁各位财务专家多考虑下,给予技术架构上在预算上一定的灵活性,可以非常有效地帮助并促进业务高速发展。 作者:吴君印 原文链接 本文为阿里云原创内容,未经允许不得转载

优秀的个人博客,低调大师

一文搞懂浏览器同源策略

摘要:同源策略就是指必须在同一个协议,域名,端口号下,而且三者必须一致的。 本文会从以下几个方面讲述同源策略: 第一点 what:什么是同源策略 第二点 why:为什么需要同源策略 第三点 how:如何解决经典的跨域问题 什么是同源策略 什么是同源策略呢?通常一个概念出来之后,我会从生活的实际例子找到解析,你可以想象一下,假如你们家的房子,是不是不允许陌生人进入,如果可以随便进入,那么久有可能被盗了,那么这个时候,锁头和钥匙就出现了为了保证家的安全。 所以我们引出浏览器的同源策略,就是指必须在同一个协议,域名,端口号下,而且三者必须一致的。这个时候,我们就说是同源。 举个例子: https://www.angular.cn:80/guide/inputs-outputs http:// 是我们所说的协议。 www.angular.cn是我们所说的域名。 80 表示端口号。 所以就会牵引出一个问题,不同源的数据交互问题,如果是以下两个链接交互数据,可以通过同源策略的检测: https://www.angular.cn:80/guide/inputs-outputs https://www.angular.cn:80/guide/index 而如果是以下这样的链接交互数据,则不能通过同源策略的检测: http://www.child.a.com/test/index.html ----失败,域名不同 https://www.a.com/test/index.html ----失败,协议不同 http://www.a.com:8080/test/index.html ----失败,端口号不同 有哪些是不受同源策略限制 页面上的链接,比如 a 链接。 重定向。 表单提交。 跨域资源的引入,比如:script, img, link, iframe。 解决跨域问题 既然有同源策略的限制,那么就会产生跨域问题,就是指不同源的脚本在数据交互的时候,会报错,这个过程就是跨域。 那么有什么解决方案? JSONP 解决跨域 CORS 解决跨域 总的来说,这两个比较经典,工作中比较常用,所以先讲讲上面的方案。 JSONP 解决跨域 什么是 JSONP,举个例子,就是a.com/jsonp.html想要获取b.com/main.js的数据,这个时候由于浏览器同源策略,是获取不到数据的,所以我们可以在a.com/jsonp.html创建一个script脚本,http://b.com/main.js?callback=xxx。在main.js中调用这个回调函数xxx,并且以JSON数据形式作为参数传递,完成回调。我们来看看代码: // a.com/jsonp.html中的代码 function addScriptTag(src) { var script = document.createElement('script'); script.setAttribute("type","text/javascript"); script.src = src; document.body.appendChild(script); } window.onload = function () { addScriptTag('http://b.com/main.js?callback=foo'); } //window.onload是为了让页面加载完成后再执行 function foo(data) { console.log(data.name+"欢迎您"); }; //b.com/main.js中的代码 foo({name:"hl"}) 存在以下几点问题: 只能使用 GET 请求方式,无法使用 POST 请求方式。 可能被注入恶意代码,篡改页面内容,可以采用字符串过滤来规避此问题。 CORS 解决跨域 CORS是一个W3C标准,全称是"跨域资源共享"(Cross-origin resource sharing)。 它允许浏览器向跨源服务器,发出XMLHttpRequest请求,从而克服了AJAX只能同源使用的限制。 刚才的例子中,在b.com里面添加响应头声明允许a.com的访问,代码: Access-Control-Allow-Origin: http://a.com 然后a.com就可以用ajax获取b.com里的数据了。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册