首页 文章 精选 留言 我的

精选列表

搜索[软件构建],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— 使用 Maven 构建 Storm 应用

在开发拓扑的时候,你需要在 classpath 中包含 Storm 的相关 jar 包。你可以将各个 jar 包直接包含到你的项目的 classpath 中,也可以使用 Maven 将 Storm 添加到依赖项中。Storm 已经集成到 Maven 的中心仓库中。你可以在项目的 pom.xml 中添加以下依赖来将 Storm 包含进项目中: <dependency> <groupId>org.apache.storm</groupId> <artifactId>storm-core</artifactId> <version>0.9.3</version> <scope>provided</scope> </dependency> 这里有一个 Storm 项目的 pom.xml 文件的例子(依赖中的版本号与实际 Storm 发行版相关,目前最新的正式版本为 0.9.5 —— 译者注)。 Storm 开发 如果对 Storm 的开发很感兴趣,请参考DEVELOPER一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

如何在阿里云上构建高可用应用

业务高可用是我们每个项目的需求,一个经常故障的项目,会让我们觉得不靠谱而选择放弃,从而导致项目的失败。今天,我们来聊一聊,如何让你自己的业务能够更加稳固的运行! 本次我们从四个不同的角度,来分析,如何让我们的应用更加稳固,平稳运行。 一、 程序架构 优秀的代码 优秀的代码非常重要,即使我们拥有最好的硬件资源和架构,如果我们没有一套健壮的代码,其他资源再好都没有用,所以代码在设计和编写时,应当注意代码的健壮程度。优秀的代码不止开发起来方便,同时维护成本也较低,对于后续的优化来说,健壮的代码会让优化人员更加容易的找到问题的关键。 合理的架构 一个大型的、负载的单体应用可能会让你的整个开发进度缓慢、部署困难。所以,为了解决这种问题,不妨在开发初期便将应用程序设计为微服务架构的程序,虽然可能会提升程序之间的沟通难度,但却为你的应用提供了

优秀的个人博客,低调大师

docker(6):使用dokcer 构建 mariadb 数据库

本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/53540615 未经博主允许不得转载。 博主地址是:http://blog.csdn.net/freewebsys 1,关于mariadb 其实就是mysql的另外一个开源项目。不想被oracle控制的开源版本。 这里有个方便的做法,使用docker的官方的镜像。 自己弄镜像还需要安装,编译配置啥的。 这个特别的省事。只要下载安装就可以了。 项目地址: /mariadb/”>https://hub.docker.com/r//mariadb/ 2,下载使用 首先下载本地镜像,然后启动就行了。 1),参考文档 如果系统开启了SELinux 需要设置文件夹权限,否则mariadb启动不了。 mkdir -p /data/mysql/data chcon -Rt svirt_sandbox_file_t /data/mysql/data docker run -v /data/mysql/data:/var/lib/mysql -p 3306:3306 -e MYSQL_ROOT_PASSWORD=root --name mariadb -d mariadb:latest MYSQL_ROOT_PASSWORD 是设置root的密码。 然后使用docker ps查看: 启动成功,并且绑定了端口 3306 可以使用mysql了。 docker exec -it mariadb bash root@XXXX:/# mysql -uroot -proot 可以使用mysql了。 Welcome to the MariaDB monitor. Commands end with ; or \g. Your MariaDB connection id is 3 Server version: 10.1.19-MariaDB-1~jessie mariadb.org binary distribution Copyright (c) 2000, 2016, Oracle, MariaDB Corporation Ab and others. Type 'help;' or '\h' for help. Type '\c' to clear the current input statement. MariaDB [(none)]> show databases; +--------------------+ | Database | +--------------------+ | information_schema | | mysql | | performance_schema | +--------------------+ 3 rows in set (0.00 sec) MariaDB [(none)]> 3,总结 本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/53540615 未经博主允许不得转载。 博主地址是:http://blog.csdn.net/freewebsys 使用一个最简单的办法安装了mariadb。并且将数据放到了,宿主的/data/mysql/data 目录下面了。 方便数据备份。数据迁移,同时暴露了3306端口对外。 使用docker还是非常的方便的,比起yum安装配置简单多了。 配置文件也可以通过目录映射的方式修改。 而且完全的拆分了服务,存储,接口。真的是一个集装箱了。

优秀的个人博客,低调大师

iOS 高性能异构滚动视图构建方案 —— LazyScrollView

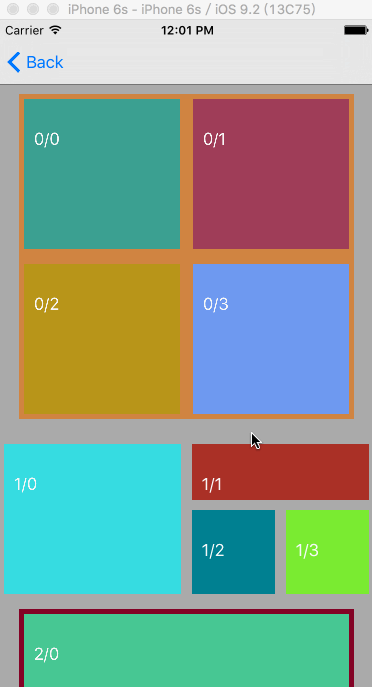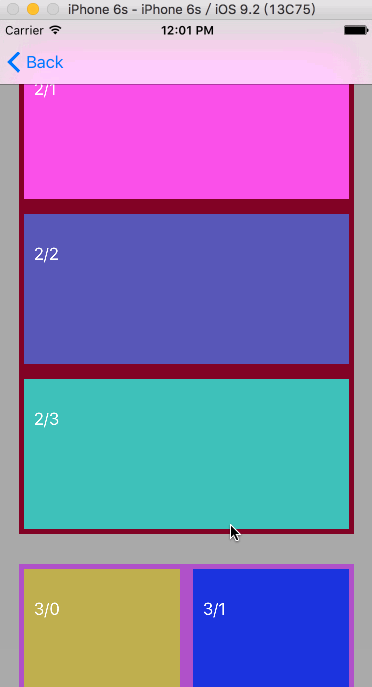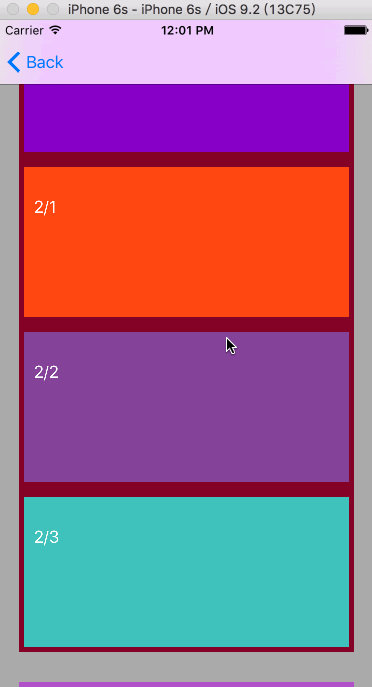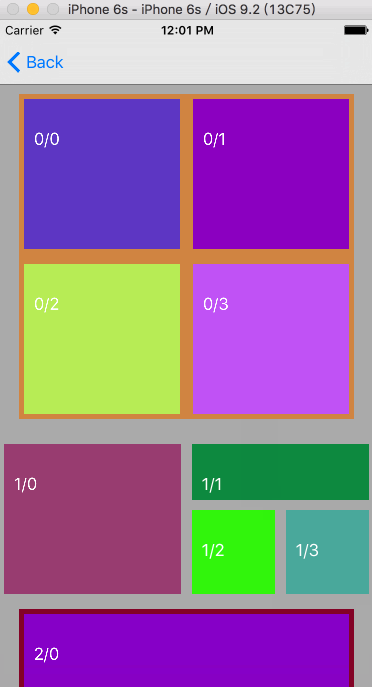
##LazyScroll是什么 LazyScrollView 继承自ScrollView,目标是解决异构(与TableView的同构对比)滚动视图的复用回收问题。它可以支持跨View层的复用,用易用方式来生成一个高性能的滚动视图。此方案最先在天猫iOS客户端的首页落地。 为什么要用LazyScrollView 猫客首页之前首页的View比较少,不需要复用和回收也有很优秀的性能,但是之后首页的View数量逐渐膨胀,没有一套复用回收机制的ScrollView已经影响到性能了,迫切需要处理对ScrollView中View的复用和回收。 使用TableView只能用来解决同类Cell的展示,而在猫客首页这个ScrollView里面,View的种类太多了。不适合我们的场景。 而UICollectionView本身的布局和复用回收机制不够灵活,用起来也较为繁琐。并且本来猫客的首页就有一套相对成熟的卡片布局方案。所以诞生了LazyScrollView去解决这个问题。 LazyScroll如何用 LazyScrollView的使用和TableView很像,不过多了一个需要实现的方法:返回对应index的View 相对LazyScrollView的绝对坐标。 实现LazyScrollViewDatasource 类似TableView的用法,我们需要使用方实现LazyScrollViewDatasource这个Delegate @protocol TMMuiLazyScrollViewDataSource <NSObject> @required //ScrollView一共展示多少个item - (NSUInteger)numberOfItemInScrollView:(TMMuiLazyScrollView *)scrollView; //要求根据index直接返回RectModel - (TMMuiRectModel *)scrollView:(TMMuiLazyScrollView *)scrollView rectModelAtIndex:(NSUInteger)index; //返回下标所对应的view - (UIView *)scrollView:(TMMuiLazyScrollView *)scrollView itemByMuiID:(NSString *)muiID; @end LazyScrollView的核心是在初始状态就得知所有View应该显示的位置。这个Protocol可以让LazyScrollView获取到这些信息。 第一个方法很简单,获取LazyScrollView中item的个数。 第二个方法需要按照Index返回TMMuiRectModel,它会携带对应index的View 相对LazyScrollView的绝对坐标。TMMuiRectModel是这么个东西: @interface TMMuiRectModel:NSObject //转换后的绝对值rect @property (nonatomic,assign) CGRect absRect; //业务下标 @property (nonatomic,copy) NSString *muiID; @end absRect是LazyScroll中的View相对LazyScrollView的绝对坐标,muiID是这个View在LazyScrollView中唯一的标识符,可赋值也可不赋值,不赋值的话LazyScroll会处理成转换为字符串的下标。如果这个标识符在Protocol的第三个方法中会用到。 第三个方法,返回View。首先,我们在UIView之外加了一个Category: @interface UIView(TMMui) //索引过的标识,在LazyScrollView范围内唯一 @property (nonatomic, copy) NSString *muiID; //重用的ID @property (nonatomic, copy) NSString *reuseIdentifier; 这个category可以让View携带muiID和reuseIdentifier,对于返回的View来说,只需要在乎对View的reuseIdentifier赋值,muiID的赋值会在lazyScrollView中处理掉。reuseIdentifier相同的View会被复用,如果这个View的reuseIdentifier是nil或者空字符串,则不会被复用。 调用核心API - (void)reloadData; 重新走一遍DataSource的这些方法,等同于TableView中的reloadData - (UIView *)dequeueReusableItemWithIdentifier:(NSString *)identifier 根据identifier获取可以复用的View。和TableView的dequeueReusableCellWithIdentifier:(NSString *)identifier方法意义相同。通常是在LazyScrollViewDatasource第三个方法,返回View的时候使用。先尝试获取复用池中的View,如果没有再去新建。 LazyScrollView的内部实现 这是一个Demo, 被复用的View,标记的backgroundColor会和之前生成的时候有所不同。 STEP 1 根据DataSource获取所有的TMMuiRectModel 根据DataSource的Delegate,拿到所有的View应该被显示的位置。这一步,核心是拿到的位置是确定的。 根据Demo,我们观察从 0/1 - 2/3 之间这些View 这个时候LazyScrollView拿到的Rect如下: Index 标号(MUIID) Rect 0 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 1 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) 2 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 3 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 4 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 5 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 6 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 7 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 8 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 9 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 10 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) STEP 2 排序 拿到了这些位置之后,接下来做的事情就是排序。排序生成的索引会有两个:根据顶边(y)升序排序的索引和根据底边(y+height)降序排序的索引。 根据顶边(y)升序排序的索引 RANK 标号(MUIID) Rect 0 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 1 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) 2 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 3 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 4 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 5 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 6 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 7 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 8 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 9 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 10 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) 根据底边(y+height)降序排序的索引 RANK 标号(MUIID) Rect 0 2/2 origin = (x = 25, y = 860), size = (width = 325, height = 150) 1 2/1 origin = (x = 25, y = 695), size = (width = 325, height = 150) 2 2/0 origin = (x = 25, y = 530), size = (width = 325, height = 150) 3 1/0 origin = (x = 5, y = 360), size = (width = 177.5, height = 150) 4 1/2 origin = (x = 192.5, y = 360), size = (width = 177.5, height = 56) 5 1/3 origin = (x = 286.5, y = 426), size = (width = 83.5, height = 84) 6 1/1 origin = (x = 192.5, y = 426), size = (width = 84, height = 84) 7 0/2 origin = (x = 25, y = 180), size = (width = 156, height = 150) 8 0/3 origin = (x = 194, y = 180), size = (width = 156, height = 150 9 0/0 origin = (x = 25, y = 15), size = (width = 156, height = 150 10 0/1 origin = (x = 194, y = 15), size = (width = 156, height = 150) STEP 3 查找 前两步是在执行完reload,在视图还没有生成的时候就开始做了,而接下来的步骤在要生成视图(初始化或滚动的时候)才会去做。 我们设定了Buffer为上下各20,滚动超过20个像素后才会指定查找视图并显示的动作。 接下来就是找哪些View应该被显示了。举个例子,如下图,红圈是应该显示的区域。 现在已知的是红圈顶边y是242,底边y是949,加上缓冲区Buffer,应该是找222 - 969之间的View。我们要做的是,找到底边y小于969的Model和顶边y大于222的Model,取交集,就是我们要显示的View 采用的方法为二分查找,在根据顶边升序排序的索引中找949,找到的index为0(MUIID为2/2),我们使用一个Set,把根据顶边排序中index >= 0的元素先放在这里。获取的Set中包含的muiID为0/0,0/1,0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2。 根据底边排序的索引中找222,找到的index为2,我们把index >= 2的元素放在另一个Set,获取的Set中包含的muiID为0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2 两个Set取交集,得到的就是我们的ResultSet,这里面都是我们要显示View的Model,它们的muiID是0/2,0/3,1/0,1/1,1/2,1/3,2/0,2/1,2/2。 STEP 4 回收、复用、生成 我们知道了应该显示哪些View,但是我们之后做的第一步是把不需要显示的View加入到复用池中。 LazyScroll可以取到当前显示了的View,拿当前显示的View的muiID和将要显示view的Model的muiID做对比,可以知道当前显示的View哪些应该被回收。 LazyScrollView中有一个Dictionary,key是reuseIdentifier,Value是对应reuseIdentifier被回收的View,当LazyScrollView得知这个View不该再出现了,会把View放在这里,并且把这个View hidden掉。 接下来,LazyScrollView会去调用datasource的- (UIView *)scrollView:(TMMuiLazyScrollView *)scrollView itemByMuiID:(NSString *)muiID;复用还是不复用,是由datasource决定的。如果要复用,需要datasource方法内调用- (UIView *)dequeueReusableItemWithIdentifier:(NSString *)identifier获取复用的View,这个方法取出来的View就是在上一段所说的Dictionary中拿的。 这样,我们就完成了一次完整的循环 : 找到所有View将要显示的位置 – 排序 – 查找应该显示的View – 回收 – 创建/复用。 ##最后 LazyScroll的复用和回收能力是比较强大的,在猫客首页使用之后,因为View数量而导致内存过多的问题得到了解决。 在这套复用和回收机制的加持之下,我们将LazyScrollView继续延伸,构造出一套完整的布局解决方案Tangram,它将Native中View的布局方式变得更动态化,敬请期待。


优秀的个人博客,低调大师

Spark 的 Shell操作,核心概念,构建独立应用

1:Spark中的Python和Scala的shell 2:Spark核心概念简介 3:独立应用 4:Spark数据集 一:Spark中的Python 和Scala 的shell 1:shell设置显示日志 进入Spark的安装目录,启动spark的集群,输入bin/pyspark,但此时会伴有大量的日志信息,在这里想要缩减启动信息的显示,可以调整日志的级别来控制输出的信息量,在conf目目录下创建log4j.properties的文件来管理系统日志设置,Spark开发者默认在conf下已经加入了日志设置的模板,为 log4l,proper.template,赋值一份修改为 log4j.properties找到 log4j.rootCategory=INFO,console 然后通过下面的设定降低日志的优先级,只显示警告和更严重的信息 log4j.rootCategory=WARN,console 2:利用python-shell进行行数统计 >>> lines = sc.textFile("file:///usr/local/hadoop/spark/README.md") #创建一个lines的RDD >>> lines.count() #统计RDD中元素的个数 95 >>> lines.first() #返回RDD中的第一个元素,也就是README.md的第一行 u'# Apache Spark' >>> 需要注意的是这里的文件路径,如果是本地文件,需要加上 file:// 若是hdfs文件则路径为:hdfs://ip:9000/xxx/xxx textFile的参数是一个path,这个path可以是: 1. 一个文件路径,这时候只装载指定的文件 2. 一个目录路径,这时候只装载指定目录下面的所有文件(不包括子目录下面的文件) 3. 压缩文件读取,如 textFile(”/my/directory/*.gz“) 注意必须是gzip压缩的 4. 通过通配符的形式加载多个文件或者加载多个目录下面的所有文件 第四点是一个使用小技巧,现在假设我的数据结构为先按天分区,再按小时分区的,在hdfs上的目录结构类似于: /user/hdfs/input/dt=20130728/hr=00/ /user/hdfs/input/dt=20130728/hr=01/ ... /user/hdfs/input/dt=20130728/hr=23/ 具体的数据都在hr等于某个时间的目录下面,现在我们要分析20130728这一天的数据,我们就必须把这个目录下面的所有hr=*的子目录下面的数据全部装载进RDD,于是我们可以这样写:sc.textFile("hdfs://n1:8020/user/hdfs/input/dt=20130728/hr=*/"),注意到hr=*,是一个模糊匹配的方式。 3:Scala进行函数统计 scala> val lines = sc.textFile("file:///usr/local/hadoop/spark/README.md") lines: org.apache.spark.rdd.RDD[String] = file:///usr/local/hadoop/spark/README.md MapPartitionsRDD[1] at textFile at <console>:27 scala> lines.count() res0: Long = 95 scala> lines.first() res1: String = # Apache Spark scala> 二:Spark核心概念简介 1:RDD(弹性分布数据集) RDD是Spark的最基本抽象,是对分布式内存的抽象使用,实现了以操作本地集合的方式来操作分布式数据集的抽象实现。RDD是Spark最核心的东西,它表示已被分区,不可变的并能够被并行操作的数据集合,不同的数据集格式对应不同的RDD实现。RDD必须是可序列化的。RDD可以cache到内存中,每次对RDD数据集的操作之后的结果,都可以存放到内存中,下一个操作可以直接从内存中输入,省去了MapReduce大量的磁盘IO操作。这对于迭代运算比较常见的机器学习算法, 交互式数据挖掘来说,效率提升比较大。 RDD的特点: (1). 它是在集群节点上的不可变的、已分区的集合对象。 (2). 通过并行转换的方式来创建如(map, filter, join,etc)。 (3). 失败自动重建。 (4). 可以控制存储级别(内存、磁盘等)来进行重用。 (5). 必须是可序列化的。 (6). 是静态类型的。 RDD创建的两种方式 (1):从Hadoop文件系统(或与Hadoop兼容的其它存储系统)输入(例如HDFS)创建 (2):从父RDD转换得到新RDD 2:驱动器程序(driver program) 每个spark应用用驱动器程序发起集群上的各种并行操作,包含了应用的main函数,并定义了集群上的分布式数据集,还对这些分布式数据集应用了相关操作 驱动器程序通过一个sparkContext对象来访问Spark,这个对象代表对计算机集群的一个连接,shell在启动时就已经创建了一个SparkContext对象,是一个sc变量,一旦有了SparkContext就可以用它来创建RDD(弹性分布数据集) 3:执行器(executor) 在Worker Node上为某Application启动一个进程,该进程负责运行任务,并且负责将数据存在硬盘或者内存中;每个Application都有各自独立的executors; 比如:应用A在一个Node上启动Executor,B应用也在同一个Node上启动Executor,他们各自的Executor是相互隔离的,运行在不同的JVM上。不同的应用对应不同的Executor; 4:Application 基于spark的用户程序,包含了一个Driver Program以及集群上中多个executor; spark中只要有一个sparkcontext就是一个application; 启动一个spark-shell也是一个application,因为在启动shark-shell时就内置了一个sc(SparkContext的实例); 5:Cluster Manager 在集群上获取资源的外部服务。如:standalone、yarn、mesos; 各种不同的集群的区别:只是任务调度的粗细粒度不同,对学习spark没有影响,自己在学习时使用standalone即可; 6:Worker Node 集群中任何一个可以运行Application代码的节点; 可以在Worker Node启动Executor进程; 7:Job 包含很多task的并行计算,spark中的一个action对应一个job,如:collect、count、saveAsTextFile; 用户提交的Job会提交给DAGScheduler,Job会被分解成Stage(TaskSet) DAG; RDD的transformation只会记录对元数据的操作(map/filter),而并不会真正执行,只有action触发时才会执行job; 8:Stage 每个Job会被拆分成多组任务,每组任务被称为一个Stage,可称为TaskSet; 一个stage的边界往往是从某个地方取数据开始(如:sc.readTextFile),在shuffle时(如:join、reduceByKey等)终止; 一个job的结束(如:count、saveAsTextFile等)往往也是一个stage的边界; 有两种类型的Stage:shuffle和result; 9:Task 被送到executor上的工作单元; 在Spark中有两类Task:shuffleMapTask和ResultTask,第一类Task的输出是shuffle所需数据,第二类task的输出是result; stage的划分也以此为依据,shuffle之前的所有变换是一个stage,shuffle之后的操作是另一个stage; 比如:rdd.parallize(1 to 10).foreach(println)这个操作没有shuffle,直接就输出了,那么它的task就是resulttask,stage也只有一个; 如果rdd.map((x,1)).reduceByKey(_+_).foreach(println),这个job因为有reduce,所以有个一shuffle过程,那么reduceByKey之前是一个stage,执行shuffleMapTask,输出shuffle所需要的数据,reduceByKey到最后是一个stage,直接就输出结果了。 如果一个job中有多次shuffle,那么每个shuffle之前都是一个stage; 10:Partition partition类似hadoop的split,计算是以partition为单位进行的 三:独立应用 1:Python中初始化Spark from pyspark import SparkConf, SparkContext conf = SparkConf().setMaster("local").setAppName("My App") sc = SparkContext(conf = conf) #<span style="font-family:Microsoft YaHei;">以上为初始化sc</span> line = sc.textFile("file:///usr/local/hadoop/spark/README.md") print line.count() print line.first() 执行:bin/spark-submit my_script.py 运行结果: 2:Scala中初始化Spark import org.apache.spark.SparkConf import org.apache.spark.SparkContext import org.apache.spark.SparkContext_ val conf = new SparkConf().setMaster("local").setAppName("My App") val sc = new SparkContext(conf) 3:在Java中初始化Spark import org.apache.spark.SparkConf import org.apache.spark.api.java.JavaSparkContext SparkConf conf = new SparkConf().setMaster("local").setAppName("My App") JavaSparkContext sc = new JavaSparkContext(conf) 四:Spark数据集 – Spark 可以将任何 hadoop 所支持存储资源转化成 RDD ,如本地文件、 HDFS 、 Cassandra 、 HBase, Amazon S3 等。 – Spark 支持 text files, SequenceFiles 和任何 Hadoop InputFormat 格式 ●使用 textFile() 方法可以将本地文件或 HDFS 文件转换成 RDD – 如果读取本地文件,各节点都要有该文件;或者使用网络共享文件 – 支持整个文件目录读取,如 textFile("/my/directory") – 压缩文件读取,如 textFile("/my/directory/*.gz") – 通配符文件读取,如 textFile("/my/directory/*.txt") – textFile() 有可选的第二个参数 slice ,默认情况下,为每个 block 创建一个分片,用户也可以通过 slice 指定更多的分片, 但不能使用少于 block 数的分片 ●使用 wholeTextFiles() 读取目录里面的小文件,返回 ( 文件名,内容 ) 对 ●使用 sequenceFile[K,V]() 方法可以将 SequenceFile 转换成 RDD ●使用 hadoopRDD() 方法可以将其他任何 Hadoop 的输入类型转化成 RDD

优秀的个人博客,低调大师

Spark-构建基于Spark的推荐引擎

推荐引擎 推荐引擎就是是预测人们可能喜好的物品并通过探寻物品之间的联系来辅助这个过 程。从这点上来说,它同样也做预测的搜索引擎互补。但与搜索引擎不同,推荐引擎试图向人 们呈现的相关内容并不一定就是人们所搜索的,其返回的某些结果甚至人们都没听说过。推荐引擎试图对用户与某类物品之间的联系建模。比如上一个博客案 例中,我们使用推荐引擎来告诉用户有哪些电影他们可能会喜欢。如果这点做得很好,就能吸引 用户持续使用我们的服务。这对双方都有好处。同样,如果能准确告诉用户有哪些电影与某一电 影相似,就能方便用户在站点上找到更多感兴趣的信息。这也能提升用户的体验、参与度以及站 点内容对用户的吸引力。 实际上,推荐引擎的应用并不限于电影、书籍或是产品。 推荐引擎很适合如下两类常见场景(两者可兼有)。 可选项众多 可选的物品越多,用户就越难找到想要的物品。如果用户知道他们想要什 么,那搜索能有所帮助。然而最适合的物品往往并不为用户所事先知道。这时,通过向 用户推荐相关物品,其中某些可能用户事先不知道,将能帮助他们发现新物品。 偏个人喜好 当人们主要根据个人喜好来选择物品时,推荐引擎能利用集体智慧,根据 其他有类似喜好用户的信息来帮助他们发现所需物品。 任务:  使用上述模型来为用户进行推荐和求指定物品的类似物品(即相关物品);  应用标准的评估指标来评估该模型的预测能力。 推荐模型的分类 基于内容的过滤 协同过滤 代码 提取有效特征 训练推荐模型 使用推荐模型 推荐模型效果的评估 代码:github.com/jinhang

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册