ConcurrentHashMap 源码分析
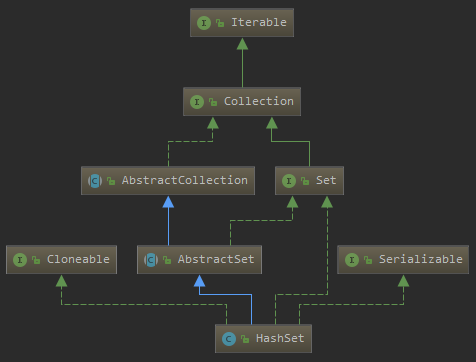
和 HashMap 不同的是,ConcurrentHashMap 采用分段加锁的方式保障线程安全,JDK 1.8 之后,ConcurrentHashMap 的底层数据结构从 1.8 开始跟 HashMap 差不多。 HashTable 也是线程安全的,存储 Key-Value 键值对的数据结构,Key 和 Value 都不能为空,但不推荐使用,因为其所有的方法采用 synchronized 修饰,效率低。 Key 和 Value 都不能为 Null 的原因是:如果 map.get(key) 返回 null,可以认为是 value 的值本来就是 null,也可以认为 map 中不存在 key 的存储数据,因此具有二义性,但 HashMap 在单线程环境,可以通过 map.containsKey(key) 判断,消除而已性。 但在多线程环境中,map.get(key) 和 map.containsKey(key) 是非原子的操作,可能在线程 A 的两个语句运行之间,其他线程 B 运行 map.put(key,value),导致线程 A 无法消除上面的二义性。 参考 https://www.cnblogs.com/thisiswhy/p/12059240.html 下图是 ConcurrentHashMap 的 UML 关系图。 1、底层存储结构 1.1、JDK 1.7 的存储结构,了解即可 在 JDK 1.7 ,ConcurrentHashMap 通过对 Segment 的分段加锁实现线程安全。一个 Segment 里面就是 HashMap 的存储结构,可以扩容。Segment 的数据量初始化以后不可以更改,默认值 16,因此默认支持 16 个线程同时操作 ConcurrentHashMap。 1.2 JDK 1.8 的存储结构 JDK 1.8 之后,存储结构变化比较大,跟 HashMap 类似。红黑树节点小于某个数(默认值 6) 又会转换为链表。 [ ] ConcurrentHashMap的主要成员变量,类似 HashMap,补上注释 2、ConcurrentHashMap 的构造方法 ConcurrentHashMap 的默认构造容量为 16,在初始化的时候并不会初始化 table 数组。同 HashMap 一样,在 put 第一个元素的时候才会 initTable() 初始化数组。 /** Creates a new, empty map with the default initial table size (16). */ public ConcurrentHashMap() { } // 设置初始化大小的构造函数 public ConcurrentHashMap(int initialCapacity) { this(initialCapacity, LOAD_FACTOR, 1); } // 根据传入的 map 初始化 public ConcurrentHashMap(Map<? extends K, ? extends V> m) { this.sizeCtl = DEFAULT_CAPACITY; putAll(m); } // 设置初始容量和加载因子的大小 public ConcurrentHashMap(int initialCapacity, float loadFactor) { this(initialCapacity, loadFactor, 1); } // 初始容量、加载因子、并发级别 public ConcurrentHashMap(int initialCapacity, float loadFactor, int concurrencyLevel) { // 数据校验 if (!(loadFactor > 0.0f) || initialCapacity < 0 || concurrencyLevel <= 0) throw new IllegalArgumentException(); // 如果初始容量小于并发级别 if (initialCapacity < concurrencyLevel) // Use at least as many bins initialCapacity = concurrencyLevel; // as estimated threads // 一些比较 long size = (long)(1.0 + (long)initialCapacity / loadFactor); int cap = (size >= (long)MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : tableSizeFor((int)size); this.sizeCtl = cap; } 3、get、put 方法 3.1 get 方法,根据 key 找 value,没有返回 null get 的流程总体和 HashMap 差不多,只不过是通过头结点的 hash 值判断是红黑树还是链表。 static final int MOVED = -1; // 转发节点? TODO 作用? static final int TREEBIN = -2; // 跟节点 static final int RESERVED = -3; // 临时保留的节点? TODO 作用? static final int HASH_BITS = 0x7fffffff; // hash 的扰动函数 spread() 计算用的 // 根据 key 获取 value 值 public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; // 计算 hash 值 int h = spread(key.hashCode()); // 集散所在的 hash 桶 if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { // 头结点,刚好是要找的节点 if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) // 头结点 hash 值小于 0,说明正在扩容或者是红黑树,find 查找 return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { // 链表遍历查找 if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 3.2、put 方法 put 方法的流程跟 HashMap 的流程差不多,不同点在于线程安全,自旋,CAS,synchronized onlyIfAbsent 如果为 true ,如果已经存在了 key,不会替换旧的值。 public V put(K key, V value) { return putVal(key, value, false); } /** Implementation for put and putIfAbsent */ final V putVal(K key, V value, boolean onlyIfAbsent) { // key 和 value 都不能为 null if (key == null || value == null) throw new NullPointerException(); // 计算 hash(key) 的扰动函数 int hash = spread(key.hashCode()); // 离岸边的长度 int binCount = 0; for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; K fk; V fv; // 如果 table 还没有初始化,就初始化 table (自旋+CAS) if (tab == null || (n = tab.length) == 0) tab = initTable(); else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { // 如果当前 hash 桶为 null,直接放入,CAS 加入,成功了就直接 break if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value))) break; // no lock when adding to empty bin } // TODO : else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else if (onlyIfAbsent // check first node without acquiring lock && fh == hash && ((fk = f.key) == key || (fk != null && key.equals(fk))) && (fv = f.val) != null) return fv; else { // 旧的值 V oldVal = null; // 加锁 synchronized (f) { if (tabAt(tab, i) == f) { if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; // 如果存在 hash(key) 和 key 对应的节点,直接更改 value 值 if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; if ((e = e.next) == null) { // 不存在直接放入,因为前面加锁了 pred.next = new Node<K,V>(hash, key, value); break; } } } // 如果是红黑树,红黑树插入 else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } else if (f instanceof ReservationNode) throw new IllegalStateException("Recursive update"); } } if (binCount != 0) { // 是否要转为红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); // 旧的值 if (oldVal != null) return oldVal; break; } } } addCount(1L, binCount); return null; } 4、TODO ConcurrentHashMap 的扩容方法 ConcurrentHashMap 也是默认扩容 2 倍,扩容的方法 transfer() Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1]; 5、总结 ConcurrentHashMap 在 JDK 1.7 和 1.8 变化很大,在 JDK 1.7 中,采用 Segment 分段存储数据,也通过 Segment 分段加锁。 而在 JDK 1.8 中,使用 synchronized 锁定 hash 桶的链表的首节点/红黑树的根节点,只要 hash(key) 不冲突,就不会影响其他线程。