首页 文章 精选 留言 我的

精选列表

搜索[在线编辑器],共10000篇文章
优秀的个人博客,低调大师

领课教育—在线教育系统(常见问题)

前端账号密码 普通用户: 13800138002 密码:123456 讲师用户: 13800138001 密码:123qwe 管理后台账号密码 管理员:13800000000 密码:123456 超级管理员:18800000000 密码:123456(2.0.0-SNAPSHOT版本) 超级管理员:18800000000 密码:asdanEn.132reFwf(1.0.0版本) 1、eureka报错Connection refused: connect 原因:只启动一台就会报错。默认启动2台,相互注册,此错误不影响使用 解决方法:(1) 启动两台(2) 也可在配置文件配置(设置不注册自身): # 设置不注册自身eureka.client.register-with-eureka=falseeureka.client.fetch-registry=false 2、druid加密不成功 (1) 可能密码加密错误,可以通过工具类来加密 package com.roncoo.education.boss.test;import com.alibaba.druid.filter.config.ConfigTools;public class DruidUtil { public static void main(String[] args) throws Exception { String password = "你的密码"; System.out.println(ConfigTools.encrypt(password)); }} (2) 存在缓存,配置不更新 原因:通过配置中心获取配置,配置中心里面的配置没更新。 解决方法:删除配置中心里面加载的配置,默认在:/home/roncoo/education/file/config-repo spring.cloud.config.server.git.basedir=/home/roncoo/education/file/config-repo

优秀的个人博客,低调大师

TableStore发布多元索引功能,打造统一的在线数据平台

什么是NoSQL “NoSQL”一词最早出现在1998年,距今刚好二十年。站在今天回头看的话,很少有人能想到在关系型数据库成熟发展了三十年,已经在数据存储领域占据了不可动摇的的地位后,NoSQL数据库尽然还可以快速地异军突起,并且以多点开花、多路并进的方式高速发展。“NoSQL”最早的意思是“non-relational”,后来又升级为了“Not Only SQL”,不管如何定义,“NoSQL”都代表了一种不同于关系型数据库的全新的思维方式。虽然在最近几年也出现了一些新颖的单机数据存储系统,也被划归为NoSQL,但在本文中,“NoSQL”仅指传统的分布式NoSQL数据库。 NoSQL最近二十年,尤其是最近十年可以说异军突起,主要得益于互联网的高速发展,对数据库有了更多更高的要求: 高达TB,PB级的海量数据存储需求:不管是二十年前起步的

优秀的个人博客,低调大师

在线伪原创工具www.bolewei.com的开发过程

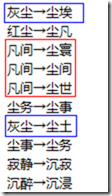
中文伪原创工具需要考虑的问题 我开始思考,目前已有的中文伪原创工具,效果差在哪些地方呢?我想到以下几个: 一、分词问题。 中文和英文不同,无论是搜索引擎的蜘蛛,还是其他自然语言处理的语料分析,都是需要分词的。如果不先进行分词的预处理就开始“伪原创”,肯定是不靠谱。举个例子:“天真”和“纯洁”是近义词。在不分词的情况下,“我有一个天真的表妹”仍然可以伪原创为“我有个纯洁的妹妹”,但“今天真热”处理为“今纯洁热”就是严重不靠谱。 二、顺序执行引发的单一化。 无论是网上流行的中文伪原创词库,还是现成的中文伪原创工具,我都试过了,他们的词库格式如下: 普通的算法是按照顺序依次替换,那么,如图所示,“凡间”的同义词原本有“尘寰”“尘间”“尘世”三个,但它永远不会被替换成后两个词。 最最理想的状态是能够根据语境,替换为合适的词。例如“天真”的同义词有“无邪 ”“纯真 ”“纯洁 ”“纯朴”等等,并非每个词在所有语境下都能够完全替换。当然,结合语境是高级自然语言处理的范畴,简单得伪原创能达到次理想状态就算OK:遇到多个同义词的情况,随机替换其中的一个。 三、词库打架的问题 我下载了网上流传的大部分词库,收费的、免费的,都尝试了。发现没有人去解决词库打架问题。 什么叫做“词库打架问题”?很简单,看这两组词。 顺序执行替换后,会发现文字兜了一个圈回到了原点……这显然不是我们想要的,但,这个问题在现有的词库、伪原创工具中,非常非常普遍。 四、可读性太差 为什么会可读性太差?因为现有的中文伪原创工具,都是通篇全部替换。如果词库里有10万组同义词,程序会遍历一次,把原文中所有能够替换的字符串“榨干”。这样一来虽然伪原创成功了,但可读性无限趋近于零。让我们看这样一组例子: 伪原创后: 如果读者直接阅读伪原创后的文字,能够理解吗? 怎样解决这个问题呢,我想,可以设置一个百分比,或叫做伪原创等级。例如“轻微 柔和 适中 猛烈 变态 面目全非 魂飞魄散”七个等级。用户选择“轻柔”时,只替换100个可替换同义词中的随机10个, 选择“适中”中,替换100个可替换同义词中的随机50个,以此类推。这样就可以让用户自己在“可读性”“原创度”之前自由权衡。 我心中的完美中文伪原创工具 功能模块 功能说明 技术实现 智能分词 避免“今天真热”变成“今纯洁热”的问题。 可以调用现有的中文分词开源组件。 随机性 既便是同一篇文章,每次进行伪原创的结果都不一样。 引入随机取词条。 伪原创力度调节 定义伪原创的百分比,让用户在“可读性”和“原创度”之间自由权衡。 引入等级设置、随机取词条。 词库不要打架 避免或降低“发誓”被替换为“立誓”后又被替换回“发誓”的情况发生。 放弃顺序执行。 统计 统计伪原创后替换了多少词 替换时插入标记 标记 标记被替换的词,方便查看、校对 替换时插入标记 核心程序实现 考虑以上提到的很多方面的问题,程序还是比较长,接近一万行。下面我只列几段核心的代码供大家参考、讨论。 一、分词。 分词其实很容易,因为有很懂开源组件可以使用。我最喜欢的是SCWS。官网地址是http://www.ftphp.com/scws/ SCWS本来是PHP中文分词解决方案,但它提供了API,我们C#程序猿也可以毫无压力的调用。 View Code 二、解决词库打架问题。 这没什么好说的。程序也只有一句话。 三、根据百分比,随机取x条记录。 取随机记录,最方便的是Mysql数据库,内置的rand()函数可以在select中使用。如果使用SQL Server稍微麻烦些,效率也会低一些。 参考http://www.rndblog.com/how-to-select-random-rows-in-mysql/ 四、替换同义词主函数。 请看代码里的注释。 public stringReplaceArticle( stringold, intstrength, boolmarkRed, ref intreplacedcount) { stringnewArticle=old; intwordsAmount= 180482; // 词库总量 intkwcount=Convert.ToInt32(strength* 1.0/ 100*wordsAmount); // 根据传入的百分比,计算需要取多少个词 vardataset=SQLHelper.ExecuteDataset(SQLHelper.connectionString,System.Data.CommandType.Text, " select*fromwordsorderbyrand()limit "+kwcount); // 随机取kwcount组词 foreach(DataRowr indataset.Tables[ 0].Rows) { // 随机。对于词典中A->B的词组。随机决定本次替换是Replace(A,B)还是Replace(B,A) inti= newRandom().Next( 0, 1); newArticle=newArticle.Replace(r[i].ToString() , string.Format( " <b>{0}</b> ",r[ 1-i].ToString())); } // 数被替换的词。 replacedcount=newArticle.Split( new string[]{ " </b> "},StringSplitOptions.None).Length- 1; if(!markRed) { // 如果用户不要求标记,则去掉<b>标记。 newArticle=newArticle.Replace( " <b> ", string.Empty).Replace( " </b> ", string.Empty); } returnnewArticle; } 最终程序界面 最后 如前文所说,中文伪原创几乎是一片空白。希望本文能够启到抛砖引玉的作用,更希望有兴趣的同学能够与我一起继续不断的完善、改进它。 本文转自 流牛木马 博客园博客,原文链接:http://www.cnblogs.com/azure/archive/2012/08/29/bolewei.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

首届阿里巴巴研发效能嘉年华,在线预约报名开始

随着云计算、大数据、AI智能等前沿科技的发展,传统的研发速度,越来越难满足企业快速发展的需求。 研发效能也成了继商业模式、技术突破之后的另一核心竞争力。 6月29日由阿里云研发协同RDC、阿里云云效和云栖社区联合举办“首届阿里巴巴研发效能嘉年华”线上直播活动。 ▼直播简介▼ 直播时间:6月29日13:30-21:30 直播渠道:阿里云云栖社区&阿里内外 主播:洪湖&乐学&胥引&问菊&金桐&渐本&怀虎&莫源&问樵&箫竹 程序员特色表演:《码农》《晒娃迪卡》《小太阳》(原创歌曲) 主持人:徒骇&锦铭 直播预约地址:见文末 ▼主播阵容▼ 阿里巴巴资深技术专家,十年敏捷教练,一线的实践专家,带你飞! 无论是项目管理,还是持续交付、测试发布、敏捷研发,带你全面感受研发全生命周

优秀的个人博客,低调大师

22【在线日志分析】之项目第二阶段概述

主要对HDFS服务和Tomcat服务进行实时计算预警,故要做以下加强功能: 1. 改造 CDH/Apache hadoop的hdfs的nn,dn进程的日志输出格式,每一条改为json格式输出 (之前每一条为 string) 2. 改造 Tomcat的日志支持log4j,其为json格式输出 3. 改造 基于Flume-ng Exec Source开发自定义插件ExecSource_JSON,支持JSON数据处理 4. 改造 spark streaming+spark sql,支持读取json解析 5. 使用hive离线计算loginfo字段,计算高词频的词,添加到MySQL表中,同时支持添加自定义监控词 6. 改造 spark streaming+spark sql,参数配置定时读取监控词库,进行预警计算 7. 改造grafana dashboard可视化 8. 整个架构高可靠设计和优化 9. 扩展其他应用、DB的日志等等

优秀的个人博客,低调大师

00【在线日志分析】之项目概述和GitHub项目地址

1.前期基本架构图2.最终基本架构图 3.版本 Flume: 1.7 Hadoop: 2.7.3Scala: 2.11Kafka: 0.10.1.0 Spark: 2.0.2 InfluxDB: 1.2.0 Grafana: 4.1.1 maven: 3.3.9 4.主要目的 主要是想基于Exec Source开发自定义插件AdvancedExecSource,将机器名称 和 服务名称 添加到cdh 服务的角色log数据的每一行前面,则格式为:机器名称 服务名称 年月日 时分秒.毫秒 日志级别 日志信息 ;然后在后面的spark streaming 实时计算我们所需求:比如统计每台机器的服务的每秒出现的error次数、统计每5秒的warn,error次数等等;来实时可视化展示和邮件短信、微信企业号通知。 其实主要我们现在的很多监控服务基本达不到秒级的通知,都为5分钟等等,为了方便我们自己的维护; 其实对一些即将出现的问题可以提前预知; 其实最主要可以有效扩展到实时计算数据库级别日志,比如MySQL慢查询日志,nginx,tomcat,linux的系统级别日志等等。 5.大概流程1.搭建hadoop cluster 2.eclipse 导入flume源代码(window7 安装maven,eclipse,eclipse与maven集成) 3.开发flume-ng 自定义插件 4.flume 收集,汇聚到hdfs(主要测试是否汇聚成功,后期也可以做离线处理) 5.flume 收集,汇聚到kafka 6.搭建kafka monitor 7.搭建 spark client 8.window7装ieda开发工具 9.idea开发 spark streaming 的wc 10.读取kafka日志,开发spark streaming的这块日志分析 11.写入influxdb12.grafana可视化展示 13.集成邮件 说明:针对自身情况,自行选择,步骤如上,但不是固定的,有些顺序是可以打乱的,例如开发工具的安装,可以一起操作的,再如这几个组件的下载编译,如果不 想编译可以直接下tar包的,自行选择就好,但是建议还是自己编译,遇到坑才能更好的记住这个东西,本身这个项目就是学习提升的过程,要是什么都是现成的, 那就没什么意义了 6.百度云: http://pan.baidu.com/s/1skXCh8T 密码:m2rs7.GitHub: https://github.com/Hackeruncle/OnlineLogAnalysis(欢迎大家单击Star,持续关注)

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册