首页 文章 精选 留言 我的

精选列表

搜索[小程序·即时通信 IM],共10028篇文章
优秀的个人博客,低调大师

Android -- 重置Bitmap大小&&Bitmap转角度

重置Bitmap大小 Bitmap bitMap = BitmapFactory.decodeFile(path); int width = bitMap.getWidth(); int height = bitMap.getHeight(); // 设置想要的大小 int newWidth = 500; int newHeight = 400; // 计算缩放比例 float scaleWidth = ((float) newWidth) / width; float scaleHeight = ((float) newHeight) / height; // 取得想要缩放的matrix参数 Matrix matrix = new Matrix(); matrix.postScale(scaleWidth, scaleHeight); // 得到新的图片 bitMap = Bitmap.createBitmap(bitMap, 0, 0, width, height, matrix, true); Bitmap转角度 Bitmap bm = BitmapFactory.decodeByteArray(imgdata, 0,imgdata.length); Matrix matrix = new Matrix(); matrix.preRotate(270); bm = Bitmap.createBitmap(bm, 0, 0, bm.getWidth(),bm.getHeight(), matrix, true); imgdata为camera开发的时候的图片数据。 这里其实找到了bitmap就OK了。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3744875.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

MongoDB学习笔记(四)--索引 && 性能优化

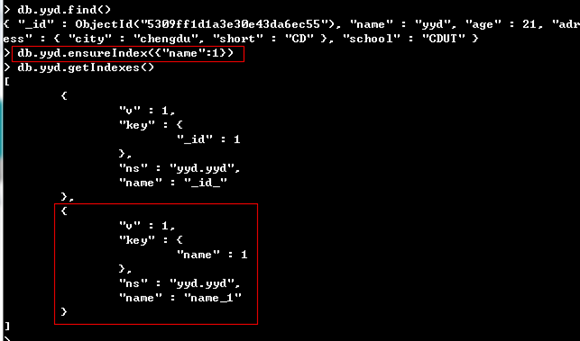
索引 基础索引 用到ensureIndex方法建立索引,1为升序,-1为降序。 MongoDB数据库在创建集合的时候,默认会为_id创建索引。 注:当系统已有大量数据时,创建索引就是一个非常耗时的工作,只需要指定backgroud:true即可。 db.yyd.ensureIndex({"name":1},{"backgroud:true"}) 文档索引 注:下面的查询将不会用到索引,因为查询的顺序与索引建立的顺序不一样。 db.yyd.find({"address":{"short":"CD","city":"chengdu"}}) 组合索引 此时,无论city和short的顺序是前是后,都会用到索引。 删除索引 为了后面方便查看,先把刚才建立的索引删除掉。 唯一索引 这里的唯一索引就像非NoSQL数据库里面的主键一样。如果集合中有重复的值,系统会报错。 强制使用索引 先向里面插入数据,使name和age为索引,当查询的时候用explain()方法来查看查询所用到的索引indexBounds参数。由上图看出,没用到索引。 现在通过hint命令强制使用索引。 索引名称 索引的名称是默认取好了的,一般是“索引_1”这样的,当然也可以自己设置索引的名字。 db.yyd.ensureIndex({"name":1},{"name":"index_name"}) 优化器profiler profiler相当于MySQL中的慢查询日志,但是比慢查询日志更详细。 使用profiler优化器就必须先开启它,在mongoDB中有两种方法控制profiler的开关和级别。 方法一: 在启动服务的时候加上 –profiler 参数,通过这个参数来设置profiler的级别。 方法二: db.setProfilingLevel(level,slowms) 在客户端调用setProfilingLevel()方法。 level为级别,0代表不开启,1代表记录慢命令(默认100ms),3代表记录所有命令。 slowms代表慢命令执行的时间,超过这个时间将写入日志中。 查询profiler日志 db.system.profile.find() show profile 性能优化 创建索引 限定返回结果数 只查询使用到的字段,而不查询所以字段 采用capped集合 采用Server Side Code Execution hint 采用profiling mongosniff底层监控 mongosniff --source NET lo mongostat查看运行中的实例统计信息 mongostat db.serverStatus查看实例运行状态 >db.serverStatus() db.stats查看数据库状态 >db.stats() 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3563704.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

BuildTask & BuildType

Build Tasks 在build文件中使用了Android或者Java插件之后就会自动创建一系列可以运行的任务。 Gradle中有如下一下默认约定的任务: assemble 该任务包含了项目中的所有打包相关的任务,比如java项目中打的jar包,Android项目中打的apk check 该任务包含了项目中所有验证相关的任务,比如运行测试的任务 build 该任务包含了assemble和check clean 该任务会清空项目的所有的输出,删除所有在assemble任务中打的包 assemble, check 和 build 任务实际上并不做任何事情,它们其实只是为插件提供了一个钩子,真正的事情都是由插件来完成的。这样的话,开发人员就不需要关心我到底运行的是一个java项目还是一个Android项目,也不用关心我到底使用了哪些gradle插件,因为我都可以调用这些约定的任务来完成构建。 注意:Gradle会自动检查一个任务的输入和输出。比如连续两次运行build任务的,Gradle会报告所有的任务都已经是最新刚运行过的了,不需要再次运行。这样的话,任务之间就算是有相互依赖,也不会导致重复的执行。 Java项目常用的任务 Java plugin 主要创建了两个任务: jar assemble任务会依赖jar任务,看名字就知道这是负责打jar包的任务。jar任务本身又会依赖很多其他的任务,比如classes任务,classes任务会编译java代码 test check任务会依赖test任务,这个任务会运行所有的测试。测试代码使用testClasses任务编译,但是我们基本不用手动运行testClasses任务因为test任务已经添加了对它的依赖。 通常情况下,我们只要运行assemble和check任务就够了。 Android项目常用的任务 和其他gradle插件一样,Android插件也提供了一些默认的任务,比如assemble,check,build,clean,同时它也提供了一些自己特有的任务,比如: connectedCheck 运行那些需要在真机或者模拟器上执行的检查任务,这些任务会并行地在所有连接的设备上运行 deviceCheck 使用APIs连接远程设备执行检查.主要用于CI(持续集成)服务上. 上面两个任务都会执行 assemble 和 check任务。新加这两个任务是很有必要的,这样可以保证我们可以运行那些不需要连接设备的检查任务。 注意:build任务并不依赖于deviceCheck或者connectedCheck 一个Android项目通常至少会有两种输出:debug apk和release apk。对应的gradle中有两个任务可以分别输出不同的apk:assembleDebug/assembleRelease。 这两个任务又会依赖其他的任务来构建一个apk。assemble任务依赖这两个任务,调用assemble任务就会生成两种apk。 BuildType 默认情况下,Android插件自动为项目构建一个debug和一个release版本的应用。这两个版本的不同主要体现在在非开发机上的调试功能以及APK的签名方式。debug版本使用一个用公开的name/password创建的key来签名(这样构建的时候就不需要提示输入密码了)。release版本在构建的时候不会进行签名,而是稍后在做。 这个可以使用gradle中的BuildType对象来进行配置。默认情况下,2个BuildType的实例会被创建,一个debug,一个release。Android插件允许自定义这两个实例,当然你也可以创建其他的build type。配置由buildTypes这个DSL来完成: android { buildTypes { debug { applicationIdSuffix ".debug" } jnidebug.initWith(buildTypes.debug) jnidebug { packageNameSuffix ".jnidebug" jniDebuggable true } } } 上面的代码完成了下列配置: 配置默认的debug Build Type 设置debug版本的包名为<应用id>.debug,这样就可以在设备上同时安装debug和release版本了。 创建一个新的BuildType,名字是jnidebug,同时配置它是复制自debug Build Type。 配置jnidebug开启debug版本的JNI组件,添加一个不同的包名后缀。 创建一个新的的Build Types非常简单,只需要在buildTypes下面通过调用initWith或者使用闭包添加一个新的元素。下表是可以配置的属性以及默认值: 属性名 debug版本默认值 release或其他版本默认值 debuggable true false jniDebuggable false false renderscriptDebuggable false false renderscriptOptimLevel 3 3 applicationIdSuffix null null versionNameSuffix null null signingConfig android.signingConfigs.debug null zipAlignEnabled false true minifyEnabled false false 除了这些属性,Build Types还可以用来配置代码和资源文件。针对每一个Build Type,一个新的对应的sourceSet会被创建,这个sourceSet使用一个默认的路径src/< buildtype名字>/。这就意味着Build Type的名字不能是main或者androidTest(这是由插件强制的),同时每个Build Type的名字必须是唯一的。 和其他的source sets一样,Build Type中的source set路径也是可以配置 android { sourceSets.jnidebug.setRoot('foo/jnidebug') } 另外,对每一个Build Type,一个新的assemble< BuildType名字>任务会被创建.当debug和release Build Types被预先创建的时候,他们对应的assemble任务也会被一起创建. 上面的build.gradle代码片段还会创建一个assembleJnidebug任务,assemble任务也会添加对assembleJniDebug任务的依赖,正如它对assembleDebug和assembleRelease任务的依赖一样。 可能是使用场景: 仅在debug模式下使用的权限,release模式不使用。 debug时使用不同的实现 debug模式使用不同的资源(比如当一个资源的值依赖于签名的时候) BuildType中的 代码/资源文件 将会被按照下列方式处理: manifest配置会被merge到app manifest中 代码不会被merge,会被当做另一个代码目录(source folder)来使用 资源文件会覆盖同名的main中的资源文件 作者: 我爱物联网 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4821156.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

【Cassandra生态】Cassandra强大的支持力量-商业&amp;大公司&amp;云&amp;生态周边

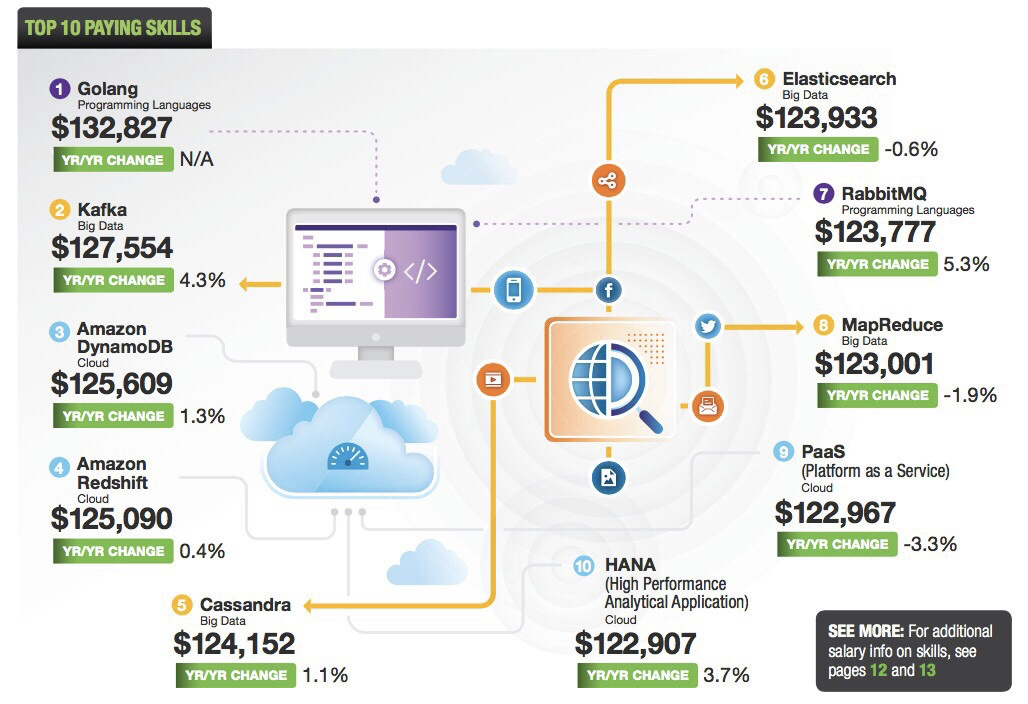
引言 在本次 ApacheCon2019年的会议上,Cassandra的议题多达 30场次:https://www.apachecon.com/acna19/s/#/schedule?search=Cassandra,与最火的Spark类似。其它一些项目只有个位数的分享。这么多的分享,背后必然有一个强大的生态社区,本文将梳理下Cassandra的商业公司、云公司、全球使用的大公司及相关生态的支持。另外有份资料表明,从事Cassandra职业的薪水非常可观,排名第五 商业公司 Datastax:https://www.datastax.com/,是一家位于加州的初创公司,提供了一个商业版本的Apache Cassandra数据库,公司目前已经接近1亿美元的融资。创始人也是Cassandra作者之一,是社区Cassandra较大贡献者。Da

优秀的个人博客,低调大师

Elasticsearch: 权威指南 &amp;#187; 深入搜索 &amp;#187; 多字段搜索 &amp;#187; 多数字段 good

跨字段实体搜索 » 多数字段编辑 全文搜索被称作是召回率(Recall)与精确率(Precision)的战场:召回率——返回所有的相关文档;精确率——不返回无关文档。目的是在结果的第一页中为用户呈现最为相关的文档。 为了提高召回率的效果,我们扩大搜索范围——不仅返回与用户搜索词精确匹配的文档,还会返回我们认为与查询相关的所有文档。如果一个用户搜索 “quick brown box” ,一个包含词语fast foxes的文档被认为是非常合理的返回结果。 如果包含词语fast foxes的文档是能找到的唯一相关文档,那么它会出现在结果列表的最上面,但是,如果有 100 个文档都出现了词语quick brown fox,那么这个包含词语fast foxes的文档当然会被认为是次相关的,它可能处于返回结果列表更下面的某个地方。当包含了很多潜在匹配之后,我们需要将最匹配的几个置于结果列表的顶部。 提高全文相关性精度的常用方式是为同一文本建立多种方式的索引,每种方式都提供了一个不同的相关度信号signal。主字段会以尽可能多的形式的去匹配尽可能多的文档。举个例子,我们可以进行以下操作: 使用词干提取来索引jumps、jumping和jumped样的词,将jump作为它们的词根形式。这样即使用户搜索jumped,也还是能找到包含jumping的匹配的文档。 将同义词包括其中,如jump、leap和hop。 移除变音或口音词:如ésta、está和esta都会以无变音形式esta来索引。 尽管如此,如果我们有两个文档,其中一个包含词jumped,另一个包含词jumping,用户很可能期望前者能排的更高,因为它正好与输入的搜索条件一致。 为了达到目的,我们可以将相同的文本索引到其他字段从而提供更为精确的匹配。一个字段可能是为词干未提取过的版本,另一个字段可能是变音过的原始词,第三个可能使用shingles提供词语相似性信息。这些附加的字段可以看成提高每个文档的相关度评分的信号signals,能匹配字段的越多越好。 一个文档如果与广度匹配的主字段相匹配,那么它会出现在结果列表中。如果文档同时又与signal信号字段匹配,那么它会获得额外加分,系统会提升它在结果列表中的位置。 我们会在本书稍后对同义词、词相似性、部分匹配以及其他潜在的信号进行讨论,但这里只使用词干已提取(stemmed)和未提取(unstemmed)的字段作为简单例子来说明这种技术。 多字段映射编辑 首先要做的事情就是对我们的字段索引两次:一次使用词干模式以及一次非词干模式。为了做到这点,采用multifields来实现,已经在multifields有所介绍: DELETE /my_index PUT /my_index { "settings": { "number_of_shards": 1 }, "mappings": { "my_type": { "properties": { "title": { "type": "string", "analyzer": "english", "fields": { "std": { "type": "string", "analyzer": "standard" } } } } } } } 拷贝为 CURL 在 SENSE 中查看 参考被破坏的相关度. title字段使用english英语分析器来提取词干。 title.std字段使用standard标准分析器,所以没有词干提取。 接着索引一些文档: PUT /my_index/my_type/1 { "title": "My rabbit jumps" } PUT /my_index/my_type/2 { "title": "Jumping jack rabbits" } 拷贝为 CURL 在 SENSE 中查看 这里用一个简单match查询title标题字段是否包含jumping rabbits(跳跃的兔子): GET /my_index/_search { "query": { "match": { "title": "jumping rabbits" } } } 拷贝为 CURL 在 SENSE 中查看 因为有了english分析器,这个查询是在查找以jump和rabbit这两个被提取词的文档。两个文档的title字段都同时包括这两个词,所以两个文档得到的评分也相同: { "hits": [ { "_id": "1", "_score": 0.42039964, "_source": { "title": "My rabbit jumps" } }, { "_id": "2", "_score": 0.42039964, "_source": { "title": "Jumping jack rabbits" } } ] } 如果只是查询title.std字段,那么只有文档 2 是匹配的。尽管如此,如果同时查询两个字段,然后使用bool查询将评分结果合并,那么两个文档都是匹配的(title字段的作用),而且文档 2 的相关度评分更高(title.std字段的作用): GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 我们希望将所有匹配字段的评分合并起来,所以使用most_fields类型。这让multi_match查询用bool查询将两个字段语句包在里面,而不是使用dis_max查询。 { "hits": [ { "_id": "2", "_score": 0.8226396, "_source": { "title": "Jumping jack rabbits" } }, { "_id": "1", "_score": 0.10741998, "_source": { "title": "My rabbit jumps" } } ] } 文档 2 现在的评分要比文档 1 高。 用广度匹配字段title包括尽可能多的文档——以提升召回率——同时又使用字段title.std作为信号将相关度更高的文档置于结果顶部。 每个字段对于最终评分的贡献可以通过自定义值boost来控制。比如,使title字段更为重要,这样同时也降低了其他信号字段的作用: GET /my_index/_search { "query": { "multi_match": { "query": "jumping rabbits", "type": "most_fields", "fields": [ "title^10", "title.std" ] } } } 拷贝为 CURL 在 SENSE 中查看 title字段的boost的值为10使它比title.std更重要。 https://www.elastic.co/guide/cn/elasticsearch/guide/current/most-fields.html

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册