首页 文章 精选 留言 我的

精选列表

搜索[VMware替代],共10000篇文章
优秀的个人博客,低调大师

用 structuredClone 替代 JSON.parse(JSON.stringify()) 做深拷贝时,你会遇到哪些坑

处理表单回显、状态快照或者撤销重做时,深拷贝是躲不开的一步。早些年用 JSON.parse(JSON.stringify(obj)) 是最省事的写法,但它会丢掉 Date、RegExp、Map、Set、函数、undefined,遇到循环引用直接抛错,NaN 和 Infinity 还会被改成 null。后来浏览器和 Node.js 陆续提供了 structuredClone,它基于结构化克隆算法,能处理循环引用、Date、Map、Set,甚至 ArrayBuffer 和 File。不过它也不是万能钥匙:函数、DOM 节点、原型链、WeakMap 都不在支持范围内,Symbol 键也会被忽略,某些内置对象克隆后原型会变成普通对象。下面结合几个真实开发场景,聊聊怎么判断该不该用它,以及遇到边缘数据时怎么兜底。

优秀的个人博客,低调大师

大模型激活函数迭代演进:SwiGLU替代传统ReLU/GELU激活逻辑提升模型性能18.9

在前一期《大模型主流激活函数解析:ReLU/GELU/SwiGLU 原理差异,拆解 FFN 前向逻辑》内容中,我们已经系统认识了神经网络激活函数的基础作用:线性矩阵运算无法拟合复杂语义规律,只有加入非线性激活,Transformer才能学习语言逻辑、上下文关联与世界知识。相信在我们初步了解后在对比 ReLU、GELU两种经典激活后都会产生疑问:既然ReLU计算简单高效、GELU平滑稳定适配早期模型,为什么如今ChatGLM3、Qwen-7B这类主流开源大模型,全都全面切换为SwiGLU门控激活?

优秀的个人博客,低调大师

Sealos Devbox 基础教程:使用 Cursor 从零开发一个 One API 替代品

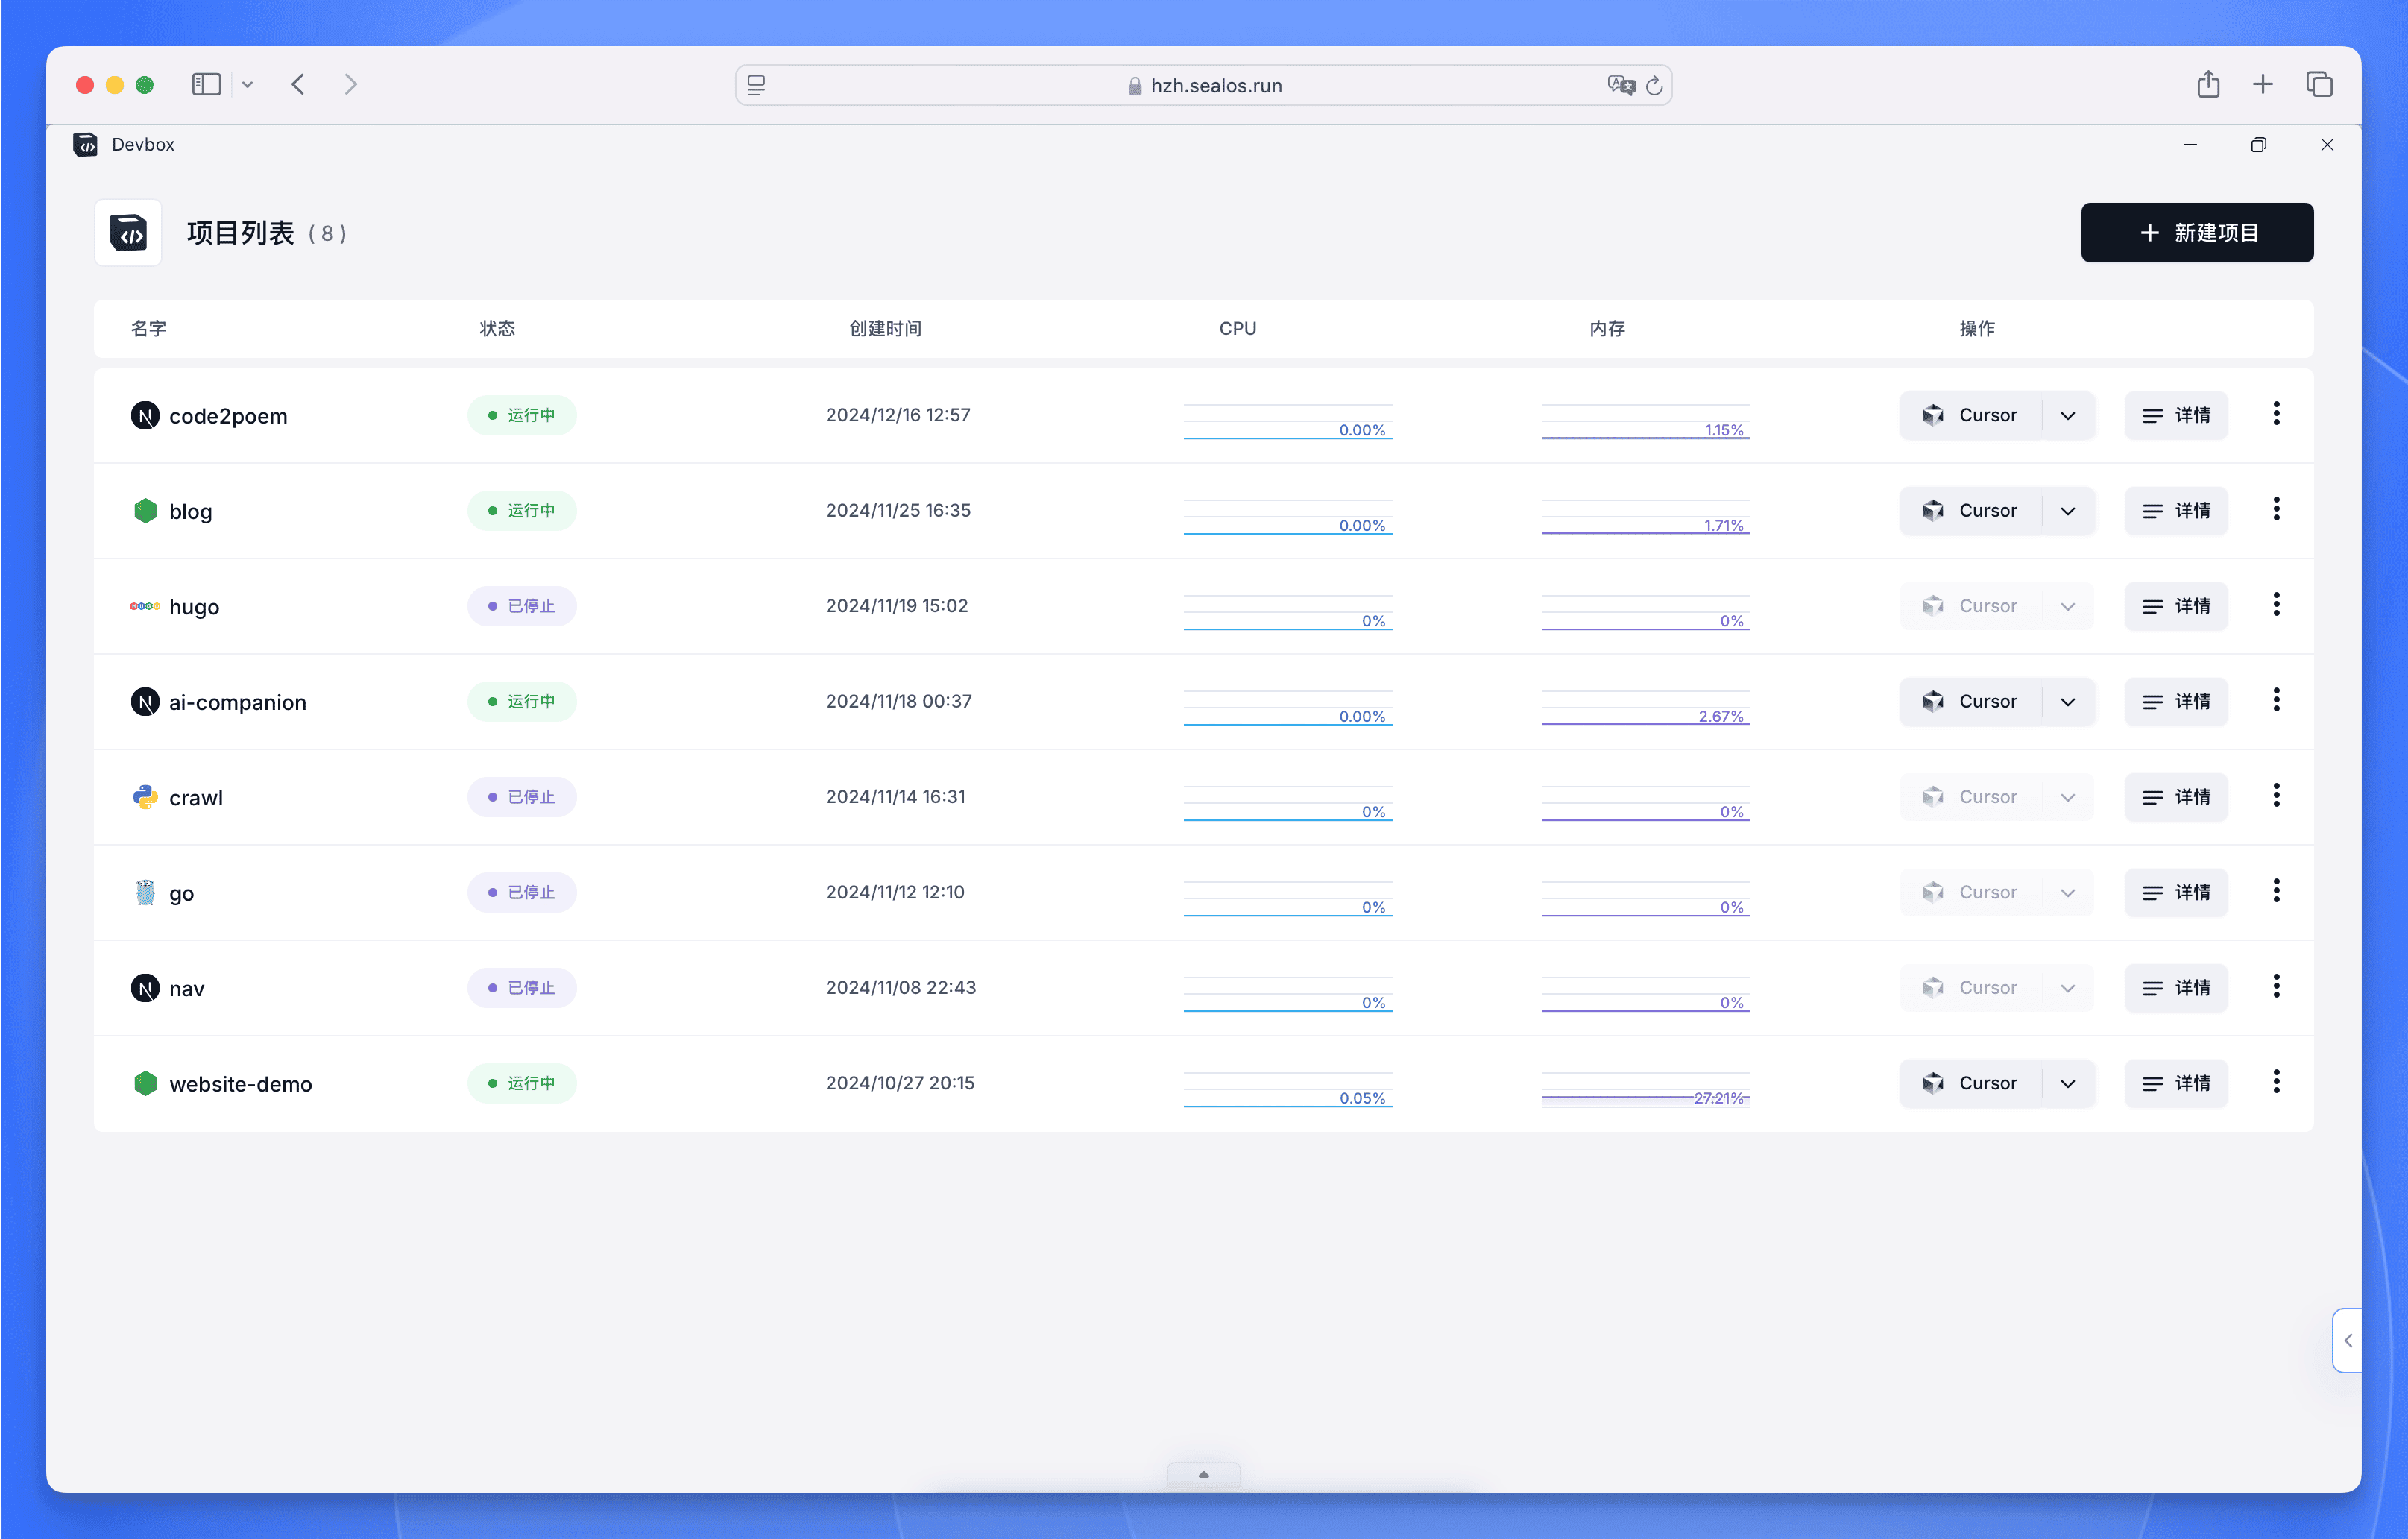
随着技术的成熟和 AI 的崛起,很多原本需要团队协作才能完成的工作现在都可以通过自动化和智能化的方式完成。于是乎,单个开发者的能力得到了极大的提升 - 借助各种工具,一个人就可以完成开发、测试、运维等整条链路上的工作,渡劫飞升成为真正的 "全干工程师"。 之前我们分享过一些入门级的 Hello World 教程。今天,我想通过一个实际的业务案例来展示 Devbox 并非只能开发玩具,而是一个真正的生产力工具。 Sealos 平台上有很多应用,其中很多管控层面的应用都是使用 Cursor + Go + Next.js 开发的。我们的开发环境直接使用 Sealos Devbox,上线也是通过 Devbox 一键完成。这种开发模式让我们团队拥有了非常高效的作战能力 - 大部分重复性工作都通过自动化或 AI 完成,让开发者可以专注于核心业务逻辑。 以 Sealos 中的 AI Proxy 应用为例,这是一个典型的前后端分离架构的应用,主要由两部分组成: 基于 Next.js 开发的前端应用和 BFF 层。BFF 层负责用户鉴权,并将经过验证的请求转发给后端服务。 使用 Golang 开发的后端服务,负责核心业务逻辑,包括 token 存储、日志记录和请求转发等功能。 接下来,我将详细介绍如何高效地开发这样一个生产级别的系统。 Golang 后端 创建开发环境 首先在 Sealos Cloud 中打开 Debox 应用,创建一个新项目,选择 Go 作为运行环境,选择 1.23 版本。 Devbox 为开发者提供了几个非常实用的功能: 灵活的资源配置:可以根据项目需求自由调整 CPU 和内存,选择合适配置既保证性能又能控制成本。 一键启用 HTTPS:系统自动分配安全域名,再也不用为配置 SSL 证书发愁。 全自动域名管理:从开发到测试环境,域名配置全程由系统处理,开发者可以专注于代码本身。 创建完成后,几秒钟即可启动开发环境。 环境准备好后,我们直接用 Cursor 连接开发环境。在操作选项中选择使用 Cursor 连接: 首次打开会提示安装 Devbox 插件,安装后即可自动连接开发环境。 导入项目到 Cursor 首先 Fork Sealos 源码到自己的仓库,然后再将你自己的仓库克隆到 Devbox 开发环境: 测试环境开发 在 Cursor 的面板中切换到 "Databse" 标签页,然后点击箭头指向的按钮,在浏览器中打开 Sealos 的数据库应用: 然后创建 PostgreSQL 和 Redis 实例。 回到 Cursor 面板的 "Database" 标签页,点击刷新即可看到刚创建的数据库实例,点击可复制连接信息: 在终端中启动服务: export ADMIN_KEY=sealos-admin export SQL_DSN=<复制的pgsql连接串>/postgres export REDIS_CONN_STRING=<复制的redis连接串> go run . --port 8080 提示 server stared 即为启动成功 在 Cursor 面板的 "Network" 标签页中,点击地址栏右侧的 🌐 按钮,然后在弹窗中选择 "Copy",将地址复制到自己电脑上使用 curl 进行测试: curl https://mmznjndvzdrv.sealoshzh.site/api/status -H "Authorization: sealos-admin" 接口返回没有问题。 优化数据库设计 在开发过程中,我们发现数据库中 Group 和 Token 之间的外键约束增加了系统维护的复杂度。为了简化这一关系,我们可以将外键约束改为程序层面的显式调用,这样可以让代码逻辑更加清晰和可控。 首先切换到 fix-aiproxy 分支: 在 sealos/service/aiproxy/model/group.go 文件中,我们需要将 Group 结构体中一个外键约束改成在程序内显示调用更新和删除来降低维护心智。 这里我选择使用 Cursor 的 Chat 功能让 AI 自己写代码,最后生成的结果如下: 这种实现方式的优势在于:当删除 Group 时,相关的 Token 删除操作会在同一个事务中完成。由于是在事务内进行,我们不需要担心删除失败或系统宕机导致的数据不一致问题。 我们可以通过一系列测试来验证这个优化是否达到预期效果。首先编译并运行服务: go build . && ./aiproxy --port 8080 然后通过以下 API 调用来测试完整的 Group 和 Token 生命周期: # 创建一个group curl https://gawavirgsomu.sealosbja.site/api/group/ -H "Authorization: sealos-admin" -d '{ "id": "ns-admin" }' # 创建一个token curl https://gawavirgsomu.sealosbja.site/api/token/ns-admin -H "Authorization: sealos-admin" -d '{ "name": "token 1" }' # 查询token curl https://gawavirgsomu.sealosbja.site/api/tokens/ -H "Authorization: sealos-admin" # 删除group curl https://gawavirgsomu.sealosbja.site/api/group/ns-admin -H "Authorization: sealos-admin" -X DELETE # 再次查询token curl https://gawavirgsomu.sealosbja.site/api/tokens/ -H "Authorization: sealos-admin" 测试结果符合预期,确认优化方案可行。接下来我们就可以提交这些更改并创建 Pull Request 了。 上线到生产环境 首先在 Cursor 目录顶层的 endpoint.sh 中设置启动命令,在文件中添加以下启动配置: cd sealos/service/aiproxy export ADMIN_KEY=sealos-admin # 可以再创建一个单独的生产环境数据库,与开发环境隔离 export SQL_DSN=<复制的pgsql连接串>/postgres export REDIS_CONN_STRING=<复制的redis连接串> # 使用编译好的二进制文件 ./aiproxy --port 8080 然后来到 Devbox 发布页面发布版本: 点击发布按钮后,等待发布流程完成。发布成功后,点击 "上线" 按钮进入部署页面,然后点击 "部署应用" 即可: 部署完成后,进入应用的详情页面,等待应用变成 running 状态,然后复制公网地址: 这个公网地址就是生产环境的域名,我们可以使用生产环境的域名进行测试: # 这里使用的是生产环境的域名 curl https://jpesudzryuhp.sealosbja.site/api/tokens/ -H "Authorization: sealos-admin" 完美! Next.js 前端 前端项目搭建 前端环境的搭建与后端类似,具体步骤如下: 在 Devbox 中创建一个 Node.js 环境,版本选择 20,端口改成 3000。由于 pnpm 安装依赖比较消耗资源,建议选择 4c 16G 的配置。然后克隆你自己 Fork 的 Sealos 仓库:git clone https://github.com/xxx/sealos.git。AI Proxy 的前端代码位于 sealos/frontend/providers/aiproxy 目录。 切换到 sealos/frontend 目录,首先修改 sealos/frontend/package.josn 文件,去除 node 版本限制,直接删除 "node": "20.4.0" 和 "pnpm": "8.9.0" 这两行即可,这一步很重要,不然代码构建依赖会不成功。 执行命令 pnpm i 安装依赖。 执行命令 pnpm -r --filter ./packages/client-sdk run build 构建 client-sdk 包。 为了让 Cursor 的 i18n 插件正常工作,我们需要将项目根目录切换到 sealos/frontend/providers/aiproxy: 切换目录后,建议安装所有 @recommended 插件以获得最佳的开发体验: 之前只是构建出了 Sealos Desktop SDK,并没有安装 aiproxy 的依赖,aiproxy 的依赖需要在 aiproxy 工作目录下 sealos/frontend/providers/aiproxy 进行安装。直接执行命令 pnpm i 安装即可: 对接后端环境 项目搭建完成后,我们需要配置环境变量来对接后端服务。在项目根目录创建一个 .env 文件,需要配置以下几个关键变量: NEXT_PUBLIC_MOCK_USER="" AI_PROXY_BACKEND_KEY="" APP_TOKEN_JWT_KEY="test123" AI_PROXY_BACKEND="" AI_PROXY_BACKEND_INTERNAL="" ADMIN_NAMESPACES="" NEXT_PUBLIC_MOCK_USER:由于 AI Proxy 是 Sealos Desktop 的一部分,用户认证通过 JWT Token 实现,AI Proxy 只做解析 Token,JWT Token 的签发由 Sealos Desktop 完成。在开发阶段,我们需要 mock 一个 JWT Token。NEXT_PUBLIC_MOCK_USER 的值就是 mock 出来的 JWT Token。可以使用在线工具 https://www.lddgo.net/encrypt/jwt-generate 生成。 mock 数据如下: { "workspaceId" : "test" } APP_TOKEN_JWT_KEY:JWT Token 的密钥 (随便写) AI_PROXY_BACKEND_KEY:后端 API 的访问密钥 (也就是后端项目的 ADMIN_KEY) AI_PROXY_BACKEND:后端服务的公网地址 AI_PROXY_BACKEND_INTERNAL:后端服务的内网地址 (开发测试阶段可以不填) ADMIN_NAMESPACES:管理员用户名,开发时填 test 就行,和 token 中的 "workspaceId":"test" 保持一致 环境变量配置完成后,运行 pnpm dev 即可启动开发服务器。项目的发布和部署流程与前面介绍的后端开发流程完全一致。 总结 Sealos AI Proxy 前端项目采用了经典的 Next.js App Router 架构,其中 app/[lng] 目录用于页面路由,app/api 目录则用于后端 API 路由。 在这个项目中,Next.js 的后端实际上是一个中间层,它主要负责用户认证相关的业务逻辑,并将经过认证的请求转发给真正的 Golang 后端服务。这种分层设计可以让 Golang 后端专注于核心业务逻辑,不需要关心认证等基础设施,从而提高了代码的灵活性和可移植性。

优秀的个人博客,低调大师

以替代 MyBatis 为己任,融合 JPA 和超强 SQL 功能 sqltoy-orm 5.6.26 发版了

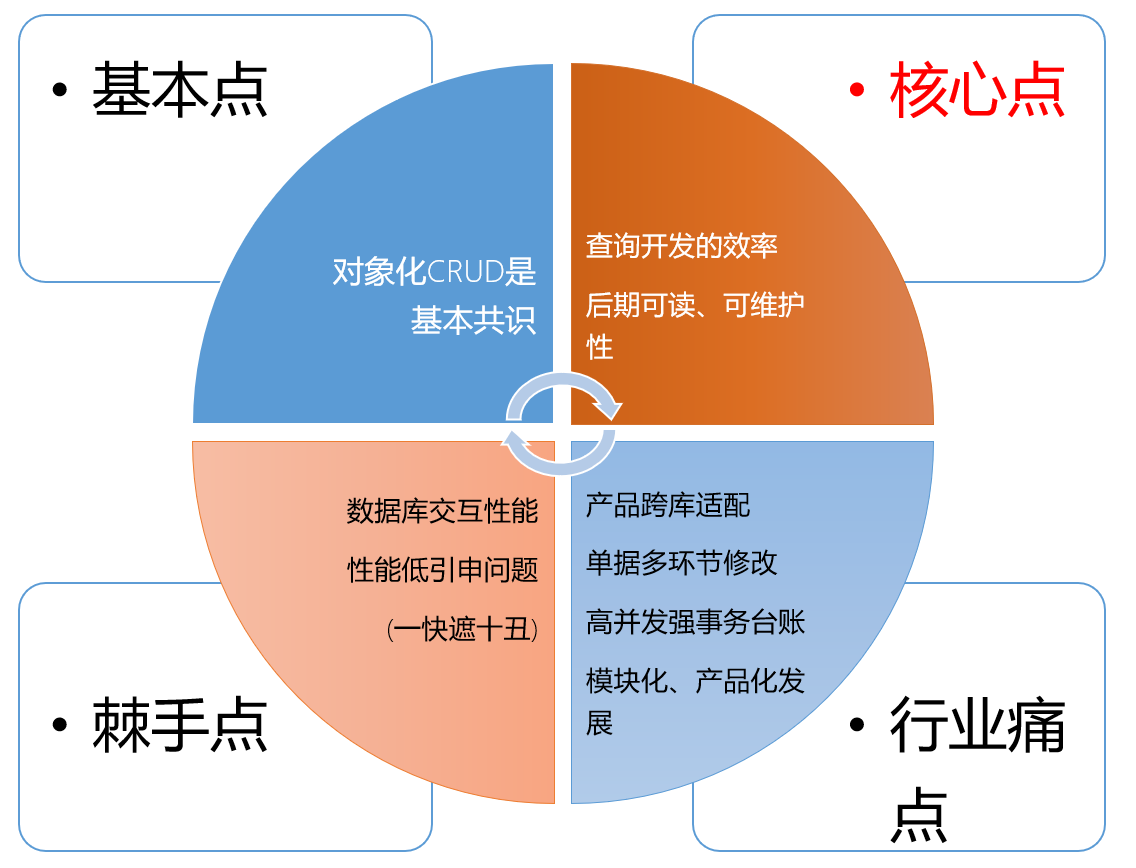
兄弟们,让mybatis退出历史舞台吧,mybatis的存在引发了反xml之争、反sql之争,产生了成百个的plus系列,无尽的争吵、无尽的后来者开发plusplus! 开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、针对batchUpdate、saveAll、updateAll、saveOrUpdateAll、loadAll等批量操作,针对超大数据集场景提供并行执行机制 @Test public void testDeleteAll() { List entites = new ArrayList(); for (int i = 1; i < 3000; i++) { entites.add(new ComplexpkHeadVO(LocalDateTime.parse("2020-09-08T12:11:20"), "S000" + i)); } // 最小1000作为一个并行分组,并行度10、最大等待时间120秒 lightDao.delete().parallelConfig(ParallelConfig.create().groupSize(1000) .maxThreads(10).maxWaitSeconds(120)).many(entites); //批量修改 //lightDao.update().parallelConfig(ParallelConfig.create().groupSize(1000)).many(entites); //批量保存 //lightDao.save().parallelConfig(ParallelConfig.create().groupSize(1000)).many(entites); //批量saveOrUpdate,saveMode(SaveMode.UPDATE)存在则修改 //lightDao.save().saveMode(SaveMode.UPDATE).parallelConfig(ParallelConfig.create() // .groupSize(1000)).many(entites); //lightDao.batch().sql(sql).dataSet(batchDataSet).parallelConfig(ParallelConfig.create().groupSize(1000)).submit() } 2、sql支持if\elseif\else 逻辑 String sql = """ select * from table where 1=1 #[@if(:flag==1) and status=:status #[@if(:operateType==2) and saleType is not :saleType] #[@else and saleType is :saleType] ] #[@elseif(:flag==2) and name like :name] #[@else and orderType=:orderType] #[@if(:tenantId==4) and tenant=1] #[@elseif(:tenantId==3) and tenant=3] """; SqlToyResult result = SqlConfigParseUtils.processSql(sql,new String[] { "flag", "status", "name", "orderType", "saleType", "operateType", "tenantId" },new Object[] { 1, 1, "张", "SALE", null, 4, 3 }); JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

优秀的个人博客,低调大师

vue2的$refs在vue3组合式API中的替代方法

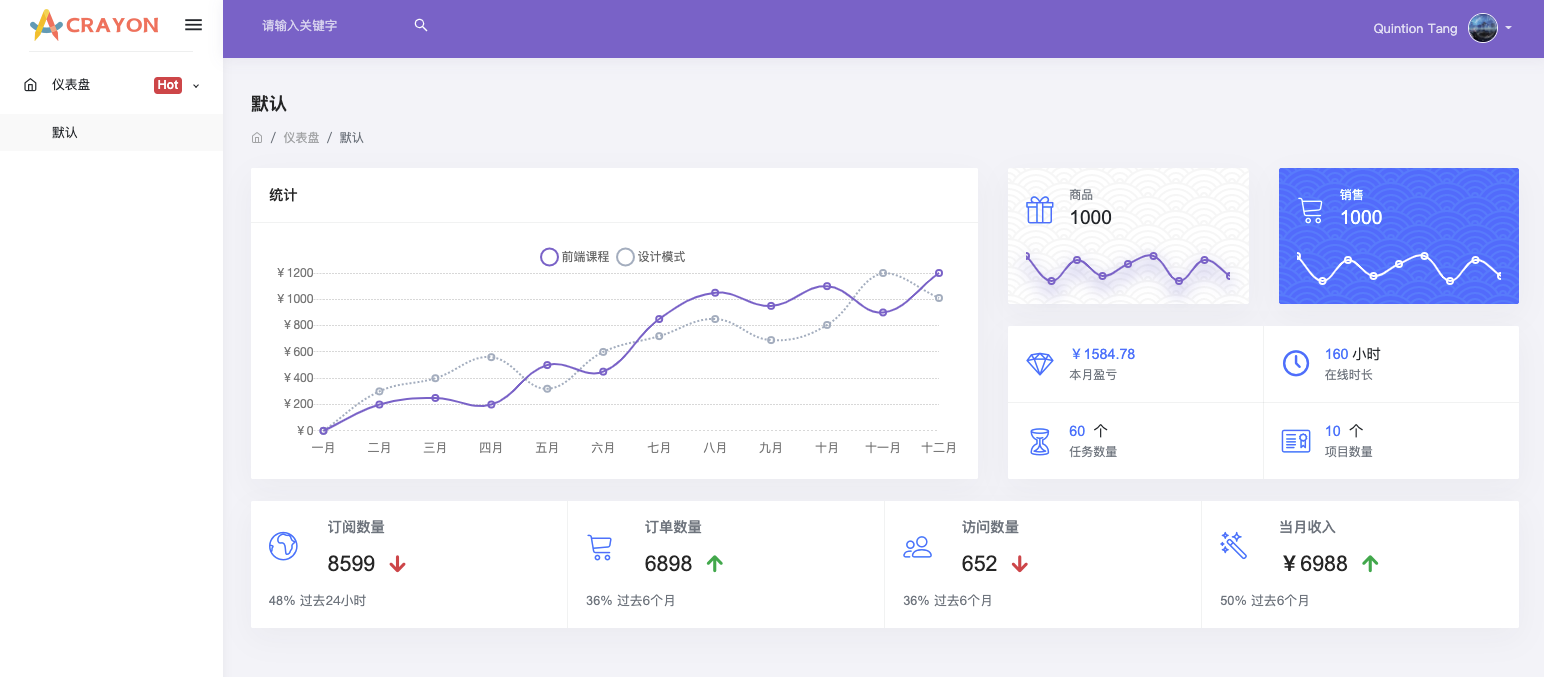
如果你有过vue2的项目开发经验,那么对$refs就很熟悉了。由于vue3的断崖式的升级,在vue3中如何使用$refs呢?想必有遇到过类似的问题,我也有一样的疑惑。通过搜索引擎和github,基本掌握如何使用$refs。在vue3中使用组合式API的函数ref来代替静态或者动态html元素的应用。 最近业余在学习vue3项目《蜡笔(Crayon)管理模板:Vue3 + Vuex4 + Ant Design2》开发,这两天迭代推进了一点,实现了chart图表组件,写文章的时候发现提交代码的commit有错别字。 在vue3中使用组合式API的setup()方法的时候,无法正常使用this.$refs,但可以使用新的函数ref()。 下面代码摘自:https://github.com/QuintionTang/crayon/blob/feat-dashboard/src/qtui/components/Chart.vue <template> <canvas ref="refChart" :height="setHeight"></canvas> </template> <script> import { defineComponent, onMounted, ref, inject, watch } from "vue"; import Chart from "chart.js"; import { deepCopy } from "@/helper/index"; export default defineComponent({ name: "QtChart", props: { type: { type: String, required: true, default: "line", }, data: { type: Object, required: true, default: () => ({}), }, options: { type: Object, default: () => ({}), }, height: { type: Number, default: 0, }, refKey: { type: String, default: null, }, }, setup(props) { const refChart = ref(); // 初始化方法 const init = () => { const canvasChart = refChart.value?.getContext("2d"); const chartHelper = new Chart(canvasChart, { type: props.type, data: deepCopy(props.data), options: props.options, }); watch(props, () => { chartHelper.data = deepCopy(props.data); chartHelper.options = props.options; chartHelper.update(); }); // 附加一个实例给refChart refChart.value.instance = chartHelper; }; // 设置高度 const setHeight = () => { return { height: props.height, }; }; // 绑定一个实例,使用inject注入 const bindInstance = () => { if (props.refKey) { const bind = inject(`bind[${props.refKey}]`); if (bind) { bind(refChart.value); } } }; onMounted(() => { bindInstance(); init(); }); return { refChart, setHeight, }; }, }); </script> 这段代码完整的实现了一个图表组件Chart,其中自定义了属性props,通过把参数传递给setup方法来使用其属性值。html中定义一个ref="refChart"来作为图表的dom对象,在setup方法中通过方法ref方法来定义响应式可变对象,并在setup函数结尾作为返回值。 const refChart = ref(); 需要注意的是,返回值的属性名必须和html中的ref值一致。 下面代码是可以正常执行的。 <template> <canvas ref="refChart" :height="setHeight"></canvas> </template> <script> import { defineComponent, onMounted, ref, inject, watch } from "vue"; import Chart from "chart.js"; import { deepCopy } from "@/helper/index"; export default defineComponent({ name: "QtChart", props: { // ... }, setup(props) { const refChartBox = ref(); // ... return { refChart:refChartBox, }; }, }); </script> 下面的情况,会出现程序错误,无法达到预期效果。应为html中定义的ref="refChart"和setup返回的refChartBox不一致。 <template> <canvas ref="refChart" :height="setHeight"></canvas> </template> <script> import { defineComponent, onMounted, ref, inject, watch } from "vue"; import Chart from "chart.js"; import { deepCopy } from "@/helper/index"; export default defineComponent({ name: "QtChart", props: { // ... }, setup(props) { const refChartBox = ref(); // ... return { refChartBox, }; }, }); </script> 结论 本文只是简单的介绍ref方法的使用,正好在项目中用到,后续将继续边学边推进项目并做好笔记。
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册