首页 文章 精选 留言 我的

精选列表

搜索[Java库],共10000篇文章
优秀的个人博客,低调大师

Java函数式编程-4.lambda表达式排序

1.lambda表达式排序 我们首先看几个比较常见的排序例子,基本数据类型的排序 List list = Arrays.asList(1,3,2,5,4); list.sort(Comparator.naturalOrder()); System.out.println(list); list.sort(Comparator.reverseOrder()); System.out.println(list); 输出结果: [1, 2, 3, 4, 5] [5, 4, 3, 2, 1] 我们可以看到执行结果是符合预期的,但是多数场景我们可能需要针对对象的某个属性进行排序,那么应该怎样做呢?我们看下边的例子: public class Student { private String name; private String sexual; private Integer age; public Student(String name, String sexual,Integer age) { this.name = name; this.sexual = sexual; this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } public String getSexual() { return sexual; } public void setSexual(String sexual) { this.sexual = sexual; } public Integer getAge() { return age; } public void setAge(Integer age) { this.age = age; } @Override public String toString() { return "Student{" + "name='" + name + '\'' + ", sexual='" + sexual + '\'' + ", age=" + age + '}'; } public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", 12), new Student("john", 13), new Student("lily", 11), new Student("lucy", 10) ); list.sort(Comparator.comparing(Student::getAge)); System.out.println(list); list.sort(Comparator.comparing(Student::getAge).reversed()); System.out.println(list); } } 输出结果: [Student{name='lucy', age=10}, Student{name='lily', age=11}, Student{name='jack', age=12}, Student{name='john', age=13}] [Student{name='john', age=13}, Student{name='jack', age=12}, Student{name='lily', age=11}, Student{name='lucy', age=10}] 如果我们需要按照性别分组再排序又该如何实现呢?我们接着看下边的例子 public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", "male", 12), new Student("john", "male", 13), new Student("lily", "female", 11), new Student("david", "male", 14), new Student("luck", "female", 13), new Student("jones", "female", 15), new Student("han", "male", 13), new Student("alice", "female", 11), new Student("li", "male", 12) ); Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge)) .collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); System.out.println(groupMap.toString()); } } 输出结果: { female = [ Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 我们看到上边的输出结果存在一个问题,如果年龄相同则没有按照姓名排序,怎样实现这个功能呢?我们接着看下边的例子 Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge) .thenComparing(Student::getName)).collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); 输出结果: { female = [ Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 看输出结果是符合预期的,到此为止我们的lambda表达式排序已经基本介绍完了,当然还有一些特殊的场景没涉猎到,大家可以根据兴趣再深入探索。

优秀的个人博客,低调大师

JAVA使用for循环会重复调用list.size()吗?

最近有朋友讨论说for循环里不要用list.size(),这样会导致每次都调用一次list.size()接口会耗性能,建议我们在外面使用一个变量来存储这个list.size()的值再放到循环里面,真的是这样吗?我做了个小测试,代码如下: public class Test2 { public static void main(String[] args) { List list = new ArrayList<String>(); list.add("1"); list.add("2"); for (int i = 0; i < list.size(); i++) { System.out.println(i); } } } 这里将list.size()放在了for循环里,按朋友的说法,这里应该会调用多次。 接下来我查看了字节码发现,这里确实会调用多次list.size()方法,字节码如下: 具体字节码指令解析可查看:http://www.blogjava.net/DLevin/archive/2011/09/13/358497.html 接着查看了ArrayList调用size()方法的源码是直接返回一个int 型的 size变量的,而这个size变量是每次新增和删除都会改变这个size的值 结论:经过网友们热情的探讨与更正,for循环里会多次调用list.size(),list.size()方法会直接返回一个声明在类中的size全局变量,虽然这个size会直接保存在堆中,但每次发生函数调用确实会发生压栈出栈的性能开销。

优秀的个人博客,低调大师

java中的四种引用(强,软,弱,虚)

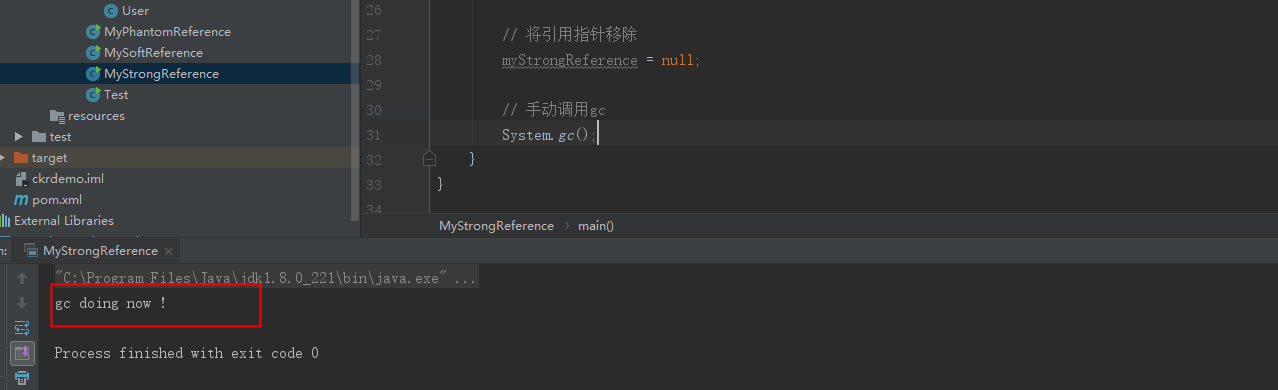
一、强引用 概念:当对象不可达时,即可回收。 /** * 强引用。当强引用指针不存在时,对象将被回收 * 也可以理解为 ROOT 引用消失时,对象将被回收 */ public class StrongReference { /** * jvm在执行gc时 将回调该方法 * @throws Throwable */ @Override protected void finalize() throws Throwable { System.out.println("gc doing now !"); } public static void main(String[] args) { StrongReference strongReference = new StrongReference(); // 将引用指针移除 strongReference = null; // 手动调用gc System.gc(); } } 二、软引用 概念: 当内存空间不足时,将被回收。 /** * Xmx2oM 设置最大堆内存为20M * 软引用 会在内存空间不够时,进行 gc 操作。 从而 回收 软引用对象 */ public class MySoftReference { public static void main(String[] args) { SoftReference<byte[]> softReference = new SoftReference<byte[]>(new byte[1024*1024*10]); System.out.println("第一次gc前 : byte[]:" + softReference.get()); System.gc(); System.out.println("第一次执行gc后 : byte[]:" + softReference.get()); byte[] bytes = new byte[1024*1024*12]; System.out.println("内存不够后 : byte[]:" + softReference.get()); } } 上述代码的补充:源码中,我将虚拟机参数 -Xmx 设置为20M。 我先后 new 出来的 两个byte 数组均超过10M。 目标对象均会存放在老年代中。(按照 新生代 : 老年代 = 1:2.) 大概内存分布为。 老年代 20 * 2/3 约为13.3M。 年轻代 约为 20 * 1/3 约为 6.7M。其中 年轻代 eden:s0:s1 = 8:1:1 故 Eden 约为 5.3 M。So/S1 约为0.67M。如下图所示,基本跟计算出来的结果吻合。至于 多出来的部分,个人理解,jvm对计算出的堆大小自我调优勒。 基于对堆内存的分析。可以看出。 第一次 老年代 装入 10 M的 对象。 第二次 想要 装入 12M 对象。肯定装不下。 由于是 软引用。 jvm gc 时会将这部分内容先回收掉。 所以这里没有 出现OOM 的问题。 三、弱引用 (比较重要,面试常考题之一) 备注: ThreadLocal 里使用勒 弱引用。会产生内存泄露的问题。下篇博客,我会加以说明。 概念:jvm无视该引用。该对象可被弱引用对象获取到对象的实例。 当jvm执行gc时,将直接被回收。(提前条件:没有强引用存在)。 示例一: /** * 弱引用 虚拟机无视该引用。只要gc 一定会被回收(前提该对象没有被强引用) */ public class Test { public static void main(String[] args) { Teacher teacher = new Teacher(); WeakReference<Teacher> weakReference = new WeakReference<Teacher>(teacher); System.out.println(weakReference.get()); // 若不将 teacher 置为null,则还存在一个强引用。不会被gc回收 //teacher = null; System.gc(); System.out.println(weakReference.get()); } 示例二: /** * User 对象持有 Teacher 对象的强引用。 * 当teacher 被置为null 时。 teacher 的强应用 随之消失。 * 而 User 对 Teacher 的强引用还在。 故 user.getTeacher() 并不是null * 所以 teacher 并不会被 gc 回收。 * * 当 user 也被置为null时。 user 对 teacher 的强引用也不存在勒。 * 此时 teacher 将会被gc回收 */ public class Test1 { public static void main(String[] args) { User user = new User(); Teacher teacher = new Teacher(); teacher.setName("zs"); user.setTeacher(teacher); WeakReference<Teacher> weakReference = new WeakReference<Teacher>(teacher); System.out.println(System.identityHashCode(weakReference.get())); System.out.println(System.identityHashCode(teacher)); System.out.println(System.identityHashCode(user.getTeacher())); teacher = null; System.out.println(user.getTeacher().getName()); // 当user 置为null 时, 对teacher 的强引用消失。 此时 teacher 将会被回收。 user = null; System.gc(); System.out.println(weakReference.get()); } } 示例三: public class People extends WeakReference<Teacher> { public People(Teacher referent) { super(referent); } } /** * People 继承自WeakReference<T> People也是一个虚拟引用对象。 * 所以teacher 被置为null时,强引用指针被清除。 * teacher 就会被gc回收。 */ public class Test2 { public static void main(String[] args) { Teacher teacher = new Teacher(); People people = new People(teacher); teacher = null; System.gc(); System.out.println(people.get()); } } 四、虚引用 概念:该引用很鸡肋。一个对象被虚引用所引用时。并不能获取到该实例的对象。只有当该对象被回收时,才会收到通过并存入队列中。基本上用于操作直接内存来使用的。 可用于对一些重要对象的gc的监听。或者监听gc的频率(不如打印gc日志来的简单直观)。 以下 jvm参数 -Xmx20M。 当然也可以更小,主要是为了看gc 的效果。 /** * 虚拟引用 * 比较鸡肋,虚拟引用的对象,并不能get()出来。 而是直接操作 操作系统内存的。 * 虚拟引用的目标对象,被回收后,会存入队列中 * 需要新启一个线程监听该队列中,是否有数据。有数据 则 回收掉直接内存。 */ public class MyPhantomReference { private static final List<Object> LIST = new LinkedList<Object>(); private static final ReferenceQueue<MyPhantomReference> QUEUE = new ReferenceQueue<MyPhantomReference>(); public static void main(String[] args) { PhantomReference<MyPhantomReference> phantomReference = new PhantomReference<MyPhantomReference>(new MyPhantomReference(),QUEUE); new Thread( () -> { while(true){ LIST.add(new byte[1024*1024]); try{ Thread.sleep(1000); }catch(Exception e){ e.printStackTrace(); Thread.currentThread().interrupt(); } System.out.println(phantomReference.get()); } }).start(); new Thread( () -> { while(true){ Reference<? extends MyPhantomReference> poll = QUEUE.poll(); if(poll != null){ System.out.println("虚拟引用被jvm回收啦 ----" + poll); } } }).start(); try{ Thread.sleep(500); }catch(Exception e){ e.printStackTrace(); } } }

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

用户登录
用户注册