首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

PHP学习7——文件系统

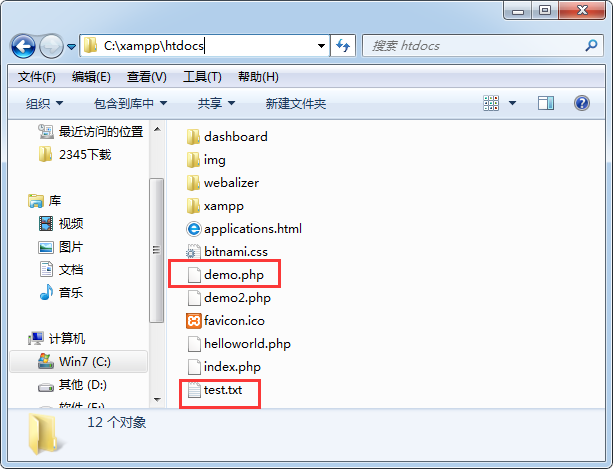
主要内容: 打开和关闭文件 文件类型 文件处理 目录处理 访问远程文件 文件锁定 文件上传 数据除了可以存储在数据库中,我们主要的还是存储在文件中,而且存储在文件中更加的方便直接。 打开和关闭文件 打开fopen($filepath,$mode) 关闭fclose($file) 注意,我的test.txt文件和demo.php在同一个目录下 demo.php <?php //打开文件r只读,r+读写,打开成功返回true,否则false $file=fopen("C:/xampp/htdocs/test.txt","r");//绝对路径 if($file){ echo "文件test.txt打开了<br/>"; }else{ echo "文件test.txt打开失败文件打开了<br/>"; } $file2=fopen("./test.txt","r");//相对路径 if($file2){ echo "文件test.txt打开了<br/>"; }else{ echo "文件test.txt打开失败<br/>"; } if(fclose($file)){ echo "文件test.txt成功关闭<br/>"; } if(fclose($file2)){ echo "文件test.txt成功关闭<br/>"; } ?> 输出 文件test.txt打开了 文件test.txt打开了 文件test.txt成功关闭 文件test.txt成功关闭 文件类型 无论是txt文件还是jpg文件,还是doc文件,都属于同一种文件类型,file 文件夹是另外一种文件类型,dir 文件类型: file普通文件 dir目录类型 char字符串设备,键盘,打印机 block块设备,某个磁盘分区 link快捷方式,指针的指针 fifo管道,用于把一个进程传到另外一个进程 unknow未知文件 使用filetype($filename)判断文件的类型,返回字符串 stat($filename)可以输出文件的大部分属性 stat.php <?php print_r(stat("./test.txt")); ?> 输出 Array ( [0] => 2 [1] => 0 [2] => 33206 [3] => 1 [4] => 0 [5] => 0 [6] => 2 [7] => 12 [8] => 1533566405 [9] => 1533566414 [10] => 1533566405 [11] => -1 [12] => -1 [dev] => 2 [ino] => 0 [mode] => 33206 [nlink] => 1 [uid] => 0 [gid] => 0 [rdev] => 2 [size] => 12 [atime] => 1533566405 [mtime] => 1533566414 [ctime] => 1533566405 [blksize] => -1 [blocks] => -1 ) 文件处理 readfile($filename)读取文件内容写入输出缓冲,并返回文件字符串大小,报错返回false fgets($filename)从文件指针读取一行,出错返回false fgetc($filename)从文件指针读取一个字符,出错返回false readfile.php <?php readfile("./test.txt"); ?> test.txt 输出 这是一个测试 这是一个测试这是一个测试 这是一个测试这是一个测试 这是一个测试这是一个测试 这是一个测试这是一个测试 这是一个测试这是一个测试 这是一个测试这是一个测试 fwrite($filename,$date)向文件中写入信息 fwrite.php <?php //使用@隐藏提示信息,@叫做错误控制运算符 $file=@fopen("./test.txt","r+"); echo $file."<br/>"; $num=fwrite($file,"今天是个好日子,心想的事儿都能成"); if($num){ echo "写入成功,写入了$num 字符"; }else{ echo "写入失败"; } ?> 输出 Resource id #3 写入成功,写入了48 字符 test.txt 但是使用r+模式,会覆盖原先的内容,如果不想覆盖原先的内容,而是在原先基础上增加内容,应该使用追加模式,这里不研究。 常用方法: copy($source,$dest)复制文件到指定路径 rename($oldname,$newname)重命名文件 unlink($filename)删除文件 pathinfo($path,$options)返回文件的路径信息 realpath($path)返回文件的绝对路径 is_file($filename)判断是否是文件 目录处理 目录是一种特殊的文件类型 判断是否是目录isdir($path) 打开目录opendir($path) 关闭目录closedir($path) dir.php <?php $path="D:\资料"; if(is_dir($path)){ //打开目录 $dir=opendir($path); echo "文件打开成功<br/>"; }else{ echo "打开失败,程序退出<br/>"; exit(); } closedir($dir); ?> 输出 文件打开成功 操作目录方法: readdir($path)浏览目录,返回一个文件名 mkdir($pathname)创建目录 rmdir($pathname)删除目录 chdir($pathname)改变目录 dir_operate.php <?php if(chdir("D:/")){ echo "切换到D:/<br/>"; }//成功返回1 if(mkdir("D:/test")){ echo "创建文件夹D:/test<br/>"; }//成功返回1 if(rmdir("D:/test")){ echo "删除文件夹D:/test<br/>"; }//成功返回1 ?> 输出 切换到D:/ 创建文件夹D:/test 删除文件夹D:/test 访问远程文件 PHP支持URL格式的文件调用,需要在php.ini中设置一下 url_file.php <?php $html=file_get_contents("http://www.baidu.com/"); echo $html; ?> 输出 文件锁定 在向一个文件写入内容时,如果其他用户也修改这个文件,可能会造成冲突,为了防止冲突,使用flock()来锁定文件 flock.php <?php $file=fopen("C:/xampp/htdocs/test.txt","r+"); if(flock($file,LOCK_EX)){ echo "文件已经锁定,可以安全写入数据"; }else{ echo "文件未锁定,写入数据是不安全的"; } fclose($file); ?> 输出 文件已经锁定,可以安全写入数据 文件上传 首先需要配置php.ini文件 单文件上传 使用move_upload_file($tmpname,$name) upload.php <html> <form method="post" enctype="multipart/form-data"> <input type="file" name="upfile" /> <input type="submit" value="上传" /> </form> </html> <?php $file=fopen("C:/xampp/htdocs/test.txt","r+"); if(!empty($_FILES)){ foreach($_FILES["upfile"] as $k=>$v){ echo "$k=>$v<br/>"; } }else{ echo "没有上传文件"; } ?> 未上传效果 上传文件 上传成功 upload2.php <html> <form method="post" enctype="multipart/form-data"> <input type="file" name="upfile" /> <input type="submit" value="上传" /> </form> </html> <?php if(!empty($_FILES)){ $tmpname=$_FILES["upfile"]["tmp_name"];//文件临时名 $name=$_FILES["upfile"]["name"];//文件原名 move_uploaded_file($tmpname,$name)or die("文件上传失败,程序退出"); echo "文件上传成功"; }else{ echo "没有上传文件"; } ?> 未上传 上传 文件已经上传到跟目录 ok,文件上传先到这里

优秀的个人博客,低调大师

ES6学习笔记(一)

一、let 命令 1、let命令 1.1基本用法 1.1.1 let用于声明变量 类似var,但是let声明的变量只在当前代码块内有效 { let a = 10; var b = 1; } a // ReferenceError: a is not defined. b // 1 let命令在for 循环的计数器中很实用。 1.1.2 let不存在变量提升 var命令会发送“变量提升”,即变量可以在声明之前使用,值为undefined 正常来说变量使用一定要在声明之后。 1.1.3 暂时性死区 只要块级作用域内存在let命令,它所生命的变量就绑定(binding)这个区域,不受外部影响。 ES6明确规定,在区块中存在let 和 const命令,这个区块对这些命令声明的变量都是 不能提前使用的,会报错。 总之在代码块之内,Let声明的变量不可提前使用。 1.1.4不允许重复声明 let不允许在相同作用域内重复声明同一个变量。所以不能在函数内部重新声明参数。 function func(arg) { let arg; // 报错 } function func(arg) { { let arg; // 不报错 } } 1.1.5 ES6的块级作用域 let为JavaScript新增了块级作用域,允许块级作用域的任意嵌套。 {{{{{let insane = 'Hello World'}}}}}; 外层作用域无法读取内层作用域内的变量。 {{{{ {let insane = 'Hello World'} console.log(insane); // 报错 }}}}; 内层作用域可以定义外层作用域的同名变量。 {{{{ let insane = 'Hello World'; {let insane = 'Hello World'} }}}}; 1.1.6 允许块级作用域中声明函数 // 浏览器的 ES6 环境 function f() { console.log('I am outside!'); } (function () { if (false) { // 重复声明一次函数f function f() { console.log('I am inside!'); } } f(); }()); // Uncaught TypeError: f is not a function ES6的块级作用域允许声明函数的规则只在使用大括号的前提下成立,否则就会报错。 1.1.7 do表达式 块级作用域是一个语句,将多个操作封装在一起,没有返回值。 使得块级作用域可以变为表达式,也就是说可以返回值,办法就是在块级作用域之前加上do,使它变为do表达式。 let x = do { let t = f(); t * t + 1; }; 上面代码中,变量x会得到整个块级作用域的返回值。

优秀的个人博客,低调大师

Java 学习(21)--集合笔试题

集合笔试题 1.产生10个1-20之间的随机数,要求随机数不能重复(List 和 Set 分别实现) 分析:1.创建一个 ArrayList 对象 2.如果 ArrayList 对象长度小于 10 3.在循环中,创建一个 Random 对象,产生 1-20 之间的随机数 4. 通过 ArrayList 对象 d constains 方法判断,该随机数是否存在于集合中,不存在则加入,存在则放弃。 代码: 1.List package com.neuedu.collection; import java.util.ArrayList; import java.util.Random; public class Demo1 { public static void main(String[] args) { ArrayList<Integer> list = new ArrayList<>(); while(list.size() < 10){ Random random = new Random(); int nextInt = random.nextInt(20) + 1; if(!list.contains(nextInt)) { list.add(nextInt); } } System.out.println(list); } } 输出: 2.Set (无序【添加顺序和打印顺序不一致】、不重复) package com.neuedu.collection; import java.util.HashSet; import java.util.Set; public class Demo2 { public static void main(String[] args) { Set set = new HashSet<Integer>(); while(set.size() < 10) { int random = (int)(Math.random() * 20) + 1; set.add(random); } System.out.println(set); } } 输出: 拓展:当两个内容相同则输出一个,不同则都输出 hashcode: 根据一个对象,通过一定的算法,计算出一个 32位 的 2进制 表示的数据(不定长数据 转换 定长数据) Objecthashcode(默认的hashcode):根据对象在内存的地址来计算hashcode 值(基本都不相同) name 是string 类型,string 类型重写 hashcode ,当字符串内容相同则 hashcode 值相同(属性相关) set 结构: 竖:hashtable(hash 桶)里面的小格(hashcode),当hashcode 值相同时才会放到同一个小格里面; 横:LinkedList(链表),里面的小格(equal 后的值),若二者相同则表示在链表的同一格里面,重复的不在添加到小格中;如二者不同则不在同一格里面,将不同的放在后面的小格里面。 package com.neuedu.collection; import java.util.HashSet; import java.util.Set; public class SetDemo { public static void main(String[] args) { Set<Person> set = new HashSet<Person>(); Person p1 = new Person("林青霞", 50); Person p2 = new Person("林青霞", 40); set.add(p1); set.add(p2); System.out.println(set); } } class Person { private String name; private int age; public Person(String name, int age) { super(); this.name = name; this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } public int getAge() { return age; } public void setAge(int age) { this.age = age; } @Override public String toString() { return "Person [name=" + name + ", age=" + age + "]"; } @Override public int hashCode() { return name.hashCode() + age; } @Override public boolean equals(Object obj) { if(!(obj instanceof Person)){ return false; } Person person = (Person)obj; if(this.name.equals(person.name) && this.age == person.age) { return true; } return false; } } 输出: 2.键盘录入5个学生信息(姓名、语文成绩、数学成绩、英语成绩)按照总分从高到低的顺序(若总分相同,则按照语文、数学、英语的成绩进行倒序) 二叉树:24 18 30 16 20 28 35 中序遍历(详解) :左 中 右 16 18 20 24 28 30 35 package com.neuedu.collection; import java.util.Scanner; import java.util.Set; import java.util.TreeSet; public class Demo3 { public static void main(String[] args) { TreeSet<Student> treeSet = new TreeSet<>(); Scanner scanner = new Scanner(System.in); for(int i = 1; i <= 5; i++) { System.out.println("请输入第" + i + "个学生的信息"); System.out.println("姓名:"); String name = scanner.next(); System.out.println("语文 成绩:"); int chinese = scanner.nextInt(); System.out.println("数学成绩:"); int math = scanner.nextInt(); System.out.println("英语成绩:"); int english = scanner.nextInt(); Student student = new Student(name, chinese, math, english); treeSet.add(student); } System.out.println("学生成绩录入完毕"); System.out.println("按照分数排序后的结果是:"); System.out.println(treeSet); } } class Student implements Comparable<Student>{ private String name; private int chinese; private int math; private int english; public String getName() { return name; } public void setName(String name) { this.name = name; } public int getChinese() { return chinese; } public void setChinese(int chinese) { this.chinese = chinese; } public int getMath() { return math; } public void setMath(int math) { this.math = math; } public int getEnglish() { return english; } public void setEnglish(int english) { this.english = english; } public int getTotal() { return chinese + english + math; } @Override public String toString() { return "Student [name=" + name + ", chinese=" + chinese + ", math=" + math + ", english=" + english + "]"; } public Student(String name, int chinese, int math, int english) { super(); this.name = name; this.chinese = chinese; this.math = math; this.english = english; } @Override public int compareTo(Student o) { int temp = o.getTotal() - this.getTotal(); if(temp == 0) { temp = o.chinese - this.chinese; } if(temp == 0) { temp = o.math - this.math; } if(temp == 0) { temp = o.english - this.english; } /*temp = (temp != 0 ? temp : (o.chinese - this.chinese)); temp = (temp != 0 ? temp : (o.math - this.math)); temp = (temp != 0 ? temp : (o.english - this.english));*/ return temp; } } 输出:(只有2名学生) 3.“aababcabcdabcde”获取字符串中每个字母出现的次数,要求结果 a(5) b(4) c(3) 分析:1.将字符串转换成一个字符数组 2.对字符数组进行遍历,放到 Set 集合中 package com.neuedu.collection; import java.util.Map.Entry; import java.util.Scanner; import java.util.Set; import java.util.TreeMap; import java.util.TreeSet; import org.omg.CosNaming.NamingContextExtPackage.StringNameHelper; public class Demo4 { public static void main(String[] args) { Scanner scanner = new Scanner(System.in); System.out.println("请输入字符串"); String str = scanner.next(); TreeSet<Character> treeSet = new TreeSet<>(); for(int i = 0; i < str.length(); i++) { treeSet.add(str.charAt(i)); } System.out.println(treeSet); for(Character c : treeSet) { int count = 0; for(int i = 0; i < str.length(); i++) { if(str.charAt(i) == c) { count++; } } System.out.print(c+"(" + count + ") " ); } } } 输出: 方法二: package com.neuedu.collection; import java.util.Map.Entry; import java.util.Scanner; import java.util.Set; import java.util.TreeMap; import java.util.TreeSet; import org.omg.CosNaming.NamingContextExtPackage.StringNameHelper; public class Demo4 { public static void main(String[] args) { Scanner scanner = new Scanner(System.in); System.out.println("请输入字符串"); String str = scanner.next(); TreeMap<Character, Integer> map = new TreeMap<>(); //遍历字符串 for(int i = 0; i < str.length(); i++) { //获取每个字符 Character key = str.charAt(i); //判断map中是否包含该字符,如果不包含,value=1, if(!map.containsKey(key)) { map.put(key, 1); }else {//如果map中已经包含改字符,则取出原来的值+1 map.put(key, map.get(key) + 1); } } StringBuffer sb = new StringBuffer(); Set<Entry<Character, Integer>> entrySet = map.entrySet(); for(Entry<Character, Integer> entry : entrySet) { sb.append(entry.getKey()).append("(").append(entry.getValue()).append(") "); } System.out.println(sb.toString()); } 输出: 标准方法: //“aababcabcdabcde”获取字符串中每个字母出现的次数,要求结果 a(5) b(4) c package com.hd.file; import java.util.Set; import java.util.TreeMap; public class demo3 { public static void main(String[] args) { String str = "aababcabcdabcde"; TreeMap<Character,Integer> map = new TreeMap<Character,Integer>(); char[] chs = str.toCharArray(); for(Character ch:chs){ Integer value = map.get(ch); if(value==null){ map.put(ch, 1); }else{ value++; map.put(ch, value); } } Set<Character> set = map.keySet(); StringBuilder sb = new StringBuilder(); for(Character s:set){ Integer value = map.get(s); sb.append(s).append("(").append(value).append(")"); } System.out.println(sb.toString()); } } 输出: 4.模拟斗地主洗牌、发牌、看牌 方法一: 分析: 分析: * 1:创建一副牌 * 1.1 : 创建一个牌盒 * 1.2: 装牌 * 2:洗牌 * 3:发牌 * 4:看牌 package com.neuedu.collection; import java.util.ArrayList; import java.util.Collections; public class PokerDemo { public static void main(String[] args) { ArrayList<String> poker = new ArrayList<>(); String[] colors = {"","","",""}; String[] numbers = {"A","2","3","4","5","6","7","8","9","10","J","Q","K"}; for(String color : colors) { for(String number : numbers) { poker.add(color.concat(number)); } } poker.add("大王"); poker.add("小王"); //洗牌 Collections.shuffle(poker); //创建打牌的人 ArrayList<String> rulai = new ArrayList<>(); ArrayList<String> sunwukong = new ArrayList<>(); ArrayList<String> weiwei = new ArrayList<>(); ArrayList<String> dipai = new ArrayList<>(); //摸牌 for(int i = 0; i < poker.size(); i++) { if(i >= poker.size() - 3) { dipai.add(poker.get(i)); } if(i % 3 == 0) { rulai.add(poker.get(i)); } if(i % 3 == 1) { sunwukong.add(poker.get(i)); } if(i % 3 == 2) { weiwei.add(poker.get(i)); } } //看牌 lookPoker("A", rulai); lookPoker("B", sunwukong); lookPoker("C", weiwei); lookPoker("底牌", dipai); } public static void lookPoker(String name, ArrayList<String> pai) { System.out.println(name + "的牌是:"); for(String s : pai) { System.out.print(s + " "); } System.out.println(); } } 输出: 方法二: 思路: * 1:创建一个HashMap集合 * 2:创建一个ArrayList,用来存放牌的编号 * 3:创建花色数组和点数数组 * 4:从1编号开始向Hashmap中存放相应的编号和对应的牌,同时往ArrayList中存储编号 * 5:洗牌(洗的是编号) * 6:发牌(发牌发的也是编号,为了保证编号是排序的,应该创建一个TreeSet集合) * 7:看牌(遍历TreeSet,获取编号,然后从HashMap中找到对应的牌) package com.neuedu.collection; import java.util.ArrayList; import java.util.Collections; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.Set; import java.util.TreeSet; /** * 4: 模拟斗地主洗牌、发牌和看牌 * 思路: * 1:创建一个HashMap集合 * 2:创建一个ArrayList,用来存放牌的编号 * 3:创建花色数组和点数数组 * 4:从1编号开始向Hashmap中存放相应的编号和对应的牌,同时往ArrayList中存储编号 * 5:洗牌(洗的是编号) * 6:发牌(发牌发的也是编号,为了保证编号是排序的,应该创建一个TreeSet集合) * 7:看牌(遍历TreeSet,获取编号,然后从HashMap中找到对应的牌) * */ public class PokerDemo2 { public static void main(String[] args) { Map<Integer,String> poker = new HashMap<>(); List<Integer> num = new ArrayList<>(); String[] colors = {"","","",""}; String[] numbers = {"3","4","5","6","7","8","9","10","J","Q","K","A","2"}; int count = 1; for(String number : numbers) { for(String c : colors) { poker.put(count, c.concat(number)); num.add(count); count++; } } poker.put(count, "小王"); num.add(count); count++; poker.put(count, "大王"); num.add(count); //洗牌 Collections.shuffle(num); TreeSet<Integer> linQingXia = new TreeSet<>(); TreeSet<Integer> zhouRunFa = new TreeSet<>(); TreeSet<Integer> liuDeHua = new TreeSet<>(); TreeSet<Integer> diPai = new TreeSet<>(); for(int i = 0; i <num.size(); i++) { if(i >= num.size() - 3) { diPai.add(num.get(i)); continue; } if(i % 3 == 0) { linQingXia.add(num.get(i)); } if(i % 3 == 1) { zhouRunFa.add(num.get(i)); } if(i % 3 == 2) { liuDeHua.add(num.get(i)); } } //看牌 lookPoker("A", linQingXia, poker); lookPoker("B", zhouRunFa, poker); lookPoker("C", liuDeHua, poker); lookPoker("底牌", diPai, poker); } public static void lookPoker(String name,Set<Integer> set,Map<Integer, String> map) { System.out.println(name + "的牌是:"); for(Integer key : set) { System.out.print(map.get(key) + " "); } System.out.println(); } } 输出:

优秀的个人博客,低调大师

Java 学习(20)--异常 / IO 流

异常(Exception) (1)程序出现的不正常的情况。 (2)异常的体系 Throwable(接口,将异常类对象交给 JVM 来处理) |--Error 严重问题,我们不处理。(jvm 错误,程序无法处理) |--Exception异常 (程序可以处理的异常) |--RuntimeException (运行期异常,可以通过逻辑判断进行控制,不需要捕获 处理方法:1.try...catch 2.throws) |--其他(受查)异常 (继承自Exception,且不是RuntimeException,必须要捕获) (3)异常的处理: A:JVM 的默认处理 当系统发生运行异常时,Jvm 会创建一个异常类的对象;查看是否对这个异常进行捕获和处理,若没有,则把异常的名称 ,原因,位置等信息输出在控制台,但是程序不能继续执行了。 B:自己处理 a:try...catch...finally 自己编写处理代码 ,后面的程序可以继续执行 b:throws 把自己处理不了的,在方法上声明,告诉调用者,这里有问题 (4)面试题 A:编译期异常和运行期异常的区别 ? 编译期异常必须要处理的,否则编译不通过;运行期异常可以不处理,也可以处理 B:throw和 throws 的区别 throw:在方法体中,后面跟的是异常对象名 ,并且只能是一个 throw 抛出的是一个异常对象,说明这里肯定有一个异常产生了 throws:在方法声明后,后面跟的是异常的类名 , 可以是多个 ;throws 是声明方法有异常,是一种可能性,这个异常并不一定会产生, (5)finally A:finally用于释放资源,它的代码永远会执行。 特殊情况:在执行到 finally 之前jvm 退出了 B:面试题 a:final,finally,finalize 的 区 别 ? 详解 b: 如果在 catch里面有 return, 请问 finally还执行吗 ?如果执行 ,在 return前还是后 会/前(实际上在中间) C:异常处理的变形 try...catch...finally / try...catch... / try...catch...catch.../try...catch...catch...fianlly / try...finally (6)自定义异常 继承自 Exception 或者 RuntimeException, 只需要提供无参构造和一个带参构造即可 (7)异常的注意实现 A:父的方法有异常抛出 ,子的重写方法在抛出异常的时候必须要小于等于父的异常 B:父的方法没有异常抛出 ,子的重写方法不能有异常抛出 C:父的方法抛出多个异常 ,子的重写方法必须比父少或者小 IO 流 File 我们要想实现输入输出操作就必须要知道,java在硬盘上的表现形式,也就是说硬盘上面的文件和文件夹在java中有一个专门的 类来表示:File;IO流操作中大部分都是对文件的操作,所以 Java就提供了 File类供我们来操作文件 (java类:成员变量,成员方法,构造方法,成员代码块,成员内部类) 构造方法 A:File file =newFile("e:\\demo\\a.txt");// 根据一个路径得到 File对象 B:File file =newFile("e:\\demo","a.txt");// 根据一个目录和一个子文件 /目录得到File 对象 C:File file = new File("e:\\demo"); File file2 =newFile(file,"a.txt");// 根据一个父 File对象和一个子文件 /目录得到File对象 1.File(File parent, String child) :根据一个File对象和一个文件名创建File对象 2.File(String pathname):根据指定的路径创建File对象 3.File(String parent, String child) :根据一个路径字符串和一个文件名创建File对象 public class FileDemo1 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\a.txt"); //全路径 File file1 = new File("d:\\test", "a.txt"); //真正的路程 , 要创建的文件名 File file1 = new File("d:\\test"); File file2 = new File(file1,"a.txt"); //将路径封装到 file 对象里去; //封装好的对象 , 要创建的文件名 //以上三种方式实现的效果是一样的 System.out.println(file2); } } File 类的功能 A:创建功能 publicbooleancreateNewFile() :根据file对象的路径,创建一个硬盘中的文件或路径, 如果没有对应的路径,就会抛出异常 java.io.IOException; 如果该路径下没有对应文件,则创建成功,返回true; 如果该文件已经存在则创建失败,返回false publicbooleanmkdir(): 创建一个文件夹,创建成功返回true 如果没有对应的路径,则创建失败,返回false 如果该文件夹已经存在,则创建失败,返回false publicbooleanmkdirs() :创建文件夹,如果路径中的文件夹不存在,就一起创建出来 public class FileDemo2 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\a.txt"); System.out.println("createNewFile:" + file.createNewFile()); File file = new File("d:\\test\\demo"); System.out.println("mkdir:" + file.mkdir()); File file1 = new File("d:\\test\\aaa"); System.out.println("mkdir:" + file1.mkdir()); File file2 = new File("d:\\test\\aaa\\bbb"); System.out.println("mkdir:" + file2.mkdir()); File file3 = new File("d:\\test\\aaa\\bbb\\ccc"); System.out.println("mkdir:" + file3.mkdir()); File file = new File("d:\\test\\aaa\\bbb\\ccc"); System.out.println("mkdirs:" + file.mkdirs()); //说明骑白马的不一定是王子 File file = new File("D:\\test\\a.txt"); System.out.println("mkdir:" + file.mkdir()); } } B:删除功能 public boolean delete() :java删除不走回收站,所删除时一定要小心;如果删除时对应的路径名不存在, 则删除失败,返回false;删除此抽象路径名表示的文件或目录。如果此路径名表示一个目录,则该目录必须为空才能删除。 public class FileDemo3 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\aaa\\bbb"); System.out.println("delete:" + file.delete()); } } C:重命名功能 public boolean renameTo(File dest) :将File对象对应的路径名改为传入的file对象对应路径名, 如果重命名前后的两个文件不在同一个文件夹下,则该方法有剪切的效果 如果路径名相同,就是改名。 如果路径名不同,就是改名并剪切。 路径以盘符开始:绝对路径 c:\\a.txt 路径不以盘符开始:相对路径 a.txt public class FileDemo4 { public static void main(String[] args) throws IOException { File file = new File("d:\\test\\lihongxiao.txt"); File newFileName = new File("d:\\test\\demo\\weiwei.txt"); System.out.println("renameTo:" + file.renameTo(newFileName)); File file = new File("aaa.txt"); file.createNewFile(); //没有写盘符,叫做相对路径,会在项目的根路径下创建 File file = new File("aaa\\bbb\\ccc"); System.out.println("mkdirs:" + file.mkdirs()); // 相对路径 } } D:判断功能 publicbooleanisDirectory() :判断是否是文件夹 publicbooleanisFile() :判断是否是文件 publicbooleanexists(): 判 断 是 否 存 在 publicbooleancanRead(): 判 断 是 否 可 读 publicbooleancanWrite() :判断是否可写 publicbooleanisHidden() :判断是否隐藏 public class FileDemo5 { public static void main(String[] args) throws IOException { File file = new File("a.txt"); File file = new File("ccc"); System.out.println("是否文件夹:" + file.isDirectory()); File file = new File("aaa"); System.out.println("canRead:" + file.canRead()); System.out.println("canWrite:" + file.canWrite()); File file = new File("aaa"); System.out.println("canRead:" + file.canRead()); System.out.println("isHidden:" + file.isHidden()); } } E:获取功能 publicStringgetAbsolutePath() :获取文件的绝对路径 publicStringgetPath() :获取相对路径 publicStringgetName() :获取名称 publiclonglength() :获取长度。字节数 publiclonglastModified() :获取最后一次的修改时间,毫秒值 public class FileDemo6 { public static void main(String[] args) throws IOException { File file1 = new File("aaa\\bbb\\ccc"); file1.mkdirs(); File file = new File("aaa\\bbb\\ccc\\weiwei.txt"); file.createNewFile(); System.out.println("AbsolutePath:----" + file.getAbsolutePath()); System.out.println("path:----" + file.getPath()); System.out.println("fileName:-----" + file.getName()); System.out.println("length:---" + file.length()); Date date = new Date(file.lastModified()); DateFormat df = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); String format = df.format(date); System.out.println(format); } } F:高级获取功能 public String[] list() :获取指定目录下的所有文件或者文件夹的名称数组 public File[] listFiles() :获取指定目录下的所有文件或者文件夹的 File数组 public class FileDemo7 { public static void main(String[] args) throws IOException { File file = new File("d:\\"); for(String name : file.list()) { System.out.println(name); } File file = new File("d:\\"); for(File file1 : file.listFiles()) { System.out.println(file1.getName()+"----"+file1.getAbsolutePath()); } } } G:过滤器功能 案例: 判断D盘中是否存在后缀名为.png的文件 分析: 1:将D封装到一个File对象中 2:获取D盘下的所有的文件和文件夹 3: 从这些文件和文件夹中根据条件遍历查找满足条件的文件 public class FileDemo8 { public static void main(String[] args) throws IOException { File file = new File("D:\\"); File[] sonFiles = file.listFiles(); for(File file2 : sonFiles) { String filename = file2.getName(); if(filename.endsWith(".png") && file2.isFile()) { System.out.println(filename); } } } } 方法二:设置条件,查找满足条件的文件 public class FileDemo9 { public static class MyFilter implements FilenameFilter{ @Override public boolean accept(File dir, String name) { if(name.endsWith(".png")){ return true; } return false; } } public static void main(String[] args) throws IOException { File file = new File("D:\\"); MyFilter myFilter = new MyFilter(); String[] list = file.list(new FilenameFilter() { @Override public boolean accept(File dir, String name) { // TODO Auto-generated method stub return false; } }); for(String name : list) { System.out.println(name); } } } 总结:输出指定目录下指定后缀名的文件名称 a:先获取所有的,在遍历的时候判断,再输出 b: 先判断,再获取,最后直接遍历输出即可

优秀的个人博客,低调大师

Python | Python学习之深浅拷贝

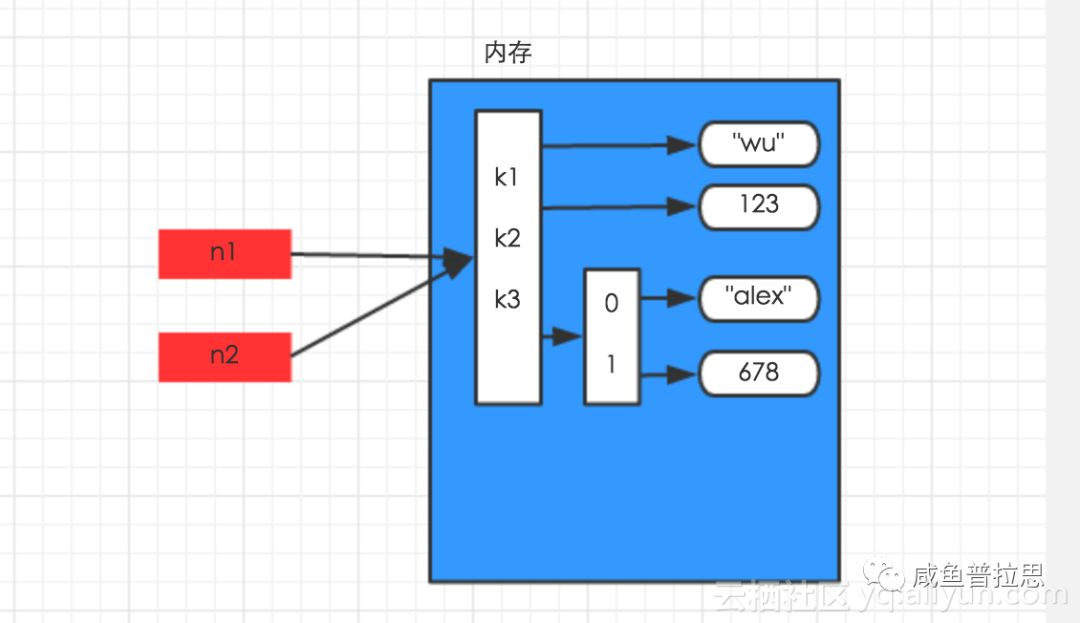
直接步入正题,聊一聊 Python 中的深浅拷贝 关于 is 和 == == 是 python 标准操作符中的比较操作符,用来比较判断两个对象的 value(值) 是否相等 。 # 例1.1 a = '2332424' b = '2332424' print(a == b) 输出: True [Finished in 0.1s] is 也被叫做同一性运算符,这个运算符比较判断的是对象间的唯一身份标识,也就是id是否相同。 # 例1.2 a = b = ['2343456'] c = ['2343456'] print(a == b, id(a), id(b)) print(a == c, id(a), id(c)) print(a is b, id(a), id(b)) print(a is c, id(a), id(c)) 输出: True 10715336 10715336 True 10715336 10717064 True 10715336 10715336 False 10715336 10717064 [Finished in 0.1s] 不同类型下, == 的结果都为True,但是 is 的结果则不一定 # 例1.3 # a 和 b 都为数值时 a = 1 b = 1 print(id(a)) print(id(b)) print(a == b) print(a is b) 1715077616 1715077616 True True [Finished in 0.1s] # a 和 b 都为字符串时 a = 'abcdefg' b = 'abcdefg' print(id(a)) print(id(b)) print(a == b) print(a is b) 11847696 11847696 True True [Finished in 0.1s] # a 和 b 都为列表时 a = ['12345678'] b = ['12345678'] print(id(a)) print(id(b)) print(a == b) print(a is b) 16941256 16942984 True False [Finished in 0.1s] # a 和 b 都是字典时 a = {'a':1,'b':2} b = {'a':1,'b':2} print(id(a)) print(id(b)) print(a == b) print(a is b) 10421192 10421256 True False [Finished in 0.1s] # a 和 b 都是元组时 a = (1,2,3) b = (1,2,3) print(id(a)) print(id(b)) print(a == b) print(a is b) 11960608 11960680 True False [Finished in 0.1s] # a 和 b 都为集合时 a = set([1,2,3]) b = set([1,2,3]) print(id(a)) print(id(b)) print(a == b) print(a is b) 16850504 16919464 True False [Finished in 0.1s] 只有数值型和字符串型的情况下,a is b才为True,当a和b是tuple,list,dict或set型时,a is b为False。 关于深浅拷贝 首先我们来看几个栗子: # 例2.1:赋值 a = [1,2,3] b = a a.append([4,5,6]) print(a) print(b) print(a is b) print(a == b) 输出: [1, 2, 3, [4, 5, 6]] [1, 2, 3, [4, 5, 6]] [Finished in 0.1s] True True 在例2.1中a的末尾新增了[4,5,6]之后,b的值也发生了变化,这是因为a把值赋值给b只是将创建的b对象指向了a对象指向的内存,这时的a和b指向的都是同一块内存空间(id),所以修改a后b的值也一起改变。 # 例2.2:赋值 a = [1,2,3] b = a a = [4,5,6] print(a) print(b) print(id(a)) print(id(b)) 输出: [4, 5, 6] [1, 2, 3] 10848136 10846408 [Finished in 0.1s] 在例2.2中先将a赋值给b,又将[4,5,6]赋值给a,这时已经给a创建了新的内存空间,所以打印a,b时a和b的值并不相同。 下面来看下深浅拷贝的不同之处: 首先字符串 、元组以及数值的深浅拷贝是没有差别的,如下例子所示: # 例3.1 # 字符串 import copy a = '1345' b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 17025040 17025040 17025040 [Finished in 0.1s] # 数值 import copy a = 1345 b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 9326480 9326480 9326480 [Finished in 0.1s] # 元组 import copy a = (1,2,3) b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 10715424 10715424 10715424 [Finished in 0.2s] 而对于字典、列表 进行浅拷贝和深拷贝时,其id是有变化的 # 列表 import copy a = [1,2,3] b = copy.copy(a) c = copy.deepcopy(a) print(id(a), id(b), id(c)) 输出: 17540104 17040264 17419656 [Finished in 0.1s] #字典 import copy a = {"a": "1", "b": 2, "c": ["c", 3]} b = copy.copy(a) c = copy.deepcopy(a) print(a, b, c) print(id(a), id(b), id(c)) a['c'] = '666' print(a, b, c) print(id(a), id(b), id(c)) 输出: {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} 6882248 17105992 16886792 {'b': 2, 'a': '1', 'c': '666'} {'b': 2, 'a': '1', 'c': ['c', 3]} {'b': 2, 'a': '1', 'c': ['c', 3]} 6882248 17105992 16886792 [Finished in 0.1s] 浅拷贝 :不管多么复杂的数据结构,浅拷贝都只会copy一层,且当copy指向不可变类型时,copy不会执行copy操作。当copy指向可变类型时,copy会执行第一层拷贝,即拷贝浅层的指向。 深拷贝 :其实深拷贝就是在内存中重新开辟一块空间,不管数据结构多么复杂,只要遇到可能发生改变的数据类型,就重新开辟一块内存空间把内容复制下来,直到最后一层,不再有复杂的数据类型,就保持其原引用。这样,不管数据结构多么的复杂,数据之间的修改都不会相互影响,这就是深拷贝,也同样可以将深拷贝理解为真正意义上的复制,是两个操作独立的个体。 有关深浅拷贝相关的图片说明可以参照下面几个链接的内容,以加深理解: http://www.cnblogs.com/wupeiqi/articles/5453708.htmlhttp://www.runoob.com/w3cnote/python-understanding-dict-copy-shallow-or-deep.html也可参照下面的几张图片: 原文发布时间为:2018-07-10本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”。

优秀的个人博客,低调大师

机器学习实战之线性回归

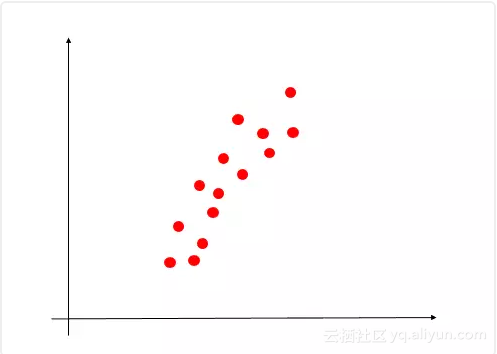
线性回归原理与推导 如图所示,这时一组二维的数据,我们先想想如何通过一条直线较好的拟合这些散点了?直白的说:尽量让拟合的直线穿过这些散点(这些点离拟合直线很近)。 目标函数 要使这些点离拟合直线很近,我们需要用数学公式来表示。首先,我们要求的直线公式为:Y = XTw。我们这里要求的就是这个w向量(类似于logistic回归)。误差最小,也就是预测值y和真实值的y的差值小,我们这里采用平方误差: 求解 我们所需要做的就是让这个平方误差最小即可,那就对w求导,最后w的计算公式为: 我们称这个方法为OLS,也就是“普通最小二乘法” 线性回归实践 数据情况 我们首先读入数据并用matplotlib库来显示这些数据。 def loadDataSet(filename): numFeat = len(open(filename).readline().

优秀的个人博客,低调大师

Python学习-基础知识-2

目录 Python基础知识2 一、二进制 二、文字编码-基础 为什么要有文字编码? 有哪些编码格式? 如何解决不同国家不兼容的编码格式? unicode编码格式的缺点 如何既能全球通用还可以规避unicode的缺点? python3的编码格式是什么样的? 三、浮点数 四、列表 如何理解列表? 列表的操作有哪些? 深浅复制问题 五、字符串 什么是字符串? 字符串的常用方法 使用r取消字符串转义 六、元组 元组和列表有什么区别? 七、哈希 八、字典 什么是字典? 字典常用操作 九、集合 什么是集合? 集合基本操作 集合分类计算 十、文件编码--进阶 十一、几个技术问题 if 条件语句判断 字典的两种循环方法对比 while...else... Python基础知识2 标签:python 目录: 一、二进制 计算机内部使用二进制表示数据。1位二进制可以代表2种状态,n位二进制可以表示2^n种状态,一般使用如下图示来计算一个字节的二进制和十进制互转: 128 64 32 16 8 4 2 1 256 1 1 1 1 1 1 1 1 78 0 1 0 0 1 1 1 0 33 0 0 1 0 0 0 0 1 6 0 0 0 0 0 1 1 0 二、文字编码-基础 为什么要有文字编码? 不论是文字、图片、视频还是其他类型的数据,在计算机内部都是以二进制的形式存储和表示。对于文字类型的数据,二进制需要通过文字编码表的映射关系,将二进制数据转换为对应的文字。文字编码表预先收录了字形和二进制数据的对应关系。但不同的国家因文字不同,所以产生了不同的编码表,编码表也叫作编码格式。 有哪些编码格式? 因不同国家的文字不同,各国都编写了适合本国语言的编码格式。如GBK是中国的编码格式,ASCII是美国的编码格式,SHIFT_JIS是日本的编码格式等等。不同的编码格式给出了不同的二进制和字形的对应关系标准,所以不同编码格式之间不能混用,否则会出现乱码。 如何解决不同国家不兼容的编码格式? 正因为编码格式互相不兼容,国际标准组织才出面编写了一个全球各国通用的unicode编码格式,此编码格式将全世界的语言都囊括进去,不论是哪一个国家,只要使用unicode进行编码,输出的文件都可以在全球通用,所以unicode也称为:万国码。(当然,读取的时候也要使用unicode编码进行读取) unicode编码格式的缺点 但是,unicode编码格式要求一个字符至少对应2个字节的二进制数据,这就导致对于编码长度小于2个字节的语言比如英文来说,存储空间加倍,不但影响存储,还影响传输效率。 如何既能全球通用还可以规避unicode的缺点? 此时UTF-8编码格式应运而生,UTF-8在unicode基础上,使用可变长编码的方法,使用1-4个字节来表示一个字符,优先使用1字节,不够的话再增加1字节,以此类推。通过变长的方式用于优化unicode在存储和传输时带来的资源浪费。 python3的编码格式是什么样的? 简单来说,python3在内存中操作字符串时的编码格式统一是unicode,而在读写文件时使用的编码格式默认是UTF-8。 三、浮点数 python中的浮点数包括:有限小数(如:1.2)和无限循环小数(如:1/3)。 python中的浮点数精度最长只有小数点后16位,可以使用decimal模块来提高精度。使用python3的/运算得到的结果就是浮点数。此外,浮点数还用于科学计数法,如1000000的科学计数法写法是:1.0E6。 当超出浮点数当前精度的时候会发生四舍五入的操作。 四、列表 如何理解列表? 列表可以简单的被理解成一个存储容器。此容器可以存放不同种类的对象,可以新增一个对象、删除一个对象、或者替换一个对象。列表类似于数组,只不过python的列表是动态的,不仅可以动态扩展和缩小长度,还可以存放不同的数据类型。列表使用如下方式声明: li = [0,1,2,3,4] 或者 li = list(range(5)) 列表的操作有哪些? 1. 查询 li[0]或者li[-1] # 通过下标索引对象值,不能超出下标范围 li.index('a') # 通过对象值查找对应下标,不存在的对象会导致此函数报错ValueError li.count('a') # 得到列表中'a'值出现的次数 2. 增加 li.append(20) # 在列表末尾追加元素 li.insert(0, 20) # 在列表下标0出插入20,这会导致元素右侧统一右移一个单位 3. 修改 li[0] = 20 # 直接修改第一个元素的值为20 li[:3] = [1,2,3] # 将列表前三个元素批量修改 4. 删除 li.remove(23) # 根据元素值删除元素,不存在会报错ValueError li.pop(0) # 根据元素下标删除元素,不给于参数则默认-1 del li[1] # 使用通用删除关键字del del li[1:5] # 使用del批量删除 5. 切片 li = [1,2,3,4,5] L = li[:3] # L的值是[1,2,3],切片含首不含尾 L = li[:] # 将li列表进行浅复制赋予L L = li[::-1] # 将li列表倒序后浅复制赋予L 6. 更新/扩展 list_a.extend(list_b) # 将b的值更新至a list_a = [1,2] list_b = [2,3] list_a.extend(list_b) # a的值是[1,2,3],b保持不变 7. 拼接 list_a = [1,2] list_b = [2,3] list_c = list_a + list_c # c的值是[1,2,3],a和b保持不变 8. 排序 li.sort() # 在原始列表上修改,排序默认方式是升序 li.reverse() # 让列表倒序 9. 循环 for i in li: print(i) 10. 清空/复制 li.clear() list_b = list_a.copy() # 等价于list_b = list_a[:] 深浅复制问题 因为列表是可变对象,即列表中的元素是可以改变的,所以在复制列表的时候,如果使用简单的复制(即浅复制),遇到嵌套的小列表时就会出现问题。为了规避可变对象在修改值时的安全问题,对于可变对象的复制,建议使用深复制。深复制的使用方式如下: import copy list1 = [1,2,3,[4,5],6] list2 = copy.deepcopy(list1) list1[-2][-1] = 'abc' print(list1) print(list2) 结果是: [1, 2, 3, [4, 'abc'], 6] [1, 2, 3, [4, 5], 6] 五、字符串 什么是字符串? 字符串就是一串字符序列,字符串在计算机中也是二进制数据,这些二进制数据通过编码格式显示成对应的字形,即字符串。字符串是不可变对象,一旦被创建就无法被修改。 字符串的常用方法 1.判断是否是数字字符串 str.isdigit() s = '123' s.isdigit() # 值是True s = '123b' s.isdigit() # 值是False 2. 替换字符 str2 = str1.replace(old, new) # 返回一个新字符串 s1 = 'aaahello,world' s2 = s1.replace('a', 'A') print(s1) print(s2) 结果: aaahello,world AAAhello,world 3. 定位字符 i = str.index(char) # 不存在会报错 i = str.find(char) # 不存在返回-1 s1 = 'aaahello world' print(s1.index('a')) print(s1.index('b')) print(s1.find('a')) print(s1.find('b')) 结果: 0 报错ValueError 0 -1 4. 字符计数 count = str.count(char) # 查找字符串中char字符的个数 s1 = 'aaahello world' print(s1.count('a')) 结果: 3 5. 处理首尾空格 str2 = str1.strip() # 返回新字符串,删除首尾空格 s1 = ' hello world' print(s1) print(s1.strip()) 结果: hello world hello world 6. 处理banner展示条 str2 = str1.center(len, char) # 使用char填充字符串长度到len s1 = 'student info' print(s1.center(20, '*')) print(s1.center(20, '-')) print(s1.center(20, '+')) 结果: ****student info**** ----student info---- ++++student info++++ 7. 分割字符串产生列表 list = str.split(char) # 根据char字符分割字符串成列表,默认cahr是空格 s1 = 'student!info!xiaoming' li = s1.split('!') print(type(li)) print(li) 结果: <class 'list'> ['student', 'info', 'xiaoming'] 8. 拼接字符串列表成更长字符串 str = char.join(list) # 根据char字符连接list里的所有字符串成为更长的字符串 li = ['student', 'info', 'xiaoming'] s1 = '+'.join(li) print(type(s1)) print(s1) 结果: <class 'str'> student+info+xiaoming 9. 字符串格式化输出 str2 = str1.format(*args, **kw) # 根据args和kw来对应赋值 result = 'name:{name}, age:{age}, a {0},a {1}'.format('apple', 'bananer', name='xiaoming', age=26) print(result) 结果: name:xiaoming, age:26, a apple,a bananer 10. 判断字符串开头和结尾 bool = str.startwith/endwith(char) # 判断是否以char开头或结尾 s1 = 'hello' s2 = 'world' print(s1.startswith('h')) print(s2.endswith('d')) 结果: True True 11. 改变字符串大小写 str2 = str1.upper/lower() # 设置大小写 s1 = 'hello world' print(s1.upper()) 结果: HELLO WORLD 使用r取消字符串转义 在字符串前面增加一个r可以取消此字符串在print过程中的转义功能,从而打印出字符串字面量。 s1 = '\ta\nbc' print(s1) s2 = r'\tabc\n' print(s2) 结果: a bc \tabc\n 六、元组 元组和列表有什么区别? 元组可以认为是只读列表,元组的操作大部分和列表一致,只不过一旦定义完毕之后就不能修改元组元素的值。 但是,如果元组元素是一个可变对象比如列表,则可以修改此列表中的值,这并不违反元组的规则因为列表自身这个容器的内存地址并没有变化。 tu = (1,2,[3,4]) # tu[0] = 10 # 这条语句会报错 tu[-1].append(5) print(tu) 结果是: (1, 2, [3, 4, 5]) 七、哈希 哈希函数用于将任意长度的输入通过算法计算得到固定长度的输出,这个输出也叫哈希值。 哈希算法是根据输入值的特征计算的,所以如果输入值不停变化,则输出也会不稳定,这就要求输入的是不可变对象。 因为哈希算法的原因,可能会出现不同的输入值有同样的输出值,这就发生了哈希冲突,所以想通过输出来反推唯一的输入是不合理的。 数据中保存的用户密码都是密文。 使用哈希的程序一定要有处理冲突的模块。 八、字典 什么是字典? 字典在某种角度上和列表很类似,都可以被认为是存储工具,保存各种数据类型对象。不过列表是通过下标索引,而字典是通过key来索引。另外,列表是有序的,而字典是无序的,因为字典的key涉及到哈希算法的计算。 数据类型 是否有序 索引值 作用 是否可变对象 使用方式 列表 有序 下标,从0开始 存储其他对象地址 是 li[0],li[-1] 字典 无序 key值,不可变对象 存储其他对象地址 是 dic[key] 字典常用操作 1. 增加 字典没有追加的函数,增加一个key-value的方式是直接: dic['name'] = 'xiaoming' 如果dic中已经存在'name'的key,则会使用'xiaoming'来覆盖原有的value 2. 修改 字典的修改直接是: dic['name'] = new_value 将新的值覆盖原有值 3. 查找 方法1:print(dic['name']) 如果dic没有'name'的key,则会报错 方法2:print(dic.get('name', 'not found!') 如果dic没有'name'的key,则会返回'not found!',默认第二参数是None,可以不填写 4. 删除 方法1:del dic['name'] 如果dic没有'name'的key,则会报错 方法2:dic.pop('name', 'not found!') 如果dic没有'name'的key,则会返回'not found!',第二参数没有默认值,必须手工输入否则会报错 5. 清空/复制 dic.clear() dic2 = dic1.copy() # 浅复制 6. 设置默认 dic.setdefault('name', 'xiaoming') 首先,dic会查找自身是否有'name',如果有返回原有value值。如果没有,就新增这个key-value并返回新value值。 7. 更新 dic1.update(dic2) 使用dic2来更新dic1,有则覆盖,无则新增。 dic1 = { 'a': 1, 'b': 2, 'x': 3,{'a': 1, 'b': 2, 'x': 100, 'y': 200} } dic2 = { 'b': 2, 'x': 100, 'y': 200, } dic1.update(dic2) print(dic1) 结果是: {'a': 1, 'b': 2, 'x': 100, 'y': 200 } 8. fromkeys 为一系列key设置统一的value值,并返回此字典。比如要为3个房地产楼盘设置统一价格: dic = dict.fromkeys(['万科', '阳光城', '融信'], 2000) print(dic) 结果是: {'万科': 2000, '阳光城': 2000, '融信': 2000} 9. 循环获取keys、values、items for key in dic.keys() for value in dic.values() for item in dic.items() 九、集合 什么是集合? 集合一般用于分类计算。集合中的元素都是唯一的,不会有重复。集合是无序的,集合是可变对象,但是集合内的元素必须是不可变对象。因为集合一般用于分类计算,是站在集合维度的,所以集合并不支持s[0]这种方式来访问元素。 集合基本操作 s = {1,2,3,4,5} print(s.pop()) # 随机删除一个元素 s.add(50) s.add(60) print(s) s.discard(100) # 删除元素,不存在不会报错 # s.remove(100) # 100不存在就会报错 s2 = {100,200,300} s.update(s2) # 两个集合合并,其实就是并集 print(s) s.clear() # 清空集合元素 print(s) 结果是: 1 {2, 3, 4, 5, 50, 60} {2, 3, 4, 5, 100, 200, 300, 50, 60} set() # 代表空集合 集合分类计算 s1 = {11,22,33} s2 = {22,33,44} print('交集是:', s1 & s2) # 交集是: {33, 22} print('s1 对于 s2 的差集是:', s1 - s2) # s1 对于 s2 的差集是: {11} print('s2 对于 s1 的差集是:', s2 - s1) # s2 对于 s1 的差集是: {44} print('并集是:', s1 | s2) # 并集是: {33, 11, 44, 22} print('对称差集是:', s1 ^ s2) # 对称差集是: {11, 44} print('s1是s2的超集吗?', s1.issuperset(s2), s1 > s2) # s1是s2的超集吗? False False print('s1是s2的子集吗?', s1.issubset(s2), s1 < s2) # s1是s2的子集吗? False False print('23在不在是s1中?', 23 in s1) # 23在不在是s1中? False print('s1 和 s2 是不是 不相交?', s1.isdisjoint(s2)) # s1 和 s2 是不是 不相交? False 十、文件编码--进阶 这里从:python3读取文件abc.txt,执行文件中的代码并在命令行展现内容的整个过程来理解各环节的编码问题。 文件准备 # abc.txt str1 = '中国' print(str1) 环境准备 python环境:python3.6.1 os环境:windows 10 abc.txt是使用pycharm编辑的,pycharm的编码设置为UTF-8 开始 我们登录windows操作系统,windows操作系统默认的编码格式是GBK,windows中有一个cmd命令行,此命令行的编码格式继承了操作系统的格式,也是GBK。 打开pycharm,默认pycharm在安装完毕后的编码格式是GBK,可以通过设置修改为UTF-8。 在pycharm中创建文件abc.txt,在此文件中写入: str1 = '中国' print(str1) 注意,此时abc.txt文件中的str1的编码格式是UTF-8,即编辑器pycharm是什么格式,则编写的文件就是什么编码格式。 使用Crtl+s保存此文件到硬盘。 单独在cmd中打开python解释器,进入交互环境,在交互环境中,我们可以输入: s1 = 'hello world' s2 = '你好 世界' 不论你输入的是什么字符串,不论是中文还是英文,此时在python3交互环境中的编码格式都是统一的unicode。 退出python3交互环境,在cmd命令中通过命令启动python3解释器执行abc.txt文件:python abc.txt 第7步其实有很多小环节: python3会使用默认的读写文件的编码格式对abc.txt文件进行解释。python3默认读写编码格式是UTF-8,而此文件恰好也是以UTF-8格式保存在硬盘上的,所以python3可以正确的对此文件进行编码。 python3通过UTF-8读写文件编码对此文件进行解释,将UTF-8的文件内容转换成unicode格式的字符串保留在内存中。 python3解释器执行unicode的保存在内存中的代码,设置一个str1变量,创建一个unicode格式的'中国' python3执行print函数,此时str1依然是unicode格式 print函数被执行,str1的'中国'会被打印到cmd中 cmd命令行接收到一个以unicode编码的字符串,虽然cmd默认是GBK编码,但是cmd可以认识GBK和unicode,所以可以根据unicode编码规则打印出此字符串的字形:'中国' 总之,有如下几个环节是需要编码的: python3解释器内部编码,也就是在内存中的编码格式,就是unicode python3解释器去读取文件时使用的编码格式,默认是UTF-8,会按照你在文件头部指定的# coding: xxx来设定,不设定的话就是UTF-8 文件自身也有一个编码格式,此编码格式来源于编辑此文件的编辑器 编辑器的编码格式继承了操作系统的编码格式,mac/Linux是UTF-8,windows是GBK,此外,cmd和shell也继承了操作系统的编码格式 十一、几个技术问题 if 条件语句判断 a = [1] if a: print('true') else: print('false') 这里的if条件是判断成立的,但是如下两者却是false: a == True a is True 为什么? 首先,a和True不能用is比较,因为是肯定不同的两个对象内存地址。也不能用==比较因为是不同的数据类型,值是肯定不同的。其次,if a这个语句等价于:if boo(a),bool(a)的结果是True,所以可以判断成立。 字典的两种循环方法对比 dic = { 'a': 1, 'b': 2, 'c': 3, } for key in dic.keys(): print(key, dic[key]) for key, value in dic.items(): print(key, value) 哪一种循环的性能更好? 尝试过两种办法: 两种循环各循环100次,计算运行时间,发现是下面那种时间短。 扩大dic的数据量到100万个项目,两种循环各执行1次,发现上面那种时间短。 目前还不知道确切分析的方法,后续补充。 while...else... 用处:需要判断while是否完全正常执行完毕时 i = 0 while i < 10: print(i) i += 1 else: print('循环正常执行完毕,没有被break或者return打断')

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册