首页 文章 精选 留言 我的

精选列表

搜索[副语言],共10000篇文章
优秀的个人博客,低调大师

如何编译运行HanLP自然语言处理包

master分支 对于master分支,编译方法如下: git clone https://github.com/hankcs/HanLP.git mvn install -DskipTests ·由于目前一些test不够规范,使用了硬编码路径下的资源,所以暂时跳过单元测试。 ·该方法不会将src/main/resources目录下的任何资源(包括hanlp.properties)打包进jar,如果需要打包资源文件,请切换到portable分支。 portable分支 git checkout portable 然后将需要的data放入src/main/resources,最后执行: mvn install -DskipTests 运行jar 目前jar包中有一些模块可以命令行执行,以感知机词法分析器为例。由于这些模块一般需要加载外部data,所以需要在运行时指定hanlp.properties。运行时,一个典型的目录结构如下: ·此处只列出了重要的目录。 ·一个良好的实践是把hanlp.properties放到resources目录下。 命令行需要指定jar包和hanlp.properties所在的目录: $ java -cp target/hanlp-1.6.0.jar:src/main/resources com.hankcs.hanlp.model.perceptron.Main -test \ <<< '华安集团胡花蕊来到纽约艺术博物馆参观' [华安/nz 集团/n]/nt 胡花蕊/nr 来到/v [纽约/ns 艺术/n 博物馆/n]/ns 参观/v ·Windows用户请使用分号java -cp target/hanlp-1.6.0.jar;src/main/resources

优秀的个人博客,低调大师

关于python语言优化的一些思考

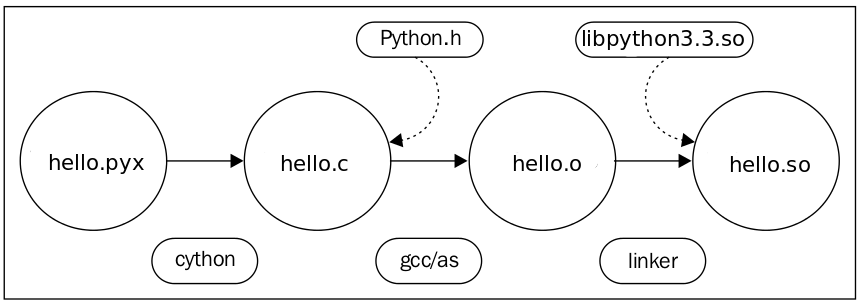
最近一直在做python工程化相关的工作,颇有心得,遂总结一下。一是为了整理思绪,二是为了解放自己健忘的大脑。 python是一个C的语法糖盒子 原生的python通常都是由cpython实现,而cpython的运行效率,确实让人不敢恭维,比较好的解决方案有cython、numba、pypy等等 cython 是目前我认为发展最好,最靠谱的一项Python加速解决方案。 使用cython编译过后的代码,通常会对原python代码有2倍以上的速度提升。cython的编译也很简单,只需要构建一个setup.py,然后执行: python setup.py build_ext numba numba也是我比较看好的,它的亮点在于使用装饰器的方式应用jit技术,例如下面的代码: @jit def run_xxx(): ... 可直接将run_xxx方法进行高效的c编译。但在大多数应用场景下(尤其是采取了服务拆分或微服务的架构策略),这种功能反而让人有种鸡肋的感觉 只能说numba更适用于模型开发的场景,在模型应用和部署的环节,numba的作用很尴尬 pypy pypy相对比较小众,这是由于它本身的限制条件较多,尤其是对python第三方包的支持上面更是非常局限。由于我在做python开发的过程中,经常需要限制版本,以及引入较多的第三方包,所以pypy就不在考虑的范围内了 不要轻易相信声称自己很快的模块和方法 曾经在网上看到有人发文,声称numpy是目前python下非常高效的一个模块,而numpy的“娘亲们”,甚至把自己夸上了天,说自己如何如何高效。而国内的一些伪专家们,也是盲目的“助纣为虐”,说什么如果你不太懂,请不要轻易去优化numpy云云,难道你自认为优化的算法能胜过numpy里内置的久经考验的算法?真的是误人子弟!很多人在这里就被唬住了,代码分析到numpy的环节,就不敢往下走了。我想说的是,对一切永远保持怀疑的精神才是真正的科学素养,是不是真的高性能,一切要用数据说话。刚开始,我也被短暂的唬住了,毕竟numpy的底层也没接触过,但profiler分析的结果告诉我,问题就出在numpy里,结果发现在我的项目场景里,使用dict能完全替代numpy的所有操作,性能一下提高了很多,而numpy的高效在于ndarray 所以,采取什么数据结构要看应用场景,没有万能的高效数据结构 不要以为排除法是万能的 优化代码的过程中,因为我的以往成功“经验”,也导致走了不少弯路,最主要的,就是盲目使用排除法。使用排除法只能使用二分查找或快排的策略去组织代码,如果目标代码比较少还可以,事实上,在真实场景中往往有成百上千行目标代码。人工执行和实现O(logN)量级的操作,似乎是一种蛮干。 这里有几个度量工具顺便记录下: py_spy https://github.com/benfred/py-spy方便的生成CPU执行方法的火焰图 line_profiler https://github.com/rkern/line_profiler逐行代码分析,不要小看它的能力,它还可以指定要分析的方法和模块 量变真的会引起质变 在很多人的习惯性逻辑思维里,一个程序的性能,随着代码的优化,会是一条平滑的增长曲线。但实践表明,这个逻辑确实有问题。通过不断对代码的优化,我发现,程序的性能到达一定阶段会发生“突变”,或者“阶跃”。上一次优化的执行时间几百毫秒,下一次优化后的执行时间竟然只有几十毫秒,说发生了“阶跃”一点都不夸张。为什么会这样?至少在我的朋友圈里,还没有人能给我令人信服的答案,我自认为比较可靠的理解是,现代操作系统在cpu指令的处理上,对cpu的任务分配还不是那么“流畅”。哪位朋友有好的见解,欢迎批评指正!

优秀的个人博客,低调大师

Pyhanlp自然语言处理中的新词识别

新词发现 本“新词发现”模块基于信息熵和互信息两种算法,可以在无语料的情况下提取一段长文本中的词语,并支持过滤掉系统中已存在的“旧词”,得到新词列表。 调用方法 静态方法 一句话静态调用接口已经封装到HanLP中: /** * 提取词语 * * @param text 大文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size) /** * 提取词语 * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size) throws IOException /** * 提取词语(新词发现) * * @param text 大文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size, boolean newWordsOnly) /** * 提取词语(新词发现) * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size, boolean newWordsOnly) throws IOException 调用示例请参考com.hankcs.demo.DemoNewWordDiscover。 值得注意的是,在计算资源允许的情况下,文本越长,结果质量越高。对于一些零散的文章,应当合并为整个大文件传入该算法。 高级参数 根据语料的长度或用词的不同,默认的参数有可能不能得到最佳的结果。我们可以通过构造不同的NewWordDiscover调整提取算法。该构造函数如下: /** * 构造一个新词识别工具 * @param max_word_len 词语最长长度 * @param min_freq 词语最低频率 * @param min_entropy 词语最低熵 * @param min_aggregation 词语最低互信息 * @param filter 是否过滤掉HanLP中的词库中已存在的词语 */ public NewWordDiscover(int max_word_len, float min_freq, float min_entropy, float min_aggregation, boolean filter) 其中: · max_word_len控制识别结果中最长的词语长度,默认值是4;该值越大,运算量越大,结果中出现短语的数量也会越多。 · min_freq控制结果中词语的最低频率,低于该频率的将会被过滤掉,减少一些运算量。由于结果是按照频率排序的,所以该参数其实意义不大。 · min_entropy控制结果中词语的最低信息熵的值,一般取0.5左右。该值越大,越短的词语就越容易被提取出来。 · min_aggregation控制结果中词语的最低互信息值,一般取50到200.该值越大,越长的词语就越容易被提取出来,有时候会出现一些短语。 · filter设为true的时候将使用内部词库过滤掉“旧词”。

优秀的个人博客,低调大师

学习Python语言 基础语法:变量的基本使用

Python变量 程序是用来处理数据的,变量就是用来保存数据的,通过给数据定义一个名称来保证方便记忆和识别、使用这个数据。变量可以保存所有类型的数据。 Python变量的定义 在Python中,变量的定义可以不定义变量的类型,这与PHP一样。 同时,在使用变量前必须给变量赋值。(这与上述的观点一致,都没有数据,用啥呢?) 赋值的格式如下: 左边是变量名称,中间使用“=”号,右边为数据,基本可以记忆为“将右边的数据用左边的名称”替代。也可以多变量赋值,如:变量1=变量2=变量3=“数据”,如图: 在学习中有迷茫不知如何学习的朋友小编推荐一个学Python的学习q u n 227 -435- 450可以来了解一起进步一起学习!免费分享视频资料 变量赋值示例 一些Python已经定义的类型 Python有五个标准的数据类型: Numbers(数字) String(字符串) List(列表) Tuple(元组) Dictionary(字典) 其中Numbers支持int、float、long、complex类型 String为字符串,可以使用[头下标:尾下标]来获取子字符串,其中头下标可以从左到右,默认0开始,尾下标可以从右到左,默认-1开始,用来截取子字符串。如: 字符串示例 List为列表,用“[]”来标识,它可以包含多种类型,也可以像String的用法一样,使用[头下标:尾下标]来获取子列表,如: 列表示例 Tuple元组,用“()”来标识,更像是List的缩减版,一旦定义以后就不能编辑,只能读取,如: 元组示例 Dictionary字典,用“{}”来标识,类似于java的map,由索引“key”和值“value”组成,取值时也是由“key”定位取得“value”,如: 字典示例 关于数据类型的转换,可以通过转换函数进行转换,如:

优秀的个人博客,低调大师

二, 跨语言微服务框架 - Istio环境搭建

当我们知道Istio是一个好东西,能够帮助我们快速实现微服务化中的一些关键节点,那么下一步就需要考虑怎么使用Istio了,Istio现在版本是和Kubernetes强关联在一起的,如果大家还不是太了解Kubernetes可以先从笔者的文章中了解,通过Kubernetes生态Istio可以非常方便的进行部署和使用。 附上: 喵了个咪的博客:w-blog.cn Istio官方地址:https://preliminary.istio.io/zh Istio中文文档:https://preliminary.istio.io/zh/docs/ PS : 此处基于当前最新istio版本1.0.3版本进行搭建和演示 一. Kubernetes准备工作 搭建部署Istio时需要先准备好Kubernetes环境,笔者这边使用的是Rancher进行环境的搭建,可以参考笔者的以下博文: Docker应用容器引擎介绍与搭建 - 喵了个咪博客空间 - 开源中国 Kubernetes(二) - 使用Rancher部署K8S集群(搭建Rancher) - 喵了个咪博客空间 - 开源中国 Kubernetes(三) - 使用Rancher部署K8S集群(搭建Kubernetes) - 喵了个咪博客空间 - 开源中国 Docker应用容器引擎介绍与搭建 - 喵了个咪的博客 - CSDN博客 Kubernetes(二) - 使用Rancher部署K8S集群(搭建Rancher) - 喵了个咪的博客 - CSDN博客 Kubernetes(三) - 使用Rancher部署K8S集群(搭建Kubernetes) - 喵了个咪的博客 - CSDN博客 这里需要着重提醒的是关于在部署的时候需要修改Kubernetes模板配置项,之后配置之后后面的Sidecar自动注入才能使用,否则只能手动入住Sidecar. 需要找到Kubernetes Admission controllers选项,如下 NamespaceLifecycle,LimitRanger,ServiceAccount,PersistentVolumeLabel,DefaultStorageClass,DefaultTolerationSeconds,ResourceQuota 在指定位置添加两个选项 MutatingAdmissionWebhook,ValidatingAdmissionWebhook 如下 NamespaceLifecycle,LimitRanger,ServiceAccount,PersistentVolumeLabel,DefaultStorageClass,DefaultTolerationSeconds,MutatingAdmissionWebhook,ValidatingAdmissionWebhook,ResourceQuota 这样才启动了admissionregistration API 最后在创建集群的时候选择我们事先准备好的环境模板即可. 然后按照笔者之前的文章部署k8s即可: PS : 这里使用的K8S版本为1.11,推荐使用1.10以上的版本 二. 部署Istio PS : 1.0.3版本官方已经完全把docker仓库使用了docker.io舍弃了grc.io就不需要我们去翻墙或者复制镜像了(不在推荐使用1.0.3以前的版本) 首先去官方git下载对应的版本包(liunx 和 mac 要分开) Releases · istio/istio · GitHub > tar -zxvf istio-1.0.3-linux.tar.gz 2.1 安装istioctl 如果手动注入sidecar的话需要使用这个命令,自动注入的话不装这个也行: > sudo cp istio-1.0.3/bin/istioctl /usr/local/bin/ 2.2 安装Istio核心组件 简单的安装只需要通过运行官方提前准备好的yaml即可,如果有定制需求(有些内部组件不需要可以使用helm进行yaml构建) > kubectl apply -f istio-1.0.3/install/kubernetes/istio-demo.yaml > kubectl get svc -n istio-system > kubectl get pods -n istio-system PS : 这边会有三个0/1的是正常的,主要是三个task只有到达指定时间才会运行或一次性脚本 三. 结尾 此时istio就已经搭建完成,通过这种方式搭建的istio是一整套没有删减的容器组,包括grafaba + prometheus等(存在磁盘和处理资源的问题),如果有需求独立在外层部署这些组件的需求就需要修安装yaml进行了解学习修改,本套文章后续也会讲解怎么把一些非核心组件在外层部署(每个版本都会有一些区别需要小心)。 PS : 大家也许遇到了无法访问外网的问题可以关注笔者后续的Egress流量控制或参考 Istio Prelim 1.1 / 控制 Egress 流量

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册