首页 文章 精选 留言 我的

精选列表

搜索[全模态推理],共10000篇文章
优秀的个人博客,低调大师

常见的初级排序算法,这次全搞懂

本文已被Github仓库收录 https://github.com/silently9527/JavaCore 程序员常用的IDEA插件:https://github.com/silently9527/ToolsetIdeaPlugin 完全开源的淘客项目:https://github.com/silently9527/mall-coupons-server 微信公众号:贝塔学Java 前言 相信所有的程序员刚开始接触到的算法都会是排序算法,因为排序在对数据处理和计算有这重要的地位,排序算法往往是其他算法的基础;本文我们就先从初级排序算法开始学习算法。 排序算法的模板 在开始之前我们先定义一个排序算法通用的模板,在后面的排序算法都会实现这个模板 public interface SortTemplate { void sort(Comparable[] array); default void print(Comparable[] array) { for (Comparable a : array) { System.out.print(a + " "); } } default boolean less(Comparable a, Comparable b) { return a.compareTo(b) < 0; } default void exch(Comparable[] array, int i, int j) { Comparable tmp = array[i]; array[i] = array[j]; array[j] = tmp; } } Comparable: 为了让我们实现的排序算法更加的通用,可以排序任意的对象,所以我们这里使用了Comparable数组 sort: 不同的排序算法实现的方式不一样,子类自己去实现 less: 定义的公用方法,如果a < b就返回true exch: 定义的公用方法,交换数组中的两个对象 print: 打印出数据中的每个元素 选择排序 算法实现的思路: 首先找到数组中的最小元素, 其实将它和数组中的第一个元素进行交换,这样就排定了一个元素; 再次找出剩余元素中最小的元素与数组中的第二个元素进行交换,如此反复直到所有元素都是有序的 代码实现: public class SelectionSort implements SortTemplate { @Override public void sort(Comparable[] array) { int length = array.length; for (int i = 0; i < length; i++) { int min = i; for (int j = i + 1; j < length; j++) { if (less(array[j], array[min])) { min = j; } } exch(array, i, min); } } } 假如输入的数组是有序的,我们会发现选择排序运行的时候和未排序的时间一样长! 对于N个元素的数组,使用选择排序的时间复杂度是O(n²) 选择排序的是数据移动最少的,交换的次数与数组的大小是线性关系,N个元素的数组需要N次交换 冒泡排序 算法实现的思路: 比较相邻的两个元素,如果前一个比后一个大,那么就交换两个元素的位置 对每一组相邻的元素执行同样的操作,直到最后一个元素,操作完成之后就可以排定一个最大的元素 如此往复,直到数组中所有的元素都有序 代码实现: public class BubbleSort implements SortTemplate { @Override public void sort(Comparable[] array) { int length = array.length - 1; for (int i = 0; i < length; i++) { for (int j = 0; j < length - i; j++) { if (less(array[j + 1], array[j])) { exch(array, j, j + 1); } } } } } 对于N个元素的数组,使用冒泡排序的时间复杂度是O(n²) 插入排序 想象我们在玩扑克牌时,整理扑克牌都是把每一张插入到左边已经排好序的牌中适当的位置。插入排序的思路类似 算法实现的思路: 初始默认第一个元素就是有序的,当前索引的位置从0开始 先后移动当前索引的位置,当前索引位置左边的元素是有序的,从后往前开始扫码与当前索引位置元素进行比较 当确定当前索引位置上的元素在左边有序适合的位置之后,插入到该位置上 如果当确定当前索引位置上的元素大于了已排序的最后一个元素,那么当前索引位置直接往后移动 如此反复,直到所有元素有序 代码实现: public class InsertionSort implements SortTemplate { @Override public void sort(Comparable[] array) { int length = array.length; for (int i = 1; i < length; i++) { for (int j = i; j > 0 && less(array[j], array[j - 1]); j--) { exch(array, j, j - 1); } } } } 从代码的实现我们可以看出,当遇到了当前索引的元素大于了左边有序数组的最后一个元素时,内层循环就直接结束了,所以所我们排序的数组中存在着部分有序,那么插入排序算法会很快。 考虑最糟糕的情况,如果输入数组是一个倒置的,那么插入排序的效率和选择排序一样,时间复杂度是O(n²) 希尔排序 对于大规模的乱序数组插入排序很慢,是因为它只交换相邻的元素,元素只能一点一点的从数组中移动到正确的位置;插入排序对于部分有序的数组排序是的效率很高; 希尔排序基于这两个特点对插入排序进行了改进; 算法实现的思路 首先设置一个步长h用来分隔出子数组 用插入排序将h个子数组独立排序 减小h步长继续排序子数组,直到h步长为1 当步长为1时就成了普通的插入排序,这样数组一定是有序的 希尔排序高效的原因,在排序之初,各个子数组都很短,子数组排序之后都是部分有序的,这两种情况都很适合插入排序。 代码实现: public class ShellSort implements SortTemplate { @Override public void sort(Comparable[] array) { int gap = 1; int length = array.length; while (gap < length / 3) { gap = 3 * gap + 1; } while (gap >= 1) { for (int i = gap; i < length; i++) { for (int j = i; j >= gap && less(array[j], array[j - gap]); j -= gap) { exch(array, j, j - gap); } } gap = gap / 3; } } } 最后(点关注,不迷路) 文中或许会存在或多或少的不足、错误之处,有建议或者意见也非常欢迎大家在评论交流。 最后,写作不易,请不要白嫖我哟,希望朋友们可以点赞评论关注三连,因为这些就是我分享的全部动力来源

优秀的个人博客,低调大师

微服务超全的设计选型参考

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 微服务架构模式的核心包含如下几部分: 微服务之间的 RPC 通信。Java Chassis 提供了非常高效的通信方式,并支持多协议扩展,比如最快的 REST 通信模式实现, 异步的二进制通信模式 HIGHWAY 。 分布式微服务实例和服务发现。结合 ServiceComb Service Center, 实现分布式、多集群服务发现能力,以及强大的微服务元数据管理能力。 配置外置,动态、集中的配置管理。能够使用 ServiceComb Kie, 华为云配置中心、 Nacos、 Apollo 等多种配置中心, 并且和 Spring Boot 配置管理能力完整融合。 分布式故障管理,服务容错、隔离、熔断。内置故障实例隔离、故障重试、耗时接口隔离等重要分布式故障处理能力。可选使用 Hystrix 的 容错、隔离、熔断能力, 只需要做简单的配置。 分布式日志追踪。提供 Open Tracing 支持。 此外还有性能监控,日志记录系统、健康检查等。Java Chassis 采用优雅的设计模式,实现了上述所有的核心部件的功能,并且使得这些功能 开箱即用。使用 Java Chassis , 开发者能够更加聚焦于业务功能开发,快速的构建商业可用的微服务应用。 Java Chassis 的软件工程实践 Java Chassis 在设计的时候, 不仅考虑了如何更好的使用微服务架构模式, 还把优秀的软件工程思想融合进来, 帮助开发者更好的管理信息 资产, 提升软件工程管理能力。 下图简单的描述 “以契约为中心” 的核心概念。 可以通过 Invocation 获取到 Java Chassis 的契约等源数据信息, 是 Java Chassis 的一个核心对象。 Java Chassis 的运行时架构 为了支持软件工程实践, Java Chassis 的运行时架构是一个哑铃结构, 两端分别是“编程模型” 和 “通信模型”, 中间是“运行模型”。 “编程模型” 面向开发者写服务接口的习惯, “通信模型” 面向微服务之间的高效编码和通信, “运行模型” 基于“契约”, 提供一种服务服务无关 的插拔机制,能够让开发者独立于业务实现开发治理功能,并且灵活的移除和增加功能,以及调整这些治理功能的处理顺序。 “运行模型” 的核心抽象接口是 Handler , 这个接口是一个异步的定义, Java Chassis 运行时模型采用纯异步的实现, 让整个系统运行非常 高效。 Java Chassis 微服务应用架构 有很多优秀的微服务应用架构实践。微服务应用架构应该充分考虑系统的弹性, 能够针对系统的性能瓶颈点进行扩容, 需要考虑应用系统内部微服务 拆分的灵活性, 为业务的变更做好及时调整。 下图展示了一个典型的应用架构。接入层采用一些网络基础设施,比如 DNS , 浮动 IP 等方便用户采用统一的 URL 访问系统, 或者采用 API 网关等 基础设施实现系统的能力开放。业务层包含应用网关, 进行一些认证鉴权、 审计等功能, 经过认证的请求被应用网关转发到微服务系统内部。 Java Chassis 微服务技术选型 Java 语言拥有庞大的技术体系和标准, 并且广泛的应用到业务的系统的各个方面。和 Java Chassis 有紧密关系的技术包括 JSP/Servlet 标准 和容器, Spring 和 Spring Boot 技术, 以及 Spring Boot 提供的 REST 开发框架 Spring MVC。 Java Chassis 和 JSP/Servlet 标准 Java Chassis 不依赖于 JSP/Servlet 标准, 可以基于 Vert.x 的 HTTP 实现, 提供非常轻量级和高效的 REST 服务, 在性能要求高的核心 业务场景, 使用这种轻量级的技术非常合适。这种场景下, 没有完整的实现 JSP/Servlet 相关接口, 比如 HttpServletRequest, HttpServletResponse 等。 servicecomb-samples ( https://github.com/apache/servicecomb-samples/tree/master/porter_lightweight ) 提供了一个完整的使用这种部署模式的例子。 Java Chassis 可以部署运行于 JSP/Servlet 容器里面, 在这个场景下, Java Chassis 的核心部件就是一个 Servlet , 在这个 Servlet 里面 实现了 Java Chassis 的核心 RPC 系统。采用 JSP/Servlet 容器运行 Java Chassis, 业务请求首先经过容器的 HTTP 实现, 然后经过 Filter, 进入 Java Chassis 的 RestServlet , 运行 Java Chassis 的运行时模型 (Handlers) , 进入业务接口处理。 Java Chassis 和 Spring、Spring Boot Java Chassis 目前依赖于 Spring, 但是从设计上是可以独立于 Spring 运行的。Spring 是被广泛使用的技术, 非常轻量级, 在 Java Chassis 中可以直接使用 Spring 相关的技术。Java Chassis 不依赖于 Spring Boot, 但是可以将 Java Chassis 运行于 Spring Boot 基础之上。 Spring Boot 2 开始也提供了多种运行环境支持, WebApplicationType.NONE, WebApplicationType.SERVLET, WebApplicationType.REACTIVE, Java Chassis 可以集成 NONE, SERVLET 两种模式。在 NONE 模式下集成 Java Chassis, 和 Spring Boot 自身的 REACTIVE 非常类似, 但是比 Spring Boot 的 REACTIVE 运行更加高效, 并且支持早期的 RestTemplate API 和 RPC API 来访问服务。 Spring MVC Java Chassis 继承了 Spring MVC 的接口设计, 提供了 Provider 和 Consumer 层面的 API 接口来定义 REST 接口和访问 REST 接口。但是需要 注意的是, 两个是完全不同的实现, 实现机制也不一样。Spring Boot 主要基于 Servlet, 实现了 MVC 模式, 不仅可以开发 REST 接口, 还可以 开发其他 HTTP 功能, 比如重定向, 返回 HTML 页面等, 还可以通过 @ExceptionHandler, @ControllerAdvice 等机制拦截 Servlet 请求,进行 异常处理。Java Chassis 只实现了 REST 服务定义和调用, 并且在异常处理机制和请求拦截机制上不一样。 Java Chassis 与 Spring Cloud Java Chassis 和 Spring Cloud 都实现了微服务架构模式, 相比而言, Java Chassis 是一个更加紧凑的实现, 开箱即用, 而 Spring Cloud 则是 相对松散的实现, 整合了大量的 Hystrix 组件。 微服务架构模式关注微服务内部和微服务之间的设计, 也关注微服务与微服务基础设施之间的关系。Java Chassis 微服务基础设施包括服务注册和发现, 服务配置管理, 灰度发布和契约管理等功能。Spring Cloud 可以使用 spring-cloud-huawei ( https://github.com/huaweicloud/spring-cloud-huawei ) 来使用 Java Chassis 相关的微服务基础设施。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-02本文作者:sandag本文来自:“51CTO”,了解相关信息可以关注“51CTO”

优秀的个人博客,低调大师

使用Kubectl管理Kubernetes的全解教程

kubectl主要用于与K8s API服务器通信,以在K8s中创建、更新和删除工作负载。不少IT人员通过kubectl与K8s交互。本文将介绍如何安装kubectl、与K8s环境进行通信以及一些常用命令,给您提供管理K8s的良好起点。 对不少IT人员来说,每天与Kubernetes交互的机制一般是通过kubectl——一种命令行工具。kubectl主要用于与Kubernetes API服务器通信,以在Kubernetes中创建、更新和删除工作负载。本教程的目的是概述您可以使用的一些常用命令,并提供管理Kubernetes的良好起点。 我们将介绍如何在您的计算机上安装kubectl,如何与您的Kubernetes环境进行通信并执行一些常见操作。大多数常见的kubectl命令会提供某特定的操作,如创建、删除等。此方法通常需要解释描述Kubernetes中的对象(如POD、服务、资源等)的文件(YAML或JSON)。这些文件通常被用作模板以及环境的持续文档,并有助于保留Kubernetes对声明性配置的关注。命令行上给出的操作将传递给API服务器,然后根据需要与Kubernetes中的后端服务进行通信。 我们将介绍一些最常见的kubectl命令并提供一些示例。有关每个命令的更多详细信息,包括所有支持的标志和子命令,请查看kubectl参考文档: https://kubernetes.io/docs/reference/generated/kubectl/kubectl-commands。 安装kubectl kubectl是一个独立的程序,因此不需要复杂的安装过程。它是一个需要位于操作系统PATH中的单个文件。有许多方法可以获得kubectl二进制文件,例如通过操作系统的本机包管理器或通过curl。下表中的一些示例就是如何为各种操作系统安装kubectl: 注意: 随着新版本的发布,最佳版本的kubectl for Windows将随着时间的推移而发生变化。要查找当前最佳二进制文件,请点击此链接查找最新的稳定版本,并根据需要调整上述URL: https://storage.googleapis.com/kubernetes-release/release/stable.txt 环境中使用的kubectl版本,需要与Kubernetes服务器的版本保持一致。您可以通过键入以下内容来查看正在使用的kubectl客户端的版本: kubectl在各方面都会保持与一个版本的兼容性。其中客户端版本会比服务器版本领先一步。这为服务器版本:v1.13.4中提供的功能和命令提供了支持。如果客户端版本不是服务器版本之后的各版本中的一个,那么在尝试访问相应服务器版本中可用的功能时,可能会遇到错误或不兼容。 kubectl语法 kubectl 的语法使用如下: Command(命令):指你想要执行的操作(创建、删除等等) Type(类别):指你正在执行命令的资源类型(Pod、Service等) Name(名称):对象的名称(需区分大小写)。如果未指定名称,则可以获取有关命令匹配的所有资源的信息(例如Pod) Flags(标志):这个可以按需选择(非必须),不过它在查找特定资源时非常有用。例如,--namespacespace可以让你指定要在哪个特定的命名空间中执行操作。 kubeconfig kubectl使用配置文件来访问Kubernetes集群。默认的kubectl配置文件位于〜/ .kube / config,称为kubeconfig文件。 kubeconfig文件组织有关集群、用户、命名空间和身份验证机制的信息。kubectl命令使用这些文件来查找它在选择集群并与之通信时所需要的信息。 加载顺序遵循以下规则: 如果设置了--kubeconfig标志,则仅加载给定文件。该标志只能设置一次,不会发生合并。 如果设置了$ KUBECONFIG环境变量,则根据系统的正常路径分隔规则,将其解析为文件系统路径列表。 否则,如果上述两项都未设置,则使用${HOME}/.kube/config 文件,不进行任何合并。 如果您看到类似于以下内容的消息,则意味着kubectl配置不正确或无法连接到Kubernetes集群 The connection to the server <server-name: port> was refused - did you specify the right host or port? 你可以通过多种方式创建配置文件,具体取决于你使用何种Kubernetes发行版。以下列出的是不同的K8S发行版及其位置: RKE 使用RKE创建Kubernetes集群时,RKE会在本地目录中创建一个kube_config_rancher-cluster.yml文件,该文件包含使用kubectl等工具连接到新集群所需的凭据。 您可以将此文件复制到$ HOME / .kube / config,或者,如果您正在使用多个Kubernetes集群,请将KUBECONFIG环境变量设置为kube_config_rancher-cluster.yml的路径,如下所示: Rancher统一管理的Kubernetes集群 在Rancher中,您可以通过Web UI下载kubeconfig文件,并使用它通过kubectl连接到Kubernetes环境。 在Rancher UI中,单击要通过kubectl连接的集群。在页面的右上角,单击Kubeconfig File按钮: 单击按钮以详细查看配置文件以及放置在~/.kube/config中的方向。 将配置复制到~/.kube/config后,你无需指定--kube-config文件位置,就可以运行kubectl命令: 一些基本命令的示例 以下我将重点介绍在典型环境中会用到的许多命令。我们将从概述集群开始,一直到探索Kubernetes环境中当前正在运行的内容的各种场景。 相信下文的内容将帮助您熟悉kubectl和典型输出的命令。 管理kubectl配置 kubectl命令包含一些不同的命令,可用来帮助查看和管理自己的配置。这些在初始设置期间,或在你需要处理的集群集发生变化时,将非常有用。 要查看当前配置,请键入: apiVersion: v1 clusters: - cluster: certificate-authority-data: DATA+OMITTED server: https://www.<yoururl>.com/k8s/clusters/<cluster> name: gcpcluster - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.41:6443 name: gcpcluster-k8s-1 - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.42:6443 name: gcpcluster-k8s-2 - cluster: certificate-authority-data: DATA+OMITTED server: https://10.240.0.43:6443 name: gcpcluster-k8s-3 contexts: - context: cluster: gcpcluster namespace: rancher user: user-qkvpz name: gcpcluster 你将能看到的输出内容汇总展现了你所配置的集群和及上下文。cluster键包含每个可用集群的列表,以及相关的连接和验证详细信息。contexts键将用户、集群和可选的命名空间组合在一起,以形成用于与集群交互的唯一标识和使用上下文。 要获得每个可用上下文的更简洁摘要,你可以键入: 输出的内容显示了每个已定义上下文的详细信息以及当前选定的上下文,由星号(*)表示。 要快速检查当前使用的上下文,请键入: 虽然我们不会在本摘要中介绍它,但除此之外你还可以使用kubectl set-cluster、kubectl set-credentials和kubectl set-context以及各种标志来定义集群和上下文,不过我们在本文中就不赘述了。 要更改要连接的上下文,请使用use-context命令: 检查集群组件的状态 为集群选择好适当的上下文后,可以使用get componentstatuses(缩写为get cs)命令检查核心主组件的状态: 输出的内容将显示调度程序、控制器管理器和etcd节点的状态以及从每个服务收集的最新消息和错误。如果你的集群运行不正常,这是一个很好的、进行第一次诊断检查的机会。 可以使用cluster-info命令收集其他连接和服务信息: Kubernetes master is running at https://www.<yoururl>.com/k8s/clusters/<cluster> KubeDNS is running at https://www.<yoururl>.com/k8s/clusters/<cluster>/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy To further debug and diagnose cluster problems, use 'kubectl cluster-info dump'. 这里,输出显示了我们的Kubernetes master的端点以及KubeDNS服务端点的端点。 要查看有关作为集群成员的每个单个节点的信息,需使用get nodes命令: NAME STATUS ROLES AGE VERSION INTERNAL-IP EXTERNAL-IP OS-IMAGE KERNEL-VERSION CONTAINER-RUNTIME k8s-1 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 k8s-2 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 k8s-3 Ready controlplane,etcd,worker 34d v1.13.5 <IP> <none> Ubuntu 18.10 4.18.0-1011-gcp docker://18.9.5 这列出了在每个节点上运行的核心软件的状态、角色、连接信息和版本号。如果需要在集群节点上执行维护或登录以调试问题,此命令可以帮助您提供所需的信息。 查看资源和事件信息 要概述集群中可用的命名空间,请使用get namespaces命令: 这显示了当前集群中定义的命名空间分区。 要跨所有命名空间概述集群上运行的所有资源,使用以下命令: 输出的内容会显示部署了每个资源的命名空间信息,以及加上了资源类型前缀的资源名称(例如上面显示的示例中的pod)。之后,有关每个资源的就绪和运行状态的信息将有助于确定进程是否运行正常。 要查看与资源关联的事件,请使用get events命令: NAMESPACE LAST SEEN TYPE REASON KIND MESSAGE cattle-system 9m31s Normal BackOff Pod Back-off pulling image "miguelgt/k8s-demo:v2" cattle-system 24m Warning Failed Pod Error: ImagePullBackOff cattle-system 14m Normal BackOff Pod Back-off pulling image "miguelgt/k8s-demo:v2" cattle-system 9m30s Warning Failed Pod Error: ImagePullBackOff 输出内容将列出资源记录的最新事件,包括事件消息及其触发的原因。 示 例 为了更具体地演示您在使用kubectl时可能参与的工作流程,我们将在这一部分介绍将容器部署到集群的快速方案,并将其部署到非默认命名空间中。 默认情况下,如果在未指定命名空间的情况下部署集群,kubectl会将资源放在名为default的命名空间中。如果要部署到其他名称空间,则需要指定所需的替代项。 虽然我们可以为创建命令提供命名空间,但如果我们要使用命名空间来处理多个命令,更改上下文的方法会更为容易。更改与上下文关联的命名空间将自动将命名空间规范应用于任何其他命令,直到更改上下文。 要更改当前上下文的命名空间,请使用带有--currentand --namespace标志的set-context命令: 这将改变当前上下文,以自动将未来的操作应用于rancher命名空间。 接下来,我们可以创建一个名为nginx的部署,它基于默认的nginx容器镜像运行容器。因为我们改变了我们的上下文,所以它会在rancher命名空间中运行: 您可以通过列出当前部署的pod来检查部署是否成功: 在这里,我们可以看到Nginx部署正常运行。READY那一列显示容器已就绪,状态是“正在运行”,没有出现故障。 虽然我们已经验证了pod正在运行,但我们还没有得到关于它部署到了哪个命名空间的信息。但是,我们可以通过添加--all-namespaces标志来稍微改变输出: 这将显示在每个命名空间中运行的pod,并另外添加一个NAMESPACE列,列出每个资源部署到了哪个命名空间。在这里,我们看到Nginx pod已正确部署到我们的rancher命名空间而不是通常的default命名空间。 这表明我们的上下文操作和我们的部署都按预期工作了。 你还可以通过键入以下内容来清理已部署的资源: 其他参考信息 虽然本章中深入讨论这些内容可能超出了本文原意的范围,但我们还是为大家列出了一些非常有用的命令。 Pod 资源删除 服务 事件&指标 命名空间&安全 中级命令 其他资源 kubectl的官方概述: https://kubernetes.io/docs/reference/kubectl/overview/ kubectl的官方命令文档: https://kubernetes.io/docs/reference/kubectl/kubectl/ kubectl的官方备忘单: https://kubernetes.io/docs/reference/kubectl/cheatsheet/ Rancher kubeconfig文档: https://rancher.com/docs/rancher/v2.x/en/cluster-admin/kubeconfig/ 有关使用kubectl访问集群的Rancher文档: https://rancher.com/docs/rancher/v2.x/en/cluster-admin/kubectl/ kubectl配置命令: https://kubernetes.io/docs/reference/generated/kubectl/kubectl-commands#config 使用kubeconfig文件组织集群: https://kubernetes.io/docs/concepts/configuration/organize-cluster-access-kubeconfig/

优秀的个人博客,低调大师

Android内存泄漏定位、分析、解决全方案

原文链接 更多教程 为什么会发生内存泄漏 内存空间使用完毕之后未回收, 会导致内存泄漏。有人会问:Java不是有垃圾自动回收机制么?不幸的是,在Java中仍存在很多容易导致内存泄漏的逻辑(logical leak)。虽然垃圾回收器会帮我们干掉大部分无用的内存空间,但是对于还保持着引用,但逻辑上已经不会再用到的对象,垃圾回收器不会回收它们。 例如 忘记释放分配的内存的。(Cursor忘记关闭等)。 应用不再需要这个对象,未释放该对象的所有引用。 强引用持有的对象,垃圾回收器是无法在内存中回收这个对象。 持有对象生命周期过长,导致无法回收。 Java判断无效对象的原理 Android内存回收管理策略图: 图中的每个圆节点代表对象的内存资源,箭头代表可达路径。当圆节点与 GC Roots 存在可达路径时,表示当前资源正被引用,虚拟机是无法对其进行回收的(如图中的黄色节点)。反过来,如果圆节点与 GC Roots 不存在可达路径,则意味着这块对象的内存资源不再被程序引用,系统虚拟机可以在 GC 过程中将其回收掉。 从定义上讲,Android(Java)平台的内存泄漏是指没有用的对象资源任与GC-Root保持可达路径,导致系统无法进行回收。 内存泄漏带来的危害 用户对单次的内存泄漏并没有什么感知,但当泄漏积累到内存都被消耗完,就会导致卡顿,崩溃。 内存泄露是内存溢出OOM的重要原因之一,会导致Crash Android中常见的可能发生内存泄漏的地方 1.在Android开发中,最容易引发的内存泄漏问题的是Context。 比如Activity的Context,就包含大量的内存引用,一旦泄漏了Context,也意味泄漏它指向的所有对象。 造成Activity泄漏的常见原因: Static Activities在类中定义了静态Activity变量,把当前运行的Activity实例赋值于这个静态变量。 如果这个静态变量在Activity生命周期结束后没有清空,就导致内存泄漏。因为static变量是贯穿这个应用的生命周期的,所以被泄漏的Activity就会一直存在于应用的进程中,不会被垃圾回收器回收。 static Activity activity; //这种代码要避免 单例中保存Activity在单例模式中,如果Activity经常被用到,那么在内存中保存一个Activity实例是很实用的。但是由于单例的生命周期是应用程序的生命周期,这样会强制延长Activity的生命周期,这是相当危险而且不必要的,无论如何都不能在单例子中保存类似Activity的对象。 举例: public class Singleton { private static Singleton instance; private Context mContext; private Singleton(Context context){ this.mContext = context; } public static Singleton getInstance(Context context){ if (instance == null){ synchronized (Singleton.class){ if (instance == null){ instance = new Singleton(context); } } } return instance; } } 在调用Singleton的getInstance()方法时传入了Activity。那么当instance没有释放时,这个Activity会一直存在。因此造成内存泄露。解决方法: 可以将new Singleton(context)改为new Singleton(context.getApplicationContext())即可,这样便和传入的Activity没关系了。 Static Views同理,静态的View也是不建议的 Inner Classes内部类的优势可以提高可读性和封装性,而且可以访问外部类,不幸的是,导致内存泄漏的原因,就是内部类持有外部类实例的强引用。 例如在内部类中持有Activity对象 解决方法: 1.将内部类变成静态内部类; 2.如果有强引用Activity中的属性,则将该属性的引用方式改为弱引用;3.在业务允许的情况下,当Activity执行onDestory时,结束这些耗时任务; 例如:发生内存泄漏的代码: public class LeakAct extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.aty_leak); test(); } //这儿发生泄漏 public void test() { new Thread(new Runnable() { @Override public void run() { while (true) { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }).start(); } } 解决方法: public class LeakAct extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.aty_leak); test(); } //加上static,变成静态匿名内部类 public static void test() { new Thread(new Runnable() { @Override public void run() { while (true) { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }).start(); } } Anonymous Classes匿名类也维护了外部类的引用。当你在匿名类中执行耗时任务,如果用户退出,会导致匿名类持有的Activity实例就不会被垃圾回收器回收,直到异步任务结束。 原文链接 更多教程 Handlerhandler中,Runnable内部类会持有外部类的隐式引用,被传递到Handler的消息队列MessageQueue中,在Message消息没有被处理之前,Activity实例不会被销毁了,于是导致内存泄漏。 解决方法: 1.可以把Handler类放在单独的类文件中,或者使用静态内部类便可以避免泄露;2.如果想在Handler内部去调用所在的Activity,那么可以在handler内部使用弱引用的方式去指向所在Activity.使用Static + WeakReference的方式来达到断开Handler与Activity之间存在引用关系的目的.3.在界面销毁是,释放handler资源 @Override protected void doOnDestroy() { super.doOnDestroy(); if (mHandler != null) { mHandler.removeCallbacksAndMessages(null); } mHandler = null; mRenderCallback = null; } 同样还有其他匿名类实例,如TimerTask、Threads等,执行耗时任务持有Activity的引用,都可能导致内存泄漏。 线程产生内存泄露的主要原因在于线程生命周期的不可控。如果我们的线程是Activity的内部类,所以MyThread中保存了Activity的一个引用,当MyThread的run函数没有结束时,MyThread是不会被销毁的,因此它所引用的老的Activity也不会被销毁,因此就出现了内存泄露的问题。 要解决Activity的长期持有造成的内存泄漏,可以通过以下方法: 传入Application 的 Context,因为 Application 的生命周期就是整个应用的生命周期,所以这将没有任何问题。 如果此时传入的是 Activity 的 Context,当这个 Context 所对应的 Activity 退出时,主动结束执行的任务,并释放Activity资源。 将线程的内部类,改为静态内部类。因为非静态内部类会自动持有一个所属类的实例,如果所属类的实例已经结束生命周期,但内部类的方法仍在执行,就会hold其主体(引用)。也就使主体不能被释放,亦即内存泄露。静态类编译后和非内部类是一样的,有自己独立的类名。不会悄悄引用所属类的实例,所以就不容易泄露。 如果需要引用Acitivity,使用弱引用。 谨慎对context使用static关键字。 2.Bitmap没调用recycle() Bitmap对象在不使用时,我们应该先调用recycle()释放内存,然后才设置为null. 3.集合中对象没清理造成的内存泄露 我们通常把一些对象的引用加入到了集合中,当我们不需要该对象时,并没有把它的引用从集合中清理掉,这样这个集合就会越来越大。如果这个集合是static的话,那情况就更严重了。解决方案: 在Activity退出之前,将集合里的东西clear,然后置为null,再退出程序。 4.注册没取消造成的内存泄露 这种Android的内存泄露比纯Java的内存泄漏还要严重,因为其他一些Android程序可能引用系统的Android程序的对象(比如注册机制)。即使Android程序已经结束了,但是别的应用程序仍然还有对Android程序的某个对象的引用,泄漏的内存依然不能被垃圾回收。解决方案: 1.使用ApplicationContext代替ActivityContext;2.在Activity执行onDestory时,调用反注册; 5.资源对象没关闭造成的内存泄露 资源性对象比如(Cursor,File文件等)往往都用了一些缓冲,我们在不使用的时候,应该及时关闭它们,以便它们的缓冲及时回收内存。而不是等待GC来处理。 6.占用内存较多的对象(图片过大)造成内存溢出 因为Bitmap占用的内存实在是太多了,特别是分辨率大的图片,如果要显示多张那问题就更显著了。Android分配给Bitmap的大小只有8M.解决方法: 1.等比例缩小图片 BitmapFactory.Options options = new BitmapFactory.Options(); options.inSampleSize = 2;//图片宽高都为原来的二分之一,即图片为原来的四分之一 2.对图片采用软引用,及时地进行recycle()操作 //软引用 SoftReference<Bitmap> bitmap = new SoftReference<Bitmap>(pBitmap); //回收操作 if(bitmap != null) { if(bitmap.get() != null && !bitmap.get().isRecycled()){ bitmap.get().recycle(); bitmap = null; } } 7.WebView内存泄露(影响较大) 解决方案: 用新的进程起含有WebView的Activity,并且在该Activity 的onDestory() 最后加上 System.exit(0); 杀死当前进程。 检测内存泄漏的方法 1.使用 静态代码分析工具-Lint 检查内存泄漏 Lint 是 Android Studio 自带的工具,使用姿势很简单 Analyze -> Inspect Code 然后选择想要扫面的区域即可 对可能引起泄漏的编码,Lint 都会进行温馨提示: 2.LeakCanary 工具 Square 公司出品的内存分析工具,官方地址如下:https://github.com/square/leakcanary/LeakCanary 需要在项目代码中集成,不过代码也非常简单,如下的官方示例: 在你的 build.gradle: dependencies { debugImplementation 'com.squareup.leakcanary:leakcanary-android:1.6.3' releaseImplementation 'com.squareup.leakcanary:leakcanary-android-no-op:1.6.3' // Optional, if you use support library fragments: debugImplementation 'com.squareup.leakcanary:leakcanary-support-fragment:1.6.3' } 在 Application 类: public class ExampleApplication extends Application { @Override public void onCreate() { super.onCreate(); if (LeakCanary.isInAnalyzerProcess(this)) { // This process is dedicated to LeakCanary for heap analysis. // You should not init your app in this process. return; } LeakCanary.install(this); // Normal app init code... } } 当内存泄漏发生时,LeakCanary 会弹窗提示并生成对应的堆存储信息记录 -3.Android Monitor 开Android Studio,编译代码,在模拟器或者真机上运行App,然后点击 ,在Android Monitor下点击Monitor对应的Tab,进入如下界面 在Memory一栏中,可以观察不同时间App内存的动态使用情况,点击 可以手动触发GC,点击 可以进入HPROF Viewer界面,查看Java的Heap,如下图 Reference Tree代表指向该实例的引用,可以从这里面查看内存泄漏的原因,Shallow Size指的是该对象本身占用内存的大小,Retained Size代表该对象被释放后,垃圾回收器能回收的内存总和。 扩展知识 四种引用类型的介绍 强引用(StrongReference):JVM 宁可抛出 OOM ,也不会让 GC 回收具有强引用的对象; 软引用(SoftReference):只有在内存空间不足时,才会被回的对象; 弱引用(WeakReference):在 GC 时,一旦发现了只具有弱引用的对象,不管当前内存空间足够与否,都会回收它的内存; 虚引用(PhantomReference):任何时候都可以被GC回收,当垃圾回收器准备回收一个对象时,如果发现它还有虚引用,就会在回收对象的内存之前,把这个虚引用加入到与之关联的引用队列中。程序可以通过判断引用队列中是否存在该对象的虚引用,来了解这个对象是否将要被回收。可以用来作为GC回收Object的标志。 原文链接 更多教程

优秀的个人博客,低调大师

《一起学 Sentinel》 原理-全解析

逅弈 转载请注明原创出处,谢谢! 系列文章 《一起学 Sentinel》 原理-调用链 《一起学 Sentinel》 原理-滑动窗口 《一起学 Sentinel》 原理-实体类 《一起学 Sentinel》 实战-限流篇 《一起学 Sentinel》 实战-控制台篇 《一起学 Sentinel》 实战-规则持久化 《一起学 Sentinel》 实战-集群限流篇 Sentinel 系列教程,现已上传到 github 和 gitee 中: GitHub:https://github.com/all4you/sentinel-tutorial Gitee:https://gitee.com/all_4_you/sentinel-tutorial Sentinel 是阿里中间件团队开源的,面向分布式服务架构的轻量级高可用流量控制组件,主要以流量为切入点,从流量控制、熔断降级、系统负载保护等多个维度来帮助用户保护服务的稳定性。 大家可能会问:Sentinel 和之前常用的熔断降级库 Netflix Hystrix 有什么异同呢?Sentinel官网有一个对比的文章,这里摘抄一个总结的表格,具体的对比可以点此 链接 查看。 对比内容 Sentinel Hystrix 隔离策略 信号量隔离 线程池隔离/信号量隔离 熔断降级策略 基于响应时间或失败比率 基于失败比率 实时指标实现 滑动窗口 滑动窗口(基于 RxJava) 规则配置 支持多种数据源 支持多种数据源 扩展性 多个扩展点 插件的形式 基于注解的支持 支持 支持 限流 基于 QPS,支持基于调用关系的限流 不支持 流量整形 支持慢启动、匀速器模式 不支持 系统负载保护 支持 不支持 控制台 开箱即用,可配置规则、查看秒级监控、机器发现等 不完善 常见框架的适配 Servlet、Spring Cloud、Dubbo、gRPC 等 Servlet、Spring Cloud Netflix 从对比的表格可以看到,Sentinel比Hystrix在功能性上还要强大一些,本文让我们一起来了解下Sentinel的源码,揭开Sentinel的神秘面纱。 项目结构 将Sentinel的源码fork到自己的github库中,接着把源码clone到本地,然后开始源码阅读之旅吧。 首先我们看一下Sentinel项目的整个结构: sentinel-core 核心模块,限流、降级、系统保护等都在这里实现 sentinel-dashboard 控制台模块,可以对连接上的sentinel客户端实现可视化的管理 sentinel-transport 传输模块,提供了基本的监控服务端和客户端的API接口,以及一些基于不同库的实现 sentinel-extension 扩展模块,主要对DataSource进行了部分扩展实现 sentinel-adapter 适配器模块,主要实现了对一些常见框架的适配 sentinel-demo 样例模块,可参考怎么使用sentinel进行限流、降级等 sentinel-benchmark 基准测试模块,对核心代码的精确性提供基准测试 运行样例 基本上每个框架都会带有样例模块,有的叫example,有的叫demo,sentinel也不例外。 那我们从sentinel的demo中找一个例子运行下看看大致的情况吧,上面说过了sentinel主要的核心功能是做限流、降级和系统保护,那我们就从“限流”开始看sentinel的实现原理吧。 可以看到sentinel-demo模块中有很多不同的样例,我们找到basic模块下的flow包,这个包下面就是对应的限流的样例,但是限流也有很多种类型的限流,我们就找根据qps限流的类看吧,其他的限流方式原理上都大差不差。 public class FlowQpsDemo { private static final String KEY = "abc"; private static AtomicInteger pass = new AtomicInteger(); private static AtomicInteger block = new AtomicInteger(); private static AtomicInteger total = new AtomicInteger(); private static volatile boolean stop = false; private static final int threadCount = 32; private static int seconds = 30; public static void main(String[] args) throws Exception { initFlowQpsRule(); tick(); // first make the system run on a very low condition simulateTraffic(); System.out.println("===== begin to do flow control"); System.out.println("only 20 requests per second can pass"); } private static void initFlowQpsRule() { List<FlowRule> rules = new ArrayList<FlowRule>(); FlowRule rule1 = new FlowRule(); rule1.setResource(KEY); // set limit qps to 20 rule1.setCount(20); // 设置限流类型:根据qps rule1.setGrade(RuleConstant.FLOW_GRADE_QPS); rule1.setLimitApp("default"); rules.add(rule1); // 加载限流的规则 FlowRuleManager.loadRules(rules); } private static void simulateTraffic() { for (int i = 0; i < threadCount; i++) { Thread t = new Thread(new RunTask()); t.setName("simulate-traffic-Task"); t.start(); } } private static void tick() { Thread timer = new Thread(new TimerTask()); timer.setName("sentinel-timer-task"); timer.start(); } static class TimerTask implements Runnable { @Override public void run() { long start = System.currentTimeMillis(); System.out.println("begin to statistic!!!"); long oldTotal = 0; long oldPass = 0; long oldBlock = 0; while (!stop) { try { TimeUnit.SECONDS.sleep(1); } catch (InterruptedException e) { } long globalTotal = total.get(); long oneSecondTotal = globalTotal - oldTotal; oldTotal = globalTotal; long globalPass = pass.get(); long oneSecondPass = globalPass - oldPass; oldPass = globalPass; long globalBlock = block.get(); long oneSecondBlock = globalBlock - oldBlock; oldBlock = globalBlock; System.out.println(seconds + " send qps is: " + oneSecondTotal); System.out.println(TimeUtil.currentTimeMillis() + ", total:" + oneSecondTotal + ", pass:" + oneSecondPass + ", block:" + oneSecondBlock); if (seconds-- <= 0) { stop = true; } } long cost = System.currentTimeMillis() - start; System.out.println("time cost: " + cost + " ms"); System.out.println("total:" + total.get() + ", pass:" + pass.get() + ", block:" + block.get()); System.exit(0); } } static class RunTask implements Runnable { @Override public void run() { while (!stop) { Entry entry = null; try { entry = SphU.entry(KEY); // token acquired, means pass pass.addAndGet(1); } catch (BlockException e1) { block.incrementAndGet(); } catch (Exception e2) { // biz exception } finally { total.incrementAndGet(); if (entry != null) { entry.exit(); } } Random random2 = new Random(); try { TimeUnit.MILLISECONDS.sleep(random2.nextInt(50)); } catch (InterruptedException e) { // ignore } } } } } 执行上面的代码后,打印出如下的结果: 可以看到,上面的结果中,pass的数量和我们的预期并不相同,我们预期的是每秒允许pass的请求数是20个,但是目前有很多pass的请求数是超过20个的。 原因是,我们这里测试的代码使用了多线程,注意看 threadCount 的值,一共有32个线程来模拟,而在RunTask的run方法中执行资源保护时,即在 SphU.entry 的内部是没有加锁的,所以就会导致在高并发下,pass的数量会高于20。 可以用下面这个模型来描述下,有一个TimeTicker线程在做统计,每1秒钟做一次。有N个RunTask线程在模拟请求,被访问的business code被资源key保护着,根据规则,每秒只允许20个请求通过。 由于pass、block、total等计数器是全局共享的,而多个RunTask线程在执行SphU.entry申请获取entry时,内部没有锁保护,所以会存在pass的个数超过设定的阈值。 那为了证明在单线程下限流的正确性与可靠性,那我们的模型就应该变成了这样: 那接下来我把 threadCount 的值改为1,只有一个线程来执行这个方法,看下具体的限流结果,执行上面的代码后打印的结果如下: 可以看到pass数基本上维持在20,但是第一次统计的pass值还是超过了20。这又是什么原因导致的呢? 其实仔细看下Demo中的代码可以发现,模拟请求是用的一个线程,统计结果是用的另外一个线程,统计线程每1秒钟统计一次结果,这两个线程之间是有时间上的误差的。从TimeTicker线程打印出来的时间戳可以看出来,虽然每隔一秒进行统计,但是当前打印时的时间和上一次的时间还是有误差的,不完全是1000ms的间隔。 要真正验证每秒限制20个请求,保证数据的精准性,需要做基准测试,这个不是本篇文章的重点,有兴趣的同学可以去了解下jmh,sentinel中的基准测试也是通过jmh做的。 深入原理 通过一个简单的示例程序,我们了解了sentinel可以对请求进行限流,除了限流外,还有降级和系统保护等功能。那现在我们就拨开云雾,深入源码内部去一窥sentinel的实现原理吧。 首先从入口开始:SphU.entry() 。这个方法会去申请一个entry,如果能够申请成功,则说明没有被限流,否则会抛出BlockException,表面已经被限流了。 从 SphU.entry() 方法往下执行会进入到 Sph.entry() ,Sph的默认实现类是 CtSph ,在CtSph中最终会执行到 entry(ResourceWrapper resourceWrapper, int count, Object... args) throws BlockException 这个方法。 我们来看一下这个方法的具体实现: public Entry entry(ResourceWrapper resourceWrapper, int count, Object... args) throws BlockException { Context context = ContextUtil.getContext(); if (context instanceof NullContext) { // Init the entry only. No rule checking will occur. return new CtEntry(resourceWrapper, null, context); } if (context == null) { context = MyContextUtil.myEnter(Constants.CONTEXT_DEFAULT_NAME, "", resourceWrapper.getType()); } // Global switch is close, no rule checking will do. if (!Constants.ON) { return new CtEntry(resourceWrapper, null, context); } // 获取该资源对应的SlotChain ProcessorSlot<Object> chain = lookProcessChain(resourceWrapper); /* * Means processor cache size exceeds {@link Constants.MAX_SLOT_CHAIN_SIZE}, so no * rule checking will be done. */ if (chain == null) { return new CtEntry(resourceWrapper, null, context); } Entry e = new CtEntry(resourceWrapper, chain, context); try { // 执行Slot的entry方法 chain.entry(context, resourceWrapper, null, count, args); } catch (BlockException e1) { e.exit(count, args); // 抛出BlockExecption throw e1; } catch (Throwable e1) { RecordLog.info("Sentinel unexpected exception", e1); } return e; } 这个方法可以分为以下几个部分: 1.对参数和全局配置项做检测,如果不符合要求就直接返回了一个CtEntry对象,不会再进行后面的限流检测,否则进入下面的检测流程。 2.根据包装过的资源对象获取对应的SlotChain 3.执行SlotChain的entry方法 3.1.如果SlotChain的entry方法抛出了BlockException,则将该异常继续向上抛出 3.2.如果SlotChain的entry方法正常执行了,则最后会将该entry对象返回 4.如果上层方法捕获了BlockException,则说明请求被限流了,否则请求能正常执行 其中比较重要的是第2、3两个步骤,我们来分解一下这两个步骤。 创建SlotChain 首先看一下lookProcessChain的方法实现: private ProcessorSlot<Object> lookProcessChain(ResourceWrapper resourceWrapper) { ProcessorSlotChain chain = chainMap.get(resourceWrapper); if (chain == null) { synchronized (LOCK) { chain = chainMap.get(resourceWrapper); if (chain == null) { // Entry size limit. if (chainMap.size() >= Constants.MAX_SLOT_CHAIN_SIZE) { return null; } // 具体构造chain的方法 chain = Env.slotsChainbuilder.build(); Map<ResourceWrapper, ProcessorSlotChain> newMap = new HashMap<ResourceWrapper, ProcessorSlotChain>(chainMap.size() + 1); newMap.putAll(chainMap); newMap.put(resourceWrapper, chain); chainMap = newMap; } } } return chain; } 该方法使用了一个HashMap做了缓存,key是资源对象。这里加了锁,并且做了 double check 。具体构造chain的方法是通过: Env.slotsChainbuilder.build() 这句代码创建的。那就进入这个方法看看吧。 public ProcessorSlotChain build() { ProcessorSlotChain chain = new DefaultProcessorSlotChain(); chain.addLast(new NodeSelectorSlot()); chain.addLast(new ClusterBuilderSlot()); chain.addLast(new LogSlot()); chain.addLast(new StatisticSlot()); chain.addLast(new SystemSlot()); chain.addLast(new AuthoritySlot()); chain.addLast(new FlowSlot()); chain.addLast(new DegradeSlot()); return chain; } Chain是链条的意思,从build的方法可看出,ProcessorSlotChain是一个链表,里面添加了很多个Slot。具体的实现需要到DefaultProcessorSlotChain中去看。 public class DefaultProcessorSlotChain extends ProcessorSlotChain { AbstractLinkedProcessorSlot<?> first = new AbstractLinkedProcessorSlot<Object>() { @Override public void entry(Context context, ResourceWrapper resourceWrapper, Object t, int count, Object... args) throws Throwable { super.fireEntry(context, resourceWrapper, t, count, args); } @Override public void exit(Context context, ResourceWrapper resourceWrapper, int count, Object... args) { super.fireExit(context, resourceWrapper, count, args); } }; AbstractLinkedProcessorSlot<?> end = first; @Override public void addFirst(AbstractLinkedProcessorSlot<?> protocolProcessor) { protocolProcessor.setNext(first.getNext()); first.setNext(protocolProcessor); if (end == first) { end = protocolProcessor; } } @Override public void addLast(AbstractLinkedProcessorSlot<?> protocolProcessor) { end.setNext(protocolProcessor); end = protocolProcessor; } } DefaultProcessorSlotChain中有两个AbstractLinkedProcessorSlot类型的变量:first和end,这就是链表的头结点和尾节点。 创建DefaultProcessorSlotChain对象时,首先创建了首节点,然后把首节点赋值给了尾节点,可以用下图表示: 将第一个节点添加到链表中后,整个链表的结构变成了如下图这样: 将所有的节点都加入到链表中后,整个链表的结构变成了如下图所示: 这样就将所有的Slot对象添加到了链表中去了,每一个Slot都是继承自AbstractLinkedProcessorSlot。而AbstractLinkedProcessorSlot是一种责任链的设计,每个对象中都有一个next属性,指向的是另一个AbstractLinkedProcessorSlot对象。其实责任链模式在很多框架中都有,比如Netty中是通过pipeline来实现的。 知道了SlotChain是如何创建的了,那接下来就要看下是如何执行Slot的entry方法的了。 执行SlotChain的entry方法 lookProcessChain方法获得的ProcessorSlotChain的实例是DefaultProcessorSlotChain,那么执行chain.entry方法,就会执行DefaultProcessorSlotChain的entry方法,而DefaultProcessorSlotChain的entry方法是这样的: @Override public void entry(Context context, ResourceWrapper resourceWrapper, Object t, int count, Object... args) throws Throwable { first.transformEntry(context, resourceWrapper, t, count, args); } 也就是说,DefaultProcessorSlotChain的entry实际是执行的first属性的transformEntry方法。 而transformEntry方法会执行当前节点的entry方法,在DefaultProcessorSlotChain中first节点重写了entry方法,具体如下: @Override public void entry(Context context, ResourceWrapper resourceWrapper, Object t, int count, Object... args) throws Throwable { super.fireEntry(context, resourceWrapper, t, count, args); } first节点的entry方法,实际又是执行的super的fireEntry方法,那继续把目光转移到fireEntry方法,具体如下: @Override public void fireEntry(Context context, ResourceWrapper resourceWrapper, Object obj, int count, Object... args) throws Throwable { if (next != null) { next.transformEntry(context, resourceWrapper, obj, count, args); } } 从这里可以看到,从fireEntry方法中就开始传递执行entry了,这里会执行当前节点的下一个节点transformEntry方法,上面已经分析过了,transformEntry方法会触发当前节点的entry,也就是说fireEntry方法实际是触发了下一个节点的entry方法。具体的流程如下图所示: 从图中可以看出,从最初的调用Chain的entry()方法,转变成了调用SlotChain中Slot的entry()方法。从上面的分析可以知道,SlotChain中的第一个Slot节点是NodeSelectorSlot。 执行Slot的entry方法 现在可以把目光转移到SlotChain中的第一个节点NodeSelectorSlot的entry方法中去了,具体的代码如下: @Override public void entry(Context context, ResourceWrapper resourceWrapper, Object obj, int count, Object... args) throws Throwable { DefaultNode node = map.get(context.getName()); if (node == null) { synchronized (this) { node = map.get(context.getName()); if (node == null) { node = Env.nodeBuilder.buildTreeNode(resourceWrapper, null); HashMap<String, DefaultNode> cacheMap = new HashMap<String, DefaultNode>(map.size()); cacheMap.putAll(map); cacheMap.put(context.getName(), node); map = cacheMap; } // Build invocation tree ((DefaultNode)context.getLastNode()).addChild(node); } } context.setCurNode(node); // 由此触发下一个节点的entry方法 fireEntry(context, resourceWrapper, node, count, args); } 从代码中可以看到,NodeSelectorSlot节点做了一些自己的业务逻辑处理,具体的大家可以深入源码继续追踪,这里大概的介绍下每种Slot的功能职责: NodeSelectorSlot 负责收集资源的路径,并将这些资源的调用路径,以树状结构存储起来,用于根据调用路径来限流降级; ClusterBuilderSlot 则用于存储资源的统计信息以及调用者信息,例如该资源的 RT, QPS, thread count 等等,这些信息将用作为多维度限流,降级的依据; StatistcSlot 则用于记录,统计不同纬度的 runtime 信息; FlowSlot 则用于根据预设的限流规则,以及前面 slot 统计的状态,来进行限流; AuthorizationSlot 则根据黑白名单,来做黑白名单控制; DegradeSlot 则通过统计信息,以及预设的规则,来做熔断降级; SystemSlot 则通过系统的状态,例如 load1 等,来控制总的入口流量; 执行完业务逻辑处理后,调用了fireEntry()方法,由此触发了下一个节点的entry方法。此时我们就知道了sentinel的责任链就是这样传递的:每个Slot节点执行完自己的业务后,会调用fireEntry来触发下一个节点的entry方法。 所以可以将上面的图完整了,具体如下: 至此就通过SlotChain完成了对每个节点的entry()方法的调用,每个节点会根据创建的规则,进行自己的逻辑处理,当统计的结果达到设置的阈值时,就会触发限流、降级等事件,具体是抛出BlockException异常。 总结 sentinel主要是基于7种不同的Slot形成了一个链表,每个Slot都各司其职,自己做完分内的事之后,会把请求传递给下一个Slot,直到在某一个Slot中命中规则后抛出BlockException而终止。 前三个Slot负责做统计,后面的Slot负责根据统计的结果结合配置的规则进行具体的控制,是Block该请求还是放行。 控制的类型也有很多可选项:根据qps、线程数、冷启动等等。 然后基于这个核心的方法,衍生出了很多其他的功能: 1、dashboard控制台,可以可视化的对每个连接过来的sentinel客户端 (通过发送heartbeat消息)进行控制,dashboard和客户端之间通过http协议进行通讯。 2、规则的持久化,通过实现DataSource接口,可以通过不同的方式对配置的规则进行持久化,默认规则是在内存中的 3、对主流的框架进行适配,包括servlet,dubbo,rRpc等 Dashboard控制台 sentinel-dashboard是一个单独的应用,通过spring-boot进行启动,主要提供一个轻量级的控制台,它提供机器发现、单机资源实时监控、集群资源汇总,以及规则管理的功能。 我们只需要对应用进行简单的配置,就可以使用这些功能。 1 启动控制台 1.1 下载代码并编译控制台 下载 控制台 工程 使用以下命令将代码打包成一个 fat jar: mvn clean package 1.2 启动 使用如下命令启动编译后的控制台: $ java -Dserver.port=8080 -Dcsp.sentinel.dashboard.server=localhost:8080 -jar target/sentinel-dashboard.jar 上述命令中我们指定了一个JVM参数,-Dserver.port=8080 用于指定 Spring Boot 启动端口为 8080。 2 客户端接入控制台 控制台启动后,客户端需要按照以下步骤接入到控制台。 2.1 引入客户端jar包 通过 pom.xml 引入 jar 包: <dependency> <groupId>com.alibaba.csp</groupId> <artifactId>sentinel-transport-simple-http</artifactId> <version>x.y.z</version> </dependency> 2.2 配置启动参数 启动时加入 JVM 参数 -Dcsp.sentinel.dashboard.server=consoleIp:port 指定控制台地址和端口。若启动多个应用,则需要通过 -Dcsp.sentinel.api.port=xxxx 指定客户端监控 API 的端口(默认是 8719)。 除了修改 JVM 参数,也可以通过配置文件取得同样的效果。更详细的信息可以参考 启动配置项。 2.3 触发客户端初始化 确保客户端有访问量,Sentinel 会在客户端首次调用的时候进行初始化,开始向控制台发送心跳包。 sentinel-dashboard是一个独立的web应用,可以接受客户端的连接,然后与客户端之间进行通讯,他们之间使用http协议进行通讯。他们之间的关系如下图所示: dashboard dashboard启动后会等待客户端的连接,具体的做法是在 MachineRegistryController 中有一个 receiveHeartBeat 的方法,客户端发送心跳消息,就是通过http请求这个方法。 dashboard接收到客户端的心跳消息后,会把客户端的传递过来的ip、port等信息封装成一个 MachineInfo 对象,然后将该对象通过 MachineDiscovery 接口的 addMachine 方法添加到一个ConcurrentHashMap中保存起来。 这里会有问题,因为客户端的信息是保存在dashboard的内存中的,所以当dashboard应用重启后,之前已经发送过来的客户端信息都会丢失掉。 client client在启动时,会通过CommandCenterInitFunc选择一个,并且只选择一个CommandCenter进行启动。 启动之前会通过spi的方式扫描获取到所有的CommandHandler的实现类,然后将所有的CommandHandler注册到一个HashMap中去,待后期使用。 PS:考虑一下,为什么CommandHandler不需要做持久化,而是直接保存在内存中。 注册完CommandHandler之后,紧接着就启动CommandCenter了,目前CommandCenter有两个实现类: SimpleHttpCommandCenter 通过ServerSocket启动一个服务端,接受socket连接 NettyHttpCommandCenter 通过Netty启动一个服务端,接受channel连接 CommandCenter启动后,就等待dashboard发送消息过来了,当接收到消息后,会把消息通过具体的CommandHandler进行处理,然后将处理的结果返回给dashboard。 这里需要注意的是,dashboard给client发送消息是通过异步的httpClient进行发送的,在HttpHelper类中。 但是诡异的是,既然通过异步发送了,又通过一个CountDownLatch来等待消息的返回,然后获取结果,那这样不就失去了异步的意义的吗?具体的代码如下: private String httpGetContent(String url) { final HttpGet httpGet = new HttpGet(url); final CountDownLatch latch = new CountDownLatch(1); final AtomicReference<String> reference = new AtomicReference<>(); httpclient.execute(httpGet, new FutureCallback<HttpResponse>() { @Override public void completed(final HttpResponse response) { try { reference.set(getBody(response)); } catch (Exception e) { logger.info("httpGetContent " + url + " error:", e); } finally { latch.countDown(); } } @Override public void failed(final Exception ex) { latch.countDown(); logger.info("httpGetContent " + url + " failed:", ex); } @Override public void cancelled() { latch.countDown(); } }); try { latch.await(5, TimeUnit.SECONDS); } catch (Exception e) { logger.info("wait http client error:", e); } return reference.get(); } 主流框架的适配 sentinel也对一些主流的框架进行了适配,使得在使用主流框架时,也可以享受到sentinel的保护。目前已经支持的适配器包括以下这些: Web Servlet Dubbo Spring Boot / Spring Cloud gRPC Apache RocketMQ 其实做适配就是通过那些主流框架的扩展点,然后在扩展点上加入sentinel限流降级的代码即可。拿Servlet的适配代码看一下,具体的代码是: public class CommonFilter implements Filter { @Override public void init(FilterConfig filterConfig) { } @Override public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException { HttpServletRequest sRequest = (HttpServletRequest)request; Entry entry = null; try { // 根据请求生成的资源 String target = FilterUtil.filterTarget(sRequest); target = WebCallbackManager.getUrlCleaner().clean(target); // “申请”该资源 ContextUtil.enter(target); entry = SphU.entry(target, EntryType.IN); // 如果能成功“申请”到资源,则说明未被限流 // 则将请求放行 chain.doFilter(request, response); } catch (BlockException e) { // 否则如果捕获了BlockException异常,说明请求被限流了 // 则将请求重定向到一个默认的页面 HttpServletResponse sResponse = (HttpServletResponse)response; WebCallbackManager.getUrlBlockHandler().blocked(sRequest, sResponse); } catch (IOException e2) { // 省略部分代码 } finally { if (entry != null) { entry.exit(); } ContextUtil.exit(); } } @Override public void destroy() { } } 通过Servlet的Filter进行扩展,实现一个Filter,然后在doFilter方法中对请求进行限流控制,如果请求被限流则将请求重定向到一个默认页面,否则将请求放行给下一个Filter。 规则持久化,动态化 Sentinel 的理念是开发者只需要关注资源的定义,当资源定义成功,可以动态增加各种流控降级规则。 Sentinel 提供两种方式修改规则: 通过 API 直接修改 (loadRules) 通过DataSource适配不同数据源修改 通过 API 修改比较直观,可以通过以下三个 API 修改不同的规则: FlowRuleManager.loadRules(List<FlowRule> rules); // 修改流控规则 DegradeRuleManager.loadRules(List<DegradeRule> rules); // 修改降级规则 SystemRuleManager.loadRules(List<SystemRule> rules); // 修改系统规则 DataSource 扩展 上述 loadRules() 方法只接受内存态的规则对象,但应用重启后内存中的规则就会丢失,更多的时候规则最好能够存储在文件、数据库或者配置中心中。 DataSource 接口给我们提供了对接任意配置源的能力。相比直接通过 API 修改规则,实现 DataSource 接口是更加可靠的做法。 官方推荐通过控制台设置规则后将规则推送到统一的规则中心,用户只需要实现 DataSource 接口,来监听规则中心的规则变化,以实时获取变更的规则。 DataSource 拓展常见的实现方式有: 拉模式:客户端主动向某个规则管理中心定期轮询拉取规则,这个规则中心可以是 SQL、文件,甚至是 VCS 等。这样做的方式是简单,缺点是无法及时获取变更; 推模式:规则中心统一推送,客户端通过注册监听器的方式时刻监听变化,比如使用 Nacos、Zookeeper 等配置中心。这种方式有更好的实时性和一致性保证。 至此,sentinel的基本情况都已经分析了,更加详细的内容,可以继续阅读源码来研究。

优秀的个人博客,低调大师

Android: 在native中访问assets全解析

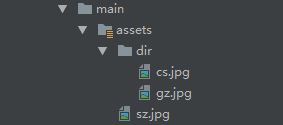
在CMake中添加相关NDK LIB的 依赖 因为我们接下来用到的一些函数实现在NDK库libandroid.so中,因此我们直接在CMakeList.txt中添加对其依赖即可: target_link_libraries( # Specifies the target library. native-lib #lib to link android # other libs ) 如果没有添加此依赖,显然会提示undefined reference错误,比如: error: undefined reference to 'AAssetManager_fromJava' error: undefined reference to 'AAssetManager_open' error: undefined reference to 'AAsset_getLength' error: undefined reference to 'AAsset_getBuffer' error: undefined reference to 'AAsset_close' error: undefined reference to 'AAssetManager_open' error: undefined reference to 'AAsset_getLength' error: undefined reference to 'AAsset_openFileDescriptor' error: undefined reference to 'AAsset_close' error: undefined reference to 'AAssetManager_openDir' error: undefined reference to 'AAssetDir_getNextFileName' error: undefined reference to 'AAssetManager_open' 获得AssetManager 在Java中,我们可以通过Context.getAssets()轻松获得AssetManager。在NDK中,提供了AAssetManager_fromJava来获得Native中对应的AAssetManager。顾名思义,fromJava,肯定是要从Java层获取了,也即意味着要通过JNI来获得。代码如下: /***code in Java, such as MainActivity.java***/ //decale the jni func public native void setNativeAssetManager(AssetManager assetManager); //call it, such as during Activity.onCreate() setNativeAssetManager(getAssets()); /***end of java***/ /***code in native c++***/ extern "C" JNIEXPORT void JNICALL Java_willhua_androidstudioopencl_MainActivity_setNativeAssetManager( JNIEnv *env, jobject instance, jobject assetManager) { AAssetManager *nativeasset = AAssetManager_fromJava(env, assetManager); //the use of nativeasset } 下面所有的代码都是在Java_willhua_androidstudioopencl_MainActivity_setNativeAssetManager内实现。 访问assets下的文件 我们知道,assets文件夹下面是可以有子文件夹的,因为,下面我以读取图片为例,介绍各种情况的访问方法。例子中用到OpenCV的相关方法,在此不介绍,自行了解。 测试用assets文件夹目录: 已知完整路径的访问 如果我们已经知道assets下某个文件的完整路径,比如"sz.jpg","dir/cs.jpg",那么我们可以直接把这个路径传给AAssetManager_open来获得AAsset. //open file AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); //this will also be ok //AAsset *assetFile = AAssetManager_open(nativeasset, "dir/cs.jpg", AASSET_MODE_BUFFER); //get file length size_t fileLength = AAsset_getLength(assetFile); char *dataBuffer2 = (char *) malloc(fileLength); //read file data AAsset_read(assetFile, dataBuffer2, fileLength); //the data has been copied to dataBuffer2, so , close it AAsset_close(assetFile); //decode the file data to cv::Mat std::vector<char> vec2(dataBuffer2, dataBuffer2 + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("asset file %d x %d %d", mat2.cols, mat2.rows, mat2.channels()); //free malloc free(dataBuffer2); 获取文件下的名字并访问之 如果我们只知道文件夹的名字,但并不知道文件夹下面有哪些具体文件,比如我们只知道有个dir文件夹,但不知道下面的具体情况。那么我们可以使用AAssetDir_getNextFileName来获取文件夹的文件名。但是有个问题,这个方法只能获得文件夹下的文件名,而无法获得子文件夹,有哪位知道的请告知。注意:AAssetDir_getNextFileName只返回文件名,而不是该文件的完整路径,比如只会返回cs.jpg,而不是dir/cs.jpg,所以如果直接把AAssetDir_getNextFileName的返回结果传给AAssetManager_open会读取不到正确的文件,返回NULL. AAssetDir *assetDir = AAssetManager_openDir(nativeasset, "dir"); const char *filename = AAssetDir_getNextFileName(assetDir); while (filename != NULL){ char fullname[1024]; sprintf(fullname, "dir/%s", filename); //get the full path AAsset *file = AAssetManager_open(nativeasset, fullname, AASSET_MODE_BUFFER); if(file == NULL){ LOGD("FILE NULL %s", filename); break; } size_t fileLength = AAsset_getLength(file); LOGD("filename next:%s, size:%d", filename, fileLength); char *buffer = (char*)malloc(fileLength); AAsset_read(file, buffer, fileLength); AAsset_close(file); //do something with the buffer free(buffer); filename = AAssetDir_getNextFileName(assetDir); } AAssetDir_close(assetDir); //remember to close it 使用AAsset_getBuffer读整个文件内容 在上面的case中,我们拿到AAsset之后都是malloc内存,然后把文件信息读出来的形式,其实这种方式适合不一次性读取整个文件内容的情况,按照官网的说法就是: Attempt to read 'count' bytes of data from the current offset. 也就是AAsset_read应该配合AAsset_seek使用更美味。 对于一次性读取整个文件的内容,更好的方式是使用AAsset_getBuffer AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); size_t fileLength = AAsset_getLength(assetFile); const char *dataBuffer2 =(const char *) AAsset_getBuffer(assetFile); std::vector<char> vec2(dataBuffer2, dataBuffer2 + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("asset file lenght:%d mat: %d x %d %d", fileLength, mat2.cols, mat2.rows, mat2.channels()); AAsset_close(assetFile); 以FileDescriptor的方式来读取 我们可以使用AAsset_openFileDescriptor来获取FileDescriptor,然后再进行其他操作。需要注意的是,AAsset_openFileDescriptor返回当前fd的起始seek位置start以及文件长度length。在读取内容之前记得要先seek到start,否则会发现文件内容不对。见代码中的lseek. AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); size_t fileLength = AAsset_getLength(assetFile); LOGD("before fd fileLength:%d",fileLength); off_t start = 0, length = 0; int fd = AAsset_openFileDescriptor(assetFile, &start, &length); LOGD("fd:%d start:%d length:%d", fd, start, length); lseek(fd, start, SEEK_CUR); //NOTICE char *dataBuffer = (char*)malloc(fileLength); memset(dataBuffer, 0, fileLength); read(fd, dataBuffer, fileLength); close(fd); //close fd LOGD("read_ %d %d %d", dataBuffer[0], dataBuffer[1], dataBuffer[2]); std::vector<char> vec2(dataBuffer, dataBuffer + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("use fd mat:%d x %d %d", mat2.cols, mat2.rows, mat2.channels()); AAsset_close(assetFile); 获得fd之后,也可以通过他来获得一个FILE:FILE * file = fdopen(fd, "rb");但是一定要记得fclose(file)。总的来说不如read方便。 open mode AAssetManager_open需要传入一个mode参数,各参数的含义如下,按需使用。 AASSET_MODE_UNKNOWN: Not known how the data is to be accessed AASSET_MODE_RANDOM: Read chunks, and seek forward and backward AASSET_MODE_STREAMING: Read sequentially, with an occasional forward seek AASSET_MODE_BUFFER: Attempt to load contents into memory,for fast small reads 细节提示 AAsset是只读的,比如上面获得FILE之后,不能用来写。 AAsset provides access to a read-only asset. 记得AAsset_close 记得AAssetDir_close 关于压缩文件 Android APK中有些文件是会进行压缩的,而有些文件则因为本身就是已经压缩过的,不再进行压缩,具体有: /* these formats are already compressed, or don't compress well */ static const char* kNoCompressExt[] = { ".jpg", ".jpeg", ".png", ".gif", ".wav", ".mp2", ".mp3", ".ogg", ".aac", ".mpg", ".mpeg", ".mid", ".midi", ".smf", ".jet", ".rtttl", ".imy", ".xmf", ".mp4", ".m4a", ".m4v", ".3gp", ".3gpp", ".3g2", ".3gpp2", ".amr", ".awb", ".wma", ".wmv" }; 那么对于在APK中会被压缩的文件,比如txt文件,就不能使用AAsset_openFileDescriptor来读了,否则,会返回-1这样的无效fd。对于会被压缩的文件,那么就只能使用AAsset_read或者AAsset_getBuffer来访问了。 现在加Android开发群;701740775,可免费领取一份最新Android高级架构技术体系大纲和视频资料,以及五年积累整理的所有面试资源笔记。加群请备注csdn领取xx资料

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、cookie, session)

cookie: 什么是cookie? 是一种数据存储技术 将一段文本保存在客户端的一种技术 并且可以长时间保存 cookie的使用场合: 记住密码 搜索关键词 在Flask使用cookie 使用 响应对象 来保存cookie到客户端 响应对象: resp = make_response("响应字符串") resp = redirect("地址") 响应对象.set_cookie(key, value, max_age) key: 保存cookie的名称 value: 保存cookie的值 max_age: 保存时间以 s 单位 session 什么是session session是保存在服务器为每个浏览器所开辟的一段空 session 在Flask中的实现 配置SECRET_KEY app.fonfig["SECRET_KEY"] = "YOURGUESS" 使用session

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、多表关联)

关系映射: 一对多 语法: 1."多"实体中 外键列名=db.Column(db.Integer,db.ForeignKey('主表.主键')) 2."一"实体中 增加反向引用关系 属性名=db.relationship('多表实体类名',关系选项) 常用的关系选项: 选项名 说明 backref 在关系的另一个模型中添加反向引用 lazy 指定如何加载相关记录 select : 首次访问时加载 immediate : 源对象加载后立马加载关联数据 subquery : 立即加载,但

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、模型、sqlalchemy)

Flask的文件传输: 如果大批量上传数据的时候(如:大文件) 就不能使用网页上传了 主要是由于http协议不支持 需要使用单独的上传工具(c/s版的) URL不存在参数上限的问题,HTTP协议规范也没有对URL长度进行限制。 这个限制是特定的浏览器及服务器对它的限制。 IE对URL长度的限制是2083字节(2K+35字节)对于其他浏览器, 如FireFox,Netscape等,则没有长度限制, 这个时候其限制取决于服务器的操作系统。即如果url太长, 服务器可能会因为安全方面的设置从而拒绝请求或者发生不完整的数据请求。 post 理论上讲是没有大小限制的,HTTP协议规范也没有进行大小限制, 但实际上post所能传递的数据量大小取决于服务器的设置和内存大小。 因为我们一般post的数据量很少超过MB的,所以我们很少能感觉的到post的数据量限制,

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、变量、模板)

模板 Templates: 模板中的语法规范 变量: 变量时一种特殊的占位符 告诉模板引擎该位置的 值是从渲染模板时的数据中来获取的 在视图中: @app.route("/temp") def temp(): return render_template("01_temp.html",uname="user name") name和age就是要传递到xxx.html中的变量 在模板中: {{变量名}} <title>{{unam}}</title> Python代码 @app.route("/temp") def temp(): dic = {"bookName":"钢铁是咋炼成的", "author": "鲁迅", "price": 32.5 ,

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、安装、应用)

Flask 轻量级WEB框架 静态网页: 不能与服务器交互的网页都是静态网页 动态网页: 能够与服务器进行交互的网页 WEB:浏览器 网页(前端三剑客) 服务器: 能够给用户提供服务的机器就是服务器 硬件来说就是 一台主机 还要配备一个能够接受用户请求并给出响 应用程序 APACHE TOMCAT IIS(Internet Information Service) Nginx(Python用的较多) 作用: 存储WEB所需要的信息 所有的服务器都能够处理用户请求( request)并作出回应( response) 能够执行服务器端的程序 具备一定的安全性功能 框架: 是一种为了解决开放性问题而存在的一种结构 框架本身也提供了一些基本功能, 我们只需要在自己的基础功能上搭建属于自己的操作即可 Python的WEB框架: Flask Django Tornado Webpy Flask框架: 什么

优秀的个人博客,低调大师

Python全栈 Web(Django框架、概述、安装)

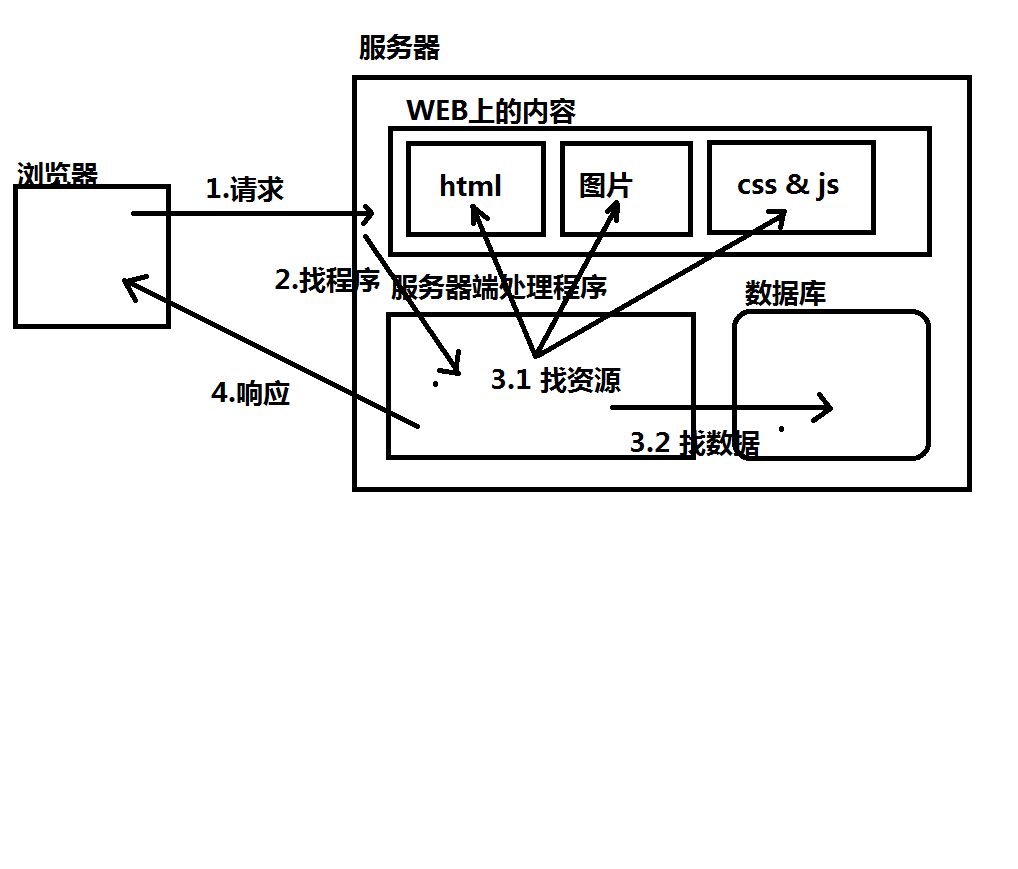
Django 框架 WEB 与 服务器 WEB : 表示用户可以浏览的网页内容(HTML,CSS,JS) 服务器 专门给用户提供服务的一台机器 1.硬件与软件 硬件范畴:一台机器 软件范畴:一个能够接受用户请求并给出响应的程序 1.APACHE 2.TOMCAT 3.IIS(Internet Information Service) 4.Nginx 2.服务器的作用 1.存储WEB上所需要的信息(HTML,图片,js,css,音视频) 2.处理用户的请求(request)并给出响应(response) 3.执行服务器端的程序 : 查找数据库 3.服务器 与 WEB之间的关系 WEB需要放在服务器上才能够被用户访问 框架 什么是框架 框架是一个为了解决开放性问题而存在的一种结构.框架本身会提供一些最基本的功能.我们只需要在基本功能之上搭建属于自己的操作即可. PYTH

优秀的个人博客,低调大师

Python全栈 Web(JavaScript DOM节点、事件)

1.查询节点 1.根据节点的层级查询节点 1.childNodes 元素节点,文本节点, 2.children 元素节点 3.parentNode 获取父节点 4.nextSibling 获取下一个兄弟节点 有可能是文本节点 5.nextElementSibling 获取下一个兄弟元素节点 6.previousSibling 获取上一个兄弟节点 有可能是文本节点 7.previousElementSibling 获取上一个兄弟元素节点 2.通过标签名查询节点 - 返回数组 document|elem.getElementsByTagName("标签名"); document:整个文档内查找 elem:某个元素内查找 3.通过元素的name属性值查询节点 document.getElementsByName("name属性值"); 返回值:包含指定name属性值的元素的数组 <

优秀的个人博客,低调大师

Python全栈 Web(CSS常用样式大全)

常用内联样式: func-size color background-color 内部样式表: <style> 选择器1{ 属性:值; } 选择器2{ 属性:值; } ... </style> 外链方式: <link rel="stylesheet" type="text/css" href=".css文件名"> 样式优先级: 默认 < 稳文档内嵌/元素选择器 < 行内 不发生冲突 同步 发生冲突 后来者居上 选择器: 标签选择器: p{ color: red; } 类选着器: .cls{ 样式 } <p class="cls">文本</p> <p class="cls1 cls2"> 文本 </p> 标签类结合: p.cls{ 样式 } 表示在指定标签中匹配class属性 id选着器: #nav{ 样式 } <div id="nav"></div> 群组选择器: div, p{ 样式 } <div></div> <p></p> 后代选择器: #nav #npc/div{ 样式 } 子代选择器: 选择器1>选择器2/标签{ 样式 } 伪类选择器: 超链接伪类选择器: :link 访问前 :visited 访问后 :active 鼠标点按 :hover 鼠标滑过 其他元素伪类选择器: :hover 鼠标滑过 :active 鼠标点按 伪类选择器只能和其他选择器/元素结合使用 p:hover{ 鼠标滑过p元素的新样式 } 选择器优先级: 标签选择器: 1 类/伪类选择器: 10 id选择器: 100 行内选择器: 1000 尺寸单位: px % in 英寸 1in 2.54cm pt 榜 1pt = 1/72 in cm m deg 角度 颜色单位: 英文单词(transparent: 透明) rgb(r,g,b) 0~255 rgba(r,g,b,a)透明度 十六进制:#fff 元素分类: 块元素 独占一行 支持宽高 div h1 p ul ol table form 行内元素 可以共行 大小由内容决定 span i b label u sub sup 行内块元素 可以共行 支持宽高 img input 常用属性: img{ width: 300px; height: 300px; color: red; background-color: #fff; font-size: 24px; font-weight: normal; 取消字体加粗 text-decoration: none; 取消下划线 vertical-align: top/middle/bottom; 左右元素与其的对齐方式(只能在行内块元素中使用) } 尺寸: img{ width: 300px/50%; height: 300px/50%; 溢出处理: overflow: visible/hidden/scroll/auto; 默认可见/溢出部分不显示/始终有滚动条溢出可用/自动产生滚动条 } 边框: div{ border: width style color; 宽度 样式 颜色 缺一不可 border: 1px solid/dashed/dotted/double; 实线/虚线/点线/双线 border: none; 取消边框 单独设置: border-top: 上 border-right: 右 border-bottom: 下 border-left: 左 border-width: 宽度 border-style: 样式 border-color: 颜色 三角标: width: 0px; height: 0px; border-top: 100px solid red; border-right: 100px solid green; border-bottom: 100px solid transparent; border-left: 100px solid transparent; } 轮廓线: div{ outline: width style color; outline: none; 取消轮廓线 } 圆角边框: div{ border-radius: 10px/10%; 超过50%就是圆形 border-radius: 10px 20px 30px 40px; 上 右 下 左 一个值:表示是个角相等 两个值:表示上下、左右相等 三个值:左右相等 其他分别设置 四个值:表示上右下左全不分别设置 } 边框阴影: div{ box-shadow: offset-x offset-y blur spread color 水平偏移 垂直偏移 延伸距离(可以省略) 阴影颜色 box-shadow: 10px 10px 10px pink; } 盒模型: 外边距: div{ margin: 10px/10%; 有四个值 最少一个 最多4个 效果同上(圆角边框) margin: 0px; 清除外边距 margin: 0px auto; 在父元素内水平居中 margin: -10px; 位置微调 单独设置: margin-top: 上 margin-right: 右 margin-bottom: 下 margin-left: 左 可以是像素也可以是百分比 默认具有外边距的元素: body p h1~h6 ul ol } 内边距: div{ padding: 10px/10%; 有四个值 最少一个 最多4个 效果同上(圆角边框) padding-top 上 padding-right 右 padding-bottom 下 padding-left 左 具有默认内边距的元素: ol ul 文本框 密码框 按钮 td } 声明盒模型计算方式: div{ box-sizing: border-box/content-box; 内边距+边框+内容的共同尺寸/默认值 } 改变元素类型: div{ display: block/inline/inline-block/none; 转换为块元素(显示元素)/转换为行内元素/行内块元素/隐藏元素 } 背景相关属性: 背景颜色: background-color:red; 背景图片: div{ background-image:url("./1.jpg") 图片平铺: background-repeat: repeat/no-repeat/repeat-x/repeat-y; 水平和垂直平铺/不重复平铺/水平平铺/垂直平铺 图片尺寸: background-size: 10px 10px/10%/cover/contain; 当前元素宽 高/元素比例/将图片拉伸全部覆盖元素超出部 分裁剪掉/将图片拉至刚好被容纳 超出部分不管 拉伸:图片比例不变 图片的位置: background-position: x/x% y/y%; 水平偏移/垂直偏移 百分比参照尺寸获取 background-position: 0% 0%; 图片左上角显示 background-position: 100% 100%; 图片右下角显示 background-position: 50% 50%; 图片居中显示 background-position: left/center/right top/center/bottom; 方位值表示:左/中/右 上/中/下 } 简写: div{ background: color/url()/repeat/position; } 文本相关属性: 字体: div{ 字体大小: font-size: 24px; 设置字体大小 font-family: "微软雅黑", "黑体", "KaiTi"; 设置字体类型 字体类型: font-weight: normal/bold/lighter; 正常显示/加粗显示/极细文本 字体加粗: font-weight: 400/700/100; 数字越大越粗 400=normal/700=bold 字体样式: font-style: normal/italic/oblique; 正常显示/使用倾斜显示/使文本倾斜达到斜体效果 简写: font: style weight size family; family 必须写 不写没效果 } 文本: div{ color: green; 文本颜色 文本对齐: text-align: left/center/right/justify; 默认水平左对齐/居中/右对齐/两端对齐 文本行高: line-height: 32px/2; 设置行高位32像素/设置行高为字体大小的2倍 文本居中方式: 将行高设置为和元素一样的高度 一行文本一定的垂直居中的 上下空隙由浏览器默认分配 文本装饰线: text-decoration: underline/overline/line-through/none; 下划线/上划线/删除线/取消下划线 } 表格属性: div{ width:; height:; background:; color:; margin:; padding:; 边框合并: border-collapse: separate/collapse; 默认边框分离/合并边框 td不支持外边距 只能写在table里 边框边距: border-spacing: h-Value v-Value; border-spacing: 10px 10px; 只能在表格分离的状态下使用 } 过渡效果: div{ 过渡属性: transition-property: width/height; 指定某个属性添加过渡效果 宽度过渡/高度过渡 transition-property: all; 将所有能过渡的属性都进行过渡 能够添加过渡的属性:所有颜色相关的、取值为数值的 过渡时长: transition-duration: 1s/100ms; 1秒完成过渡/100毫秒 时间曲率: transition-timing-function: ease/linear/ease-in/ease-out/ease-in-out; 默认开始结束满中间块/匀速/开始慢结束块/开始块结束慢/慢开始结束中间加速后减速 过渡延迟: transition-delay: 1s/100ms; 1秒后开始过渡/100毫秒 过渡时长必须设置其他可以省略 必须写在默认样式中 简写: transition:property duration timing-function delay; duration必须写 } 布局: 普通流布局: 默认方式 浏览器默认布局方式 浮动布局: div{ float: left/right/none; 元素向左浮动停靠在其他元素便于/向右浮动/默认 特点: 元素飘浮会脱流 后面的元素会补位 所有的元素只要设置浮动都可设置宽高 行内元素或行内块元素浮动后 水平方向之间没有空隙 浮动元素特殊效果: 文字环绕效果 浮动元素会遮挡正常元素 但是不会遮挡内容 解决不占位影响: 1.指定父元素的高度 2.父元素中设置 :overflow: hidden; 3.清除浮动: clear: none/left/right/both; 默认不处理/清除左浮影响/正常元素左边不允许出现浮动元素/两边都不允许 4.父元素末尾添加空块元素 设置:clear: both; } 定位布局: div{ position: relative/absolute/fixed/static; 相对定位/绝对定位/固定定位/默认文档流布局 只有设置了非默认属性 才算是已经定位的元素 偏移属性: 用来配合已定位的属性 进行位置移动 top: 10px; 以元素的上边界向下为正方向 right: 10px; 以元素的右边界向左为正方向 bottom: 100px; 以元素的下边界向上为正方向 left: 10px; 以元素的左边界向右为正方向 } 定位方式: div{ 相对定位: position: relative; 按照当前位置偏移 绝对定位: position: absolute; 定位后会脱流 脱流的所有元素都可以设置宽高 按照离他最近的祖先元素偏移 如果没有按照body位置偏移 一般采用父元素相对定位 子元素绝对行为方式 浮动 + 外边距调整元素位置 = 绝对定位 + 偏移属性 固定定位: position: fixed; 按照浏览器窗口进行定位 配合偏移属性使用 定位后元素都会变成块元素 层叠次序调整: z-index: 0~n; 默认0 数字越大越靠上 数值相同 后来者居上 只能用在已经定位的元素上 子元素永远在父元素之上 不受层次影响 } 显示方式: div{ display: none/block/inline/inline-block; 隐藏元素并且不占位/转换为块元素/转换为行内元素/转换为行内块元素 } 显示效果: div{ visibility: visible/hidden; 默认显示/隐藏元素并占位 opacity: 0~1; 设置元素的透明度 继承效果: 子元素最终效果 = 父元素opacity * 自身opacity vertical-align: top/middle/bottom; 调整垂直对齐方式 常见于行内块元素 cursor: default/pointer/text/crosshair; 默认值/设置为小手形状/输入I形状/ +形状 } 转换属性: div{ transform: 转换函数1 转换函数2...; 转换原点设置: transform-origin: x y; transform-origin: 像素/百分比/方位值; 默认以元素中心为原点 转换函数: 平移转换: transform: transform(x,y); x:水平方向平移距离 y:垂直方向 一个值等于translateX(value) transform: translateX(value) 水平方向位移 transform: translateY(value) 垂直方向位移 缩放变换: transform: scale(value)/scaleX()/scaleY(); 正常缩放/横向缩放/垂直缩放 value:默认1 大于1会等比放大 0~1会缩小 小于0会翻转 旋转变换: transform: rotate(90deg/-90deg); 顺时针旋转90度/逆时针旋转90度 transform: rotate3d(45deg/-45deg); transform: rotateX(ndeg); 沿x轴翻转 transform: rotateY(ndeg); 沿y轴翻转 transform: rotateZ(ndeg); 沿z轴旋转 旋转原点会影响旋转效果 如果涉及旋转操作 会连带坐标轴一起旋转,影响后面的位移 } HTML 会跳动的小心心 <!DOCTYPE html> <html> <head> <title></title> <meta charset="utf-8"> <style type="text/css"> #box{ width: 200px; height: 160px; /*background-color: pink;*/ margin: 100px auto; position: relative; } #box:hover{ transform: scale(1.2); } .c1,.c2{ width: 100px; height: 160px; position: absolute; border-radius: 50px 50px 0 0; background-color: red; } .c1{ top:0; left:0; transform:rotate(45deg); transform-origin: right bottom; } .c2{ top:0; right: 0; transform:rotate(-45deg); transform-origin: left bottom; } </style> </head> <body> <div id="box"> <span class="c1"></span> <span class="c2"></span> </div> </body> </html>

优秀的个人博客,低调大师

Python全栈 Web(定位布局、定位方式)

定位布局: 属性:position 取值: static 默认值 按照文档流布局 relative 相对定位 absolute 绝对定位 fixed 固定定位 只有元素的position属性设置为非默认属性 才算是已经定位的元素 偏移属性: top right bottom left 用来配合已经定位的元素实现位置移动 取值:px top:以元素的上边界为基准移动元素 right:以元素的右边界为基准移动元素 bottom:以元素的低边界为基准移动元素 left:以元素的上左界为基准移动元素 定位方式: 相对定位: 属性:position:relative; 元素采用相对定位时会参照它在文档中原本的位置进行偏移 绝对定位: 属性:position:absolute; 特点: 1.绝对定位的元素,会脱离文档流不占位 2.绝对定位元素会参照离他最近的已经定位的祖先元素进行偏移 3.如果没有已经定位的祖先元素 元素会参照body(浏览器窗口左上角)进行偏移 注意: 所有元素只要脱流就可以设置宽高大小 通常使用“父相子绝”的方式页面布局 限制其他元素的布局方式 浮动和绝对定位点都可以实现元素脱流,采用浮动+外边距调整元素的位置 等价于绝对定位+偏移属性 浮动更常见于外围结构标签,做网页整体布局时 使用,绝对定位更常见于内部元素的调整 浮动和相对定位可以共存 设置相对定位只是为了辅助内部子元素+的定位布局 堆叠次序的调整: 已经定位的元素堆叠在一起是的排列顺序 语法: 属性:z-index 取值:整数 数值越大越靠上 注意: 如果我们元素z-index属性值相同,后来者居上 父子元素都设置z-index 永远都是子元素在上 不受影响 z-index属性只能用在已经定位的元素上 固定定位: 可以使元素的位置固定在浏览器窗口的某个位置 不会随网页内容的滚动而滚动 语法: 属性:position 取值:fixed 配合偏移属性实现元素位置的固定 注意: 固定定位的元素永远是参照浏览器的窗口定位的 固定定位的元素都会变成块元素 显示方式: 1.决定元素以何种样式显示在网页中 属性:display 取值: none 设置元素隐藏 隐藏后不占位 block 设置元素显示 或 将元素转换为块元素 inline 转换为行内元素 inline-block 转换为行内块元素 显示效果: 属性:visibility 取值: visible 默认值 表示显示 hidden 元素隐藏 仍然在文档中占位 元素透明度: 属性:opacity 设置元素透明度 取值:0~1 0:透明 1:不透明 元素设置opacity属性 所有的内容都会实现透明效果 子元素会继承父元素的透明效果 如果父子元素都设置了opacity 子元素最终的效果是在父元素半透明的基础上 在进行半透明 子元素最终效果=父元素opacity*本身opacity 设置垂直对齐方式: 属性:vertical-align 取值:top middle bottom 可以用在行内元素上 但更常见于为行内快元素设置vertical-align 调整行内快元素左右内容与它的对齐方式 光标显示: 改变鼠标悬停在元素上时的显示外观 属性:cursor 取值: default 默认 pointer 显示为小手形状 text 显示为 I crosshair 显示为 + 列表属性: 列表本身是块级元素,自带外边距,电邮项目符号 属性: 属性:list-style-type 设置项目符号 取值: none 取消项目符号 disc 实心原点 circle 空心原点 square 实心方块 ... 设置项目符号为图片: 属性:list-style-image 取值: url(“图片路径”) 设置项目符号的位置: 属性:list-style-position 取值:inside outside 设置项目符号出现在内容框的外部还是内部 **简写属性: list-style:none; 常用来取消列表的项目符号 转换属性: 主要是用来改变元素在页面中的位置、尺寸、角度 属性:transform 取值: 转换函数 多个函数之间用空格隔开 转换原点: 转换原点实际上就是元素转换操作的基准点 属性:transform-origin 取值:x y; 表示以元素左上角为原点进行选取旋转原点的坐标 可以使用像素值、百分比、方位值 top center bottom left center right 默认以元素的中心点为原点 转换函数: 平移变换: 改变元素在网页中的位置 属性:transform 取值:translate(x, y) x表示元素在水平方向上平移的距离 y表示元素在垂直方向上平移的距离 可以填写正值或负值 其他情况: translateX(value) 指水平方向位移 translateY(value) 指垂直方向位移 translate(value) 等价于translateX 缩放变换: 改变元素在页面中的大小 属性:transform 取值:scale(value) value为无单位的素值 表示缩放比例 默认值是1 正常比例显示 value > 1 会等比放大 0 < value < 1 等比缩小 value < 0 元素会等比反转 其他情况: scaleX(v) 横向缩放 scaleY(v) 垂直缩放 旋转变换: 元素旋转一定的角度显示 属性:transform 取值:rotate(ndeg) 表示元素按照指定的角度旋转 正值:顺时针 负值:逆时针 3D变换: rotateX(ndeg)沿X轴旋转 rotateY(ndeg)沿Y轴旋转 rotateZ(ndeg)沿Z轴旋转 旋转原点会影响转换效果 元素如果涉及旋转操作 会连带坐标轴一起旋转,影响后面的位移

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册