首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Spring Boot 教程系列学习

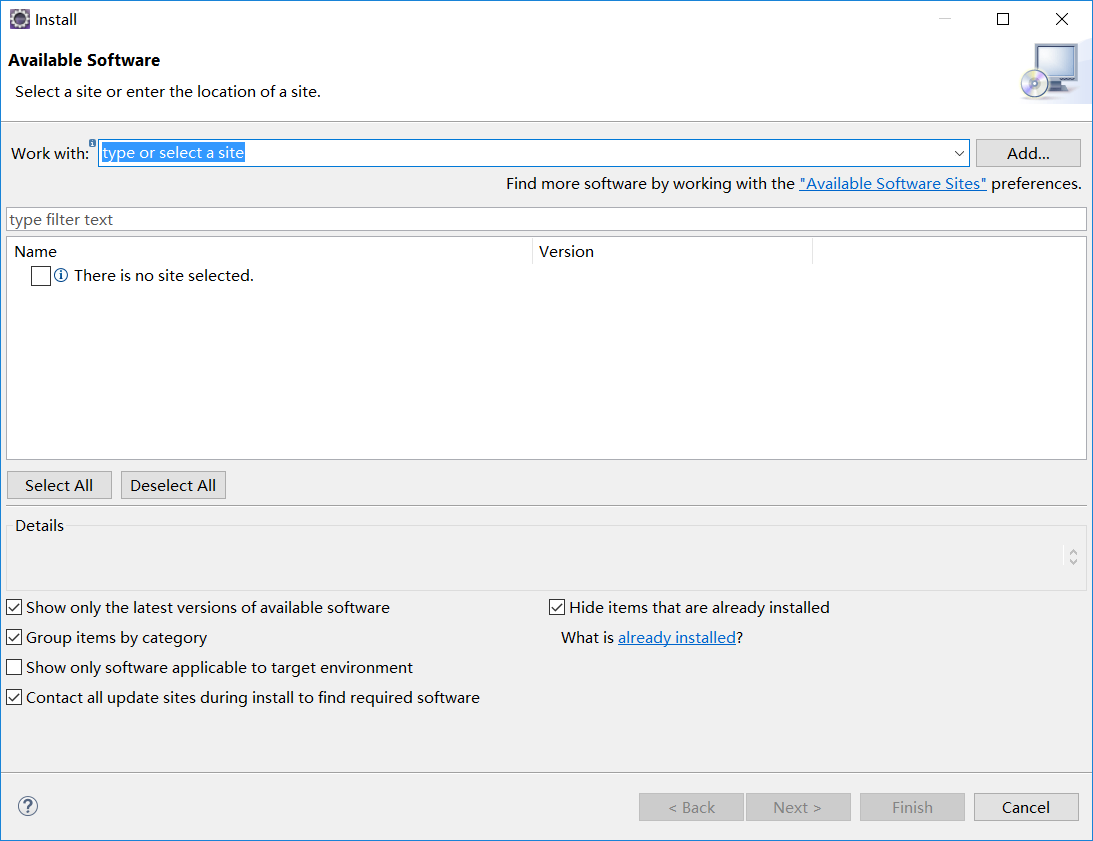
Spring Boot基础教程1-Spring Tool Suite工具的安装 Spring Boot基础教程2-RESTful API简单项目的快速搭建 Spring Boot基础教程3-配置文件详解:Properties和YAML Spring Boot基础教程4-配置文件-多环境配置 Spring Boot基础教程5-日志配置-logback和log4j2 Spring Boot基础教程6-web应用开发-模板引擎FreeMarker Spring Boot基础教程7-web应用开发-模板引擎Thymeleaf Spring Boot基础教程8-web应用开发-模板引擎jsp Spring Boot基础教程9-web应用开发-错误处理 Spring Boot基础教程10-web应用开发-Servlets, Filters, listeners Spring Boot基础教程11-web应用开发-CORS支持 Spring Boot基础教程12-web应用开发-文件上传 点击链接加入群聊【Spring Boot Cloud技术交流】:https://jq.qq.com/?_wv=1027&k=5FDiKZw 插件篇 Elicpse使用技巧-打开选中文件文件夹或者包的当前目录 (更详细的讲解请观看视频,源码也在相应的文档里面) 视频教程:http://www.roncoo.com/course/view/c99516ea604d4053908c1768d6deee3d 源码地址:https://github.com/roncoo/spring-boot-demo 1.工具下载地址: Eclipse:http://www.eclipse.org/downloads/packages/eclipse-ide-java-ee-developers/neonr Spring Tool Suite:https://spring.io/tools/sts/all 2.使用版本为: Eclipse:eclipse-jee-neon-R-win32-x86_64.zip Spring Tool Suite:springsource-tool-suite-3.8.0.RELEASE-e4.5.2-updatesite.zip 3.安装步骤: 3.1 解压Eclipse,打开Help ---> Install New Sofware... 3.2 点击右上角位置的:Add... 3.3 点击右上角位置的:Loccal...,选中解压之后的springsource-tool-suite-3.8.0.RELEASE-e4.5.2-updatesite,,之后点击 OK 3.4 点击 Select All,之后确认,后面有多次需要确认,会花费一定的时间,请耐心等待,安装完成之后,会提示重启。 小提示:可以选中在线安装Spring Tool Suite 这个插件。Help ---> Eclipse Marketplce...之后搜索spring tool suite 注意版本的选择 查看Eclipse版本:Help ---> About Eclipse

优秀的个人博客,低调大师

c++命名空间 namespace学习

我们为什么需要命名空间? 我们假设一下这种情况,在A班中,有一名同学叫小明,在B班中,也有一名同学叫小明,现在两个班的同学一起聚会,老师找A班的小明,这时候他在人群中喊一声小明肯定两个小明都过来了,这个时候B班小明就白跑一趟了,为了避免这种尴尬,老师只要喊“A班的小明过来一下就行了”。在c++已经其他某些语言中,也是这个道理,在很多大型项目中,由于可能多人一起开发,难免出现相同名字的变量,这个时候我们就需要namespace了,在调用同名变量时,另外加上它的namespace,这样就避免了出错。 1.命名空间实例 //namespace study #include<iostream> using namespace std; namespace first_space{ void func(){ cout<<"my first_space"<<endl; } } namespace second_space{ void func(){ cout<<"my second_space"<<endl; } } int main(){ first_space::func(); second_space::func(); } 2.using指令 您可以使用using namespace指令,这样在使用命名空间时就可以不用在前面加上命名空间的名称。这个指令会告诉编译器,后续的代码将使用指定的命名空间中的名称。 //namespace study #include<iostream> using namespace std; namespace using_space{ void beusing(){ cout<<"I am using"<<endl; } } using namespace using_space; //namespace using_space{ // void beusing(){ // cout<<"I am using"<<endl; // } //} int main(){ beusing(); } 这里注意using namespace必须在被调用空间定义后再使用。 using 指令也可以用来指定命名空间中的特定项目。例如,如果您只打算使用 std 命名空间中的 cout 部分,您可以使用如下的语句: #include <iostream> using std::cout; int main () { cout << "std::endl is used with std!" << std::endl; return 0; } 3.不连续的命名空间 命名空间可以定义在几个不同的部分中,因此命名空间是由几个单独定义的部分组成的。一个命名空间的各个组成部分可以分散在多个文件中。 所以,如果命名空间中的某个组成部分需要请求定义在另一个文件中的名称,则仍然需要声明该名称。下面的命名空间定义可以是定义一个新的命名空间,也可以是为已有的命名空间增加新的元素: namespace namespace_name { // 代码声明 } 4.嵌套的命名空间 在c++中,命名空间的使用是可以嵌套的。如下所示: namespace namespace_name1 { // 代码声明 namespace namespace_name2 { // 代码声明 } } 注意,引用父级命名空间并不能直接调用子空间里的变量,如下: #include<iostream> using namespace std; namespace first_space{ namespace second_space{ int a=0,b=1; } } using namespace first_space; int main(){ cout<<a<<" "<<b<<endl; //错误代码,a未定义 return 0; } 正确调用方式如下: #include<iostream> using namespace std; namespace first_space{ namespace second_space{ int a=0,b=1; } } using namespace first_space::second_space; int main(){ cout<<a<<" "<<b<<endl; return 0; }

优秀的个人博客,低调大师

java8学习:默认方法

内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 在java8中接口引进了静态方法以及默认方法,通过默认方法,可以为接口方法提供默认实现,也就是说接口能提供方法的具体实现.因此实现接口的类如果不显示的提供该方法的具体实现,就会自动继承默认的实现 同时定义接口以及工具辅助类是java常用的一种模式,工具类定义了与接口实例协作的很多静态方法,由于静态方法现在可以存在接口内部,所以代码中的辅助类就没有了存在的必要,可以直接把这些静态方法转移到接口内部 不断演进的API 我们来说一下为什么会出现默认方法 假如有如下一个接口,你是类库的设计者,那么你写的接口是这样的 public interface Behavior { void eat(String foodName); } 然后你发布之后大火,你的用户是这样使用的 public class Dog implements Behavior { @Override public void eat(String foodName) { System.out.println("dog " + foodName); } } 之后你收到了很多意见,说这个行为接口并不丰富,行为不可能只有吃的行为,动物可是都有吃喝拉撒的行为啊! 现在你就遇到了问题,如果你将建议的接口添加入Behavior接口,然后发布,这时候你的用户只要更新API的版本,那么他就会遇到一个大麻烦,那么就是实现你在接口中定义的所有方法.这对用户来说是非常不好的.这也是默认方法产生的原因:它可以让你放心的改进接口,无须担心遗留代码的影响,这是因为实现更新接口的类都会自动的集成一个默认的方法实现 不同类型的兼容:二进制,源代码和函数行为 变更对java的影响大体可以分为三种类型的兼容:二进制级的兼容,源代码级的兼容,以及函数行为的兼容. 二进制级的兼容性表示现有的二进制执行文件能无缝持续链接和运行,比如,为接口添加一个方法就是二进制级的兼容,这种方式下,如果添加的新方法不被调用,接口已经实现的方法可以继续运行,不会出现错误 简单的说,源代码级的兼容性表示引入变化之后,现有的程序依然能够成功通过编译 函数行为的兼容性表示发生变更后,程序接受同样的输入能得到相同的结果 概述默认方法 默认方法就是用default修饰的方法,并像类中声明的其他方法一样包含方法体,并且只要类实现了这个包含默认方法的接口,他就会继承默认方法 java8中的抽象类和抽象接口区别:首先一个类只能继承一个抽象类,但是一个类可以实现多个接口,其次,一个抽象类可以通过实例变量保存一个通用状态,而接口是不能有实例变量的 默认方法的使用模式 可选模式 平常我们用类实现一个接口,接口中有很多方法需要我们重新定义,如果有用的方法还好,如果我们并用不到的方法,为了满足接口方法的实现规则,我们就必须在那放一个空方法实现,这也是多余的模板代码,我们可以将这类方法变更为默认方法以实现不必要的空实现 行为的多继承 行为的多继承值得是:类只能继承一个类,但是可以实现多个接口中的方法,这就是所谓的多继承,现在java8中有了方法的默认实现,那么我们的类就得到了来自不同接口的实现的功能 解决冲突的规则 一个类实现了多个接口,而多个接口中含有覆盖实现的方法,那么类会使用那个接口中的方法呢?如果是多个接口中的方法都是相同的方法签名呢? interface A{ default void say(){ System.out.println("A"); } } interface B extends A { @Override default void say() { System.out.println("B"); } } public class Dog implements B{ public static void main(String[] args) { new Dog().say(); //B } } 如果一个类使用相同的函数签名从多个地方继承了方法,通过三条规则可以进行判断 类中的方法优先级最高,类或父类中声明的方法的优先级高于任何声明为默认方法的优先级 如果无法依据第一条判断,那么就是子类的优先级更高:函数签名相同时,优先选择拥有最具体实现的默认方法的接口,即B继承了A,那么B更具体 如果还没办法判断,继承多个接口的类必须通过显示覆盖和调用期望的方法,现实的选择使用哪个默认方法的实现 如下 interface A{ default void say(){ System.out.println("A"); } } interface B extends A { @Override default void say() { System.out.println("B"); } } class D implements A{ } public class Dog extends D implements A,B{ public static void main(String[] args) { new Dog().say(); //B } } 依照类或父类中声明的方法的优先级高于任何声明为默认方法的优先级,那么就会优先选择D,那么D并没有覆盖掉say方法,但是他默认继承了A的方法,所以它会调用A的方法,但是他会选择更具体的实现,那么就是B,最终也是输出的B 菱形继承问题 interface A{ default void say(){ System.out.println("A"); } } interface B extends A { } interface C extends A{ } public class Dog implements B,C{ public static void main(String[] args) { new Dog().say(); //A } } 如上,其继承实现关系类似于菱形,Dog实现了B,C但是BC中只是继承了A中的默认方法,所以编译并不会出错,并且Dog也是使用此默认实现,所以输出A 如果我们将B加上覆盖实现呢? interface B extends A { default void say(){ System.out.println("B"); } } 现在会输出B,因为覆盖实现的方法更加具体 如果两个BC接口都覆盖实现了say方法呢? //B接口如上变动 interface C extends A{ default void say(){ System.out.println("C"); } } 这时候我们就会发现,Dog编译出错了,因为BC都有具体实现,并且都是一个级别的,都是具体实现了A的默认方法,Dog就不知道需要调用谁的方法了,这时候我们只能是在Dog中覆盖这个默认方法的实现了 public class Dog implements B,C{ public static void main(String[] args) { new Dog().say(); //dog } @Override public void say() { System.out.println("dog"); } } 如果BC接口只是定义的与A中say方法签名一样的抽象方法呢? interface A{ default void say(){ System.out.println("A"); } } interface B extends A { void say(); } interface C extends A{ default void say(){ System.out.println("C"); } } public class Dog implements B,C{ public static void main(String[] args) { new Dog().say(); //dog } @Override public void say() { System.out.println("dog"); } } 如上只要有一个接口有抽象方法,那么我们就还得按照接口中抽象方法必须实现的规则来 所以解决所有可能的冲突只需要三点 类或父类中显示声明的方法,其优先级高于任何默认方法,即自己实现的比默认的优先级高 如果上面的无法判断,方法签名又没有区别,那么选择提供最具体实现的默认方法的接口,即用接口的最具体的子类的实现 如果依旧有冲突,那么就只能在本类中重写覆盖默认方法了
优秀的个人博客,低调大师

JavaScript学习(十一)--数值处理对象

目录 Math对象 1.math对象的属性 2. Math对象的方法 Number对象 1.创建Number对象 2.Number对象的属性 (1)MAX_VALUE属性 (2)MIN_VALUE属性 (3)NEGATIVE_INFINITY属性 (4)POSITIVE_INFINITY属性 3.Number对象的方法 (1)toString()方法 (2)toFixed()方法 (3)toExponential()方法 (4)toPrecision()方法 Boolean对象 1.创建Boolean对象 2.Boolean对象的属性 (1)constructor属性 (2)prototype属性 3.Boolean对象的方法 (1)toString()方法 (2)valueOf()方法 Math对象 1.math对象的属性 例子: var piValue=Math.PI; //计算圆周率 var rootofTwo=Math.SQRT2; //计算平方根 2. Math对象的方法 例子: var result=Math.pow(value1,10); //计算一个数的10次方 var result=Math.round(value); //使用四舍五入函数计算最相近的整数值 随机产生指定位数的验证码。 <body> <script type="text/javascript" language="JavaScript"> function ran(digit){ /*自动生成验证码*/ var result=""; for(i=0;i<parseInt(digit);i++){ result=result+(parseInt(Math.random()*10)).toString(); } return result; } function deal(){ result.innerHTML="&nbsp;&nbsp;产生的验证码:"+ran(form.digit.value); } </script> <form name="form"> <input type="text" name="digit" /> <input type="button" value="生成" onclick="deal()"/> </form> <div id="result"> &nbsp;&nbsp;产生的验证码: </div> </body> Number对象 由于JavaScript使用简单数值完成日常数值的计算,因此,number对象很少被使用,当需要访问某些常量值时,如数字的最大或最小值、正无穷大或负无穷大时,该对象显得非常有用。 1.创建Number对象 number对象是原始数值的包装对象,使用该对象可以将数字作为对象直接进行访问。 语法:numobject=new Number(value) value:可选项。是新对象的数字值。如果忽略value,则返回值为0. 2.Number对象的属性 (1)MAX_VALUE属性 MAX_VALUE属性用于返回number对象的最大可能值。 语法:value=Number.MAX_VALUE; value:存储Number对象的最大可能值的变量。 例子: var max=Number.MAX_VALUE; document.write(max); (2)MIN_VALUE属性 MIN_VALUE属性用于返回number对象的最小可能值 语法:value=Number.MIN_VALUE value:存储Number对象的最小可能值的变量。 (3)NEGATIVE_INFINITY属性 NEGATIVE_INFINITY属性用于返回number对象的负无穷大的值。 语法:value=Number.NEGATIVE_INFINITY value:存储Number对象的负无穷大的值。 (4)POSITIVE_INFINITY属性 POSITIVE_INFINITY属性用于返回number对象的正无穷大的值。 语法:value=Number.POSITIVE_INFINITY value:存储Number对象的正无穷大的值。 3.Number对象的方法 (1)toString()方法 toString()方法可以把Number对象转换成一个字符串,并返回结果。 语法:Numberobject=.toString(radix) (2)toFixed()方法 toFixed()方法将number对象四舍五入为指定小数位数的数字,然后转换为字符串。 语法:Numberbject.toFixed(num) (3)toExponential()方法 toExponential()方法 利用指数计数法计算number对象的值,然后将其转换成字符串。 语法:number.toExponential(NUM) NUM:必选项。规定指数计数法中的小数位数 ,是0-20之间的值。 (4)toPrecision()方法 toPrecision()方法将number对象转换成字符串,并根据不同的情况选择定点计数法或指数计数法。 语法:number.toPrecision(num) NUM:必选项。规定指数计数法中的小数位数 ,是0-20之间的值。 Boolean对象 1.创建Boolean对象 Boolean对象是JavaScript的一种基本数据类型,是一个把布尔值打包的布尔对象。可以通过Boolean对象创建新的Boolean值。 语法:bool=new Boolean([boolValue]) bool:要赋值为Boolean对象的变量名。 boolValue:可选项。是新对象的初始Boolean值。如果忽略boolValue,或者其值为false、0、null、NaN或空字符串,则该Boolean对象的初始值为false;否则,初始值为true。 2.Boolean对象的属性 Boolean对象有constructor和prototype两个属性,下面分别进行介绍。 (1)constructor属性 constructor属性用于对当前函数的引用。 (2)prototype属性 prototype属性可以对对象添加属性和方法。 var newboolean=new Boolean(); Boolean.prototype.mark=null; newboolean.mard=1; alert(newboolean.mard); 3.Boolean对象的方法 Boolean对象有toString()和valueOf()两个方法。 (1)toString()方法 toString()方法用于将Boolean值转换为字符串。 语法:Boolean.toString() (2)valueOf()方法 valueOf()方法用于返回Boolean对象的原始值。 语法:Boolean.valueOf()

优秀的个人博客,低调大师

20.Swift学习之协议

协议 协议为方法、属性、以及其他特定的任务需求或功能定义一个大致的框架。协议可被类、结构体、或枚举类型采纳以提供所需功能的具体实现。满足了协议中需求的任意类型都叫做遵循了该协议。 协议的定义 协议的定义方式与类,结构体,枚举的定义都非常相似 protocol SomeProtocol { // 属性 // 方法 } 协议中的属性 不可以有默认值 必须设置是{get}或者{get set} ,注意:get与set之间是没有逗号的 必须设置为var 协议中的方法 可以定义普通方法也可以是mutating方法 方法不能有方法体 方法的参数不可以有默认值 protocol Pet { // 定义属性 var name: String {get set} var age: Int {get} // 定义方法 func feed(food: String) mutating func shout(sound :String); } 协议的遵守格式(实现协议) 格式 class SomeClass: SomeSuperClass, FirstProtocol, AnotherProtocol { // 类的内容 // 实现协议中的方法 } 实现协议中的属性 此时属性可以设置默认值 协议中属性为可读可写的,可以直接声明为var类型就可以 协议中属性为可读属性,可以直接声明为let类型就可以,也可以声明为var类型 实现协议中的方法 可以为方法中的参数设置默认值 在结构体中,如果需要改变自身的值,需要在方法前面加mutating关键字。在协议的方法中添加mutating关键字,如果结构体来遵守协议,需要有mutating这个关键字,如果是类来遵守协议,mutating关键字就不需要了。 class Cat : Pet{ //属性可以设置默认值 //可读可写用var var name: String = "Dingding" //只读可以用let let age: Int = 10 func feed(food: String) { print("feed\(food)") } //方法参数可以有默认值 //类实现mutating方法要修改属性值时必须加不用加mutating func shout(sound: String = "miaomiao") { self.name = "Caicai" print("shout\(sound)") } } struct Dog : Pet{ var name: String var age: Int func feed(food: String) { print("feed\(food)") } //结构体实现mutating方法要修改属性值时必须加mutating mutating func shout(sound: String) { self.name = "Guaiguai" print("shout\(sound)") } } 协议之间的继承 protocol CrazySportProtocol { func jumping() } //继承协议 protocol SportProtocol : CrazySportProtocol { func playBasketball() func playFootball() } //此时的类必须所有方法都实现 class Person:SportProtocol{ func playBasketball() { print("playBasketball") } func playFootball() { print("playFootball") } func jumping() { print("jumping") } } 协议中方法的可选 方法一 定义协议 @objc protocol SportProtocol2 { // 该方法可选 @objc optional func playBasketball() func playFootball() } 遵守协议 class Person : SportProtocol2 { var name : String? var age : Int = 0 // 实现协议中的方法,此时可以不实现协议中的可选方法,当然也可以实现 func playBasketball() { print("人在打篮球") } } 方法二 扩展协议 protocol SomeProtocol { func requiredFunc() func optionalFunc() } extension SomeProtocol { func optionalFunc() { print("optionalFunc扩展中实现") } } class SomeClass: SomeProtocol { func requiredFunc() { print("requiredFunc具体类中实现") } } 协议的运用——代理模式 //1.定义一个协议,规定需要完成的任务 protocol BuyTicketProtocol { func buyTicket() } //2.让具体的类或者结构体实现协议,将任务具体化 class Assist : BuyTicketProtocol{ func buyTicket() { print("助手去买票") } } class HN : BuyTicketProtocol{ func buyTicket() { print("黄牛去买票") } } //3.委托方申明一个属性(遵循协议),然后在真正需要完成任务的时候调用属性来完成 class Person { // 1.定义协议属性 var delegate : BuyTicketProtocol // 2.自定义构造函数 init (delegate : BuyTicketProtocol) { self.delegate = delegate } // 3.行为 func goToBeijing() { print("找代理买票") delegate.buyTicket() print("拿到票去北京") } } let p = Person(delegate: HN()) p.goToBeijing() let p2 = Person(delegate: Assist()) p2.goToBeijing()

优秀的个人博客,低调大师

2018-11-12学习笔记

Android 实战 | 使用揭露动画(Reveal Effect)做一个丝滑的Activity转场动画 揭露动画(Reveal Effect)实现时的注意事项(附上bug-logcat) boolean java.lang.String.equals(java.lang.Object)' on a null object reference java.lang.NullPointerException: Attempt to invoke virtual method 'int android.content.Intent.getI... 其他 ROS_机器人urdf建模仿真实践 基于VM14+ Ubuntu 16.04安装VMware Tools(VM同主机file交互的工具)以及使用的骚操作 解决 | 此数据库文件跟当前sql server实例不兼容 & sql server2008无法连接到(local) 解决 | VS 2015右键项目添加新项中没有web窗体等选项

优秀的个人博客,低调大师

java8学习:引入stream

内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 这一篇内容要讲的是流,关于流的概念,流的内部迭代跟外部迭代的区别之类的偏概念性的问题,下一篇在细讲流到底是什么用 那么说到流,我们自然就会想到水,这就涉及到水源头是哪里,水怎么流过来的,水会被我们的桶收集起来,还是说用水杯收集起来,那么问题就一下子出现了三个 流的源头是哪里 流的源头包括集合,数组或者一些输入输出资源,但是需要注意的是,从有序集合生成流时会保持原有的数据,从列表生成的流,其元素数据与列表一致 流是怎么个处理过程 这其实就要设计到用到了具体的api了,下面会说到 流的收集 无非就是收集成集合等一些等存储数据的数据结构中 流和集合作对比 一点很清楚的就是,流是来做计算的,而集合是用来存储的,这个应该很容易理解 还有一个就是:我们需要看一部电影,那么无非就是两种在线看和下载下来看,那么在线看就属于流模式,而整个资源下载下来看就属于集合模式了,所以从简单的说集合与流之间的差异就在与什么时候计算。集合是一个内存中的数据结构,它包含了所有值,就比如我们使用的list,不管添加还是删除他总是在内存中操作的,并且它是每个元素先计算出来再添加到集合的,而流呢?他就像我们在线看电影一样,不需加载全部的数据,剧情无聊快进的时候,流的处理方式就是加载你点击的时间点之后的几帧来供你观看,这就是他们的区别 好了扯了一大堆概念,让我们来看看集合和流处理数据的方式 我们利用下面这个类的结构来编写代码 @Data public class Dish { private final String name; private final boolean vegetarian; //是否是素菜 private final int calories; //卡路里 private final Type type; private enum Type{ MEAT,FISH,OTHER; } public Dish(String name, boolean vegetarian, int calories, Type type) { this.name = name; this.vegetarian = vegetarian; this.calories = calories; this.type = type; } } 好了让我们创建一个集合 List<Dish> menu = Arrays.asList( new Dish("apple",true,50, Dish.Type.OTHER), new Dish("chicken",false,350, Dish.Type.MEAT), new Dish("rich",true,150, Dish.Type.OTHER), new Dish("pizza",true,350, Dish.Type.OTHER), new Dish("fish",false,250, Dish.Type.FISH), new Dish("orange",true,70, Dish.Type.OTHER), new Dish("banana",true,60, Dish.Type.OTHER)); 集合操作:找出卡路里最低排名的前三位 @Test public void test() throws Exception { menu.sort(new Comparator<Dish>() { @Override public int compare(Dish o1, Dish o2) { return o1.getCalories() - o2.getCalories(); } }); for (int i = 0; i < 3; i++) { System.out.println(menu.get(i)); } } 流操作:找出卡路里最低排名的前三位 @Test public void test() throws Exception { List<Dish> collect = menu .stream() .sorted(Comparator.comparing(Dish::getCalories)) .limit(3) .collect(Collectors.toList()); for (Dish dish : collect) { System.out.println(dish); } } 观察上面两种,肯定是流操作比较好一些,因为它操作的每一步都很清楚的告诉开发者他的流在干什么,如上就是流和集合的一个简单对比 如上其实也反映了两个:内部迭代和外部迭代,流就属于内部迭代,集合的操作的方法就是外部迭代 内部迭代就是按照我们的意思,类似SQL似的查询操作,比如取前三啊那就是limit(3),然后他会根据你的查询条件自动的去遍历你的集合,这样就省去自己去一步步的写逻辑了 外部迭代自己理解的就是需要开发者手动编写遍历逻辑 那么流是一个一次性的,所以我们看如下 Stream<Dish> limit = menu.stream() .sorted(Comparator.comparing(Dish::getCalories)) .limit(3); List<Dish> collect1 = limit.collect(Collectors.toList()); //IllegalStateException: stream has already been operated upon or closed List<Dish> collect2 = limit.collect(Collectors.toList()); 上面就充分说明了,流只能遍历一次。当遍历一次之后这个流就被消费掉了,如果重新需要,那么需要从源头那再获取个stream 我们看下面的代码 Stream<Dish> limit = menu.stream() .sorted(Comparator.comparing(Dish::getCalories)) .limit(3); System.out.println(limit);//java.util.stream.SliceOps$1@436e852b List<Dish> collect1 = limit.collect(Collectors.toList()); //结果 这段代码就可以说明了,流是一种类似懒加载模式的,只有触发终端操作,那么这个流才会开始启动遍历数据,如上我们一直到limit(3)这都是流的中间操作,流的中间操作是不会产生数据的,只有出发了collect方法这个终端方法才会开始流的遍历工作,当然中间操作不止limit,sorted,终端操作也不止collect,这一篇只是简单的引入一下流而已,下一篇内容将会讲stream的使用 好了这一篇内容就介绍到这,主要介绍了流的概念,流和集合的区别,内外迭代和流的中间操作以及终端操作,还有重要的一点就是流是一次性的

优秀的个人博客,低调大师

21.Swift学习之扩展

扩展 为现有的类、结构体、枚举类型、协议添加了新功能。扩展和 Objective-C 中的分类类似。 扩展可以: 添加计算属性; 定义方法; 提供新的构造函数; 使现有的类型遵循某协议 Swift中使用extension关键字实现扩展 语法 extension SomeType { // new functionality to add to SomeType goes here } 扩展可以使已有的类型遵循一个或多个协议。在这种情况下,协议名的书写方式与类或结构体完全一样: extension SomeType: SomeProtocol, AnotherProtocol { // implementation of protocol requirements goes here } 扩展计算属性 扩展可以向已有的类型添加计算实例属性和计算类型属性。 extension Double { var km: Double { return self * 1_000.0 } var m: Double { return self } var cm: Double { return self / 100.0 } var mm: Double { return self / 1_000.0 } var ft: Double { return self / 3.28084 } } 25.0.km 25.0.m 25.0.cm 25.0.mm 3.0.ft 扩展构造函数 扩展可向已有的类型添加新的初始化器 extension CGRect{ init(center: CGPoint, size: CGSize) { let originX = center.x - size.width * 0.5 let originY = center.y - size.height * 0.5 self.init(x: originX, y: originY, width: size.width, height: size.height) } } let centerRect = CGRect(center: CGPoint(x: 100.0, y: 100.0), size: CGSize(width: 100.0, height: 100.0)) 扩展方法 扩展可以为已有的类型添加新的实例方法和类型方法。 extension Int { func repetitions(task: () -> Void) { for _ in 0..<self { task() } } } 3.repetitions { print("Hello!") } 扩展mutating方法 扩展结构体,如果要修改里面的值,必须在方法面前加上mutating extension Int { mutating func square() { self = self * self } } //必须用变量,因为它的值要被修改 var someInt = 3 someInt.square() 使现有的类型遵循某协议 class ViewController : UIViewController{ } extension ViewController : UITableViewDataSource{ func tableView(_ tableView: UITableView, numberOfRowsInSection section: Int) -> Int { return 10 } func tableView(_ tableView: UITableView, cellForRowAt indexPath: IndexPath) -> UITableViewCell { return UITableViewCell() } } 面向协议编程 针对某个需要实现的功能,可以使用协议定义出接口,然后利用协议扩展提供默认的实现。需要这个功能,只需要声明遵守了这个协议即可,遵守某个协议的对象调用协议声明的方法时,如果类本身没有提供实现,协议扩展提供的默认实现会被调用。 案例一 protocol Eat { func eat() } class Person: Eat { func eat() { print("吃饭了") } } var p = Person() p.eat() 改进 extension Eatable { func eat() { print("吃饭了") } } class Person: Eatable { } var p = Person() p.eat() 再次修改 class Person: Eatable { func eat() { print("人要吃饭了") } } var p = Person() p.eat() 案例二 protocol Coder { var haveFun:Bool {get set} var ownMoney:Bool {get set} } protocol Swifter { var codingLevel:Int {get set} } struct CoderA : Coder { var name:String var haveFun: Bool var ownMoney: Bool } struct CoderB : Coder, Swifter { var name:String var haveFun: Bool = true var ownMoney: Bool = true var codingLevel: Int = 3 } struct CoderC : Coder, Swifter{ var name:String var haveFun: Bool = true var ownMoney: Bool = true var codingLevel: Int = 5 } 可以发现CoderB与CoderC有冗余 改进 protocol Coder { var haveFun:Bool {get set} var ownMoney:Bool {get set} } protocol Swifter { var codingLevel:Int {get set} } //where限定条件 extension Coder where Self:Swifter { var haveFun:Bool { return true} var ownMoney:Bool { return true} } struct CoderA : Coder { var name:String var haveFun: Bool var ownMoney: Bool } struct CoderB : Coder, Swifter { var name:String var haveFun: Bool var ownMoney: Bool var codingLevel: Int = 3 } struct CoderC : Coder, Swifter{ var name:String var haveFun: Bool var ownMoney: Bool var codingLevel: Int = 5 }

优秀的个人博客,低调大师

Scala学习笔记(1)-环境搭建

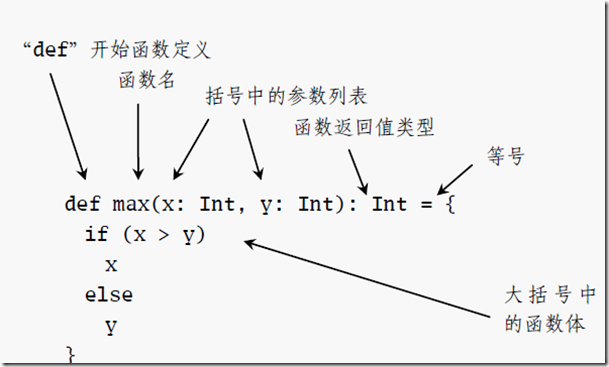
Scala是一种多范式的编程语言,设计初衷是要集成面向对象编程和函数式编程的各种特性。scala可以和java程序无缝拼接,因为scala文件编译后也是成为.class文件,并且在JVM上运行,有下下一代Java之称,当然要有Java今天的阵势还有很长很长的一段路要走。 Scala的几个主要特性 1.面向风格:Scala中的每个值都是一个对象,包括基本数据类型(java中基本类型不是对象)在内,连函数也是对象。 2.函数式风格:高阶函数(Higher-Order Function)、局部套用(Currying)、嵌套函数(Nested Function)、序列解读(Sequence Comprehensions)等等。 3.Scala是静态类型的,这就允许它提供泛型类、内部类、甚至多态方法(Polymorphic Method) 4.Scala可以与Java互操作:它用scalac这个编译器把源文件编译成Java的class文件(即在JVM上运行的字节码)。你可以从Scala中调用所有的Java类库,也同样可以从Java应用程序中调用Scala的代码。它也可以访问现存的数之不尽的Java类库,这让(潜在地)迁移到Scala更加容易。 1.安装Scala,这个不用多说 Scala目前最新的版本为2.11.8,下载地址http://www.scala-lang.org/,我下载的.msi文件,直接安装完毕自动添加了path 2.安装IDE (1)直接下载ScalaIDE,安装完后就可以直接使用。 (2)已安装有Eclipse的,可以安装scala支持插件,支持的eclipse版本是3.8-4.3(Juno and Kepler) 插件地址 http://download.scala-ide.org/sdk/helium/e38/scala211/stable/site 其他版本:http://scala-ide.org/download/prev-stable.html 3.写一段代码测试一下 package com.demo object Demo {//注意这里是object 不是 class 喔,两者区别后面会讲到。 def main(args: Array[String]): Unit = { println("hello scala!") println("hello world!");//分号可选要不要 } } 本文来自云栖社区合作伙伴“开源中国” 本文作者:山海经 原文链接

优秀的个人博客,低调大师

kettle学习笔记及最佳实践

最近在用kettle迁移数据,从对kettle一点不会到比较熟悉,对于期间的一些问题和坑做了记录和总结,内容涵盖了使用的经验和技巧,踩到的坑、最佳实践和优化前后结果对比。 常用转换组件 计算形成新字段:只限算术运算,并且选择固定 过滤记录:元表某字段按照某个条件分流,满足条件的到一个表,不满足的到另一个表,这两个目标表都必须有。 Switch/Case:和过滤记录类似,可以多个条件判断,并且有默认转向条件,可以完美替换过滤记录组建 记录分组:group by 组建未能正常按照预期理解运行 设置为NULL:将某个特定值设置为NULL 行扁平化:行扁平化,使用与某条件下某名称对应的行数相同的情况 行列转换:行转成列,使用Row Normalizer组件,事先一定要是根据分组字段排好序,关键字段就是name列字段,分组字段就是按照什么分组,目标字段就是行转列之后形成的字段列表。 8.字段选择:选择需要的目的列到目标表,并且量表的对应字段不一样时可以用来做字段映射 排序:分组前先排序可以提高效率 条件分发:根据条件分发,相当与informatica的router组件 值映射:相当与oracle的decode函数,源和目标字段同名的话,只要写源字段就可以了 #常用输入组件 表输入:源表输入 文本文件输入:文本文件输入 xml文件输入:使用Get Data From XML组件,可以在其中使用xpath来选择数据 JsonInput:貌似在中文环境下组件面板里看不到,切换到英文模式就看到了 #常用输出组件 表输出:表输出 文本文件输出:文本文件输出 XML文件输出:输出的XML文件是按照记录行存储的,字段名为元素名 Excel文件输出:输出的excel文件是按照记录行存储的,字段名为元素名 删除:符合比较条件的记录将删除 更新:注意两个表都要有主键才可以 插入/更新:速度太慢,不建议使用 检查字段是否存在:若在则家一个标志位,值可以是Y/N 等值连接:有关联关系字段可以关联,其它的不关联。 笛卡尔连接:所有两边的记录交叉连接 write to log:把数据输出到控制台日志里,一般调试时很常用 空操作:很常用,比如过滤数据,未过滤走正常流程,滤除的数据就转向空操作。我喜欢在转换里用它做开始和结束之类需要分发或汇聚数据流的场景 #内置变量 Internal.Transformation.Name 当前转换的名字 Internal.Job.Name 当前job名字 Internal.Job.Filename.Name job的文件名 #需要修改的配置 在java8里-XX:MaxPermSize,-XX:PermSize已经去掉了,需要修改成-XX:MetaspaceSize 和 -XX:MaxMetaspaceSize 生产环境和开发环境使用不同的数据库连接 ~/.kettle/kettle.properties里设置key=value 在kettle.properties中添加变量,然后在类似数据库连接的地方可以用${key}来使用,这样可以实现开发环境和生产环境配置的差异,就算往资源库里提交也可以互不影响了 kettle分页问题 kettle循环分页 首先弄一个转换A,根据源表获取记录数,页数,每页记录数,然后写入系统变量,然后在job里调用转换A,再加一个转换B来迁移数据(其中查询sql要使用转换A生成的系统变量),最后在job里用一个javascript脚本来判断查询记录数是否是0,如果是0就走执行成功,否则就继续执行转换B。 最关键的是判断的js脚本,可以参考 var prevRow=previous_result.getRows();//获取上一个传递的结果,这种方案需要在转换B中将记录集复制为结果,如果记录集较多会造成内存溢出。就算在job里执行也是如此 完整代码: if (prevRow==null && prevRow.size()==0){ false; }else{ var startRow=parseInt(parent_job.getVariable("START_ROW", 0)); var pageSize=parseInt(parent_job.getVariable("PAGE_SIZE",1000)); startRow=startRow+pageSize; parent_job.setVariable("START_ROW", startRow); true; } kettle分页循环的更高效的改进方案 在转换里,每执行一次有个SUCC_COUNT环境变量就+1,在job中用js脚本判断成功数是否>=总记录数,是就终止循环,否就起始行+每页记录数,下面是代码 var startRow=parseInt(parent_job.getVariable("startrow")); var totalItemCount=parseInt(parent_job.getVariable("totalitemcount")); if (startRow >= totalItemCount){ false; }else{ true; } 对比前一种方案,改进方案一次迁移一万条数据没有压力,而且cpu稳定在20%以下。 参数和变量 全局变量参数 在kettle.properties中配置,通过获取环境变量组件来读取,一般用来做数据库连接配置等 位置参数(arguments参数) 最多支持10个,通过命令行参数的位置来区别,不是太好用 命名参数(named params) 通过 -param:name=value的方式设置参数,如果传多个参数需要 -param:name1:value1 -param:name2:value2 配置方法 在转换中双击空白处添加命名参数arg3,arg4,用的时候可以 ${arg3},${arg4}来使用,注意:如果不直接执行转换就不要配置转换命名参数(转换的命名参数和全局参数在调试时有时候会出现莫名其妙的冲突),建议使用全局参数来替代 在job中双击转换,切换到命名参数页,点击获取参数(arg3和arg4会出现到列表里)注意:在使用全局参数的时候这步可以省略 在job中双击空白处添加命名参数arg3,arg4,然后在调用kitchen.sh时通过 -param:arg3=abc -param:arg4=def来使用,注意:-param传递的命名参数一定要在job中事先定义才可以。 命名参数可以做变量使用,即${var}的方式来调用,如果是日期这样必须包含'的场景,可以用-param:date="2018-1-1 0:0:0"来表示,在sql里用'${var}'来表示 kitchen常用命令 命令行执行job(repository模式) ./kitchen.sh -listrep kitchen.sh -rep=<respository名字> -user=<respository登录用户名> -pass=<respository密码> -level=<日志级别> -job=<job名字> -logfile=<日志文件路径> kitchen.sh -rep=olpbdb01 -user=admin -pass=admin -level=Basic -dir=/demo1 -job=demo1 //会执行repository上 /demo1/demo1.kjb 命令行执行job(文件模式) kitchen.sh -file=/home/job/demo.kjb >> /home/job/log/demo.log 命令行执行转换(respository模式) pan.sh -rep=mysql -user=admin -pass=admin -dir=/fixbug -trans=f_loan_update -level=Basic -logfile=/data/kettle.log 命令行执行转换(文件模式) pan.sh -file /data/kettle/demo1/t_test_rep_mysql.ktr 三种增量同步的模式 时间戳增量同步:表中增加一个时间戳字段,每次更新值查询update_time>上次更新时间的记录。优点速度快,实现简单,缺点是对数据库有侵入性,对于业务系统也需要更新时间戳,增加了复杂性。 触发器增量同步:使用触发器来监控数据变化,对数据库有侵入性并且实现难度较大 全表增量同步:主要是用合并记录来比对,优点是数据库侵入较小,实现简单,缺点是性能较差。 个人观点是全表比对要好一点,如果按照分页的方式的化,二十几万条数据20分钟可以全同步完成。但全表增量同步只适合对实时性要求不高的场景。 几个常用组件的用途 1.字段选择:比如上一步骤有10个字段,下一步骤需要对其中某个字段做处理,就用字段选择来选择那个字段。还有,如果要合并记录,也会在数据流中使用字段选择选择一下字段。还有就是字段选择自带删除字段和修改字段类型和格式的功能 2.写日志:在处理数据时用写日志组建来记录logger是个不错的方法。 3.Switch/Case:和合并记录配合使用可以实现增量的数据插入/更新和删除。用过滤记录也可以实现同样功能 4.表输出:实际就是向表里insert数据,里面有个[返回自动产生的关键字]功能很好用,相当与insert后立刻查询的到刚刚自增的ID,省去了一部查询操作。 5.更新,删除:和名字一个意思 6.空操作:这个也很有用。 7.记录集连接:类似sql中的join操作,把两个数据流的字段(类型相同,列数相同,位置相同且已经排序过)拼合到一起。 8.分组:类似sql里的group by,构成分组的字段是分组条件(如果没有组可分但又要把每一行的数据都拼成一个串,可以不设置分组条件),聚合部分的字段是类似在select部分需要用聚合函数处理的字段。在拼合in 条件时很有用。 9.javascript脚本:这个不好用,能不用就不要用了。javascript组件支持将js变量转成输出字段。注意在转换里js脚本是每行执行一次。 10.获取变量:如果有外部传入的命名参数或者有环境变量,最好获取变量是做为流程的起点来使用。 11.设置变量:把某个字段转成变量时可以用。 12.表输入 12.1.一般提供一个复杂的sql查询,而且如果表输入需要参数,那么前一步骤一定是个获取变量。 12.2.如果需要实现动态sql(即拼一个sql存入变量A,然后在表输入里执行${A}),必须用两个转换实现。 12.3.如果需要实现每行查询一次(尽量避免这样做,太慢),可以在表输入中选中从步骤插入数据,并勾选执行每一行,在表输入的前一个步骤使用选择选择表输入的参数,在表输入中用占位符?来表示字段选择中选择的字段。 12.4.如果有可能,尽量一次性的用表输入完成所有的各类计算,转换,排序,而尽量避免使用kettle自带组件,因为这样速度快。 13.映射 13.1.可以在转换里调用另一个转换,转换中通过映射输入规范来接收入参数(实际就是个表记录集,在输入规范里定义的都是字段),用映射输出规范来定义输出数据集。这样整个映射就可以作为一个步骤整合到一个转换里(有输入和输出)。映射可以实现转换流程逻辑的复用。 13.2..关于在同一个转换的不同步骤中先修改变量然后再获取变量(取得的是转换刚开始执行时的值)不正确的问题,官方是这样解释的,在转换开始时会有一些变量初始化,初始化之后一些转换中的步骤并不是顺次执行的,所以无法做到同一个转换中在一个步骤。对于这种情况需要拆成两个抓换,先定义和初始化变量,然后再另一个转换中获取变量,需要注意的是,如果是转换中定义变量在子映射的获取的话也是不行的。 14.执行结果里面的Preview data非常好用,可以跑起来查看每个步骤的处理结果,如果发现一个步骤有数据,下一个步骤没数据了,那么可能是有问题了。 15.对于执行时有错误的情况,最好采用一张表来存储执行除错的数据,这对于无人职守迁移数据很重要。可以做成一个子转换来实现功能的复用。 16.对于javascript的调试,最好使用第三方的js开发工具来做,kettle自带的js编辑器太垃圾了。 17.合并记录时总是报NullPointerException,原因是合并记录的两个来源可能有不存在的情况,也可能是两个数据来源的排序不一致 18.转换的配置里的日志可以在线上部署的时候先禁用掉,有问题的时候可以再打开(通过点击连接线) kettle的最佳实践 启动时 kettle不能加入到PATH里去,加了执行 kitchen.sh -listrep找不到资源库 在~/.kettle里有重要的kettle.properties和repositories.xml文件,服务器部署的时候需要拷贝上去 spoon图形界面一般用来调试,跑多条数据会很慢 个人认为文件模式比repository模式好用点,repository模式总是莫名其妙的出问题,并且repository无法保留变更历史,但文件模式+git就可以做到 Unable to get module class path. (java.lang.RuntimeException: Unable to open JAR file, probably deleted: error in opening zip file) 需要删掉 <kettle_home>/system/karaf/caches/下的所有文件 启动时闪退时需要删掉~/.kettle/db.cache打头的文件就可以了。 防内存溢出和提高性能的处理办法 数据量较大时一定要使用分页机制,控制每个批次导入5000~10000 需要在分页循环中首先用一个独立的转换来计算出当前批次的用户ID数组,页码数量,总记录数以及维度表的数据,比如有日期维度表,那么就需要算出当前批次要处理的日期时间数组,最后把这些数据存入到全局变量里面去。这样在后续步骤就可以取出这些全局变量内容按照分页批次进行迁移了。 2.分页要通过一个表输入根据传入的每页记录数动态计算出总页数,并把总页数,总记录数存入全局变量,然后每处理一行计数器加1,截止条件就是总记录数<=处理过的记录数,从而实现的分页循环。 分页变量务必要通过命名参数-param来传递,这样在生产环境万一碰到了数据过大造成内存泄漏,可以通过参数快速调整 分页需要动态在模型中计算出页码数和总记录数,可以用个sql来搞定 select count(1) totalitemcount, round(CEIL(count(1)/${pagesize})) pagecount from table_name where create_time between unix_timestamp('${startdate}') and unix_timestamp('${enddate}') 之后的结果(totalitemcount,pagecount)用设置变量组件存入变量里就ok了 5. 注意数据量较大时不要使用记录复制到结果组件,不然一定会内存溢出 6. kettle的很多功能都有对应的纯sql实现方法,比如加字段,比如排序和空值的处理,纯sql的实现方式要比kettle的方式快很多,而且对内存的消耗也会小很多。 7. 可以设置几个变量来优化性能 KETTLE_MAX_LOG_SIZE_IN_LINES=5000 #内存里最多记录多少行日志 KETTLE_MAX_LOG_TIMEOUT_IN_MINUTES=1440 #kettle日志的保留时间,单位是分钟 KETTLE_MAX_JOB_ENTRIES_LOGGED=1000 #内存中保留多少实体返回结果日志 KETTLE_MAX_JOB_TRACKER_SIZE=1000 #内存里最多保留多少job跟踪记录 KETTLE_MAX_LOGGING_REGISTRY_SIZE=1000 #内存里记录多少实体 来优化内使用情况(在~/.kettle/kettle.properties里设置) 迁移模型的设计原则 整个模型必须是job+多个转换(除非是一次性工作可以没有job) job可以认为是表级处理(即一次处理多行,所有组件都是对于多行的处理组件),转换可以认为是行级处理(即一次处理一行,所有组件都是一次一行) 转换分两组,初始化变量用的转换(至少有一个,也可能有多个,主看是否有新变量,因为新变量无法在同一个转换里使用),和迁移数据用的转换(看情况,一般一个就够了) 命名参数的选择,即通过-param:varname=value的参数,一般需要有startdate,enddate,startrow,pagesize几个就够了 迁移的模式一般来说需要一个独立的转换根据日期区间计算出本次需要处理的业务ID数组(即先锁定该批次要处理交易),然后第二个转换根据事先锁定的交易ID数组提取出日期时间数组,用户ID数组,地区数组等。第三个转换再使用前面两步转换里提取的变量查询数据进行迁移 在迁移i数据时,数据流分成了新数据流(针对业务表)和旧数据流(针对事实/维度表),新数据流通过排序、分组、字段选择和连接数据集join起来,然后通过合并记录组件计算出每行记录的flagfield(new/changed/deleted/identical的评判结论),然后通过Switch/Case或过滤记录分别针对每种情况进行处理(调用表输出/更新/删除) 如果转换时涉及多个类别的数据要迁移到一张事实/维度表,不要拆成两组job,可以在一个job里依次调用一组转换,执行完一组再执行下一组,千万不要并行,因为设置的全局变量名字都一样,会出现冲突问题 变量的的使用 ${Internal.Entry.Current.Directory}/test.ktr可以表示当前目录下的test.ktr,同时适配repository模式和local文件模式 关于变量的使和编程语言中的变量不太一样,无法使用在同一个转换中定义和获取当前转换内修改过的变量,变通方法是拆成两个转换来使用,这问题卡了好几天才找到原因。 在job/转换通过-param:varname=value的方式传参时,如果发现变量无法解析,那么一定是job和转换的命名参数里没有配置(双击空白处,有个命名参数页签....) 在job/转换开始执行的时候通过日志输出一下用到的变量是个很好的习惯 作业和转换都要有命名参数startrow,pagesize,startdate,enddate几个,这样可以在调用的时候灵活控制分页以及起止时间,灵活实现全量和增量迁移 对变量冲突的问题要小心,特别是同一个job并行处理多个转换时更是如此,因此在job里并行执行转换时要格外小心。 写变量时有对变量作用域的设置,推荐设置成Valid in the root job,不推荐Valid in the Java Virtual Matchine。 表输入的处理 表输入有个功能,可以每行都执行一次查询,这个功能不要用,太慢对内存占用很高。 推荐使用记录集连接的方法,比如A,B,C三个表要通过外键拼接在一起插入到D表中,那么可以A,B,C三个表分别通过表输入查询出来,然后通过连接记录集拼接到一起做为新数据(排序、字段对齐、类型要一致),然后查询出D表做为老数据(排序、字段对齐、类型要一致),然后通过合并记录的方式对比新老数据,并根据flagfield的四个状态值(new/update/delete/identical)来通过Switch/Case组件分别处理插入/更新/删除和无变化四种情况。处理完成后,记得startrow要加一,这样做会显著提升迁移性能。 表输入最好选中忽略插入错误选项并且设置自动产生的关键字字段名称,并且在下一步骤用Switch/Case判断下这个自动产生的关键字字段的内容是否是null,不这样做,当插入出错时(不会在表输出步骤报错),错误会在表输出的下一步骤报错。 全量和增量迁移 全量迁移和增量迁移做到一起可以通过合并记录+Switch/Case来判断flagfied的值分别实现对应的插入/更新/删除/无变化四种类型的数据处理。千万不要将全量迁移和增量迁移分开,维护工作量太大了 映射功能 映射功能可以提升整个模型的复用度,映射中的输入就是外部查询的业务数据(不同的业务数据sql不同,但对于初始化的维度数据必须一致),这样可以实现业务转换和通用转换的分离,极大的降低整个模型的复杂度和维护难度。 每个维度表要使用一个独立的转换(内部实现新增/修改/删除等功能),在事实表中调用维度表转换(每个维度字段都要对应一个转换)在业务模型查询出本页里面需要处理的维度数据集,然后传入映射(子转换)并交由子转换(输入规范组件)做处理,每个子转换处理一个维度表,处理完的结果在子转换中通过映射输出规范组件输出到父模型里,然后父模型可以继续往下处理。 映射调试:首先输入数据用文本输出组件输出成A.txt,然后在映射中同时添加映射输入规范和文件输入(使用A.txt)通过点击连接禁用和启用输入规范和文件输入实现调试映射和在父转换中调试映射。 映射可以提升模型的复用度,比如类似日期处理,地区处理,用户处理这些一般都要抽取成可复用的模型,通过映射嵌入到别的模型里去,这样模型的层次比较清晰和简洁,而且不显得那么乱 映射时的变量我推荐勾选默认的“从父转换集成所有变量”,而不要每个转换里都定义,当子转换和父转换中的变量同名时很容易出现稀奇古怪的问题 映射偶尔会出现不返回数据的情况(重复执行可能又正常了,估计是kettle的bug),经过测试,在传参的上一步加一个文件输出会有改善(连接使用复制就可以) 模型调试 完整模型是由一个job,多个转换组成(转换也分成了业务转换和共用转换),执行迁移的时候通过job来执行(不要直接执行转换),从逻辑上只要关注全局变量的内容和转换的结果就可以了。这样对于调试来说效率较高。 整个完整的转换中,全局变量是统一的,主要包含startdate,enddate,pagesize,所有转换和job都使用这三个命名参数,在通过kitchen.sh执行时要通过-param传入这三个变量 某个共用转换需要另一个转换中的数据的时候,可以使用文件保存输出数据,然后在共用转换中用文件输入替代映射输入规范的输入参数 合并记录时的几个注意事项。 貌似kettle是用数据字段匹配的,关键字段必须可以唯一确定一条数据(类似联合唯一索引的作用,但不要选事实表主键),如果关键字段是空,那么合并的结果可能多条会合并成一条。数据字段是标识新旧数据需要比对哪些字段(也就是通过哪些字段来的到new/update/delete/identical的评判结论)。 合并记录时数据字段的多少并不影响合并后的结果。 合并记录最大的作用是对比两个数据流的数据变化,自动识别出需要插入/更新/删除和无变化的数据行,再配合Switch/Case组件分别实现insert、update和delete。 注意在合并记录中不能有更新时间,否则会出现很奇怪的结果 合并记录时需要注意一个是新旧数据源的排序必须相同,第二就是关键字和数据字段的选择,这两点做到了结果就是对的。 合并记录后某些记录的flagfield总是不正确(已经存在的数据flagfield是new,造成插入时唯一索引冲突),这说明前面步骤的排序方式不对 合并记录如果出现相同的两条数据flagfield一个是new另一个是deleted,那说明关键字定义的几个字段有差异 合并记录后处理更新和删除时条件部分选择合并记录的关键字保持一致 表输出的处理 表输出有个[返回一个自动产生的关键字]在insert后,可以将主键值自动获取到并填入到一个新字段,在后续的步骤可以通过给字段赋值来回写到主键字段,再通过字段选择移除这个临时生成的新字段,可以减少一次查询表的过程。 表输出时有个选项是忽略插入错误,这个一定要打开,但要有区分,一般唯一索引异常是要忽略掉的,但其余不能忽略,这个问题可以通过添加自定义错误来解决。 合并之前一定要用选择字段对新旧数据流里面的字段做一致化处理(元数据名字,类型,长度,精度,Binary to Normal)甚至字段的数量和顺序都要严格匹配 合并之前字段一定要排序,并且排序规则完全一致 合并记录后,flagfield=identical的记录主键会是0,这时候需要把老数据重新连接到合并之后的数据流就可以了(注意排序和字段名字) 异常处理 表输出异常,表输出是支持异常的,组件上右键菜单里选“定义错误处理”,可以设置错误列名,字段名,描述等信息,在后续步骤中可以使用过滤记录来做甄别,比如主键冲突错误要Contains Duplicate entry就忽略掉异常,其余的错误就停止,这样可以提高容错性。 排序 很多组件都要实现对数据排序,比如分组、合并记录、连接数据集等,如果不排序会出现一些稀奇古怪的问题 有条件一定用sql排序,只有中间步骤没法使用sql排序的情况下才使用kettle自带的排序。 异常和报错 you're mixing rows with different storage types. Field [VISIT_NO String(13)<binary-string>] does not have the same storage type as field [VISIT_NO String(13)] 有两种办法,一种是两处数据流在查询的时候,字段类型不一致,可以在sql里做下cast转换解决。 另外一种是通过字段选择,在元数据页添加一致的类型(长度,格式,最重要的是Binary to Normal改成true) java.lang.NullPointerException: 这种一般是有合并记录步骤,需要两个输入步骤,但其中有的输入步骤不存在,就会报这个错 字段选择提示字段不存在,但字段明明存在: 因为在选择和修改页把字段修改了名字,在元数据页填修改后的新名字就不报错了 优化前后效果对比 优化前 里面有大量的每行查询一次的功能,一次迁移最多2000条,多了就内存溢出 全量迁移一次要2天 全量和增量迁移是分开的,修改起来很罗嗦 没有使用变量,limit限制条件都是写死的,每次执行都要先调整模型的limit参数 没有使用子转换,模型间没有复用,模型都是复制来复制去,很容易出错 缺少异常处理 优化后 增加命名参数,迁移的时候非常灵活 改用分页机制,每页数据量可以通过参数传递 将全量模型和增量模型整合在一起,通过时间参数来控制 将用户,时间,地区等复用度高的模型写成了子转换,通过映射的方式提高模型复用度,极大的简化了模型。 有异常处理,同时对插入数据做了容错(索引冲突不报错,认为是成功) 增加了完善的数据调试机制 优化后每次迁移可以5000~10000条(通过参数设置,如果中间出错还可以从上次断开的地方继续迁移),自动全量迁移,相同的数据量迁移一次只要1小时就搞定。

优秀的个人博客,低调大师

百度AI智能学习

春色将阑,莺声渐老,红英落尽青梅小。画堂人静雨蒙蒙,屏山半掩余香袅。 密约沉沉,离情杳杳,菱花尘满慵将照。倚楼无语欲销魂,长空黯淡连芳草。 首先安装python包 pip3 install baidu-aip 再注册百度AI得到相关参数 https://ai.baidu.com/ 一、语音合成 from aip import AipSpeech APP_ID = '14446020' API_KEY = 'GnaoLWrIiTKP10disiDHMiNZ' SECRET_KEY = 'FYaMNBsH5NFsgWcRsyBfaHDV70MvvE6u' #实例化AipSpeech对象 client = AipSpeech(APP_ID, API_KEY, SECRET_KEY) #调用方法语音合成 result = client.synthesis("欢迎来到王者荣耀", options={ "per": 1, "spd": 9, "pit": 9, "vol": 15, }) if not isinstance(result, dict): with open('auido.mp3', 'wb') as f: f.write(result) 二、语音识别 from aip import AipSpeech import os APP_ID = '14446020' API_KEY = 'GnaoLWrIiTKP10disiDHMiNZ' SECRET_KEY = 'FYaMNBsH5NFsgWcRsyBfaHDV70MvvE6u' client = AipSpeech(APP_ID, API_KEY, SECRET_KEY) def get_file_content(filePath): cmd_str = f"ffmpeg -y -i {filePath} -acodec pcm_s16le -f s16le -ac 1 -ar 16000 {filePath}.pcm" os.system(cmd_str) with open(f"{filePath}.pcm", 'rb') as fp: return fp.read() res = client.asr(speech=get_file_content("auido.mp3"),options={ "dev_pid":1536, }) print(res["result"][0]) 这里用到一个格式转换的软件,百度地址:https://pan.baidu.com/s/1MadxSh-A0Pzo1Su_wKdktQ 提取码:x5xi 固定的格式转换命令:(需要将bin文件添加环境变量,在cmd中执行) ffmpeg -y -i filePath -acodec pcm_s16le -f s16le -ac 1 -ar 16000 filePath.pcm 三、短文本相似度 from aip import AipNlp APP_ID = '14446020' API_KEY = 'GnaoLWrIiTKP10disiDHMiNZ' SECRET_KEY = 'FYaMNBsH5NFsgWcRsyBfaHDV70MvvE6u' client = AipNlp(APP_ID,API_KEY,SECRET_KEY) ret = client.simnet("你今年几岁了?","多大年龄了?") print(ret) {'log_id': 4545309161914786697, 'texts': {'text_2': '多大年龄了?', 'text_1': '你今年几岁了?'}, 'score': 0.742316} score 是两个测试的短文本相似度,一般大于0.72的两个短文本的意思是相似的句子! 四、代码实现对接图灵 import requests def tuling_test(question): url = "http://openapi.tuling123.com/openapi/api/v2" data = { "reqType":0, "perception": { "inputText": { "text": question }, "inputImage": { }, }, "userInfo": { "apiKey": "2f4e809b8b3049ce82a6b4787bad65bb", "userId": "wangjifei" } } return requests.post(url=url,json=data).json() ret = tuling_test("心情不好") print(ret.get("results")[0]["values"]["text"]) 五、简单实现人机交流 基本步骤: 用户录制音频---传入函数---格式转化---语音识别---匹配答案---语音合成---语音文件流写入文件---os执行文件---删除文件 from aip import AipSpeech from aip import AipNlp from uuid import uuid4 import os import requests import time APP_ID = '14446007' API_KEY = 'QrQWLLg5a8qld7Qty7avqCGC' SECRET_KEY = 'O5mE31LSl17hm8NRYyf9PwlE5Byqm0nr' client = AipSpeech(APP_ID, API_KEY, SECRET_KEY) nlp_client = AipNlp(APP_ID, API_KEY, SECRET_KEY) def tuling_test(question): """接入图灵,为问题匹配答案""" url = "http://openapi.tuling123.com/openapi/api/v2" data = { "reqType": 0, "perception": { "inputText": { "text": question }, "inputImage": { }, }, "userInfo": { "apiKey": "2f4e809b8b3049ce82a6b4787bad65bb", "userId": "wangjifei" } } ret = requests.post(url=url, json=data).json() return ret.get("results")[0]["values"]["text"] def get_file_content(filePath): """音频的格式转换""" cmd_str = f"ffmpeg -y -i {filePath} -acodec pcm_s16le -f s16le -ac 1 -ar 16000 {filePath}.pcm" os.system(cmd_str) with open(f"{filePath}.pcm", 'rb') as fp: return fp.read() def custom_reply(text): """根据问题得到相应的答案,可以通过短文本相似来自定义,也可以调用图灵问题库""" if nlp_client.simnet("你叫什么名字", text).get("score") >= 0.72: return "我不能告诉你" return tuling_test(text) def learn_say(file_name): """机器人学说话""" # 语音识别成文字 res = client.asr(speech=get_file_content(file_name), options={ "dev_pid": 1536, }) os.remove(f"{file_name}.pcm") text = res.get("result")[0] # 根据问题得到相关答案 text1 = custom_reply(text) # 答案语音合成 res_audio = client.synthesis(text1, options={ "vol": 8, "pit": 8, "spd": 5, "per": 4 }) # 通过uuid 生成文件名 ret_file_name = f"{uuid4()}.mp3" # 将生成的语音流写入文件中 with open(ret_file_name, "wb") as f: f.write(res_audio) # 执行音频文件 ret = os.system(ret_file_name) time.sleep(2) os.remove(ret_file_name) if __name__ == '__main__': learn_say("auido.m4a") 六、网页版智能机器人对话 flask_ws.py from flask import Flask, request, render_template from uuid import uuid4 from geventwebsocket.websocket import WebSocket from gevent.pywsgi import WSGIServer from geventwebsocket.handler import WebSocketHandler from learn_say import learn_say app = Flask(__name__) # type:Flask @app.route("/ws") def ws(): user_socket = request.environ.get("wsgi.websocket") # type:WebSocket while True: msg = user_socket.receive() q_file_name = f"{uuid4()}.wav" with open(q_file_name, "wb") as f: f.write(msg) ret_file_name = learn_say(q_file_name) user_socket.send(ret_file_name) if __name__ == '__main__': http_serv = WSGIServer(("127.0.0.1", 8006), app, handler_class=WebSocketHandler) http_serv.serve_forever() flask_app.py from flask import Flask, request, render_template, send_file app = Flask(__name__) # type:Flask @app.route("/index") def index(): return render_template("index.html") @app.route("/get_audio/<audio_name>") def get_audio(audio_name): return send_file(audio_name) if __name__ == '__main__': app.run("127.0.0.1", 8008, debug=True) learn_say.py from aip import AipSpeech from aip import AipNlp from uuid import uuid4 import os import requests import time APP_ID = '14446007' API_KEY = 'QrQWLLg5a8qld7Qty7avqCGC' SECRET_KEY = 'O5mE31LSl17hm8NRYyf9PwlE5Byqm0nr' client = AipSpeech(APP_ID, API_KEY, SECRET_KEY) nlp_client = AipNlp(APP_ID, API_KEY, SECRET_KEY) def tuling_test(question): """接入图灵,为问题匹配答案""" url = "http://openapi.tuling123.com/openapi/api/v2" data = { "reqType": 0, "perception": { "inputText": { "text": question }, "inputImage": { }, }, "userInfo": { "apiKey": "2f4e809b8b3049ce82a6b4787bad65bb", "userId": "wangjifei" } } ret = requests.post(url=url, json=data).json() return ret.get("results")[0]["values"]["text"] def get_file_content(filePath): """音频的格式转换""" cmd_str = f"ffmpeg -y -i {filePath} -acodec pcm_s16le -f s16le -ac 1 -ar 16000 {filePath}.pcm" os.system(cmd_str) with open(f"{filePath}.pcm", 'rb') as fp: return fp.read() def custom_reply(text): """根据问题得到相应的答案,可以通过短文本相似来自定义,也可以调用图灵问题库""" if nlp_client.simnet("你叫什么名字", text).get("score") >= 0.72: return "我不能告诉你" return tuling_test(text) def learn_say(file_name): """机器人学说话""" # 语音识别成文字 res = client.asr(speech=get_file_content(file_name), options={ "dev_pid": 1536, }) os.remove(file_name) os.remove(f"{file_name}.pcm") text = res.get("result")[0] # 根据问题得到相关答案 text1 = custom_reply(text) # 答案语音合成 res_audio = client.synthesis(text1, options={ "vol": 8, "pit": 8, "spd": 5, "per": 4 }) # 通过uuid 生成文件名 ret_file_name = f"{uuid4()}.mp3" # 将生成的语音流写入文件中 with open(ret_file_name, "wb") as f: f.write(res_audio) return ret_file_name index.html <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Title</title> </head> <body> <audio src="" autoplay controls id="player"></audio> <button onclick="start_reco()">录制消息</button> <br> <button onclick="stop_reco()">发送语音消息</button> </body> <script src="/static/Recorder.js"></script> <script type="application/javascript"> var serv = "http://127.0.0.1:8008"; var ws_serv = "ws://127.0.0.1:8006/ws"; var get_music = serv + "/get_audio/"; var ws = new WebSocket(ws_serv); ws.onmessage = function (data) { document.getElementById("player").src = get_music + data.data }; var reco = null; var audio_context = new AudioContext(); navigator.getUserMedia = (navigator.getUserMedia || navigator.webkitGetUserMedia || navigator.mozGetUserMedia || navigator.msGetUserMedia); navigator.getUserMedia({audio: true}, create_stream, function (err) { console.log(err) }); function create_stream(user_media) { var stream_input = audio_context.createMediaStreamSource(user_media); reco = new Recorder(stream_input); } //录制消息 function start_reco() { reco.record(); } //先停止录制,再获取音频 function stop_reco() { reco.stop(); get_audio(); reco.clear(); } //获取音频,发送音频 function get_audio() { reco.exportWAV(function (wav_file) { // wav_file = Blob对象 ws.send(wav_file); }) } </script> </html>

优秀的个人博客,低调大师

15.Swift学习之枚举

枚举介绍 概念介绍 枚举定义了一个通用类型的一组相关的值,可以在代码中以一个安全的方式来使用这些值 Swift中的枚举是一等类型, 它可以像类和结构体一样增加属性和方法 在 C/OC 语言中枚举指定相关名称为一组整型值,而Swift 中的枚举更加灵活 不必给每一个枚举成员提供一个值 Swift 中的枚举可以提供的值类型有:字符串,字符,整型值,浮点值等 枚举类型的语法 使用enum关键词并且把它们的整个定义放在一对大括号内 enum SomeEnumeration { // enumeration definition goes here } enum Method{ case Add case Sub case Mul case Div } let selectMethod = Method.Sub switch (selectMethod){ case Method.Add: print("加法") case Method.Sub: print("减法") case Method.Mul: print("除法") case Method.Div: print("乘法") default: print("都不是") } 枚举的定义 定义方式一 case关键词表明新的一行成员值将被定义 不像 C 和 Objective-C 一样,Swift 的枚举成员在被创建时不会被赋予一个默认的整数值 下面的例子中,North,South,East和West不是隐式的等于0,1,2和3 enum CompassPoint { case North case South case East case West } 定义方式二:多个成员值可以出现在同一行上 enum CompassPoint { case North, South, East,West } 枚举赋值 枚举类型赋值可以是字符串/字符/整型/浮点型 如果有给枚举类型赋值,则必须在枚举类型后面明确说明具体的类型 enum CompassPoint : Int { case North = 1 case South = 2 case East = 3 case West = 4 } enum CompassPoint : Double { case North = 1.0 case South = 2.0 case East = 3.0 case West = 4.0 } enum CompassPoint : String { case North = "North" case South = "South" case East = "East" case West = "West" } 枚举类型推断 前面的例子中,在使用枚举的时候,是通过枚举.值的形式来访问的,其实由于Swift的类型推断非常强大,如果枚举类型确定了,在访问值的时候可以用.值的形式来访问 enum Method { case Add case Sub case Mul case Div func method(){ } } //已经明确a是一个Method类型 后面访问可以简写 let a:Method = .Add let selectMethod = Method.Sub switch (selectMethod){ case .Add: print("加法") case .Sub: print("减法") case .Mul: print("除法") case .Div: print("乘法") default: print("都不是") } 枚举的原始值 C/OC中枚举的本质就是整数,所以C/OC中的枚举是有原始值的,默认是从0开始,而Swift中的枚举默认是没有原始值的, 但是可以在定义时告诉系统让枚举有原始值 注意: 原始值区分大小写 通过rawValue可以获取原始值 通过rawValue返回的枚举是一个可选型,因为原始值对应的枚举值不一定存在 如果想指定第一个元素的原始值之后,后面的元素的原始值能够默认+1 , 枚举一定是 Int 类型 enum Planet:Int { case Mercury = 1, Venus, Earth, Mars, Jupiter, Saturn, Uranus, Neptune } let planet:Planet = .Mars //打印4 print(planet.rawValue) //p是一个可选型 let p = Planet(rawValue: 3) if let p = p { switch p { case .Mercury: print("Mercury") case .Venus: print("Venus") case .Earth: print("Earth") case .Mars: print("Mars") case .Jupiter: print("Jupiter") case .Saturn: print("Saturn") case .Uranus: print("Uranus") case .Neptune: print("Neptune") } }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册