首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

python算法学习笔记1

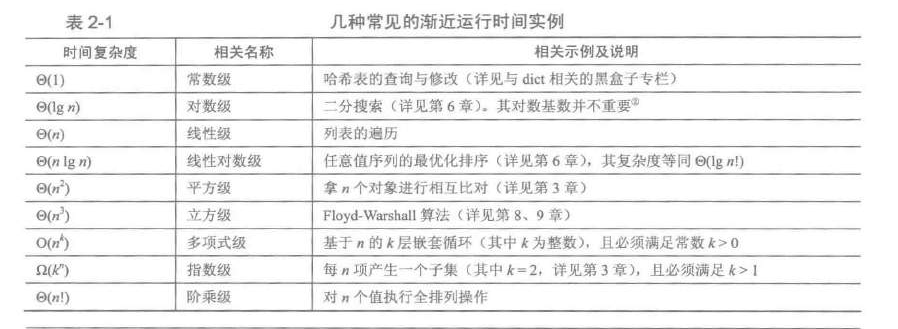
python中array 是一整块单一连续的内存区域,根据索引值访问的话可以直接计算出目标元素在内存中的位置,对于链表要从头开始遍历链表插入代价小,数值插入代价大,要移动右边所有的元素这边的数组指动态数组复杂度O 构建排序算法之前先对序列进行检查,如果目标已经排过序则直接返回 def sort_w_check(): n=len(seq) for i in range(n-1): if seq[i] >seq[i+1]: break else: return .... 排序的三种情况:1.最好情况,已经排好序,线性时间2.最坏情况3.平均情况,期望时间算法评估:用timeit模块 import timeit t1=timeit.timeit("x=2+2") print(t1) t2=timeit.timeit("x=sum(range(10))") print(t2) 计算时间,但对于多次迭代时timeit会通过多次运行相关代码的方式来提高计时精度图结构:图的要点主要包括: 散列(hashing)可以通过python中的hash函数提供 print(hash("hello,world!")) print(hash("Hello,world!")) python中字典类型dict就是常说的散列表,集合类型也是通过这种机制完成的,对于散列的访问平局时间为O(1),最坏为O(n)邻接列表及类似的结构示意图 示意图转换为邻接集表示方法 a,b,c,d,e,f,g,h=range(8) N=[ {b,c,d,e,f}, {c,e}, {d}, {e}, {f}, {c,g,h}, {f,h}, {f,g} ] 加权的邻接列表 a,b,c,d,e,f,g,h=range(8) N=[ {b:2,c:1,d:3,e:9,f:4}, {c:4,e:3}, {d:8}, {e:7}, {f:5}, {c:2,g:2,h:2}, {f:1,h:6}, {f:9,g:8} ] 邻接集的字典表示法: N={ 'a':set('bcdef'), 'b':set('ce'), 'c':set('d'), 'e':set('e'), 'f':set('cgh'), 'g':set('fh'), 'h':set('fg') } 树二叉树 class Tree(object): """docstring for Tree""" def __init__(self, left,right): self.left=left self.right=right t=Tree(Tree("a","b"),Tree("c","d")) print(t.right.left) 多路搜索树 class True: def __init__(self,kids,next=None): self.kids=self.val=kids self.next=next t=Tree(Tree("a",Tree("b",Tree("c",Tree("d"))))) print(t.kids.next.next.val) 隐性平方级操作例子 import time from random import randrange L=[randrange(10000) for i in range(1000)] t1=time.time() print(42 in L) t2=time.time() print(t2-t1) S=set(L) t3=time.time() print(42 in S) t4=time.time() print(t4-t3) 对list的搜索是线性数量级的,set的搜索是常数级的

优秀的个人博客,低调大师

Elasticsearch学习笔记(一)之what?

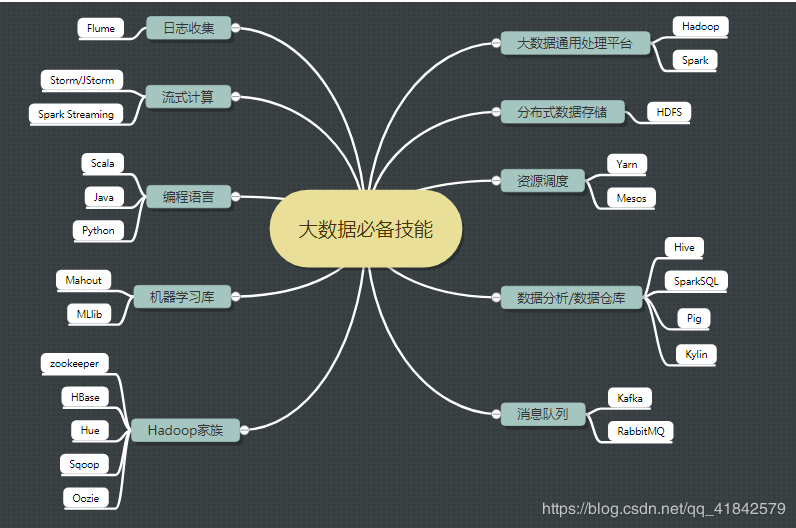
一句话介绍 Elasticsearch 是一个分布式、RESTful 风格的搜索和数据分析引擎,能够解决不断涌现出的各种用例。作为 Elastic Stack 的核心,它集中存储您的数据,帮助您发现意料之中以及意料之外的情况。---摘自官方文档 他的父亲 Elasticsearch 的前世或者父亲应该可以说是Lucene。它是基于Java开发并且开源,目前被认为性能最好的全文检索引擎,但是它并不能直接拿来用或是对外提供服务。它本质上只是一个工具包,需要对它进行二次封装。目前基于Lucene组件的全文搜索应用有两个:Solr和Elasticsearch 。 他的兄弟 他的老大哥solr也是基于Lucene,2007发布第一版,作为企业级应用的全文检索服务,solr曾经也是风云一时。2010年,一个程序员为让他的妻子能够方便检索菜谱而开发的全文搜索服务横空出世,顺应大数据时代的潮流,他以其分布式,大数据量方面的处理优势迅速占领一席之位。Elasticsearch发展至今风头甚至可以说已经盖过了他曾经的老大哥solr。 兄弟PK 那么,到底是选择 Solr 还是 Elasticsearch?有时很难找到明确的答案。无论您选择 Solr 还是 Elasticsearch,首先需要了解正确的用例和未来需求,总结它们的每个属性。 记住下面这些要点: 由于易于使用,Elasticsearch 在新开发者中更受欢迎。但是,如果您已经习惯了与 Solr 合作,请继续使用它,因为迁移到 Elasticsearch 没有特定的优势。如果除了搜索文本之外还需要它来处理分析查询,Elasticsearch 是更好的选择。如果需要分布式索引,则需要选择 Elasticsearch。对于需要良好可伸缩性和性能的云和分布式环境,Elasticsearch 是更好的选择。两者都有良好的商业支持(咨询,生产支持,整合等)。两者都有很好的操作工具,尽管 Elasticsearch 因其易于使用的 API 而更多地吸引了 DevOps 人群,因此可以围绕它创建一个更加生动的工具生态系统。Elasticsearch 在开源日志管理用例中占据主导地位,许多组织在 Elasticsearch 中索引它们的日志以使其可搜索。虽然 Solr 现在也可以用于此目的,但它只是错过了这一想法。Solr 仍然更加面向文本搜索。另一方面,Elasticsearch 通常用于过滤和分组,分析查询工作负载,而不一定是文本搜索。Elasticsearch 开发人员在 Lucene 和 Elasticsearch 级别上投入了大量精力使此类查询更高效(降低内存占用和 CPU 使用)。因此,对于不仅需要进行文本搜索,而且需要复杂的搜索时间聚合的应用程序,Elasticsearch 是一个更好的选择。Elasticsearch 更容易上手,一个下载和一个命令就可以启动一切。Solr 传统上需要更多的工作和知识,但 Solr 最近在消除这一点上取得了巨大的进步,现在只需努力改变它的声誉。在性能方面,它们大致相同。我说“大致”,因为没有人做过全面和无偏见的基准测试。对于 95% 的用例,任何一种选择在性能方面都会很好,剩下的 5% 需要用它们的特定数据和特定的访问模式来测试这两种解决方案。从操作上讲,Elasticsearch 使用起来比较简单,它只有一个进程。Solr 在其类似 Elasticsearch 的完全分布式部署模式 SolrCloud 中依赖于 Apache ZooKeeper,ZooKeeper 是超级成熟,超级广泛使用等等,但它仍然是另一个活跃的部分。也就是说,如果您使用的是 Hadoop,HBase,Spark,Kafka 或其他一些较新的分布式软件,您可能已经在组织的某个地方运行 ZooKeeper。虽然 Elasticsearch 内置了类似 ZooKeeper 的组件 Xen,但 ZooKeeper 可以更好地防止有时在 Elasticsearch 集群中出现的可怕的裂脑问题。公平地说,Elasticsearch 开发人员已经意识到这个问题,并致力于改进 Elasticsearch 的这个方面。如果您喜欢监控和指标,那么使用 Elasticsearch,您将会进入天堂。这个东西比新年前夜在时代广场可以挤压的人有更多的指标!Solr 暴露了关键指标,但远不及 Elasticsearch 那么多。总之,两者都是功能丰富的搜索引擎,只要设计和实现得当,它们或多或少都能提供相同的性能。

优秀的个人博客,低调大师

Android底层学习之Linux基础

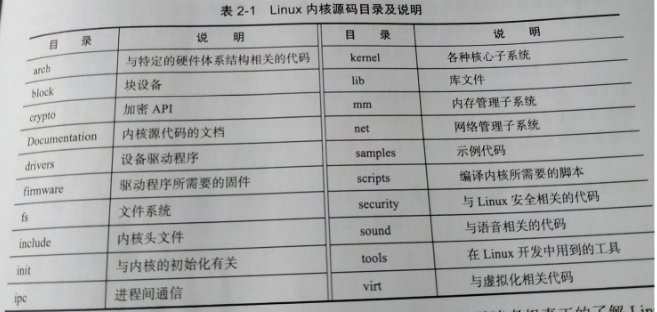
1、Linux系统是一种类UNIX的操作系统,开源 2、基本命令 2.1 打开终端 Ctrl+Alt+T,或者按住Alt键,然后在光标提示处输入terminal,按回车键即可 2.2 目录操作 cd dir:change directory 切换、进入目录 pwd:查看当前所在目录 cd -:对已切换过的目录进行恢复操作,即返回到切换前目录 cd ..:切换到包含当前目录的上层目录 ls: 显示目录内容 2.3 文件操作 touch file:创建一个文件 mkdir dir:创建一个目录 rm file: 删除一个文件 rm -r dir:删除一个目录 rmdir: 删除一个目录 cp file file_copy:复制文件 mv file file_move:移动文件 find / -name filename:查找文件,find可能因用户权限出现permission denied无法查到到查找出来文件 find ./ -name 'filename' awk: 查找如在文件中查找 awk '/set/' vivado.log 打印出vivado.log文件中所包含set的行的内容。 vim使用:linux上文件本机工具,可通过sudo apt-get install vim安装,新建个文件myfile,使用vim myfile后按回车进入编辑模式,在编辑器中输入i或者a进入编辑模式,屏幕左下角有INSERT提示即表示可编辑 3、shell脚本 同windows中bat脚本一样,shell脚本是将一系列命令写到一个文件中,并赋予这个文件可执行的权限,可执行权限不能执行,则试试使用: chmod a+x myfile 4、Linux源码与Android源码介绍

优秀的个人博客,低调大师

python模块学习之glob模块

glob模块 功能描述:glob模块可以使用Unix shell风格的通配符匹配符合特定格式的文件和文件夹,跟windows的文件搜索功能差不多。glob模块并非调用一个子shell实现搜索功能,而是在内部调用了os.listdir()和fnmatch.fnmatch()。查看我之前写的fnmatch。 glob模块共包含以下3个函数:glob,isglob和escape。 glob(pathname, recursive=False) 第一个参数为需要匹配的字符串.(尽量在字符串前加r) 第二个参数代表递归调用,与特殊通配符“**”一同使用,默认为False。 路径格式可以是绝对路径 /usr/src/Python-1.5/Makefile ,也可以是相对路径../../Tools//.gif。 在3.5版本之后,glob函数支持一个特殊的通配符“**”,该通配符可以匹配指定路径里所有文件和目录,包括子目录里的所有文件和目录。使用这个通配符必须加上recursive=True参数。 (在有复杂目录结构的情况下使用该通配符可能会导致性能下降,拖累整个程序的运行,需谨慎使用!) 例如,目录中包含文件: 1.gif, 2.txt, card.gif里面含有子目录sub,sub目录里含有3.txt. >>>importglob>>>glob.glob('./[0-9].*') ['./1.gif','./2.txt']>>>glob.glob('*.gif') ['1.gif','card.gif']>>>glob.glob('?.gif') ['1.gif']>>>glob.glob('**/*.txt',recursive=True) ['2.txt','sub/3.txt']>>>glob.glob('./**/',recursive=True) ['./','./sub/'] 需要注意的是如果,文件名的前面含有点像这样,card.gif 和.card.gif,需要下面这样的方式处理通配符前加. >>>importglob>>>glob.glob('*.gif') ['card.gif']>>>glob.glob('.*.gif') ['.card.gif'] iglob(pathname, recursive=False) 参数与glob()一致。 返回一个迭代器,遍历该迭代器的结果和glob()的返回结果一致。 escape(pathname) 转义所有的特殊字符('?','*'和'['])。如果您想匹配任意可能包含特殊字符的字符串,这将非常有用。驱动器/ UNC共享点中的特殊字符不会转义,例如在Windows系统上 escape('//?/c:/Quo vadis?.txt') 将返回 '//?/c:/Quo vadis[?].txt'。但是这些非法字符是无法创建文件的所以一般也就用来测试用了。

优秀的个人博客,低调大师

Golang学习笔记之方法(method)

法总是绑定对象实例,并隐式将实例作为第⼀实参 (receiver)。• 只能为当前包内命名类型定义⽅法。• 参数 receiver 可任意命名。如⽅法中未曾使⽤,可省略参数名。• 参数 receiver 类型可以是 T 或 *T。基类型 T 不能是接⼝或指针。• 不⽀持⽅法重载, receiver 只是参数签名的组成部分。• 可⽤实例 value 或 pointer 调⽤全部⽅法,编译器⾃动转换。• Go 不允许同名函数,但是同名方法可以定义在不同的类型上• method和receiver必须在同一个包里定义• 作为函数参数,值类型就是值类型,指针类型就是指针类型• 方法有一个值类型和指针类型的接受者时,都可以直接调用,内部会自动进行语法的转换。 一个方法只是一个函数,它有一个特殊的接收者(receiver)类型,该接收者放在 fu

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册