首页 文章 精选 留言 我的

精选列表

搜索[轻量版],共10000篇文章
优秀的个人博客,低调大师

Mybatis迷你版--QueryObjectFactory

今天在看JDBC4.2新规范,然后无意之间就碰到了这个东西QueryObjectFactory, 市面上orm框架有很多,在这里我就不一一列举了。那么今天我来记录一下QueryObjectFactory。官网地址:点这里 一、快速入门 1、将下载好的jar包加入项目 2、我们利用一下jdbc4.0的规范在项目中建立如下文件 在这里我们指定要加载的驱动:com.mysql.jdbc.Driver 3、编写接口: package com.bdqn.lyrk.java.study; import sf.qof.BaseQuery; import sf.qof.Insert; import sf.qof.Query; import java.util.List; public interface StudentDao extends BaseQuery { @Query(sql = "select stuName {%%.stuName},id {%%.id} from student_0") List<StudentEntity> listStudents(); @Insert(sql = "INSERT INTO student_0 (id,stuName,password) values({%1.id},{%1.stuName},{%1.password})") void save(List<StudentEntity> studentEntities); } View Code 这里面我们使用注解的方式配置SQL语句。在这里{}表示占位符,{%%.属性} 通常用于设置查询结果对应的对象属性上,{%1} 通常代表方法内的参数 4、Main方法 package com.bdqn.lyrk.java.study; import sf.qof.QueryObjectFactory; import sf.qof.dialect.HSQLDbDialect; import java.sql.Connection; import java.sql.DriverManager; import java.sql.SQLException; import java.util.ArrayList; import java.util.List; public class Main { public static void main(String[] args) throws SQLException { Connection connection = DriverManager.getConnection("jdbc:mysql://localhost:3306/MySchool?characterEncoding=utf-8&useSSL=false", "root", "xxx"); StudentDao studentDao = QueryObjectFactory.createQueryObject(StudentDao.class); QueryObjectFactory.setSQLDialect(new HSQLDbDialect()); studentDao.setConnection(connection); studentDao.setBatchSize(3); studentDao.listStudents().forEach(s -> System.out.println(s.getStuName())); List<StudentEntity> studentEntities = new ArrayList<>(); for (int i = 0; i < 5; i++) { StudentEntity studentEntity = new StudentEntity(); studentEntity.setId(i + 10); studentEntity.setStuName("test3"); studentEntity.setPassword("abcd"); studentEntities.add(studentEntity); } studentDao.save(studentEntities); } } View Code 执行成功后,拿到如下结果: 5、 设置参数的方式与坑 在这里面QueryFactory给我们设置了如下几种数据类型 registerResultMapper("string", AbstractCharacterMapping.StringMapping.class, AbstractCharacterMapping.StringMapping.getTypes()); registerResultMapper("char", AbstractCharacterMapping.CharacterMapping.class, AbstractCharacterMapping.CharacterMapping.getTypes()); registerResultMapper("boolean", AbstractNumberMapping.BooleanMapping.class, AbstractNumberMapping.BooleanMapping.getTypes()); registerResultMapper("byte", AbstractNumberMapping.ByteMapping.class, AbstractNumberMapping.ByteMapping.getTypes()); registerResultMapper("short", AbstractNumberMapping.ShortMapping.class, AbstractNumberMapping.ShortMapping.getTypes()); registerResultMapper("int", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerResultMapper("integer", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerResultMapper("long", AbstractNumberMapping.LongMapping.class, AbstractNumberMapping.LongMapping.getTypes()); registerResultMapper("float", AbstractNumberMapping.FloatMapping.class, AbstractNumberMapping.FloatMapping.getTypes()); registerResultMapper("double", AbstractNumberMapping.DoubleMapping.class, AbstractNumberMapping.DoubleMapping.getTypes()); registerResultMapper("date", AbstractDateTimeMapping.DateMapping.class, AbstractDateTimeMapping.DateMapping.getTypes()); registerResultMapper("time", AbstractDateTimeMapping.TimeMapping.class, AbstractDateTimeMapping.TimeMapping.getTypes()); registerResultMapper("timestamp", AbstractDateTimeMapping.TimestampMapping.class, AbstractDateTimeMapping.TimestampMapping.getTypes()); registerParameterMapper("string", AbstractCharacterMapping.StringMapping.class, AbstractCharacterMapping.StringMapping.getTypes()); registerParameterMapper("char", AbstractCharacterMapping.CharacterMapping.class, AbstractCharacterMapping.CharacterMapping.getTypes()); registerParameterMapper("boolean", AbstractNumberMapping.BooleanMapping.class, AbstractNumberMapping.BooleanMapping.getTypes()); registerParameterMapper("byte", AbstractNumberMapping.ByteMapping.class, AbstractNumberMapping.ByteMapping.getTypes()); registerParameterMapper("short", AbstractNumberMapping.ShortMapping.class, AbstractNumberMapping.ShortMapping.getTypes()); registerParameterMapper("int", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerParameterMapper("integer", AbstractNumberMapping.IntegerMapping.class, AbstractNumberMapping.IntegerMapping.getTypes()); registerParameterMapper("long", AbstractNumberMapping.LongMapping.class, AbstractNumberMapping.LongMapping.getTypes()); registerParameterMapper("float", AbstractNumberMapping.FloatMapping.class, AbstractNumberMapping.FloatMapping.getTypes()); registerParameterMapper("double", AbstractNumberMapping.DoubleMapping.class, AbstractNumberMapping.DoubleMapping.getTypes()); registerParameterMapper("date", AbstractDateTimeMapping.DateMapping.class, AbstractDateTimeMapping.DateMapping.getTypes()); registerParameterMapper("time", AbstractDateTimeMapping.TimeMapping.class, AbstractDateTimeMapping.TimeMapping.getTypes()); registerParameterMapper("timestamp", AbstractDateTimeMapping.TimestampMapping.class, AbstractDateTimeMapping.TimestampMapping.getTypes()); View Code 注意我们通过以下几种方式设置数据类型: {数据类型%1} 或者 {数据类型%%.属性的方式} 坑:注意以下关于日期数据类型代码: /* * Copyright 2007 brunella ltd * * Licensed under the LGPL Version 3 (the "License"); * you may not use this file except in compliance with the License. * * THIS SOFTWARE IS PROVIDED BY THE COPYRIGHT HOLDERS AND CONTRIBUTORS "AS IS" * AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE * IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE * ARE DISCLAIMED. IN NO EVENT SHALL THE COPYRIGHT OWNER OR CONTRIBUTORS BE * LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR * CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF * SUBSTITUTE GOODS OR SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS * INTERRUPTION) HOWEVER CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN * CONTRACT, STRICT LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) * ARISING IN ANY WAY OUT OF THE USE OF THIS SOFTWARE, EVEN IF ADVISED OF * THE POSSIBILITY OF SUCH DAMAGE. */ package sf.qof.mapping; import java.util.Date; import java.util.HashSet; import java.util.Set; public abstract class AbstractDateTimeMapping extends AbstractBaseMapping implements Mapping, ParameterMapping, ResultMapping { private static final Set<Class<?>> types = new HashSet<Class<?>>(); static { types.add(Date.class); } public static Set<Class<?>> getTypes() { return types; } public void accept(Mapper mapper, MappingVisitor visitor) { visitor.visit(mapper, this); } public abstract void accept(Mapper mapper, DateTimeMappingVisitor visitor); public static class DateMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } public static class TimeMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } public static class TimestampMapping extends AbstractDateTimeMapping { public void accept(Mapper mapper, DateTimeMappingVisitor visitor) { visitor.visit(mapper, this); } } } View Code 在静态代码块中所有的日期类型都对应的是java.util.Date ,因此我们不能用Timestamp或者java.sql.Date作为JavaBean的数据类型 二、总结与展望 1. 使用注解通常情况下适配一些比较简单的查询,复杂的查询不建议使用 2.这个适合于小型项目的迅速开发与上线,大型项目建议选择成熟的orm框架 3.虽然说select * 不建议使用的,但是如何解决select * 下映射关系?

优秀的个人博客,低调大师

spark基本操作 java 版

1.map算子 private static void map() { //创建SparkConf SparkConf conf = new SparkConf() .setAppName("map") .setMaster("local"); //创建JavasparkContext JavaSparkContext sc = new JavaSparkContext(conf); //构造集合 List<Integer> numbers = Arrays.asList(1,2,3,4,5); //并行化集合,创建初始RDD JavaRDD<Integer> numberRDD = sc.parallelize(numbers); //使用map算子,将集合中的每个元素都乘以2 JavaRDD<Integer> multipleNumberRDD = numberRDD.map(new Function<Integer, Integer>() { @Override public Integer call(Integer v1) throws Exception { return v1 * 2; } }); //打印新的RDD multipleNumberRDD.foreach(new VoidFunction<Integer>() { @Override public void call(Integer t) throws Exception { System.out.println(t); } }); //关闭JavasparkContext sc.close(); } 2.filter算子 private static void filter() { //创建SparkConf SparkConf conf = new SparkConf() .setAppName("filter") .setMaster("local"); //创建JavaSparkContext JavaSparkContext sc = new JavaSparkContext(conf); //模拟集合 List<Integer> numbers = Arrays.asList(1,2,3,4,5,6,7,8,9,10); //并行化集合,创建初始RDD JavaRDD<Integer> numberRDD = sc.parallelize(numbers); //对集合使用filter算子,过滤出集合中的偶数 JavaRDD<Integer> evenNumberRDD = numberRDD.filter(new Function<Integer, Boolean>() { @Override public Boolean call(Integer v1) throws Exception { return v1%2==0; } }); evenNumberRDD.foreach(new VoidFunction<Integer>() { @Override public void call(Integer t) throws Exception { System.out.println(t); } }); sc.close(); } 3.flatMap算子 Spark 中 map函数会对每一条输入进行指定的操作,然后为每一条输入返回一个对象; 而flatMap函数则是两个操作的集合——正是“先映射后扁平化”: 操作1:同map函数一样:对每一条输入进行指定的操作,然后为每一条输入返回一个对象 操作2:最后将所有对象合并为一个对象 private static void flatMap() { SparkConf conf = new SparkConf() .setAppName("flatMap") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<String> lineList = Arrays.asList("hello you","hello me","hello world"); JavaRDD<String> lines = sc.parallelize(lineList); //对RDD执行flatMap算子,将每一行文本,拆分为多个单词 JavaRDD<String> words = lines.flatMap(new FlatMapFunction<String, String>() { //在这里,传入第一行,hello,you //返回的是一个Iterable<String>(hello,you) @Override public Iterable<String> call(String t) throws Exception { return Arrays.asList(t.split(" ")); } }); words.foreach(new VoidFunction<String>() { @Override public void call(String t) throws Exception { System.out.println(t); } }); sc.close(); } 4.groupByKey算子 private static void groupByKey() { SparkConf conf = new SparkConf() .setAppName("groupByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<String, Integer>> scoreList = Arrays.asList( new Tuple2<String, Integer>("class1", 80), new Tuple2<String, Integer>("class2", 90), new Tuple2<String, Integer>("class1", 97), new Tuple2<String, Integer>("class2", 89)); JavaPairRDD<String, Integer> scores = sc.parallelizePairs(scoreList); //针对scoresRDD,执行groupByKey算子,对每个班级的成绩进行分组 //相当于是,一个key join上的所有value,都放到一个Iterable里面去了 JavaPairRDD<String, Iterable<Integer>> groupedScores = scores.groupByKey(); groupedScores.foreach(new VoidFunction<Tuple2<String,Iterable<Integer>>>() { @Override public void call(Tuple2<String, Iterable<Integer>> t) throws Exception { System.out.println("class:" + t._1); Iterator<Integer> ite = t._2.iterator(); while(ite.hasNext()) { System.out.println(ite.next()); } } }); } 5.reduceByKey算子 private static void reduceByKey() { SparkConf conf = new SparkConf() .setAppName("reduceByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<String, Integer>> scoreList = Arrays.asList( new Tuple2<String, Integer>("class1", 80), new Tuple2<String, Integer>("class2", 90), new Tuple2<String, Integer>("class1", 97), new Tuple2<String, Integer>("class2", 89)); JavaPairRDD<String, Integer> scores = sc.parallelizePairs(scoreList); //reduceByKey算法返回的RDD,还是JavaPairRDD<key,value> JavaPairRDD<String, Integer> totalScores = scores.reduceByKey(new Function2<Integer, Integer, Integer>() { @Override public Integer call(Integer v1, Integer v2) throws Exception { return v1 + v2; } }); totalScores.foreach(new VoidFunction<Tuple2<String,Integer>>() { @Override public void call(Tuple2<String, Integer> t) throws Exception { System.out.println(t._1 + ":" + t._2); } }); sc.close(); } 6.sortByKey算子 private static void sortByKey() { SparkConf conf = new SparkConf() .setAppName("sortByKey") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<Integer, String>> scoreList = Arrays.asList( new Tuple2<Integer, String>(78, "marry"), new Tuple2<Integer, String>(89, "tom"), new Tuple2<Integer, String>(72, "jack"), new Tuple2<Integer, String>(86, "leo")); JavaPairRDD<Integer, String> scores = sc.parallelizePairs(scoreList); JavaPairRDD<Integer, String> sortedScores = scores.sortByKey(); sortedScores.foreach(new VoidFunction<Tuple2<Integer,String>>() { @Override public void call(Tuple2<Integer, String> t) throws Exception { System.out.println(t._1 + ":" + t._2); } }); sc.close(); } 7.join算子 join算子用于关联两个RDD,join以后,会根据key进行join,并返回JavaPairRDD。JavaPairRDD的第一个泛型类型是之前两个JavaPairRDD的key类型,因为通过key进行join的。第二个泛型类型,是Tuple2<v1, v2>的类型,Tuple2的两个泛型分别为原始RDD的value的类型 private static void join() { SparkConf conf = new SparkConf() .setAppName("join") .setMaster("local"); JavaSparkContext sc = new JavaSparkContext(conf); List<Tuple2<Integer, String>> studentList = Arrays.asList( new Tuple2<Integer, String>(1, "tom"), new Tuple2<Integer, String>(2, "jack"), new Tuple2<Integer, String>(3, "marry"), new Tuple2<Integer, String>(4, "leo")); List<Tuple2<Integer, Integer>> scoreList = Arrays.asList( new Tuple2<Integer, Integer>(1, 78), new Tuple2<Integer, Integer>(2, 87), new Tuple2<Integer, Integer>(3, 89), new Tuple2<Integer, Integer>(4, 98)); //并行化两个RDD JavaPairRDD<Integer, String> students = sc.parallelizePairs(studentList);; JavaPairRDD<Integer, Integer> scores = sc.parallelizePairs(scoreList); //使用join算子关联两个RDD //join以后,会根据key进行join,并返回JavaPairRDD //JavaPairRDD的第一个泛型类型,之前两个JavaPairRDD的key类型,因为通过key进行join的 //第二个泛型类型,是Tuple2<v1, v2>的类型,Tuple2的两个泛型分别为原始RDD的value的类型 JavaPairRDD<Integer, Tuple2<String, Integer>> studentScores = students.join(scores); //打印 studentScores.foreach(new VoidFunction<Tuple2<Integer,Tuple2<String,Integer>>>() { @Override public void call(Tuple2<Integer, Tuple2<String, Integer>> t) throws Exception { System.out.println("student id:" + t._1); System.out.println("student name:" + t._2._1); System.out.println("student score:" + t._2._2); System.out.println("=========================="); } }); sc.close(); } 更深的方法参见:http://blog.csdn.net/liulingyuan6/article/details/53397780http://blog.csdn.net/liulingyuan6/article/details/53410832https://www.2cto.com/net/201608/543044.html 转自:http://blog.csdn.net/sunhaoning/article/details/70505718 本文转自whk66668888 51CTO博客,原文链接:http://blog.51cto.com/12597095/2063767
优秀的个人博客,低调大师

hbase单机版安装

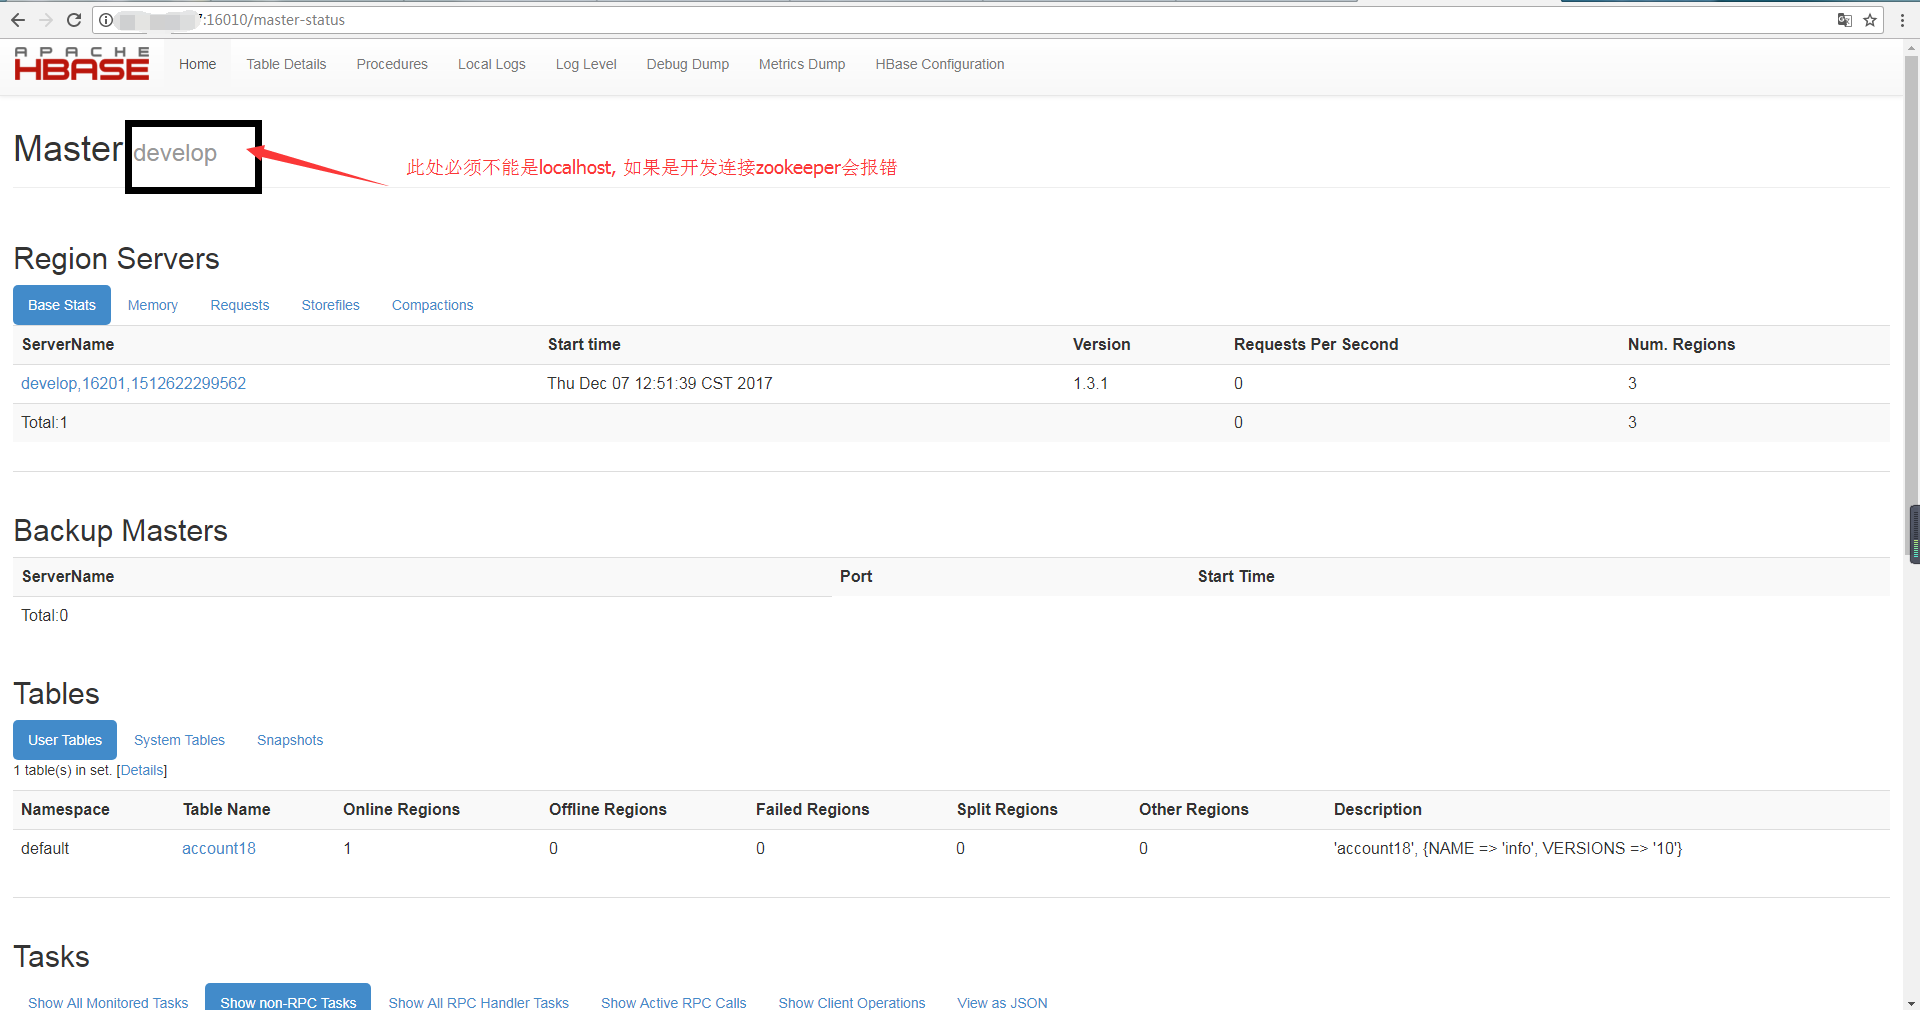
、系统版本 2、安装 3、测试一下 4、注意事项 1、系统版本 版本: linux centos6.8 hbase版本: hbase-1.3.1 jdk版本 [root@test hbase]# java -version java version "1.8.0_121" Java(TM) SE Runtime Environment (build 1.8.0_121-b13) Java HotSpot(TM) 64-Bit Server VM (build 25.121-b13, mixed mode) 2、安装 # 将hbase解压到/opt/hadoop/目录下,并弄一个软链接 # 配置/etc/hosts文件 #注意这里127.0.0.1 这行一定要注释,否则hbase单机启动的时候会报错 # 加一行 你的主机IP地址 主机hostname 如192.168.1.1 test # 配置 conf/hbase-env.sh# 这里配置你安装的jdk的目录 export JAVA_HOME=/usr/java/default/ # 配置 conf/hbase-site.xml <configuration> <property> <name>hbase.rootdir</name> <value>file:///opt/hadoop/hbase/data/</value>#这里是安装目录自行定义的目录 </property> <property> <name>hbase.master</name> <value>192.168.1.1</value># 主机IP,也可以是主机名 </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.zookeeper.property.clientPort</name> <value>2181</value># zookeeper端口 </property> <property> <name>hbase.zookeeper.quorum</name> <value>192.168.1.1</value># zookeeper地址,也可以是主机名 </property> </configuration> 3、测试一下 # 使用 bin/hbase shell 1 2 3 4 5 6 7 8 9 10 11 2017-12-0713:21:03,242WARN[main]util.NativeCodeLoader:Unabletoloadnative-hadooplibrary for yourplatform...using builtin -javaclasseswhereapplicable HBaseShell;enter 'help<RETURN>' for listofsupportedcommands. Type "exit<RETURN>" toleavetheHBaseShell Version1.3.1,r930b9a55528fe45d8edce7af42fef2d35e77677a,ThuApr619:36:54PDT2017 hbase(main):001:0>list TABLE account18 1row(s) in 0.1570seconds =>[ "account18" ] 4、注意事项 # 也可以使用ip地址:16010登陆,查看master一定不能是localhost如果是那么一定要检查/etc/hosts文件 本文转自812374156 51CTO博客,原文链接:http://blog.51cto.com/xiong51/2048302,如需转载请自行联系原作者

优秀的个人博客,低调大师

wu-framework-parent 1.2.5-JDK17 (SNAPSHOT)正式版、快照版

版本:1.2.5-JDK7、1.2.5-JDK17-SNAPSHOT | 旧模块 | 调整为新模块 | 描述 | |--------------------------------------------|--------------------------------------------------------------------------|----------------------------------------------------------------------------------------------------------------| | wu-layer-stereotype | wu-framework-translation | 字典转译、加密、limit、orm转译 | | wu-layer-stereotype | wu-framework-core | 框架核心模块,注解深度解析、工具 | | wu-layer-stereotype | wu-framework-bean | 框架bean管理 代理反射、自定义bean容器 | | wu-database-click-house-starter | | 删除clickhouse 对应的stater orm操作统一由lazy-orm-core sql处理 后进行datasource执行 | | wu-database-generator-starter | | 删除数据库逆向工程请使用lazy-orm-client [wu-smart-acw-client](wu-smart-integration%2Fwu-smart-acw%2Fwu-smart-acw-client) | | wu-database-layer-stereotype | | 删除 | | wu-database-lazy-lambda-core | wu-database-lazy-lambda | | | wu-database-lazy-sql-core | wu-database-lazy-sql | | | wu-database-lazy-spring-boot-autoconfigure | | 此模块删除,促使lazy orm 将不再依赖spring 框架 | | wu-framework-lazy-orm-spring-starter | wu-framework-lazy-orm-spring-starter、wu-framework-lazy-orm-solon-starter | 此模块删除,针对spring和solon 使用不同的starter | | wu-database-mysql-lazy-starter | wu-framework-lazy-orm-spring-starter、wu-framework-lazy-orm-solon-starter | 此模块删除,针对spring和solon 使用不同的starter | | wu-dynamic-database-starter | wu-database-lazy-sql | lazy orm 框架自带数据源切换 | | wu-framework-web | | 此模块调整将不绝对依赖spring、已经支持spring,后续solon支持 | | | wu-framework-web-spring-starter | wu-framework-web 支持spring | | | wu-framework-translation-spring-starter | wu-framework-translation 支持spring | | | wu-smart-agent-network-heartbeat-common | 内网穿透公共模块(声明接口、枚举、常量、适配器、解析器) | | | wu-smart-agent-network-heartbeat-client | 客户端(支持二次开发) | | | wu-smart-agent-network-heartbeat-server | 服务端(支持二次开发) | | | wu-smart-agent-network-ui | 服务端页面 | | | wu-smart-agent-network-heartbeat-client-start | 客户端样例 | | | wu-smart-agent-network-heartbeat-server-start | 服务端样例 | - [fix] lazy orm 摆脱spring依赖 - [fix] lazy orm 适配solon - [add] 添加内网穿透统一管理 - [fix] 修复lazy operation proxy 代理过程中连接泄漏问题 - [add] datasource、connection 使用代理方式 官网地址:https://wujiawei1207537021.gitee.io/wu-framework-parent/ Lazy ORM 学习模板地址:https://gitee.com/wujiawei1207537021/wu-database-lazy-starter-simple

优秀的个人博客,低调大师

Docker 桌面版再填新成员,企业版助力生产提速

出品丨Docker公司(ID:docker-cn)编译丨小东每周一、三、五,与您不见不散! 对于想要基于容器进行开发的组织来说,Docker Desktop 是一种最直接、最简单的方法。因此,每天有将近140万的开发人员在使用 Docker Desktop。Docker Desktop 可以直接在桌面上提供 Swarm 和 Kubernetes 编排,所有这些都可以通过一次安装完成。虽然这对于单个用户来说非常有用,但在企业环境中,管理员通常希望实现自动安装 Docker Desktop,同时确保开发团队中的每个人都具有遵循企业要求的相同配置,并根据标准结构创建应用程序。 Docker Desktop Enterprise 是一款全新的桌面产品,它为创建和交付可用于生产的容器化应用程序提供了一种最简单、最快速和最安全的方式。开发人员可以使用他们选择的框架和语言,而 IT 可以安全地配置、部署和管理符合公司标准和实践的开发环境。这使组织能够快速提供从开发到生产的容器化应用程序。 企业标准化助力生产提速 Docker Desktop Enterprise 提供了一种安全的方式来配置、部署和管理开发人员的环境,同时实施符合公司策略和实践的安全开发标准。IT 团队和应用程序架构师可以为开发人员提供专为其团队设计的应用程序模板,从而引导和标准化开发过程,并为生产提供一致的环境。 为 IT 设计的主要新功能: 打包为标准 MSI(Win)和 PKG(Mac)分发文件,这些分发文件可与现有端点管理工具配合使用,并通过策略文件锁定设置; 为开发人员提供定制和经过批准的应用程序模板,为编码做好前期准备; 企业部署和配置打包 Docker Desktop Enterprise 使 IT 桌面管理员能够跨分布式开发人员团队使用标准 MSI 和 PKG 文件的首选端点管理工具来部署和管理 Docker Desktop Enterprise。无需手动干预或开发人员进行额外的配置,桌面管理员可以在 Docker Desktop Enterprise 中启用或禁用特定设置来满足企业标准并为开发人员提供最佳的体验。 应用程序模板 应用程序架构师可以通过 Docker Desktop Enterprise 中的 Application Designer 界面为开发人员提供可信的自定义应用程序模板,并确保开发人员从已经批准的设计着手来帮助提高可靠性和安全性。应用程序团队和 IT 部门可以在整个软件供应链(从开发人员的桌面一直到生产)实现一致的安全性和开发实践。 提高开发人员的工作效率并交付可用于生产的容器化应用程序 对于开发人员而言,Docker Desktop Enterprise 是一种构建可用于生产的容器化应用程序最简单、最快捷的方式,并且针对每个平台提供可选择的框架和语言。开发人员可以利用公司提供的应用程序模板进行快速创新,这些模板可以立即在本地桌面上复制经过生产批准的应用程序配置。 为开发人员设计的主要新功能: 可配置的版本包能够立即在本地桌面上复制生产环境的配置; Application Designer 界面允许基于模板的工作流来创建容器化应用程序,无需启动 Docker CLI 命令; 可配置的版本包 Docker Desktop 内置了 Docker Engine 和 Kubernetes,并且添加了可变更的版本包,您现在可以将桌面开发环境与 Docker Enterprise 生产中使用的相同 Docker API 和 Kubernetes 版本进行同步。您可以确保您的应用程序不会因 API 调用不兼容而中断,如果您有多个下游环境运行不同版本的 API,则只需单击按钮即可快速更改桌面配置。 Application Designer Application Designer 是一种全新的工作流,它提供可用于生产的应用程序和服务模板,使您可以快速编写代码,并确保您的应用程序符合架构标准。即使您以前从未使用过容器,Application Designer 界面也会提供基础容器工件和组织的框架代码,让您在几分钟内就可以开始使用容器了。 此外,无论您喜欢 IDE 还是文本编辑器亦或是命令行界面,Docker Desktop Enterprise 都已经集成了您所选择的开发工具。 Docker 全新的桌面产品 Docker Desktop Enterprise 是 Docker 桌面产品组合的新成员,目前包括了适用于 MacOS 和 Windows 的免费 Docker 桌面社区产品。Docker Desktop 是在 Windows 10 和 macOS 上开始基于容器进行开发的最简单方法,它具有一系列现在可供企业使用的功能: 浏览 https://goto.docker.com/Docker-Desktop-Enterprise.html 了解有关 Docker Desktop Enterprise 的更多信息。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册