首页 文章 精选 留言 我的

精选列表

搜索[虚幻引擎],共10000篇文章
优秀的个人博客,低调大师

【Elasticsearch全文搜索引擎实战】之Kibana搭建

1. Kibana介绍 Kibana是一个针对Elasticsearch的开源分析及可视化平台,用来搜索、查看交互存储在Elasticsearch索引中的数据。使用Kibana,可以通过各种图表进行高级数据分析及展示。 Kibana让海量数据更容易理解。它操作简单,基于浏览器的用户界面可以快速创建仪表板(dashboard)实时显示Elasticsearch查询动态。 设置Kibana非常简单。无需编码或者额外的基础架构,几分钟内就可以完成Kibana安装并启动Elasticsearch索引监测。 2. Kibana特性 2.1 丰富的数据报表 Kibana 核心搭载了一批经典功能:柱状图、线状图、饼图、环形图,等等。它们充分利用了 Elasticsearch 的聚合功能。 2.2 将地理数据融入任何地图 利用 Elastic Maps Services 来实现地理空间数据的可视化,或者发挥创意,在您自己的地图上实现自定义位置数据的可视化。 2.3 时间序列 可以利用 Timelion,对Elasticsearch 中的数据执行高级时间序列分析。您可以利用功能强大、简单易学的表达式来描述查询、转换和可视化。 2.4 用机器学习探索异常 借助 X-Pack 里面的非监督型 machine learning 功能 来检测隐藏在 Elasticsearch 数据中的异常和探索那些对它们有显著影响的属性。 2.5 与Elasticsearch REST API实现可视化交互 Console 等 Kibana 开发工具提供多种方法帮助您开发 Elastic Stack。借助 Console,可以跳过在终端键入的过程直接处理 Elasticsearch 数据。 Search Profiler 可让您轻松查看搜索请求期间花费的时间。并且在Logstash配置中创建复杂的 Grok 模式,使 Grok Debugger 变得轻而易举。 3. 下载安装 OS Kibana CentOS 6.0.1 wget https://artifacts.elastic.co/downloads/kibana/kibana-6.0.1-linux-x86_64.tar.gz sha1sum kibana-6.0.1-linux-x86_64.tar.gz tar -xzf kibana-6.0.1-linux-x86_64.tar.gz cd kibana-6.0.1-linux-x86_64/ 3.1 配置 #修改配置 vi config/kibana.yml #增加以下内容 server.port: 5601 server.host: "192.168.1.31" elasticsearch.url: "http://192.168.1.31:9200" 3.2 运行 #进入kibana根目录 /kibana-6.0.1-linux-x86_64 #启动 ./bin/kibana 4. 访问 浏览器访问: 192.168.1.31:5601 此时会提示: Configure an index pattern 浏览器访问:192.168.1.31:5601/app/kibana#/discover 即可查看日志 参考资料: [1] Kibana使用教程:https://segmentfault.com/a/1190000002972420 [2] Kibana User Guide:https://www.elastic.co/guide/en/kibana/current/index.html
优秀的个人博客,低调大师

MySQL · 引擎特性 · 从节点可更新机制

背景 主从集群,指由一个主数据库实例和多个从数据库实例组成,其中主数据库实例提供读写功能支持,而从数据库不提供对外服务或只提供只读功能支持,但也有从数据库提供读写功能支持,下面就这几种集群架构做详细的解读,并就如何实现从节点可更新机制进行探讨。 主从集群概述 主从集群的实现方式主要有以下几种: 基于磁盘镜像的主备集群 基于Proxy中间件的主从(多主)集群 基于共享磁盘的主从集群 基于日志重放(物理日志或逻辑日志)的主从集群 一、基于磁盘镜像的主备集群 基于磁盘镜像的主备集群是最早出现的一种高可用解决方案,对数据库系统没有特殊要求,不需要额外的功能支持,利用原有单机数据库系统即可搭建,主要利用磁盘镜像来实现主备之间数据的同步。 原理是利用磁盘镜像的机制,当主机数据更新后,在写入磁盘的同时将数据同步到备机的磁盘上,主机缓冲区中的数据并不能同步到备机。当主机down机后,除了缓冲区数据未同步之外,磁盘上的数据还可能因为部分写而导致数据错误。所谓部分写是由于IO的特性导致的。 通常磁盘IO以扇区为单位一次性读写,但真正的数据页通常大于一个扇区(512字节),因此在down机时有可能只写了数据页的一部分,如一个数据页面大小为16K,down机时只写了此数据页的2K。后面会专门介绍数据库解决部分写的方法。 它的缺点也比较明显,主备机实例不能同时启动,只有当主机down机后,备机启动,并执行恢复操作,然后提供对外服务。因此,切换时间较长,而且备机的资源无法充分利用,适用于主机硬件损坏导致无法恢复的场景,也可用于计划检修等场景。 二、基于Proxy中间件的主从(多主)集群 基于proxy中间件可以搭建多主或主从集群,主要原理是利用proxy代理对应用请求进行分类、转发,当是写请求时,将写请求转发到集群中的每一台服务器;当是读请求时,将读请求转发到任意一台服务器即可。 基于proxy中间件搭建的集群,在数据库层面并不保证多机之间的数据一致性,而是由proxy来间接实现一致性,proxy通过检查发给所有服务器的写请求的执行结果,当任一服务器执行失败,就反向执行写请求,以保证多节点之间数据的一致性,这种一致性只是弱一致性,在数据库中也称为事务补偿机制。此外,也可以利用数据库本身提供的XA协议(如果数据库支持的话),但为了提高一致性,会损失性能和可用性。 它的主要缺点是无法保证事务的强一致性,当一个节点down机后,其它节点后续的写请求无法在down机服务器上执行,会造成down机服务器的数据丢失。 三、基于共享磁盘的主从集群 基于共享磁盘的主从集群是目前比较常见的集群架构之一,原理是通过主从服务器读取共享磁盘的数据来进行数据同步。因为数据库服务器的缓存,所以除了从共享磁盘读取数据之外,还要进行日志的内存重放,以更新缓存的数据。 共享磁盘架构的主要问题是缓存的同步,当主机提交事务时,同时将日志发到从机,或将日志刷写到磁盘后通知从机读取,然后从机重放日志,更新缓冲区的数据,但从机禁止将缓冲区数据写回到磁盘,只有主机可以将数据写回到磁盘。另外一个问题是部分写的问题,后面会专门讨论。 根据主机提交事务的时机,可以实现异步、近同步、实时同步等不同模式。异步指主机提交事务时,将日志发给从机,但不关心是否发送成功即完成事务提交。因为有网络延迟、重放日志延迟等,主从之间的数据并不是实时同步的。通常日志发送采用专门的进(线)程来实现,从机的数据有可能delay主机很久,这要实际的生产环境有很大关系。 近同步指从机收到日志即向主机返回成功,主机即可完成事务提交,但此时从机尚未日志重放,会有稍许日志重放的延迟。 共享磁盘架构的主要的问题在于必须有集群文件系统的支持,依赖于集群文件系统来保证节点间的数据一致性,并且在数据库层面也要有分布式锁来防止写写冲突和读写冲突。 四、基于日志重放(物理日志或逻辑日志)的主从集群 基于日志重放的主从集群是最常见的集群构架,并且也有很多独立于数据库的产品。日志大体有两种,一种是逻辑日志,一种是物理日志。物理日志通常都比较小,易于保存和传输,但重放的代价比较大,对从机资源的消耗也比较大,mysql的主从集群就是典型的以逻辑日志为基础的主从集群。与之相反的是物理日志,通常物理日志都比较大,但物理日志重放的代价都比较小,对从机资源的消耗也比较小,但对网络资源的消耗比较大。 逻辑日志重放代价上最有利的场景一个应用场景就是全表更新;而物理日志重放代价上最有利的场景更新全表扫描中的一条记录。因此,不能简单的说,哪种日志更好,必须以实际的应用场景来具体分析。 数据库系统中解决部分写的常见方法在数据库系统中,数据通常以固定大小的页面来保存,页面大小也通常是512字节的整数倍,512字节是通常磁盘一个扇区的大小,扇区是一次磁盘IO的最小单位。SSD盘通常扇区大小为4K。在数据库系统中,一般情况下,数据页面的大小都会远大于512字节,随着大数据的到来,8K,16K页面已经很常见。当数据页面比较大时,要将一个数据页面刷写到磁盘上就需要多次IO,但这多次IO之间并不是原子操作,在执行过程中很可能因为各种原因导致中断,如断电,磁盘损坏等,造成的后果就是磁盘上的数据页面前面部分已经更新,后半部分仍是旧的数据,也就是部分写。出现部分写后的数据页是无法使用的,典型的牛唇不对马嘴。使用raid条带化也可能会导致同样的问题。 在数据库系统实现过程中,必须如何发现并解决这个问题。首先我们来说一说单机系统中的解决方法。 首先数据库要能检测到这个问题,实现的方法也比较简单,在页面头上记录一个标志,如时间戳,然后在页面尾上也记录一个相同的标志,当读取数据页面后,只要检查一下标志是否相同即可证明页面是否存在部分写。需要注意的是每次页面更新后,标志也必须同时进行修改,不能使用原有页面的标志。还有一些代价更大的方法,如生成整个页面的摘要,然后记录到页头中,除了可以检查页面的部分写之外,还能防止页面被恶意篡改,但这对系统资源的消耗比较大。一种热衷的办法是计算部分页面数据的摘要,但要包含页面头和页面尾,这样就可以能检测页面的部分写,也能部分达到防止篡改的目的。 在实现页面部分写检测的功能之后,我们还要解决如何这个问题,我们的目的是能得到正确的数据,而不只是发现错误。当数据库发现页面错误之后,可以采用的办法是通过日志重放来恢复数据。如果要从系统最初的状态重头开始进行日志重放,那么代价太大,或者有些场景下就是不可能实现的。为了加速这个过程,数据库引用checkpoint来解决这个问题。当checkpoint时,当前所有缓冲区中被修改的页面都要被刷写到磁盘上,执行成功后,记录checkpoint日志,以后就可以从这个点进行恢复。这与部分写有什么关系呢?数据库在更新每个缓冲区的数据后,都会记录日志,日志内容记录了当前修改的内容,最重要的一点是在记录日志时,如果发现当前的缓冲区是在checkpoint之后的首次修改时,会做一个当前页面的快照,并将其记录到磁盘上,在postgresql中是将其记录到redo日志中,另外一些数据库是记录到一个专门的日志中,如mysql的double write。当这个缓冲区被多次修改后,若在将其刷写到磁盘的过程中出现的断机等异常情况,造成部分写后,系统重新启动读取页面时发现页面有部分写,那么会将之前记录到磁盘的快照覆盖出现部分写的数据页面,然后在此基础上进行日志重放,从而达到恢复部分写的结果。 在基于共享磁盘的主从集群中也会存在相同的问题,有可能是主要写了一半,而从机此时来读取数据,就会读取到错误的数据。利用前面时间戳或摘要的方法,可以轻易解决检测部分写的问题。如何读到正确的数据呢?一种简单易用的方法就是重读,当检测到数据页面错误时,重试几次就好了,就能解决绝大多数的问题了,如果总是读取不正确,就要考虑是不是磁盘坏掉了。报错给DBA也是一个不错的选择。如果非要数据库来解决了,也是可以的,同样采用在快照上重放日志就可以实现数据的恢复,但代价比较大,运行过程中进行数据页恢复的设计也比较复杂。 从节点可更新机制通常在主从集群中,主节点是可以读写的,而从节点通常只能提供只读功能,能不能实现在从节点也可以读写支持呢?当然可以,常见的方法有如下几种: SQL转发 全局锁 主机延迟裁定 1.SQL转发 从节点接受应用请求后,经过词法语法分析后,若发现是更新类的操作,如DML,DDL等,将其转发给主节点,再将主节点执行后的返回结果转发回给应用程序。从节点本身实际并不真正执行更新操作,它依赖于主从之间的同步机制来更新本地缓存的数据。若不是实时同步更新,可能会导致应用程序在从节点更新,又在从节点读取到更新前的脏数据(历史数据)。若是更新较多的应用场景,从节点并不能承担分流的任务,主节点的负载不会有明显降低。 2.全局锁 如果集群实现了全局锁,从节点就可以真正在本地更新数据,但需要有额外的同步机制将从节点的数据同步到主节点。全局锁的实现可以使用集中式锁管理,也可以使用分布式锁管理,可以根据需要和应用场景来选择实现。 全局锁虽然解决了从节点的更新问题,但会对整个系统的性能造成较大影响,因为每次对数据页面的访问都要加全局锁,增加了大量额外的网络开销。并且还要实现从节点到主节点的数据同步机制。 3.主机延迟裁定 从节点收到应用程序的更新请求后,直接在备机执行syntax解析、SQL优化、执行等,在提交之前,向主节点发送裁定请求,以判定此写操作是否可以提交。向主节点发送的内容至少应包括更新前的数据快照、修改后的数据等,主节点收到裁定请求,比较更新前的数据快照是否与当前的数据相同,若相同则说明在从机修改数据之前此份数据没有被修改过,是在最新数据版本上进行的更新,则将更新的内容应用到主节点,如果需要记录日志,同时将日志刷写到磁盘。如果更新前的数据快照与当前的数据不相同,则说明在从机修改数据之前,主机已经修改过数据,但尚未同步到从机,因此必须回滚事务。

优秀的个人博客,低调大师

全文搜索引擎Elasticsearch的安装过程

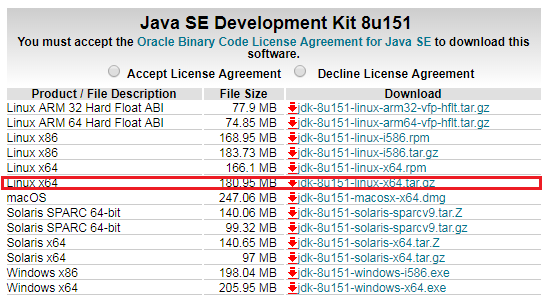
Elasticsearch是目前为止比较屌炸天的一款大数据日志收集工具,而且在很多知名大公司比如360、蚂蚁金服、京东、腾讯等都急需这方面的研究人才,在https://elasticsearch.cn/explore/category-12官方网站就有N多Elasticsearch招聘贴。 要安装Elasticsearch,需要在机器里先有java1.8+的环境,我这2个机器都是阿里云centos 7.4 64位纯净系统,配置是2核2G。 首先#yum -y update一波,更新一下最新的yum,在更新的时候呢,也不要干坐着,登陆http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html ,下载最新的java安装包,我为了省事直接就选择的tar包,如图: 下载完并且上传之后,执行一下#rpm -qa | grep java,看一下有没有以前老的java,比如: 1 2 3 4 5 6 7 [root@chen-elk-001usr] #rpm-qa|grepjava java-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 python-javapackages-3.4.1-5.el7.noarch tzdata-java-2014b-1.el7.noarch javapackages-tools-3.4.1-5.el7.noarch java-1.7.0-openjdk-1.7.0 [root@chen-elk-001usr] # 如果有的话就#rpm -e --nodeps加上查询出的java名逐一删除掉java,比如: 1 2 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-1.7.0 删除完毕之后,要#java -version检查一下是否已经不会出现版本了。 现在更新也更新完了,以前老的java也干掉了,那么就把jdk-8u151-linux-x64.tar.gz 拆包解压缩到/usr/local里,如图: 然后就#vim /etc/profile,在全文的末尾加上这样的内容: 1 2 3 4 5 6 #java1.8config JAVA_HOME= /usr/local/jdk1 .8.0_151#这里就是jdk1.8的那个路径,根据解压缩的位置而定 JRE_HOME=$JAVA_HOME /jre CLASSPATH=:$JAVA_HOME /lib/dt .jar:$JAVA_HOME /lib/tools .jar:$JRE_HOME /lib/dt .jar PATH=$PATH:$JAVA_HOME /bin :$JRE_HOME /bin export JAVA_HOMEJRE_HOMECLASSPATHPATH 保存退出之后,#source /etc/profile,然后#java -version看一下版本: java 1.8安装完毕,下面就是安装Elasticsearch,直接下载压缩包吧,比较简单暴力。 1 2 3 4 #wgethttps://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-5.5.1.zip #unzipelasticsearch-5.5.1.zip #cdelasticsearch-5.5.1/bin #./elasticsearch 启动之后,发现爆了一个错误,"Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x000000008a660000, 1973026816, 0) failed; error='Cannot allocate memory' (errno=12)",如图: vim打开elasticsearch会看到下面这句话 1 #ES_JAVA_OPTS="-Xms8g-Xmx8g"./bin/elasticsearch 这个错误代表8G内存才可以启动elasticsearch,于是就升级到8G,这玩意的确是有钱人玩的东西。 升级之后,再次启动,出现了"can not run elasticsearch as root"这个错误: 既然不让root,那就建立一个新的用户吧: 1 2 3 4 5 roupaddelsearch useradd elsearch-gelsearch-pelasticsearch chown -Relsearch:elsearch/安装路径 /elasticsearch-5 .5.1 cd /安装路径 /elasticsearch-5 .5.1 /bin su elsearch. /elasticsearch 这样就看到正确启动的样子: 如果要后台启动的话,命令就是#su elsearch ./elasticsearch -d。如果你非要用root用户去启动的话,也不是不可以,命令是#./安装路径/bin/elasticsearch -Des.insecure.allow.root=true。 如果启动的时候,爆“max virtual memory areas vm.maxmapcount [65530] is too low”这个错误,那么就先运行如下命令:#sudo sysctl -w vm.max_map_count=262144。 如果启动的时候,爆“max file descriptors [65535] for elasticsearch process is too low, increase to at least [65536]”,那么#vim /etc/security/limits.conf,把文末内容改成这样,改完了之后#sysctl -p即可: 1 2 3 4 5 6 7 #Endoffile rootsoftnofile65535 roothardnofile65535 *softnofile165536 *hardnofile165536 *softnproc2048 *hardnproc4096 启动之后,在命令行里输入#curl localhost:9200,就会返回JSON 对象,包含当前节点、集群、版本等信息。 我这个Elasticsearch版本是5.11,中文教程https://elasticsearch.cn/book/elasticsearch_definitive_guide_2.x/ 已经有点老了,所以研究之路不仅充满荆棘还充满各种墙和英语... 参考资料:http://www.yiibai.com/elasticsearch/ 参考资料:http://www.cnblogs.com/Wolfmanlq/p/5984376.html 最后的最后,如果您觉得本文对您升职加薪有帮助,那么请不吝赞助之手,刷一下下面的二维码,赞助本人继续写更多的博文! 本文转自 苏幕遮618 51CTO博客,原文链接:http://blog.51cto.com/chenx1242/2043924

优秀的个人博客,低调大师

传感技术或成工业互联网推广引擎

工信部部长苗圩近日接受专访时透露,工信部正在研究制定智能制造发展战略,编制智能制造专项规划;推动传统装备智能化改造和升级,分行业制定传统装备智能化改造路线图,组织开展重点行业智能车间、智能工厂试点,培育一批样板企业并组织推广行业应用示范。同时,工信部将推进工业互联网发展,研究制定工业互联网网络架构方案,开展工业互联网试点示范。 有媒体认为,工业互联网是全球工业系统与高级计算、分析、感应技术以及互联网连接融合的结果。它通过智能机器间的连接并最终将人机连接,结合软件和大数据分析,重构全球工业、激发生产力,让世界更美好、更快速、更安全、更清洁且更经济。工业互联网必须以物联网和工业数据分析为基础,不同于传统互联网公司比如谷歌、亚马逊等可以通过PC、移动端后台收集数据,工业数据需要来自安装在机器上的传感器,传感器收集机器运行时的数据,实时传送到云端进行存储、分析和决策。 工业级传感器相对于普通传感器来说,需要更强大的稳定性和更高的灵敏度,因为很多工业级传感器需要在更恶劣环境下运行,比如生产车间相比普通环境,工业噪声会大很多,比如电力、铁路沿线的监测,需要在恶劣的自然条件下进行监测。而工业互联网对于工业数据的要求是实时采集、存储和分析,因此MEMS传感器体积小、重量轻、成本低、功耗低、可靠性高、适于批量生产、易于集成和实现智能化的特点,正好契合了工业互联网对于传感器的要求。 作者:何妍 来源:51CTO

优秀的个人博客,低调大师

存储与计算分离:OSS构建表 + 计算引擎对接

看到标题,可能有用户要问:OSS不是用来存图片、视频、及文件的吗,还可以在上面建表、数仓?计算效率和经济性表现怎么样? 本文先给出基本结论: OSS是什么? 对象存储(Object Storage Service,简称OSS)是基于阿里云飞天分布式系统的海量、安全和高可靠的云存储服务,是一种面向互联网的大规模、通用存储,提供RESTful API,具备容量和处理的弹性扩展能力。 基于OSS是否可以创建数据表? 既然可以把摄像头推流接到OSS,建表属于小Case了。并且2016年在亦龙大神的帮助下,Hadoop社区在官方版本中支持OSS,开启了阿里云存储与开源融合的新里程碑。 OSS上建表是否易用? 今天为了降低OSS上建表的门槛,日志服务(原SLS)LogHub可以支持OSS上表的实时写入(表类型包括TextFile,列存储Parquet),支

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册