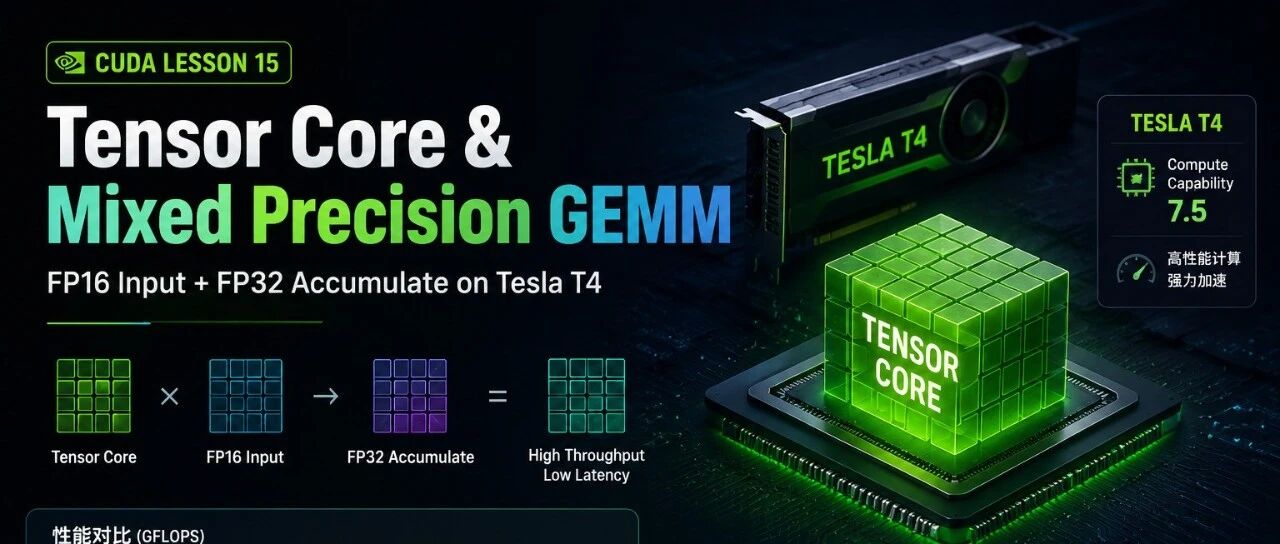
CUDA 编程:Tensor Core 与混合精度 GEMM
### 文章目录 - 1. 背景 - 2. Tensor Core 的核心思想 - 3. 实验环境 - 4. 实现方式 - FP32 SGEMM - Mixed Precision GEMM - 5. 实验结果 - 5.1 不同矩阵规模性能 - 5.2 GFLOPS 对比 - 6. Tensor Core 为什么越大矩阵越快? - 7. 矩阵尺寸对 Tensor Core 的影响 - 8. Tensor Core不是简单降低精度 - 9. 实验结论 > 从 cuBLAS SGEMM 到 Tensor Core GEMM,探索现代 GPU 矩阵计算的核心优化路径。  # **1. 背景** 前一节,我们比较了: - CPU MatMul - CUDA Naive Kernel - Shared Memory Kernel - cuBLAS SGEMM 发现 cuBLAS 已经远超手写 CUDA Kernel。 但现代深度学习模型中的矩阵计算,还会进一步使用: > Tensor Core + Mixed Precision 例如: - Transformer Linear 层 - Attention Projection - MLP - CNN 卷积 大量采用 FP16/BF16 混合精度计算。 本节在 Tesla T4 上测试: ``` FP32 SGEMM vs FP16 Tensor Core GEMM ``` # **2. Tensor Core 的核心思想** 普通 CUDA Core: ``` 一个线程 | | 标量乘加 | ↓ a*b+c ``` Tensor Core: ``` Matrix A | | Tensor Core | | Matrix B ---------> Matrix C 一次完成矩阵块乘加 D = A × B + C ``` Tensor Core 针对矩阵计算进行了硬件优化: - 矩阵块运算 - 高吞吐 FP16 运算 - FP32 累加保证稳定性 # **3. 实验环境** GPU: ``` Tesla T4 Compute Capability: 7.5 ``` 测试: |项目|配置| | --- | --- | |输入类型|FP16| |累加类型|FP32| |输出类型|FP32| |计算库|cuBLAS| |GPU|Tesla T4| |矩阵规模|512~4096| # **4. 实现方式** ## **FP32 SGEMM** 计算流程: ``` FP32 Matrix A + FP32 Matrix B ↓ cuBLAS SGEMM ↓ FP32 Matrix C ``` ## **Mixed Precision GEMM** 流程: ``` FP32 数据 ↓ 转换 FP16 ↓ Tensor Core FP16 × FP16 ↓ FP32 accumulate ↓ FP32 Output ``` 关键代码: ``` cublasGemmEx( handle, ..., CUDA_R_16F, ..., CUDA_R_16F, ..., CUDA_R_32F, ..., CUBLAS_COMPUTE_32F, CUBLAS_GEMM_DEFAULT_TENSOR_OP ); ``` 含义: |配置|作用| | --- | --- | |CUDA_R_16F|输入 FP16| |CUDA_R_32F|输出 FP32| |CUBLAS_COMPUTE_32F|FP32累加| |Tensor_OP|启用Tensor Core| # **5. 实验结果** ## **5.1 不同矩阵规模性能** |矩阵规模|FP32(ms)|Tensor Core(ms)|加速| | --- | --- | --- | --- | |512×512|0.0492|0.0299|1.64×| |1024×1024|0.2475|0.0946|2.62×| |2048×2048|1.4601|0.5835|2.50×| |4096×4096|16.2076|4.7007|3.45×| 可以看到: 随着矩阵规模增加: ``` Tensor Core 优势逐渐扩大 ``` ## **5.2 GFLOPS 对比** |矩阵规模|FP32 SGEMM|Mixed GEMM| | --- | --- | --- | |512|5457 GFLOPS|8969 GFLOPS| |1024|8675 GFLOPS|22694 GFLOPS| |2048|11766 GFLOPS|29442 GFLOPS| |4096|8479 GFLOPS|29237 GFLOPS| 性能变化: 4096矩阵: ``` FP32: 8.5 TFLOPS Tensor Core: 29.2 TFLOPS ``` 接近: ``` 3.5倍提升 ``` # **6. Tensor Core 为什么越大矩阵越快?** 小矩阵: ``` 计算量较少 Kernel启动 调度 缓存 占比较高 ``` 大矩阵: ``` 更多矩阵Tile ↓ Tensor Core持续工作 ↓ 硬件利用率提高 ``` 因此: ``` N ↑ Tensor Core利用率 ↑ 加速比 ↑ ``` # **7. 矩阵尺寸对 Tensor Core 的影响** |Matrix Size|FP32 SGEMM(ms)|Tensor Core GEMM(ms)|Speedup| | --- | --- | --- | --- | |1024×1024|0.2636|0.1037|2.54×| |1023×1023|0.4504|0.1683|2.68×| |2048×2048|1.2328|0.4890|2.52×| |2047×2047|2.9654|1.1937|2.48×| |Matrix Size|FP32 SGEMM|Tensor Core GEMM| | --- | --- | --- | |1024|8147 GFLOPS|20711 GFLOPS| |1023|4754 GFLOPS|12723 GFLOPS| |2048|13935 GFLOPS|35132 GFLOPS| |2047|5784 GFLOPS|14371 GFLOPS| 非规则尺寸需要: ``` padding 边界处理 ``` GPU 高性能计算非常依赖规则的数据布局 # **8. Tensor Core不是简单降低精度** 很多人认为: ``` FP16 = 精度差 ``` 实际上: Tensor Core 混合精度: ``` 输入: FP16 计算: FP32 accumulate 输出: FP32 ``` 结构: ``` FP16 | | Tensor Core | | FP32 Accumulate | | FP32 ``` 兼顾: ``` 速度 + 精度 ``` # **9. 实验结论** 本次 Tesla T4 实验得到: 1. **Tensor Core 显著提高 GEMM 性能** 1. **矩阵越大,Tensor Core优势越明显** 1. **混合精度是AI推理的重要优化** > CUDA Kernel 可以让我们理解 GPU 工作方式,而 Tensor Core 代表现代 GPU 矩阵计算的极致性能。 对于深度学习推理和训练,合理使用 FP16/BF16 混合精度,是获得高吞吐的重要手段。