首页 文章 精选 留言 我的

精选列表

搜索[c 17],共10000篇文章
优秀的个人博客,低调大师

排序算法总结——c++实现

Java实现见链接:https://mp.weixin.qq.com/s/pN4RH4pPKtSkZJgcf2V-Vw 排序算法的稳定性分析 选择排序无法保证稳定性: 归并排序可以保证稳定性:(相等的就先放置左区域内的元素) 快速排序无法保持稳定性(因为partition的时候无法保持稳定性) 以后补充 堆排序无法保证稳定性:(图中数组建堆的过程,稳定性就会被破坏,第二个4会跑到第三个4的后面) 稳定性的意义在哪 数据不会乱 冒泡——稳定排序算法 时间复杂度 O(n*n),空间复杂度O(n)。 下面代码中交换两个数的值的方式虽然节省了一个变量,但是如果溢出就不好玩了,所以不要轻易乱秀。 void bubble(int nums[]) { if (nums == nullptr) return; //获取数组长度 int len= sizeof(nums) / sizeof(int); for (int end = len - 1; end >0; end++) { for (int i=0; i < end; i++) { if (nums[i] > nums[i+1]) { nums[i] = nums[i] + nums[i + 1]; nums[i + 1] = nums[i] - nums[i + 1]; nums[i] = nums[i] - nums[i + 1]; } } } } 冒泡排序改进版——鸡尾酒排序 #include <stdio.h> // 分类 -------------- 内部比较排序 // 数据结构 ---------- 数组 // 最差时间复杂度 ---- O(n^2) // 最优时间复杂度 ---- 如果序列在一开始已经大部分排序过的话,会接近O(n) // 平均时间复杂度 ---- O(n^2) // 所需辅助空间 ------ O(1) // 稳定性 ------------ 稳定 void Swap(int A[], int i, int j) { int temp = A[i]; A[i] = A[j]; A[j] = temp; } void CocktailSort(int A[], int n) { int left = 0; // 初始化边界 int right = n - 1; while (left < right) { for (int i = left; i < right; i++) // 前半轮,将最大元素放到后面 { if (A[i] > A[i + 1]) { Swap(A, i, i + 1); } } right--; for (int i = right; i > left; i--) // 后半轮,将最小元素放到前面 { if (A[i - 1] > A[i]) { Swap(A, i - 1, i); } } left++; } } int main() { int A[] = { 6, 5, 3, 1, 8, 7, 2, 4 }; // 从小到大定向冒泡排序 int n = sizeof(A) / sizeof(int); CocktailSort(A, n); printf("鸡尾酒排序结果:"); for (int i = 0; i < n; i++) { printf("%d ", A[i]); } printf("\n"); return 0; } 插入排序——稳定排序 最差时间复杂度:O(n^2) 最优时间复杂度:O(n) 平均时间复杂度:O(n^2) 当存储容器为数组时 //插入排序 void insert(int nums[]) { if (nums == nullptr) return; //获取数组长度 int len = sizeof(nums) / sizeof(int); //当前考察i位置的数字 for (int i = 1; i < len; i++) { //从i往前比较,每次与j和j+1的位置相比较。如果j+1的值小,则把小的放在前面 for (int j = i - 1; j >= 0 && nums[j] > nums[j + 1]; j--) { nums[j] = nums[j] + nums[j + 1]; nums[j + 1] = nums[j] - nums[j + 1]; nums[j] = nums[j] - nums[j + 1]; } } } 当容器为vector时 #include <iostream> #include <vector> using namespace std; //传入一对迭代器,标准的插入排序 void Insertion_sort(vector<int>::iterator begin, vector<int>::iterator end) { for (auto p1 = begin; p1 != end; ++p1) { auto p2 = p1; while ((p2 != begin) && *(p2 - 1) > *p2) { int temp = *(p2); *p2 = *(p2 - 1); *(p2 - 1) = temp; --p2; } } } int main(int argc, char **argv) { int a[10] = { 2,5,6,3,1,4,8,7,9,0 }; vector<int> vec(a, a + 10); Insertion_sort(vec.begin(), vec.end()); for (size_t i = 0; i < vec.size(); ++i) { cout << vec[i] << " "; } return 0; } 当容器为链表时,从前往后遍历,找到对应的位置,进行链表的插入操作即可。 预备知识,链表的创建 #include<iostream> using namespace std; struct ListNode { int val; struct ListNode *next; }; //创建链表 ListNode* create(int arr[], int n) { if (arr == NULL || n <= 0) return NULL; ListNode *head = (ListNode*)malloc(sizeof(struct ListNode)); head->val = arr[0]; head->next = NULL; ListNode *tmp = head; ListNode *next = NULL; for (int i = 1; i < n; i++) { next = (ListNode*)malloc(sizeof(struct ListNode)); if (next) { next->val = arr[i]; next->next = NULL; tmp->next = next; tmp = next; } } return head; } int main() { int arr[6] = { 2,4,5,6,8,9 }; ListNode*first=create(arr, 6); return 0; } 链表实现插入排序代码(硬着头皮,终于写出来了。再坚持一下,再坚持一下,就会成功) #include <iostream> #include <vector> using namespace std; struct linklist { int data; linklist* next; linklist(int num = 0) : data(num), next(nullptr) {} }; //用了两个指针,fast指针用于比较当前节点的值与数组中的值的大小 //slow指向fast所指节点的前一个节点,slow用于插入新节点 linklist* insertion_sort(int arr[], int len){ linklist *before = (linklist*)malloc(sizeof(struct linklist)); linklist *head = (linklist*)malloc(sizeof(struct linklist)); head->data = arr[0]; before->next = head; head->next = NULL; linklist *fast = head; linklist *slow = before; linklist *next = NULL; for (int i = 1; i < len; i++) { //创建链表节点 next = (linklist*)malloc(sizeof(struct linklist)); next->data = arr[i]; //向后查找比arr[i]大的链表节点的位置 while ((arr[i] > fast->data)&&(fast->next!=nullptr)) { fast = fast->next; slow = slow->next; } //此时说明fast并没有指向链表最后一个元素 if (fast->next!=nullptr) { //说明arr[i]的值是最小的,应该插到链表头 if (slow==before) { next->next = slow->next; slow->next = next; } else { next->next = fast; slow->next = next; } } //此时fast指向链表结尾,需要比较fast->data与arr[i]的值 else { if (arr[i] > fast->data) { fast->next = next; next->next = nullptr; } else { next->next = fast; slow->next = next; } } slow = before; fast = slow->next; } return slow->next; } int main(int argc, char **argv){ int a[10] = { 2,5,6,3,1,4,8,7,9,0 }; linklist *answer=insertion_sort(a,10); return 0; } 插入排序改进——二分查找插入排序 #include <stdio.h> // 分类 -------------- 内部比较排序 // 数据结构 ---------- 数组 // 最差时间复杂度 ---- O(n^2) // 最优时间复杂度 ---- O(nlogn) // 平均时间复杂度 ---- O(n^2) // 所需辅助空间 ------ O(1) // 稳定性 ------------ 稳定 void InsertionSortDichotomy(int A[], int n) { for (int i = 1; i < n; i++) { int get = A[i]; // 右手抓到一张扑克牌 int left = 0; // 拿在左手上的牌总是排序好的,所以可以用二分法 int right = i - 1; // 手牌左右边界进行初始化 while (left <= right) // 采用二分法定位新牌的位置 { int mid = (left + right) / 2; if (A[mid] > get) right = mid - 1; else left = mid + 1; } for (int j = i - 1; j >= left; j--) // 将欲插入新牌位置右边的牌整体向右移动一个单位 { A[j + 1] = A[j]; } A[left] = get; // 将抓到的牌插入手牌 } } int main() { int A[] = { 5, 2, 9, 4, 7, 6, 1, 3, 8 };// 从小到大二分插入排序 int n = sizeof(A) / sizeof(int); InsertionSortDichotomy(A, n); printf("二分插入排序结果:"); for (int i = 0; i < n; i++) { printf("%d ", A[i]); } printf("\n"); return 0; } 插入排序再改进——希尔排序 https://www.cnblogs.com/chengxiao/p/6104371.html https://www.iqiyi.com/v_19rrhzyejc.html 希尔排序是基于插入排序的以下两点性质而提出改进方法的: 1、插入排序在对几乎已经排好序的数据操作时,效率高,即可以达到线性排序的效率; 2、但插入排序一般来说是低效的,因为插入排序每次只能将数据移动一位; 希尔排序的基本思想是: 先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,待整个序列中的记录“基本有序”时,再对全体记录进行依次直接插入排序。 #include <iostream> using namespace std; void shell_sort(int a[], int n) { //设定每次的步长 for (int dk = n / 2; dk >= 1; dk = dk / 2) { //对每一组进行插入排序 for (int k = 0; k < dk; k++) { //子组,做简单的插入排序 for (int i = 1; k + i * dk < n; i++) { //确定插入位置 for (int j = 0; j <= i; j++) { if (a[k + j * dk] >= a[k + i * dk]) { int temp = a[k + i * dk]; for (int p = i - 1; p >= j; p--) { a[k + (p + 1)*dk] = a[k + p * dk]; } a[k + j * dk] = temp; break; } } } } } } int main() { int a[10] = { 3,6,4,9,7,1,2,5,8,0 }; shell_sort(a, 10); return 0; } 选择排序 无论什么数据进去都是 O(n²) 的时间复杂度。所以用到它的时候,数据规模越小越好。唯一的好处可能就是不占用额外的内存空间 算法思路: 第1趟,在待排序记录 r[1] ~ r[n] 中选出最小的记录,将它与 r[1] 交换;第2趟,在待排序记录 r[2] ~ r[n] 中选出最小的记录,将它与 r[2] 交换;以此类推,第i趟在待排序记录 r[i] ~ r[n] 中选出最小的记录,将它与 r[i] 交换,使有序序列不断增长直到全部排序完毕。 //选择排序 void select(int nums[]) { if (nums == nullptr) return; //获取数组长度 int len = sizeof(nums) / sizeof(int); for (int i = 0; i < len-1; i++) { int minIndex = i; //循环找到最小的值,将其放在位置i处 for (int j = i + 1; j < len; j++) { minIndex = nums[j] < nums[minIndex] ? j : minIndex; } nums[i] = nums[i] + nums[minIndex]; nums[minIndex] = nums[i] - nums[minIndex]; nums[i] = nums[i] - nums[minIndex]; } } 快速排序 http://www.iqiyi.com/w_19rvedija1.html 算法思路: 1、从数列中挑出一个元素,称为 “基准”(pivot); 2、重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区退出之后,该基准就处于数列的中间位置。这个称为分区(partition)操作; 3、递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序; 递归实现 #include <iostream> void quick_sort(int a[], int l, int r) { if (l >= r) return; int low = l, high=r; int key = a[low]; while (low < high) { //从右往左找,如果该值小于key,则左移到low所指的位置 for (;; high--) { if (high <= low) break; if (a[high] < key) { a[low] = a[high]; break; } } //从左往右找,如果该值大于key,则右移到high所指的位置 for (;; low++) { if (high <= low)break; if (a[low] > key) { a[high] = a[low]; break; } } } //把key放在low和high重合的位置(即key应该在数组中的最终位置) if (low == high) a[low] = key; //分而治之 quick_sort(a, l, low - 1); quick_sort(a, low+1, r); } int main() { int a[10] = {2,6,3,8,9,0,1,4,7,5}; //递归 quick_sort(a, 0,9); return 0; } 非递归 堆排序 堆是一个完全二叉树(满二叉树的每个非叶子节点都有两个孩子节点,完全二叉树是前几层都是满的,左后一层叶子节点从左到右依次连续的,例如:) 堆在实际过程中可以用数组来进行实现。位置 i 的左孩子的下标为 2* i + 1 ,右孩子下标为 2* i + 2 。堆的结构在脑海中,实际的存储形式是数组。 -1/2=0; 堆分为大根堆和小根堆,堆就是完全二叉树。 把数组变成大根堆的过程(找索引位置为 x 的节点的父节点,父节点的索引位置为 (x-1)/2 ) 1、数组: 2、考查范围(0到1时的堆): 由于此时 1 的父节点坐标 x=(1-1)/2 =0 ,计算出 1 的父节点为2,2>1 ,因此 1 不与2 进行交换。 3、考查范围(0-2时的堆): 变换过程如下: 计算 3 的父节点为 (2-1)/2=0,因此3的父节点坐标为0,3 的父节点 2<3 ,此时需要将 3 和 2 的位置进行交换,数组变成 4、考查范围(0-3时的堆): 按照上述比较方式,6先和1进行交换,数组变成,然后6 再和3进行比较,发现自己比3大,因此两个数进行交换 代码实现思路:给你一个数组,依次把 0到 i 的位置的数加进来,将 i 位置元素的值与其父位置元素的值进行比较,只要我大,我们就换,直到不能继续往上换位置,最终形成大根堆。 #include<iostream> using namespace std; void swap(int arr[], int i, int father) { int temp = arr[i]; arr[i] = arr[father]; arr[father] = temp; } void helper(int arr[], int i) { while (arr[i]>arr[(i-1)/2]) { swap(arr, i, (i - 1) / 2); i = (i - 1) / 2; } } void CreatHeap(int input [], int len) { if ((input == nullptr) || (len == 0)) return; for (int i = 0; i < len; i++) { helper(input, i); } } int main() { int heap[] = { 0,1,2,3,4,5,6,7 ,8}; int len = sizeof(heap) / sizeof(int); CreatHeap(heap, len); return 0; } 堆排序就是利用堆结构进行的一个排序 先让数组变成大根堆,然后将堆顶元素与堆中最后一个元素进行交换,再将堆的尺寸减一,此时最大的值就固定在数组的最后一位了。将堆中剩余的元素进行heapify。这样,每次都能确定一个值的位置。 #include "pch.h" #include<iostream> using namespace std; void swap(int arr[], int i, int j) { int temp = arr[i]; arr[i] = arr[j]; arr[j] = temp; } void helper(int arr[], int i) { //不断将其与其父节点进行比较,如果他更大,则交换两个节点的值 while (arr[i]>arr[(i-1)/2]) { swap(arr, i, (i - 1) / 2); i = (i - 1) / 2; } } void heapify(int heap[], int index, int size) { //确定左孩子的节点坐标 int left = index * 2 + 1; //确保不越界 while (left < size) { //选择两个孩子里面的大值 int largest = (left + 1 < size && heap[left + 1] > heap[left]) ? left + 1 : left; //将大值与原index的值进行比较,取两者中最大者 largest = heap[largest] > heap[index] ? largest : index; //说明index已经是最大的值了 if (largest == index) break; //将最大值放在index位 swap(heap, largest, index); index = largest; //重新确定左子树的位置,方便进行下一轮比较 left = index * 2 + 1; } } void CreatHeap(int input [], int len) { if ((input == nullptr) || (len == 0)) return; //一次获取一个元素,考察他应该在堆中的位置 for (int i = 0; i < len; i++) { helper(input, i); } int size = len; swap(input, 0, --size); while (size > 0) { heapify(input, 0, size); swap(input, 0, --size); } } int main() { int heap[] = { 2,1,3,6,0,4}; int len = sizeof(heap) / sizeof(int); CreatHeap(heap, len); return 0; } 归并排序 桶排序、基数排序和基数排序不是基于比较的排序

优秀的个人博客,低调大师

c++ 逗号运算符

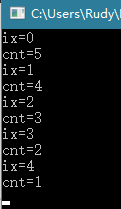
逗号运算符含有两个运算对象,按照从左向右的顺序依次求值。 对于逗号运算符,首先对左侧表达式求值,然后将求值结果丢弃。逗号运算符真正的结果是右侧表达式的值。 逗号运算符经常被用在for循环中: #include <iostream> #include<vector> using namespace std; int main() { vector<int>ivec = {1,2,3,4,5}; vector<int>::size_type cnt = ivec.size(); for (vector<int>::size_type ix = 0; ix != ivec.size(); ++ix, --cnt) { cout << "ix=" << ix << endl; cout << "cnt=" << cnt << endl; ivec[ix] = cnt; } return 0; } 运行结果: 补充: 对于 vector<int>::size_type 参考链接:https://blog.csdn.net/jingzhengyi/article/details/44022119

优秀的个人博客,低调大师

HTTPS通信的C++实现

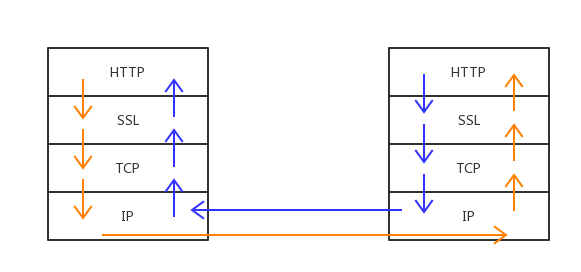
HTTPS是以安全为目标的HTTP通道,简单讲是HTTP的安全版。即HTTP下加入SSL层,HTTPS的安全基础是SSL,因此加密的详细内容就需要SSL。Nebula是一个为开发者提供一个快速开发高并发网络服务程序或搭建高并发分布式服务集群的高性能事件驱动网络框架。Nebula作为通用网络框架提供HTTPS支持十分重要,Nebula既可用作https服务器,又可用作https客户端。本文将结合Nebula框架的https实现详细讲述基于openssl的SSL编程。如果觉得本文对你有用,帮忙到Nebula的Github或码云给个star,谢谢。Nebula不仅是一个框架,还提供了一系列基于这个框架的应用,目标是打造一个高性能分布式服务集群解决方案。Nebula的主要应用领域:即时通讯(成功应用于一款IM)、消息推送平台、数据实时分析计算(成功案例)等,Bwar还计划基于Nebula开发爬虫应用。 1. SSL加密通信 HTTPS通信是在TCP通信层与HTTP应用层之间增加了SSL层,如果应用层不是HTTP协议也是可以使用SSL加密通信的,比如WebSocket协议WS的加上SSL层之后的WSS。Nebula框架可以通过更换Codec达到不修改代码变更通讯协议目的,Nebula增加SSL支持后,所有Nebula支持的通讯协议都有了SSL加密通讯支持,基于Nebula的业务代码无须做任何修改。 Socket连接建立后的SSL连接建立过程: 2. OpenSSL API OpenSSL的API很多,但并不是都会被使用到,如果需要查看某个API的详细使用方法可以阅读API文档。 2.1 初始化OpenSSL OpenSSL在使用之前,必须进行相应的初始化工作。在建立SSL连接之前,要为Client和Server分别指定本次连接采用的协议及其版本,目前能够使用的协议版本包括SSLv2、SSLv3、SSLv2/v3和TLSv1.0。SSL连接若要正常建立,则要求Client和Server必须使用相互兼容的协议。 下面是Nebula框架SocketChannelSslImpl::SslInit()函数初始化OpenSSL的代码,根据OpenSSL的不同版本调用了不同的API进行初始化。 #if OPENSSL_VERSION_NUMBER >= 0x10100003L if (OPENSSL_init_ssl(OPENSSL_INIT_LOAD_CONFIG, NULL) == 0) { pLogger->WriteLog(neb::Logger::ERROR, __FILE__, __LINE__, __FUNCTION__, "OPENSSL_init_ssl() failed!"); return(ERR_SSL_INIT); } /* * OPENSSL_init_ssl() may leave errors in the error queue * while returning success */ ERR_clear_error(); #else OPENSSL_config(NULL); SSL_library_init(); // 初始化SSL算法库函数( 加载要用到的算法 ),调用SSL函数之前必须调用此函数 SSL_load_error_strings(); // 错误信息的初始化 OpenSSL_add_all_algorithms(); #endif 2.2 创建CTX CTX是SSL会话环境,建立连接时使用不同的协议,其CTX也不一样。创建CTX的相关OpenSSL函数: //客户端、服务端都需要调用 SSL_CTX_new(); //申请SSL会话环境 //若有验证对方证书的需求,则需调用 SSL_CTX_set_verify(); //指定证书验证方式 SSL_CTX_load_verify_location(); //为SSL会话环境加载本应用所信任的CA证书列表 //若有加载证书的需求,则需调用 int SSL_CTX_use_certificate_file(); //为SSL会话加载本应用的证书 int SSL_CTX_use_certificate_chain_file();//为SSL会话加载本应用的证书所属的证书链 int SSL_CTX_use_PrivateKey_file(); //为SSL会话加载本应用的私钥 int SSL_CTX_check_private_key(); //验证所加载的私钥和证书是否相匹配 2.3 创建SSL套接字 在创建SSL套接字之前要先创建Socket套接字,建立TCP连接。创建SSL套接字相关函数: SSL *SSl_new(SSL_CTX *ctx); //创建一个SSL套接字 int SSL_set_fd(SSL *ssl, int fd); //以读写模式绑定流套接字 int SSL_set_rfd(SSL *ssl, int fd); //以只读模式绑定流套接字 int SSL_set_wfd(SSL *ssl, int fd); //以只写模式绑定流套接字 2.4 完成SSL握手 在这一步,我们需要在普通TCP连接的基础上,建立SSL连接。与普通流套接字建立连接的过程类似:Client使用函数SSL_connect()【类似于流套接字中用的connect()】发起握手,而Server使用函数SSL_ accept()【类似于流套接字中用的accept()】对握手进行响应,从而完成握手过程。两函数原型如下: int SSL_connect(SSL *ssl); int SSL_accept(SSL *ssl); 握手过程完成之后,Client通常会要求Server发送证书信息,以便对Server进行鉴别。其实现会用到以下两个函数: X509 *SSL_get_peer_certificate(SSL *ssl); //从SSL套接字中获取对方的证书信息 X509_NAME *X509_get_subject_name(X509 *a); //得到证书所用者的名字 2.5 数据传输 经过前面的一系列过程后,就可以进行安全的数据传输了。在数据传输阶段,需要使用SSL_read( )和SSL_write( )来代替普通流套接字所使用的read( )和write( )函数,以此完成对SSL套接字的读写操作,两个新函数的原型分别如下: int SSL_read(SSL *ssl,void *buf,int num); //从SSL套接字读取数据 int SSL_write(SSL *ssl,const void *buf,int num); //向SSL套接字写入数据 2.6 会话结束 当Client和Server之间的通信过程完成后,就使用以下函数来释放前面过程中申请的SSL资源: int SSL_shutdown(SSL *ssl); //关闭SSL套接字 void SSl_free(SSL *ssl); //释放SSL套接字 void SSL_CTX_free(SSL_CTX *ctx); //释放SSL会话环境 3. SSL 和 TLS HTTPS 使用 SSL(Secure Socket Layer) 和 TLS(Transport LayerSecurity)这两个协议。 SSL 技术最初是由浏览器开发商网景通信公司率先倡导的,开发过 SSL3.0之前的版本。目前主导权已转移到 IETF(Internet Engineering Task Force,Internet 工程任务组)的手中。 IETF 以 SSL3.0 为基准,后又制定了 TLS1.0、TLS1.1 和 TLS1.2。TSL 是以SSL 为原型开发的协议,有时会统一称该协议为 SSL。当前主流的版本是SSL3.0 和 TLS1.0。 由于 SSL1.0 协议在设计之初被发现出了问题,就没有实际投入使用。SSL2.0 也被发现存在问题,所以很多浏览器直接废除了该协议版本。 4. Nebula中的SSL通讯实现 Nebula框架同时支持SSL服务端应用和SSL客户端应用,对openssl的初始化只需要初始化一次即可(SslInit()只需调用一次)。Nebula框架的SSL相关代码(包括客户端和服务端的实现)都封装在SocketChannelSslImpl这个类中。Nebula的SSL通信是基于异步非阻塞的socket通信,并且不使用openssl的BIO(因为没有必要,代码还更复杂了)。 SocketChannelSslImpl是SocketChannelImpl的派生类,在SocketChannelImpl常规TCP通信之上增加了SSL通信层,两个类的调用几乎没有差异。SocketChannelSslImpl类声明如下: class SocketChannelSslImpl : public SocketChannelImpl { public: SocketChannelSslImpl(SocketChannel* pSocketChannel, std::shared_ptr<NetLogger> pLogger, int iFd, uint32 ulSeq, ev_tstamp dKeepAlive = 0.0); virtual ~SocketChannelSslImpl(); static int SslInit(std::shared_ptr<NetLogger> pLogger); static int SslServerCtxCreate(std::shared_ptr<NetLogger> pLogger); static int SslServerCertificate(std::shared_ptr<NetLogger> pLogger, const std::string& strCertFile, const std::string& strKeyFile); static void SslFree(); int SslClientCtxCreate(); int SslCreateConnection(); int SslHandshake(); int SslShutdown(); virtual bool Init(E_CODEC_TYPE eCodecType, bool bIsClient = false) override; // 覆盖基类的Send()方法,实现非阻塞socket连接建立后继续建立SSL连接,并收发数据 virtual E_CODEC_STATUS Send() override; virtual E_CODEC_STATUS Send(int32 iCmd, uint32 uiSeq, const MsgBody& oMsgBody) override; virtual E_CODEC_STATUS Send(const HttpMsg& oHttpMsg, uint32 ulStepSeq) override; virtual E_CODEC_STATUS Recv(MsgHead& oMsgHead, MsgBody& oMsgBody) override; virtual E_CODEC_STATUS Recv(HttpMsg& oHttpMsg) override; virtual E_CODEC_STATUS Recv(MsgHead& oMsgHead, MsgBody& oMsgBody, HttpMsg& oHttpMsg) override; virtual bool Close() override; protected: virtual int Write(CBuffer* pBuff, int& iErrno) override; virtual int Read(CBuffer* pBuff, int& iErrno) override; private: E_SSL_CHANNEL_STATUS m_eSslChannelStatus; //在基类m_ucChannelStatus通道状态基础上增加SSL通道状态 bool m_bIsClientConnection; SSL* m_pSslConnection; static SSL_CTX* m_pServerSslCtx; //当打开ssl选项编译,启动Nebula服务则自动创建 static SSL_CTX* m_pClientSslCtx; //默认为空,当打开ssl选项编译并且第一次发起了对其他SSL服务的连接时(比如访问一个https地址)创建 }; SocketChannelSslImpl类中带override关键字的方法都是覆盖基类SocketChannelImpl的同名方法,也是实现SSL通信与非SSL通信调用透明的关键。不带override关键字的方法都是SSL通信相关方法,这些方法里有openssl的函数调用。不带override的方法中有静态和非静态之分,静态方法在进程中只会被调用一次,与具体Channel对象无关。SocketChannel外部不需要调用非静态的ssl相关方法。 因为是非阻塞的socket,SSL_do_handshake()和SSL_write()、SSL_read()返回值并不完全能判断是否出错,还需要SSL_get_error()获取错误码。SSL_ERROR_WANT_READ和SSL_ERROR_WANT_WRITE都是正常的。 网上的大部分openssl例子程序是按顺序调用openssl函数简单实现同步ssl通信,在非阻塞IO应用中,ssl通信要复杂许多。SocketChannelSslImpl实现的是非阻塞的ssl通信,从该类的实现上看整个通信过程并非完全线性的。下面的SSL通信图更清晰地说明了Nebula框架中SSL通信是如何实现的: SocketChannelSslImpl中的静态方法在进程生命期内只需调用一次,也可以理解成SSL_CTX_new()、SSL_CTX_free()等方法只需调用一次。更进一步理解SSL_CTX结构体在进程内只需要创建一次(在Nebula中分别为Server和Client各创建一个)就可以为所有SSL连接所用;当然,为每个SSL连接创建独立的SSL_CTX也没问题(Nebula 0.4中实测过为每个Client创建独立的SSL_CTX),但一般不这么做,因为这样会消耗更多的内存资源,并且效率也会更低。 建立SSL连接时,客户端调用SSL_connect(),服务端调用SSL_accept(),许多openssl的demo都是这么用的。Nebula中用的是SSL_do_handshake(),这个方法同时适用于客户端和服务端,在兼具client和server功能的服务更适合用SSL_do_handshake()。注意调用SSL_do_handshake()前,如果是client端需要先调用SSL_set_connect_state(),如果是server端则需要先调用SSL_set_accept_state()。非阻塞IO中,SSL_do_handshake()可能需要调用多次才能完成握手,具体调用时机需根据SSL_get_error()获取错误码SSL_ERROR_WANT_READ和SSL_ERROR_WANT_WRITE判断需监听读事件还是写事件,在对应事件触发时再次调用SSL_do_handshake()。详细实现请参考SocketChannelSslImpl的Send和Recv方法。 关闭SSL连接时先调用SSL_shutdown()正常关闭SSL层连接(非阻塞IO中SSL_shutdown()亦可能需要调用多次)再调用SSL_free()释放SSL连接资源,最后关闭socket连接。SSL_CTX无须释放。整个SSL通信顺利完成,Nebula 0.4在开多个终端用shell脚本死循环调用curl简单压测中SSL client和SSL server功能一切正常: while : do curl -v -k -H "Content-Type:application/json" -X POST -d '{"hello":"nebula ssl test"}' https://192.168.157.168:16003/test_ssl done 测试方法如下图: 查看资源使用情况,SSL Server端的内存使用一直在增长,疑似有内存泄漏,不过pmap -d查看某一项anon内存达到近18MB时不再增长,说明可能不是内存泄漏,只是部分内存被openssl当作cache使用了。这个问题网上没找到解决办法。从struct ssl_ctx_st结构体定义发现端倪,再从nginx源码中发现了SSL_CTX_remove_session(),于是在SSL_free()之前加上SSL_CTX_remove_session()。session复用可以提高SSL通信效率,不过Nebula暂时不需要。 这种测试方法把NebulaInterface作为SSL服务端,NebulaLogic作为SSL客户端,同时完成了Nebula框架SSL服务端和客户端功能测试,简单的压力测试。Nebula框架的SSL通信测试通过,也可以投入生产应用,在后续应用中肯定还会继续完善。openssl真的难用,难怪被吐槽那么多,或许不久之后的Nebula版本将用其他ssl库替换掉openssl。 5. 结束 加上SSL支持的Nebula框架测试通过,虽然不算太复杂,但过程还是蛮曲折,耗时也挺长。这里把Nebula使用openssl开发SSL通信分享出来,希望对准备使用openssl的开发者有用。如果觉得本文对你有用,别忘了到Nebula的Github或码云给个star,谢谢。 本文来自云栖社区合作伙伴“开源中国” 本文作者:Bwar 原文链接

优秀的个人博客,低调大师

C#中的NameValueCollection简介

NameValueCollection继承自NameObjectCollectionBase,并且和一般的键值对不同的是,它支持集合中出现相同的Key。 引用:using System.Collections.Specialized; 直接上示例代码: NameValueCollection props = new NameValueCollection { { "quartz.serializer.type", "binary" }, { "quartz.serializer.type", "binary" } }; Console.WriteLine(props[0]); Console.Read(); 输出结果如下: 可以看到,在读取相同的key时,输出结果对Value进行了合并,这就是NameValueCollection与一般键值对的主要区别所在。

优秀的个人博客,低调大师

区域生长算法 C++实现

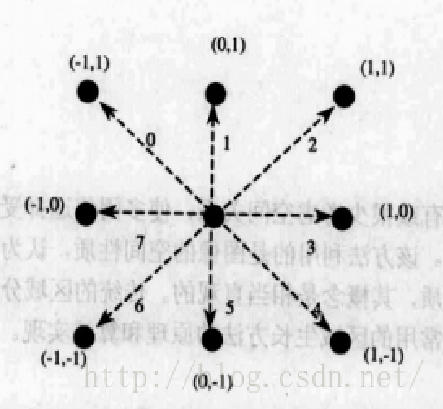
在比赛和项目中用opencv用多了,就会发现很多opencv没有实现的算法,其中一些还是十分常用,在教科书上经常出现的。作为一个弱鸡,有的简单的算法能够自己实现(比如本文所要讲的),有的写到一半就打出GG,有的直接就下不了手。。。作为一个非计算机科班的自动化系学生,想要成为一名视觉算法工程师,还是有很长的路要走啊~~ 区域生长 1.算法原理 其实看上图和这个名字就很容易理解,区域生长是根据预先定义的生长准则将像素或子区域组合为更大区域的过程。基本方法是从一组“种子”点开始(原点),将与种子相似的临近像素(在特定范围内的灰度或颜色)添加到种子栈中,不断迭代,生成一大片区域。严谨的数学定义可以查看冈萨雷斯的数字图像处理。 2.算法实现 算法的步骤如下: 创建一个与原图像大小相同的空白图像 将种子点存入vector中,vector中存储待生长的种子点 依次弹出种子点并判断种子点如周围8领域的关系(生长规则)并与最大与最小阈值进行比较,符合条件则作为下次生长的种子点 vector中不存在种子点后就停止生长 我这里因为项目需要,对原本的区域生长算法多加了最大与最小值的限制,作为默认参数可以不填。 /** * @brief 区域生长算法,输入图像应为灰度图像 * @param srcImage 区域生长的源图像 * @param pt 区域生长点 * @param ch1Thres 通道的生长限制阈值,临近像素符合±chxThres范围内才能进行生长 * @param ch1LowerBind 通道的最小值阈值 * @param ch1UpperBind 通道的最大值阈值,在这个范围外即使临近像素符合±chxThres也不能生长 * @return 生成的区域图像(二值类型) */ Mat RegionGrow(Mat srcImage, Point pt, int ch1Thres,int ch1LowerBind=0,int ch1UpperBind=255) { Point pToGrowing; //待生长点位置 int pGrowValue = 0; //待生长点灰度值 Scalar pSrcValue = 0; //生长起点灰度值 Scalar pCurValue = 0; //当前生长点灰度值 Mat growImage = Mat::zeros(srcImage.size(), CV_8UC1); //创建一个空白区域,填充为黑色 //生长方向顺序数据 int DIR[8][2] = {{-1,-1}, {0,-1}, {1,-1}, {1,0}, {1,1}, {0,1}, {-1,1}, {-1,0}}; vector<Point> growPtVector; //生长点栈 growPtVector.push_back(pt); //将生长点压入栈中 growImage.at<uchar>(pt.y, pt.x) = 255; //标记生长点 pSrcValue = srcImage.at<uchar>(pt.y, pt.x); //记录生长点的灰度值 while (!growPtVector.empty()) //生长栈不为空则生长 { pt = growPtVector.back(); //取出一个生长点 growPtVector.pop_back(); //分别对八个方向上的点进行生长 for (int i = 0; i<9; ++i) { pToGrowing.x = pt.x + DIR[i][0]; pToGrowing.y = pt.y + DIR[i][1]; //检查是否是边缘点 if (pToGrowing.x < 0 || pToGrowing.y < 0 || pToGrowing.x > (srcImage.cols-1) || (pToGrowing.y > srcImage.rows -1)) continue; pGrowValue = growImage.at<uchar>(pToGrowing.y, pToGrowing.x); //当前待生长点的灰度值 pSrcValue = srcImage.at<uchar>(pt.y, pt.x); if (pGrowValue == 0) //如果标记点还没有被生长 { pCurValue = srcImage.at<uchar>(pToGrowing.y, pToGrowing.x); if(pCurValue[0] <= ch1UpperBind && pCurValue[0] >= ch1LowerBind ) { if (abs(pSrcValue[0] - pCurValue[0]) < ch1Thres ) //在阈值范围内则生长 { growImage.at<uchar>(pToGrowing.y, pToGrowing.x) = 255; //标记为白色 growPtVector.push_back(pToGrowing); //将下一个生长点压入栈中 } } } } } return growImage.clone(); } 上面是灰度图像的处理,我这里重载了三通道图像的区域生长 /** * @brief 区域生长算法,输入图像应为三通道图像(RGB、HSV、YUV等) * @param srcImage 区域生长的源图像 * @param pt 区域生长点 * @param ch1Thres ch2Thres ch3Thres 三个通道的生长限制阈值,临近像素符合±chxThres范围内才能进行生长 * @param ch1LowerBind ch1LowerBind ch1LowerBind 三个通道的最小值阈值 * @param ch1UpperBind ch2UpperBind ch3UpperBind 三个通道的最大值阈值,在这个范围外即使临近像素符合±chxThres也不能生长 * @return 生成的区域图像(二值类型) */ Mat RegionGrow(Mat srcImage, Point pt, int ch1Thres,int ch2Thres, int ch3Thres, int ch1LowerBind=0,int ch1UpperBind=255,int ch2LowerBind=0, int ch2UpperBind=255,int ch3LowerBind=0,int ch3UpperBind=255) { Point pToGrowing; //待生长点位置 int pGrowValue = 0; //待生长点灰度值 Scalar pSrcValue = 0; //生长起点灰度值 Scalar pCurValue = 0; //当前生长点灰度值 Mat growImage = Mat::zeros(srcImage.size(), CV_8UC1); //创建一个空白区域,填充为黑色 //生长方向顺序数据 int DIR[8][2] = {{-1,-1}, {0,-1}, {1,-1}, {1,0}, {1,1}, {0,1}, {-1,1}, {-1,0}}; vector<Point> growPtVector; //生长点栈 growPtVector.push_back(pt); //将生长点压入栈中 growImage.at<uchar>(pt.y, pt.x) = 255; //标记生长点 pSrcValue = srcImage.at<Vec3b>(pt.y, pt.x); //记录生长点的灰度值 while (!growPtVector.empty()) //生长栈不为空则生长 { pt = growPtVector.back(); //取出一个生长点 growPtVector.pop_back(); //分别对八个方向上的点进行生长 for (int i = 0; i<9; ++i) { pToGrowing.x = pt.x + DIR[i][0]; pToGrowing.y = pt.y + DIR[i][1]; //检查是否是边缘点 if (pToGrowing.x < 0 || pToGrowing.y < 0 || pToGrowing.x > (srcImage.cols-1) || (pToGrowing.y > srcImage.rows -1)) continue; pGrowValue = growImage.at<uchar>(pToGrowing.y, pToGrowing.x); //当前待生长点的灰度值 pSrcValue = srcImage.at<Vec3b>(pt.y, pt.x); if (pGrowValue == 0) //如果标记点还没有被生长 { pCurValue = srcImage.at<Vec3b>(pToGrowing.y, pToGrowing.x); if(pCurValue[0] <= ch1UpperBind && pCurValue[0] >= ch1LowerBind&& //限制生长点的三通道上下界 pCurValue[1] <= ch2UpperBind && pCurValue[1] >= ch2LowerBind && pCurValue[2] <= ch3UpperBind && pCurValue[2] >= ch3LowerBind ) { if (abs(pSrcValue[0] - pCurValue[0]) < ch1Thres && abs(pSrcValue[1] - pCurValue[1]) < ch2Thres && abs(pSrcValue[2] - pCurValue[2]) < ch3Thres) //在阈值范围内则生长 { growImage.at<uchar>(pToGrowing.y, pToGrowing.x) = 255; //标记为白色 growPtVector.push_back(pToGrowing); //将下一个生长点压入栈中 } } } } } return growImage.clone(); } 3.算法检验 原图像 区域生长后 References:https://blog.csdn.net/robin__chou/article/details/50071313 数字图像处理(第三版) ——冈萨雷斯 P493

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册